[Back to basic] Training
Transformer 공부하다가 기본기가 부족하다는 걸 느껴서, MNIST MLP로 학습의 기초를 다시 짚는다. Dataset / DataLoader, iter와 next, cross entropy, validation 함수, 그리고 epoch loop와 step loop(next(it))의 차이까지 정리한다.
Introduction
Transformer 학습을 진행하면서, 기본적인 학습 지식이 부족하다는 것을 깨닫고 오늘은 그냥 아주 간단한 이미지 classification MLP model 학습을 먼저 진행해보고자 한다. 이게 가장 핵심적으로 볼 부분이 데이터 로드를 해가지고 배치로 어떻게 만드는가. 그리고 학습할때, validation loss는 어떻게 정의하며, 그것을 이제 output하는 방법들을 제대로 다뤄보자.
1. Dataload
기본적으로 학습은 이렇게 3개로 데이터를 분류한다. 학습용과 학습진행중에 점검용인 val그리고 마지막에 학습이 다 끝나고 아예 처음 보는 데이터를 가지고 테스트를 진행한다.
| split | 언제 보나 | 뭘 하나 |
|---|---|---|
| train | 매 스텝 | 가중치 업데이트 (loss.backward) |
| val | 학습 중간중간 | 잘 되고 있는지 채점. 모델은 안 건드림 |
| test | 전부 끝난 뒤 한 번 | 최종 성적. 학습 중에는 안 봄 |
1.1 Overall workflow
일단 학습의 큰 틀을 이해해야한다. 우리가 이제 최종적으로 학습을 진행할때는, 결국에 배치라는 덩어리 하나를 동시에 학습을 진행한다. (배치는 결국에 여러데이터가 들어있는 하나의 덩어리라고 이해하면 된다)
아주 잘 설명해주는 그림이 하단에 있다.
- 데이터를 배치로 그룹화한다.
- 배치 하나가 호출되면 그 안에 데이터를 하나의 텐서로 합치고, 학습 연산을 진행
- Loss는 배치 안 데이터들의 loss 평균으로 정의한다.
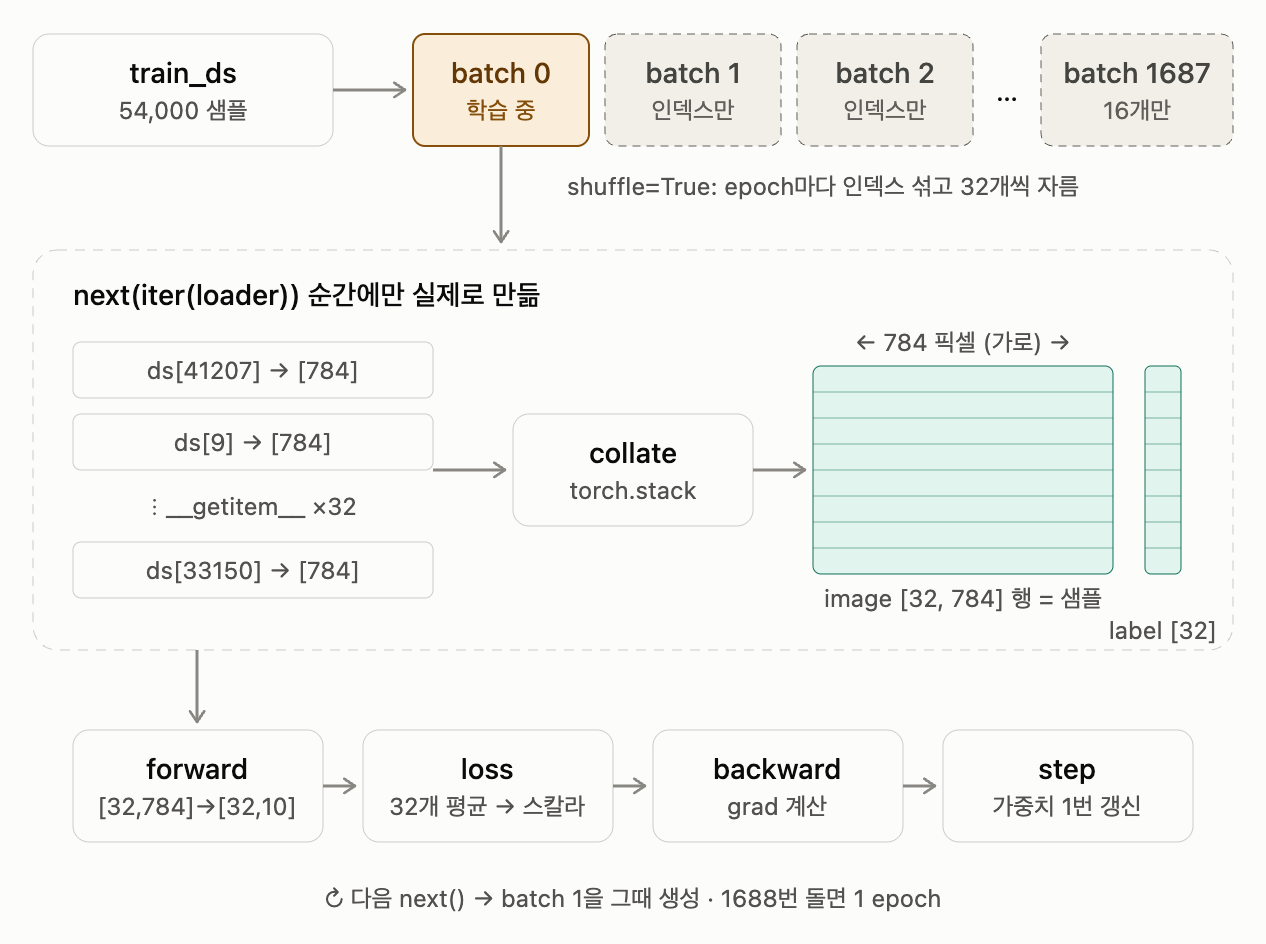
그리고 그 배치를 그룹화라고 이해하면, 그 그룹들을 언제 어떻게 미리 만들어 놓을지가 이제 우리가 선행해야하는 일이다. 그에 필요한 도구들이 바로
- Dataset class
- Dataloader
이라고 이해하면 된다.
1.2 Dataset class
데이터셋 클래스는 간단하게 len이랑 get item method를 적절히 정의해야한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
from datasets import load_dataset
import torch


class MNISTDataset(torch.utils.data.Dataset):
    def __init__(self):
        self.data = load_dataset("ylecun/mnist", split = "train")

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        return self.data[idx]
- len 메서드는 단순하게 데이터의 길이가 얼마인지를 output하고,
- 그 길이 안에서 특정 인덱스의 데이터를 뽑아내는게 이제 getitem method가 되겠다.
그렇다면 getitem에서는 우리가 정말 학습에 딱 필요한 모양의 데이터셋 {input, output}이 들어가 있어야한다.
아주 간단한 예시로, 우리가 여기서 이제 image를 학습가능한 디멘션으로 바꿔주고 그게 이제 input으로 만들어 주는 것이고, 그리고 label이라는 것이 그 이미지 데이터의 정답지가 될 것이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class MNISTDataset(torch.utils.data.Dataset):
    def __init__(self, data):
        self.data = data

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        row = self.data[idx]
        image = row["image"]   # PIL 28x28
        label = row["label"]   # int 0~9

        # PIL -> [784] float 0~1  (MLP 입력)
        image = torch.tensor(np.array(image), dtype=torch.float32) / 255.0
        image = image.view(-1)
        label = torch.tensor(label, dtype=torch.long)

        return {"image": image, "label": label}
저 데이터를 로드할때, 한가지 주의할 점은,
보통 huggingface 에서 데이터를 가져오는데 대부분 test/train split이 미리 되어있는 경우가 대다수이다. 하지만, test를 진행하면서 우리가 결과를 보고싶기 때문에 이 경우 train 안에서 val을 또 따로 빼주는 일을 진행하는 경우가 흔하다.
1
2
3
4
5
# 1. Dataset
data = load_dataset("ylecun/mnist", split="train")
n = int(len(data) * 0.9)
train_data = data.select(range(0, n))
val_data = data.select(range(n, len(data)))
이후에 이제 Dataset class instance를 형성한다.
1
2
train_ds = MNISTDataset(train_data)
val_ds = MNISTDataset(val_data)
1.3 Dataloader
마지막으로 이제 데이터 로더 클래스는 torch → utils → data 에 미리 정의되어있는 클래스 이다. 거기서 원하는 배치 사이즈와 데이터셋 인스턴스를 넣어주자. 그리고 shuffle은 매 epoch마다 데이터를 다시 섞어서 batch를 새로 만들지 말지를 결정하는 변수이다. (모든 배치를 한바퀴 다 돌았을때를 우리는 1 epoch라고 한다) 보통 train은 True, val은 섞을 필요가 없으니 False.
1
2
3
4
5
6
7
8
# 2. Data Loader
train_loader = DataLoader(train_ds, batch_size=32, shuffle=True)
val_loader = DataLoader(val_ds, batch_size=32, shuffle=False)

batch = next(iter(train_loader))
print(len(train_ds), len(val_ds))
print(batch["image"].shape, batch["image"].dtype, batch["image"].min(), batch["image"].max())
print(batch["label"].shape, batch["label"].dtype)
1
2
3
4
#output
54000 6000
torch.Size([32, 784]) torch.float32 tensor(0.) tensor(1.)
torch.Size([32]) torch.int64
여기서 iter(train_loader) 가 정확히는 또다른 인스턴스(iterator)를 형성하고 그 안에 이제 loader 내부에 있던 shuffle된 데이터의 인덱스들이 batch size에 맞게 들어있는 상황이다.
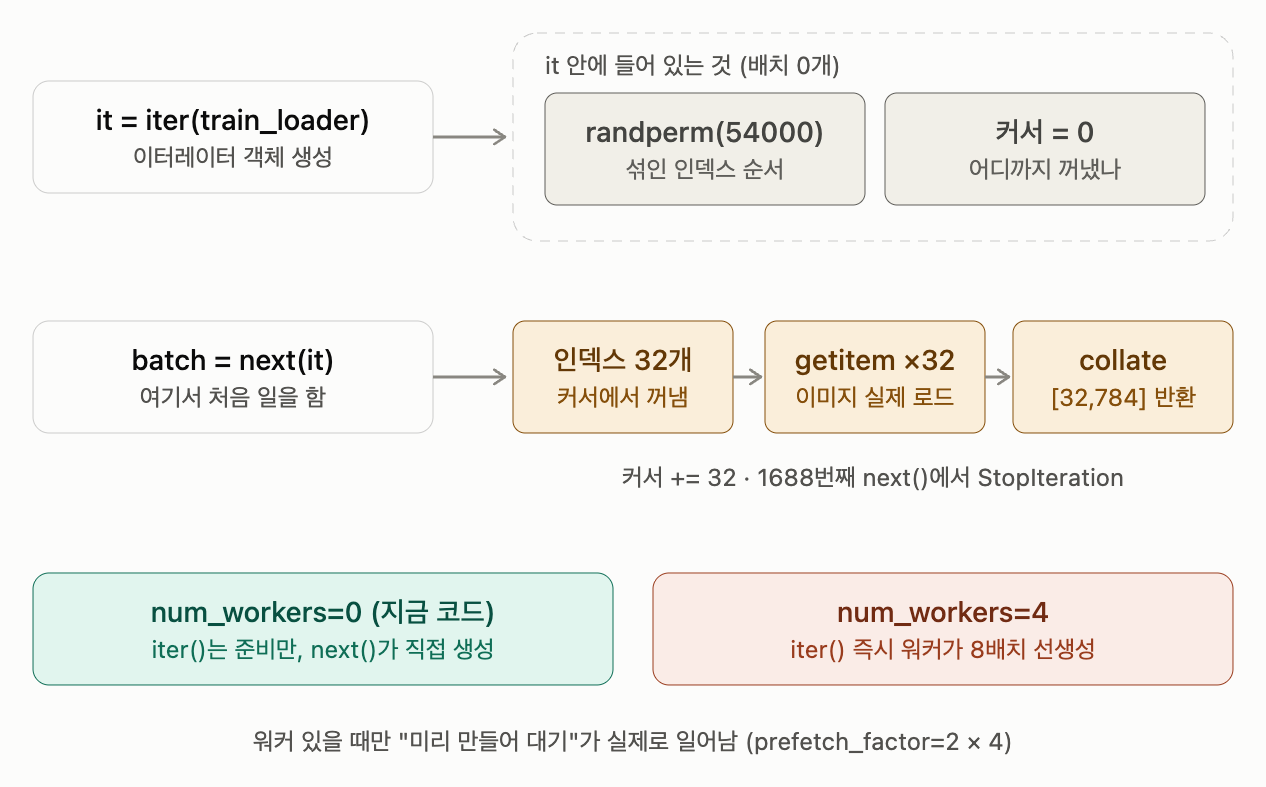
그리고 이제 next() method가 거기서 배치를 실제로 하나 꺼낸다.
2. Model / optimizer / loss function
1
2
3
4
5
6
7
8
9
10
11
class MLP(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.net = torch.nn.Sequential(
            torch.nn.Linear(784, 256),
            torch.nn.ReLU(),
            torch.nn.Linear(256, 10),
        )

    def forward(self, x):          # [B, 784]
        return self.net(x)         # [B, 10]
모델은 이번시간에 메인이 아니기 때문에 그냥 선형함수 2개와 비선형함수를 사이에 둔 간단한 MLP 구조로 제작하였다.
그리고 이제 optimizer and loss function instance 생성을 해주자.
1
2
3
4
# 3. Model / optimizer / loss function
model = MLP().to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
criterion = torch.nn.CrossEntropyLoss()
3. Train & Val loop
가장 먼저 해야할 일이 이제 validation 전용 함수를 항상 제작하자.
1
2
3
4
5
6
7
8
9
10
11
12
13
def run_val():
    model.eval()
    tot = 0.0
    with torch.no_grad():
        for batch in val_loader:
            images = batch["image"].to(device)
            labels = batch["label"].to(device)

            # model(images) -> [B, 10]
            # labels        -> [B]
            tot += criterion(model(images), labels).item()
    model.train()
    return tot / len(val_loader)
여기서 먼저 model.eval() and torch.no_grad()로 학습이 진행이 안되는 구간임을 명시하자. 그리고 이제 cross entropy로 loss를 구해준다. 간략하게 cross entropy loss 구하는 것에 대해서 이야기를 해보면,
배치 내부의 데이터 하나의 셋마다 우리가 loss function을 Logits으로부터 구한다. 여기서 중요한 점은
‘정답칸’만 본다. 라는 것이다.
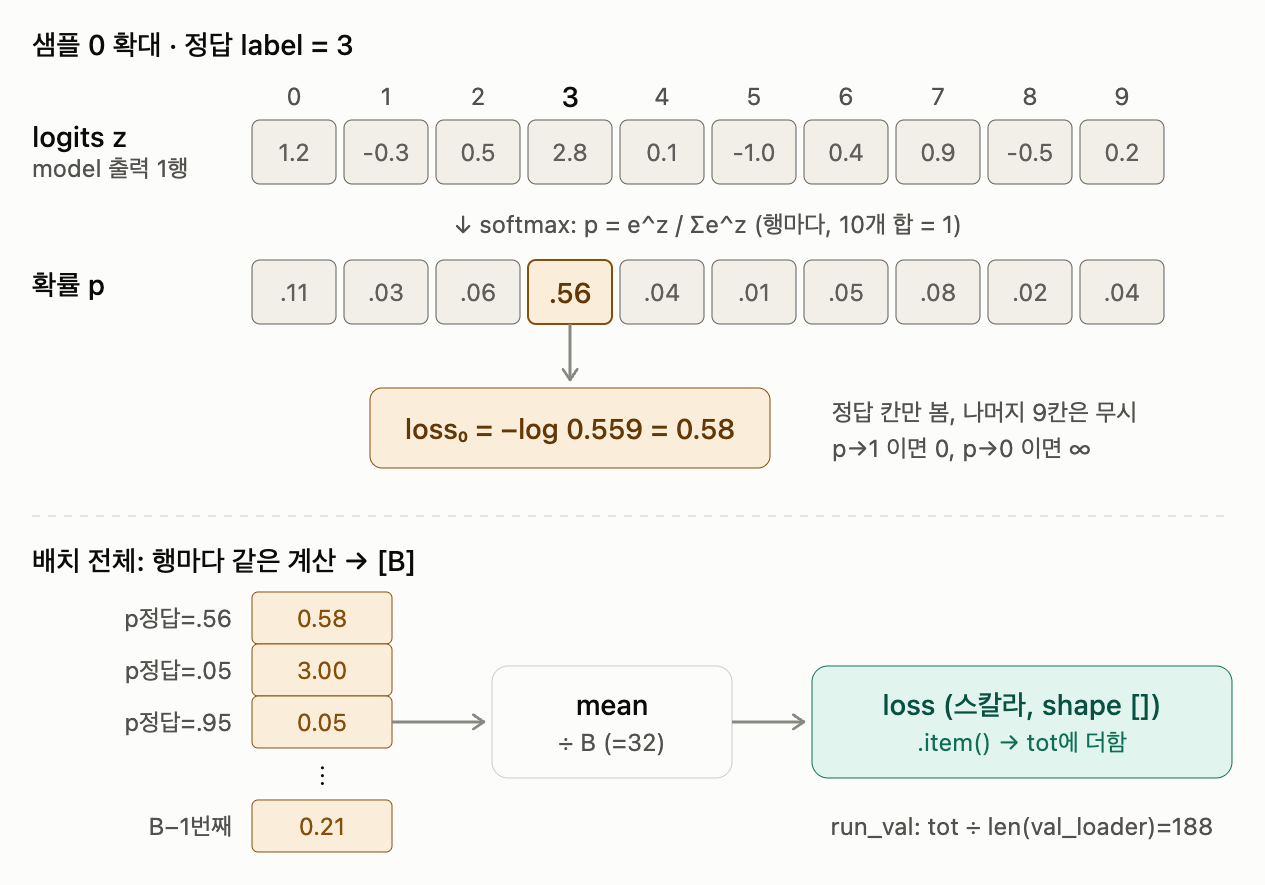
식으로 쓰면 loss = −log(p_정답), 여기서 p = softmax(logits) 이다. 정답칸 확률이 1이면 loss 0, 정답칸 확률이 0에 가까워질수록 loss가 확 커진다. (나머지 9칸은 softmax 안에서 정답칸 확률을 깎아먹는 식으로만 간접적으로 들어간다)
그리고 배치 안 모든 데이터의 그 loss를 평균을 내고, 계산을 진행하는 것이다. (CrossEntropyLoss 가 기본으로 평균 내줌)
여기서 이제 최종 학습루프로 들어가자. 일단은 총 5 Epoch ( 5바퀴 데이터셋 으로 가자) 나머지는 사실 간단하다. loss를 구하고 이제 중간중간에 디버깅용 호출을 진행해준다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
it = iter(train_loader)     # 책갈피 꽂기 (여기서 처음 섞임)
best = float("inf")
for step in range(1, 5 * len(train_loader) + 1):
    try:
        batch = next(it)
    except StopIteration:
        it = iter(train_loader)
        batch = next(it)
    images = batch["image"].to(device)
    labels = batch["label"].to(device)

    optimizer.zero_grad()
    loss = criterion(model(images), labels)
    loss.backward()
    optimizer.step()

    if step % 200 == 0:
        print(f"step {step} | loss {loss.item():.4f}", flush=True)

    if step % len(train_loader) == 0:
        v = run_val()
        print(f"step {step} | val {v:.4f}", flush=True)
        if v < best:
            best = v
            torch.save(model.state_dict(), OUT / "best.pt")

print(f"best val {best:.4f} -> {OUT / 'best.pt'}", flush=True)
여기서 그냥 next(it)을 안쓰고 batch를 로더 안에서 호출하는 식으로 진행하는 방식도 있다. 이 방식이 개인적으로는 더 직관적이다. 그러니까 전체 Epoch동안 그 안에서 batch 하나씩 loader에서 직접 꺼내가지고 이제 loss를 구하고 모든 배치에 대한 loss를 평균 내어서 보고하는 식으로 진행한다. (가중치 업데이트는 매 배치마다 진행되는 것을 잊지말자)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
best = float("inf")
for epoch in range(1, NUM_EPOCHS + 1):
    model.train()
    tot = 0.0
    for batch in train_loader:
        images = batch["image"].to(device)
        labels = batch["label"].to(device)

        optimizer.zero_grad()
        loss = criterion(model(images), labels)
        loss.backward()
        optimizer.step()
        tot += loss.item()

    train_loss = tot / len(train_loader)   # 한 바퀴 평균
    val_loss = run_val()
    print(f"epoch {epoch} | train {train_loss:.4f} | val {val_loss:.4f}", flush=True)

    if val_loss < best:
        best = val_loss
        torch.save(model.state_dict(), OUT / "best_basic.pt")
Summary
일단 여기까지 진행하면서 핵심적으로 배운것들을 정리해보자
Datasetclass definition , why we need thisDataloaderand definition ofiterclass andnextmethodCross entropy→ 정답에 대해서만 loss를 구하는 것은 놓치고 있었다.- 그리고 배치의 모든 데이터의 loss를 평균
Train loop2가지 방식이 있는지를 몰랐다. 하지만 전자의 경우 next(it) 가 선호된다고 생각한다. (왜 그런지는 바로 아래)
그래서 왜 generally next(it) 방식을 쓸까?
처음에 내가 한 생각은 2가지였다.
(1) GPU가 노는 동안 배치를 미리 준비해주니까 더 빠르다?
(2) shuffle은 next(it) 방식에서만 매 epoch마다 다시 섞인다?
→ 결론부터 말하면 둘 다 아니다. 두 방식은 사실 완전히 같은 일을 한다.
for batch in train_loader: 는 파이썬이 내부에서 자동으로 it = iter(train_loader) 를 만들고 next(it) 를 반복하다가 StopIteration 이 뜨면 멈추는 문법이다. 그러니까 next(it) 방식은 그걸 그냥 손으로 풀어쓴 것.
그럼 진짜 이유는 뭘까? → 학습의 단위를 epoch이 아니라 step으로 세기 위해서다.
- 큰 모델은 step으로 학습 예산을 정한다: SmolVLA도 “20,000 step” 이었다. LLM / VLA 처럼 데이터가 크면 1 epoch도 다 못 돌고 끝나기도 하고, 데이터셋을 바꿔도 “몇 번 업데이트했는가” 기준이 그대로다.
- lr scheduler가 step 단위다: warmup 1000 step → cosine 같은 스케줄은 총 step 수로 정의된다. (
num_training_steps=20000) - val / 로그 / 체크포인트를 epoch과 상관없이 N step마다: SmolVLA 때 500 step마다 val loss 본 것처럼. epoch 방식은 한 바퀴가 끝나야만 val을 볼 수 있다.
- 이어서 학습(resume)이 쉽다: “지금 12,000 step” 하나만 저장해두면 된다. epoch 중간에 끊기면 “몇 epoch의 몇 번째 배치” 까지 기억해야 한다.
- 끝이 없는 데이터도 된다: 스트리밍 데이터처럼
len()이 없으면 epoch 자체가 정의가 안 되는데, next() 는 그냥 계속 꺼내면 된다.
두 loop는 데이터 순서도, shuffle도, 속도도 같다. 차이는 “무엇을 세냐” 뿐이다.
- epoch loop (for) = “데이터를 몇 바퀴 볼까” → MNIST 처럼 작은 데이터에 직관적
- step loop (next) = “가중치를 몇 번 업데이트할까” → 큰 모델, lr scheduler, 주기적인 val / 체크포인트가 필요할때