
Transformer Step0 - nanoGPT
안드레이 카파시의 nanoGPT 실습을 따라 Bigram부터 Causal Self-Attention, Multi-Head Attention, Transformer Block까지 decoder-only GPT를 직접 구현한다.
🎬 실습 자료 — 안드레이 카파시
영상: Let’s build GPT: from scratch, in code, spelled out. — 1시간 56분, 2023년 1월
Introduction
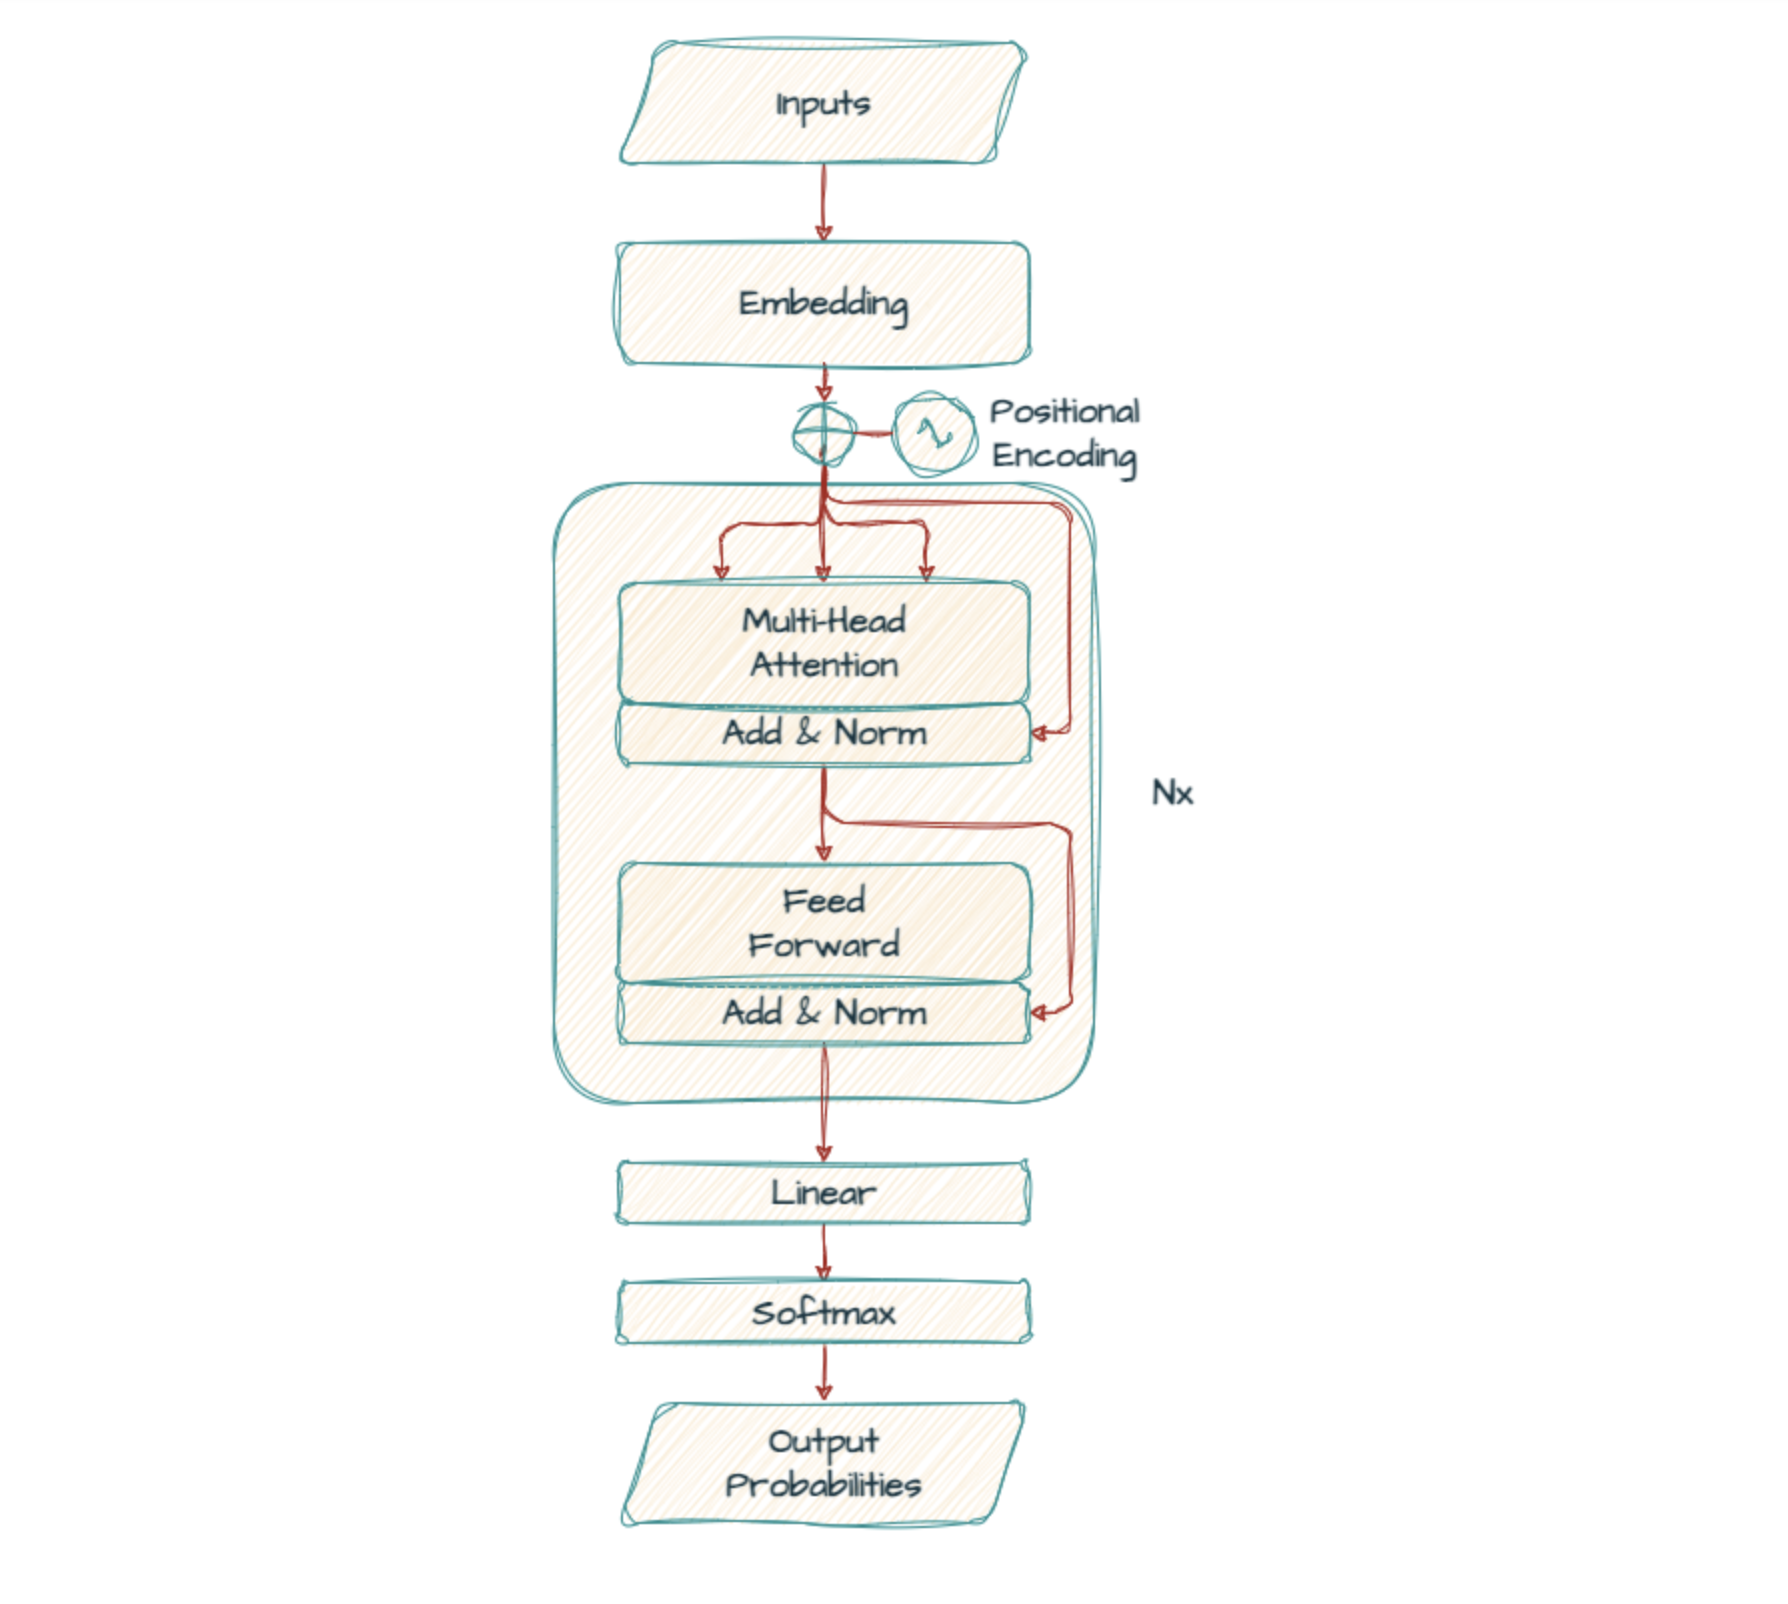
출처: Google for Developers Blog - News about Web, Mobile, AI and Cloud
(사실 VLA부터 공부해보려고했는데 어텐션 트랜스포머 개념부터 애매애매하게 머리속에 있는 관계로 이것부터 다시 시작하기로 했다….)
일단 Decoder-only Transformer의 구조는 위와 같다. 원래 Transformer 논문은 하단처럼, encoder - decoder 구조의 transformer이지만, 기본적으로 어텐션의 개념을 이해하기 위해서, decoder only transformer로 안드레는 실습을 진행하였다. 이후에 encoder vs decoder / self-attention vs cross-attention 개념을 마지막에 다룰 예정이다.
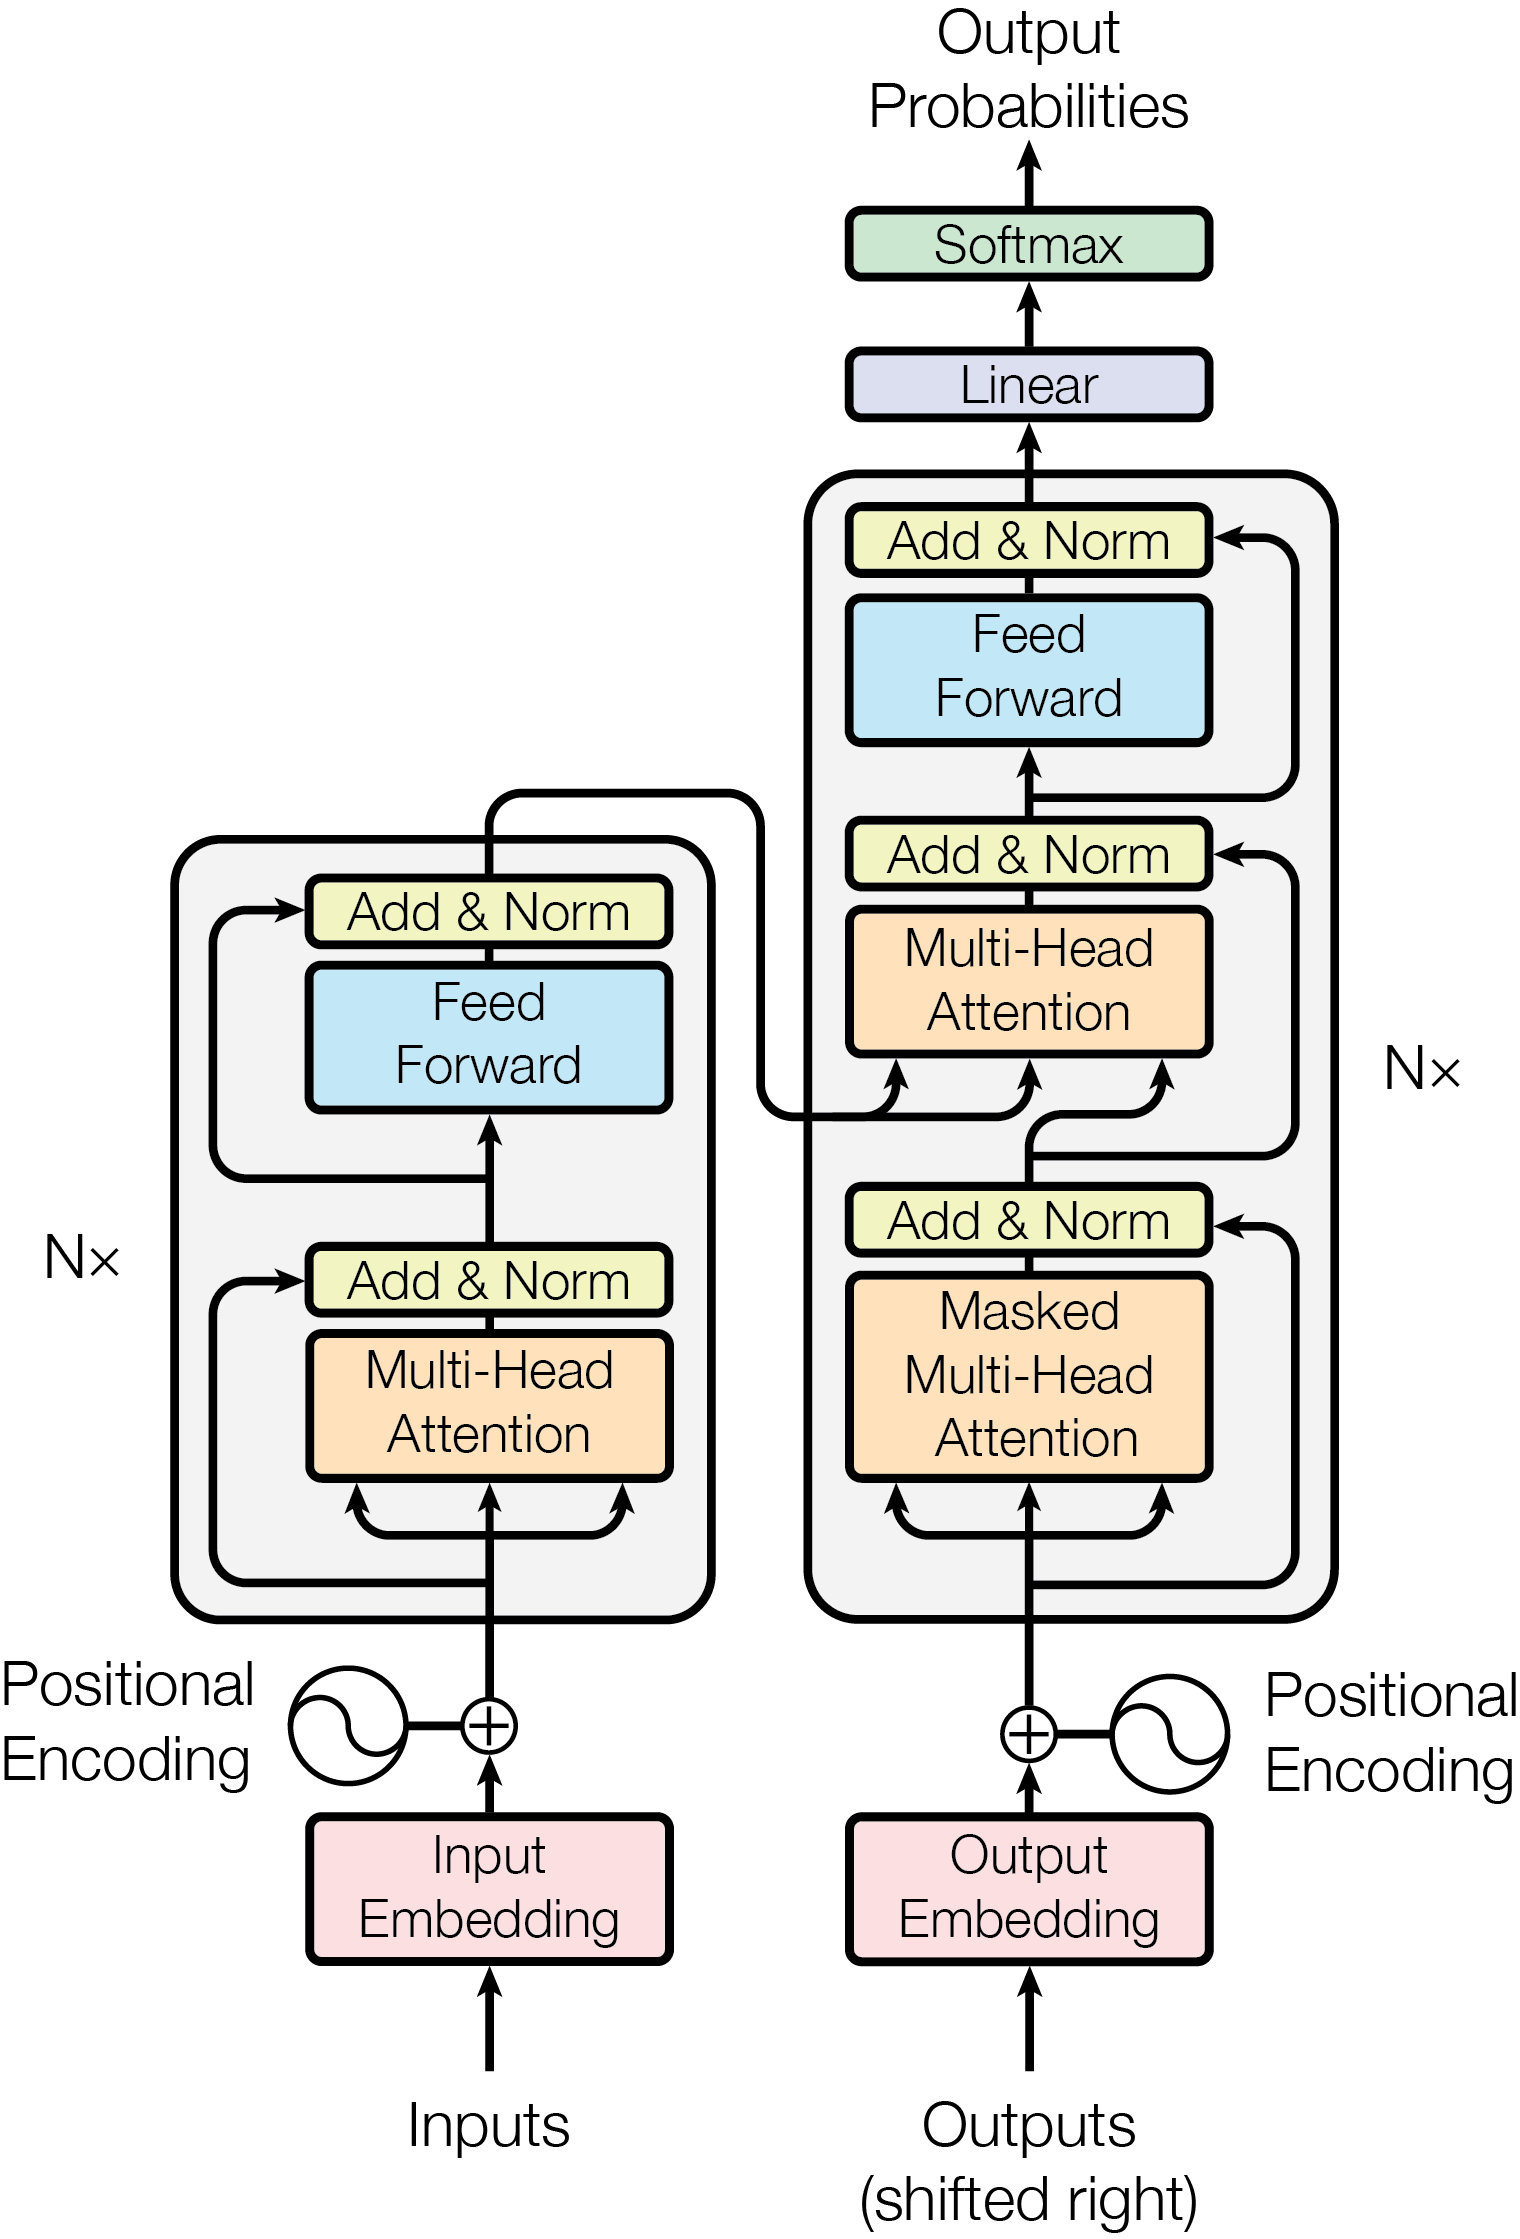
Reference: Attention Is All You Need
Content
- Colab 환경 세팅 확인.
input.txt읽기 및 문자 단위 토큰화- Train/Validation 분리와 입력
x, 정답y배치 생성 - 현재 토큰 하나로 다음 토큰을 예측하는 Bigram 모델 구현, Cross-Entropy, 역전파, 학습 및 텍스트 생성
- Query·Key·Value를 이용한 Single-Head Self-Attention 구현
- Token Embedding과 Position Embedding 결합
- Multi-Head Attention 구현
- Feed-Forward Network 구현
- Residual Connection과 LayerNorm 추가
- Dropout을 적용한 Transformer Block 완성
- Transformer Block 여러 층 쌓기
- Final LayerNorm과 LM Head를 연결해 Decoder-only GPT 완성
- 최종 모델 학습·검증·생성
1. 실행 환경 확인
이번 실습은 Shakespeare 문자 데이터를 사용해 작은 decoder-only Transformer를 직접 구현한다. Colab에서는 CUDA를, Mac에서는 MPS를 사용한다.
1
2
3
4
5
6
7
8
9
10
import torch

if torch.cuda.is_available():
    device = "cuda"  # colab에서는 cuda사용.
elif torch.backends.mps.is_available():
    device = "mps"
else:
    device = "cpu"

print(device)
2. input.txt 읽기와 문자 단위 토큰화
이 실습에서는 단어 대신 문자 하나를 토큰 하나로 사용한다. (!!실제로는 토큰은 문자로 이루어진 단어로 구성된다)
1
2
3
4
5
6
7
8
9
10
11
12
13
with open("input.txt", "r", encoding="utf-8") as f:
    text = f.read()

chars = sorted(set(text))
vocab_size = len(chars) #65

stoi = {ch: i for i, ch in enumerate(chars)}
itos = {i: ch for i, ch in enumerate(chars)}

encode = lambda s: [stoi[ch] for ch in s]
decode = lambda ids: "".join(itos[i] for i in ids)

data = torch.tensor(encode(text), dtype=torch.long)
encode()는 문자를 정수 ID로 바꾸고, decode()는 다시 문자열로 복원한다. !!!!여기서 encode/decode라는 이름은 아까 나중에 설명한다던, Transformer Encoder/Decoder와 관계없는 단순 변환 함수다!!!
e.g)
1
2
3
4
5
print(encode("hello"))
-> [46, 43, 50, 50, 53]

print(decode(encode("hello")))
-> hello
3. Train/Validation 분리와 배치 생성
데이터 앞 90%는 학습에, 뒤 10%는 검증에 사용한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
n = int(0.9 * len(data))
train_data = data[:n]
val_data = data[n:]

batch_size = 32 # 총 문장을 32개를 무작위로 고른다.
block_size = 8 # 한 문장당 8개의 연속적인 문자들을 가지고 학습한다. 그렇지 않으면 메모리 투머치.

def get_batch(split):
    source = train_data if split == "train" else val_data
    ix = torch.randint(len(source) - block_size, (batch_size,))

    x = torch.stack([source[i:i + block_size] for i in ix])
    y = torch.stack([source[i + 1:i + block_size + 1] for i in ix])

    return x.to(device), y.to(device)
x와 y는 한 칸씩 어긋나 있다.
1
2
x: h e l l o
y: e l l o ...
따라서 x의 모든 위치에서 바로 다음 문자가 정답이 된다.
4. Bigram: 현재 토큰 하나로 다음 토큰 예측, cross entropy
가장 단순한 모델은 Bigram 모델이다. 가장 심플하다. 현재 문자 하나만 보고 다음 문자의 점수를 출력하는 것 e.g) Hello → H 만 보고 e 예측, e → l, l → l ….
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
class BigramLanguageModel(nn.Module):
    def __init__(self, vocab_size):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):
        logits = self.token_embedding_table(idx)  # (B, T, C)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            logits, loss = self(idx)

            # 마지막 글자가 예측한 점수만 가져오기
            logits = logits[:, -1, :]  # (B, C) = (4, 65)

            # 점수를 확률로 변환
            probs = F.softmax(logits, dim=-1)

            # 확률에 따라 다음 글자 번호 선택
            idx_next = torch.multinomial(probs, num_samples=1)  # (B, 1)

            # 기존 글자 뒤에 새 글자 붙이기
            idx = torch.cat((idx, idx_next), dim=1)  # (B, T+1)

        return idx


model = BigramLanguageModel(vocab_size).to(device)
idx.shape = (B,T)라면 출력은 (B,T,vocab_size)다. 모든 위치마다 다음 문자 후보 전체의 logit, 즉 확률로 변환되기 전 점수가 나온다. Bigram의 한계는 block_size=8이어도 각 위치가 다른 위치를 보지 못한다는 점이다.
학습과 문자 생성
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)

batch_size = 32

for steps in range(10000):
  xb, yb = get_batch("train")

  logits, loss = model(xb,yb)

  optimizer.zero_grad(set_to_none=True)
  loss.backward()
  optimizer.step()

  if steps % 1000 == 0:
    print(f"step: {steps}, loss: {loss.item()}")
생성할 때는 하나 zero - tensor부터시작해서 max token 까지 만들어간다.
1
2
3
4
5
context = torch.zeros((1,1), dtype = torch.long, device = device)

generated = model.generate(context, max_new_tokens=100)

print(decode(generated[0].cpu().tolist()))
1
2
3
4
5
6
7
8
9
##결과.

WAbust RIUSE:


Anveabae; IOn hequ thitan nu tonm TESCOThe y, d.
Sl!
HAUSHA y IE:
ARBu ar wholers e
→ 당연히 구린다. 왜냐하면, 이전 문맥을 학습하지않고, 그냥 이전 단어 하나만 가지고 다음꺼를 예측했으니 이상한게 당연하다.
5. Query·Key·Value를 이용한 Single-Head Self-Attention 구현
따라서, 이전 문맥을 반영하는 드디어 Attention 그 중에서 self-attention으로 아이디어를 옮기게 된 것이다.
B: 동시에 처리하는 문장 수T: 문장당 토큰 수C: 토큰 하나를 표현하는 특징값 수
목표는 각 토큰이 자기 자신과 이전 토큰의 정보를 갖게 하는 것이다. 즉, Attention은 어떤 토큰을 얼마나 참고할지 학습한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
B, T, C = 4, 8, 32
x = torch.randn(B, T, C, device=device)

# head size는 어텐션이 뽑아낼 의미의 차원수라고 생각하면된다. latent space 차원 수.
head_size = 16

key = nn.Linear(C, head_size, bias=False).to(device)
query = nn.Linear(C, head_size, bias=False).to(device)
value = nn.Linear(C, head_size, bias=False).to(device)

k = key(x)       # (B,T,head_size)
q = query(x)     # (B,T,head_size)
v = value(x)     # (B,T,head_size)

wei = q @ k.transpose(-2, -1)       # (B,T,T)

# sqrt(head size)로 나누어주는 이유는 분포를 정규분포로 맞추기 위해서이다.
wei = wei * k.shape[-1] ** -0.5

# 이부분은 masking을 left triangle matrix를 곱해서 맞춰주는데, 그 이유는 과거정보만 가지고 다음것을 예측하도록
# 미래 토큰을 못보도록 가려버리는 거임.
wei = wei.masked_fill(tril[:T, :T] == 0, float("-inf"))
wei = F.softmax(wei, dim=-1)

out = wei @ v                       # (B,T,head_size)
위 로직을 이후에 재사용할 수 있도록 하나의 Head 클래스로 묶는다. + dropout을 추가한다. 딥러닝 시간에 배웠을 것이다. 과적합을 피하기위해서 임의로 특정 퍼센트의 weight를 학습할때 꺼버리는 장치이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
dropout = 0.2
class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer(
            "tril",
            torch.tril(torch.ones(block_size, block_size))
        )
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)
        q = self.query(x)
        v = self.value(x)

        wei = q @ k.transpose(-2, -1) * k.shape[-1] ** -0.5
        wei = wei.masked_fill(
            self.tril[:T, :T] == 0,
            float("-inf")
        )
        wei = F.softmax(wei, dim=-1)
        wei = self.dropout(wei)

        return wei @ v
register_buffer()는 tril을 학습 파라미터로 만들지 않으면서 모델과 함께 GPU/MPS로 이동시킨다.
Query: 현재 토큰이 어떤 정보를 찾는가?Key: 각 토큰이 어떤 정보를 가지고 있는가?Value: 선택되었을 때 실제로 전달할 정보는 무엇인가?
Attention의 핵심식은 다시, 다음과 같다.
\[\operatorname{Attention}(Q,K,V)=\operatorname{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]sqrt(head_size)로 나누는 이유는 내적 차원이 커질수록 점수가 커져 Softmax가 한쪽으로 포화되는 것을 막기 위해서다. (정규분포로 맞추는 것)
“자 여기까지가 지금 single head with self-attention을 다루었다. 여기까지 아주 잘 했고, 이제 정말 NanoGPT를 만들어볼 것이다. 다시 토큰 embedding부터 시작해서 들어가보자.”
6. Token Embedding과 Position Embedding
다시 우리는 3가지 흐름을 기억해야한다. 학습을 시키기 위해서는 벡터 형태로 정보들을 변환해야하고, 그러기에
- 문자 → 토큰 → 벡터 이렇게 3단계로 이루어진다.
- 문자 → 토큰 by tokenizer
- 토큰 → 벡터 by embedding
여기서 그렇게 문자를 n_embd 차원수의 벡터로 변환하고, 그리고 position 즉 문자의 위치정보 또한 해당 차원수의 벡터로 변환한다.
1
2
3
4
5
6
7
8
9
10
11
12
n_embd = 32

token_embedding_table = nn.Embedding(vocab_size, n_embd)
position_embedding_table = nn.Embedding(block_size, n_embd)

B, T = xb.shape
token_emb = token_embedding_table(xb)          # (B,T,C)
position_emb = position_embedding_table(
    torch.arange(T, device=xb.device)
)                                               # (T,C)

x = token_emb + position_emb                    # (B,T,C)
vocab_size는 데이터가 결정하지만, n_embd는 모델 설계자가 정한다. 각 차원의 의미를 사람이 미리 지정하지는 않는다. 다음 토큰 예측 과정에서 유용한 표현이 학습된다.
7. Multi-Head Attention
여기서 이제 어텐션으로 들어가는데, 재미있는 사실은 하나의 Head만 사용하는 대신 여러 Head가 같은 입력을 서로 다른 관점에서 처리한다. 여기서 Head 각각 Q,K,V 가중치가 다를 것이다. 즉, HEAD마다 토큰사이의 관계가 다르게 학습된다는 것이다.
e.g):
1
The animal didn't cross the street because it was tired.
it을 해석할 때, 다양한 관점에서 해석 할 수 있다.
- 어떤 명사를 가리키는가? →
animal - 문장의 주어는 무엇인가?
- 현재 동작은 무엇인가? →
cross - 원인을 나타내는 부분은 어디인가? →
because - 가까운 토큰과 먼 토큰 중 무엇이 중요한가?
1
2
3
4
5
6
7
8
9
10
11
12
class MultiHeadAttention(nn.Module):
    def __init__(self, num_heads, head_size):
        super().__init__()
        self.heads = nn.ModuleList([
            Head(head_size) for _ in range(num_heads)
        ])
        self.proj = nn.Linear(n_embd, n_embd)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        out = torch.cat([head(x) for head in self.heads], dim=-1)
        return self.dropout(self.proj(out))
n_embd=32, num_heads=4이면 각 Head의 크기는 8이다.
1
4 × (B,T,8) → cat(dim=-1) → (B,T,32)
8. Feed-Forward Network
Attention은 “누구의 정보를 가져올지”를 정하고, Feed-Forward는 “가져온 정보를 어떻게 해석하고 변환할지” 담당한다. → 표현력 담당 이라고 생각하면 된다.
“즉, 이걸 빼면 정보는 섞지만 그걸 가지고 새 특징을 만드는 힘이 확 줄어들어서, 표현력이 약해져 같은 성능을 내려면 더 많은 층이 필요해질 수 있음”
1
2
3
4
5
6
7
8
9
10
11
12
class FeedForward(nn.Module):
    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.ReLU(),
            nn.Linear(4 * n_embd, n_embd),
            nn.Dropout(dropout)
        )

    def forward(self, x):
        return self.net(x)
9. Residual Connection과 LayerNorm
- Residual Connection은 기존 정보에 각 부품이 계산한 변화량을 더한다.
1
2
x = x + self.sa(self.ln1(x))
x = x + self.ffwd(self.ln2(x))
- LayerNorm은 각 토큰이 가진
C개의 특징값을 독립적으로 정규화한다.
여기서 햇갈렸던 점은 Softmax는 Attention 가중치의 합을 1로 만드는 연산이고, LayerNorm은 토큰 내부 특징값의 분포를 안정시키는 연산이다. 서로 대상과 목적이 다르다. 이 구현은 Norm → 연산 → Add 순서인 Pre-Norm 구조를 사용한다.
10. Transformer Block 완성
1
2
3
4
5
6
7
8
9
10
11
12
13
14
class Block(nn.Module):
    def __init__(self, n_embd, n_head):
        super().__init__()
        head_size = n_embd // n_head

        self.sa = MultiHeadAttention(n_head, head_size)
        self.ffwd = FeedForward(n_embd)
        self.ln1 = nn.LayerNorm(n_embd)
        self.ln2 = nn.LayerNorm(n_embd)

    def forward(self, x):
        x = x + self.sa(self.ln1(x))
        x = x + self.ffwd(self.ln2(x))
        return x
11. Transformer Block 여러 층 쌓기
Block 하나가 구조 그림의 N_X 영역 한 층에 해당한다.
1
2
3
4
5
n_layer = 4

blocks = nn.Sequential(
    *[Block(n_embd, n_head) for _ in range(n_layer)]
)
모든 Block의 shape은 (B,T,C)로 같지만 각각 독립적인 학습 파라미터를 가진다.
1
x → Block 1 → Block 2 → Block 3 → Block 4
12. Final LayerNorm과 LM Head 연결
이제 모든 부품을 하나의 decoder-only GPT로 연결한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
class GPTLanguageModel(nn.Module):
    def __init__(self):
        super().__init__()

        # 토큰아이저와 임배딩 인스턴스 정의.
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.position_embedding_table = nn.Embedding(block_size, n_embd)

        #블락 인스턴스 정의.
        self.blocks = nn.Sequential(
            *[Block(n_embd, n_head) for _ in range(n_layer)]
        )

        #인스턴스 정의.
        self.ln_f = nn.LayerNorm(n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        B, T = idx.shape

        token_emb = self.token_embedding_table(idx)
        position_emb = self.position_embedding_table(
            torch.arange(T, device=idx.device)
        )

        x = token_emb + position_emb
        x = self.blocks(x)
        x = self.ln_f(x)
        logits = self.lm_head(x)

        loss = None
        if targets is not None:
            B, T, V = logits.shape
            loss = F.cross_entropy(
                logits.reshape(B * T, V),
                targets.reshape(B * T)
            )

        return logits, loss

    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            idx_cond = idx[:, -block_size:]
            logits, _ = self(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim=1)

        return idx
전체 흐름은 다음과 같다.
1
2
3
4
5
6
문자 ID
→ Token Embedding + Position Embedding
→ Transformer Block × N
→ Final LayerNorm
→ LM Head
→ 다음 문자 전체의 logits
다시말하지만, 이번에 다룬 nanoGPT는 Decoder only Transformer 모델로, 별도의 Encoder와 Cross-Attention이 없다. 이전 토큰들에 대한 Causal Self-Attention만 사용.
13. 최종 학습·검증·생성
1
2
3
4
5
6
7
8
9
10
model = GPTLanguageModel().to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)

for step in range(max_iters):
    xb, yb = get_batch("train")
    _, loss = model(xb, yb)

    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
Mac MPS에서 다음 소형 설정으로 구조 검증 실험을 수행했다.
1
2
3
4
5
6
block_size = 64
n_embd = 128
n_head = 4
n_layer = 4
parameters = 0.82M
training iterations = 1,000
결과:
1
2
3
4
5
초기 train loss: 4.3320
초기 val loss:   4.3306

최종 train loss: 2.0991
최종 val loss:   2.1220
생성 예시:
1
2
3
4
5
I do, it hercaThes ands an, thacom and,
The the saiell sof sour, alin is a a do?

YANGCUSIO:
Nall thord Youe and thy the oquy bou ent ef.
완성된 영어는 아니지만 Bigram보다 단어, 줄바꿈, 등장인물 대사 형태가 나타났다. 이번 실습의 목표는 높은 생성 품질이 아니라 Causal Self-Attention을 사용하는 decoder-only Transformer의 전체 데이터 흐름을 직접 구현하고 확인하는 것이다.
핵심 정리
- Bigram은 현재 토큰 하나만 사용한다.
- Causal Self-Attention은 현재 위치까지의 문맥을 사용한다.
Q,K는 어떤 토큰을 얼마나 참고할지 정한다.V는 실제로 전달할 정보를 담는다.- Multi-Head Attention은 여러 관계를 병렬로 학습한다.
- Feed-Forward는 각 토큰의 정보를 개별적으로 처리한다.
- Residual과 LayerNorm은 깊은 모델의 학습을 안정시킨다.
- LM Head는 최종 특징을 다음 토큰 logits로 변환한다.