Transformer - Step1 Basic concepts
Encoder와 Decoder, Self-Attention과 Cross-Attention, 원래 Transformer와 GPT의 구조 차이를 정리하고, Attention Is All You Need와 BERT 두 논문을 리뷰한다.
Introduction
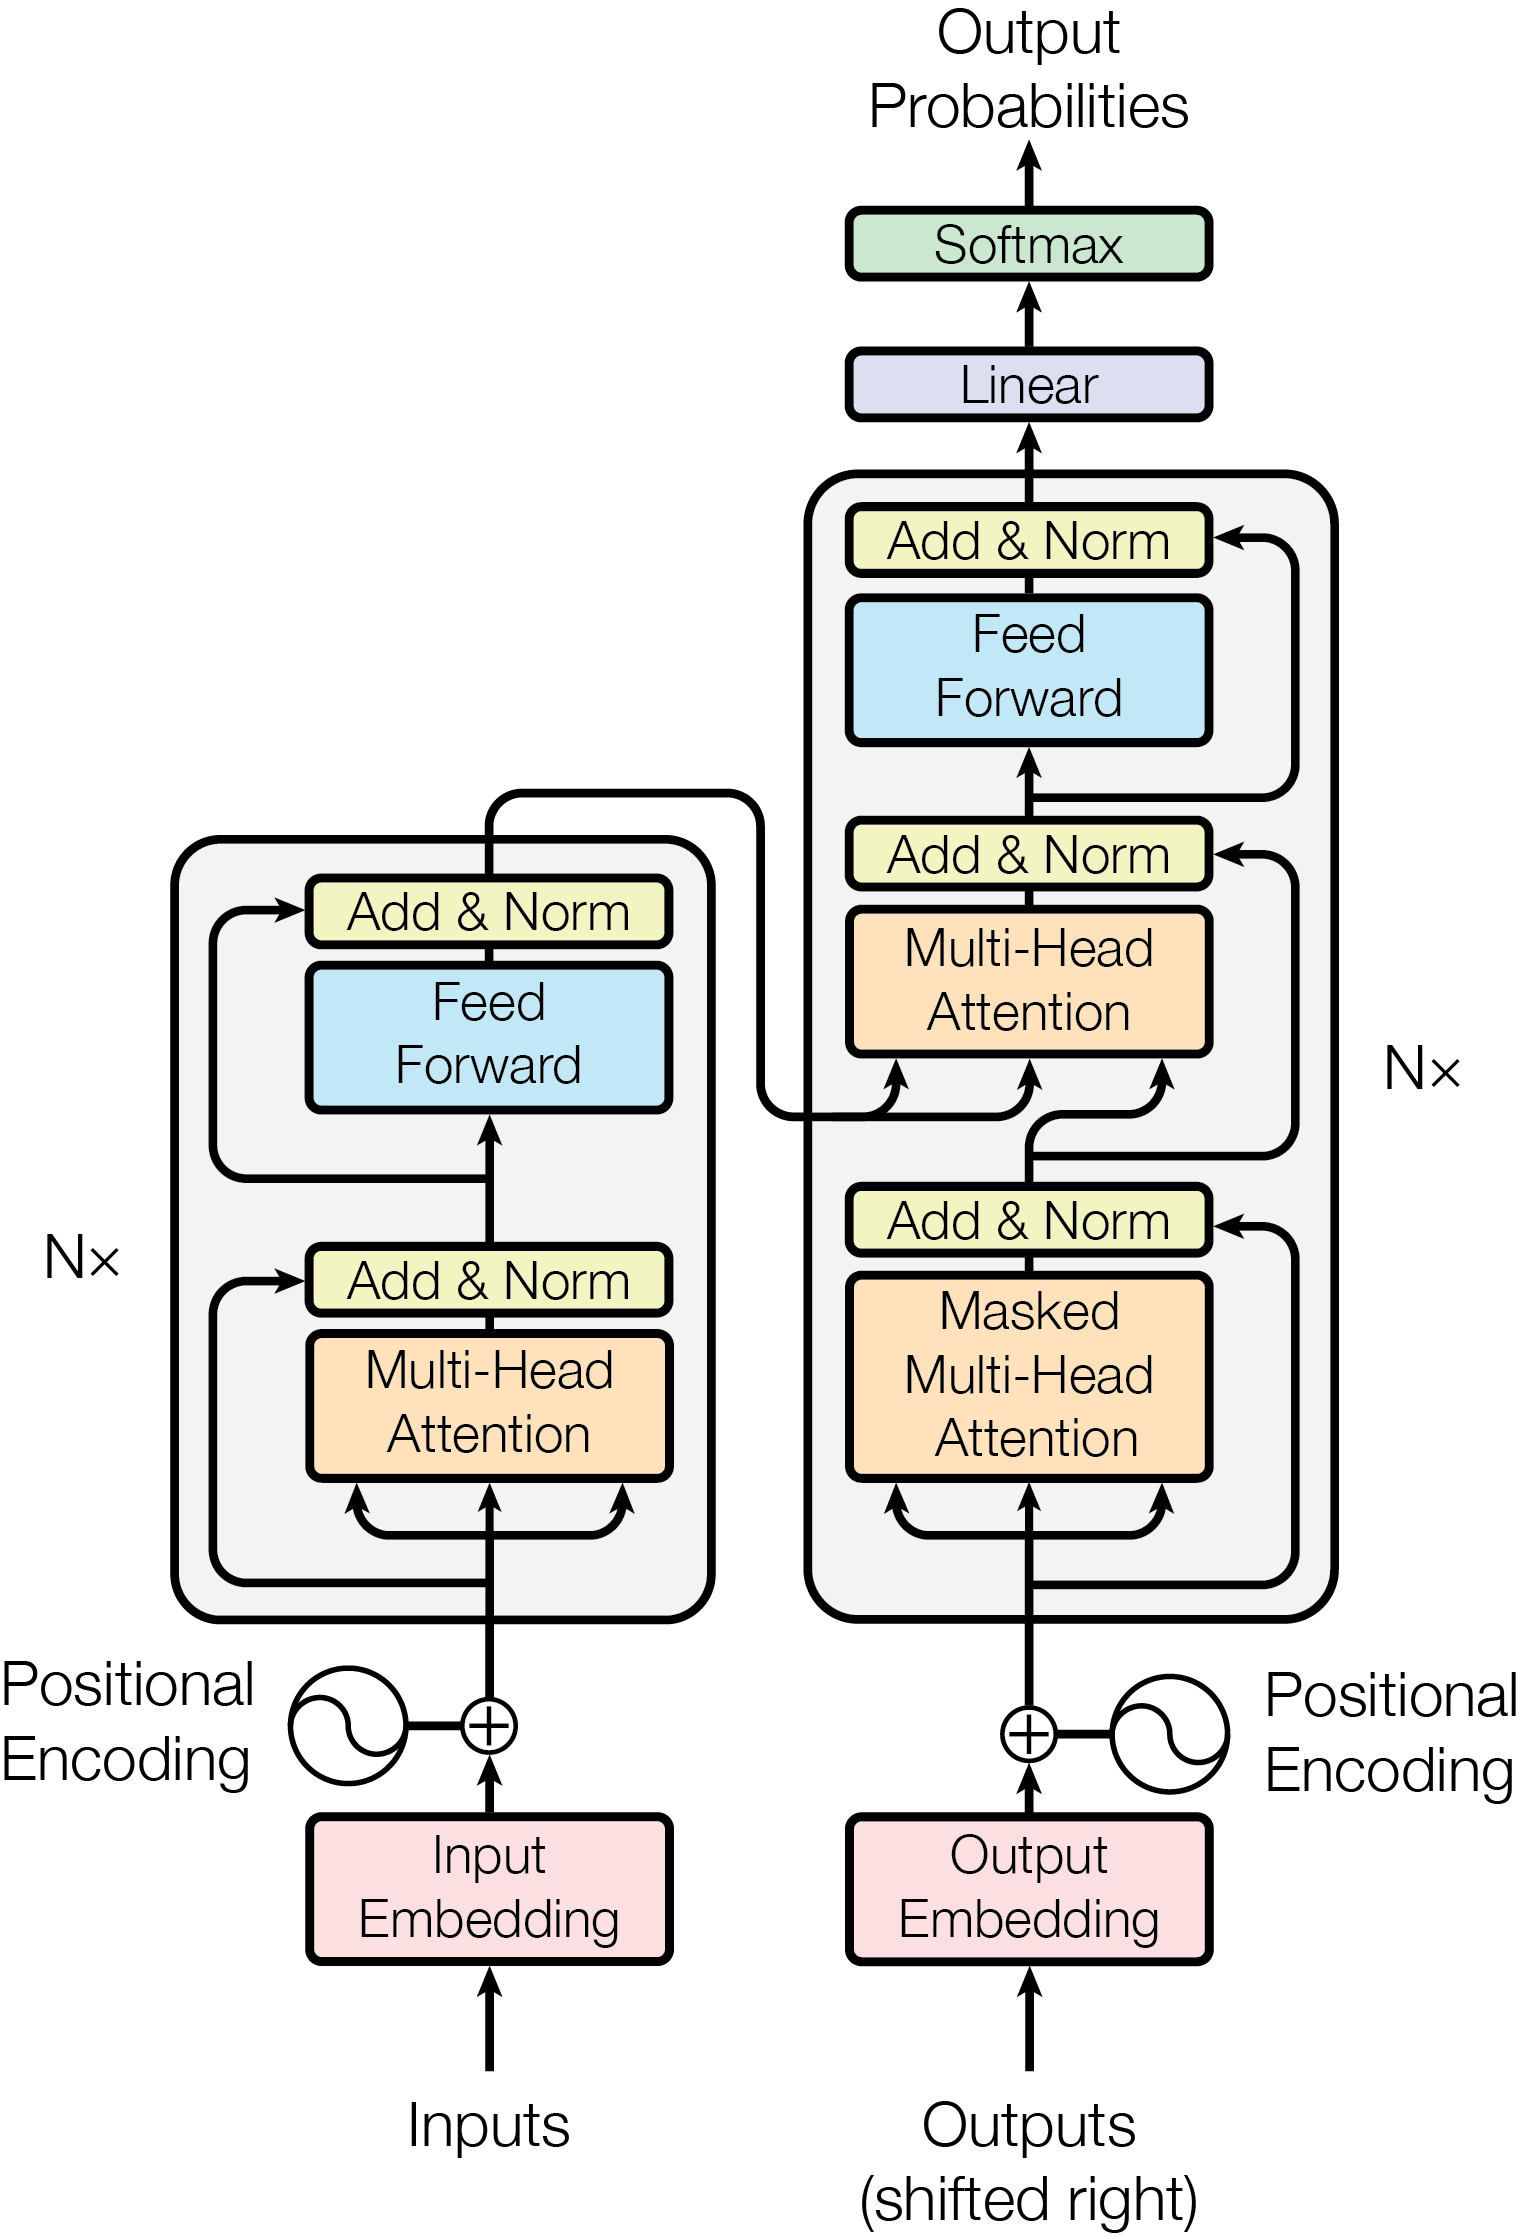
위 사진은 “attention is all u need”라는 유명한 논문의 Figure1 이고, cross - attention 그리고 encoder - decoder transform 이다. 즉 지난시간에 nano-GPT에 대해서 코드를 직접 실습을 진행하였던, decoder only transformer이와 다른 구조이다. 그렇다면 딱 봐도 다른 트랜스포머가 있다는 말인데, 다른 트랜스포머는 무엇일까? 그리고 decoder의 반대인 encoder부는 무엇일까?? 하나하나 질문들을 가지고 살펴보자.
Contents
- Encoder vs Decoder
- Transformer definition
- Self attention vs Cross attention
- Transformer and GPT
- 논문리뷰1 - “Attention is all you need”
- 논문리뷰2 - BERT
1. Encoder와 Decoder는 무엇인가?
Encoder와 Decoder라는 이름은 역할을 기준으로 이해하면 쉽다.
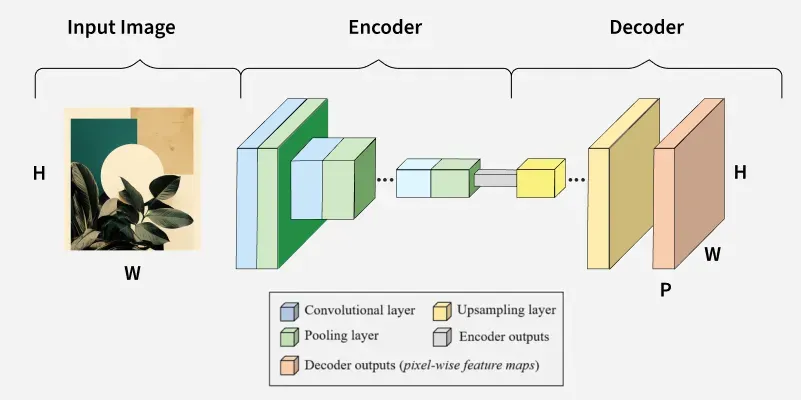 CNN에서의 Encoder → Decoder
Encoder는 입력을 모델이 사용하기 좋은 내부 표현으로 바꾸는 부분이다. 문장, 이미지, 음성과 같은 입력을 받아 중요한 관계와 문맥이 반영된 벡터들로 변환한다. 예를 들어 문장 I love you가 들어오면 Encoder는 각 토큰을 단순히 개별 단어로 두지 않는다. 문장 전체를 참고하여 각 토큰의 의미를 문맥이 담긴 벡터로 바꾼다.
1
2
3
입력 토큰:       I       love      you
                  ↓ Encoder
문맥 표현:       h₁       h₂       h₃
여기서 주의할 점은 Encoder가 항상 정보를 더 작은 하나의 벡터로 압축하는 것은 아니라는 것이다. e.g) 오토인코더에서는 입력을 작은 latent vector로 압축하기도 하지만, Transformer Encoder는 일반적으로 입력 토큰 수를 유지하면서 각 토큰의 표현을 풍부하게 만든다.
Decoder는 주어진 정보와 + 지금까지 생성한 토큰을 이용하여 다음 출력 토큰을 예측하는 부분이다.
1
2
3
4
5
Encoder의 문맥 표현 + 지금까지 생성한 출력 토큰
                         ↓
                      Decoder
                         ↓
                 다음 토큰의 점수
번역을 예로 들면 Decoder는 나는 너를 다음에 올 토큰인 사랑한다 를 예측하고, 새로 생성된 토큰까지 다시 문맥에 포함하여 다음 토큰을 계속 예측한다.
Encoder는 입력을 문맥 표현으로 변환하고, Decoder는 그 표현을 이용해 출력 sequence를 생성한다.
2. Transformer의 정의
Transformer는 단순히 Attention 연산 하나를 뜻하지 않는다. 토큰 벡터를 입력받아 문맥이 반영된 새로운 토큰 벡터로 바꾸는 전체 신경망 구조를 뜻한다.
1
2
3
4
5
6
7
token IDs
   ↓
Embedding + Position information
   ↓
Transformer Blocks × N
   ↓
contextualized token vectors
Transformer Block 하나에는 일반적으로 다음 부품이 들어간다.
- Multi-Head Attention
- Feed-Forward Network
- Residual Connection
- Layer Normalization
- Dropout
💡 즉 Attention은 Transformer를 구성하는 핵심 부품이지만, Attention 하나가 곧 Transformer 전체는 아니다.
또한 Transformer 자체의 출력은 확률일 필요가 없다. Transformer는 기본적으로 다음과 같은 벡터 변환기다.
\[\mathbb{R}^{T \times C} \rightarrow \mathbb{R}^{T \times C}\]여기서 \(T\)는 토큰 수, \(C\)는 토큰 하나의 embedding 차원이다. 이 벡터 뒤에 어떤 출력 Head를 붙이는지에 따라 모델의 목적이 달라진다.
- LM Head를 붙이면 다음 토큰의 logits를 출력한다.
- Classification Head를 붙이면 문장의 class를 예측한다.
- Action Head를 붙이면 로봇의 action을 예측할 수 있다.
3. Self-Attention과 Cross-Attention의 차이
두 Attention의 계산식은 거의 같다.
\[\operatorname{Attention}(Q,K,V) = \operatorname{softmax} \left( \frac{QK^T}{\sqrt{d_k}}\right)V\]차이는 Q, K, V가 어디에서 만들어지는가에 있다.
Self-Attention
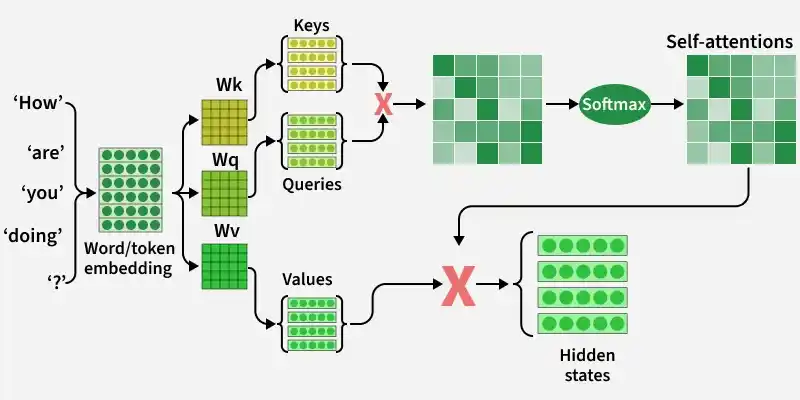
Self-Attention에서는 Q, K, V가 모두 같은 입력 sequence에서 만들어진다.
1
2
3
4
같은 입력 x = "How are you doing ?"
 ├─ Query(x)
 ├─ Key(x)
 └─ Value(x)
따라서 각 토큰이 같은 sequence 안의 다른 토큰을 참고한다. Encoder의 Self-Attention은 보통 입력 전체를 양방향으로 볼 수 있다. 반면 Decoder의 Causal Self-Attention은 미래 토큰을 보면 정답을 미리 아는 것이 되므로 causal mask \(M\)을 사용한다.
1
2
3
4
5
6
Encoder Self-Attention
token₁ ↔ token₂ ↔ token₃ ↔ token₄

Decoder Causal Self-Attention
token₁ ← token₂ ← token₃ ← token₄
각 토큰은 자신과 이전 토큰만 볼 수 있음
Cross-Attention
Cross-Attention에서는 Q와 K, V의 출처가 다르다.
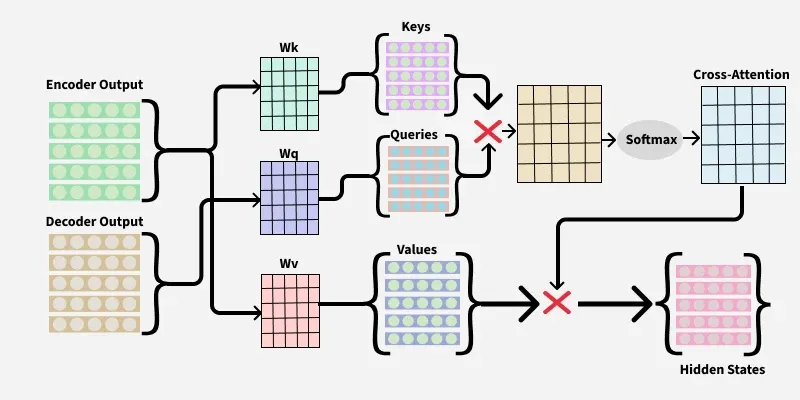
1
2
Decoder hidden state ──→ Q.   e.g) from the previous output token.
Encoder outputs      ──→ K, V e.g) from image
Decoder는 자신의 현재 상태를 Query로 사용해 Encoder 출력 중 어떤 정보가 필요한지 찾는다. 번역 과정에서 Decoder가 다음 한국어 단어를 생성할 때, 현재 Query와 관련 있는 영어 입력 토큰에 높은 Attention weight를 줄 수 있다.
| 구분 | Query | Key, Value | 역할 | 나만의 언어 |
|---|---|---|---|---|
| Self-Attention | 현재 sequence | 같은 sequence | sequence 내부의 관계 파악 | 정답을 자기자신에게서 찾는다. |
| Cross-Attention | Decoder | Encoder 출력 | 다른 입력 표현에서 필요한 정보 검색 | 정답을 다른 곳에서찾는다. |
4. 원래 Transformer와 GPT의 구조
《Attention Is All You Need》에서 제시된 원래 Transformer는 Encoder와 Decoder를 모두 사용하는 구조다.
1
2
3
4
5
6
7
입력 문장
   ↓
Encoder
   ↓  K, V
Decoder ← Q + 이전 출력 토큰
   ↓
다음 토큰
Decoder 안에는 두 종류의 Attention이 존재한다.
- Causal Self-Attention: 지금까지 생성한 출력 토큰끼리 정보를 섞는다.
- Cross-Attention: Encoder가 만든 입력 표현을 참고한다.
반면 nanoGPT는 Decoder-only Transformer다. 별도의 Encoder와 Cross-Attention 없이, 입력과 출력을 하나의 긴 token sequence로 연결한다.
1
2
3
4
5
[사용자 질문 토큰] [지금까지 생성한 답변 토큰]
                       ↓
          Causal Self-Attention
                       ↓
                 다음 토큰 예측
예를 들어 다음 sequence 전체를 GPT에 넣는다.
1
2
User: 중력이 뭐야?
Assistant: 중력은 질량을 가진
모델은 이 전체 토큰을 causal self-attention으로 처리하고 다음 토큰을 예측한다. 질문 토큰이 생성될 답변보다 앞에 있으므로, 답변 토큰은 causal mask를 지키면서도 질문 전체를 참고할 수 있다.
원래 Transformer는 Encoder + Decoder + Cross-Attention 구조이고, GPT는 Causal Self-Attention을 사용하는 Decoder-only Transformer다.
구조를 한 번에 비교하기
| 구조 | 주요 Attention | 대표적인 용도 |
|---|---|---|
| Encoder-only | 양방향 Self-Attention | 입력 이해, 분류, 표현 추출 |
| Encoder–Decoder | Encoder Self-Attention + Decoder Causal Self-Attention + Cross-Attention | 번역처럼 입력 sequence를 다른 출력 sequence로 변환 |
| Decoder-only | Causal Self-Attention | 다음 토큰 예측과 autoregressive 생성 |
정리하면 모델의 구조를 볼 때는 먼저 다음 세 가지를 확인하면 된다.
- 입력을 별도의 Encoder가 처리하는가?
- Decoder가 Encoder 출력에 Cross-Attention을 수행하는가?
- 모든 정보를 하나의 sequence로 연결하여 Causal Self-Attention만 사용하는가?
전체 햇갈리는 포인트들 overview
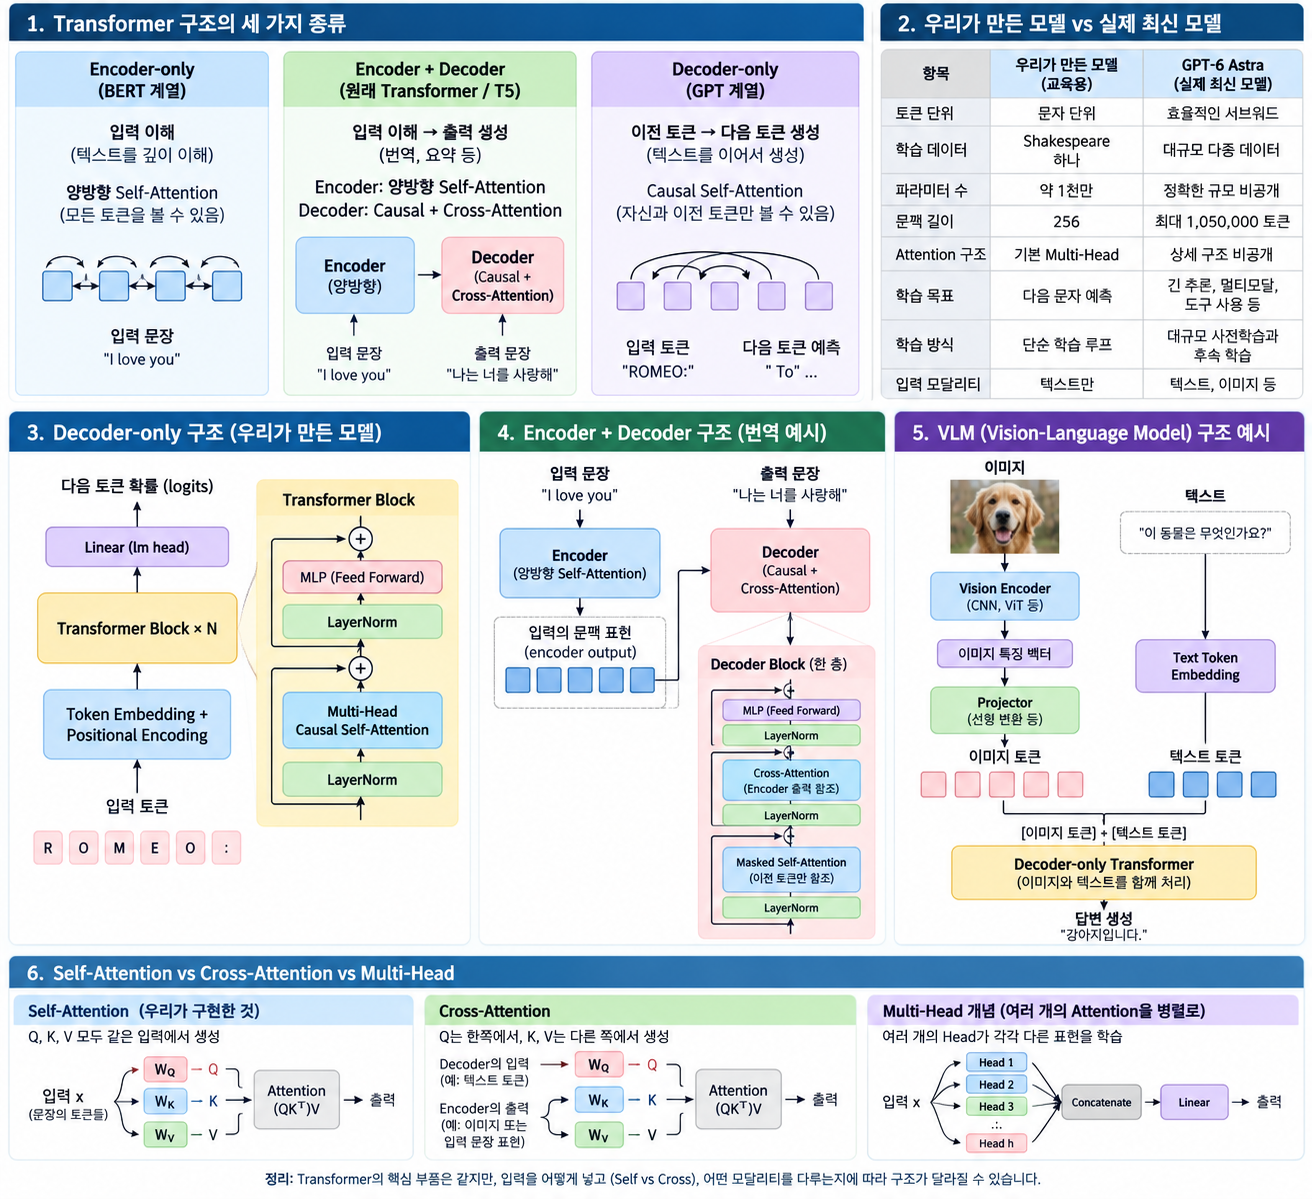
(자 그러면 지금 위에서 배운 기본 개념들을 머리에 넣은채로, 논문리뷰를 2개만 진행해보자)
5. 논문리뷰1 - Attention is all you need
- 구조: Encoder–Decoder Transformer
- 볼 부분: Figure 1, Encoder/Decoder Stack, 세 종류의 Attention
5.1 Architecture
- 구조: Encoder–Decoder Transformer
- 원문: Attention Is All You Need
- 입력 문장을 Encoder가 읽고, Decoder가 출력 토큰을 한 개씩 생성한다.
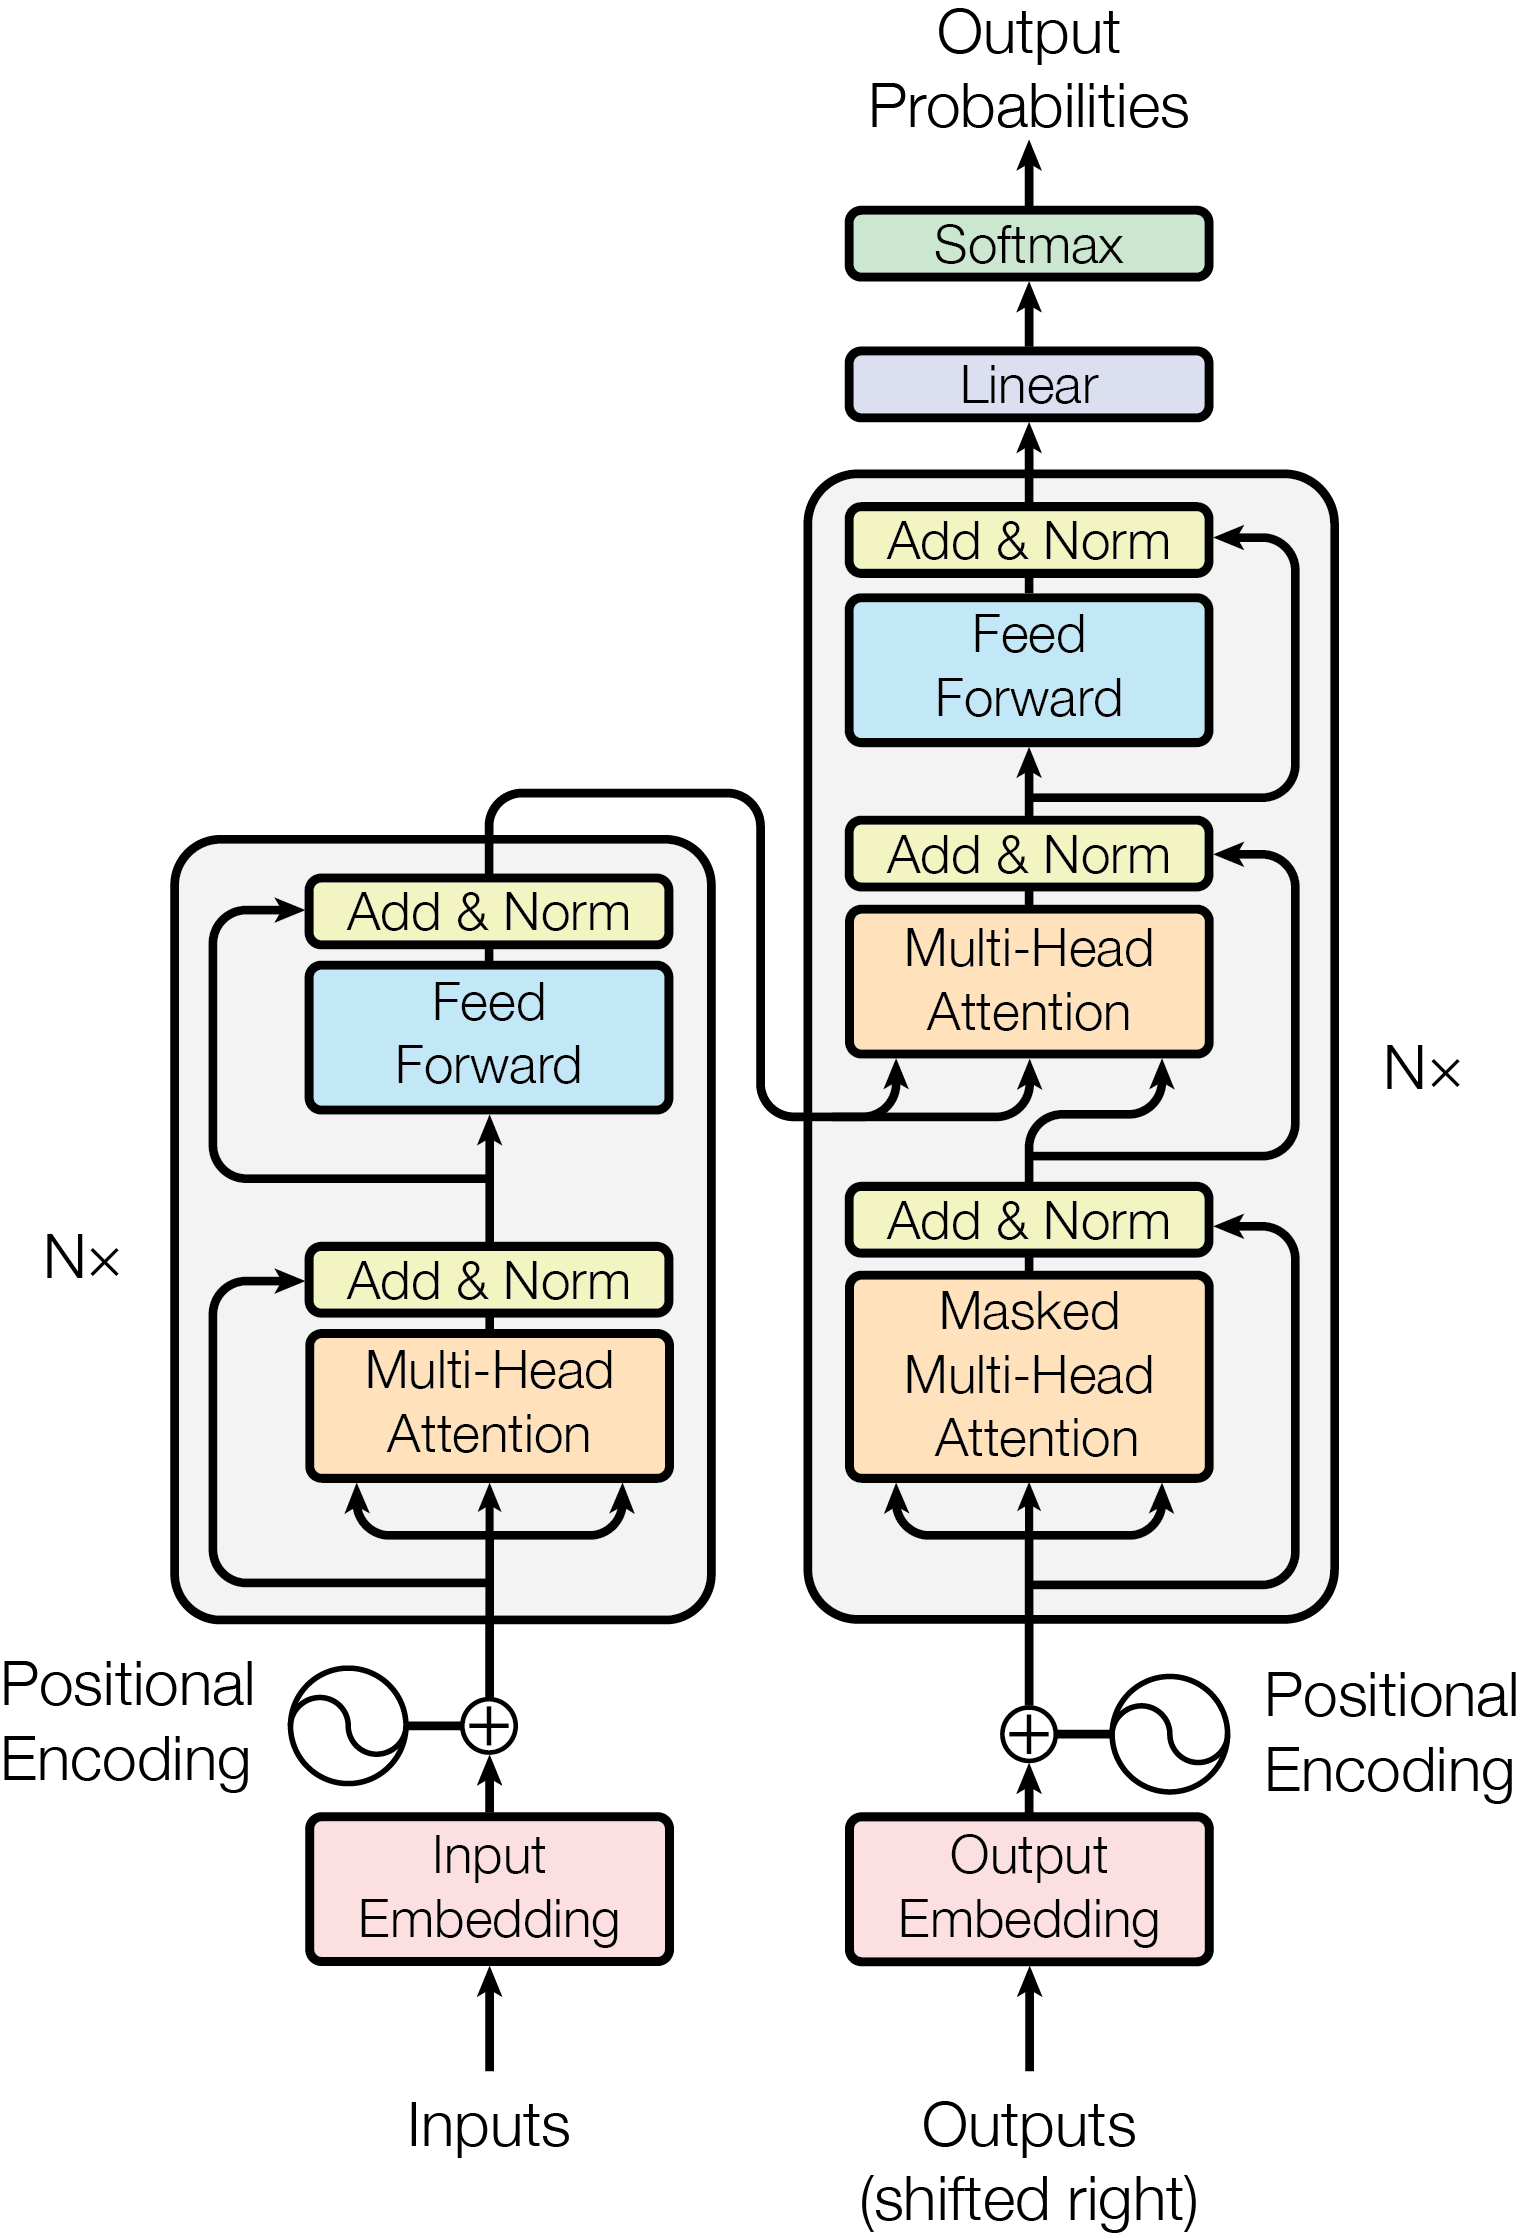
5.2 Encoder and Decoder
Encoder는 Multi-Head Self-Attention → Add & Norm → FFN → Add & Norm 묶음이 6개 쌓인 구조, Decoder는 Masked Multi-Head Self-Attention → Add & Norm → Cross-Attention → Add & Norm → FFN → Add & Norm 묶음이 6개 쌓인 구조 이다. (각 Decoder Layer의 Cross-Attention은 같은 Encoder 최종 출력을 Key와 Value로 받는다. 다만 Decoder의 현재 표현인 Query는 Layer마다 달라지므로, 같은 입력 문장도 각 층에서 다르게 참고할 수 있다.)
- Add & Norm: 하위 층의 출력에 원래 입력을 더하는 Residual Connection을 적용한 뒤 Layer Normalization 한다. Softmax를 정규화하는 단계는 아니다.
- FFN: Attention을 거친 각 토큰 벡터를 독립적으로
확장 → 비선형 활성화 → 축소하는 작은 신경망이다. - Attention은 토큰 사이의 정보를 섞고, FFN은 각 토큰의 정보를 비선형적으로 가공한다.
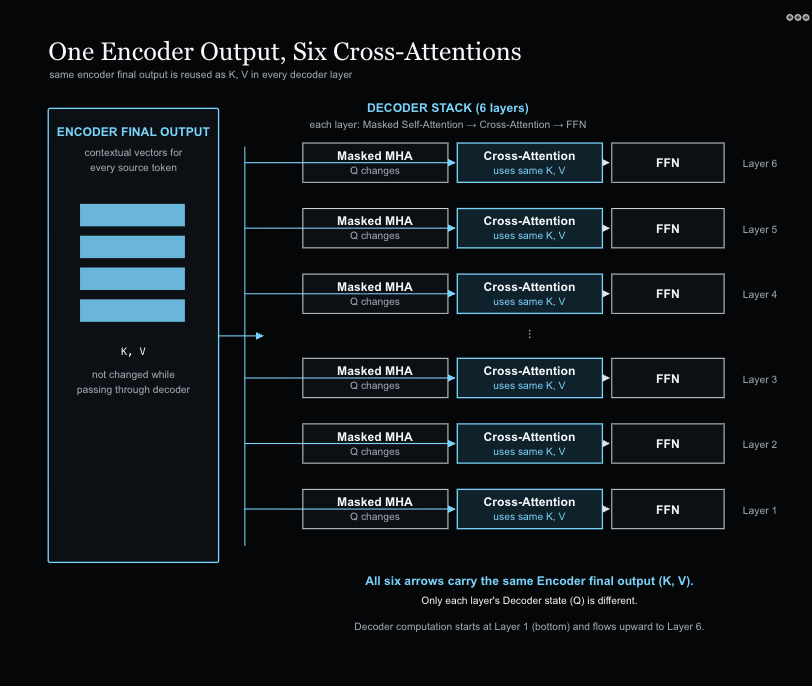
정확히 짚고 넘어가야하는게 Encoder Block, Decoder Block 6개라고 한다. 여기서, Encoder Block 6개는 직렬로 통과하고 나온 결과가 이제 Decoder block 각각에 있는 Cross Attention (MHA) 내부에 K, V 에 들어가게 된다. 이 부분은 Cross Attention 의 개념을 지난시간에 이해했다면, 바로 잡을 수 있다.
5.3 Attention Structure
Single-Head Scaled Dot-Product Attention의 핵심 계산은 다음과 같다.
\[\mathrm{Attention}(Q,K,V)=\mathrm{softmax}(QK^T / \sqrt{d_k})V\]1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# Self-Attention
k = key(x)
q = query(x)
v = value(x)
# MatMul
wei = q @ k.transpose(-2, -1)
# Scale
wei = wei * head_size**-0.5 # divide by sqrt(d_k)
# Mask
wei = wei.masked_fill(tril == 0, float("-inf"))
# Softmax
wei = F.softmax(wei, dim=-1)
# Matmul
out = wei @ v
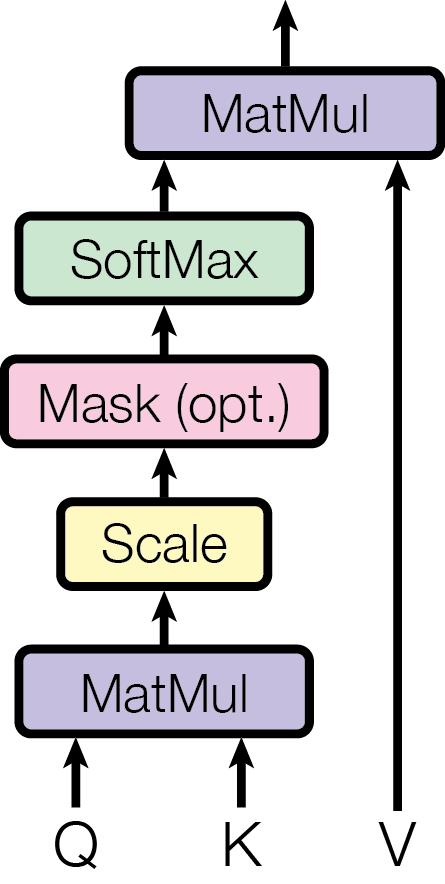
Decoder의 Masked Self-Attention에서는 Softmax 전에 미래 토큰 위치를 -inf로 가려, 현재 위치가 미래 토큰을 볼 수 없게 한다. Cross-Attention에서는 Q가 Decoder에서 오고, K,V가 Encoder 최종 출력에서 온다.
5.4 Multi-Head Attention
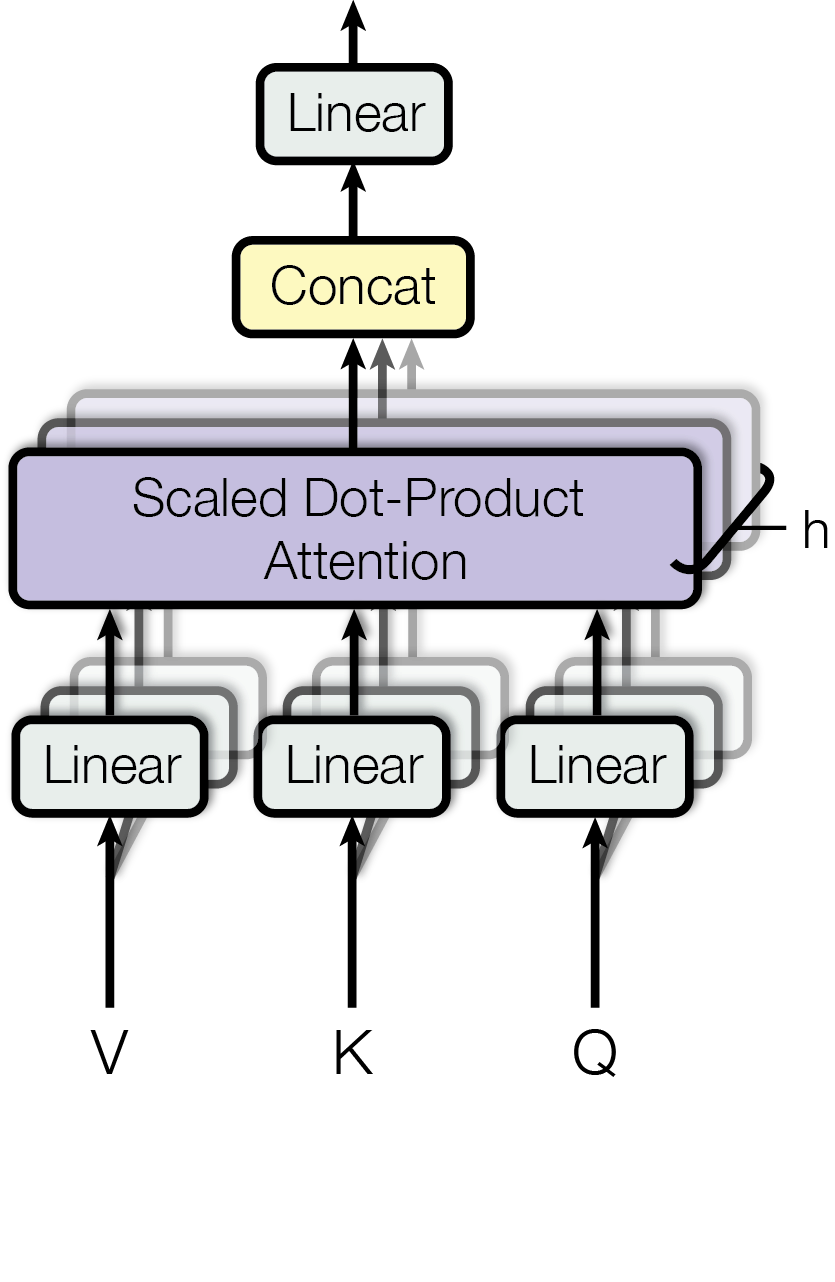
Multi-Head Attention은 Single-Head Attention을 여러 개 병렬로 수행한 뒤 결과를 붙이고 다시 선형변환하는 구조다. 논문의 base model은 h = 8, d_model = 512, d_k = d_v = 64를 쓴다.
즉, 512차원 입력을 각 Head가 64차원 Q, K, V로 투영하고, 8개 Head의 64차원 출력을 이어 다시 512차원으로 만든다.
5.5 Positional Encoding
Self-Attention만으로는 토큰의 순서를 알 수 없다. 그래서 각 토큰의 embedding에 위치 정보 벡터를 더한다.
\[PE(pos,2i)=\sin(pos / 10000^{2i/d_{model}})\] \[PE(pos,2i+1)=\cos(pos / 10000^{2i/d_{model}})\]Sinusoidal encoding은 차원마다 서로 다른 파장의 sin/cos 패턴을 사용해 각 위치를 구별하고, 두 위치의 상대적 거리 관계도 표현할 수 있다. 또 별도 학습 파라미터 없이 더 긴 위치에도 식을 적용할 수 있다. 원 논문은 학습형 위치 임베딩과 성능이 비슷했지만, 학습 때보다 긴 문장에도 일반화할 가능성 때문에 sinusoidal 방식을 선택했다. 현대 Transformer는 학습형 positional embedding, RoPE처럼 다른 위치 표현도 자주 사용한다.
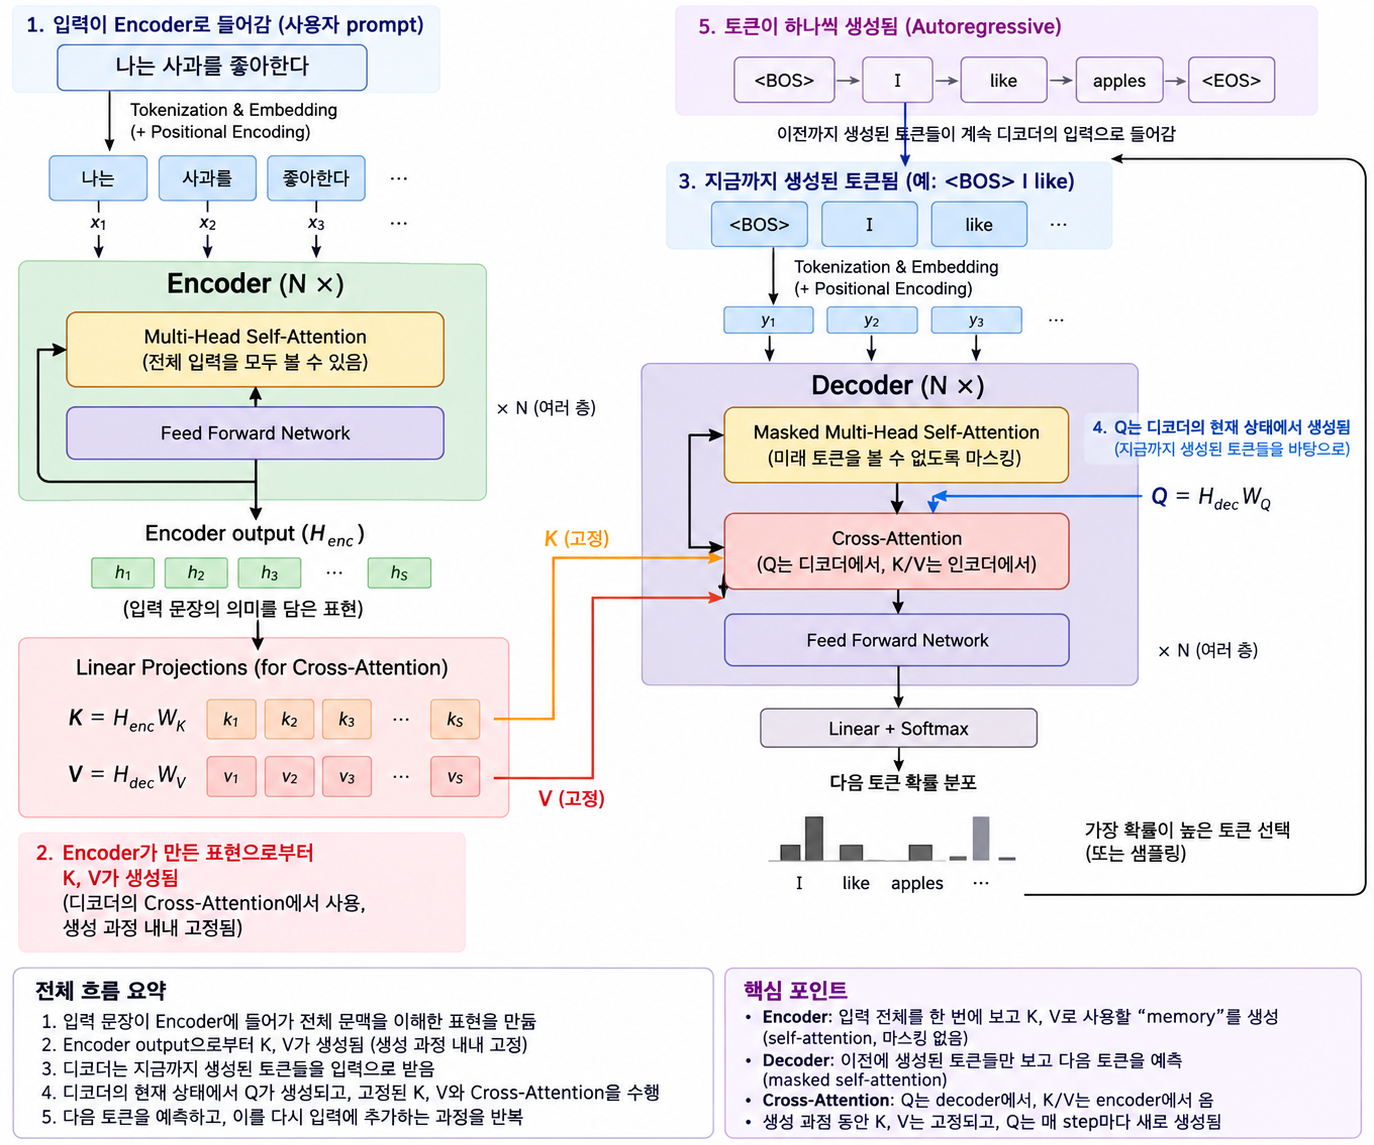
“최종적으로 process를 이해해보자”
🚧 → 사용자의 요쳥 prompt → K,V로 전환 (encoder)
→ 토큰이 하나씩 생성되면 쌓고 쌓아서 Decoder → Q로 전환
→ Cross attention 으로 다음 토큰 예측.
6. 논문리뷰2 - BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
- 구조: Encoder-only Transformer
- 원문: BERT
읽을때 가질 질문.
- 기존이랑 뭐가 다른가.
- 양방향 Self-Attention은 어떤 토큰을 볼 수 있는가?
- 입력 표현은 Token, Segment, Position embedding을 어떻게 결합하는가?
- Masked Language Modeling은 무엇을 예측하는가?
6.1 Motivation
기존 GPT는 왼쪽에서 오른쪽으로 다음 토큰을 예측하기 때문에, 각 토큰이 왼쪽 문맥만 볼 수 있었다. 이 방식은 문장 생성에는 자연스럽지만, 질문 답변·개체명 인식처럼 이미 주어진 문장 전체를 이해해야 하는 작업에서는 오른쪽 문맥을 사용하지 못한다는 한계가 있다. (쉽게 말해 양쪽다 문맥 파악해야한다는 거임) BERT의 ‘학습 방법’ 핵심 아이디어는 다음과 같다.
문장을 생성하는 대신 일부 단어를 가리고, 왼쪽과 오른쪽 문맥을 모두 사용해 가려진 단어를 맞히자.
이를 통해 모든 Encoder Layer에서 양쪽 문맥이 함께 섞이는 Deep Bidirectional Representation을 학습한다.
6.2 Architecture
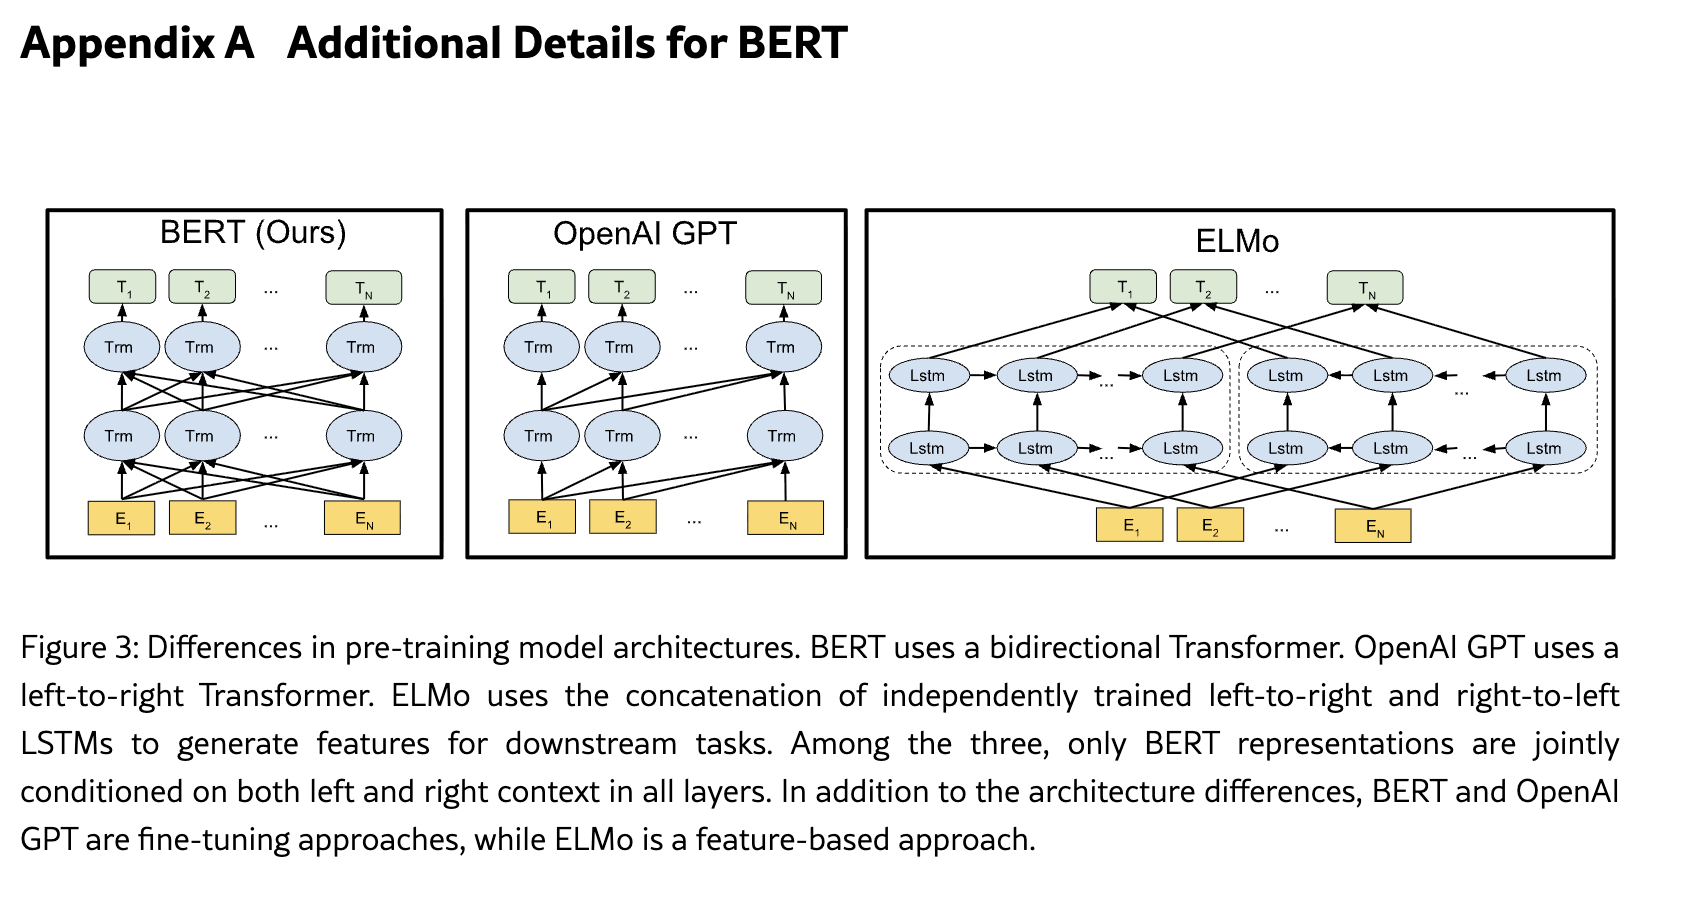
BERT = Transformer에서 Decoder를 떼어버리고, Encoder만 여러 층 쌓은 모델.
이라고 쉽게 이해하면 된다. 위 그림에서 Trm 하나가 Transformer Encoder layer 하나라고 보면 된다. 실제 layer 전체를 그린 것은 아니고 중간은 ...으로 생략했다. BERT-Base = Encoder 12개, BERT-Large = Encoder 24개를 직렬로 쌓은 구조이다. 여기서 GPT와 가장 큰 차이는 Attention을 보는 방향이다. GPT는 causal mask 때문에 현재 token이 이전 token만 볼 수 있지만, BERT는 각 token이 왼쪽 + 오른쪽 token을 모두 볼 수 있다. 그리고 이 양방향 Self-Attention이 모든 Encoder layer에서 반복된다. 즉 쉽게 보면 BERT = Transformer Encoder를 여러 층 쌓고, 모든 layer에서 양방향으로 문맥을 보는 모델이다.
6.3 Input Representation
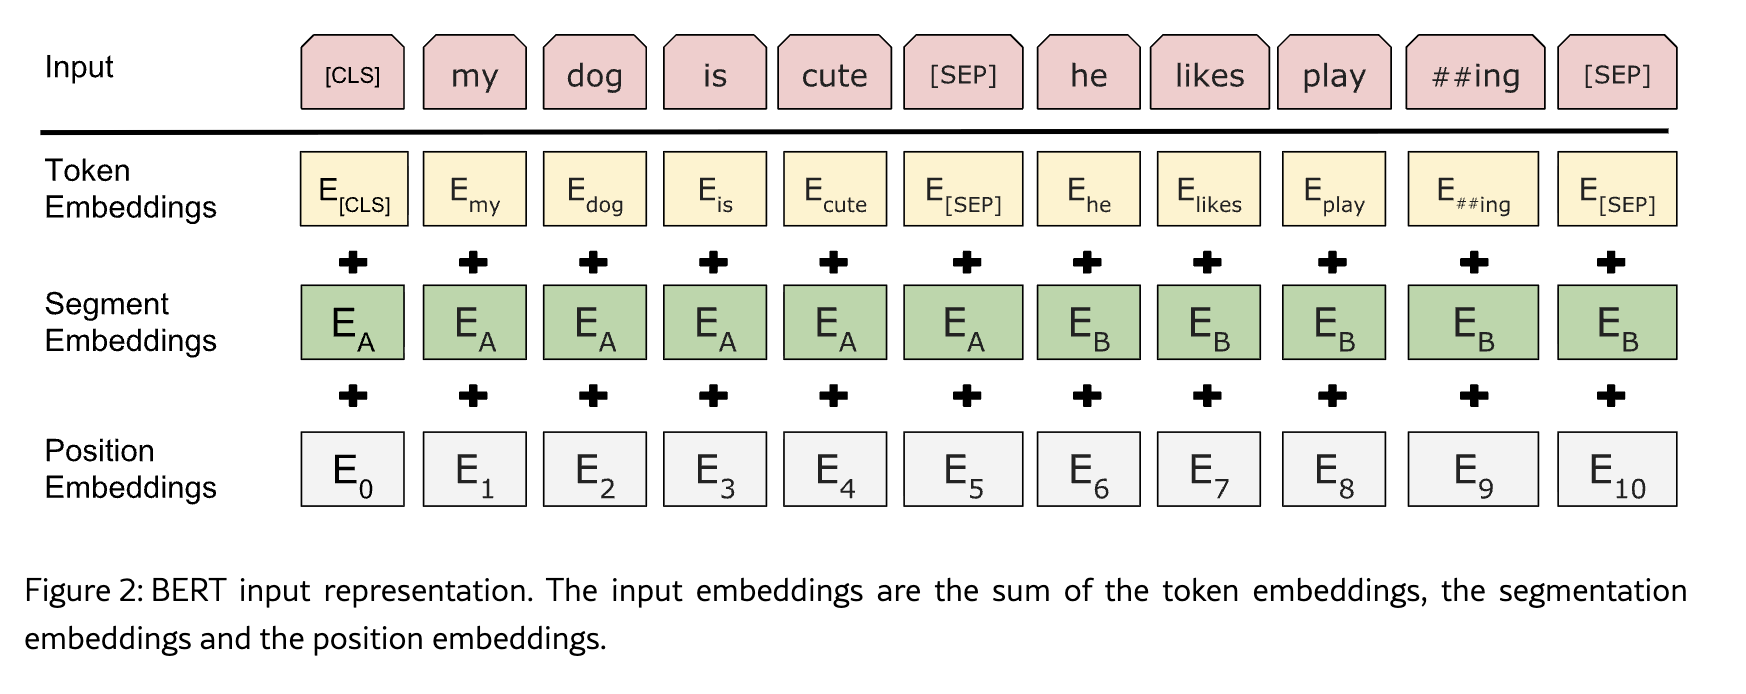
입력 토큰 하나의 최종 embedding은 세 embedding의 합이다. Input Embedding = Token Embedding + Segment Embedding + Position Embedding
- Token Embedding: WordPiece token의 의미. Vocabulary size는 30,000이다.
- Segment Embedding: 해당 토큰이 Sentence A인지 Sentence B인지 표시한다.
- Position Embedding: 문장 안에서 토큰의 위치를 표시한다.
- [CLS]: 모든 입력의 맨 앞에 붙인다. 최종 출력 C는 문장 전체 분류에 사용한다.
- [SEP]: 문장 A와 문장 B의 경계를 표시한다.
입력 형태: [CLS] Sentence A [SEP] Sentence B [SEP] BERT를 통과한 후 C는 [CLS] 위치의 출력이고, T_i는 각 입력 토큰 위치의 contextual representation이다.
6.4 Masked Language Model
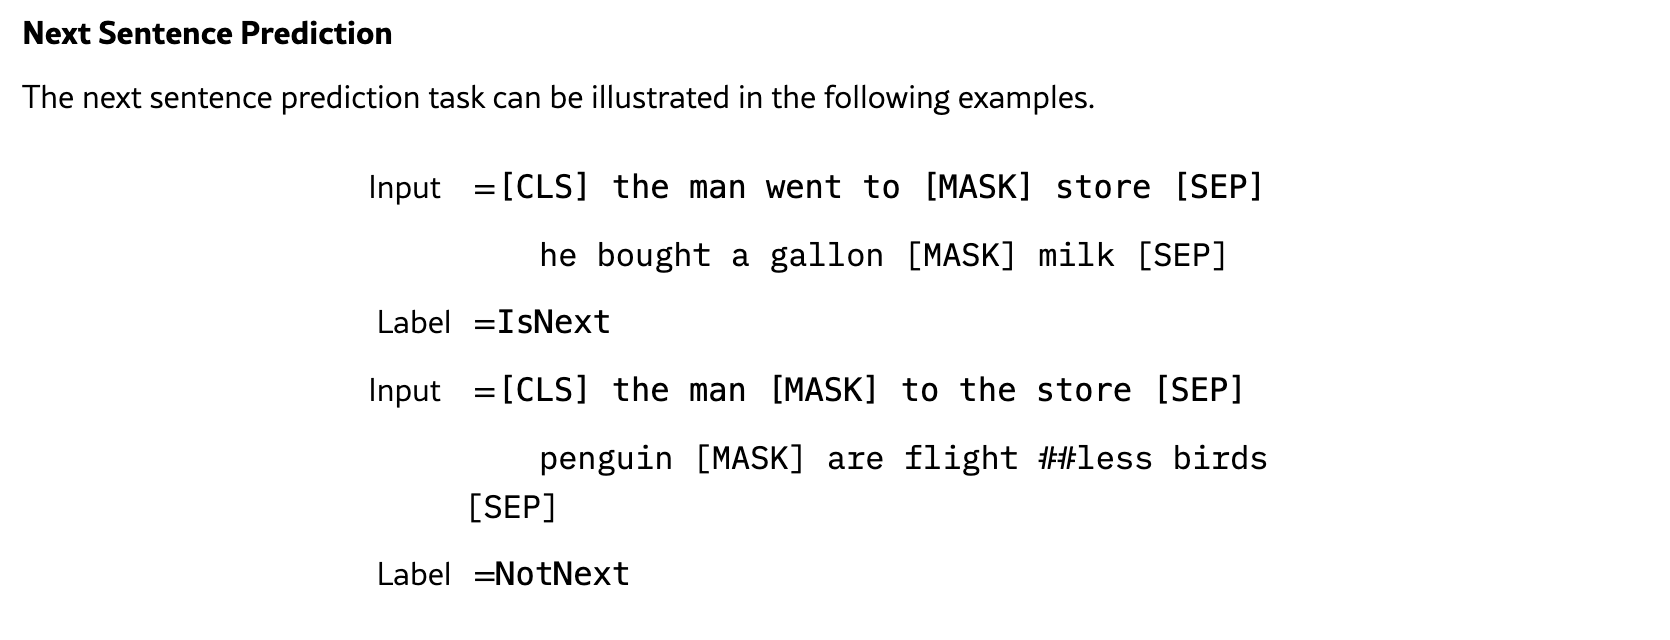
BERT는 GPT처럼 다음 token을 맞히는 방식으로 학습하지 않는다. 그렇게 하면 왼쪽 문맥만 보게 되기 때문이다. 대신 입력 token 일부를 가리고 [MASK]에 원래 어떤 token이 있었는지 맞히도록 학습한다. 예를 들어 the man went to [MASK] store가 들어오면, BERT는 [MASK] 기준으로 왼쪽의 went to뿐만 아니라 오른쪽의 store까지 양쪽 문맥을 동시에 보고 원래 token을 예측한다. 이게 BERT가 Bidirectional하게 학습될 수 있는 핵심이다. 원 논문에서는 token의 15%를 prediction 대상으로 선택한다. 선택된 token은 80% → [MASK], 10% → random token, 10% → 그대로 유지하여 원래 token을 맞히게 한다. 그리고 아래 그림에는 MLM과 함께 BERT의 두 번째 pre-training task인 NSP(Next Sentence Prediction)도 같이 보인다. 문장 A와 B를 [SEP]로 나누어 넣고, B가 실제로 A 다음에 오는 문장인지 IsNext / NotNext로 맞히는 방식이다.
💡 MLM = 가려진 단어 맞히기 / NSP = 두 문장이 실제로 이어지는지 맞히기