
Transformer Step4 Multimodal Transformer
이미지와 텍스트가 Transformer 안에서 어떤 토큰으로 바뀌고 어떤 Attention으로 만나는지, ViT·Flamingo·LLaVA를 텐서 디멘션 단위로 따라가며 비교한다.
이미지와 텍스트가 Transformer 안에서 어떤 토큰으로 바뀌고 어떤 Attention으로 연결되는지 살펴본다.
핵심 질문
이미지 특징과 텍스트 토큰은 Cross-Attention으로 만나는가, 하나의 sequence 안에서 Self-Attention으로 만나는가?
목차
- ViT: 이미지를 Patch Token으로 변환
- Flamingo: Vision Encoder와 Cross-Attention
- LLaVA: Projector와 Image Token
- Gemini: 대규모 멀티모달 Transformer
- Cross-Attention 방식과 Unified-token 방식 비교
- VLM에서 VLA로 연결하기
리뷰할 논문
- An Image is Worth 16x16 Words: Vision Transformer
- Flamingo: a Visual Language Model for Few-Shot Learning
- Visual Instruction Tuning — LLaVA
- Gemini: A Family of Highly Capable Multimodal Models
- Gemini 1.5
논문마다 확인할 항목
- 이미지를 누가 Encoder하는가?
- 이미지 특징을 어떤 크기의 token sequence로 바꾸는가?
- modality가 Self-Attention 또는 Cross-Attention 중 어디에서 섞이는가?
- 출력 Head는 텍스트, 분류 결과, action 중 무엇인가?
Gemini 기술 보고서는 공개되어 있지만 재현 가능한 전체 내부 구조와 학습 구현이 모두 공개된 것은 아니다. 공개된 내용과 추정은 구분해서 읽는다.
1. ViT - Vision Transformer
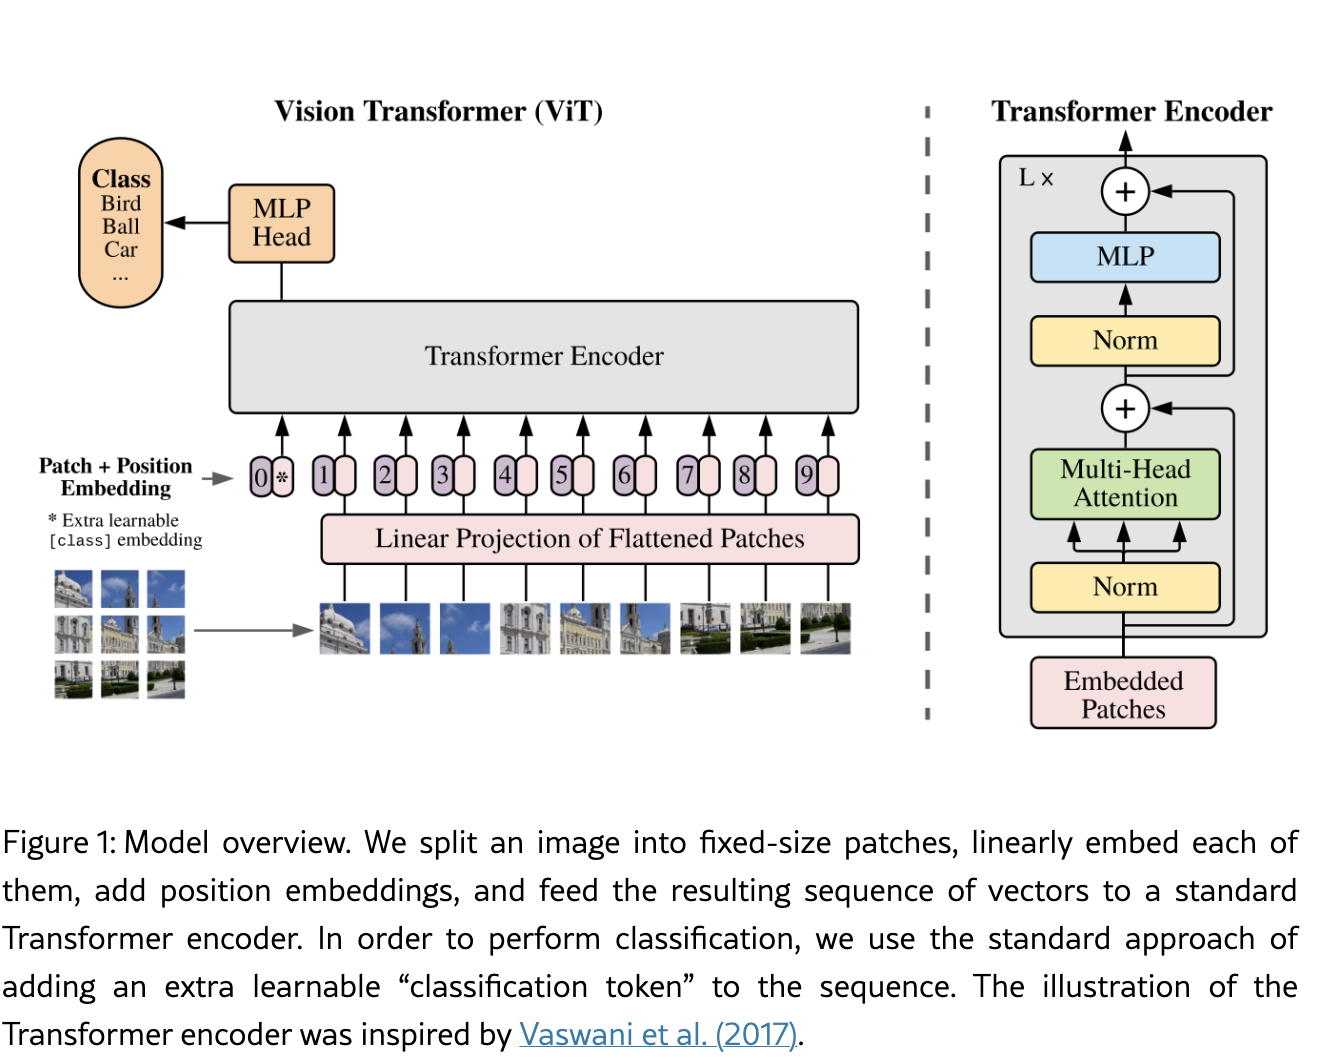
비전 트랜스포머의 목적 자체는 간단하다 사진을 트랜스포머가 ‘인지’하는 용도이다. 가장 기본적인 구조는 위 논문 구조이고 다음과 같다. 참고로 그림 맨 앞의 0*, 캡션의 “extra learnable classification token”.
- Patch로 쪼개기 — 224×224를 16×16 패치로 → 196개
- Linear Projection — 각 패치 flatten(16×16×3 = 768) → D차원 벡터
- [CLS] 토큰 prepend — 학습 가능한 벡터 1개 → 196 + 1 = 197개 토큰
- Position Embedding — 197개 전부에 더함
- Transformer Encoder × L — MHA + MLP
- Output — 마지막 레이어의 [CLS] 자리 벡터 하나만 뽑아 → MLP Head → 클래스 로짓
Q 마지막에 Classification으로 사용하네? 즉, output이 하나이네?
핵심은 197개 중 CLS 하나만 분류에 쓴다는 것. 나머지 196개는 버린다. CLS가 self-attention을 통해 모든 패치 정보를 빨아들이는 구조라서 가능한 것.
Q 아니 nanoGPT에서 Decoder Transformer에는 FFN이었는데??
MLP(Multi Layer Perceptron) = FFN (같은 것) Linear(D → 4D) → GELU → Linear(4D → D)
- Vaswani 원논문: “Position-wise Feed-Forward Network”
- ViT 논문: “MLP contains two layers with a GELU non-linearity”
토큰마다 독립적으로(position-wise) 적용되는 2층 MLP. 원논문 FFN도 정확히는 MLP이고, 비전 쪽에서 MLP라 부르는 관습 차이일 뿐. 실질적 차이는 활성함수 ReLU → GELU 정도. 주의 — 그림에 MLP가 두 개 나온다:
| 위치 | 정체 | 역할 |
|---|---|---|
| 인코더 블록 안 MLP | = FFN | 블록 내부, L번 반복 |
| 왼쪽 위 MLP Head | 분류기 | 맨 끝 한 번. CLS → 클래스 로짓 |
Q 정규화를 MHA 이후에 했었는데, nanoGPT는 근데 여기는 미리하네?? → Pre-LN
그림을 보면 Norm → MHA → + 순서다. 원 Transformer는 MHA → + → Norm(Post-LN)인데 ViT는 Pre-LN. 깊게 쌓을 때 학습이 안정되어 요즘은 대부분 이 방식이다. 기존의 CNN처럼 우리가 patching하는 작업을 진행하지 않아도, Transformer기반으로 해도 분류가 가능하다 라는 점을 시사함.
Q 최종 결과물은?
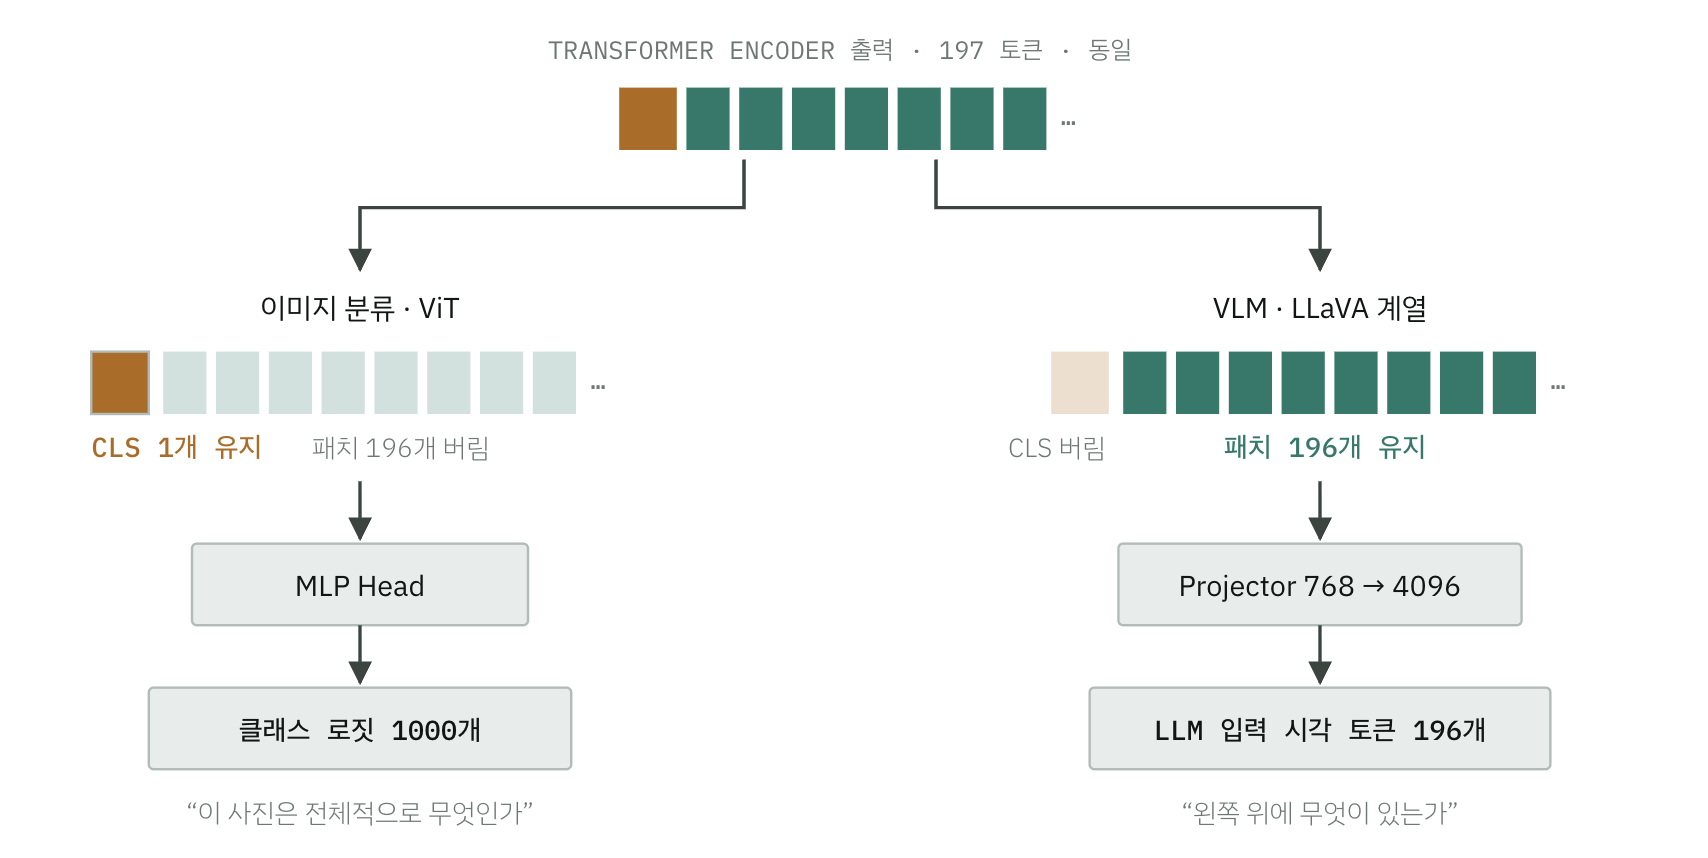
학습할때 [CLS] 라는 Extra Learning token에 대해서 봤을 것이다. 여기서, 이 토큰은 196개의 이미지 토큰과 함께 학습에 들어가 총 197개의 백터로 임베딩이 된다. 학습이 끝나고 트렌스포머를 나와도 197개의 토큰이며, 여기서 CLS는 이미지의 의미들에 의해 채워지게 된다. 따라서 최종 결과의 맨앞 CLS는 “이미지가 어떤 이미지인지 분류문제에 사용되며” 나머지 196개 는 “다음 토큰의 값으로 사용되는 것이다” 꽤 재미있다. 그러니까 학습이 되면서 비어있던 CLS가 채워지는 거다. 어떻게 이런 구조를 생각햇을까. 분류와 토큰예측을 둘다 할 수 있는.
참고 — ViT의 디멘션 (같은 눈으로 다시 보기)
1
2
3
4
5
6
7
8
9
10
11
이미지        [3, 224, 224]
  ↓ Conv2d(3, 768, k=16, s=16)  = 쪼개기 + projection 동시에
패치 토큰      [196, 768]
  ↓ CLS prepend + position embedding
입력          [197, 768]
  ↓ Encoder × 12   (모든 층이 [197,768] → [197,768])
출력          [197, 768]
  ↓ token[0]만 슬라이싱
CLS          [1, 768]
  ↓ MLP Head [768, 1000]
로짓          [1, 1000]
여기서도 [197, 768]이 12층 내내 그대로다. 마지막에 [1, 768]로 줄어드는 건 층이 바꾼 게 아니라 우리가 한 줄만 골라낸 것이다.
2. Flamingo
핵심: 플래밍고의 핵심은 이미지와 텍스트를 하나의 cross attention으로 맥락을 파악해 다음 토큰을 예측한다는 점이다.
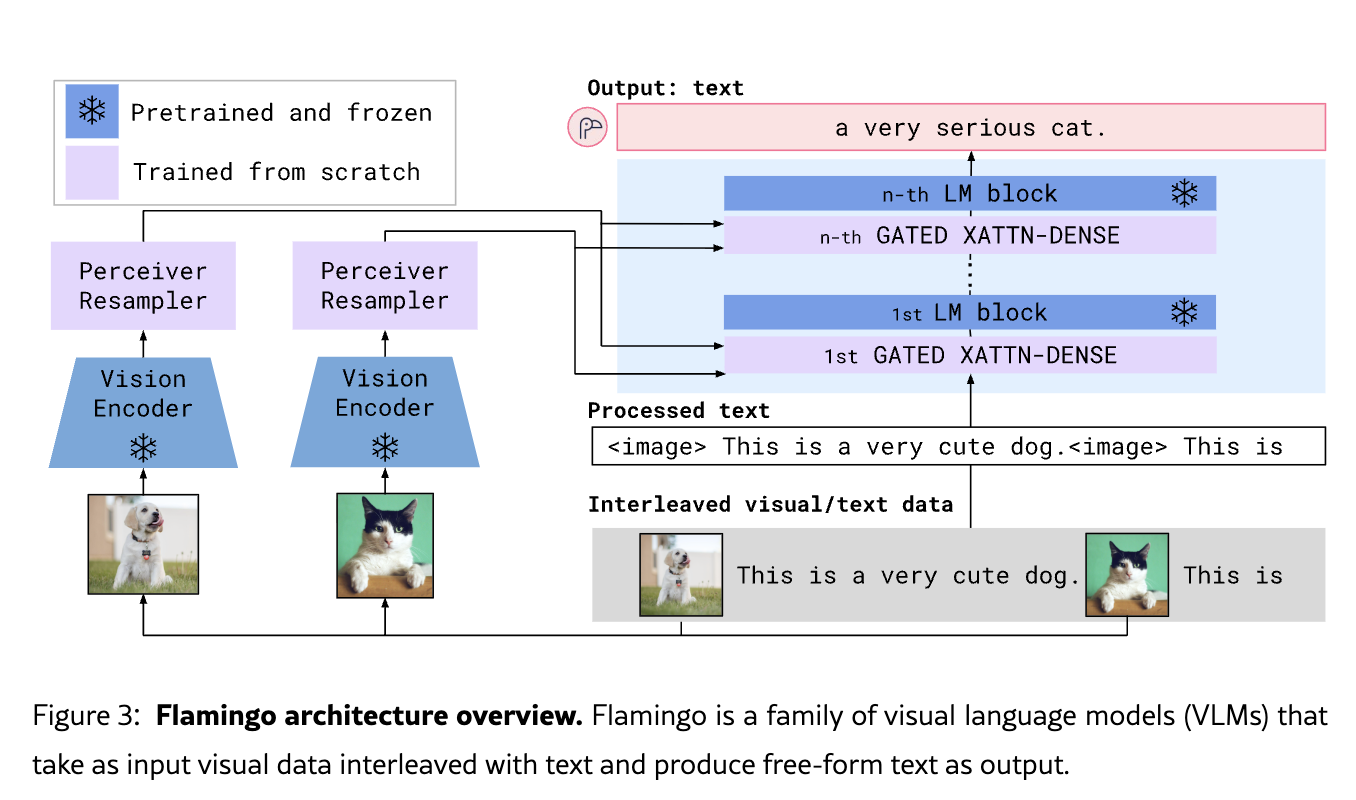
전체 구조는 위와 같다. 여기서, 우리의 목적은
강아지 , 고양이사진 + 텍스트 → 텍스트
이다.
하나하나 부품을 살펴보자.
Step1 Image → Token
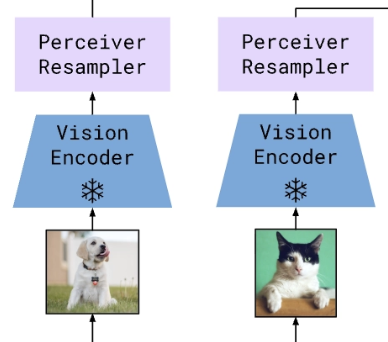
여기서, 우리는 image를 각각 Vision Encoder를 활용하여, 우리가 원하는 차원수의 벡터 형태로 embedding과정 까지 진행한다.
| 결정하는 것 | 결과 | |
|---|---|---|
| Vision Encoder | 각 벡터의 차원 d | d는 고정. 근데 개수 N은 가변 (이미지 크기따라서) |
| Perceiver Resampler | 벡터의 개수 | 64개로 고정. vector : x라고 정의하자 |
즉, 우리가 이후에 cross-attention을 위해서 64개의 벡터로 뽑아주어야하고, 그 작업을 Perceiver resampler가 진행한다. 간단하게 트렌스포머에 넣을러면 특정 크기의 벡터로 바꿔야하고, 그 작업을 한다고 이해하면 된다.
Step2 Cross Attention
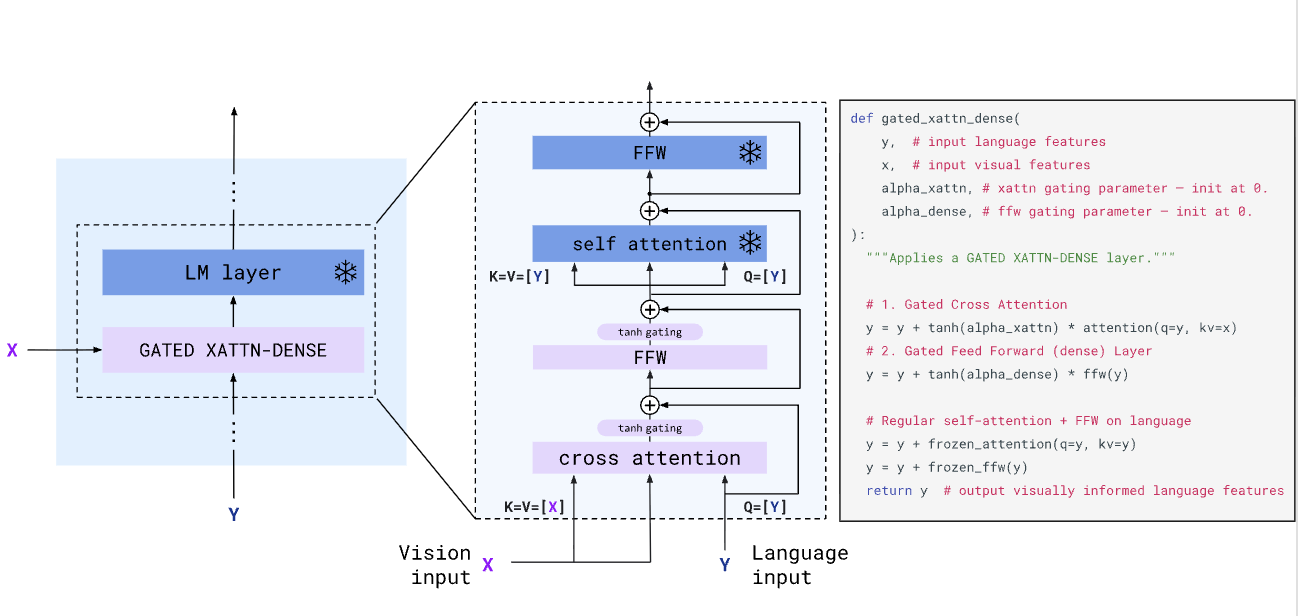
여기서, 재미있는 사실은 이제 사진의 인코더 결과: x가 이제 K,V 로 들어가게 되고, 그리고 텍스트가 Query로 들어가게 되는 구조이다. 이후에 Self attention, FFW 층을 거치는게 하나의 MHA Block 이다. 여기서 햇갈리기 쉽기 때문에 마지막 토큰이 나올때까지, 들어오고 나가는 텐서의 디멘션을 점검해보자.
텐서 디멘션 점검 — 입력부터 마지막 토큰까지
기호 약속 (배치 B는 생략)
| 기호 | 뜻 | 예시 값 | 가변? |
|---|---|---|---|
N | 이미지 장수 | 2 | 가변 (입력이 정함) |
S | vision encoder가 뱉는 feature 개수 | 수백 | 가변 (해상도·프레임 수) |
R | Resampler 출력 토큰 수 | 64 (논문 값) | 고정 |
T | 텍스트 토큰 개수 | 20 | 가변 (문장 길이) |
d_v | visual 토큰 하나의 차원 (vision 쪽) | 1536 (예시) | 고정 (설계값) |
d | LM의 hidden 차원 (language 쪽) | 2048 (예시) | 고정 (설계값) |
h | attention 헤드 수 | 16 (예시) | 고정 |
d_head | d / h | 128 | 고정 |
V | vocabulary 크기 | 32000 (예시) | 고정 |
step1. 이미지 → Vision Encoder → Perceiver Resampler
1
2
3
4
5
이미지 1장  [3 (RGB), 224, 224]
   ↓ Vision Encoder (NFNet)
[S, d_v]        ← S = 가변! 수백 개 = IMAGE FEATURE LATNET DIMENSION
   ↓ Perceiver Resampler        ★ 여기서 S → 64
[64, d_v]       ← 이제 고정 트랜스포머에서 text token를 위해서 64개로 맞춰줌
step2. 텍스트 → LM Embedding
1
2
3
4
5
token ids   [T]        = [20]
  ↓ embedding lookup
Y           [T, d]     = [20, 2048]

#d는 텍스트 임배딩의 차원수이다. 이미지랑 다른게 이 FLamingo의 핵심임.
step3. Cross attention
1
2
3
4
5
6
7
8
9
10
11
12
13
X = [64, d_v] # image 토큰
Y = [20, d] # text 토큰

K = X @ W_K -> [64, d_v] @ [d_v, d_head] -> [64, d_head]
V = X @ W_V -> [64, d_v] @ [d_v, d_head] -> [64, d_head]
Q = Y @ W_X -> [20, d. ] @ [d. , d_head] -> [20, d_head]


scores = Q @ Kᵀ / √d_head        [20, 64]
   ↓ softmax (가로 방향으로)        [20, 64]   각 행의 합 = 1
   ↓ @ V                         [20, 64] @ [64, d_head] → [20, d_head]
   ↓ 헤드 h개 concat               [20, d_head × h] = [20, d]
   ↓ @ W_O                       [20, d] @ [d,d] = [20,d]
step4. Multiple blocks and logits
1
2
3
4
5
6
7
8
[블록 1] 4줄 → [블록 2] 4줄 → ... → [블록 n] 4줄
   ↓
y  [20, d]
   ↓ LayerNorm
   ↓ lm_head  [d, V]
logits  [20, 32000]
   ↓ 마지막 행만
[1, 32000] → softmax → sampling → 다음 토큰
“hello”를 넣었으면 행 0이 ‘e’를 예측하는데, 우리는 이미 ‘e’가 뭔지 알고 있잖아. 쓸모없음.” → 따라서, 마지막 행만
그리고 이 지점이 LLaVA와 정확히 갈린다.
| 이미지가 sequence 길이에 미치는 영향 | |
|---|---|
| Flamingo (cross-attn) | 없음. y는 계속 [T, d]. 이미지는 옆에서 참조될 뿐 |
| LLaVA (unified token) | 직접 늘림. [T + 576, d]가 됨. 이미지가 아예 sequence의 일부 |
3. LLaVA — Visual Instruction Tuning
핵심: 이미지를 텍스트 토큰인 척 위장시켜 같은 sequence에 꽂는다. Flamingo가 공들여 만든 cross-attention·gating·Resampler가 전부 사라진다.
논문 표기법
수식이 기호로 되어 있어 미리 정리해두면 읽기 쉽다.
| 기호 | 뜻 |
|---|---|
X_v | 입력 이미지 |
g(·) | vision encoder = CLIP ViT-L/14 ❄️ |
Z_v = g(X_v) | vision encoder가 뱉은 grid feature |
W | projection matrix 🔥 — 이 논문의 유일한 새 부품 |
H_v = W · Z_v | LLM 임베딩 공간으로 옮겨진 visual token |
f_φ(·) | LLM = Vicuna, 파라미터 φ |
논문의 식 (1)이 전부다:
1
H_v = W · Z_v,   with  Z_v = g(X_v)
Linear 한 층. Flamingo의 Perceiver Resampler + gated cross-attention 자리에 이것 하나가 들어간다.
Step1. Image → Token
1
2
3
4
5
이미지        [3, 224, 224]
  ↓ CLIP ViT-L/14 (❄️ frozen)
Z_v          [256, 1024]      ← 256 = (224/14)² = 16×16, d_v = 1024
  ↓ W  (🔥 학습)  [1024, 4096]
H_v          [256, 4096]      ← 이제 LM의 d와 같은 차원
- 논문은 grid feature 중 마지막 Transformer 층 앞/뒤 둘 다 실험했다고 밝힌다.
- grid feature = 패치 토큰. ViT의
[CLS]는 쓰지 않는다. 분류가 아니라 “왼쪽 위에 뭐가 있나”까지 답해야 하므로 위치별 정보가 필요하기 때문. → ViT 절의 CLS 논의와 정확히 반대 선택. - 해상도·토큰 수는 논문에 명시가 없다. 위 숫자는 CLIP ViT-L/14 표준 config 기준. (LLaVA-1.5는 336px이라
(336/14)² = 576)
Step2. Sequence에 그냥 꽂는다 — Flamingo와 갈리는 지점
1
2
[ H_v (256개) | 텍스트 토큰 (T개) ]   →  [256 + T, 4096]
        ↑ 같은 sequence. 구분 없음
LLM 입장에서는 “좀 이상하게 생긴 단어 256개”가 문장에 섞여 있을 뿐이다. 그래서:
- cross-attention 층 추가 없음
- gating 없음
- per-image 마스킹 없음 (기존 causal mask 그대로)
- LLM 코드를 한 줄도 고치지 않는다
학습 시퀀스 형식은 논문 Table 2. 식 (2)에 따라 첫 턴에서 이미지가 질문 앞에 올지 뒤에 올지 무작위로 정한다.
1
2
3
X_system-message  <STOP>
Human: X_instruct¹ <STOP>  Assistant: X_a¹ <STOP>
Human: X_instruct² <STOP>  Assistant: X_a² <STOP>  ...
디멘션 추적 (Flamingo와 같은 방식으로)
1
2
3
4
5
6
7
8
9
10
11
이미지 [3,224,224] → CLIP ❄️ → Z_v [256, 1024]
                              ↓ W 🔥
                          H_v [256, 4096]
                              ↓ 텍스트와 concat
                        x  [256+T, 4096]
                              ↓ Vicuna block × N   (self-attention만!)
                           [256+T, 4096]
                              ↓ LayerNorm → lm_head [4096, V]
                     logits [256+T, V]
                              ↓ 마지막 행
                           [1, V] → sampling
Flamingo와 비교하면 차이가 shape 한 줄에 다 있다:
| Flamingo | LLaVA | |
|---|---|---|
| sequence shape | [T, d] 불변 | [T+256, d] 늘어남 |
| 이미지의 역할 | K, V 로만 존재 (Q 없음) | Q, K, V 전부 가짐 |
| 이미지가 텍스트를 보는가 | ✗ 읽히기만 함 | ✓ 서로 본다 |
| attention score | cross [T, 64] • self [T, T] | self [T+256, T+256] 하나 |
| 새 모듈 | Resampler + XATTN 층 | Linear 하나 |
| Vision encoder | NFNet (CNN) ❄️ | CLIP ViT-L/14 ❄️ |
| LLM | ❄️ frozen | 🔥 학습함 (Stage 2) |
| 이미지 장수 ↑ | 비용 거의 불변 | 컨텍스트를 잡아먹음 |
즉 Flamingo는 이미지를 sequence 밖에 두고 관리하는 대가로 장치가 늘고, LLaVA는 안에 넣는 대가로 길이를 낸다. 트레이드오프가 정확히 반대다.
2단계 학습
| 학습 대상 | 데이터 | 목적 | |
|---|---|---|---|
| Stage 1 Feature Alignment | W만 🔥 (vision ❄️, LLM ❄️) | CC3M에서 필터링한 595K 쌍 | H_v를 LLM의 word embedding 공간에 정렬 |
| Stage 2 Fine-tuning End-to-End | W + LLM(φ) 🔥 (vision ❄️) | GPT-4로 생성한 158K instruction 데이터 | 대화·추론 능력 |
논문은 Stage 1을 “frozen LLM을 위한 호환 가능한 visual tokenizer를 학습하는 것”이라고 설명한다. 이 표현이 LLaVA의 관점을 그대로 보여준다 — 이미지를 LLM이 이미 아는 언어로 번역하는 것.
학습 규모: 8×A100. Stage 1은 1 epoch (lr 2e-3, batch 128), Stage 2는 3 epoch (lr 2e-5, batch 32). Flamingo와 비교하면 대단히 가볍다.
논문이 스스로 밝히는 위치
4.1절 끝에서 저자들이 직접 Flamingo와 BLIP-2를 언급한다 — 자기들의 projection이 simple / lightweight하며, gated cross-attention(Flamingo)이나 Q-Former(BLIP-2) 같은 더 정교한 방식도 가능하지만 데이터 중심 실험을 빠르게 돌리기 위해 단순한 쪽을 택했다고. 즉 LLaVA는 “구조를 잘 만들었다”는 논문이 아니다. 구조는 일부러 최소화했고, 진짜 기여는 제목 그대로 Visual Instruction Tuning — GPT-4로 멀티모달 instruction 데이터를 생성한 것.
왜 결국 단순한 쪽이 이겼나
Flamingo가 복잡했던 이유는 “LLM을 건드리면 안 된다”는 전제 때문이다. 2022년에는 LLM 학습이 너무 비쌌고, 잘 학습된 LM 중간에 랜덤 초기화 층을 끼우면 능력이 파괴되니까 gating이 필요했다. 2023년에는 그 전제가 무너졌다. Vicuna 같은 오픈 LLM이 널려 있고 파인튜닝이 감당 가능해지자, LLM을 그냥 학습시키면 되는 일이 되었다. 전제가 사라지자 그 위에 쌓은 구조 전체(Resampler, gating, per-image masking)가 불필요해진 것. → 목차 5번(Cross-Attention vs Unified-token 비교)의 결론.
논문마다 확인할 항목 — LLaVA의 답
- 이미지를 누가 encode하는가? → CLIP ViT-L/14 ❄️
- 어떤 크기의 token sequence로? → 256개 (
(224/14)²), 각 4096차원으로 projection - modality가 어디서 섞이는가? → Self-Attention. 같은 sequence 안에서
- 출력 Head는? → 텍스트 (LM head)