
Transformer Step3 Vision language Model (VLM)
nanoVLM을 바탕으로 Vision Encoder, Projector(pixel shuffle), Text Decoder를 직접 연결해 이미지와 텍스트를 같은 차원의 토큰으로 맞추고, projector만 학습시켜 본 VLM 실습 기록.
일단 실습한내용을 정리하겠다. VLM은 nanoVLM 을 바탕으로 실습을 진행하였다. 일단, 핵심은 image → token, text → token 근데 same dimension으로 맞추는 작업을 진행한다. 그리고 하나의 token으로 결합하고, decoder에 넣어서 다음 토큰을 예측하는 작업을 진행하는 것을 실습해보자.
참고 코드 및 사용 모델
- 코드 출처: Hugging Face nanoVLM
- Vision encoder (ViT): google/siglip2-base-patch16-512
- Language model (LLM): HuggingFaceTB/SmolLM2-360M-Instruct
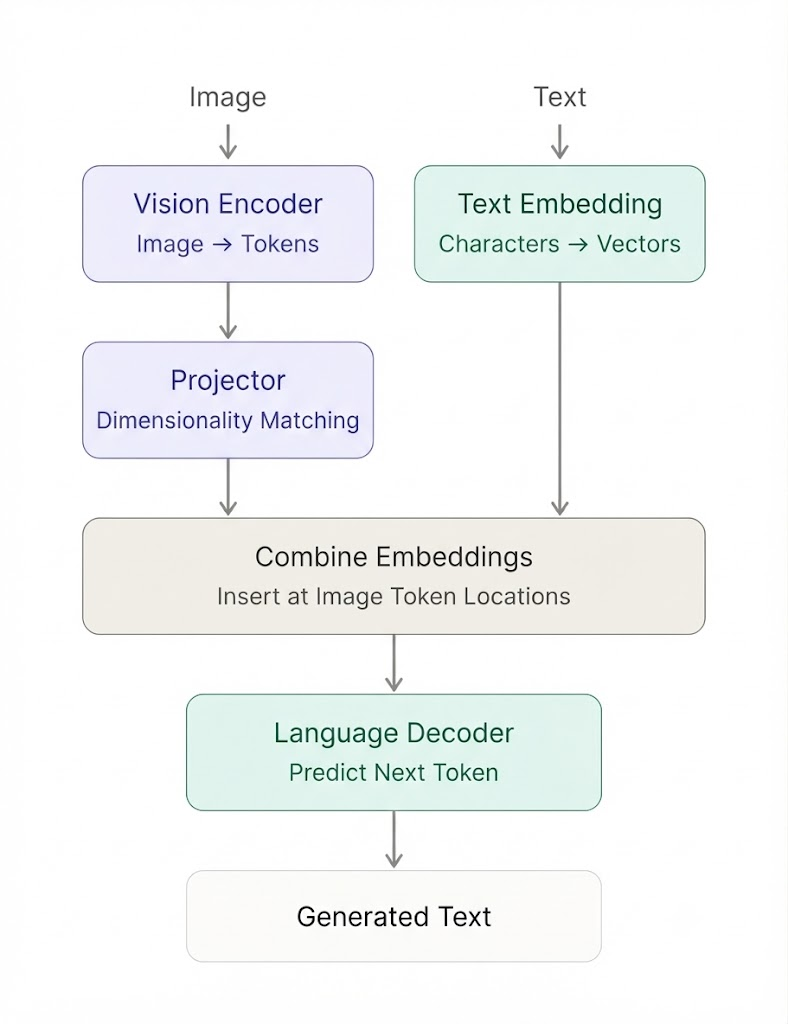
전체 스트럭쳐는 위와 같다.
1. Vision Encoder
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
"""이미지 -> 패치 임베딩.

참조: nanoVLM/models/vision_transformer.py (251줄, ViT를 직접 구현한 버전)
     우리는 직접 짜지 않고 HF에서 사전학습 SigLIP2를 로드한다.

    입력  [B, 3, 512, 512]
    출력  [B, 1024, 768]        1024 = (512/16)^2 패치,  768 = vit_hidden_dim
"""

import torch.nn as nn
from transformers import AutoImageProcessor, AutoModel


def get_image_processor(model_name="google/siglip2-base-patch16-512"):
  return AutoImageProcessor.from_pretrained(model_name)


class VisionEncoder(nn.Module):
  def __init__(self, model_name="google/siglip2-base-patch16-512"):
    super().__init__()
    self.vit = AutoModel.from_pretrained(model_name).vision_model

  @property
  def hidden_dim(self):
    return self.vit.config.hidden_size  # 768. projector에 넘길 값

  def forward(self, pixel_values):
    out = self.vit(pixel_values=pixel_values)
    return out.last_hidden_state
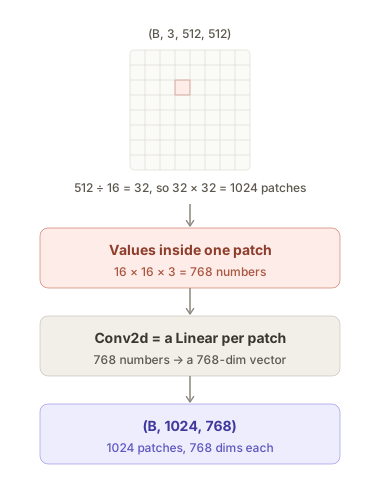
정리하면, 사진 팩셀이 512 x 512개를 → 32 x 32개로 바꾸고, 그거를 일렬로 만드는 것이다.
2. Projector
이 부분이 재미있는데, 디멘션을 twist해주어야 하는 부분이다. 왜냐하면, text embedding과 이후에 결합을 해야하기 때문이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
'''
Projector.
'''

import torch
import torch.nn as nn

class ModalityProjector(nn.Module):
  def __init__(self, vit_dim = 768, lm_dim = 960, factor = 4):
    super().__init__()
    self.factor = factor # 한개의 패치를 또 가로세로 쪼갤꺼임 4등분으로 할꺼임.

    # 1 patch = factor x factor * vit_dim??
    # 그러니까 Pathc들을 일려로 쫙 나열하는건가.
    self.input_dim = vit_dim * (factor **2)

    # 이 모듈에서 학습되는 건 이 한 줄이 전부. bias 없음
    self.proj = nn.Linear(self.input_dim, lm_dim, bias = False)


  # 이제 이해가 됨
  # (B, 32, 32, 768) -> (B, 8, 8, 12288)
  def pixel_shuffle(self,x):
    B, T, D = x.shape # (B, 1024, 768)
    side = int(T ** 0.5) # 1024 -> 32
    f = self.factor # 4

    x = x.view(B, side, side, D) # (B, 32, 32, 768)
    x = x.view(B, side //f, f, side //f, f, D) # (B, 8, 4, 8, 4, 768)

    x = x.permute(0,1,3,2,4,5).contiguous() # (B,8,8,4,4,768) / 8 <-> 4 하는 과정
    x = x.view(B, (side //f) ** 2, D * f * f) # (B, 64, 12288)
    return x


  def forward(self , x):

    # 1024 -> 64
    x = self.pixel_shuffle(x) # 결국 우리가 하고자하는거는 dimsension LLM = ViT

    # D * f f = 12288 -> lm_dim = 960
    x = self.proj(x)

    return x
여기서 총 두가지 작업이 순차적으로 이루어진다. pixel을 섞는 과정과 그리고 projection하는 과정이다. Pixel shuffle은 픽셀들을 다시 8x8 grid로 섞는 과정이고, 이후에 이제 text embeddign과 디멘션을 맞추는 작업이 진행된다. (960 = lm_dim)
근데 굳이 왜 pixel shuffle을 하는가? 이게 의문이긴 해.
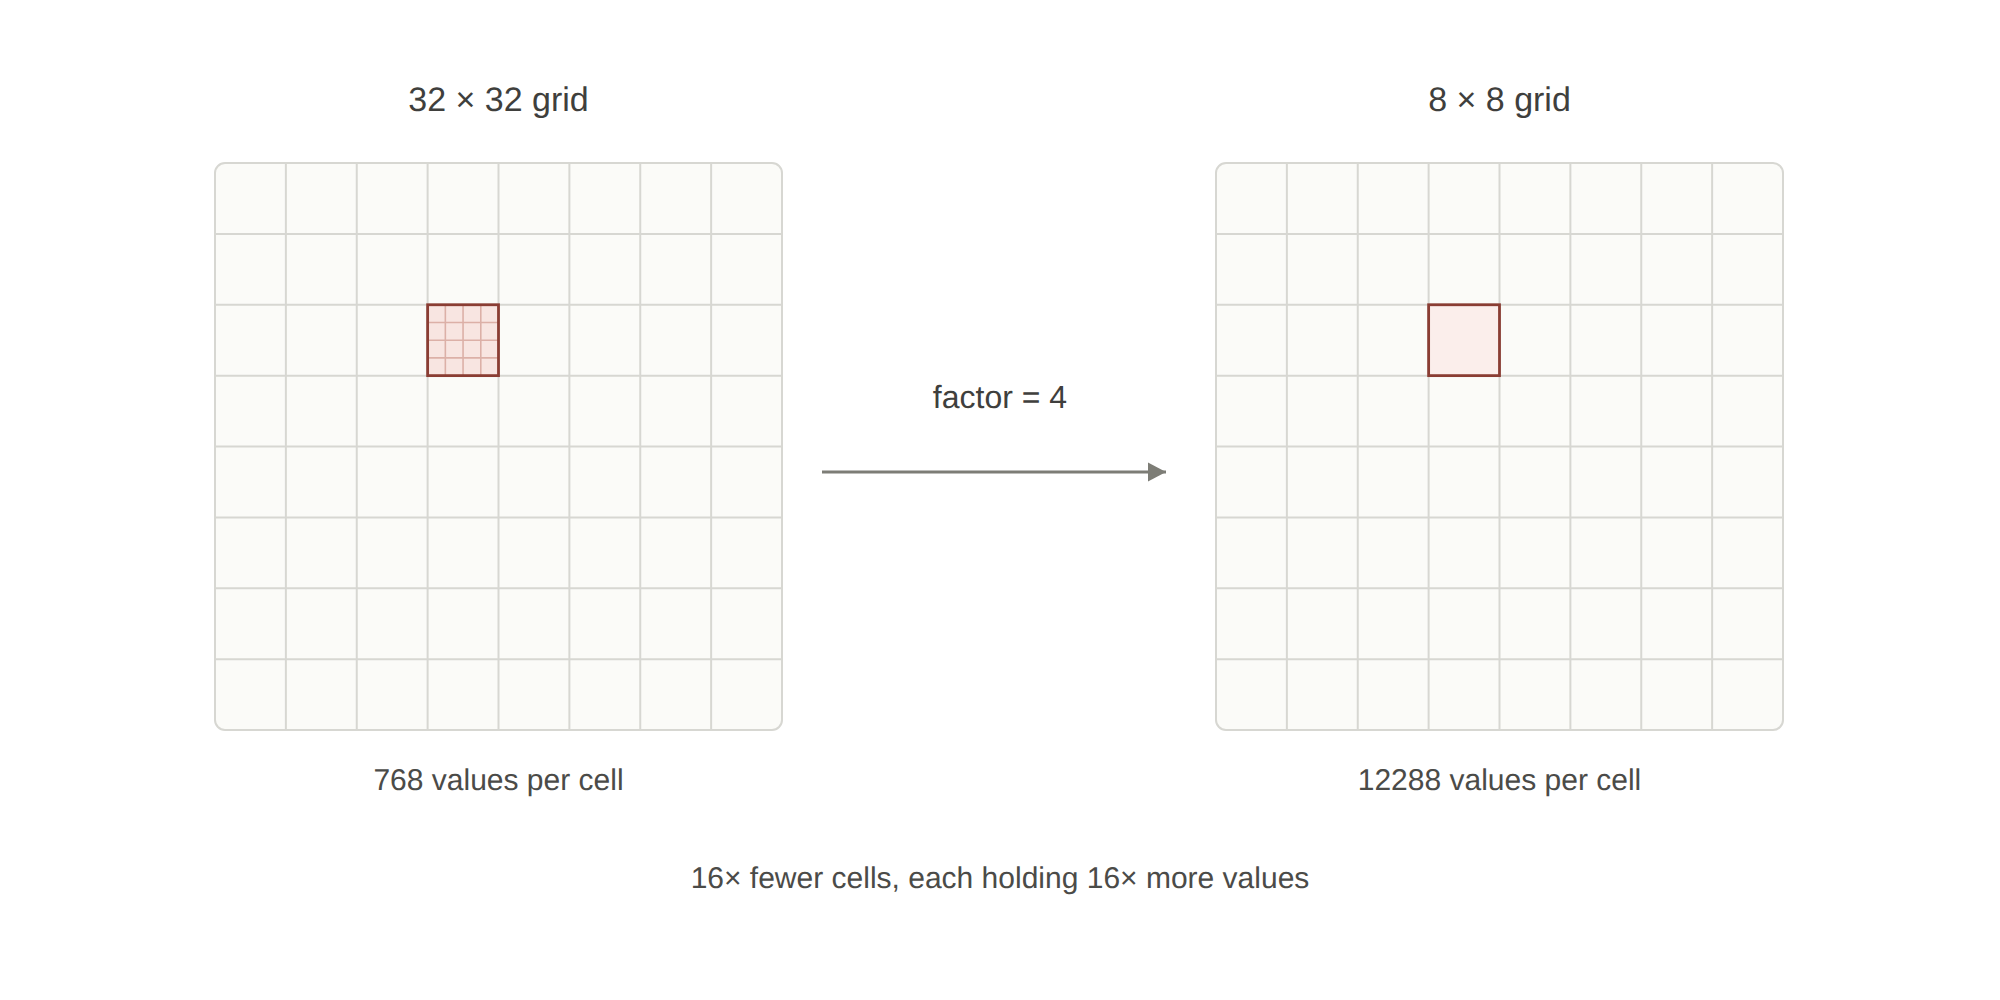
→ 이유는 크게 두 가지다.
- 토큰 개수를 줄이려고. ViT 출력 1024개를 그대로 LLM에 넣으면 이미지 한 장이 토큰 1024개를 먹는다. 문맥 길이도 잡아먹고, attention 계산량은 토큰 수의 제곱(N²)으로 늘어난다. factor 4로 pixel shuffle을 하면 1024 → 64, 무려 16배 줄어든다.
- 그래도 정보는 버리지 않으려고. pooling처럼 평균 내서 버리는 게 아니라, 4×4 이웃 패치 16개의 feature를 channel 방향으로 그대로 이어붙인다 (768 → 12288). 공간 정보가 사라지는 게 아니라 channel 쪽으로 자리만 옮긴 것이다. 그 다음 projector의 Linear 한 줄이 12288 → 960으로 줄이면서 무엇을 남길지를 학습한다.
1
2
3
4
5
[1024, 768]  ← 토큰 많고 얇음
   ↓ pixel shuffle (4×4 패치를 하나로)
[  64, 12288] ← 토큰 적고 두꺼움
   ↓ Linear
[  64, 960]   ← LLM 차원에 맞춤
나만의 언어: 토큰 개수를 줄이는 대신 토큰 하나를 두껍게 만든다. (이걸 space-to-depth라고도 부른다)
물론 공짜는 아니다. factor를 너무 키우면 아주 작은 글씨나 세밀한 위치 정보가 뭉개질 수 있다. 그래서 nanoVLM, SmolVLM처럼 작은 모델에서 LLM 문맥을 아끼려고 특히 많이 쓰는 방식이다.
3. Text Decoder
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
"""
텍스트 임베딩 + 언어 트랜스포머.

참조: nanoVLM/models/language_model.py (681줄, Llama 구조를 직접 구현한 버전)
     우리는 HF에서 사전학습 SmolLM2를 로드한다.

밖으로 내주는 것 두 가지:
  1) 토큰 임베딩만 따로   input_ids [B, T] -> [B, T, 960]
  2) 임베딩을 받는 forward  inputs_embeds -> logits [B, T, vocab]

nanoVLM은 같은 걸 cfg.lm_use_tokens 플래그로 처리한다. 우리는 그냥 메서드를 나눴다.
"""

import torch.nn as nn
from transformers import AutoModelForCausalLM, AutoTokenizer

IMAGE_TOKEN = "<|image|>"


def get_tokenizer(model_name="HuggingFaceTB/SmolLM2-360M-Instruct",
                  extra_tokens=(IMAGE_TOKEN,)):
  """
  토크나이저를 만들고 특수 토큰을 추가한다.

  주의: 반드시 TextDecoder보다 먼저 만들어야 한다.
  여기서 len(tok)이 늘어나고, 그 값으로 임베딩 행렬 크기를 맞추기 때문이다.
  """
  tok = AutoTokenizer.from_pretrained(model_name)
  tok.add_special_tokens({"additional_special_tokens": list(extra_tokens)})

  # SmolLM2는 pad 토큰이 없다. 배치 패딩을 하려면 있어야 해서 eos로 대신한다.
  # (nanoVLM/data/processors.py:16 도 같은 처리를 한다)
  if tok.pad_token is None:
    tok.pad_token = tok.eos_token

  return tok


class TextDecoder(nn.Module):
  # tokenizer를 기본값 없는 첫 인자로 둔 건 실수 방지용이다.
  # 특수 토큰을 추가해놓고 resize_token_embeddings를 빼먹으면
  # image_token_id가 임베딩 행렬 밖이라 인덱싱 에러가 난다.
  # 토크나이저를 강제로 받아서 여기서 resize까지 끝내버린다.
  def __init__(self, tokenizer, model_name="HuggingFaceTB/SmolLM2-360M-Instruct"):
    super().__init__()
    self.lm = AutoModelForCausalLM.from_pretrained(model_name)

    # len(tok)은 추가 토큰까지 센 값. tok.vocab_size는 원래 크기라 안 늘어난다.
    self.lm.resize_token_embeddings(len(tokenizer))

  @property
  def hidden_dim(self):
    return self.lm.config.hidden_size  # 960. projector가 맞춰야 할 목표 차원

  def token_embedding(self, input_ids):
    """[B, T] -> [B, T, 960]

    항상 기억하자 임배딩은 토큰 1개 -> 백터 1개로 바꿔주는거
    (960 디멘션 벡터인거임)
    """
    return self.lm.get_input_embeddings()(input_ids)

  def forward(self, inputs_embeds, attention_mask=None):
    out = self.lm(inputs_embeds=inputs_embeds, attention_mask=attention_mask)
    return out.logits
여기서 핵심은 text 를 이제 임배딩해줘서 960 디멘션으로 맞춰주는 작업 인것이다.
4. Combine embedding + Decoder
VLM 클래스를 제작할 것이고, 총 3개 메서드로 구성된다.
- Replace image token
- Forward
- Generate
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
"""encoder + projector + decoder를 합치는 곳. 이 프로젝트의 중심.

참조: nanoVLM/models/vision_language_model.py:36  _replace_img_tokens_with_embd
     nanoVLM/models/vision_language_model.py:62  forward
     nanoVLM/models/vision_language_model.py:83  generate

    images     -> encoder   -> [num_img, 1024, 768]
               -> projector -> [num_img,   64, 960]
    input_ids  -> decoder.token_embedding -> [B, T, 960]
    치환                                  -> [B, T, 960]
    decoder                               -> logits
"""

import torch
import torch.nn as nn
import torch.nn.functional as F

from model.encoder import VisionEncoder
from model.projector import ModalityProjector
from model.decoder import TextDecoder, IMAGE_TOKEN


class VLM(nn.Module):
  def __init__(self, tokenizer,
               vit_name="google/siglip2-base-patch16-512",
               lm_name="HuggingFaceTB/SmolLM2-360M-Instruct",
               pixel_shuffle_factor=4):
    super().__init__()
    self.tokenizer = tokenizer
    self.image_token_id = tokenizer.convert_tokens_to_ids(IMAGE_TOKEN)

    self.encoder = VisionEncoder(vit_name)
    self.decoder = TextDecoder(tokenizer, lm_name)

    # 차원을 손으로 적지 않고 양쪽 백본에서 뽑아온다.
    # 백본을 바꾸면 projector가 알아서 따라간다.
    self.projector = ModalityProjector(
        vit_dim=self.encoder.hidden_dim,   # 768
        lm_dim=self.decoder.hidden_dim,    # 960
        factor=pixel_shuffle_factor,
    )

  def _replace_img_tokens(self, input_ids, token_embd, image_embd):
    ...

  def forward(self, input_ids, images, attention_mask=None, targets=None):
    ...

  @torch.inference_mode()
  def generate(self, input_ids, images, attention_mask=None, max_new_tokens=30):
    ...
하나하나 어떤 함수인지를 한번 살펴보자.
1) Replace image token
여기서, 재미있는 사실은 기존에
- input_ids: 프롬트에서 토큰의 아이디 리스트
- token_embd: 토큰 아디들을 전부 벡터로 바꾼 텐서
- image_embd: 넣을 이미지의 임배딩 텐서
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
def _replace_img_tokens(self, input_ids, token_embd, image_embd):
   """<|image|> 자리의 임베딩만 이미지 임베딩으로 덮어쓴다.

   concat이 아니다. 그래서 길이 계산이 필요 없고, 이미지가 프롬프트
   중간에 있어도, 한 샘플에 이미지가 2장이든 0장이든 같은 코드로 돌아간다.
   """
   mask = (input_ids == self.image_token_id)          # [B, T] bool

   # 자리 개수와 이미지 토큰 개수가 정확히 같아야 한다.
   # 어긋나면 아래 대입이 알아서 에러를 내긴 하지만 메시지가 불친절해서
   # 여기서 먼저 잡는다. 학습 중에 터지면 원인 찾기 제일 힘든 축이다.
   n_slot = int(mask.sum())
   n_img_token = image_embd.size(0) * image_embd.size(1)
   assert n_slot == n_img_token, (
       f"<|image|> 자리 {n_slot}개 vs 이미지 토큰 {n_img_token}개. "
       f"프롬프트에 박은 개수와 projector 출력이 안 맞는다."
   )

   # clone 필수. in-place로 쓰면 autograd가 터진다.
   out = token_embd.clone()

   # mask로 대입하면 torch가 먼저 flatten한다. 그래서 image_embd도 [-1, D]로 편다.
   # .to(dtype)은 AMP 대비 — autocast 아래서 둘의 dtype이 갈릴 수 있다.
   out[mask] = image_embd.reshape(-1, image_embd.size(-1)).to(out.dtype)

   return out
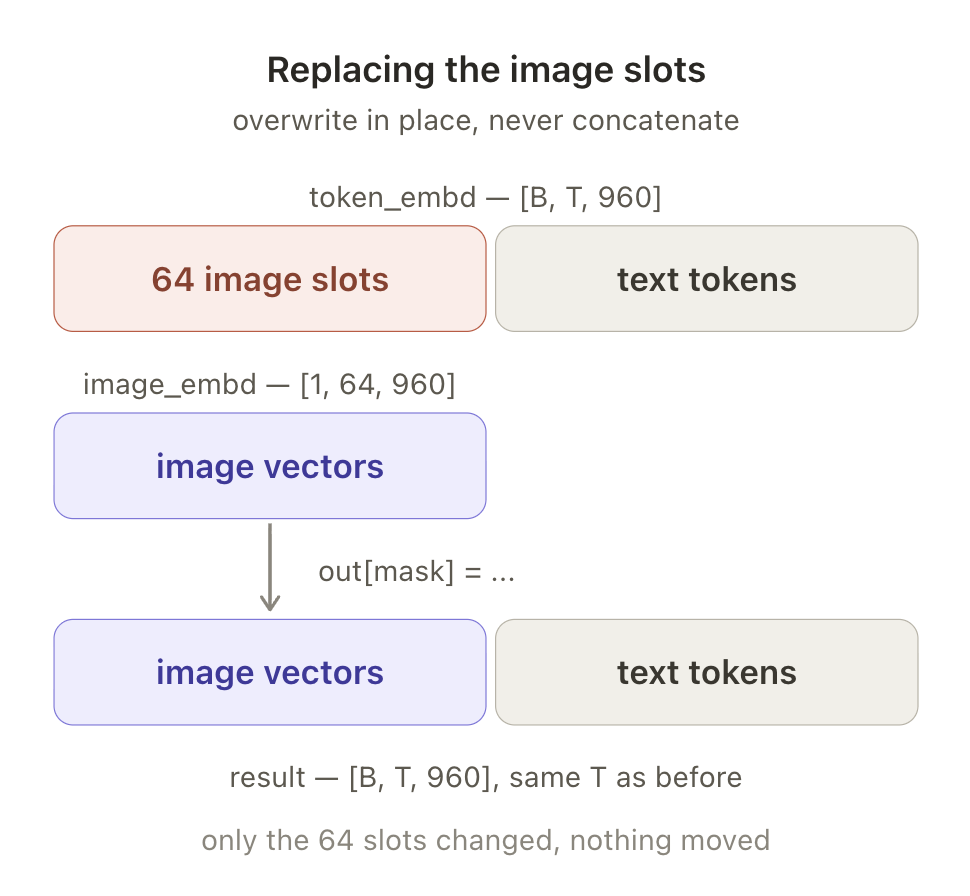
여기서, 재미있는 일은, 일단 <|image|>라는 토큰을 정의하고, text token과 결합을 한다. 그리고, 그 토큰을 실제 image encoder vectors로 대체하는 작업을 진행하는 것이다. 따라서, 결합이라는 단어를 쓰지 않고, replace method를 제작한 것이다.
2. Forward
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def forward(self, input_ids, images, attention_mask=None, targets=None):
  token_embd = self.decoder.token_embedding(input_ids)     # [B, T, 960]

  if images is not None:
    feats = self.encoder(images)                           # [num_img, 1024, 768]
    image_embd = self.projector(feats)                     # [num_img,   64, 960]
    token_embd = self._replace_img_tokens(input_ids, token_embd, image_embd)

  logits = self.decoder(token_embd, attention_mask=attention_mask)

  loss = None
  if targets is not None:
    # 여기서 shift하지 않는다. 라벨 shift는 data/dataset.py에서 이미 끝났다.
    # 여기서 또 밀면 두 칸 밀린 채로 학습되는데, loss는 멀쩡히 내려간다.
    loss = F.cross_entropy(
        logits.reshape(-1, logits.size(-1)),
        targets.reshape(-1),
        ignore_index=-100,
    )

  return logits, loss
이제 먼저, text → token을 임배딩하고, 그리고 image가 만약 prompt에 있다면, 그거를 replace image token으로 대체하는 작업을 진행한다. 그리고 이제 합쳐진 token_embd를 decoder에 넣어서 logits 을 도출한다. model : “HuggingFaceTB/SmolLM2-360M-Instruct”
3. Generate
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
@torch.inference_mode()
def generate(self, input_ids, images, attention_mask=None, max_new_tokens=30):
  """greedy 디코딩. KV 캐시 없는 순진한 버전이다.

  매 스텝 전체 시퀀스를 다시 돌리므로 느리다. nanoVLM의 generate가
  100줄인 건 대부분 KV 캐시 처리 때문이다
  (nanoVLM/models/vision_language_model.py:83). 지금은 "학습된 모델이
  이미지를 보고 말을 하는가"만 확인하면 되니 이걸로 충분하다.
  """
  token_embd = self.decoder.token_embedding(input_ids)

  print("input_ids.shape", input_ids.shape)

  if images is not None:
    image_embd = self.projector(self.encoder(images))
    token_embd = self._replace_img_tokens(input_ids, token_embd, image_embd)
    print("image_embd.shape", image_embd.shape)
    print("token_embd.shape", token_embd.shape)

  if attention_mask is None:
    attention_mask = torch.ones(input_ids.shape, dtype=torch.long,
                                device=input_ids.device)

  print("attention_mask.shape", attention_mask.shape)

  generated = []
  for _ in range(max_new_tokens):
    logits = self.decoder(token_embd, attention_mask=attention_mask)
    print("logits.shape", logits.shape)
    next_id = logits[:, -1, :].argmax(dim=-1, keepdim=True)     # [B, 1]
    generated.append(next_id)

    if (next_id == self.tokenizer.eos_token_id).all():
      break

    # 다음 스텝 입력에 이어붙인다. 여기서부터는 그냥 텍스트 토큰이라
    # 치환이 필요 없다 — 이미지는 프롬프트 안에서 이미 끝났다.
    next_embd = self.decoder.token_embedding(next_id)
    token_embd = torch.cat([token_embd, next_embd], dim=1)
    attention_mask = torch.cat([attention_mask, torch.ones_like(next_id)], dim=1)

  return torch.cat(generated, dim=1)
greedy 디코딩이다. 매 스텝 확률이 가장 높은 토큰 하나만 고른다. 샘플링이 없어서 같은 입력이면 항상 같은 출력이 나온다.
- 이미지 치환은 루프 밖에서 딱 한 번. 이후 생성되는 토큰은 전부 텍스트라
<|image|>자리가 더 생기지 않는다. 이미지는 프롬프트 안에서 이미 끝났다. logits[:, -1, :]만 쓴다. 디코더는 T개 위치 전부에 대해 다음 토큰 예측을 내놓지만, 생성할 때 필요한 건 맨 끝 하나뿐이라 나머지는 버린다. (학습 때는 전부 쓴다 — 그래서 loss가 한 번에 계산된다)- KV 캐시가 없다. 매 스텝
token_embd전체를 다시 디코더에 통과시킨다. 30 토큰을 만들면 디코더를 30번 도는데 매번 시퀀스가 길어지므로 뒤로 갈수록 느려진다. nanoVLM의generate가 100줄인 이유가 대부분 이 캐시 처리다. - 반환값은 생성된 토큰만.
[B, n_generated]이고 프롬프트는 빠져 있어서, 디코드하면 답변 부분만 나온다.
학습 전에는 projector가 랜덤 초기화 상태라 이미지와 무관한 말이 나온다. 이 단계의 확인 목표는 “말이 되는가”가 아니라 “끝까지 돌아가는가”이다.
4. Training
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
"""로컬 VLM 학습의 가장 작은 실행 스크립트.

예시 JSONL (data/train.jsonl):
{"image": "images/red_square.png", "question": "What shape is this?", "answer": "A red square."}

실행:
  /Users/jeff/miniconda3/bin/python train.py --data data/train.jsonl --max-steps 10

기본값은 projector만 학습한다. ViT/LLM까지 미세조정하려면 각각
``--train-vision``, ``--train-language``를 명시한다.
"""

import argparse
import json
from pathlib import Path

import torch
from torch.optim import AdamW
from torch.utils.data import DataLoader

from data.collate import VLMDataCollator
from data.dataset import ImageQADataset
from model.decoder import get_tokenizer
from model.encoder import get_image_processor
from model.vlm import VLM


def get_device():
  if torch.cuda.is_available():
    return torch.device("cuda")
  if torch.backends.mps.is_available():
    return torch.device("mps")
  return torch.device("cpu")


def set_trainable(module, enabled):
  for parameter in module.parameters():
    parameter.requires_grad = enabled


def build_optimizer(model, args):
  groups = [{"params": model.projector.parameters(), "lr": args.lr_projector}]
  if args.train_vision:
    groups.append({"params": model.encoder.parameters(), "lr": args.lr_vision})
  if args.train_language:
    groups.append({"params": model.decoder.parameters(), "lr": args.lr_language})
  return AdamW(groups, weight_decay=args.weight_decay)


def save_checkpoint(path, model, step, epoch, args, val_loss=None):
  """projector-only 실험의 작은 checkpoint를 저장한다.

  고정된 ViT/LLM은 Hugging Face에서 다시 받는다. 그래서 여기에는 실제로
  바뀐 projector weight만 넣는다.
  """
  path.parent.mkdir(parents=True, exist_ok=True)
  torch.save({
      "projector_state_dict": model.projector.state_dict(),
      "step": step,
      "epoch": epoch,
      "val_loss": val_loss,
      "train_args": vars(args),
  }, path)
  print(f"checkpoint saved: {path}")


@torch.inference_mode()
def evaluate(model, loader, device):
  model.eval()
  losses = []
  for batch in loader:
    batch = {
        name: value.to(device) if value is not None else None
        for name, value in batch.items()
    }
    _, loss = model(
        input_ids=batch["input_ids"],
        images=batch["images"],
        attention_mask=batch["attention_mask"],
        targets=batch["labels"],
    )
    losses.append(loss.item())
  model.train()
  return sum(losses) / len(losses)


def parse_args():
  parser = argparse.ArgumentParser()
  parser.add_argument("--data", required=True, help="image/question/answer JSONL 경로")
  parser.add_argument("--val-data", help="validation JSONL 경로")
  parser.add_argument("--output-dir", default="checkpoints")
  parser.add_argument("--batch-size", type=int, default=1)
  parser.add_argument("--epochs", type=int, default=1)
  parser.add_argument("--max-steps", type=int, default=100)
  parser.add_argument("--max-length", type=int, default=512)
  parser.add_argument("--num-workers", type=int, default=0)
  parser.add_argument("--lr-projector", type=float, default=5e-4)
  parser.add_argument("--lr-vision", type=float, default=5e-5)
  parser.add_argument("--lr-language", type=float, default=5e-5)
  parser.add_argument("--weight-decay", type=float, default=0.01)
  parser.add_argument("--grad-clip", type=float, default=1.0)
  parser.add_argument("--save-every", type=int, default=100)
  parser.add_argument("--train-vision", action="store_true")
  parser.add_argument("--train-language", action="store_true")
  return parser.parse_args()


def main():
  args = parse_args()
  device = get_device()
  print(f"device: {device}")

  tokenizer = get_tokenizer()
  dataset = ImageQADataset(
      args.data,
      tokenizer=tokenizer,
      image_processor=get_image_processor(),
      image_token_length=64,
  )
  loader = DataLoader(
      dataset,
      batch_size=args.batch_size,
      shuffle=True,
      num_workers=args.num_workers,
      collate_fn=VLMDataCollator(tokenizer, max_length=args.max_length),
  )
  val_loader = None
  if args.val_data:
    val_dataset = ImageQADataset(
        args.val_data,
        tokenizer=tokenizer,
        image_processor=get_image_processor(),
        image_token_length=64,
    )
    val_loader = DataLoader(
        val_dataset,
        batch_size=args.batch_size,
        shuffle=False,
        num_workers=args.num_workers,
        collate_fn=VLMDataCollator(tokenizer, max_length=args.max_length),
    )

  model = VLM(tokenizer).to(device)
  set_trainable(model.encoder, args.train_vision)
  set_trainable(model.decoder, args.train_language)
  optimizer = build_optimizer(model, args)

  trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
  print(f"samples: {len(dataset)}, trainable parameters: {trainable:,}")

  step = 0
  best_val_loss = float("inf")
  output_dir = Path(args.output_dir)
  output_dir.mkdir(parents=True, exist_ok=True)
  metrics_path = output_dir / "metrics.jsonl"
  (output_dir / "run_config.json").write_text(
      json.dumps(vars(args), indent=2), encoding="utf-8",
  )
  model.train()
  for epoch in range(args.epochs):
    for batch in loader:
      if step >= args.max_steps:
        break

      batch = {
          name: value.to(device) if value is not None else None
          for name, value in batch.items()
      }
      _, loss = model(
          input_ids=batch["input_ids"],
          images=batch["images"],
          attention_mask=batch["attention_mask"],
          targets=batch["labels"],
      )
      loss.backward()
      torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)
      optimizer.step()
      optimizer.zero_grad(set_to_none=True)

      step += 1
      metric = {"epoch": epoch + 1, "step": step, "train_loss": loss.item()}
      print(f"epoch={epoch + 1} step={step} loss={loss.item():.4f}")
      with metrics_path.open("a", encoding="utf-8") as f:
        f.write(json.dumps(metric) + "\n")
      if step % args.save_every == 0:
        save_checkpoint(output_dir / f"projector_step_{step}.pt", model, step, epoch, args)
    if val_loader is not None:
      val_loss = evaluate(model, val_loader, device)
      print(f"epoch={epoch + 1} validation_loss={val_loss:.4f}")
      with metrics_path.open("a", encoding="utf-8") as f:
        f.write(json.dumps({"epoch": epoch + 1, "step": step, "val_loss": val_loss}) + "\n")
      if val_loss < best_val_loss:
        best_val_loss = val_loss
        save_checkpoint(output_dir / "projector_best.pt", model, step, epoch, args, val_loss)

    if step >= args.max_steps:
      break

  save_checkpoint(output_dir / "projector_last.pt", model, step, epoch, args, best_val_loss)


if __name__ == "__main__":
  main()
코드 흐름
이 실습에서는 전체 VLM을 학습하지 않고 projector만 학습한다. 따라서 pretrained ViT와 LLM은 고정하고, 이미지 feature를 LLM embedding 공간으로 옮기는 projector weight만 업데이트한다.
ImageQADataset과VLMDataCollator가 이미지·질문·정답을 batch로 만든다.model(..., targets=labels)이 forward를 실행하고 cross-entropy loss를 계산한다.loss.backward()가 gradient를 계산하고,AdamW.step()이 projector weight를 업데이트한다.- epoch마다 validation loss를 계산하고 가장 좋은 projector를
projector_best.pt로 저장한다. - 마지막 projector는
projector_last.pt, step별 loss 기록은metrics.jsonl에 저장한다.
이번 실행 결과
- GPU: RunPod NVIDIA A40 48GB
- 학습 대상: projector만 (
11,796,480parameters) - 데이터: train 144개 / validation 48개
- 설정: batch size 1 / max steps 500
- 최종 validation loss:
4.888e-05 - generation test: validation sample 12개 중 12개 정답