
Step2 Vision language Action (VLA) model - architecture
VLM에 무엇을 붙이면 robot policy가 되는가? RT-2의 action tokenization, OpenVLA의 구조와 디멘션, Behavior Cloning 데이터 모양, π₀의 Action Expert와 flow matching까지 VLA 구조를 한 흐름으로 정리한다.
| 단계 | 핵심 질문 | 할 일 |
|---|---|---|
| 0. VLA 공통 골격 | “VLM 뒤에 무엇을 붙이면 policy가 되지?” | observation/image + language instruction → tokens → Transformer → action을 한 장 그림으로 잡기 |
| 1. RT-2 | “왜 action을 text token처럼 만들었지?” | 논문 Figure/방법만 짧게 보기 |
| 2. OpenVLA | “실제 공개 VLA는 input부터 action까지 어떻게 구현하지?” | 첫 정독 논문 + 코드 구조 읽기 |
| 3. 작은 실습 | “trajectory data와 behavior cloning은 어떤 모양이지?” | 거대 모델 훈련 대신 작은 image/instruction/action trajectory toy 실습 |
| 4. π₀ | “왜 discrete token action 대신 flow matching인가?” | Action Expert, continuous action chunk, pre/post-training을 깊게 보기 |
0. VLA 공통 골격
핵심 질문
이미지와 언어를 처리하던 VLM은 어떻게 로봇의 행동을 출력하는 policy가 되는가?
결론부터 말하면, 생각보다 단순하다. Transformer Step3에서 직접 만들어본 VLM 구조 그대로, 출력 쪽만 text → action으로 바꾸면 된다.
1
2
3
4
5
6
7
8
Camera image ─→ Vision Encoder ─→ Projector ─→ visual tokens ──┐
                                                              ├─→ LLM backbone (Transformer)
Language instruction ─→ Tokenizer ─→ text tokens ─────────────┘
                                                              ↓
                                                      Action output
                                         (Δxyz, Δrotation, gripper …)
                                                              ↓
                                            Low-level controller → Robot
여기서 VLA마다 달라지는 건 사실상 딱 하나다.
“action을 어떤 형태로 출력하는가?”
- RT-2 / OpenVLA: action을 text token처럼 쪼개서 next-token prediction으로 뽑는다. (discrete)
- π₀: VLM 뒤에 Action Expert를 붙여서 연속값 action을 flow matching으로 생성한다. (continuous)
VLA = VLM + “action을 출력하는 방법”. 나머지(이미지 토큰화, projector, Transformer)는 VLM 시간에 본 것과 같다.
참고 문헌과 문서
- Google DeepMind — RT-2 공식 소개 — VLM에서 VLA로 넘어가는 동기와 전체 흐름을 먼저 잡기.
- OpenVLA 논문 — HTML 원문 — Figure 2와 §3.1에서 Vision Encoder → Projector → LLM의 연결을 기존 VLM 구조와 비교하기.
- Hugging Face LeRobot — Imitation Learning on Real-World Robots — 보충 문서. demonstration 기록 → dataset 확인 → policy 학습 → 평가의 흐름을 살펴보기.
1. RT-2
핵심 질문
연속적인 robot action을 왜 text token처럼 표현하고, VLM을 어떤 데이터로 학습시키는가?
참고 문헌과 문서
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control — 논문 · HTML 원문
- RT-2 공식 프로젝트 페이지 — Approach Overview의 구조 그림과 실제 동작 영상을 함께 보기.
다 읽은다음에 질문 답해야하는 것들
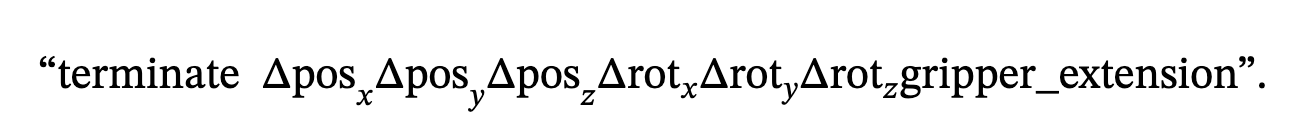
- generalizable and semantically aware robotic polices라는 말이 자꾸 나오네.
- 55B parameters trained on Internet data and robotic trajectories from previous work.
- 재미있는 사실은 fine tunning에서 로봇 데이터만 넣으니까 성능이 떨어짐 오히려 그냥 일반 웹 영상이랑 섞어서 해야함.
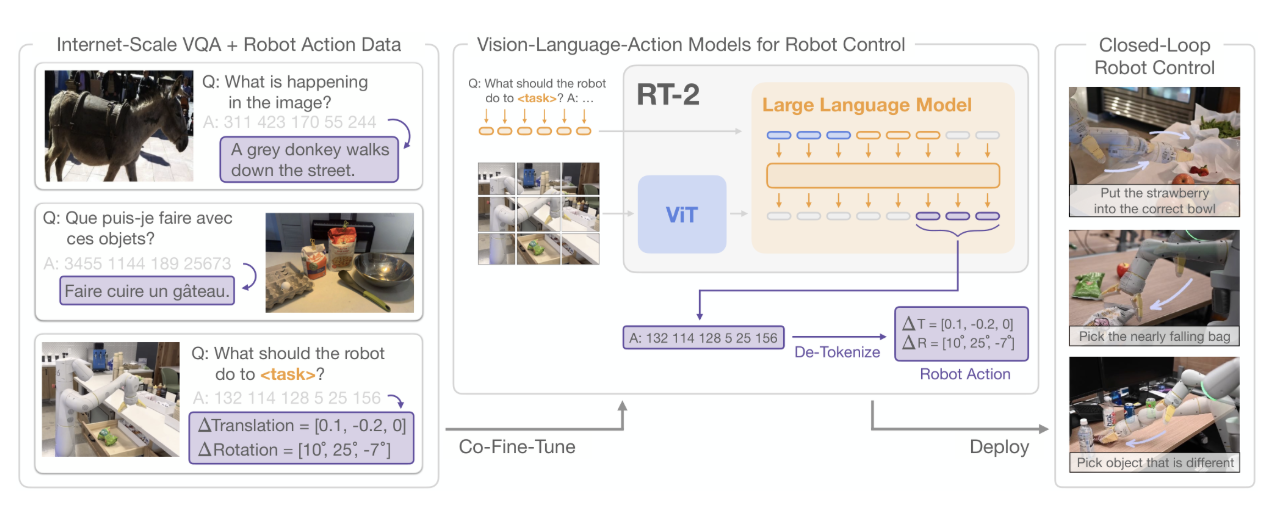
- RT-2는 RT-1 뒤에 VLM을 붙인 구조가 아니라, pretrained VLM 자체를 robot trajectory data로 co-fine-tuning해 action token까지 생성하도록 만든 VLA이다.
- 별도 action head를 추가하지 않고 action을 language token처럼 예측하므로, VLM의 pretrained weights와 next-token generation 방식을 vision-language-action에 그대로 공유할 수 있다.
- 한 timestep은 termination, end-effector의 Δ position XYZ, Δ rotation XYZ, gripper extension으로 이루어진 8개 값이다. 연속값은 각각 256 bins로 discretize하고, 추론할 때 다시 robot action으로 de-tokenize한다.
- Closed-loop control은 현재 image + instruction → action token → de-tokenize → Cartesian end-effector command를 low-level controller가 실행 → 새 image 관찰을 termination 또는 time limit까지 반복하는 구조다. 모델이 motor torque를 직접 출력하는 것은 아니다.
- Web data는 일반 영상만을 뜻하는 것이 아니라 VQA, captioning, image-text examples 등을 포함한다. Robot data는 움직이는 법을, web-scale VLM pretraining은 물체·언어·관계에 대한 semantic knowledge를 제공한다.
- Emergent capability는 완전히 새로운 motor motion을 배웠다는 뜻이 아니다. Robot data에서 배운 pick/move/place skill을 unseen object, symbol, language, reasoning context에 새롭게 연결하는 능력이다.
- RT-1은 기존 robot policy와의 비교이고, VC-1은 generative VLM이 아닌 visual-only pretrained representation과의 비교다. 즉 강한 visual feature만으로 web-scale VLM의 semantic transfer를 대체할 수 있는지를 확인한다.
- PaLI-X는 encoder-decoder, PaLM-E는 decoder-only지만 두 모델은 parameter 수와 pretraining mixture도 다르다. 따라서 PaLI-X의 성능을 encoder-decoder 구조 하나의 효과라고 단정할 수 없다.
- 같은 PaLI-X 계열에서 5B보다 55B가 더 좋아 scale effect는 확인됐지만, PaLI-X가 모든 항목에서 항상 우월한 것은 아니다. Emergent semantic에서는 PaLI-X가 강했고 math에서는 PaLM-E가 더 강했다.
- 그림의 회색 token은 별도의 modality가 아니다. 위쪽 회색은 autoregressive generation에서 이전 action token을 다시 입력한 부분이고, 아래쪽 회색은 action으로 사용하지 않는 prefix-position output이다. 보라색이 실제 action prediction이다.
Action을 text token으로 만드는 법 — 한눈에 보기
위 메모에서 제일 중요한 부분만 다시 정리하면 이렇다. 한 timestep의 action은 8개 숫자다.
| 항목 | 개수 | 의미 |
|---|---|---|
| terminate | 1 | 에피소드를 끝낼지 말지 |
| Δ position (x, y, z) | 3 | end-effector를 얼마나 이동할지 |
| Δ rotation (x, y, z) | 3 | end-effector를 얼마나 회전할지 |
| gripper extension | 1 | 집게를 얼마나 벌릴지 |
1
2
3
4
5
6
7
연속값 a = [0, 0.012, -0.034, 0.005, 0.10, 0.0, -0.02, 0.8]
   ↓ 각 차원을 256 bins로 discretize
bin id = [ 0,  132,  101,  130, 151, 128,  124, 230]
   ↓ bin id를 vocabulary 안의 token으로 매핑
"1 132 101 130 151 128 124 230"   ← 모델 입장에서는 그냥 문장 하나
   ↓ 추론 때는 거꾸로 de-tokenize
Cartesian end-effector command → low-level controller
(숫자는 이해를 위한 예시다.) PaLI-X는 원래 숫자 token이 vocabulary에 있어서 그대로 쓰고, PaLM-E는 거의 안 쓰이는 token 256개를 action용으로 덮어쓴다. 즉, action head를 새로 만들지 않고 “action도 언어다”라고 우겨서 VLM의 next-token prediction을 그대로 재활용한 것이 RT-2의 핵심 트릭이다.
RT-2 = pretrained VLM + robot trajectory data co-fine-tuning + action tokenization (8 values × 256 bins). 별도 action head 없음.
2. OpenVLA
핵심 질문
공개 VLA 모델에서 RT2와 어떤게 다른가? 데이터, 알고리즘, ..
핵심정보
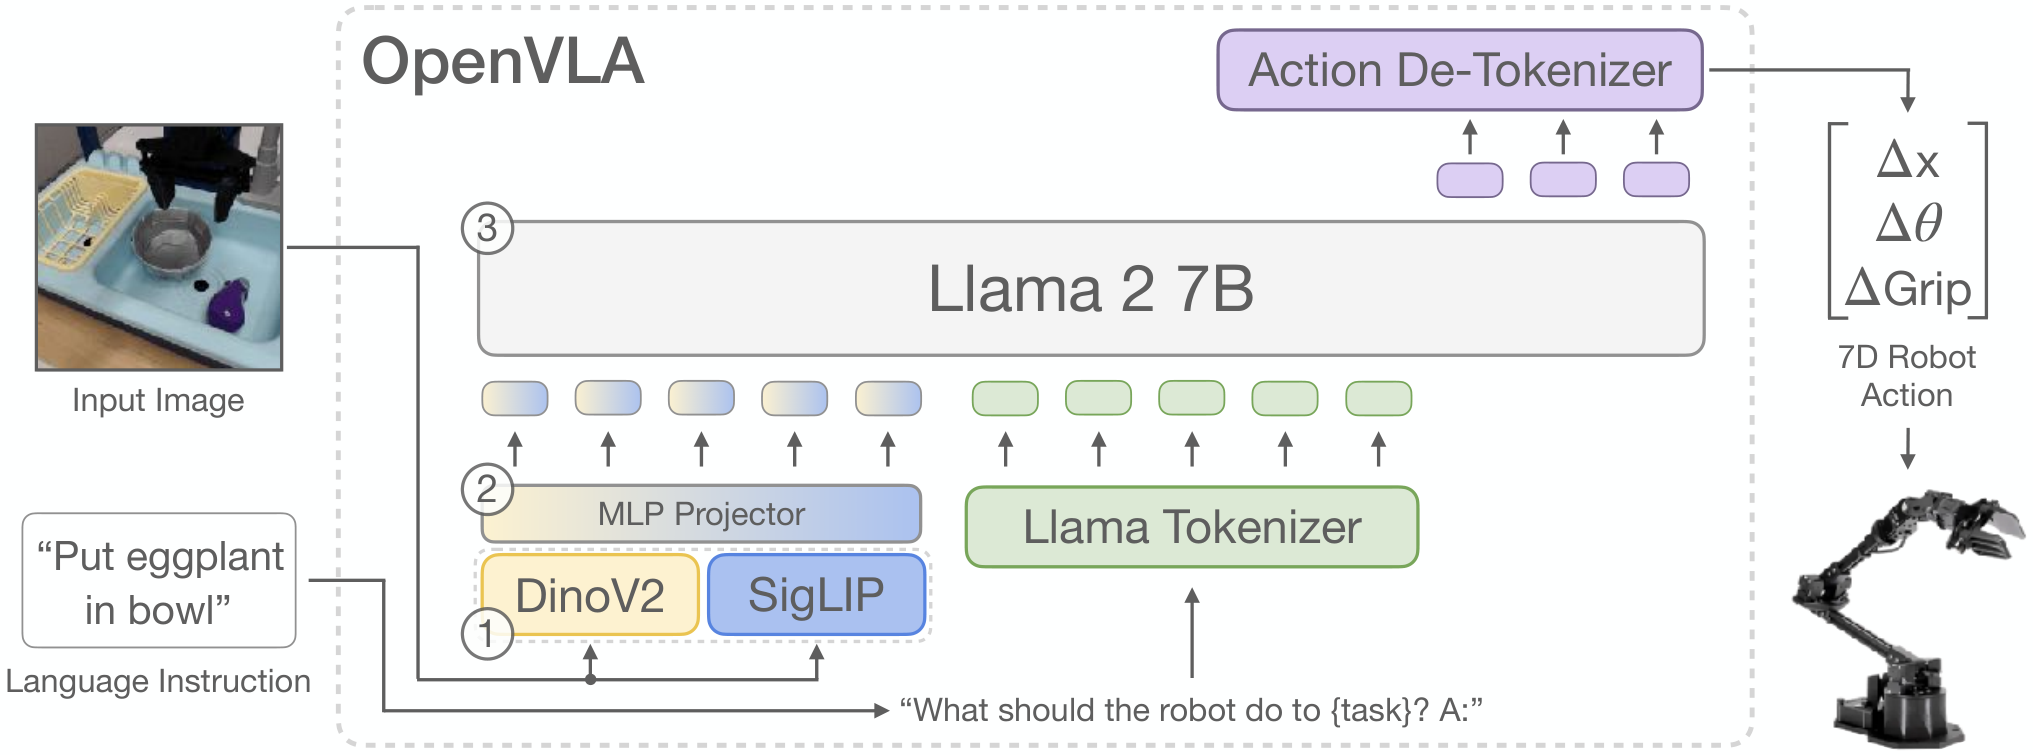
- ViT 두개를 독립적으로 하고, 합친다. 각각 다른 의미 semantic, and spatail 각각 장점
- DINOv2 → 공간·위치 정보(spatial)에 강함. “컵이 정확히 어디에 있나”
- SigLIP → 의미 정보(semantic)에 강함. “이게 컵이다”
- 두 encoder의 patch feature를 channel 방향으로 이어붙여서(concat) 하나의 visual token으로 만든다.
- post training에서 ViT를 얼리지 않는다. → 재확인 완료! 논문에서 VLA 학습 때 vision encoder까지 같이 fine-tuning하는 게 성능에 중요했다고 밝힌다. 즉, Llama 2, ViT 모두 학습한다. (VLM 실습 때 projector만 학습했던 것과 정반대 선택)
- 학습은 robot trajecotry data로만 진행, 위에 RT2랑 다르게, 웹데이터는 넣지 않고 그대신 로봇 경로 데이터로 넣음
- 주의할점은, 경로데이터이지만, 결국 로봇이 학습할때는 그냥 독립적인 사진과 액션에 불과함
- 즉 매 timestep마다 (현재 이미지 + 지시문) → (그 순간의 action) 한 쌍이 하나의 학습 샘플이다. 과거 이미지는 안 본다.
- 7D robot action을 output하는데, terminate / continue 토큰을 제거함. → Δxyz(3) + Δrotation(3) + gripper(1) = 7
- discretize도 RT-2처럼 min~max를 256등분하는 게 아니라, 데이터의 1%~99% quantile 구간을 256등분한다. 이상치(outlier) 하나 때문에 bin이 넓어지는 걸 막는 것.
- Llama tokenizer에서 가장 안 쓰이는 token 256개를 action token으로 덮어쓴다.
- 일단 RT2 보다 굉장히 경량화됨 → 7B vs 55B. 그런데도 RT-2-X보다 성공률이 더 높게 나왔다 (논문 기준 절대값 16.5%p).
- 그리고 quantization으로 4bit로 줄여서 메모리를 줄임. 논문 기준 성능 손실이 거의 없었다. (속도보다는 GPU memory 절약이 핵심)
- 그리고 fine tunning할때 W = W + AB 에서 A,B 만 학습함. 뭔말알? → LoRA다.
- 원래 weight W (d × d)는 얼리고, 작은 행렬 A (d × r), B (r × d)만 학습한다. r은 아주 작다 (예: 32).
- 7B 전체를 다시 학습하는 대신 극히 일부 파라미터만 학습해서, 새 로봇/새 작업에 싸게 적응시키는 방법이다.
Data
| 항목 | 내용 |
|---|---|
| 원본 | Open X-Embodiment |
| 원본 규모 | 70개 이상의 dataset, 2M개 이상의 trajectories |
| 실제 OpenVLA 학습량 | 약 970K trajectories |
| 포함 조건 | Manipulation task, third-person camera 존재, single-arm end-effector control |
| 입력 | 현재 observation image + language instruction |
| 정답 | 해당 timestep의 7-dimensional robot action |
| 주요 데이터 | Bridge, Fractal, Kuka, BC-Z, FMB, Language Table 등 |
Architecture — 디멘션 추적
VLM 실습 때처럼 텐서 shape을 따라가 보자. (224×224 이미지, patch 14 기준)
1
2
3
4
5
6
7
8
9
10
11
이미지 [3, 224, 224]
   ├─ DINOv2 ViT-L/14   → [256, 1024]     ← 256 = (224/14)² patch
   └─ SigLIP So400m/14  → [256, 1152]
        ↓ channel concat
   visual feature        [256, 2176]
        ↓ Projector (2-layer MLP)
   visual tokens         [256, 4096]     ← Llama 2 hidden 차원에 맞춤
        ↓ + 지시문 text tokens [T, 4096]
   Llama 2 7B (decoder-only)
        ↓ next-token prediction × 7번
   action tokens  [7]  → de-tokenize → 7D action
여기서 헷갈리지 말아야 할 세 숫자:
- 이미지 토큰 개수 = 256 (patch 개수)
- 토큰 하나의 차원 = 4096 (LLM hidden dim)
- action 차원 = 7 (= action token 7개)
즉 OpenVLA = Prismatic VLM (DINOv2 + SigLIP + Llama 2) 위에 RT-2식 action tokenization을 얹은 것. 구조는 VLM 실습 그대로고, 출력 vocabulary에 action이 들어간 것뿐이다.
학습 규모
- 64 × A100으로 약 14일, 27 epoch
- 추론: RTX 4090 기준 약 6Hz (bf16) → 정밀하고 빠른 제어에는 아직 느리다. (§6 limitation에서 본인들도 인정)
RT-2 vs OpenVLA
| RT-2 | OpenVLA | |
|---|---|---|
| Backbone | PaLI-X 55B / PaLM-E 12B | Llama 2 7B |
| Vision encoder | 단일 ViT | DINOv2 + SigLIP (fused) |
| 학습 데이터 | web data + robot data co-fine-tuning | robot data만 (OXE 970K) |
| Action | 8D (terminate 포함), min-max 256 bins | 7D, quantile 256 bins |
| 공개 여부 | 비공개 | 코드·weight 공개 |
| Fine-tuning | - | LoRA, 4bit quantization 지원 |
참고 문헌과 문서
- OpenVLA: An Open-Source Vision-Language-Action Model — 논문 · HTML 원문 — v3
- OpenVLA 공식 프로젝트 페이지 — 아키텍처 개요와 실험·동작 예시.
- OpenVLA 공식 GitHub — README의 Getting Started에서 입력 준비와 action 추론 예제를 먼저 읽기.
- OpenVLA-7B 공식 모델 카드 — 체크포인트 사용법, 입력 형식, action 출력과 정규화 관련 설정 확인.
빠른 읽기 순서
- Figure 2 + §3.1 — DINOv2·SigLIP feature, Projector, Llama 2의 연결.
- §3.2 — 연속 action의 이산화, action token과 학습 목표.
- §3.3–3.4 — 로봇 학습 데이터와 주요 설계 선택.
- §6 Discussion and Limitations — 원본 모델의 입력 제약과 추론 속도·정밀 제어의 한계.
- 공식 GitHub 추론 예제 — 이미지·지시 입력부터 action 반환까지 코드와 논문 연결.
이번 리뷰의 기준은 2024년 원본 OpenVLA 논문이다. 공식 저장소에서 소개하는 후속 OpenVLA-OFT와는 버전을 구분해서 읽는다. Fine-tuning과 시뮬레이터 실행 문서는 이후 실습 단계에서 이어서 본다.
3. 작은 실습 — trajectory data와 Behavior Cloning
핵심 질문
trajectory data와 behavior cloning은 실제로 어떤 모양이지? 7B 모델을 직접 학습하는 건 무리니까, 거대 모델 대신 데이터 모양과 학습 루프만 정확히 잡고 가자. (실제로 돌려보는 건 LeRobot으로 다음에 진행 예정)
데이터 한 개 = episode
1
2
3
4
5
6
episode (= trajectory)
├── instruction: "pick up the red cup"
├── t=0: image o_0, robot state q_0, action a_0
├── t=1: image o_1, robot state q_1, action a_1
├── ...
└── t=T: image o_T, robot state q_T, action a_T
여기서 다시 OpenVLA 메모에서 쓴 포인트가 나온다. 경로 데이터지만 학습할 때는 결국
(o_t, instruction) → a_t
이 한 쌍씩 쪼개서 들어간다. 시간 순서는 데이터를 모을 때만 의미가 있고, 학습 샘플 하나하나는 독립적이다.
Behavior Cloning loss
BC는 그냥 지도학습이다. 사람이 그 순간 한 행동을 정답으로 놓고 따라 하게 만든다.
\[\mathcal{L}_{BC} = \mathbb{E}_{(o_t, g, a_t) \sim \mathcal{D}} \left[ \| \pi_\theta(o_t, g) - a_t \|^2 \right]\]- 연속값 action이면 → MSE (위 식)
- RT-2 / OpenVLA처럼 action을 token으로 바꿨으면 → cross-entropy (next-token prediction이랑 완전히 같은 loss)
1
2
3
4
5
6
for batch in loader:                      # (image, instruction, action)
    pred = policy(batch["image"], batch["instruction"])
    loss = F.mse_loss(pred, batch["action"])   # token 방식이면 cross_entropy
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
VLA 학습 = 거대한 BC. 구조가 VLM이라는 것만 다르고, loss는 nanoGPT 때 본 next-token cross-entropy 그대로다.
BC의 한계 — compounding error
학습 데이터는 사람이 잘한 경로뿐이다. 그래서 로봇이 조금이라도 경로를 벗어나면 한 번도 본 적 없는 상황에 들어가고, 거기서 또 실수하고… 오차가 눈덩이처럼 쌓인다. → 그래서 action을 한 개씩이 아니라 여러 step을 한 번에(action chunk) 예측하는 방법이 나왔고, 이게 바로 아래 π₀로 이어진다.
4. π₀
핵심 질문
왜 discrete token action 대신 flow matching인가?
참고 문헌과 문서
- π₀: A Vision-Language-Action Flow Model for General Robot Control — 논문 · HTML 원문
- Physical Intelligence 공식 블로그
- openpi 공식 GitHub
문제의식 — token action의 한계
RT-2 / OpenVLA 방식은 action을 256칸으로 쪼개서 한 번에 한 숫자씩 뽑는다.
- 7D action 하나 뽑는데 next-token을 7번 돌려야 한다. → 느리다 (OpenVLA ~6Hz)
- 256칸으로 자르니까 정밀한 움직임이 뭉개진다.
- 빨래 개기처럼 빠르고 섬세한 손재주(dexterous) 작업은 50Hz 정도는 나와야 한다.
그래서 π₀는 질문을 바꾼다.
“action을 굳이 언어처럼 만들어야 하나? 연속값을 그대로 생성하면 안 되나?”
구조 — VLM backbone + Action Expert
Step1 기본 개념 페이지에서 봤던 그 그림이다.
1
2
3
4
5
6
7
8
images (여러 카메라) + language instruction
        ↓
PaliGemma VLM (3B)          ← 이해 담당
        ↓  (attention으로 연결)
Action Expert (~300M)       ← 행동 생성 담당
   입력: robot state q_t + noisy action chunk
        ↓  flow matching (10 step 적분)
action chunk [a_t, a_t+1, …, a_t+49]   ← H = 50 step을 한 번에
- Action Expert는 별도 Transformer weight를 가진 작은 모듈이다. VLM 토큰과 같은 attention 안에서 섞이지만, weight는 따로 쓴다. (MoE에서 expert가 따로 있는 것과 비슷한 느낌)
- attention mask는 블록 단위다.
[이미지+텍스트]→[로봇 state]→[noisy action]순서로, 뒤 블록은 앞 블록을 볼 수 있지만 앞 블록은 뒤를 못 본다. - 출력은 discrete token이 아니라 연속값 action 50개 묶음(action chunk). 이게 compounding error도 줄이고 속도도 올린다.
Flow Matching — 아주 간단하게
Diffusion이랑 사촌이다. 노이즈에서 출발해서 정답 action으로 가는 “속도장(vector field)”을 학습한다.
\[A^\tau = \tau A + (1 - \tau)\epsilon, \quad \epsilon \sim \mathcal{N}(0, I)\] \[\mathcal{L} = \left\| v_\theta(A^\tau, o_t) - (A - \epsilon) \right\|^2\]- τ = 0이면 완전 노이즈, τ = 1이면 정답 action chunk A
- 모델 v_θ는 “지금 위치에서 정답 쪽으로 어느 방향으로 가야 하나”를 배운다.
- 추론 때는 노이즈에서 시작해서 이 방향을 따라 10 step 정도 적분하면 action chunk가 나온다.
RT-2/OpenVLA: action = 언어 token (discrete, 한 개씩)
π₀: action = 연속값 chunk (flow matching, 50개 한 번에)
Pre-training / Post-training
LLM이랑 똑같은 2단계다.
| 단계 | 데이터 | 목적 |
|---|---|---|
| Pre-training | 7가지 로봇 구성, 68개 task의 10,000시간 이상 자체 데이터 + OXE | 다양한 로봇·작업에 대한 범용 능력. 실수했을 때 회복하는 법도 배움 |
| Post-training | 특정 작업의 고품질 데이터 (빨래 개기, 박스 조립 등) | 그 작업을 빠르고 깔끔하게 잘하도록 다듬기 |
재미있는 점은, 고품질 데이터로만 학습하면 실수했을 때 어떻게 할지를 모른다는 거다. 그래서 pre-training에서는 지저분한 데이터도 일부러 많이 넣는다. (LLM에서 pre-training은 넓게, fine-tuning은 깔끔하게 하는 것과 같은 논리)
정리 — RT-2 vs OpenVLA vs π₀
| RT-2 | OpenVLA | π₀ | |
|---|---|---|---|
| Backbone | PaLI-X 55B / PaLM-E | Llama 2 7B (Prismatic) | PaliGemma 3B |
| Action 표현 | text token (8D × 256 bins) | text token (7D × 256 bins) | 연속값 action chunk (H=50) |
| Action 생성 | next-token prediction | next-token prediction | Action Expert + flow matching |
| 제어 속도 | ~1–3 Hz | ~6 Hz | 최대 50 Hz |
| 나만의 언어 | action도 언어다 | action도 언어다, 근데 공개 + 가볍게 | action은 언어가 아니라 움직임이다 |
핵심 정리
- VLA = VLM + action을 출력하는 방법. 구조의 대부분은 VLM과 같다.
- RT-2는 action을 256 bins token으로 바꿔서 VLM의 next-token prediction을 그대로 썼다. web data를 같이 섞는 co-fine-tuning이 핵심.
- OpenVLA는 같은 아이디어를 7B 공개 모델로 구현했다. DINOv2 + SigLIP, vision encoder까지 학습, LoRA로 싸게 적응.
- token 방식은 느리고 정밀도가 떨어진다. π₀는 Action Expert + flow matching으로 연속값 action chunk를 한 번에 생성한다.
- 학습 자체는 결국 거대한 Behavior Cloning이다.