
π₀.₆ - RECAP (π*₀.₆) + MEM
π₀.₆ 위에 올라간 두 논문을 같이 정리했다. RECAP은 경험으로 행동을 얼마나 잘 하게 만들고, MEM은 시간에 걸친 맥락을 어떻게 기억하게 만들까?
Introduction
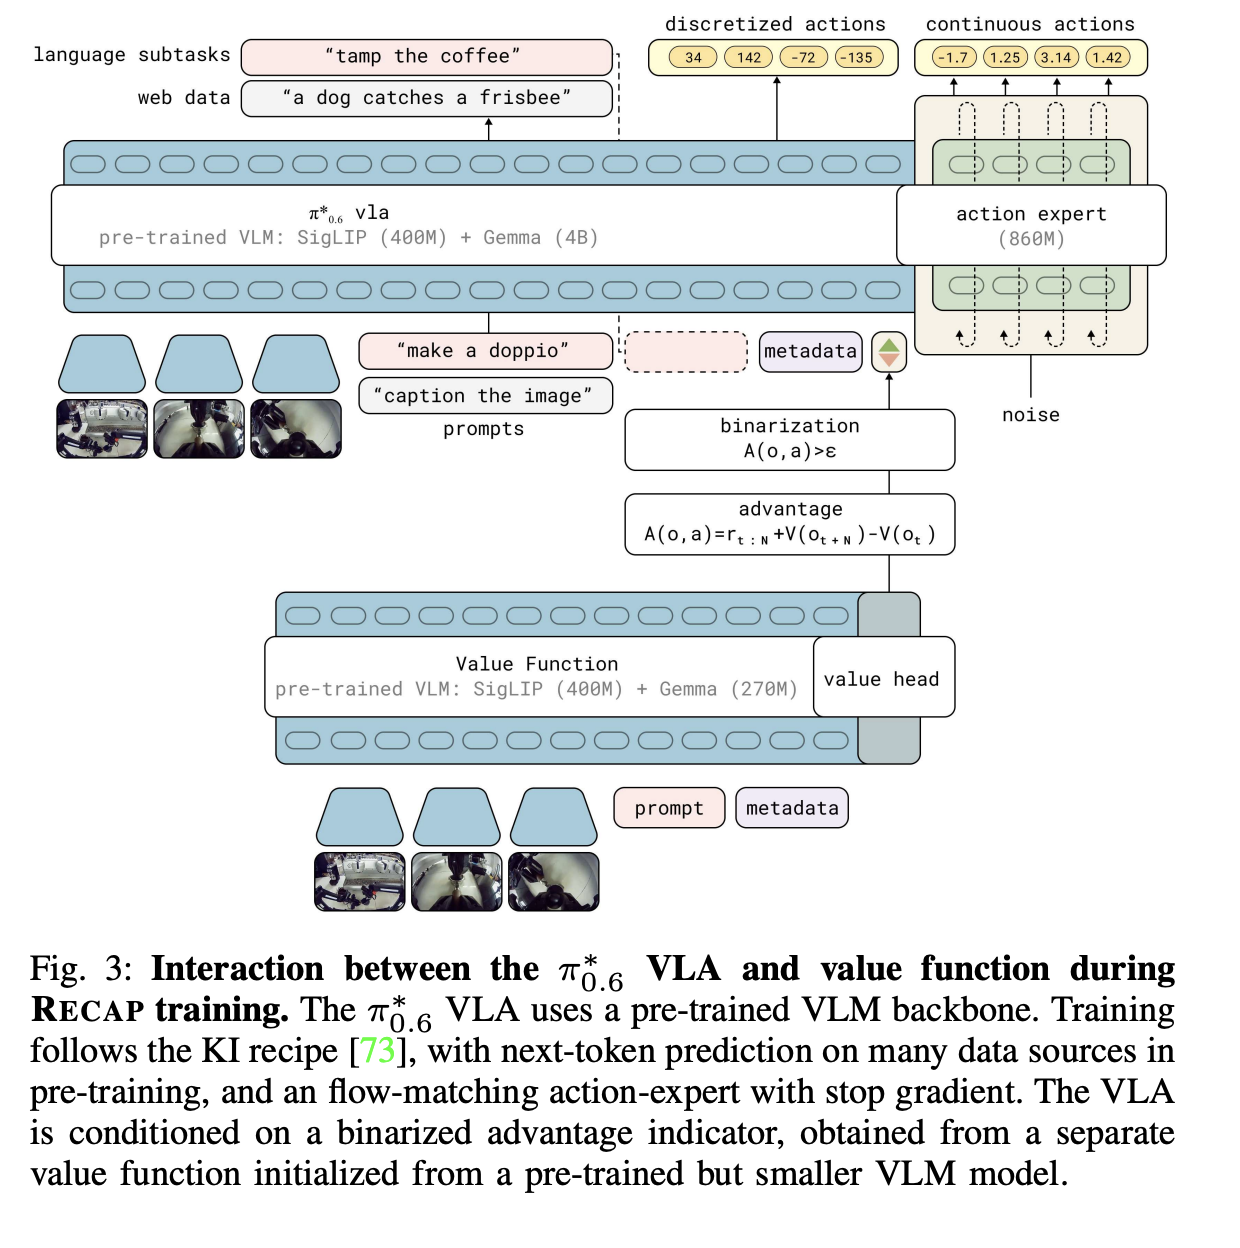
π₀.₆는 Physical Intelligence의 base VLA다. π₀.₅에서 출발해서 몇 가지를 키운 모델인데, 정리하면 이렇다. (π*₀.₆ 논문 p.6)
- pre-training dataset에 여러 robot platform 데이터를 더 넣었다
- base VLM이 Gemma 3 4B
- action expert를 860M parameter로 키웠다
구조 자체는 π₀.₅와 같다. VLM이 먼저 다음 subtask를 text로 뱉고(e.g) “pick up the coffee cup”), 그걸 보고 action expert가 flow matching으로 action chunk를 만든다.
이 페이지는 이 π₀.₆ 위에 올라간 논문 두 개를 같이 정리한다.
- Part 1. π*₀.₆ / RECAP: 경험(experience)으로부터 배우기 → 행동을 얼마나 잘 하느냐
- Part 2. MEM: memory → 시간에 걸친 맥락
Part 1. π*₀.₆ — RECAP: 경험으로 배우는 VLA
논문: π*₀.₆: a VLA That Learns From Experience · arXiv:2511.14759
핵심 요약
π*₀.₆는 RECAP을 통해 demonstration뿐 아니라 autonomous rollout, 성공·실패 결과, human intervention을 함께 학습하는 VLA다. Advantage-conditioned policy와 value function을 사용해 실제 배치 경험으로 정책을 개선하며, imitation learning을 넘어 작업의 성공률·안정성·처리 속도를 높이는 것이 핵심이다.
Q. Imitation learning만으로는 왜 부족할까?
- Imitation learning으로 학습한 policy는 compounding error에 시달리고, 아무리 잘해봐야 demonstration 데이터 수준까지만 간다. (p.2)
- 사람 teleoperation보다 빠르고 robust하게 하려면, 배치했을 때 자기가 실제로 저지르는 실수를 보고 고쳐야 한다. demo만 따라해서는 그 실수 데이터가 없다.
- 그럼 RL을 하면 되는데… 문제는 π₀.₆ 같은 flow matching VLA에는 tractable한 log-likelihood가 없어서 PPO 같은 policy gradient를 붙이기가 어렵다. (p.4)
→ 나만의 언어: 선생님 따라하기만 하면 선생님보다 잘할 수는 없다. 직접 해보고 망해봐야 는다.
Q. RECAP은 어떤 loop로 돌아갈까?
RECAP = RL with Experience and Corrections via Advantage-conditioned Policies. 아래 3단계를 한 번 이상 반복한다. (p.3)
- Data collection: VLA를 task에 돌리고 episode마다 성공/실패 label을 단다. 필요하면 사람이 중간에 개입(intervention)해서 correction을 준다.
- Value function training: 지금까지 모은 데이터 전부로 multi-task value function $V^{\pi_{ref}}$를 학습한다.
- Advantage conditioned training: value function으로 advantage를 계산하고, 그걸로 만든 improvement indicator를 VLA prefix에 넣어서 policy를 학습한다.
여기서 데이터 소스는 3종류다.
- Demonstrations: 사람이 teleoperation으로 만든 시범
- Autonomous rollouts: policy가 혼자 해본 episode (최신 policy + 예전 policy 것도 다 쓴다)
- Human interventions / corrections: 자율 실행 중에 사람이 끼어들어 고친 구간 → 이건 무조건 “좋은 action”으로 취급 ($I_t = \text{True}$ 강제)
전체 순서는 이렇다. (Algorithm 1, p.6~7)
- 전체 demo 데이터로 offline RL pre-training (V, π 둘 다)
- target task demo로 finetune. 이때는 $I_t$를 전부 True로 고정 → 사실상 SFT
- 그 policy로 데이터 수집 → V, π를 다시 학습 → 반복
재미있는 점은 매 iteration마다 직전 모델이 아니라 pre-trained checkpoint에서 다시 finetune한다는 것. iteration 돌면서 drift가 생기는 걸 막으려고. 그리고 실제로는 iteration 한 번만 해도 꽤 좋아진다고 한다. (p.7)
(!!correction만으로 다 되는 거 아님? → 아니다. 사람이 끼어드는 것 자체가 흐름을 끊고, 사람도 일정한 품질로 개입을 못 하고, 속도 같은 미묘한 부분은 못 고친다. 그래서 correction은 큰 실수 막기용이고, 나머지 디테일은 autonomous data + RL이 담당한다. p.7)
Q. Value function은 뭘 예측하고, 어떻게 학습할까?
먼저 reward가 엄청 단순하다. episode마다 성공/실패 label 하나뿐이다. (Eq.5, p.7)
\[r_t=\begin{cases}0 & t=T \text{ and success}\\ -C_{fail} & t=T \text{ and failure}\\ -1 & \text{otherwise}\end{cases}\]→ 매 step마다 -1이니까, value = 성공까지 남은 step 수의 음수가 된다. 실패한 episode는 $C_{fail}$ 때문에 큰 음수. task마다 길이가 다르니까 task별 max episode length로 나눠서 $(-1, 0)$ 사이로 normalize한다.
학습은 distributional하게 한다. empirical return $R_t(\tau)$를 B = 201개 bin으로 discretize하고 cross-entropy로 맞춘다. (Eq.1, p.4)
\[\min_\phi\ \mathbb{E}_{\tau\in D}\left[\sum_{o_t\in\tau} H\left(R^B_t(\tau),\ p_\phi(V\mid o_t,\ell)\right)\right]\]연속값이 필요하면 bin 확률로 가중평균: $V^{\pi_{ref}}(o_t,\ell)=\sum_b p_\phi(V=b\mid o_t)\,v(b)$
- 이건 Monte Carlo estimator라서, 지금까지 데이터를 만든 behavior policy $\pi_{ref}$의 value다. Q-learning처럼 optimal value를 배우는 게 아니다. 논문도 덜 optimal하지만 simple하고 reliable해서 이걸 썼다고 한다. (p.4)
- 구조는 VLA와 같은데 backbone만 작은 670M VLM (Gemma 3에서 init). overfitting 막으려고 web multi-modal 데이터도 조금 섞어서 co-train한다. (p.7)
→ 나만의 언어: “지금 이 장면이면 성공까지 얼마나 남았지?”를 맞추는 시계. Fig.4를 보면 셔츠를 구기는 순간 값이 뚝 떨어지고, 다시 회복하면 올라간다.
Q. Advantage는 어떻게 계산하고, policy에는 어떻게 넣을까?
Advantage는 n-step estimate로 계산한다. (p.3)
\[A^{\pi_{ref}}(o_t,a_t)=\mathbb{E}\left[\sum_{t'=t}^{t+N-1} r_{t'}+V^{\pi_{ref}}(o_{t+N})\right]-V^{\pi_{ref}}(o_t)\]→ “이 action을 했더니 평소 예상보다 나아졌냐?”
이걸 그대로 쓰지 않고 binarize해서 improvement indicator $I_t$를 만든다.
\[I_t=\mathbb{1}\left[A^{\pi_{ref}}(o_t,a_t,\ell)>\epsilon_\ell\right]\]threshold $\epsilon_\ell$은 task별로, value function이 그 task에서 예측한 값들의 30% percentile로 잡는다. (p.7)
Policy loss는 indicator가 없는 버전과 있는 버전을 같이 학습한다. (Eq.3, p.5)
\[\min_\theta\ \mathbb{E}_{D_{\pi_{ref}}}\left[-\log\pi_\theta(a_t\mid o_t,\ell)-\alpha\log\pi_\theta(a_t\mid I_t,o_t,\ell)\right]\]실제 구현은 정말 단순하다. (p.6)
- VLA input에 text로
"Advantage: positive"/"Advantage: negative"를 넣는다. - 위치는 subtask 예측 $\hat{\ell}$ 뒤, action 앞. 그래서 action likelihood에만 영향을 준다.
- 학습할 때 $I_t$를 random하게 빼버린다 → conditional / unconditional 둘 다 배운다. (classifier-free guidance랑 같은 아이디어)
Inference에서는 $I_t = \text{True}$로 고정하고 sample한다. 이론적으로는 아래 식에서 $\beta=1$인 경우고, 이때 $\hat\pi = \pi_{ref}(a\mid I,o,\ell)$이 된다. 더 세게 밀고 싶으면 CFG로 $\beta>1$도 가능하지만 기본은 $\beta=1$이다. (Eq.2, p.5 / p.9)
\[\hat{\pi}(a\mid o,\ell)\propto\pi_{ref}(a\mid o,\ell)\left(\frac{\pi_{ref}(a\mid I,o,\ell)}{\pi_{ref}(a\mid o,\ell)}\right)^{\beta}\]Q. 그럼 AWR이나 PPO는 왜 안 쓸까?
- PPO: flow matching이라 log-likelihood가 tractable하지 않다. 실험에서도 off-policy setting에서 안정화하려고 trust-region을 아주 작게($\eta=0.01$) 잡아야 했고, 성능이 안 나왔다. (p.10)
- AWR: advantage로 weight를 주니까 데이터 상당 부분을 버리거나 downweight한다 → 사실상 filtered imitation. success rate는 괜찮았는데 policy가 훨씬 느려서 throughput이 낮았다. (p.4, p.10)
- Advantage conditioning: 좋은 데이터든 나쁜 데이터든 전부 supervised로 학습한다. 대신 꼬리표를 달아서.
→ 나만의 언어: 모든 데이터를 다 먹이는데 “이건 잘한 거 / 이건 별로인 거” 꼬리표를 붙여서 먹인다. 그리고 실전에서는 “잘한 거 버전으로 해!”라고 부른다.
핵심: 나쁜 데이터도 버리지 않는다. 대신
Advantage: negative꼬리표를 달아준다. 이렇게 하면 RL을 하면서도 loss는 그냥 supervised learning이다.
결과
평가 task는 laundry 3종(T-shirt & shorts / diverse items / targeted failure removal), cafe(double shot espresso), box assembly다. 각 task는 5~15분짜리 multi-step task다. (p.7~8) 지표는 throughput(시간당 성공 횟수 → 성공률 + 속도를 같이 봄)과 success rate.
- 가장 어려운 diverse laundry, espresso에서 on-robot 데이터를 넣으니(offline RL + SFT → 최종 π*₀.₆) throughput이 2배 이상, failure rate는 약 절반. (p.9, Fig.7·8)
- diverse laundry를 빼면 모든 task에서 최종 success rate가 90%+. (p.9)
- Iteration 실험 (p.10)
- T-shirt laundry: 사람 correction 없이 autonomous data만, iteration당 300 trajectories(robot 4대) → throughput 50% 개선. 첫 iteration에서 이미 success rate 90% 넘음.
- Box assembly: iteration당 autonomous 600 + intervention 360 trials → 2번째 iteration 후 throughput 2×. 접기·label 붙이기는 600초 안에 약 90% 성공.
- AWR, PPO와 비교하면 throughput이 압도적으로 높다. (p.10, Fig.11)
- Failure mode 제거: 셔츠 collar가 위를 향해야만 성공인 엄격한 task에서, iteration 2번(각 600 trajectories) → 97% 성공. intervention이나 추가 demo 없이 RL만으로. (p.11)
- 실사용 수준: espresso를 13시간 연속, 새 집에서 처음 보는 빨래를 2시간 넘게 중단 없이 갰다고 한다. (p.2)
내 생각
- 제일 재미있는 건 RL인데 loss는 결국 supervised라는 것이다. policy gradient를 안 쓰고 “꼬리표 붙인 imitation”으로 policy improvement를 얻는다. flow matching VLA에서 log-likelihood 문제를 이렇게 우회한 게 깔끔하다.
- reward가 성공/실패 label 하나뿐인데, 이걸 “성공까지 남은 step 수”로 바꾸니까 속도까지 같이 최적화된다. throughput이 크게 오른 이유가 여기 있는 것 같다.
- 여기서 햇갈렸던 점: value function은 optimal value가 아니라 $\pi_{ref}$(지금까지 데이터가 섞인 behavior policy)의 value다. 그래서 한 번에 최적으로 가는 게 아니라, iteration을 돌면서 조금씩 올라가는 구조다.
- 한계는 논문도 인정한다. reward label, intervention, reset을 다 사람이 해야 해서 완전 자율이 아니고, exploration도 policy의 stochasticity + 사람 개입에 기대는 꽤 greedy한 방식이다. (p.11)
Part 2. MEM — Memory
논문: MEM: Multi-Scale Embodied Memory for Vision Language Action Models · arXiv:2603.03596
핵심 요약
π₀.₆ + MEM은 최근 장면을 압축하는 short-term video memory와 과거 사건·task progress를 언어로 저장하는 long-term text memory를 결합한다. 이를 통해 가림과 partial observability에 대응하고, 이전 실패를 바탕으로 전략을 수정하며, 최대 15분 규모의 long-horizon task를 수행하는 것이 핵심이다.
Architecture
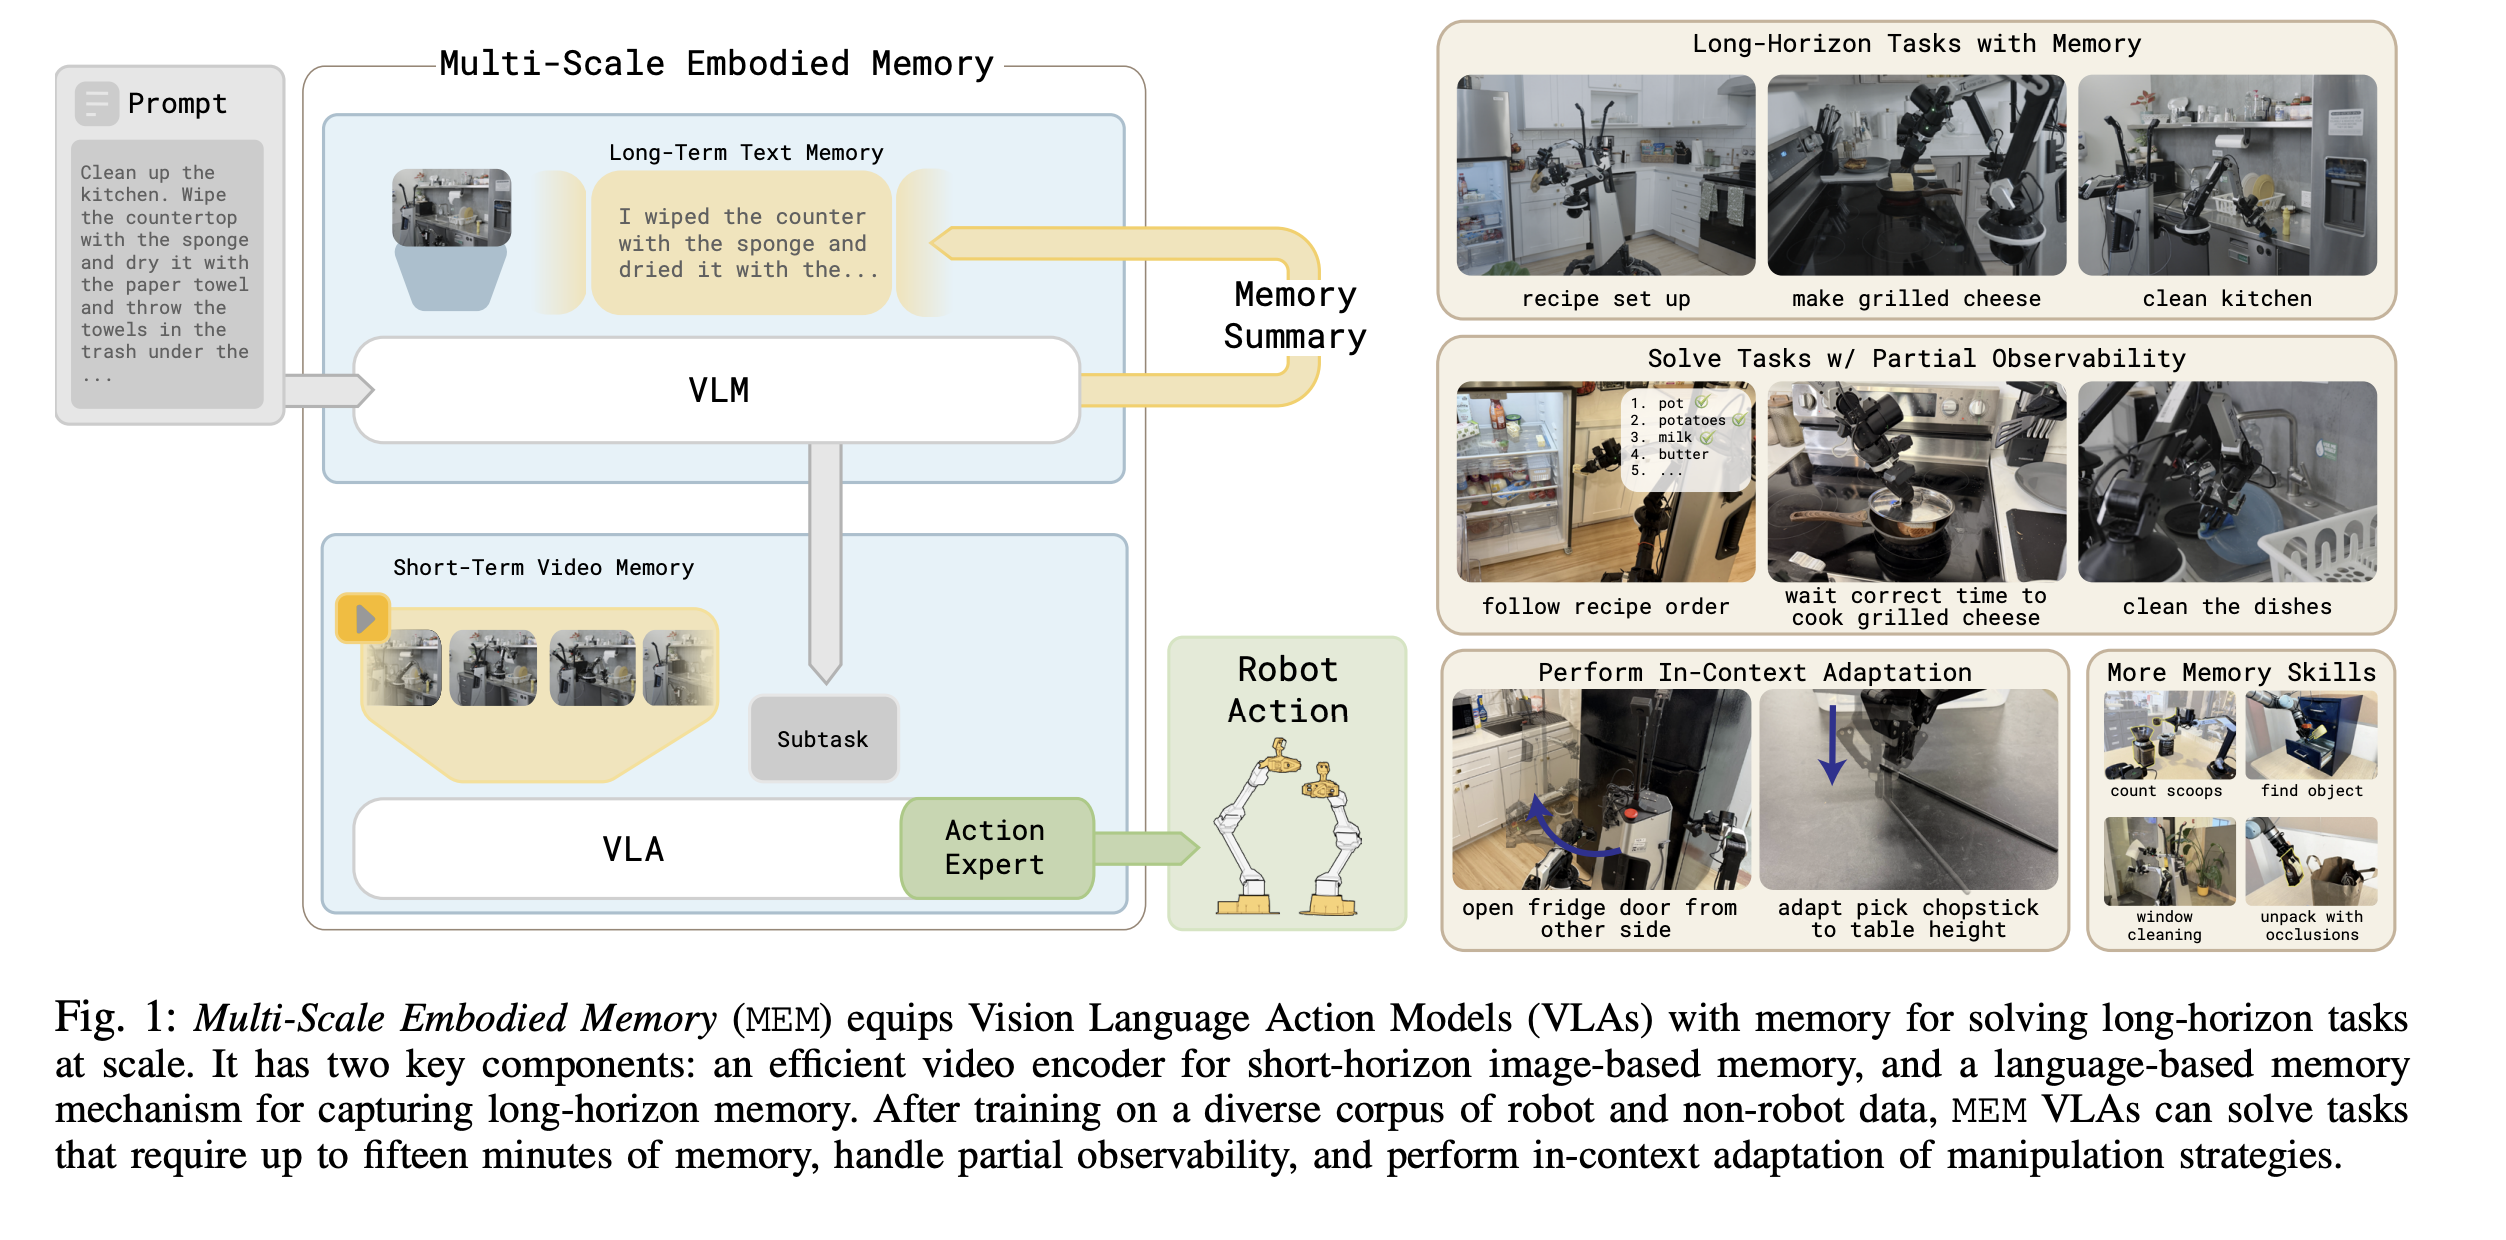
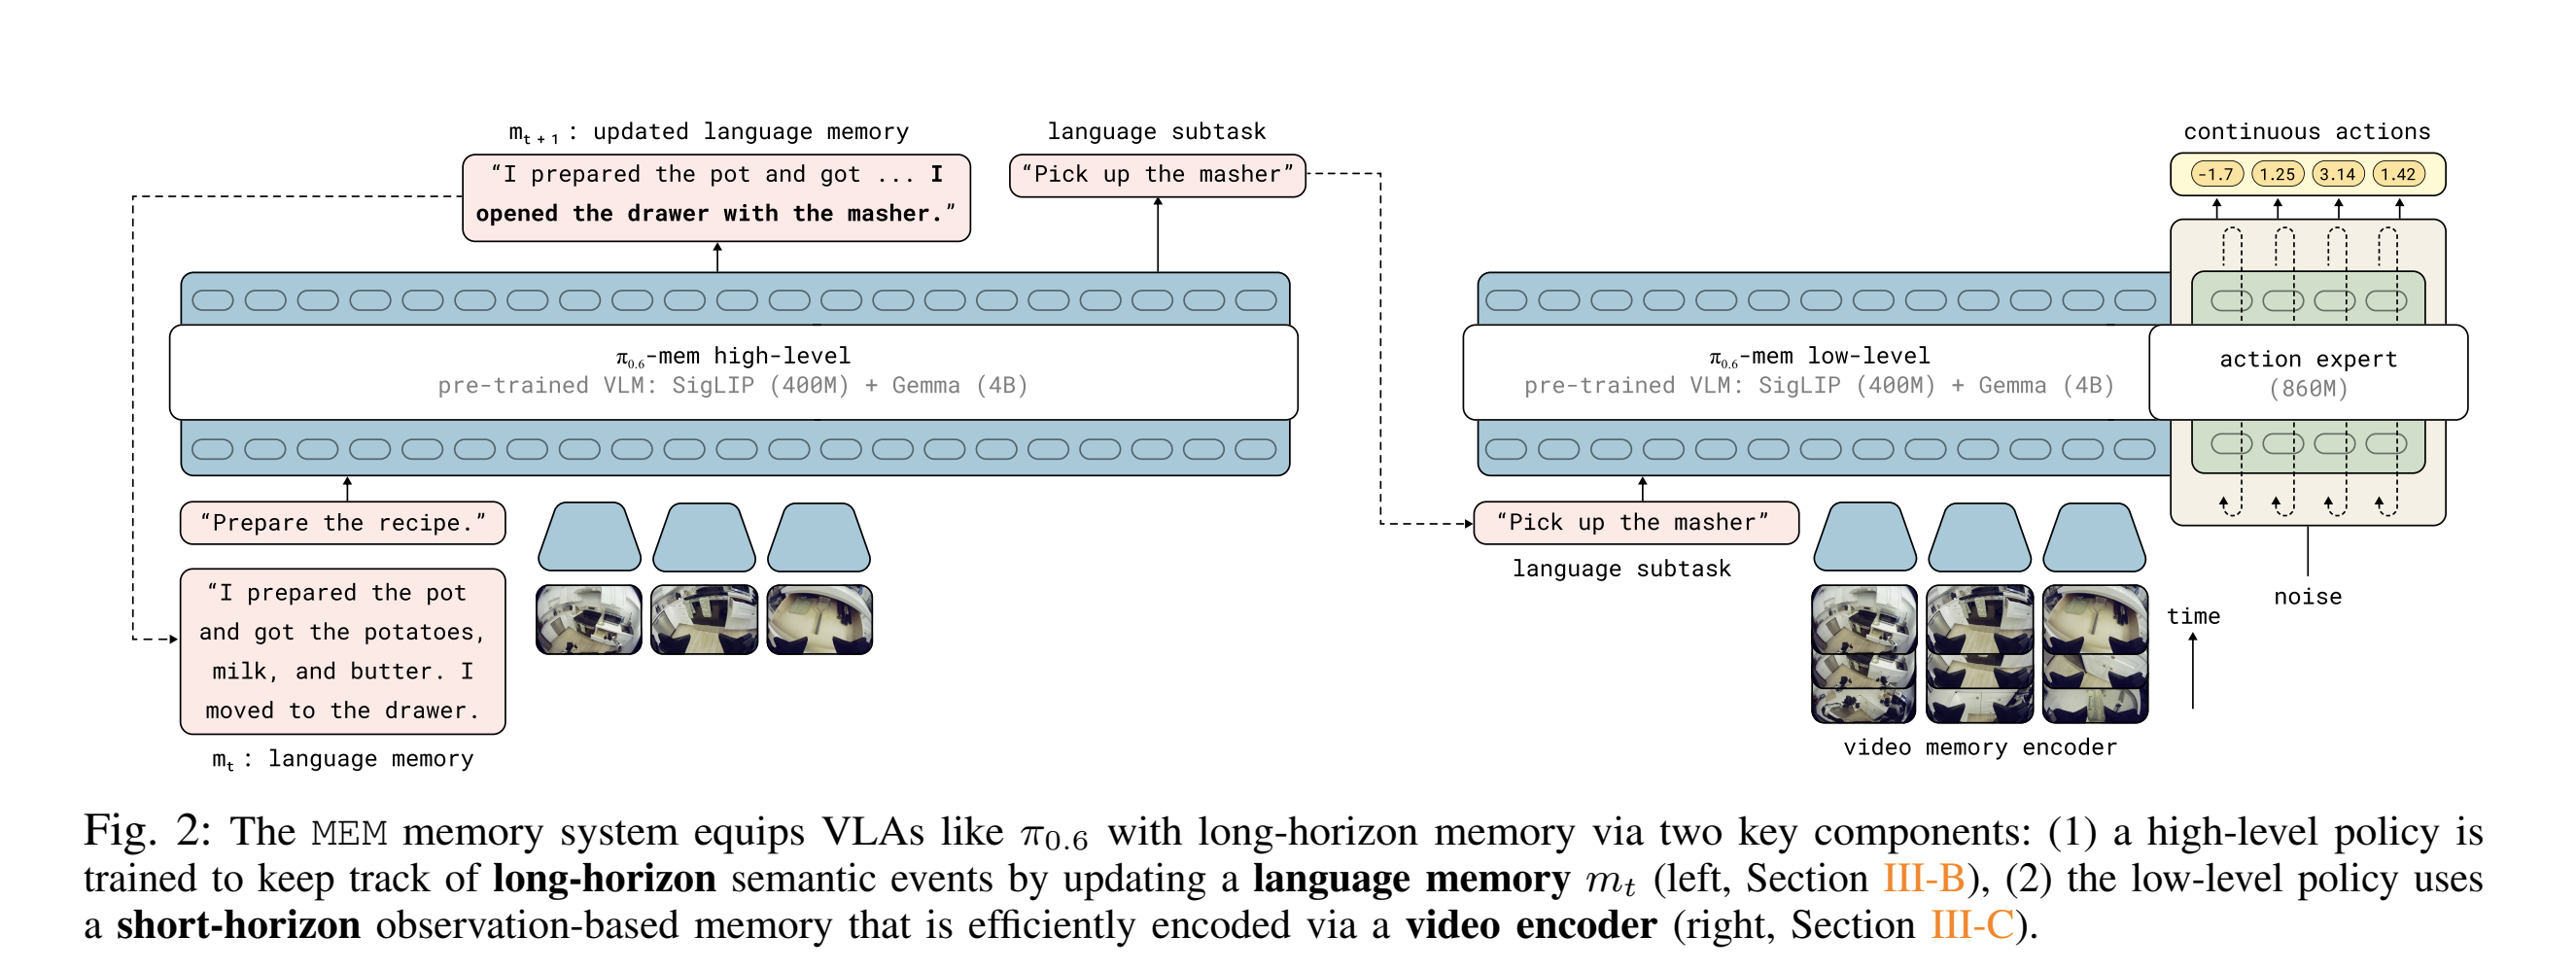
여기서 구조의 핵심은 바로, VLM이 output을 하나더 하는 것이다. 그게 바로 m_t 메모리이다.
즉, 무엇을 기억할지를 VLM이 알게 하는 것이다. 그리고 VLA로 사용할때는, short term video memory + image + subtask를 같이 넣어주고 action expert로 흐르도록 한다.
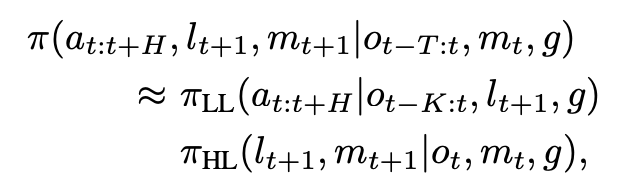
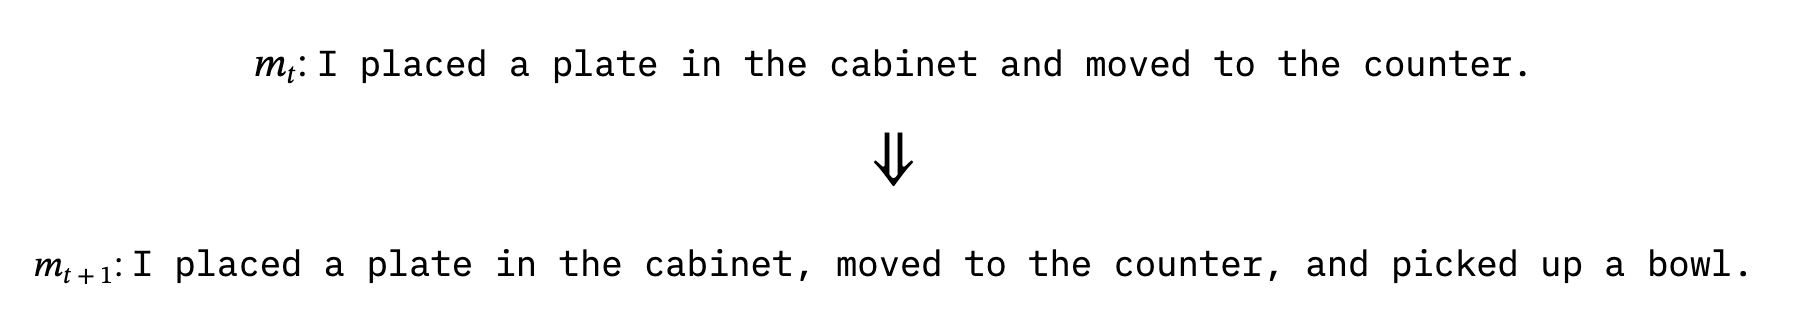
여기서 재미있는 사실은 기억을 장기/단기로 나눈다. 쉽게 설명하면
- 장기의 경우, text로 계속해서 기억한다
- 단기의 경우, 시각정보(image token)을 특정 시간 , e.g) t, (t-1), … (t-5) 동안 저장해놓는다.
Language Memory for Long-Term Memory
Given a robot episode with subtask language annotations l0:T , we pass the subtask instructions together with an indicator whether the subtask execution failed or succeeded to an off-the-shelf pre-trained language model (LLM) and ask it to summarize all information from the previous subtasks that is still relevant for future task execution. We collect the corresponding output and use it to label the sequence for training the high-level policy
시간이 지나면서, 계속해서 m_t는 업데이트가 되는 구조이다. 즉, VLM은 m_t를 업데이트 하도록 설계되었다.
Video Encoder - for Dense Short-Term Visual Memory
1. 먼저, 공간에 대해서 attention을 진행한다. (image encoder와 동일함)
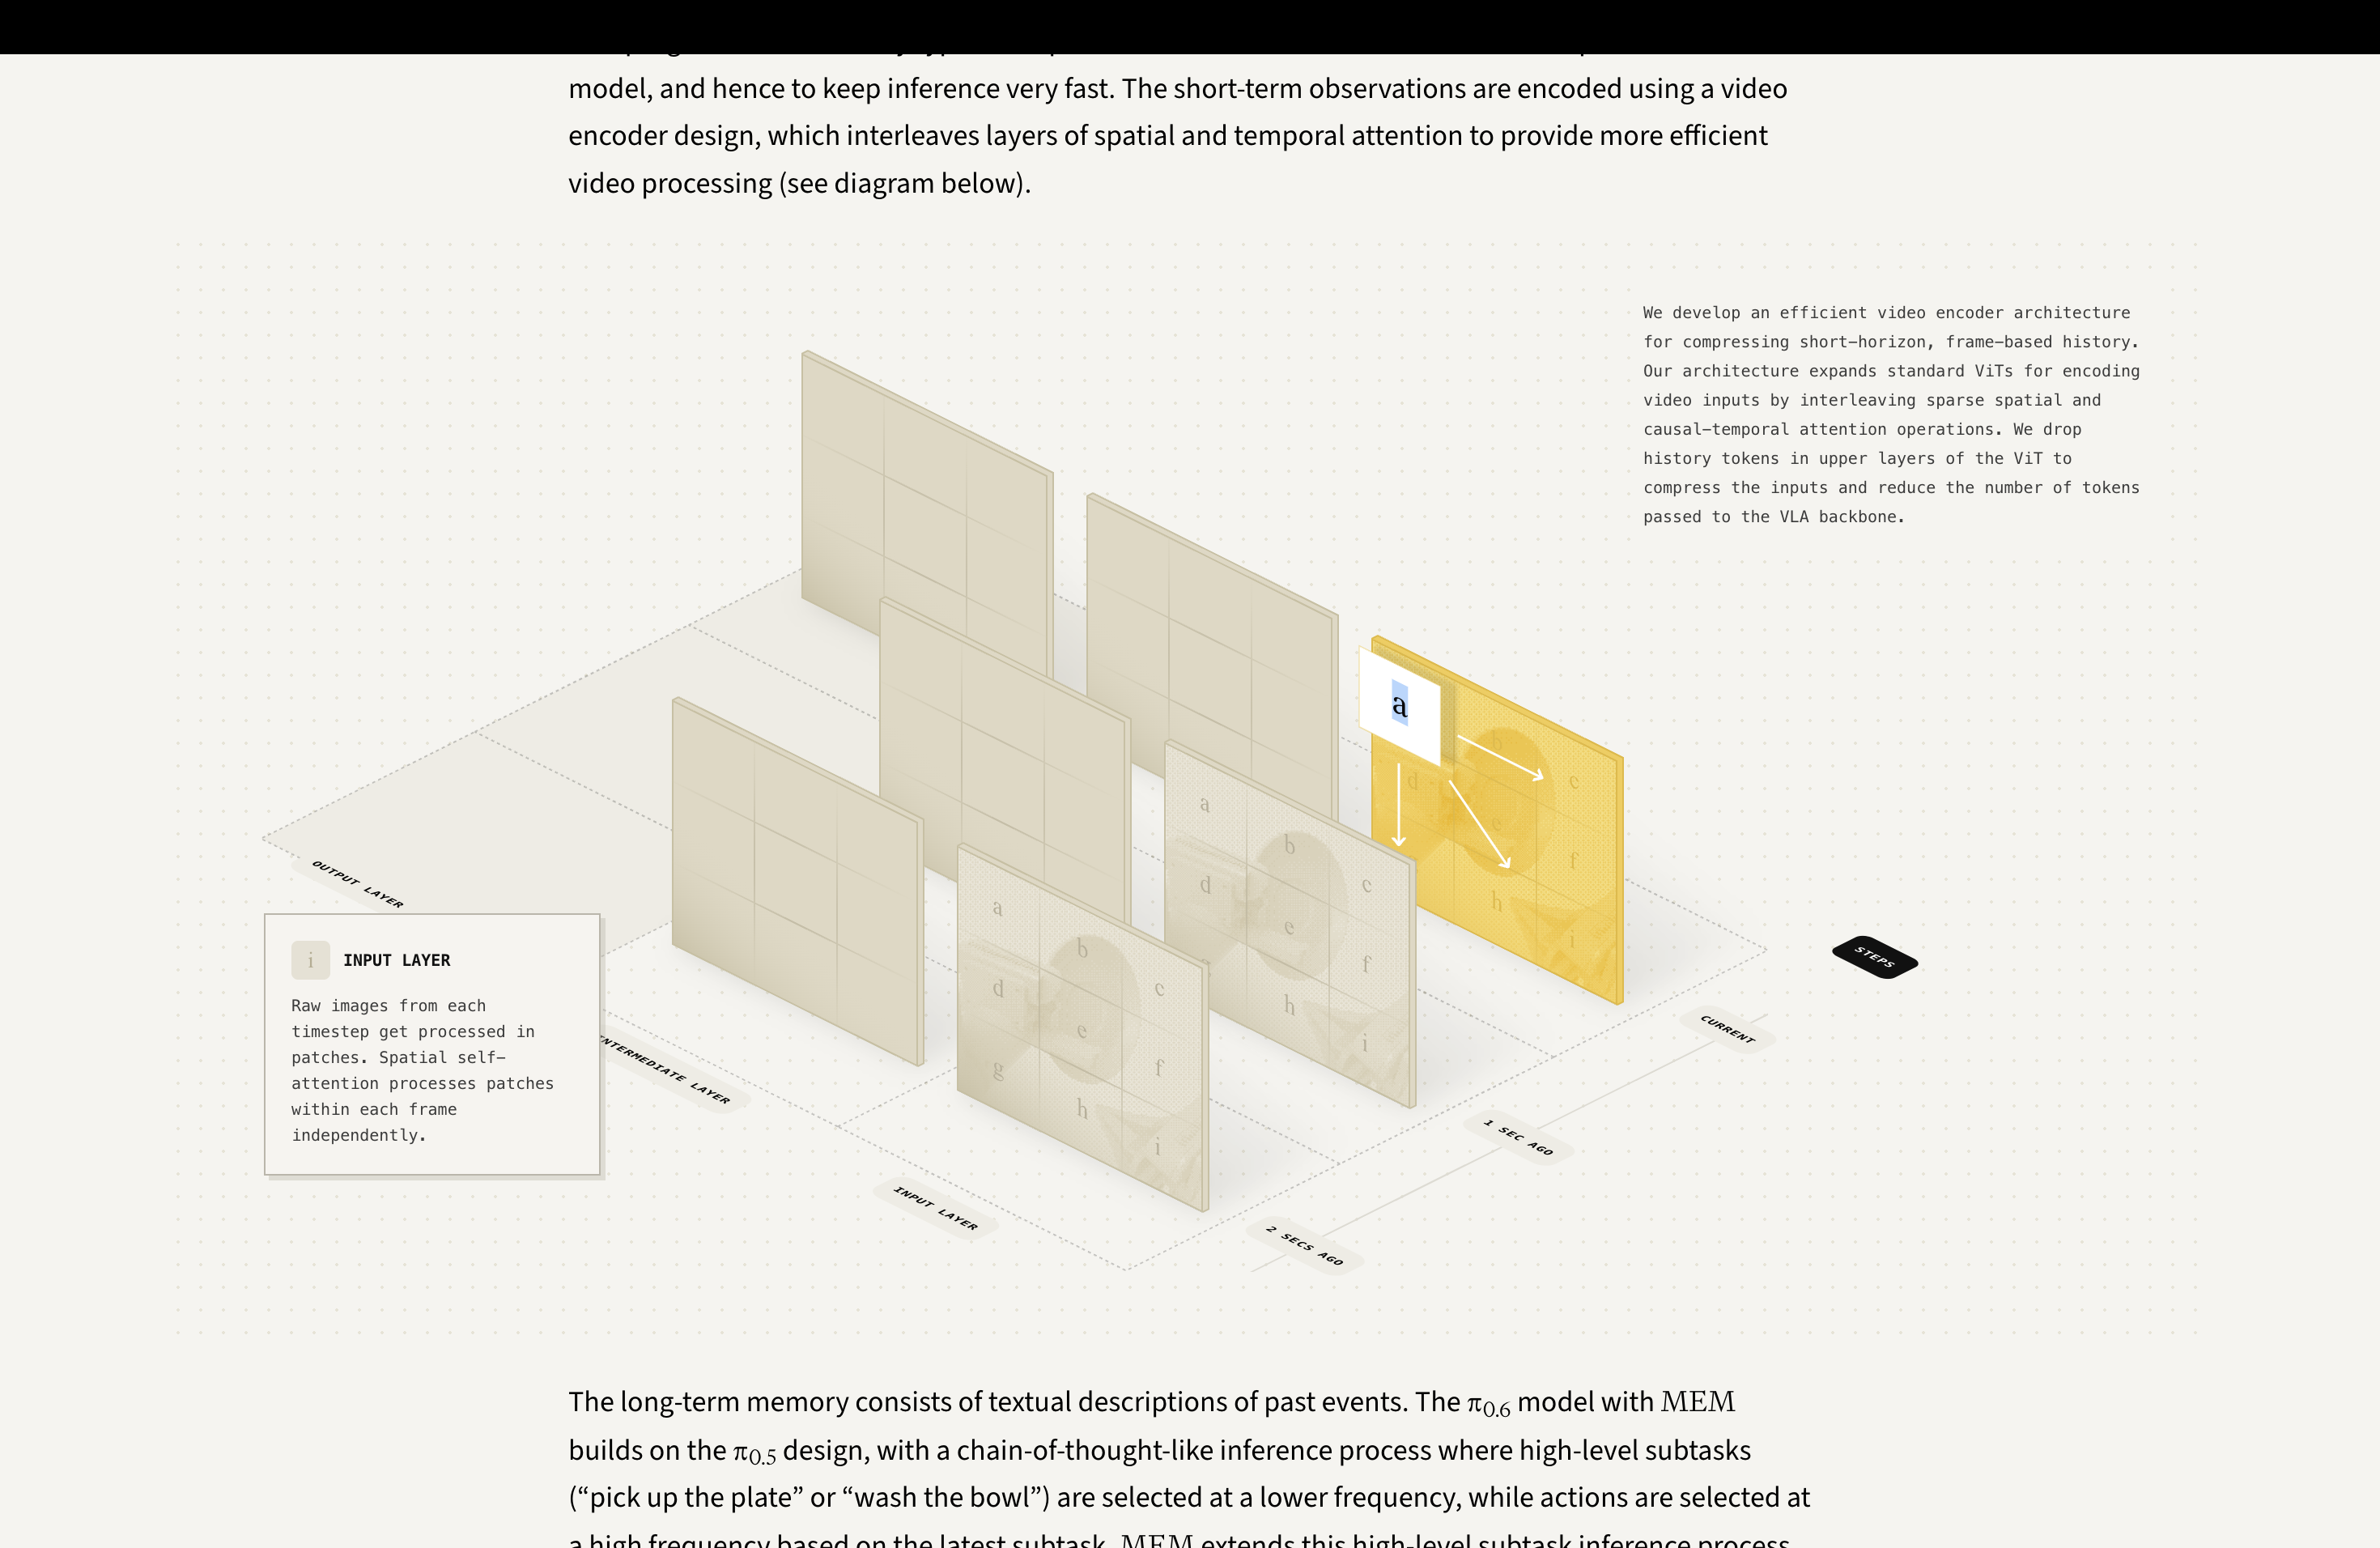
2. 그다음에 이제 temporal and spatial attention
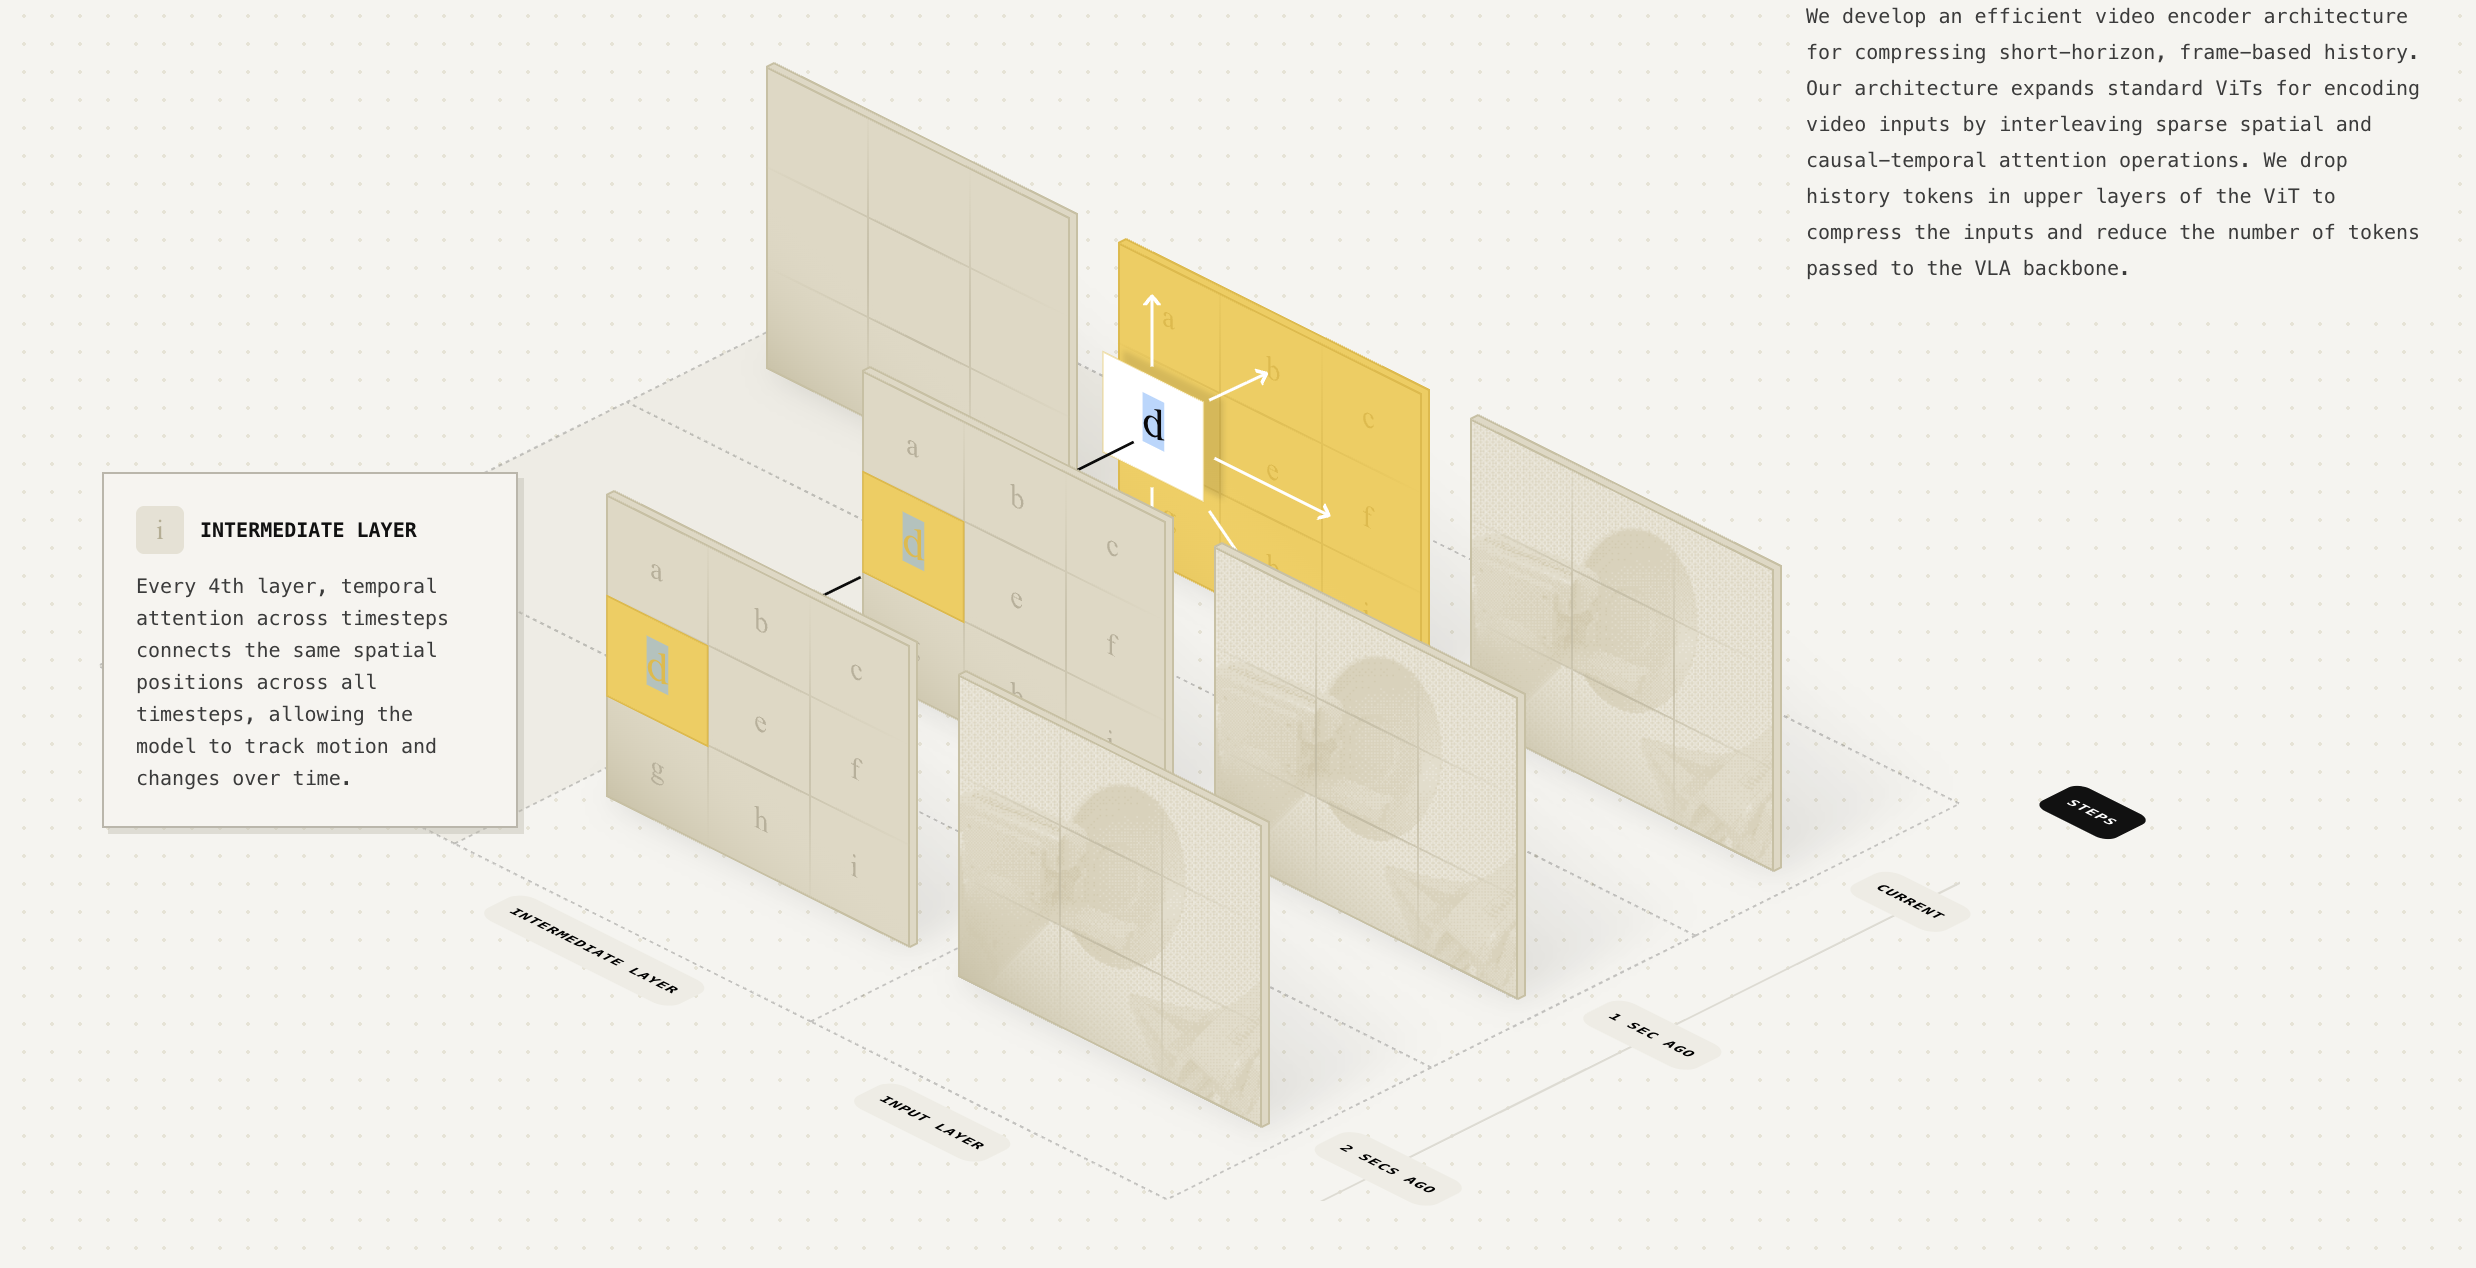
오케이 일단 그렇게 video encoder를 진행하고 나머지는 전부다. 이전 pi_0.5와 동일하다.
결과
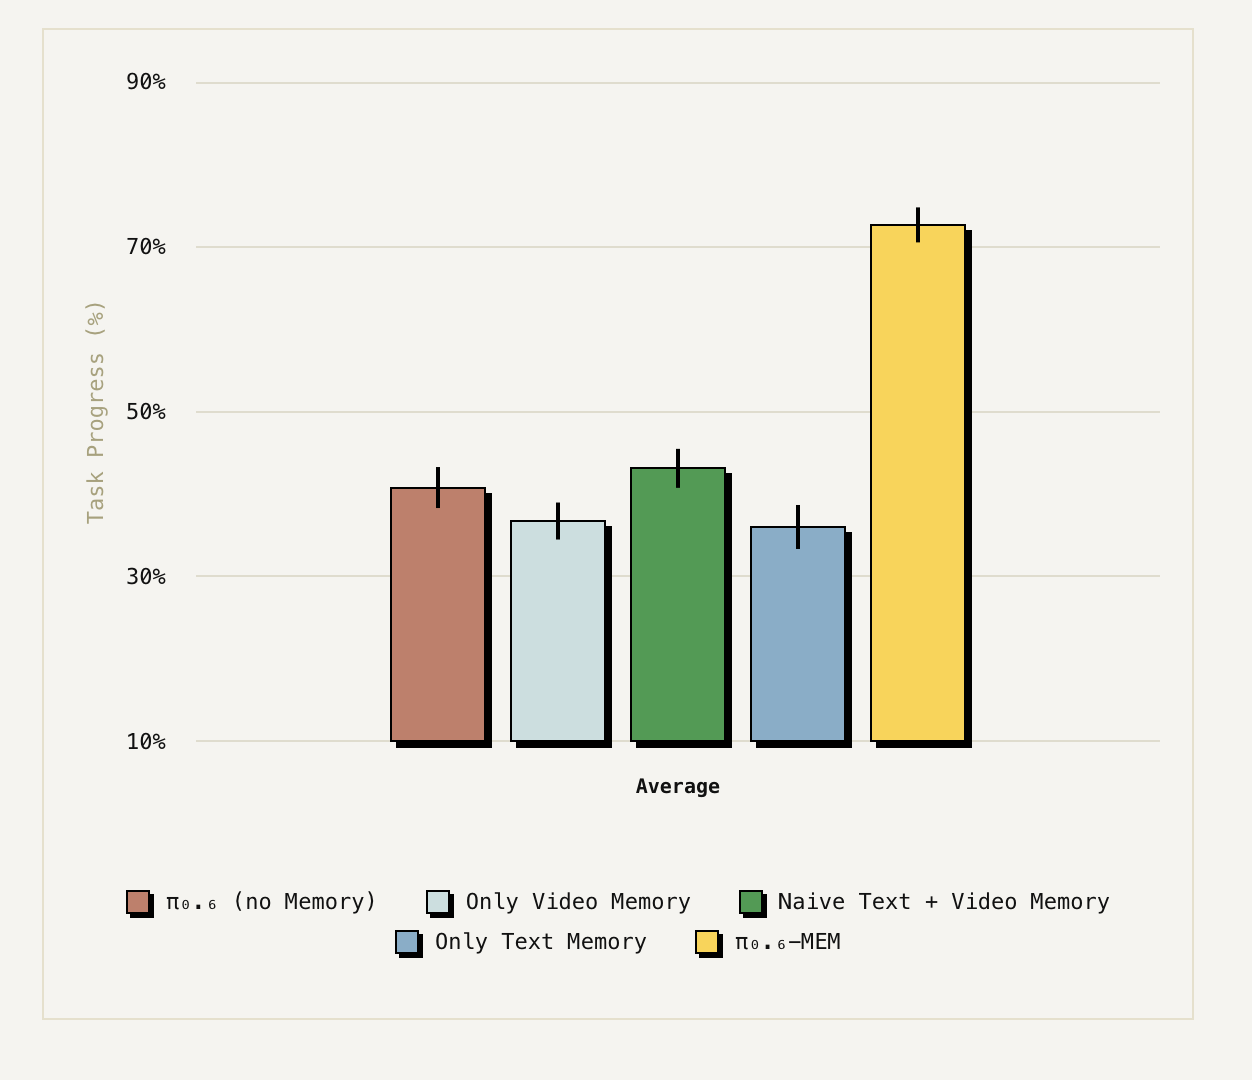
- Long-horizon task (최대 15분): recipe set up, clean kitchen에서 memory 없는 π₀.₆는 제대로 못 한다. ablation을 보면 video memory만, text memory만 있는 버전 모두 떨어지고 둘 다 있어야 풀린다. 과거 subtask를 그냥 이어붙이는 “naive” text memory도 확실히 나쁜데, 학습 데이터(거의 최적 demo)에서는 같은 subtask가 한 번씩만 나오는데 inference에서는 실패하면 “pick up bowl”이 반복되니까 train-inference distribution shift가 생긴다. (MEM p.5~6, Fig.6 / policy·task당 10 rollouts)
- In-context adaptation: 낮은 table에서 chopstick 집기, 어느 쪽으로 열리는지 모르는 fridge 열기 → memory가 있으면 직전 실패를 보고 전략을 바꾼다. Fig.7에서 두 task 모두 memory 있을 때 success rate가 오른다 (그림에 +11%, +62%로 표시). (p.7)
- 다른 memory 방식과 비교: memory 없는 π₀.₆는 사실상 찍기 수준이다. 서랍 4개 중 물건 찾기 25%, coffee scoop 더 넣을지 50%. Pool Memory(과거 frame average pooling)는 오래 기억해야 하는 task에서, Proprio Memory(과거 robot state만)는 환경 상태를 기억해야 하는 task에서 약하다. 모든 capability에서 잘하는 건 MEM뿐. (p.8, Fig.8)
- Pre-training이 중요 + 성능 손해 없음: video encoder를 post-training에서만 붙이면 확실히 못하다 (pre-train 5초 → post-train 최대 1분으로 늘려도 pre-train한 쪽이 낫다). 그리고 memory가 필요 없는 dexterous task에서도 π₀.₆ 성능을 그대로 맞춘다. (p.8~9, Fig.9·10)
MEM의 이득
- Self-occlusion / partial observability 대응: 현재 frame에서 물체가 로봇 팔 등에 가려져도 최근 video memory를 이용해 직전의 위치와 상황을 유지할 수 있다.
- 동작의 시간적 흐름 이해: 한 장의 image만 보는 것이 아니라 최근 여러 observation을 보므로, 얼마나 오래 닦았는지·씻었는지 같은 진행 상태와 dynamics를 파악할 수 있다.
- 실패를 기억하고 즉시 전략 수정 (in-context adaptation): 직전 grasp나 문 열기 등이 실패했다면 같은 행동을 반복하지 않고 grasp 높이·방향 등 manipulation strategy를 바꿀 수 있다.
- Long-horizon task 수행: 오래된 사건은 language memory로 압축하여 recipe 진행 단계, 이미 정리한 물건, 열어둔 cabinet 등을 기억한다. 논문에서는 최대 약 15분의 memory가 필요한 task를 수행한다.
- 효율적인 memory compression: 모든 과거 image token을 VLA backbone에 넣지 않고, temporal information을 현재 timestep representation에 압축한 뒤 과거 patch token은 버린다. 따라서 VLA backbone으로 전달되는 visual token 수는 기존 single-frame VLA와 비슷하게 유지된다.
- 낮은 계산량으로 temporal context 추가: space-time joint attention 대신 spatial / temporal attention을 분리하여 계산량을 줄이고 real-time inference latency를 유지한다.
- 기존 pretrained ViT 활용 가능: 새로운 learnable parameter를 추가하지 않고 attention pattern과 fixed temporal positional encoding을 사용하므로 기존 VLM의 pretrained ViT weight에서 초기화할 수 있다.
결론: MEM의 핵심은 단순히 과거를 많이 저장하는 것이 아니라, 최근 과거는 dense visual memory로 정확하게 기억하고, 먼 과거는 language로 압축해서 기억함으로써 precision + long-horizon + efficiency를 동시에 확보하는 것이다.
High-level → Low-level 전체 흐름
\[\underbrace{I_t+m_t+\mathrm{Task}\rightarrow \mathrm{VLM}\rightarrow(l_t,m_{t+1})}_{\mathrm{High\text{-}level}}\quad\Longrightarrow\quad\underbrace{I_{t-k:t}+s_t+l_t\rightarrow \mathrm{Video\ VLA}\rightarrow \mathrm{Action\ Expert}\rightarrow a_{t:t+H}}_{\mathrm{Low\text{-}level}}\]마무리: RECAP + MEM, π₀.₆ 위에서 각각 뭘 바꾸나?
두 논문 다 π₀.₆ 위에 올라가 있지만, 건드리는 축이 완전히 다르다.
- RECAP: 경험으로부터 각 action을 얼마나 잘 하느냐를 끌어올린다. → 성공률, 속도(throughput)
- MEM: 시간에 걸친 context를 준다. → 가려진 물체, 진행 상태, 직전 실패, 15분짜리 recipe 순서
π₀.₅ pipeline 기준으로 보면 (high-level: VLM이 subtask $\hat\ell$ 예측 → low-level: action expert가 $a_{t:t+H}$ 생성)
| 구분 | RECAP (π*₀.₆) | MEM |
|---|---|---|
| 바뀌는 곳 | $\hat\ell$ 뒤, action 앞에 Advantage: positive/negative text 한 줄 추가 | high-level: VLM이 $m_t$를 받고 $m_{t+1}$을 추가로 출력 / low-level: single image → video encoder로 $I_{t-k:t}$ |
| 추가로 붙는 것 | 별도 value function (670M VLM backbone) | video encoder (ViT에 temporal attention, 새 learnable parameter 없음) |
| 학습 방식 | demo + autonomous rollout + human correction을 모으고, V → π를 iteration으로 반복 | LLM으로 만든 memory summary label + robot·non-robot video로 pre-training |
| 나만의 언어 | 같은 걸 더 잘하게 | 지금까지 뭘 했는지 기억하게 |
재미있는 건 둘이 만나는 지점이 있다는 것이다. MEM의 in-context adaptation도 결국 실패 → 사람 correction 데이터로 학습하고, MEM pre-training data에도 policy rollout과 human correction이 들어간다. (MEM p.5, p.7) RECAP이 실패를 “negative 꼬리표”로 다룬다면, MEM은 실패를 “short-term memory 안의 context”로 다룬다.
핵심: RECAP은 how well, MEM은 how long / what happened. 둘은 겹치지 않는 축이라 이론상 같이 붙일 수 있다. (다만 두 개를 합친 실험은 이 두 논문에는 없다.)