
π₀.₇ - Steerable Generalist Robot Foundation Model
VLA에 무엇을 할지뿐 아니라 어떻게 할지까지 prompt로 알려주면, 품질이 제각각인 data도 다 먹일 수 있을까? π₀.₇의 metadata·subgoal image prompting과 compositional generalization을 정리했다.
논문: π₀.₇: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities · arXiv:2604.15483
핵심 요약
π₀.₇은 자세한 language instruction, strategy·quality metadata, subgoal image 같은 풍부한 multimodal context로 행동 방식을 조절할 수 있는 steerable generalist VLA다. Demonstration, autonomous data와 실패 사례, human video, web data를 함께 활용해 새로운 instruction·task·robot embodiment로 skill을 재조합하는 compositional generalization을 목표로 한다.
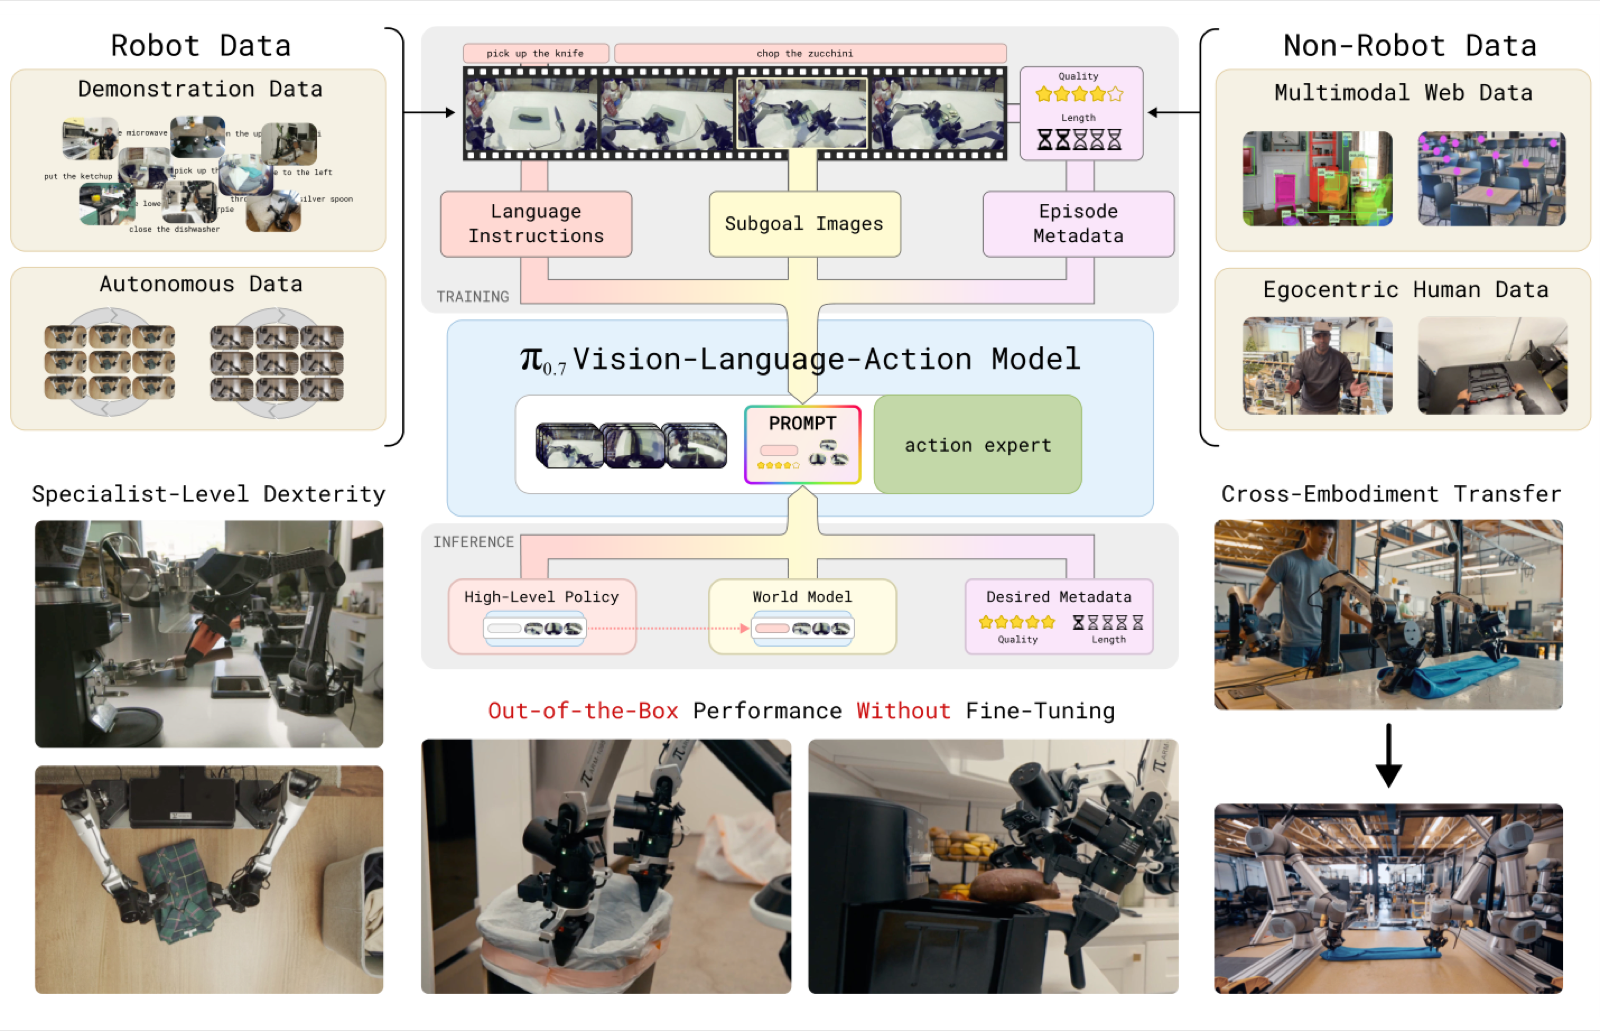 출처: π₀.₇ 논문 Figure 1 — 학습 data와 prompt가 하나의 VLA로 들어가는 전체 그림
핵심 질문 :
“지금까지 VLA는 무엇을 할지만 prompt로 받았다. 그런데 어떻게 할지까지 prompt로 알려주면, 품질이 제각각인 데이터도 다 먹일 수 있지 않을까?”
π₀.₅ 때는 prompt가 사실상 “clean the kitchen” 같은 짧은 task 설명 + subtask 정도였다. π₀.₇은 여기다가 이 episode가 얼마나 잘한 episode인지(metadata), 다음에 화면이 어떻게 보여야 하는지(subgoal image)까지 같이 넣는다. 논문 스스로도 새로운 architecture를 제안하는 게 아니라 “더 다양한 data를 쓸 수 있게 하는 methodology”라고 말한다. (솔직히 처음엔 모델 구조가 확 바뀐 줄 알았는데 아니었다 ㅋㅋ)
Architecture
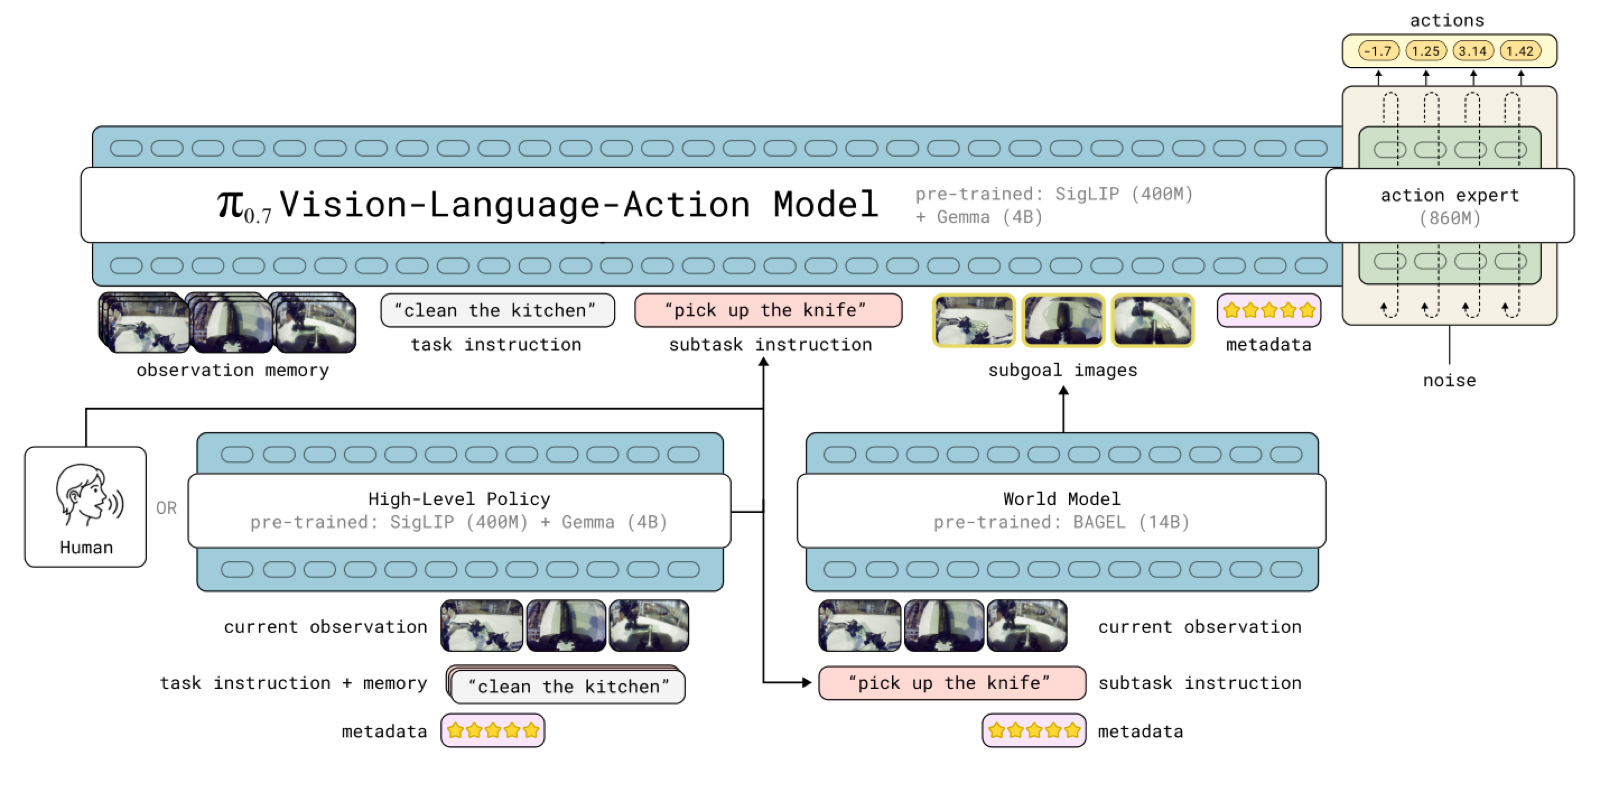 출처: π₀.₇ 논문 Figure 2 — Architecture overview
π₀.₇은 π₀.₆의 VLA 구조와 MEM memory system 위에, multimodal context conditioning을 얹은 모델이다. 큰 틀(VLM backbone + Action Expert)은 π₀.₅와 똑같다.
- VLM backbone (Gemma3 4B): 400M vision encoder 포함. 이것도 Gemma3에서 초기화한다.
- Action Expert (860M): Flow Matching으로 continuous action chunk를 만든다. 전체 모델은 약 5B.
- Vision encoder = MEM video history encoder: 과거 frame들을 temporal·spatial로 압축해서, history frame이 몇 장이든 single frame과 같은 수의 token으로 만든다.
- Knowledge Insulation 그대로: backbone은 FAST token으로 supervise하고, action expert는 backbone activation을 다 보지만 gradient는 backbone으로 안 넘어간다. (KI 페이지에서 본 그 stop-gradient!)
π₀.₅ / π₀.₆ 대비 뭐가 바뀌었나?
| 구분 | 이전 (π₀.₅ / π₀.₆) | π₀.₇ |
|---|---|---|
| Context | 짧은 task 설명 (+ subtask) | 자세한 language + episode metadata + control mode + subgoal image |
| Vision 입력 | 현재 observation | 최대 4개 camera × 최대 6 history frame (MEM encoder로 압축) + 최대 3장 subgoal image |
| Proprioceptive state | π₀.₆은 discretized text token | MEM처럼 linear projection으로 embedding, history state도 각각 token |
| Action Expert | π₀.₅ 페이지 기준 약 300M | 860M, adaptive RMSNorm으로 flow timestep 주입 |
| 추가 부품 | — | subgoal image를 만드는 world model (BAGEL 14B 기반), subtask를 만드는 high-level policy |
Multimodal context는 어떻게 들어가나?
- 입력 해상도: camera observation과 subgoal image 모두 448x448로 resize. subgoal image도 같은 vision encoder를 통과한다.
- Attention mask (block-causal): observation token끼리, subgoal image token끼리는 bidirectional. goal-image token은 observation도 볼 수 있다. 그 뒤에 오는 text token(task, subtask, metadata, control mode)은 causal attention.
- Action token: action expert의 token 수는 50개로 고정 = 50-step action chunk. 50개끼리는 bidirectional, 그리고 VLM backbone activation을 attend한다.
- Dropout: history frame 전체를 0.3 확률로, rear view image도 0.3 확률로 drop한다. history frame이 drop되면 대응하는 state token도 같이 mask.
→ 결국 “context가 하나 더 붙었다”가 아니라 context가 image·text·숫자(metadata) 섞인 multimodal prompt가 됐다는 게 핵심이다.
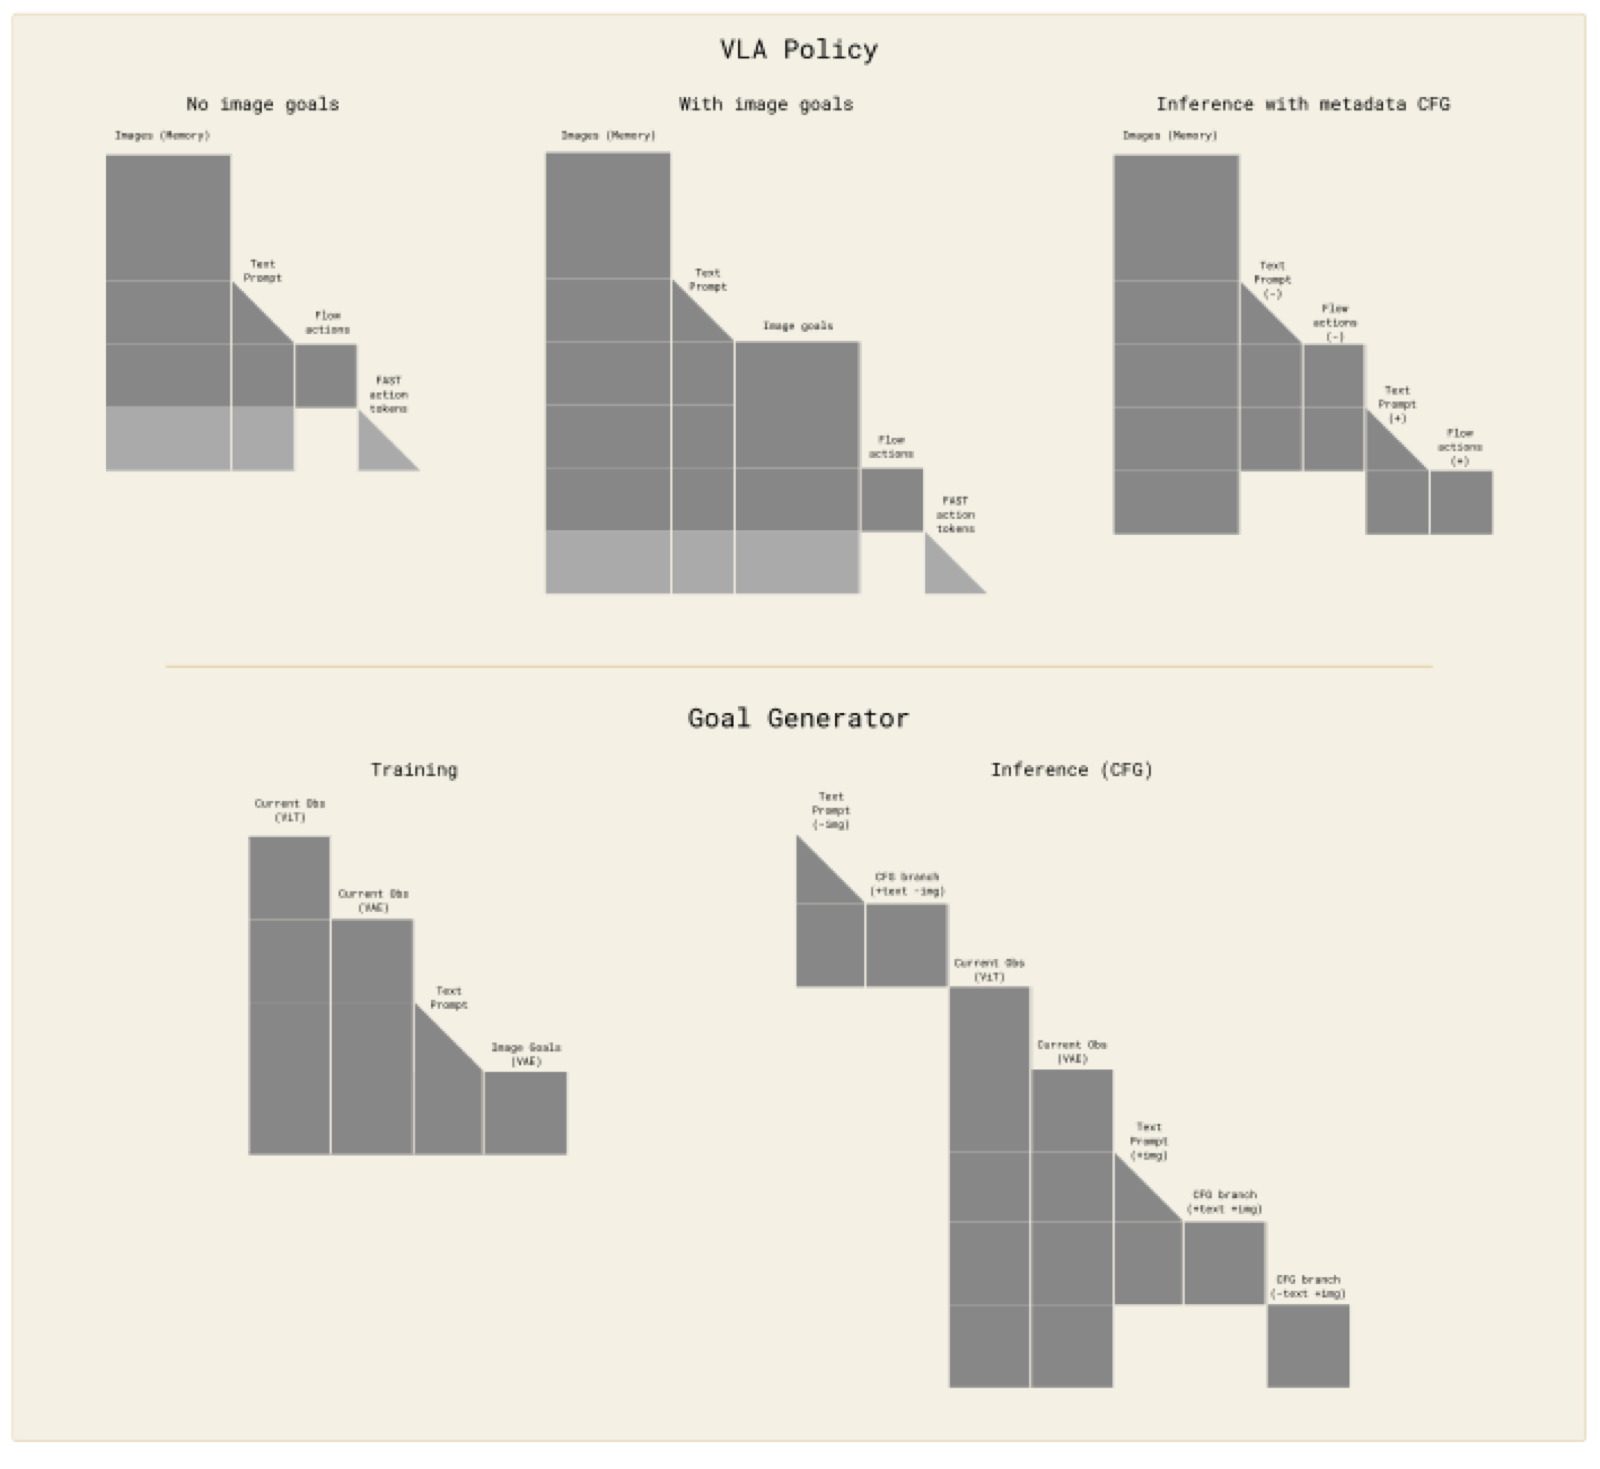 출처: π₀.₇ 논문 Figure 19 — (Appendix) image goal 유무·metadata CFG에 따른 attention pattern
핵심: 구조는 π₀.₆ + MEM 거의 그대로. 바뀐 건 prompt에 뭘 넣느냐다. “모델을 바꾼 게 아니라 질문하는 방식을 바꿨다.”
Q. 그래서 “Steerable”하다는 게 정확히 뭔데??
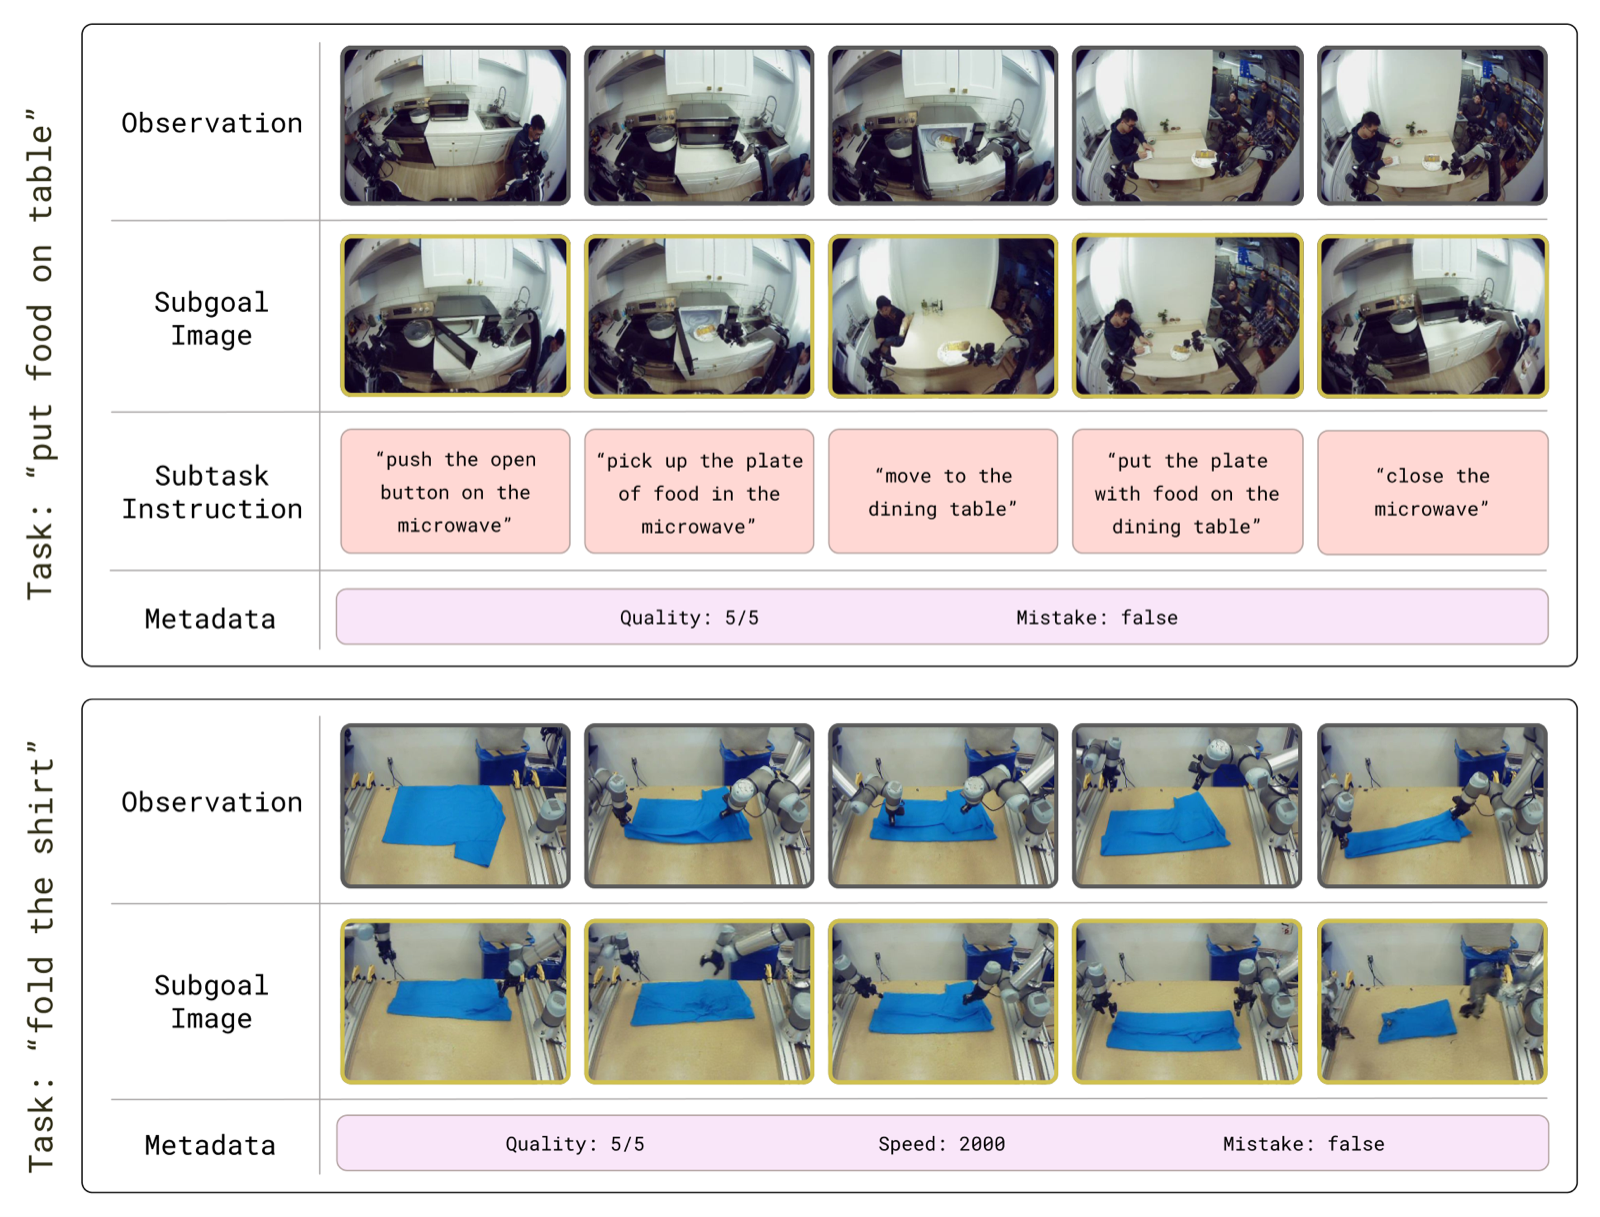 출처: π₀.₇ 논문 Figure 3 — Prompt overview
A. 같은 모델에 prompt만 바꿔서 “무엇을”뿐 아니라 “어떻게(전략, 속도, 품질)”까지 조종할 수 있다는 뜻이다. fine-tuning 없이 runtime에 context만 바꾼다.
먼저 prompt 전체가 어떻게 생겼는지 보자. 논문에 나온 예시 그대로:
1
2
<Multi-view observation><Multi-view subgoals>
Task: peel vegetables. Subtask: pick up the peeler. Speed: 8000. Quality: 5. Mistake: false. Control Mode: joint.<Proprioception>
이제 context 하나하나가 행동을 어떻게 바꾸는지 살펴보자.
| Context | 기호 | 내용 | 행동을 어떻게 바꾸나 | 나만의 언어 |
|---|---|---|---|---|
| Task instruction | $\ell_t$ | “clean the kitchen” 같은 전체 task | 무엇을 할지 | 최종 목표 |
| Subtask instruction | $\hat{\ell}_t$ | “open the fridge door” 같은 다음 semantic subtask. high-level policy나 사람이 줌 (생략 가능) | 지금 당장 뭘 할지. 사람이 step-by-step으로 말하면 verbal coaching이 됨 | 지금 할 일 |
| Subgoal image | $\mathbf{g}_t$ | camera별 “가까운 미래에 화면이 이렇게 보여야 한다” 이미지 (multi-view) | language로 표현하기 힘든 디테일 (손잡이를 어떻게 잡을지, 잘 개진 옷이 어떻게 생겼는지)을 전달 | 다음 장면 사진 |
| Episode metadata | $m$ | Speed(episode 길이), Quality(1–5), Mistake(true/false) | 같은 task라도 빠르게/잘/실수 없이 하도록 mode 선택 | 얼마나 잘할지 |
| Control mode | $c$ | joint 또는 ee (end-effector) | low-level action 표현 선택 | 어떤 손으로 조종할지 |
Episode metadata 디테일
- Overall speed: episode 길이(timestep). 500 step 간격으로 binning한다. e.g) 1750–2250 → “2000 steps”. 보통 빠를수록 실수도 적어서 품질과도 연관된다.
- Overall quality: 1–5 점수, 5가 최고.
- Mistake: 해당 action segment에서 실수(grasp 실패, 엉뚱한 subtask 등)를 했는지. 사람이 대충(coarsely) annotation한다.
!!!여기서 포인트는 학습 때는 ground-truth metadata(잘했든 못했든 있는 그대로)를 붙이고, test 때는 원하는 metadata를 넣는다는 것이다!!!
- runtime에는 항상 Quality = 5, Mistake = false로 둔다.
- Speed는 task별로 episode 길이의 15th percentile로 설정한다. (즉 “상위권으로 빠른 episode처럼 해라”)
Classifier-Free Guidance로 더 세게 steer하기
각 prompt component를 dropout하면서 학습했기 때문에, 조건 있는 버전과 없는 버전을 둘 다 계산할 수 있다 → diffusion에서 쓰는 CFG를 그대로 쓸 수 있다.
\[\nabla_{\mathbf{a}} \log \pi_\theta(\mathbf{a}_{t:t+H}\mid \mathbf{o}_t, \mathcal{C}_t) + \beta\Big(\nabla_{\mathbf{a}} \log \pi_\theta(\mathbf{a}_{t:t+H}\mid \mathbf{o}_t, \mathcal{C}_t) - \nabla_{\mathbf{a}} \log \pi_\theta(\mathbf{a}_{t:t+H}\mid \mathbf{o}_t, \mathcal{C}^{\mathrm{uncond}}_t)\Big)\]| 기호 | 뜻 |
|---|---|
| $\mathcal{C}_t$ | 전체 context (task, subtask, subgoal, metadata, control mode) |
| $\mathcal{C}^{\mathrm{uncond}}_t$ | 일부를 뺀 “unconditional” context. 논문에서는 episode metadata를 빼서 CFG를 건다 |
| $\beta$ | CFG weight. 논문은 $\beta \in \{1.3, 1.7, 2.2\}$ 정도의 moderate한 값 사용 |
| $\nabla_{\mathbf{a}} \log \pi_\theta$ | 각 action denoising step에서 action을 어느 방향으로 움직일지 (score) |
→ 쉽게 말하면 “metadata 있는 버전 − 없는 버전” 차이 방향으로 한 번 더 밀어주는 거다. 예를 들어 더 빠른 속도 쪽으로 action을 밀어줄 수 있다.
핵심: steerable = “무엇을”(task·subtask) + “어떻게”(metadata·subgoal image·control mode)를 prompt로 고르는 것. 학습할 때 각 component를 dropout했기 때문에 아무 subset이나 골라 쓸 수 있고, CFG로 강도까지 조절된다.
Training data와 recipe
데이터: 뭘 다 먹였나?
- Demonstration data: 여러 robot platform (static·mobile, single-arm·bimanual), 여러 환경 (in-house lab, home-like, in-the-wild 가정집).
- Autonomous data: policy evaluation에서 나온 대량의 rollout, policy rollout 중 human intervention. π*₀.₆가 RL 학습 중에 모은 data도 포함 → RL specialist 행동을 사실상 distillation한다.
- Suboptimal data: failure episode, 실수 많은 success episode까지 적극적으로 쓴다. (기존 VLA 학습 pipeline과 완전히 반대 방향!!)
- Open-source robot dataset
- Egocentric human video
- Web / non-robot data: object localization, attribute prediction, VQA, text-only prediction, video captioning (in-house robot data + web).
(참고로 generalization 평가용 task에서 나온 autonomous data는 학습에서 제외했다고 한다.)
Q. 실패 data를 넣으면 모델이 실패를 배우지 않나??
그냥 넣으면 당연히 망한다. 논문 표현대로면 다양한 품질·전략이 섞인 data를 naive하게 학습하면 모델이 여러 mode를 평균내버려서 suboptimal해진다.
그래서 metadata를 붙인다. 실패 episode에는 “Quality: 2, Mistake: true” 같은 label이 붙어 있으니, 모델 입장에서는 “아 이건 못한 버전이구나”로 구분해서 배운다. 그리고 test 때는 Quality 5 / Mistake false만 요청하면 된다.
→ 나만의 언어: 실패 data를 버리는 게 아니라 “이건 오답노트”라고 이름표를 붙여서 같이 공부시키는 것.
더 좋은 점은, 실패·suboptimal data가 state 분포를 넓혀줘서 robustness가 오른다는 것. 그래서 오히려 single-task 후학습 policy보다 잘하는 경우도 생긴다고 한다.
Training objective
\[\max_{\theta}\; \mathbb{E}_{\mathcal{D}}\Big[\log \pi_\theta\big(\mathbf{a}_{t:t+H}\mid \mathbf{o}_{t-T:t}, \mathcal{C}_t\big)\Big], \qquad \mathcal{C}_t = \{\ell_t, \hat{\ell}_t, \mathbf{g}_t, m, c\}\]| 기호 | 뜻 |
|---|---|
| $\pi_\theta$ | 파라미터 $\theta$를 가진 π₀.₇ VLA |
| $\mathcal{D}$ | demonstration + 실패/autonomous + human video 등을 포함한 학습 data |
| $\mathbf{o}_{t-T:t}$ | 최근 history observation (여러 camera image + joint configuration $q_t$) |
| $\mathbf{a}_{t:t+H}$ | 예측할 action chunk |
| $\mathcal{C}_t$ | prompt / context. 기존엔 $\mathcal{C}_t = (\ell_t)$였는데 π₀.₇은 이걸 확장 |
| $\mathbf{g}_t = [G^1_t, \dots, G^n_t]$ | camera $i$별 near-future subgoal image |
| $m$, $c$ | episode metadata, control mode |
식 자체는 π₀ 계열이랑 똑같다. 그냥 조건부 log-likelihood를 최대화. 바뀐 건 조건 $\mathcal{C}_t$가 엄청 풍부해졌다는 것뿐이다. (Flow matching action expert는 closed-form log-likelihood가 아니라 근사 lower bound를 최적화한다는 점은 논문에서도 짚는다.)
Prompt dropout 비율
- Subgoal image: batch의 25% example에만 넣는다. 왜냐하면 subgoal image가 있으면 문제가 “현재 frame → 미래 frame 사이 action 맞추기”, 즉 inverse dynamics가 돼서 학습이 너무 쉬워지기 때문이다.
- subgoal image가 있는 example 중 30%는 subtask text $\hat{\ell}_t$를 drop (image가 text를 대신할 수 있으니까).
- Episode metadata: 15%는 통째로 drop, 각 component(speed, quality, mistake)는 개별적으로 5% drop.
- Control mode: dropout 안 함.
Subgoal image는 어떻게 학습하나?
- Real subgoal: 0.25 확률로 segment 끝 frame (world model 정답과 동일), 0.75 확률로 0–4초 뒤 future frame을 uniform sampling.
- Generated subgoal: world model이 만든 image도 대량으로 넣어서 real vs generated 사이의 train-test mismatch를 줄인다.
- RTC (training-time): 0–12 timestep 지연을 simulate → 50Hz robot에서 최대 240ms inference latency에 해당.
World model (subgoal image 생성기)
\[\max_{\psi}\; \mathbb{E}_{\mathcal{D}_g}\Big[\mathcal{L}_{\mathrm{CFM}}\big(g^{\star}_t,\; g_\psi(\mathbf{o}_t, \hat{\ell}_t, m)\big)\Big], \qquad g^{\star}_t = \mathbf{o}_{t_{\mathrm{end}}}\]| 기호 | 뜻 |
|---|---|
| $g_\psi$ | subgoal image를 생성하는 world model (BAGEL 14B mixture-of-transformers에서 초기화) |
| $\mathcal{L}_{\mathrm{CFM}}$ | standard flow matching loss |
| $g^{\star}_t$ | 정답 subgoal = 해당 segment 마지막 frame $\mathbf{o}_{t_{\mathrm{end}}}$ |
| $\mathcal{D}_g$ | subtask label 품질이 특히 좋은 segment만 모은 subset |
(논문 표기가 max로 되어 있는데, loss니까 실제론 minimize로 읽으면 될 듯하다.)
- World model은 robot data뿐 아니라 egocentric human video, open-source image editing / video dataset도 섞어서 학습 → web·human data에서 얻은 semantic·physical 개념이 subgoal image를 통해 π₀.₇으로 넘어간다.
- Appendix 기준: ViT 쪽 token은 7B LLM backbone, VAE 쪽 token은 7B generation backbone이 처리한다. label의 temporal segmentation 품질이 subgoal 품질에 큰 영향을 준다고.
핵심: 품질이 섞인 data를 필터링하지 않고 metadata 이름표를 붙여서 전부 학습한다. human video·web 지식은 world model을 거쳐 subgoal image 형태로 들어온다.
실제 inference
- 입력 구성: 현재 multi-view observation + history frame + proprioceptive state, 전체 task $\ell$, 원하는 metadata $m$ (Quality 5, Mistake false, Speed = 15th percentile), control mode $c$.
- Subtask 결정: high-level policy(같은 Gemma3 4B 기반 구조)나 사람(coaching)이 다음 subtask $\hat{\ell}$을 준다.
- Subgoal 생성 (선택): world model이 $(\mathbf{o}_t, \hat{\ell}, m)$로 multi-view subgoal image $g^\star$를 만든다. $\hat{\ell}$이 바뀌거나 Δ = 4초가 지나면 다시 생성. 별도 thread에서 async로 돌아서 VLA는 항상 가장 최신 것을 쓴다.
- Action 생성: π₀.₇이 $\mathcal{C} = \{\ell, \hat{\ell}, g^\star, m, c\}$를 조건으로 5 denoising step만에 50-step action chunk를 생성 (필요하면 metadata CFG).
- 실행: chunk 중 $\hat{H} \in \{15, 25\}$ step을 실행하고, RTC로 다음 chunk를 async하게 이어붙인다.
전체 흐름: image(+history) + state + task ℓ + desired metadata m → high-level policy → subtask ℓ̂ → world model → subgoal image g★ → π₀.₇ (VLM backbone + Flow Matching Action Expert, metadata CFG) → 50-step continuous action chunk → ℓ̂ 변경 또는 4초마다 subgoal 갱신
- 속도: π₀.₇ minimal variant는 H100 1장에서 3 camera, 5 denoising step 기준 38ms. MEM encoder + subgoal image까지 다 켜면 worst case 127ms.
- World model: 4×H100 tensor parallel + 8-bit quantization 등으로 25 denoising step subgoal 생성에 1.25초. 그래서 async가 필수다.
Emergent capabilities / Compositional generalization
여기가 이 논문이 제일 자랑하는 부분이다. LLM이 학습 data의 지식을 새로운 방식으로 조합하듯이, robot도 skill을 재조합(remix)해서 새 task를 풀 수 있냐?
1. Language coaching으로 새 task 가르치기
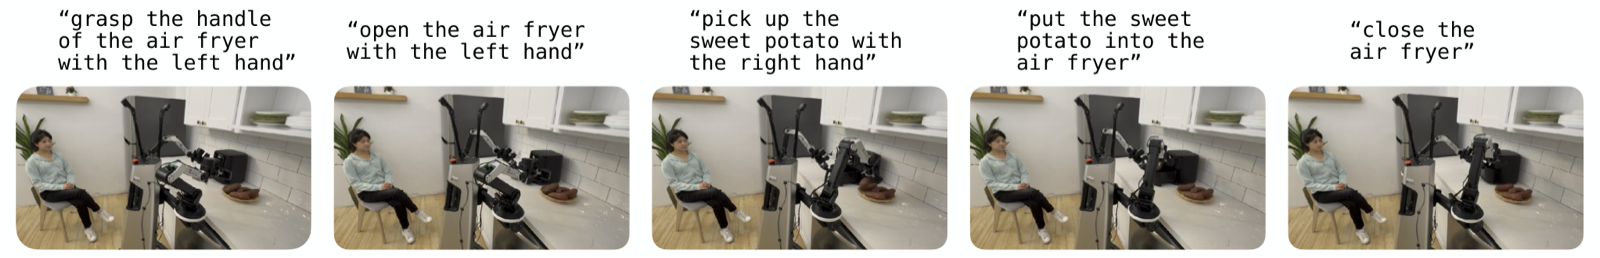 출처: π₀.₇ 논문 Figure 14 — air fryer language coaching 예시
- robot data에 전혀 없는 air fryer에 고구마 넣기, air fryer 비우기, bagel 굽기(toaster oven)를 사람이 “open the air fryer”, “pick up the sweet potato”처럼 한 단계씩 말해서 시킨다.
- 이 coaching 기록으로 high-level policy를 학습하면 → 사람 없이 완전 자율로 수행. teleoperation data 추가 수집 0.
- 비슷한 가전은 human data나 외부 dataset에서 다른 맥락으로 본 적은 있다고 논문이 밝힌다.
→ 나만의 언어: “시범을 보여주는 게 아니라, 말로 가르친다.” 사람한테 일 가르치는 거랑 비슷하다.
2. 새로운 short-horizon task를 out-of-the-box로
- French press plunger 누르기, rice cooker에 밥 퍼 담기, 헤드폰·자 같은 사무용품 천으로 닦기, gear set·desk fan 돌리기 → 이 task용 data를 전혀 모으지 않았는데 됐다.
3. Dataset bias 거스르기
- Reverse Bussing: 원래는 쓰레기 → 쓰레기통, 식기 → bussing bin인데, 반대로 시킨다.
- Reverse Fridge to Microwave: data에는 fridge → microwave 방향만 있는데 microwave → fridge로 시킨다. 여기서는 generated subgoal image(GC)가 성공에 결정적이었다.
4. 복잡한 referential instruction
- “pick up the object I would use to eat soup”, “pick up the fruit on the largest plate” 같은 이상한 표현이나 공간 관계를 이해. subgoal image를 쓰면 world model의 semantic 이해까지 가져와서 더 좋아진다.
5. Zero-shot cross-embodiment
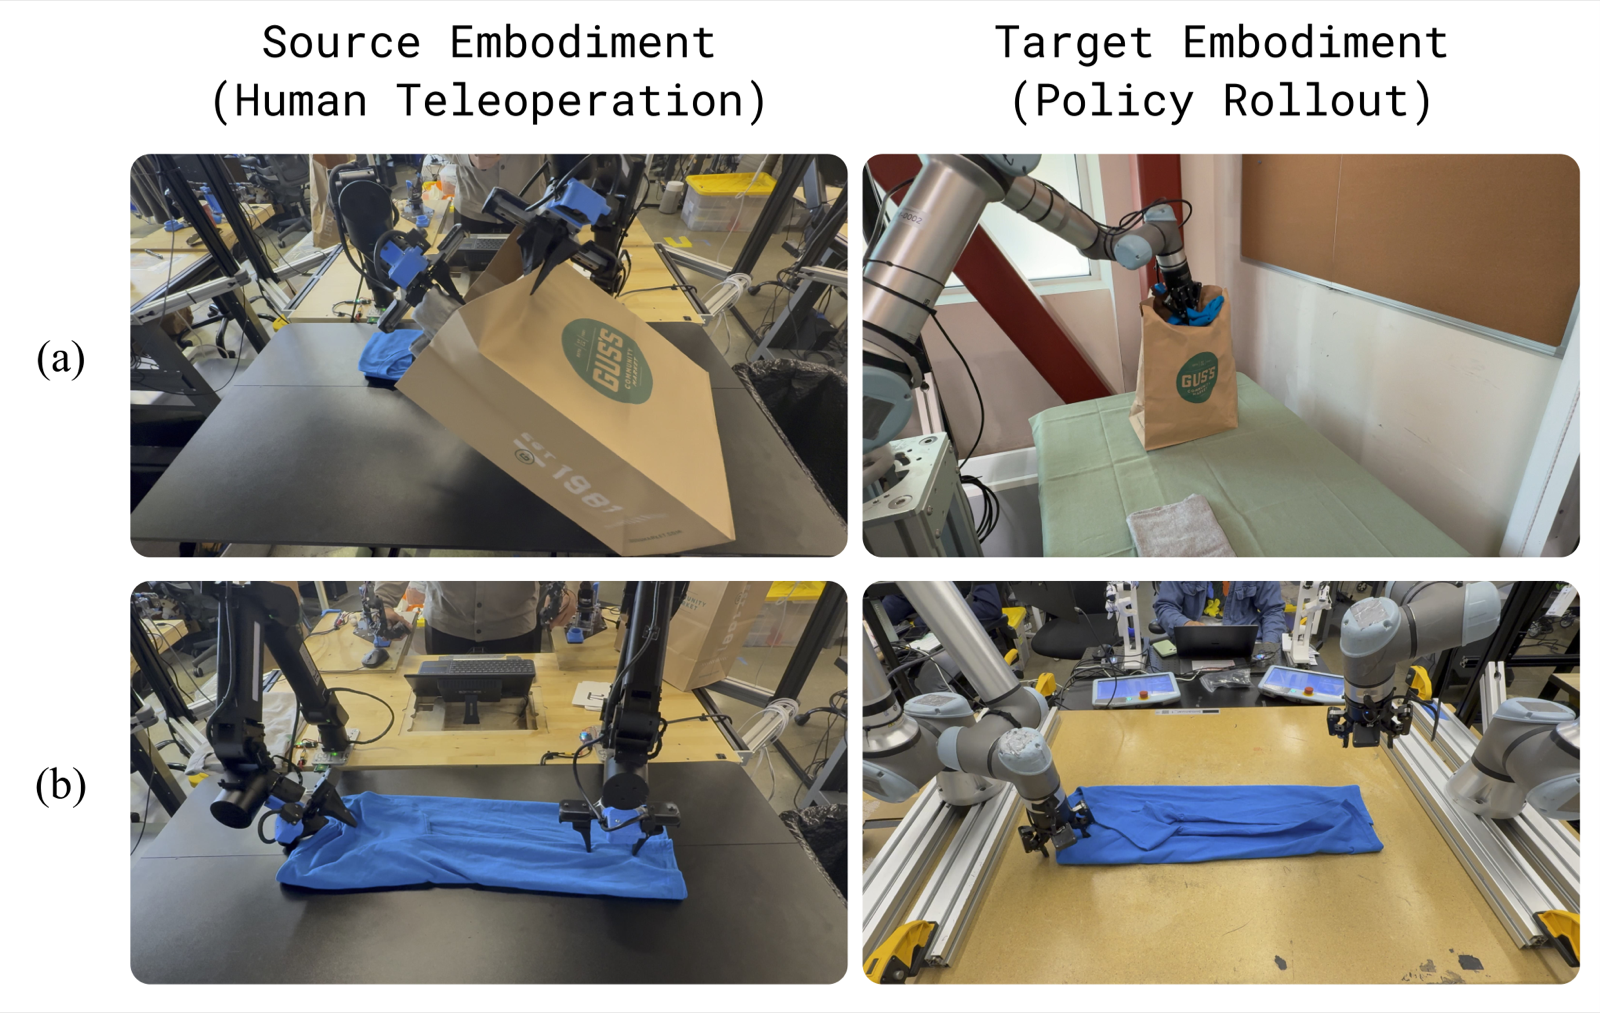 출처: π₀.₇ 논문 Figure 13 — UR5e에서 스스로 찾은 새 전략
- laundry folding data는 가벼운 static bimanual robot으로만 모았고 UR5e bimanual에서는 folding data가 0이었는데, UR5e에서 towel·shirt를 갰다.
- 그냥 따라하는 게 아니라 새 전략을 쓴다: source robot에서는 사람이 tilted end-effector로 천을 잡는데, π₀.₇은 UR5e에서 vertical grasp를 쓴다. Shirt Bagging에서는 한 팔로 가방을 잡고 다른 팔로 넣는 대신 한 팔 pick-and-place.
- 이 실험은 joint-space control로 했다. end-effector control은 이전 모델에서 뚜렷한 이득이 없었다고 (Appendix E).
핵심: compositional generalization = 새 task를 위해 data를 새로 모으는 대신, prompt하고, coaching하고, 설명해서 시킨다. 이게 LLM의 prompting과 진짜 비슷한 지점이다.
결과
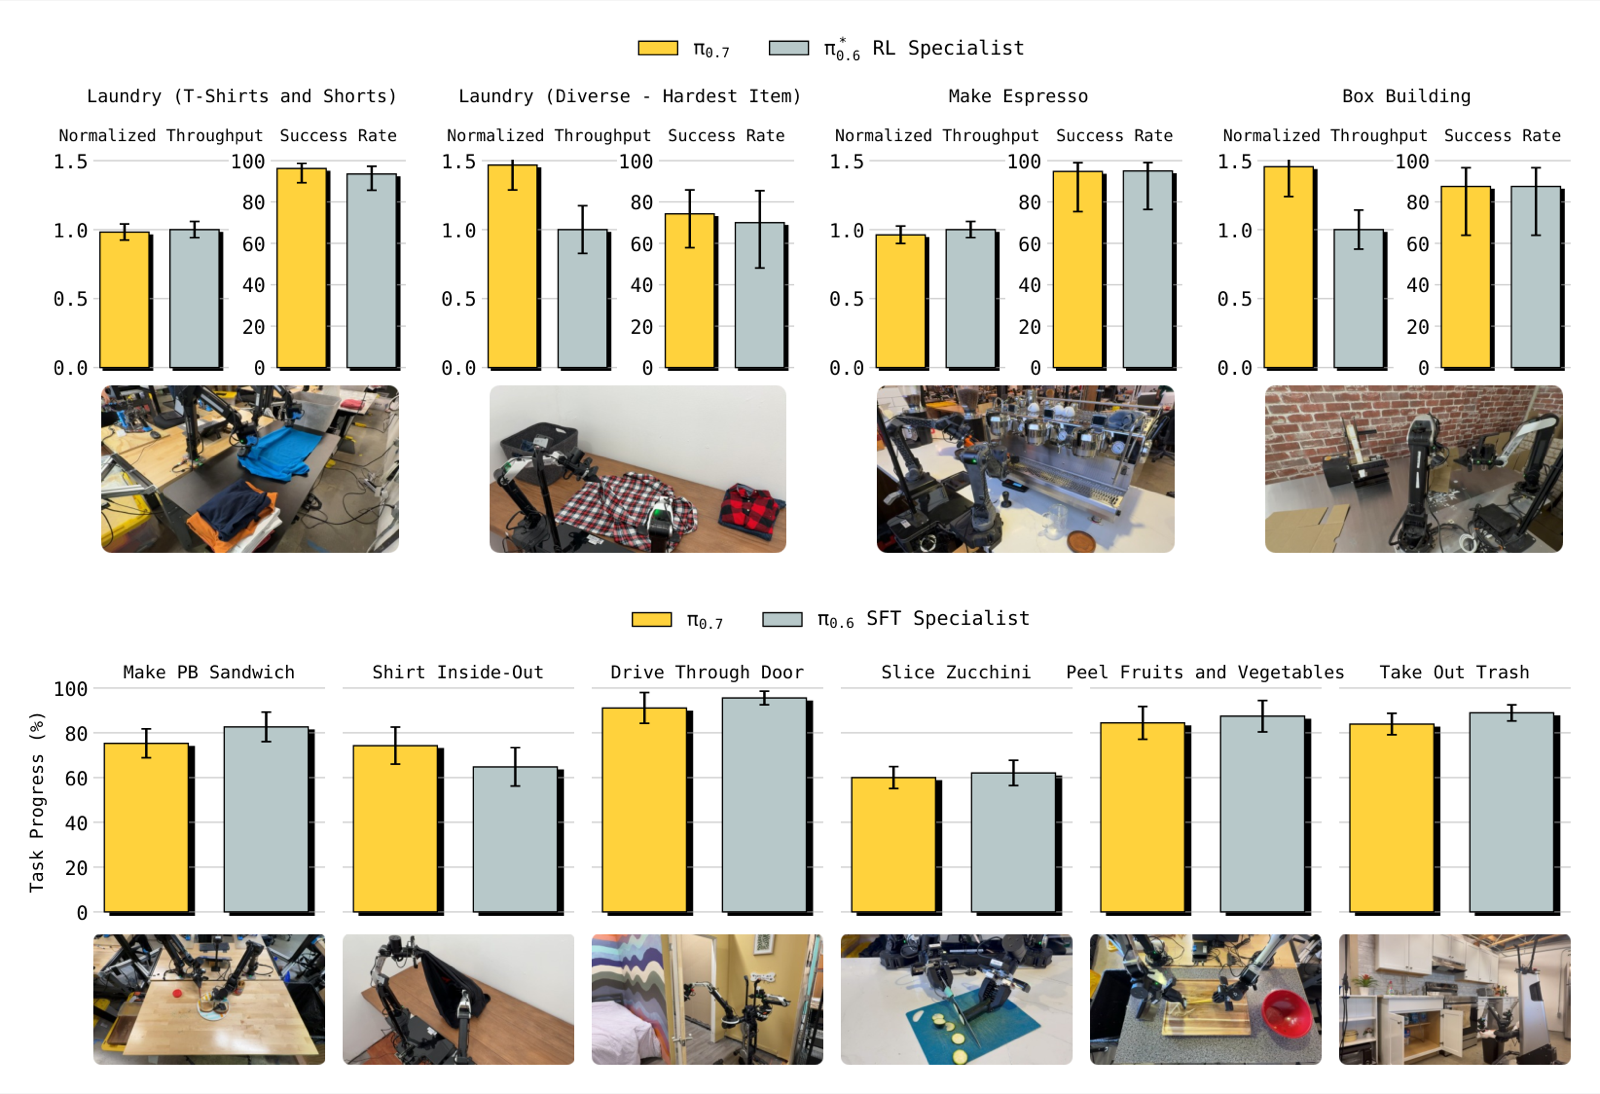 출처: π₀.₇ 논문 Figure 6 — RL/SFT specialist 대비 out-of-the-box 성능
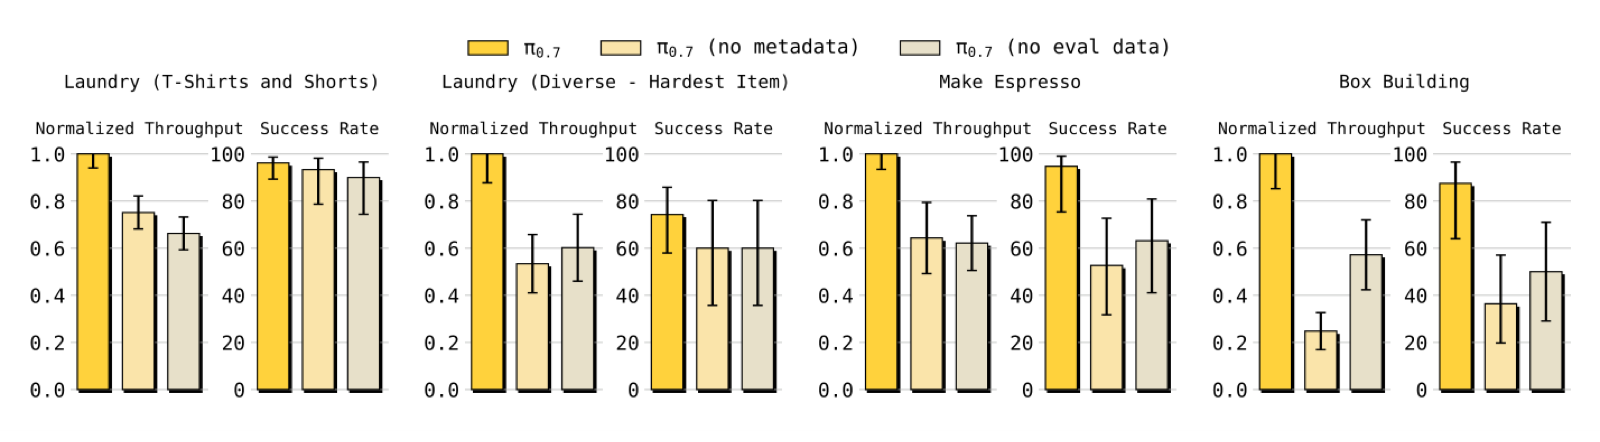 출처: π₀.₇ 논문 Figure 7 — no metadata / no eval data ablation
- Out-of-the-box dexterity: espresso, box building, laundry folding에서 task별 RL-finetuned π*₀.₆ specialist와 비슷한 성능. diverse laundry와 box building에서는 throughput이 specialist보다 높았다. PB sandwich, 셔츠 뒤집기, 문 통과, zucchini 썰기, 채소 껍질 벗기기, 쓰레기봉투 교체도 π₀.₆ SFT specialist와 비슷.
- Ablation: metadata를 빼거나(no metadata) autonomous eval data를 빼면(no eval data) 모든 task에서 떨어졌고, 특히 throughput 차이가 컸다.
- Memory task: Swap 3 Mugs 등에서 MEM 논문의 task별 fine-tuned π₀.₆-MEM과 비슷하거나 더 좋았다.
- Instruction following: unseen kitchen 4곳 + unseen bedroom 2곳, 14개 scenario, 각 3–6 step instruction에서 π₀.₅, π₀.₆보다 크게 앞섰다.
- Cross-embodiment (shirt folding on UR5e): 경험 많은 teleoperator 10명(평균 약 375시간, 상위 2%)이 같은 조건에서 첫 시도 (각 3회, 총 30 trial) → 사람 90.9% task progress / 80.6% success, π₀.₇ 85.6% / 80%. 거의 전문가 수준.
- Mixed-quality data scaling: laundry data를 품질·속도 기준 top 30% / 50% / 80% / 전체로 나눠 metadata 유무로 총 8개 모델 학습 → without metadata는 data가 늘수록(평균 품질 하락) 오히려 나빠질 수 있었지만, with metadata는 계속 좋아졌다.
- Task diversity: task diversity 가장 높은 20% data를 빼면 random 20%를 뺀 것보다 unseen short-horizon task 성능이 크게 떨어졌다.
- 한계: seen task는 success가 흔히 90% 이상인데, unseen task나 unseen task-robot 조합은 60–80% 수준. 그리고 data가 너무 커서 무엇이 진짜 “unseen”인지 확실히 말하기 어렵다고 논문도 인정한다.
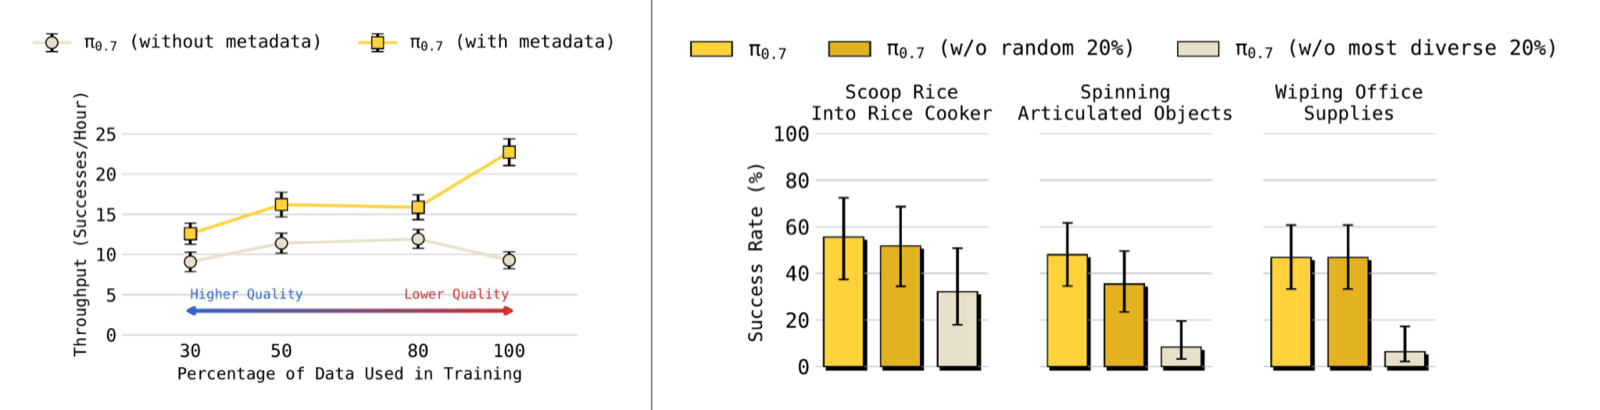 출처: π₀.₇ 논문 Figure 18 — metadata 유무에 따른 data scaling과 task diversity ablation
한 줄 결론: 다양한 data + 자세한 context의 시너지. metadata 덕분에 data가 “많아질수록 좋아지는” 구조가 됐다.
π 시리즈에서의 위치
| 모델 | 새로 추가한 것 | 나만의 언어 |
|---|---|---|
| π₀ | VLM backbone + Flow Matching Action Expert로 continuous action chunk 생성 | VLM에 팔다리를 붙였다 |
| FAST | continuous action을 discrete token으로 바꾸는 tokenizer → next-token prediction으로 빠른 학습 | action도 글자처럼 |
| π₀.₅ | heterogeneous co-training (여러 robot + web data) + high-level subtask 예측 | 처음 보는 집에서도 |
| π₀.₅ + KI | FAST loss로 backbone 학습 + action expert gradient를 stop-gradient로 차단 | VLM 지식 보호막 |
| π*₀.₆ / MEM | π*₀.₆: RL로 경험에서 학습하는 task별 specialist. MEM: video history encoder 기반 multi-scale memory | 경험으로 늘고, 기억한다 |
| π₀.₇ | prompt 확장 (자세한 language + episode metadata + subgoal image + control mode) → 실패·autonomous·human·web data 전부 활용, steerability와 compositional generalization | 무엇을 + 어떻게 까지 prompt로 |
→ 흐름을 보면 π₀.₅까지는 “data를 어떻게 섞을까”, KI는 “섞으면서 VLM을 어떻게 지킬까”, π*₀.₆는 “specialist를 어떻게 잘하게 만들까”였고, π₀.₇은 그 specialist들의 rollout까지 다시 generalist 하나로 distill한다.
내 생각
- 결국 이것도 핵심은 모델이 아니라 data를 어떻게 먹이느냐다 ㅋㅋ. π₀.₅에서 FAST가 training을 위한 수단이었던 것처럼, 여기서 metadata는 “실패 data도 버리지 않기 위한 이름표”다. 실패를 지우는 게 아니라 label을 붙이니까 오히려 data가 많을수록 좋아진다는 게 인상적이었다.
- Subgoal image 부분이 제일 신기했다. human video나 web 지식을 VLA에 직접 넣는 게 아니라, world model이 “다음 장면 그림”으로 번역해서 넘겨준다. 그런데 subgoal image를 넣으면 inverse dynamics 문제가 돼서 너무 쉬워지니까 25%만 넣는다는 디테일이 재밌다. (쉬운 문제만 풀면 머리를 안 쓰게 되는 거임)
- 다만 LLM 비유가 강한 만큼, 논문도 인정하듯이 진짜 “unseen”인지 판별하기가 어렵다. 그리고 subgoal 생성에 4×H100으로 1.25초가 걸리는 world model까지 붙어야 하니, 실제로 가볍게 돌리기는 아직 무거워 보인다.