
π₀.₅ + Knowledge Insulation
VLM에 팔다리(action)를 붙이면서 원래 갖고 있던 언어·시각 능력은 잃지 않을 수 있을까? Knowledge Insulation이 stop-gradient 하나로 이걸 어떻게 해결하는지 정리했다.
논문: Knowledge Insulating Vision-Language-Action Models: Train Fast, Run Fast, Generalize Better · arXiv:2505.23705
핵심 요약
π₀.₅ + Knowledge Insulation은 FAST action-token loss로 VLM backbone을 robot control에 적응시키면서, Flow Matching Action Expert의 gradient가 backbone으로 흐르지 않도록 차단해 기존 VLM의 semantic knowledge를 보호한다. 이를 통해 빠른 학습, 빠른 continuous-action inference, 높은 generalization을 한 모델에서 함께 얻는 것이 핵심이다.
핵심 질문 :
“How can we augment VLMs to get VLAs with continuous action outputs in a way that they maximally inherit all of the capabilities that come with web-scale pretraining?”
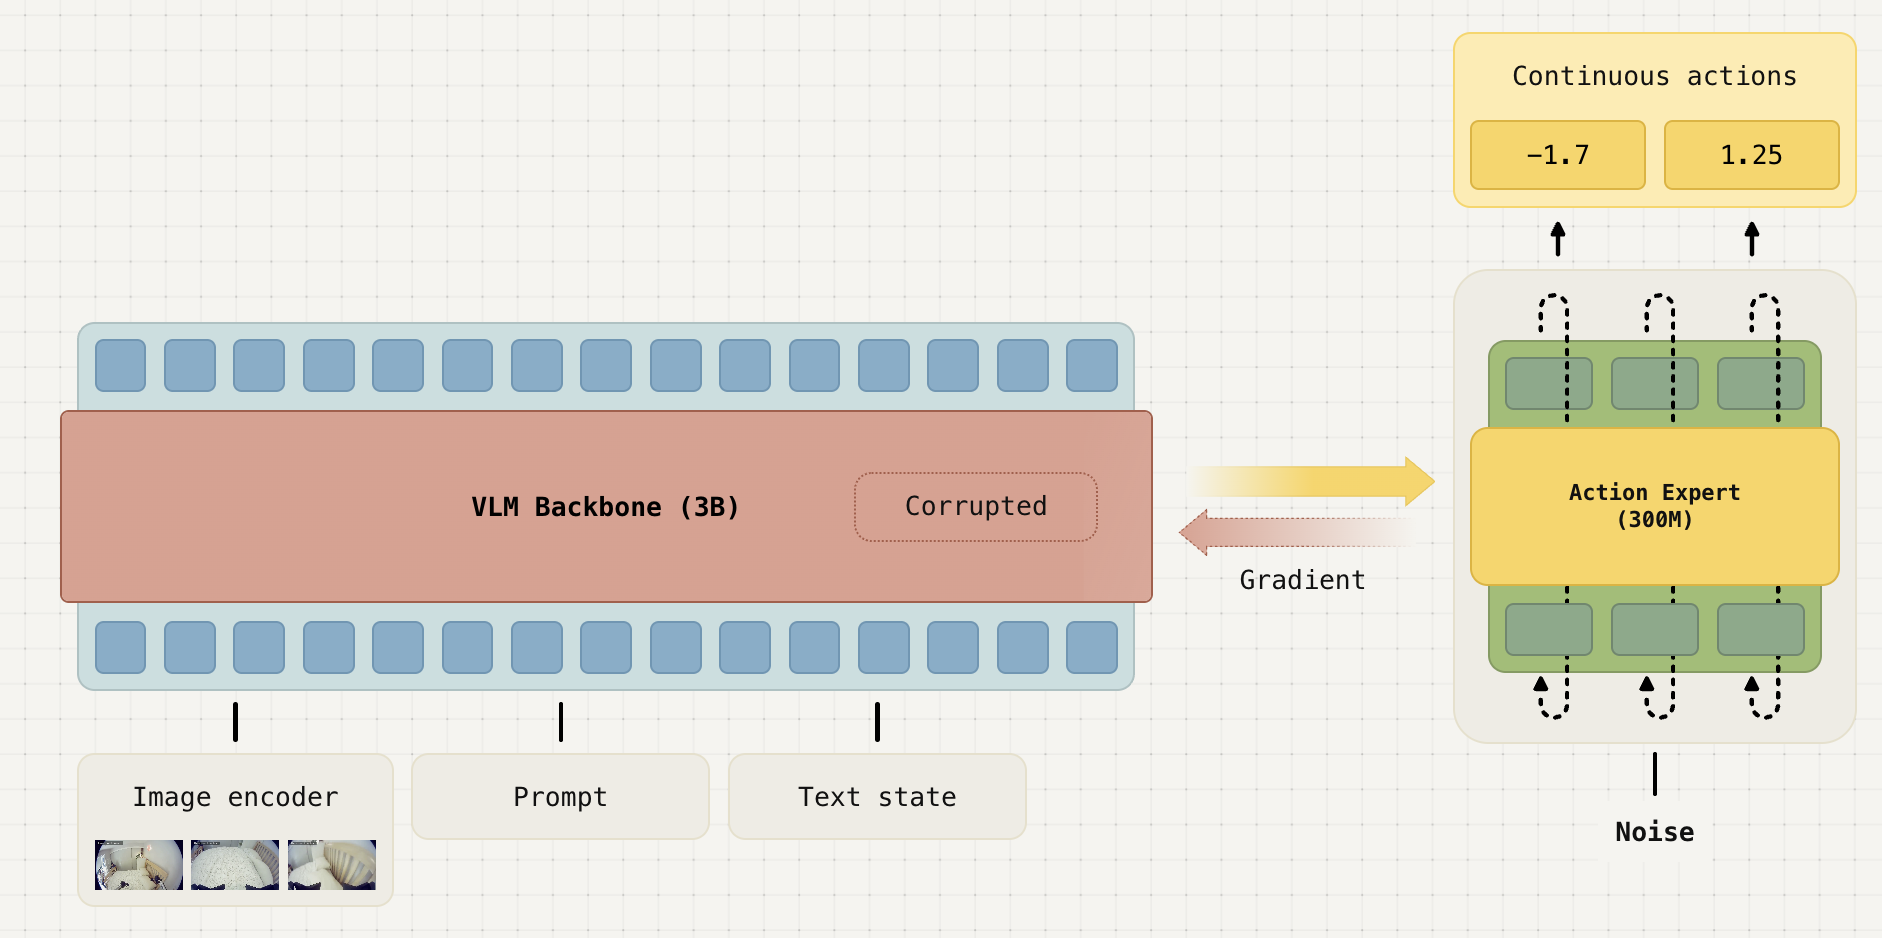
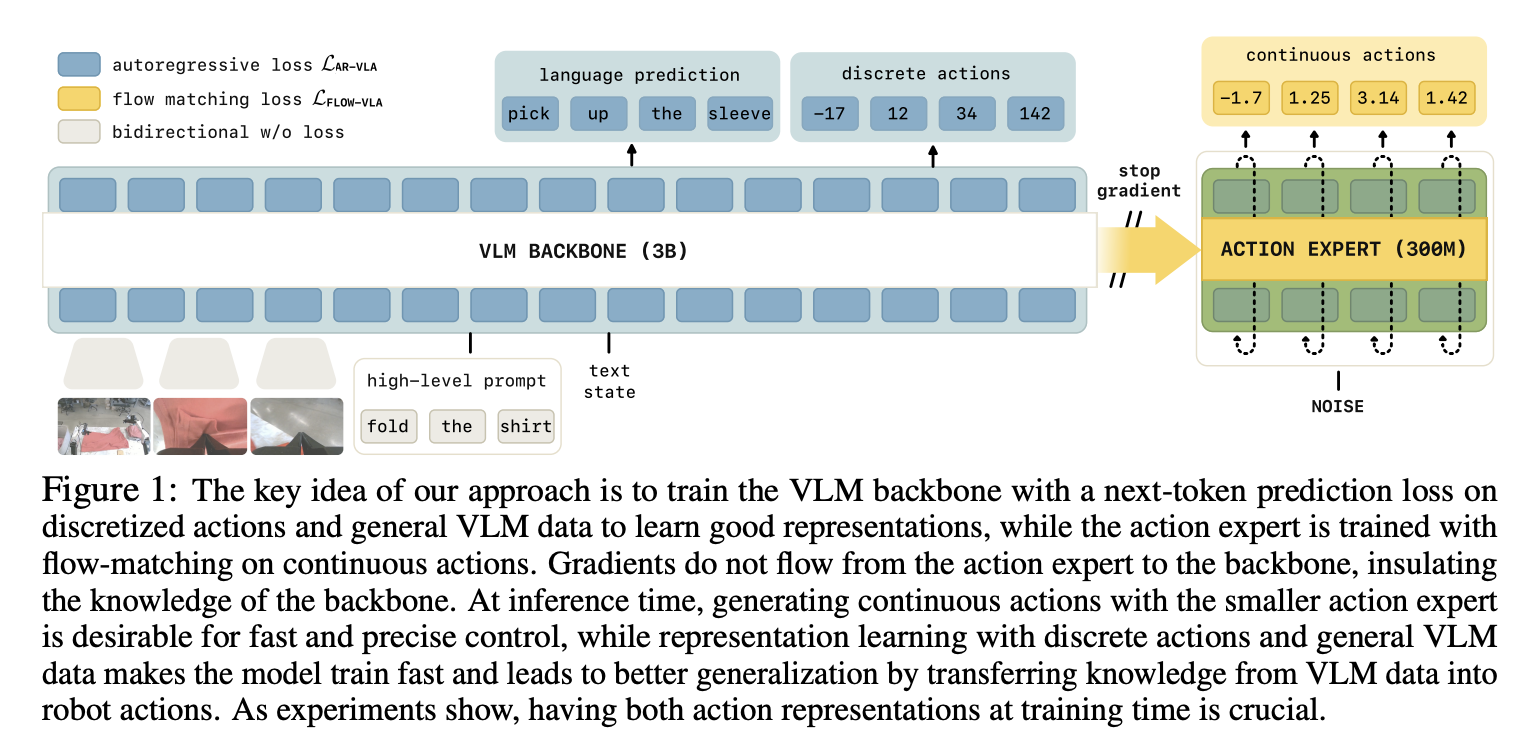
언어능력 + 시각능력 + Motion 능력으로 이렇게 우리가 계속해서 인간이 AI에게 팔다리를 붙여주고 있는데 모션 능력을 붙히면서 학습하면서 발생하는 현상이 언어능력을 잃고, 시각능력을 잃는게 보인다는 것이다. 즉, 모션능력을 학습하면서 기존의 능력을 유지할 수 없을까??
따라서 학습을할때 기존의 VLM backbone 가중치는 그대로 두기 위해서 stop gradient를 설정하는게 핵심아이디어이다.
지금까지 Mask attention으로 서로 참고할것들을 우리가 설정했었다. 그거랑 별개로, 학습할 때 가중치가 어떻게 변하는지가 여기서 진짜 헷갈렸다.
Q. pretraining에서는 그냥 학습하고, post training에서는 가중치를 그대로 둔다(freeze)는 건가??
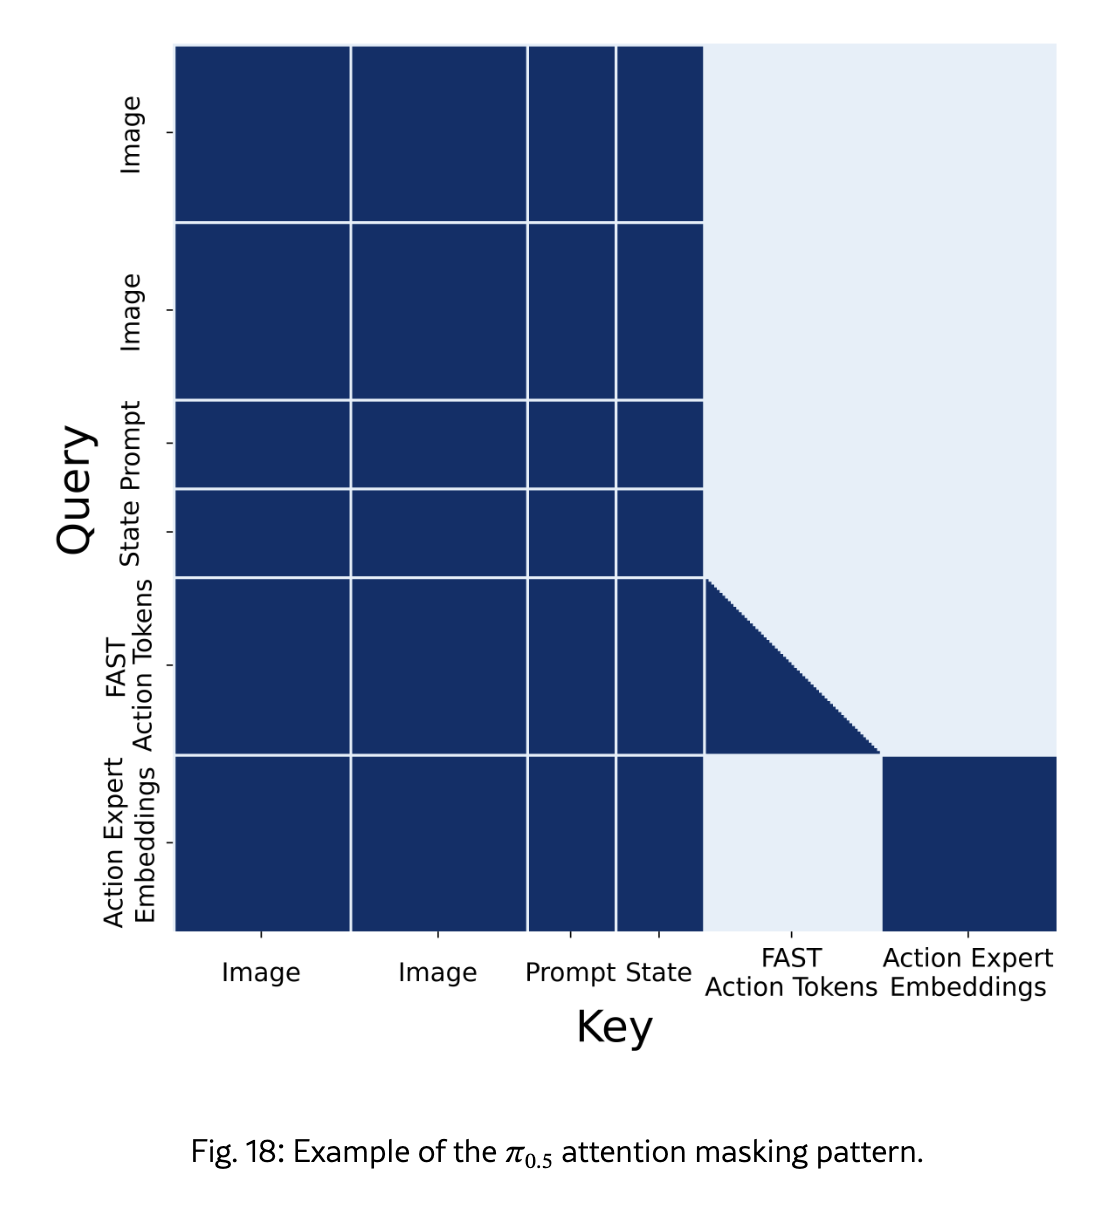
Q. 근데 가중치를 VLM 기존 / expert로 구분할 수 있나? action expert MLP 저 부분만을 의미하는건가?? joint self-attention의 Q,K,V는 어차피 학습하면서 바뀌는게 맞지??? VLM expert weights 저것만 업데이트 안하겠다 이말인건가??
A. 둘 다 아니다.
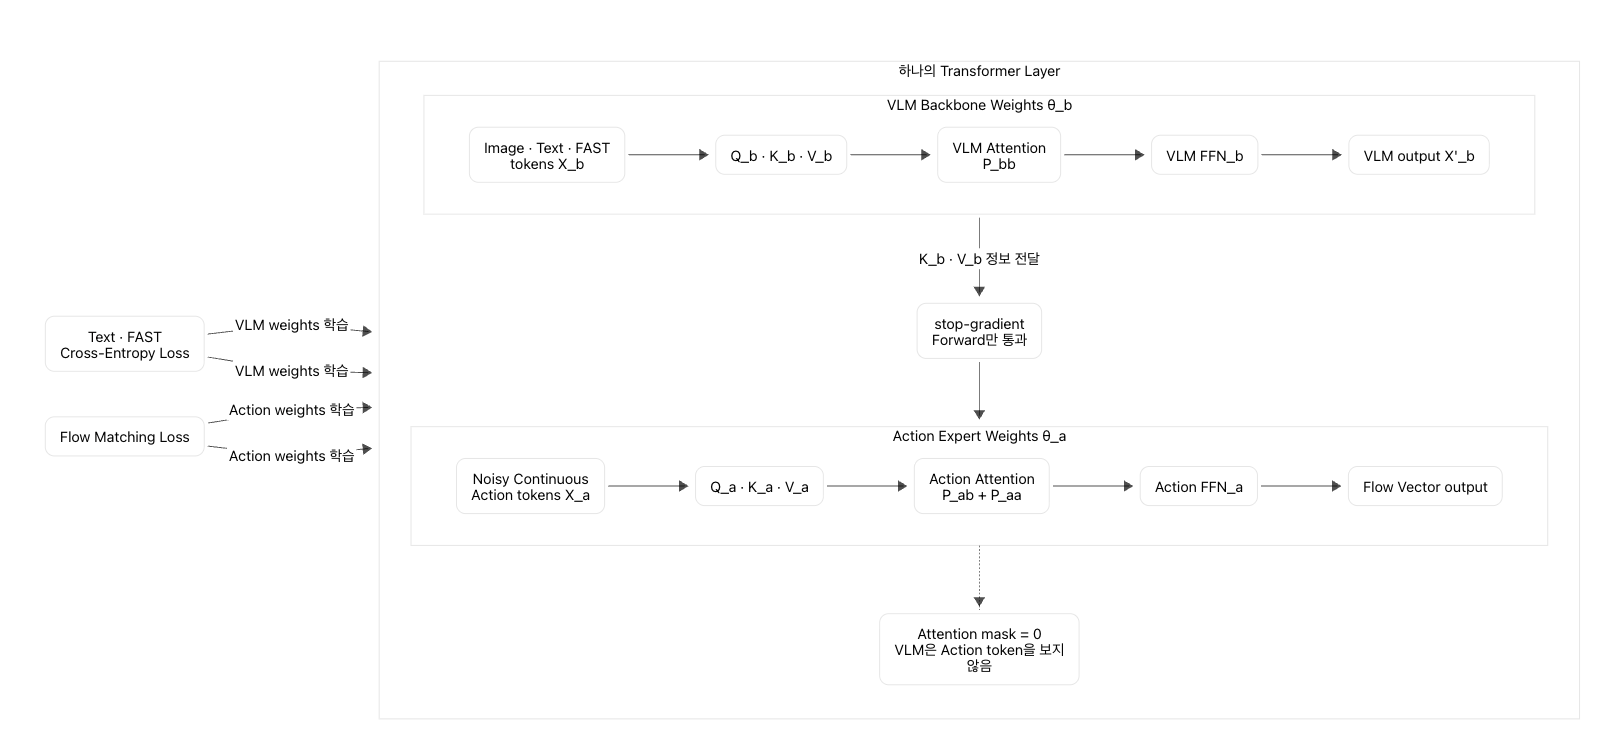
- 가중치는 애초에 토큰 종류별로 따로다. VLM 토큰은 VLM expert의 Q/K/V·FFN을, action 토큰은 action expert의 Q/K/V·FFN을 쓴다. 공유하는 건 attention 계산(서로의 K, V를 보는 것) 하나뿐이다.
- 얼리는(freeze) 건 아무것도 없다!! backbone은 text·FAST loss로 계속 학습되고, action expert는 flow loss로 학습된다.
- 막는 건 딱 하나, flow loss의 gradient가 backbone으로 넘어가는 길이다. 그게 아래 식의 $\mathrm{sg}(K_b)$, $\mathrm{sg}(V_b)$다.
- 그리고 이건 “pretraining 후 freeze”가 아니라, 하나의 training stage에서 두 loss를 동시에 학습하는 joint training이다.
→ 나만의 언어: “보는 건 되는데(forward), 탓하는 건 안 된다(backward).”
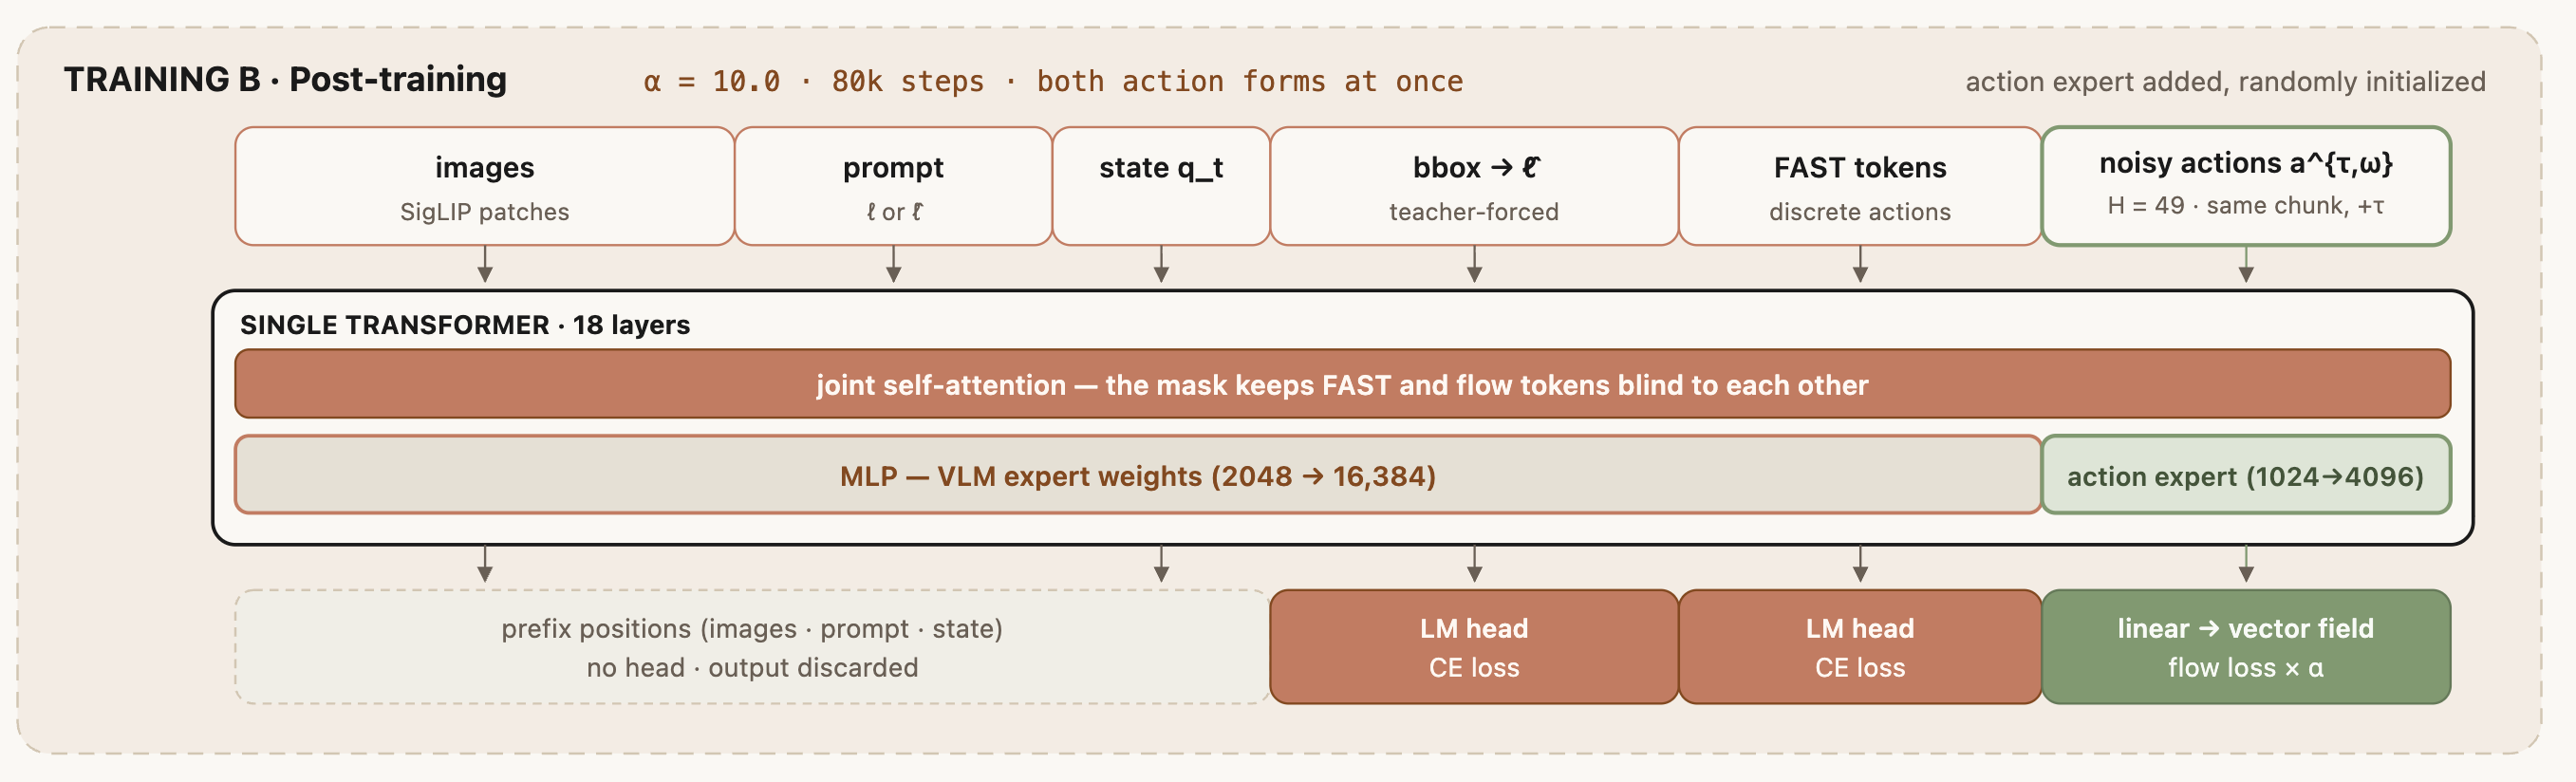
Transformer layer 내부 구조
핵심: Action Expert는 forward에서 VLM 정보를 참고하지만, Flow Matching gradient는 VLM backbone으로 넘어가지 않는다. VLM backbone은 Text·FAST loss로, Action Expert는 Flow Matching loss로 각각 학습된다.
Co-training
Joint / Co-training objective
\[\mathcal{L}_{\mathrm{CO\text{-}VLA}}(\theta) = \mathbb{E}_{\mathcal{D},\tau,\omega} \left[ -\sum_{j=1}^{n-1} M_j^{\ell} \log p_\theta\!\left(\hat{\ell}_{j+1}\mid x_{1:j}\right) + \alpha M^{\mathrm{act}} \left\| \omega-\mathbf{a}_{1:H} - f_\theta^a\!\left(\mathbf{a}_{1:H}^{\tau,\omega}\right) \right\|_2^2 \right]\] \[\mathbf{a}_{1:H}^{\tau,\omega} = \tau\mathbf{a}_{1:H}+(1-\tau)\omega, \qquad \omega\sim\mathcal{N}(0,\mathbf I)\]- Text·FAST next-token loss: text, high-level subtask, FAST action token을 다음 토큰으로 정확히 예측하도록 VLM backbone을 학습한다.
- Flow Matching loss: noisy continuous action chunk에서 정답 action 방향으로 가는 flow vector를 Action Expert가 정확히 예측하도록 학습한다.
M_j^ℓ: 해당 위치에 text·FAST token loss를 적용할지 나타내는 maskM^act: 해당 데이터에 continuous action loss를 적용할지 나타내는 maskα: 두 loss의 비중. Knowledge Insulation에서는 gradient 경로를 분리하므로 단순히α = 1로 둘 수 있다.τ: 실제 로봇 시간이 아니라 flow/noise timeω: Gaussian noisef_θ^a: Action Expert가 예측한 flow vector
π₀.₅와의 차이: 기존 π₀.₅는 먼저 FAST discrete-action pre-training으로 backbone을 action-aware하게 만든 뒤, post-training에서 continuous Action Expert를 학습하는 2-stage 방식이었다. Knowledge Insulation은 Text·FAST objective와 Flow Matching objective를 같은 training stage에서 함께 최적화한다.
중요한 교정: “두 branch의 weight가 원래 따로라서”만으로는 충분하지 않다. Action Expert는 attention으로 VLM의 key/value를 참고하므로, 그대로 두면 Flow loss의 gradient가 VLM까지 흘러간다. 별도 Q/K/V·FFN weights에 더해 stop-gradient로 backward 경로까지 끊었기 때문에 한 번에 안정적으로 joint training할 수 있다.
용어: joint training은 discrete FAST branch와 continuous Flow branch를 동시에 학습한다는 뜻이고, co-training은 robot action data뿐 아니라 web VLM·language·planning data까지 같은 학습 과정에 섞는다는 뜻이다.
Attention probability 분할
\[P = \mathrm{softmax}\!\left(Q(X)K(X)^{T}+A\right) = \begin{pmatrix} P_{bb} & 0 \\ P_{ab} & P_{aa} \end{pmatrix}\]Knowledge Insulation — 식 (5)
\[\begin{pmatrix} P_{bb} & 0 \\ P_{ab} & P_{aa} \end{pmatrix} = \mathrm{softmax}\!\left( \begin{pmatrix} Q_b(X_b)K_b(X_b)^{T} & 0 \\ Q_a(X_a)\,\mathrm{sg}\!\left(K_b(X_b)^{T}\right) & Q_a(X_a)K_a(X_a)^{T} \end{pmatrix} +A \right) \tag{5}\]Value embedding — 식 (6)
\[E = \begin{pmatrix} E_b \\ E_a \end{pmatrix} = \begin{pmatrix} P_{bb}V_b(X_b) \\ P_{ab}\,\mathrm{sg}\!\left(V_b(X_b)\right) + P_{aa}V_a(X_a) \end{pmatrix} \tag{6}\] \[\mathrm{attn}(X)=PE\]b: VLM backbonea: Action ExpertP_bb: backbone token이 backbone token을 보는 attention probabilityP_ab: Action Expert token이 backbone token을 보는 attention probabilityP_aa: Action Expert token끼리 보는 attention probabilityA: attention masksg(·): forward 값은 그대로 사용하지만, backward gradient는 통과시키지 않는 stop-gradient 연산
핵심: Action Expert는 forward에서 backbone의 key와 value를 참고한다. 하지만 식 (5)의
sg(K_b)와 식 (6)의sg(V_b)때문에 Flow Matching loss의 gradient는 backbone으로 역전파되지 않는다.
결과
- 실제 로봇 성능: drawer, table bussing, shirt folding, mobile manipulation 등에서 전반적으로 가장 높은 성능을 보였고, 학습에서 보지 못한 환경에서도 우수했다.
- Knowledge Insulation 효과: stop-gradient를 제거한 joint-training과 π₀는 언어 지시를 더 자주 무시했다. 즉 Action Expert의 gradient를 차단하면 기존 VLM의 language-following 능력이 더 잘 보존된다.
- 학습 속도: π₀-FAST와 비슷하게 빠르게 수렴했으며, Flow Matching만 사용하는 π₀는 비슷한 성능에 도달하는 데 약 7.5배 많은 training step이 필요했다.
- Generalization: VLM data co-training은 학습에서 보지 못한 물체와 환경에 대한 OOD generalization을 향상시켰다.
- 공개 benchmark: DROID에서 0.55 ± 0.09로 π₀의 0.49, π₀-FAST의 0.45보다 높았다. LIBERO-Spatial 98.0%, LIBERO-90 96.0%로 SOTA를 기록했지만, LIBERO-10에서는 최고 성능이 아니었다.
- 한계: discrete·continuous objective를 함께 사용해 step당 학습 비용이 약 20% 증가하지만, 더 빠른 수렴으로 전체 학습 시간은 줄어든다. Language following 역시 개선됐지만 완벽하지는 않다.
한 줄 결론: FAST loss로 backbone을 빠르게 action-aware하게 만들고, Knowledge Insulation으로 VLM 지식을 보호하면서, 작은 Flow Action Expert로 빠르고 정밀한 continuous action inference까지 유지했다.