
π₀-FAST - Efficient Action Tokenization
고주파 robot action을 autoregressive VLA는 왜 잘 못 배울까? FAST가 DCT와 BPE로 action을 어떻게 압축했는지, 그리고 실험이 무엇을 검증했는지 논문 순서대로 정리했다.
논문: FAST: Efficient Action Tokenization for Vision-Language-Action Models
핵심 요약
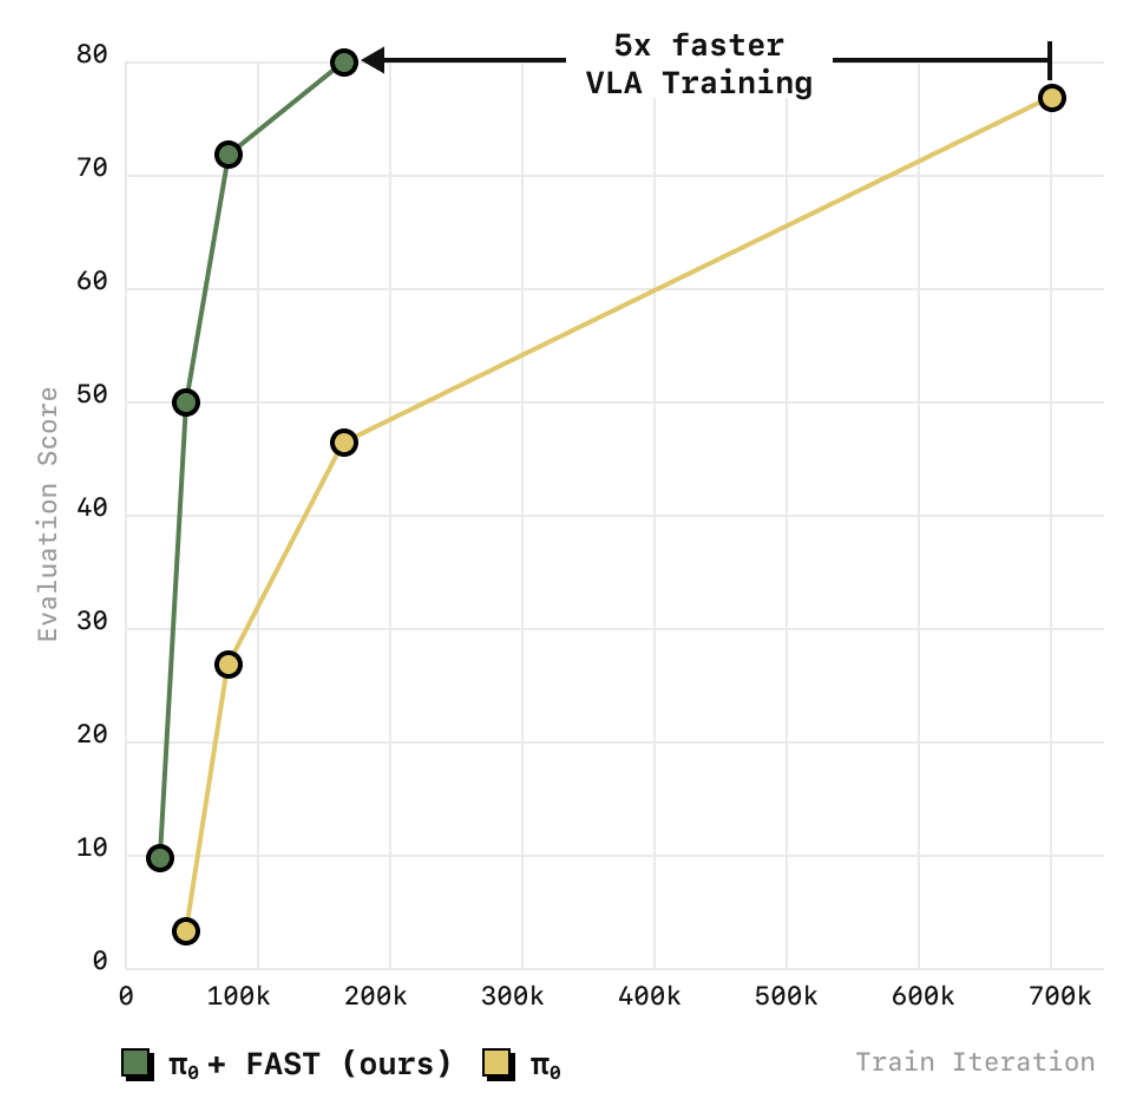
We find that current approaches for robot action tokenization, based on simple per-dimension, per-timestep binning schemes, typically perform poorly when learning dexterous skills from high-frequency robot data. Our tokenization approach, Frequency-space Action Sequence Tokenization (FAST), enables us to train autoregressive VLAs for highly dexterous and high-frequency tasks where standard discretization methods fail completely. Based on FAST, we release FAST+, a universal robot action tokenizer, trained on 1M real robot action trajectories. → 결국 트레이닝 시간을 단축시켰다.
main
- Our key insight is that robot action signals need to be compressed before training, to reduce correlation between consecutive tokens.
- discrete cosine transform (DCT) encoding
- Tokenization (multimodal → token)
- byte pair encoding (흔히 반복되는 패턴 들을 압축해서 하나의 기호로 표현하고 그거를 토큰으로 여김)
- vector-quantizing autoencoder
핵심 아키텍쳐
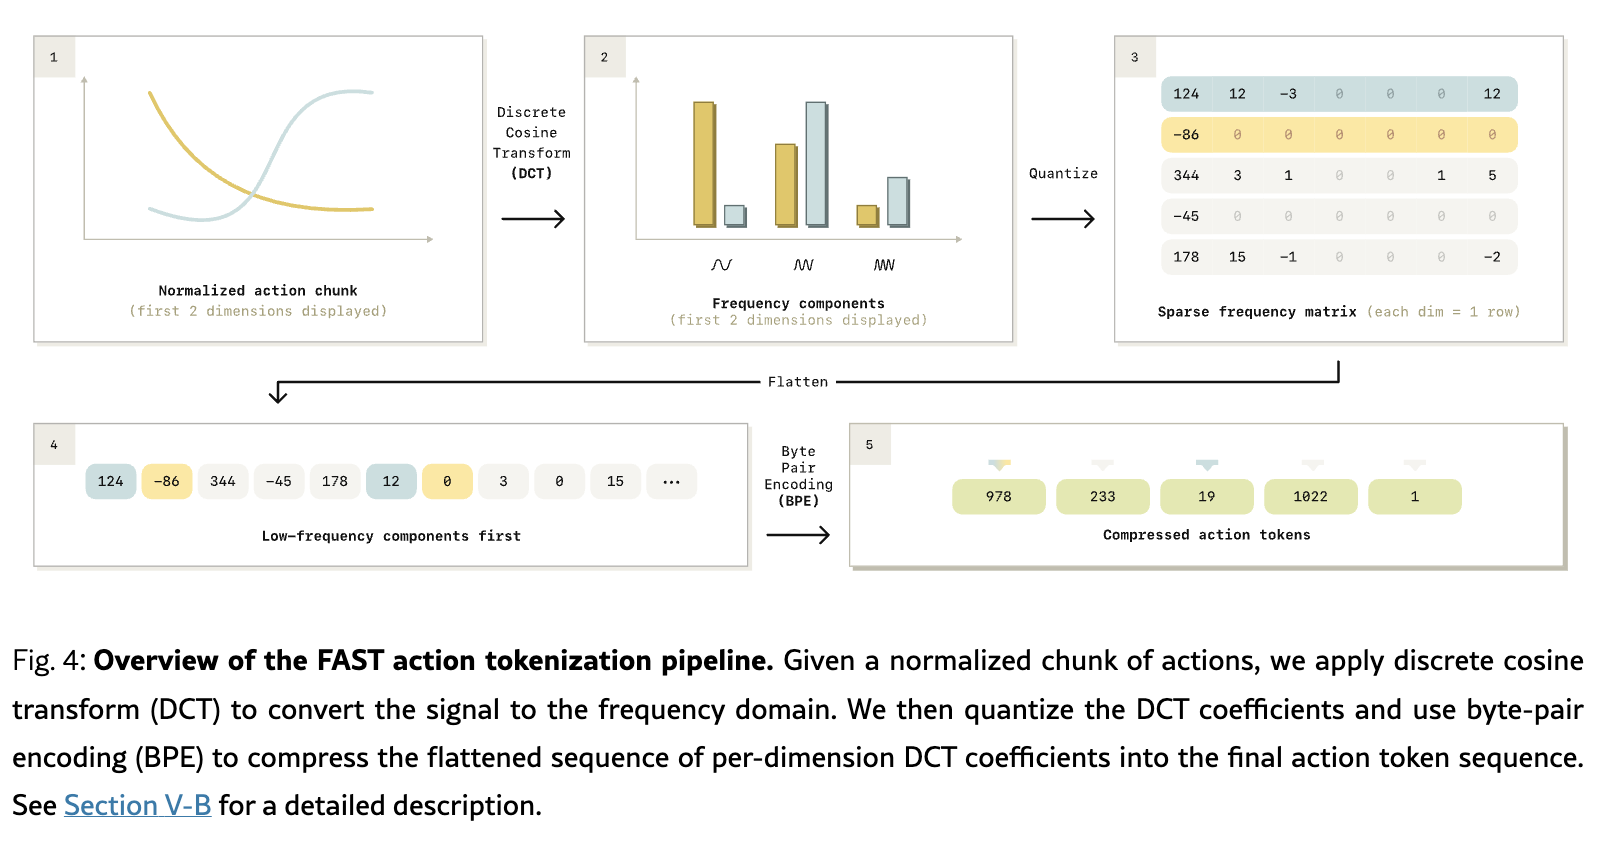
- normalize action chunk
- Discrete Cosine Transform (DCT)
Scale & Round operation (scaling coeff - hyper parameter)
→ “After the rounding operation, the DCT coefficient matrix is typically sparse, with most entries being zero and only a few significant coefficients remaining per action dimension”
- Flatten the Matrix (Low frequency components first)
- BPE tokenizer (n dimension for the real action token)
총 2가지 하이퍼 파라메터
- rounding scale : 10
- BPE vocabulary size : 1024
1
2
3
4
5
6
7
from transformers import AutoProcessor

tokenizer = AutoProcessor.from_pretrained(
    "physical-intelligence/fast",
    trust_remote_code=True
    )
tokens = tokenizer(action_chunk)
Q. High Frequency의 의미?
여기서 control frequency는 로봇이 얼마나 빨리 움직이는지가 아니라, action 명령을 1초에 몇 번 갱신하는지를 뜻한다.
- 20 Hz: 1초에 action 명령을 20번 갱신한다. 즉, 0.05초마다 한 번이다.
- 50 Hz: 1초에 action 명령을 50번 갱신한다. 즉, 0.02초마다 한 번이다.
로봇이 천천히 움직이더라도 50 Hz로 기록하면 인접한 action 값은 0.100 → 0.101 → 0.102 → 0.103처럼 거의 같을 수 있다. 이때 autoregressive Transformer는 전체 움직임 패턴을 배우지 않고 이전 action token을 반복해도 낮은 loss를 얻기 쉽다. FAST는 이렇게 중복되는 고주파 action sequence를 압축해 더 짧고 정보량 높은 token sequence로 만든다.
Experiment가 검증한 것
1. FAST가 실제로 token 수를 줄이는가? — VI-B
1초 action chunk를 기준으로 FAST는 특히 고주파 데이터에서 token 수를 크게 줄였다.
- Shirt Folding 50 Hz: naïve 700 tokens → FAST 53 tokens
- Table Bussing 20 Hz: naïve 140 tokens → FAST 28 tokens
즉, FAST는 고주파 action sequence에 반복되어 있는 정보를 압축한다. Table I
2. 압축하면 실제 로봇 정책도 잘 학습되는가? — VI-B
Naïve binning, 학습형 tokenizer인 FSQ, FAST, 범용 tokenizer FAST+를 비교했다.
- Naïve 방식은 20–50 Hz의 복잡한 작업에서 거의 진전하지 못했다.
- FSQ도 압축 덕분에 naïve 방식보다 좋아졌다.
- FAST는 FSQ와 비슷하거나 더 좋은 성능을 보였으며, 별도의 neural tokenizer 학습이 필요하지 않았다.
따라서 핵심은 action을 압축하여 Transformer가 정보량 높은 token을 예측하게 만드는 것이다. Figure 6
3. FAST+를 새로운 로봇에도 그대로 쓸 수 있는가? — VI-C
100만 개의 real-robot action sequence로 만든 범용 tokenizer FAST+를 학습 때 보지 않은 robot morphology, action space, control frequency에 적용했다.
- 새로운 데이터에서도 action token 수를 최소 약 2배 줄였다.
- 정책 학습에서는 dataset-specific FAST와 비슷한 성능을 보였다.
따라서 FAST+는 매번 새로 학습하지 않고 사용할 수 있는 범용 action tokenizer의 기본값이 될 수 있다. 다만 humanoid나 mobile robot에서는 offline compression을 확인한 것이며, 실제 policy rollout 성능까지 모두 검증한 것은 아니다. VI-C
4. 특정 Transformer에서만 작동하는가? — VI-D
FAST를 π₀뿐 아니라 OpenVLA에도 적용했을 때 고주파 Shirt Folding 학습 성능이 개선되었다. 따라서 특정 VLA backbone에만 의존하는 방법은 아니라는 근거를 제시한다. BPE를 제거한 ablation에서는 DCT만으로도 naïve 방식보다 좋았지만, 반복되는 0 token이 많이 남아 sequence가 길어지고 policy 성능과 추론 속도가 떨어졌다.
DCT: 전체 움직임 정보를 소수의 주파수 성분에 집중한다.
BPE: 남아 있는 반복 패턴과 0을 실제로 압축한다.
5. 기존 diffusion π₀보다 좋은가? — VI-E
- 작은 데이터인 LIBERO와 T-Shirt Folding에서는 두 방식의 성능이 비슷했다.
- 큰 Table Bussing 데이터에서는 π₀-FAST가 약 3배 적은 training steps로 높은 성능에 도달했다.
- DROID에서는 FAST 기반 autoregressive 모델이 언어 명령을 더 잘 따르는 경향을 보고했다.
하지만 π₀-FAST는 추론이 더 느렸다.
- Diffusion π₀: 약 100 ms/action chunk
- π₀-FAST: 약 750 ms/action chunk
따라서 FAST의 장점은 주로 training efficiency이며, inference latency가 더 빠르다는 뜻은 아니다. Figure 9와 VI-E
6. 대규모 generalist policy까지 확장되는가? — VI-F
약 10,000시간 규모의 cross-embodied robot data로 π₀-FAST를 학습했다.
- Diffusion π₀와 전반적으로 비슷한 robot performance를 보였다.
- 어려운 laundry folding도 수행했다.
- 높은 성능에 도달하는 데 약 5배 적은 GPU training hours가 필요했다.
Experiment의 최종 결론
FAST는 autoregressive VLA가 고주파·정교한 robot action data를 학습할 수 있게 만든다. π₀-FAST는 diffusion π₀와 비슷한 성능을 훨씬 적은 training compute로 달성했지만, autoregressive decoding 때문에 inference는 더 느리다.