
π₀.₅ - VLA with Open-World Generalization
한 번도 본 적 없는 집에 로봇을 갖다 놓아도 정리를 할 수 있을까? π₀.₅가 FAST token 학습과 Flow Matching Action Expert, high-level subtask 예측을 어떻게 한 모델에 묶었는지 정리했다.
논문: π₀.₅: a Vision-Language-Action Model with Open-World Generalization
핵심 요약
π₀.₅는 π₀를 기반으로, 여러 robot embodiment의 데이터·high-level semantic subtask·verbal instruction·multimodal web data를
heterogeneous co-training하여 새로운 환경에서도 일반화하도록 만든 VLA 모델이다.
- Pre-training에서는 robot action을 FAST discrete token으로 표현해 scalable한 next-token prediction을 수행하고,
- Post-training에서는 Flow Matching Action Expert를 추가해 정밀한 continuous action chunk와 빠른 real-time control을 학습한다. 추론 시에는 같은 모델이 먼저 “무엇을 할지”에 해당하는 high-level subtask를 예측한 뒤, 그 subtask를 조건으로 “어떻게 움직일지”에 해당하는 low-level action을 생성한다.
논문은 이 조합을 통해 학습에서 보지 않은 실제 집에서도 주방·침실 정리처럼 10–15분 길이의 long-horizon manipulation task를 수행할 수 있음을 보고한다.
“open-world generalization을 가능하게 하는 training recipe와 그 실증”
Architecture
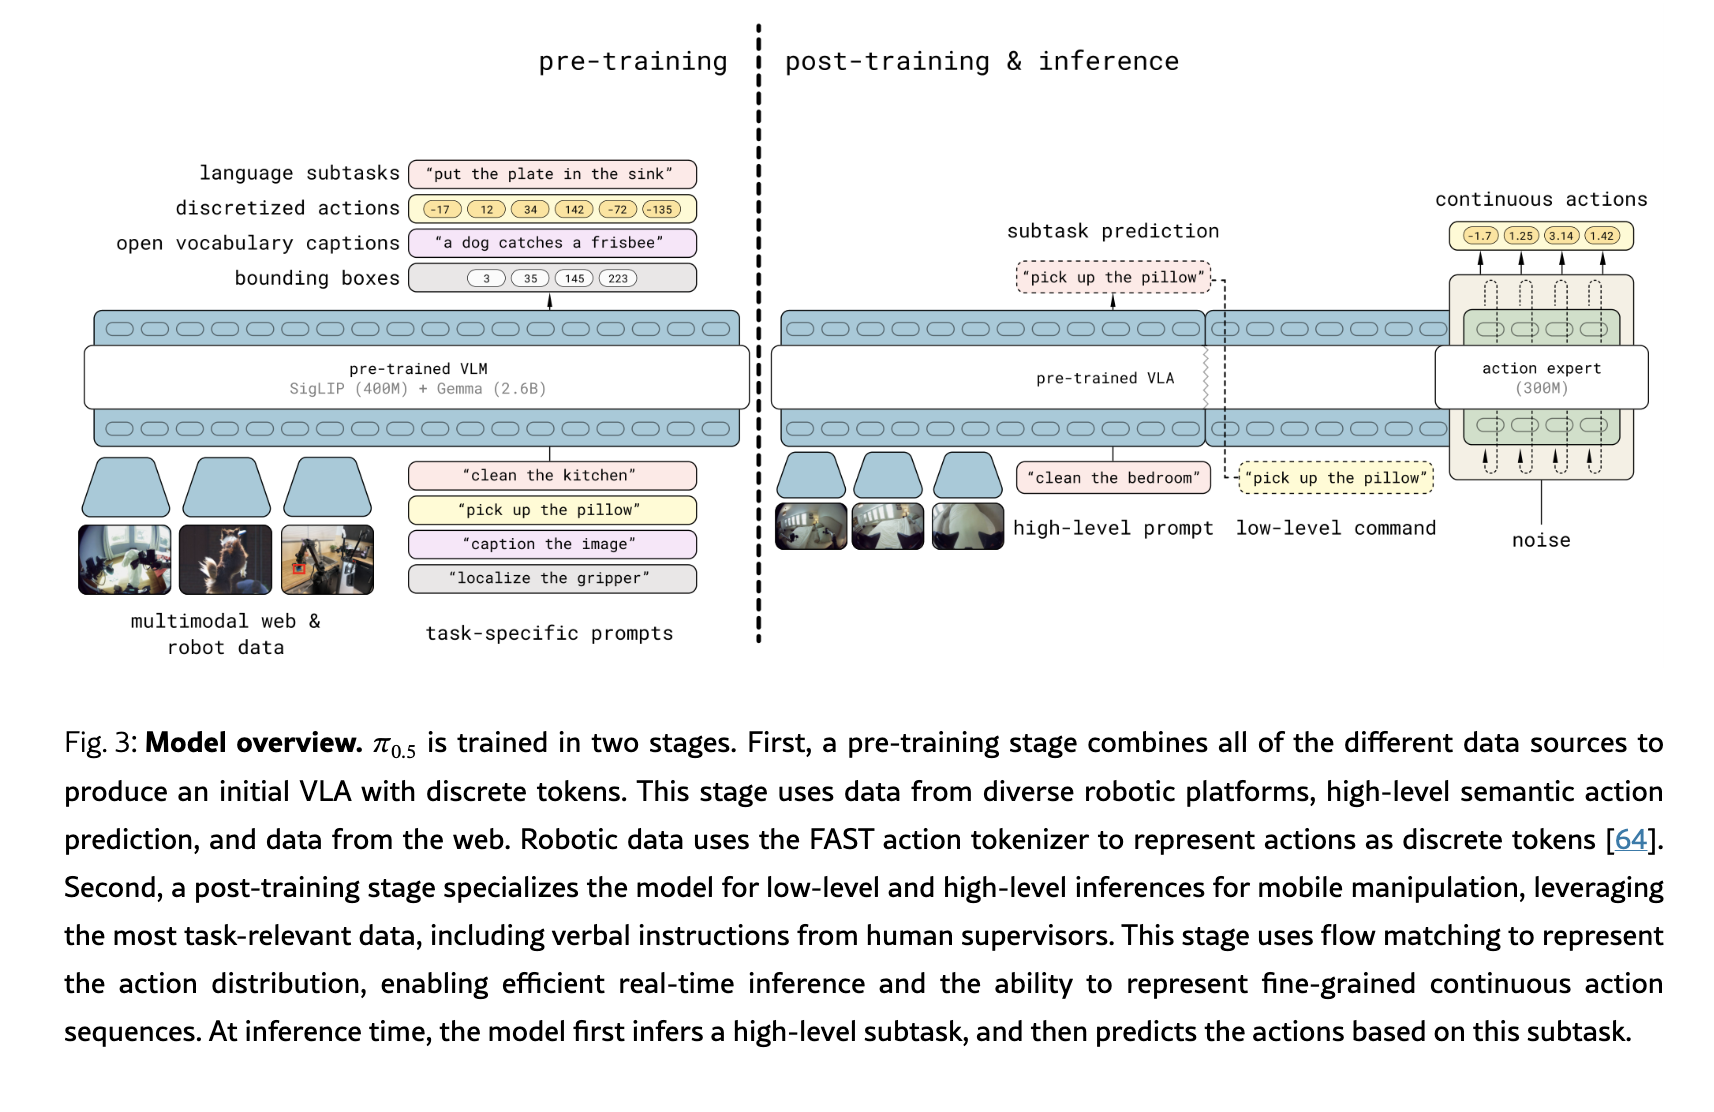
π₀.₅는 하나의 시스템 안에 VLM backbone과 Action Expert라는 두 계산 경로를 둔다. 두 경로는 완전히 독립된 모델이 아니라 같은 multimodal sequence 안에서 attention으로 연결되지만, token 종류에 따라 서로 다른 expert weights를 사용한다.
- VLM backbone (약 2B)
- Action Expert (약 300M)
핵심: VLM은 “무엇을 할지”를 discrete text로 결정하고, Action Expert는 “어떻게 움직일지”를 continuous action으로 생성한다.
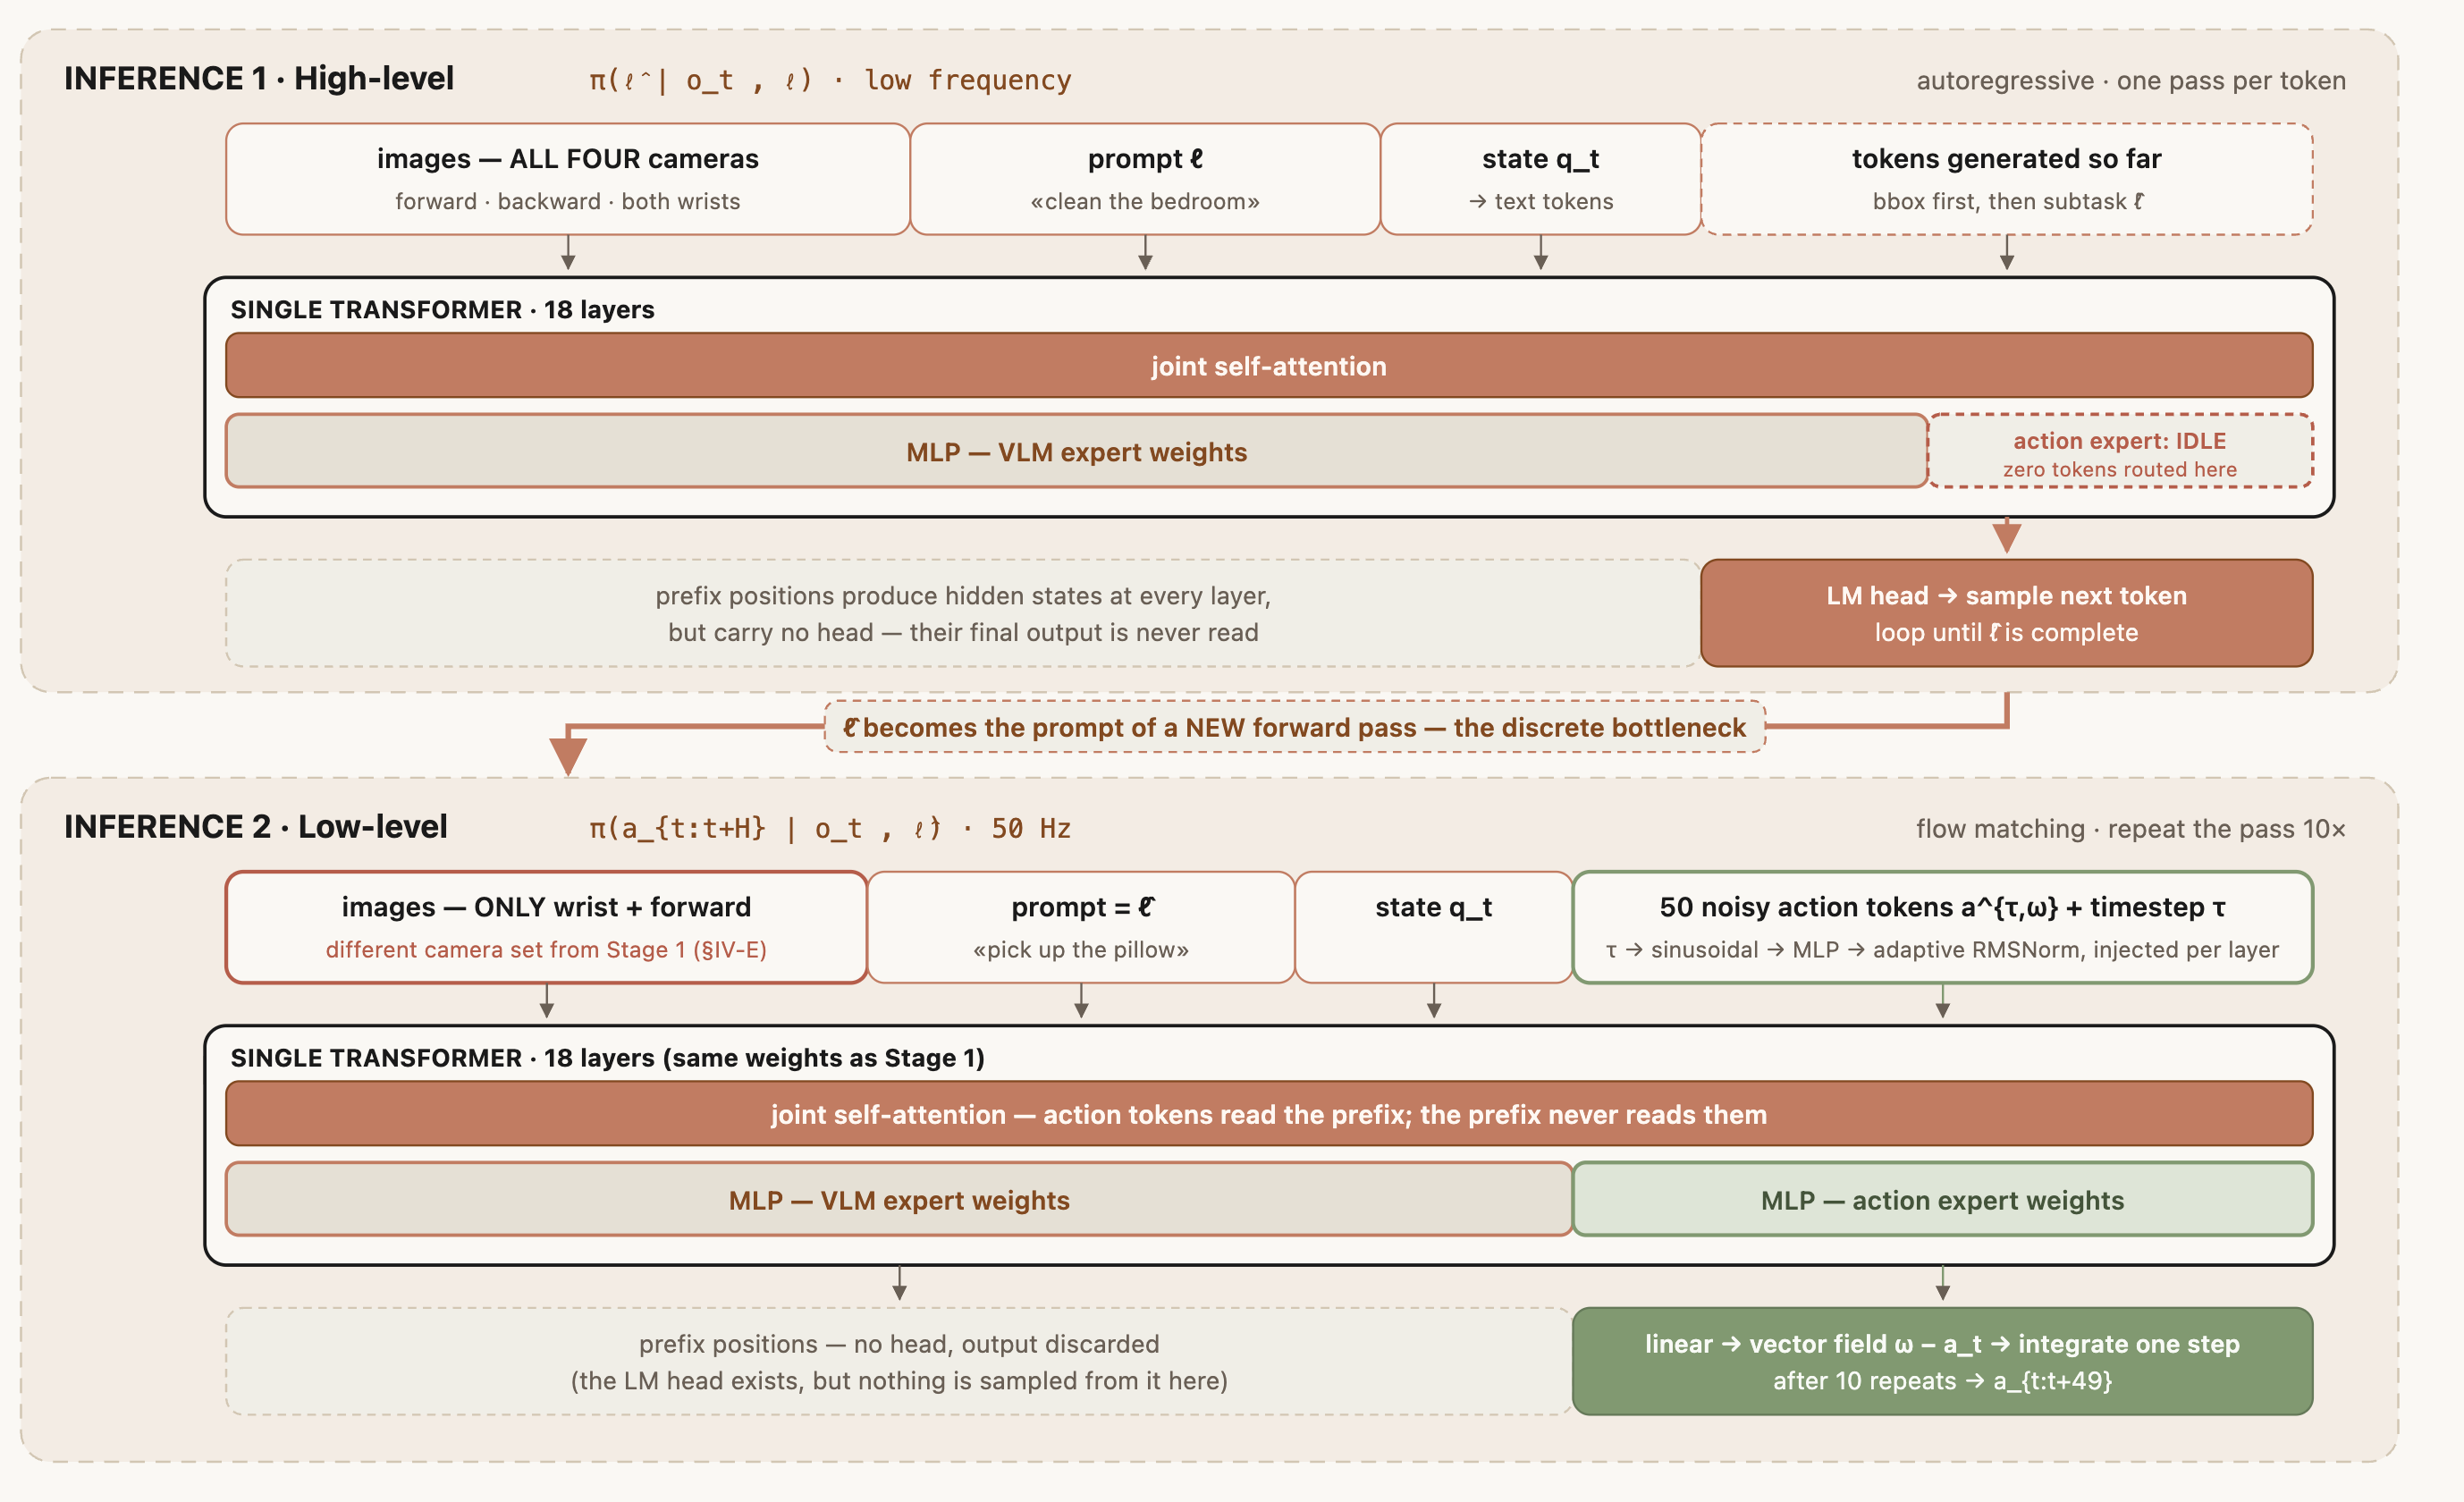
실제 inference
- 입력 구성: 현재 observation oₜ에 여러 camera image와 robot proprioceptive state를 넣고, 전체 task prompt ℓ을 함께 입력한다.
- High-level inference: VLM backbone이 현재 장면과 전체 명령을 보고 다음
high-level subtask ℓ̂을 autoregressive text token으로 생성한다. - 조건 갱신: 생성된
subtask ℓ̂을 다시 prefix 조건에 포함한다. 예를 들어 “clean the kitchen”이라는 전체 명령에서 “pick up the plate”라는 현재 subtask가 만들어진다. - Low-level inference: Action Expert가 image·state·predicted subtask를 참고하여
Gaussian noise로 시작한 action chunk 전체를 10번의 Flow Matching integration step으로 갱신한다.- → 주의할 점은!!!!! 추론단계에서는 FAST Algorithm을 가지고, 토큰 → 액션 청크가 아니라 그냥 Diffusion method를 쓴다.
- Action 실행: 완성된 continuous action chunk를 로봇이 실행하고, 새 observation을 받은 뒤 필요한 시점에 다시 subtask와 action chunk를 예측한다.
전체 흐름: image + state + overall task → VLM backbone → predicted subtask ℓ̂ → image + state + ℓ̂ + noisy action chunk → Flow Matching Action Expert → continuous action chunk
모델의 예측 확률식
\[\pi_{\theta}\!\left(\mathbf{a}_{t:t+H},\hat{\ell}\mid\mathbf{o}_t,\ell\right) =\pi_{\theta}\!\left(\mathbf{a}_{t:t+H}\mid\mathbf{o}_t,\hat{\ell}\right)\, \pi_{\theta}\!\left(\hat{\ell}\mid\mathbf{o}_t,\ell\right)\]
식의 기호
| 기호 | 뜻 |
|---|---|
| $\pi_\theta$ | 파라미터 $\theta$를 가진 π₀.₅ 모델의 확률분포 |
| $\theta$ | 학습되는 모델 가중치 전체 |
| $\mathbf{o}_t$ | 환경 시간 $t$의 관측: 카메라 이미지 + robot proprioceptive state |
| $\ell$ | 전체 task 명령, 예: “put away the dishes” |
| $\hat{\ell}$ | 모델이 예측한 high-level subtask, 예: “pick up the plate” |
| $\mathbf{a}_{t:t+H}$ | 현재부터 horizon $H$까지의 continuous action chunk |
| $t, H$ | $t$는 실제 환경 시간, $H$는 action chunk 길이 |
여기서 결국에 우리모델의 예측 확률은, 두단계 즉 $\hat{\ell}$을 예측할 확률과 action chunk을 예측할 확률을 곱한다. 근데 이건 독립이라서 곱하는게 아니다!! 그냥 chain rule이다: $p(\mathbf{a}, \hat{\ell} \mid \mathbf{o}, \ell) = p(\hat{\ell} \mid \mathbf{o}, \ell) \cdot p(\mathbf{a} \mid \mathbf{o}, \ell, \hat{\ell})$. action은 오히려 $\hat{\ell}$에 완전히 의존한다.
여기서 들어간 가정은 딱 하나다. $\hat{\ell}$이 주어지면 action은 더 이상 원래 명령 $\ell$을 볼 필요가 없다는 것: $p(\mathbf{a} \mid \mathbf{o}, \ell, \hat{\ell}) \approx p(\mathbf{a} \mid \mathbf{o}, \hat{\ell})$. 그래서 식에서 action 쪽 조건에 $\ell$이 빠져 있는 것이다.
→ 나만의 언어: “큰 명령($\ell$)은 subtask($\hat{\ell}$)를 고를 때만 쓰고, 몸은 subtask만 보고 움직인다.”
여기서 중요한 것은 학습 단계와 실제 추론 단계에서 action을 표현하는 방식이 다르다는 점이다. Pre-training에서는 FAST discrete token으로 대규모 데이터를 효율적으로 학습하고, post-training에서는 Flow Matching Action Expert를 추가한다. 최종 추론에서는 FAST action token 대신 Action Expert가 continuous action chunk를 생성한다.
Training objective
\[\mathcal{L}(\theta) = \mathbb{E}_{\mathcal{D},\tau,\omega} \left[ \mathcal{H}\!\left(x_{1:M},f^{\ell}_{\theta}(\mathbf{o}_t,\ell)\right) + \alpha \left\| \omega-\mathbf{a}_{t:t+H} - f^{a}_{\theta}\!\left( \mathbf{a}^{\tau,\omega}_{t:t+H}, \mathbf{o}_t, \ell \right) \right\|^{2} \right]\] \[\mathbf{a}^{\tau,\omega}_{t:t+H} = \tau\mathbf{a}_{t:t+H} + (1-\tau)\omega, \qquad \omega\sim\mathcal{N}(0,\mathbf{I})\]
Loss의 두 부분
- Discrete next-token branch: H(x₁:ₘ, fᶩθ(oₜ, ℓ))
- 정답 text·object location·high-level subtask·FAST action token과 VLM의 예측 logits 사이의 cross-entropy loss다.
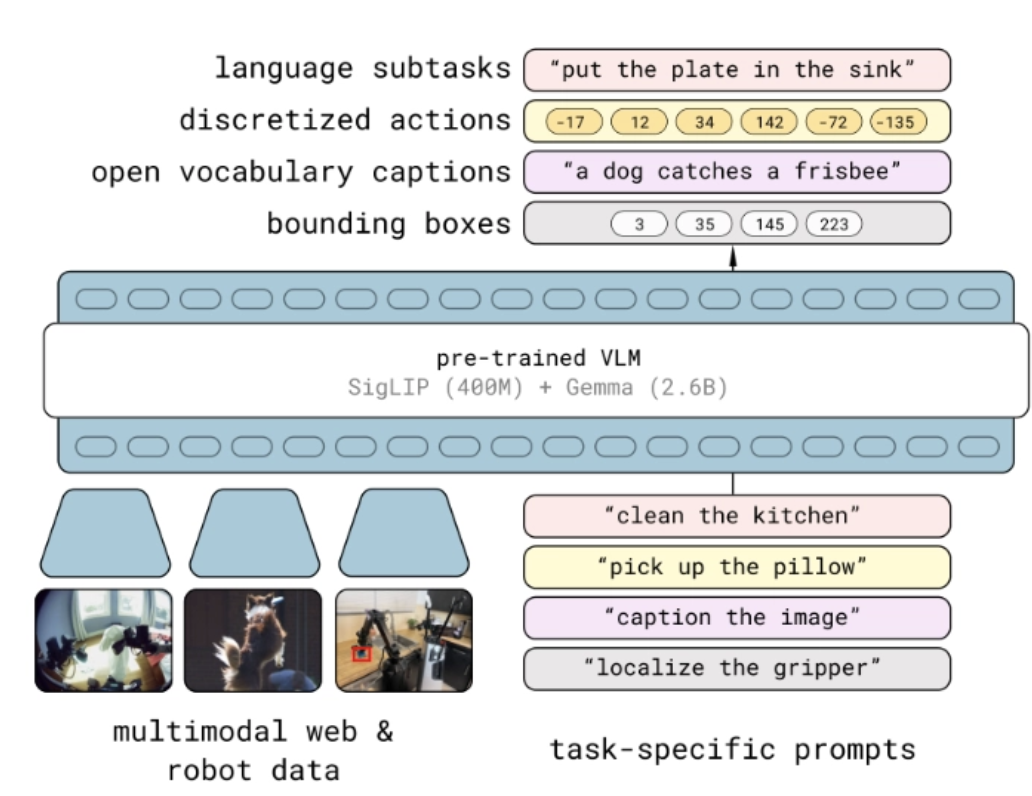
→ 이 부분이 정말 헷갈린다. 왜냐하면 단순히 subtask만 잘 맞추도록 학습하는게 아니다 (추론에서는 그것만 쓰는데) 그게 아니라, 아래 figure의 pretraining 부분에서 보이듯이
- language subtasks
- discretized actions (이 부분이 핵심임 액션도 본다는거임, 근데 학습 속도를 올리기 위해서 토큰으로 보고 그렇기에 실제 정답은 로봇 엑션 청크 → FAST → token)
- open vocabulary captions
- bounding boxes
→ 이렇게 다 맞도록 학습한다.
- Continuous Flow Matching branch: α‖ω − aₜ:ₜ₊ₕ − fᵃθ(·)‖²
- Action Expert가 예측한 flow vector를 정답 방향 ω − aₜ:ₜ₊ₕ에 맞추는 squared L2 loss다.
→ pi_0 시간에 다룸 똑같음.
→ 부호 주의: 위 보간식을 τ로 미분하면 정답 방향은 a − ω인데, 논문은 π₀ 논문(v1–v3)과 같은 표기로 ω − a라고 적었다. 방향 부호만 다를 뿐 같은 얘기다 (자세한 건 π₀ 글 참고).
Training loss 기호
| 기호 | 뜻 |
|---|---|
| 𝓛(θ) | π₀.₅가 최소화하는 전체 training loss |
| 𝔼𝒟,τ,ω | 학습 데이터, flow time, noise를 sampling하여 계산한 평균 |
| 𝒟 | robot data와 web data 등을 포함한 training mixture |
| x₁:ₘ | 정답 discrete output token sequence. text·object location·subtask·FAST action token을 포함 |
| M | loss가 적용되는 discrete output token의 개수 |
| fᶩθ | VLM backbone이 출력하는 text/FAST token logits |
| 𝓗 | 정답 token과 예측 logits 사이의 cross-entropy |
| τ ∈ [0,1] | 실제 환경 시간 t와 다른 가상의 Flow Matching time |
| ω ∼ 𝒩(0,I) | action chunk와 섞는 Gaussian noise |
| a^(τ,ω)ₜ:ₜ₊ₕ | 정답 action과 noise를 τ에 따라 섞은 중간 noisy action chunk |
| fᵃθ | Action Expert가 예측하는 flow vector field |
| ω − aₜ:ₜ₊ₕ | 학습에서 사용하는 정답 flow direction |
| α | next-token loss와 Flow Matching loss의 비중을 조절하는 계수 |
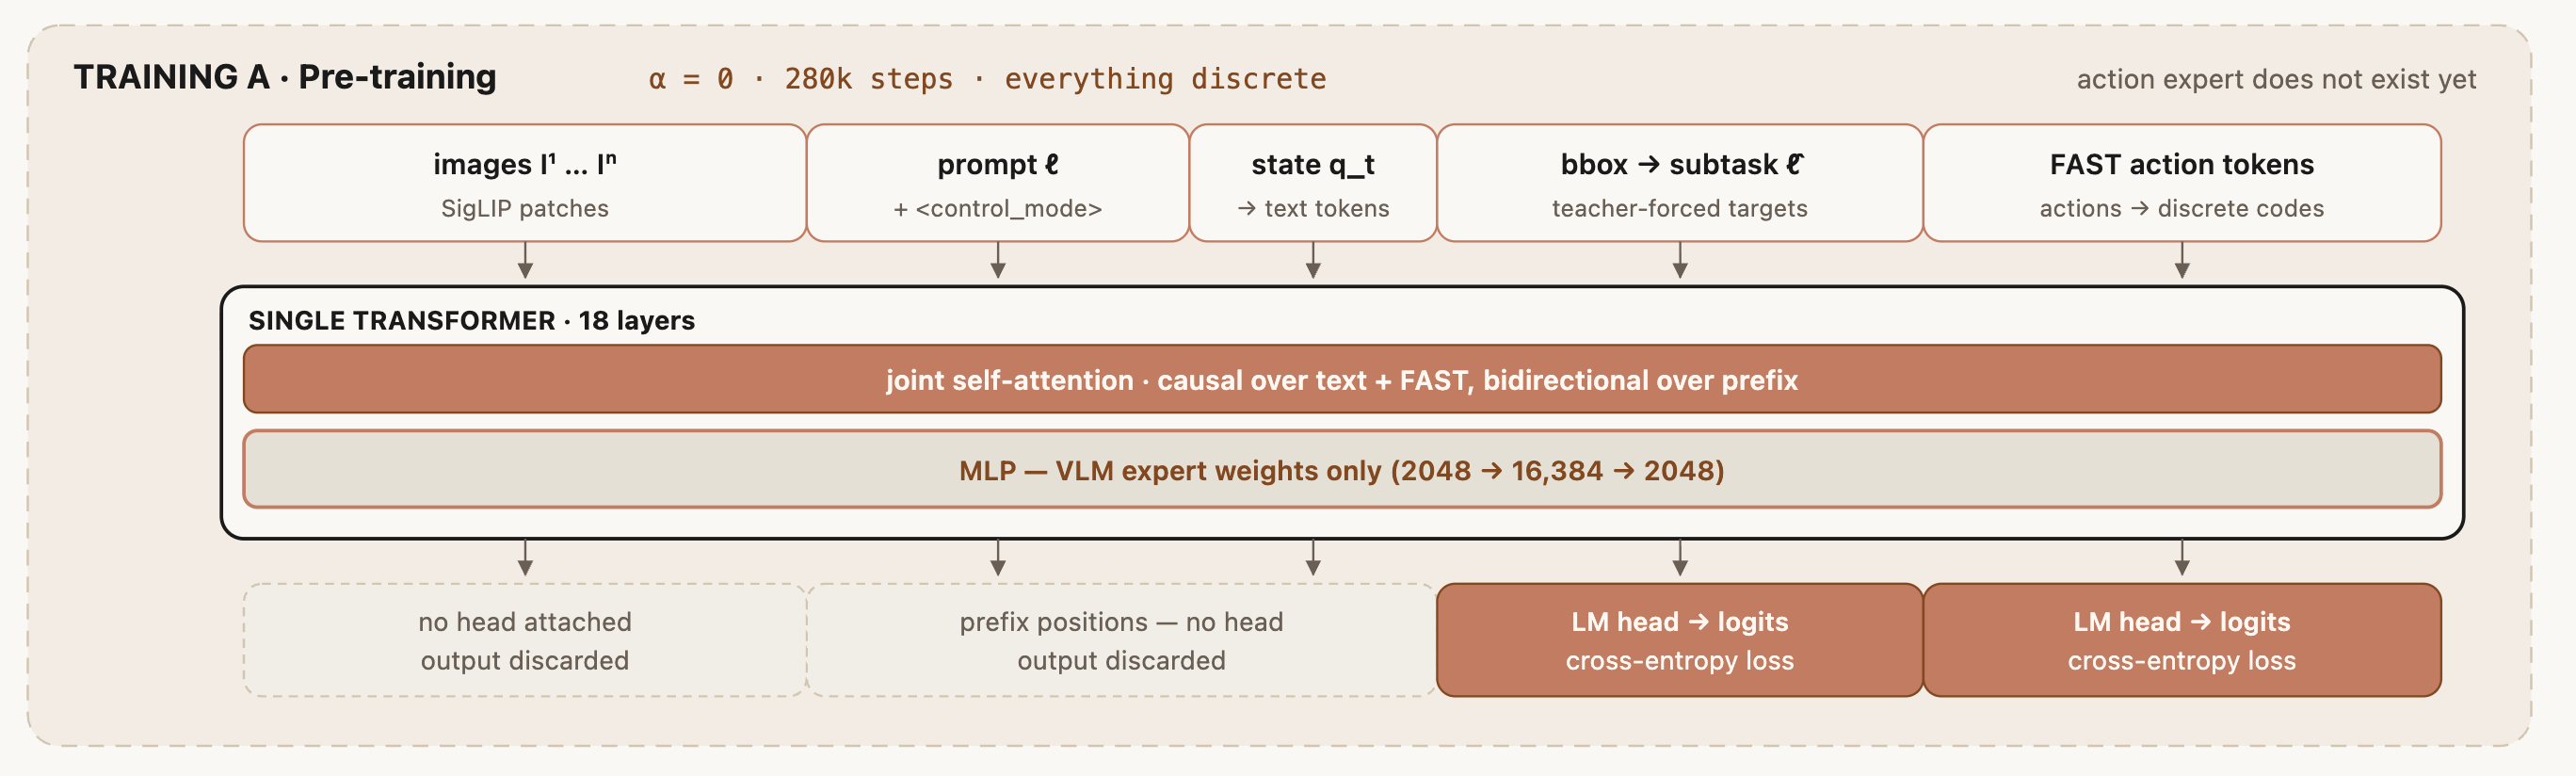
Pre-training
목적: 다양한 데이터에서 시각·언어 이해, high-level subtask prediction, cross-embodiment action knowledge를 하나의 autoregressive VLA에 학습한다.
- 초기화: web data로 미리 학습된 standard VLM에서 시작한다.
- 데이터: mobile manipulator data(MM), 다양한 환경의 non-mobile robot data(ME), laboratory cross-embodiment data(CE, OXE 포함), high-level subtask annotation(HL), multimodal web data(WD)를 함께 사용한다.
- 출력 통일: text, object location, high-level subtask와 robot action을 모두 discrete token으로 표현한다. Continuous robot action은 FAST tokenizer로 action token sequence로 변환한다.
- 학습 방식: standard autoregressive next-token prediction만 수행한다. 따라서 이 단계에서는 α=0이고 Flow Matching Action Expert를 아직 사용하지 않는다.
- High-level 학습: multi-stage robot data에 semantic subtask label을 수작업으로 붙이고, 필요한 object bounding box → subtask → FAST action token의 관계를 학습한다.
- Action 전처리: 각 데이터셋의 action dimension별 1%·99% quantile을 사용해 [-1,1]로 정규화한다. 서로 다른 robot action dimension은 최대 크기에 맞추고 부족한 차원은 zero-padding한다.
- 학습 길이: 논문에서는 280k gradient steps를 수행한다.
Pre-training 결과: 다양한 입력에서 text와 subtask뿐 아니라 FAST action token도 예측할 수 있는 discrete-action VLA backbone이 만들어진다.
Post-training
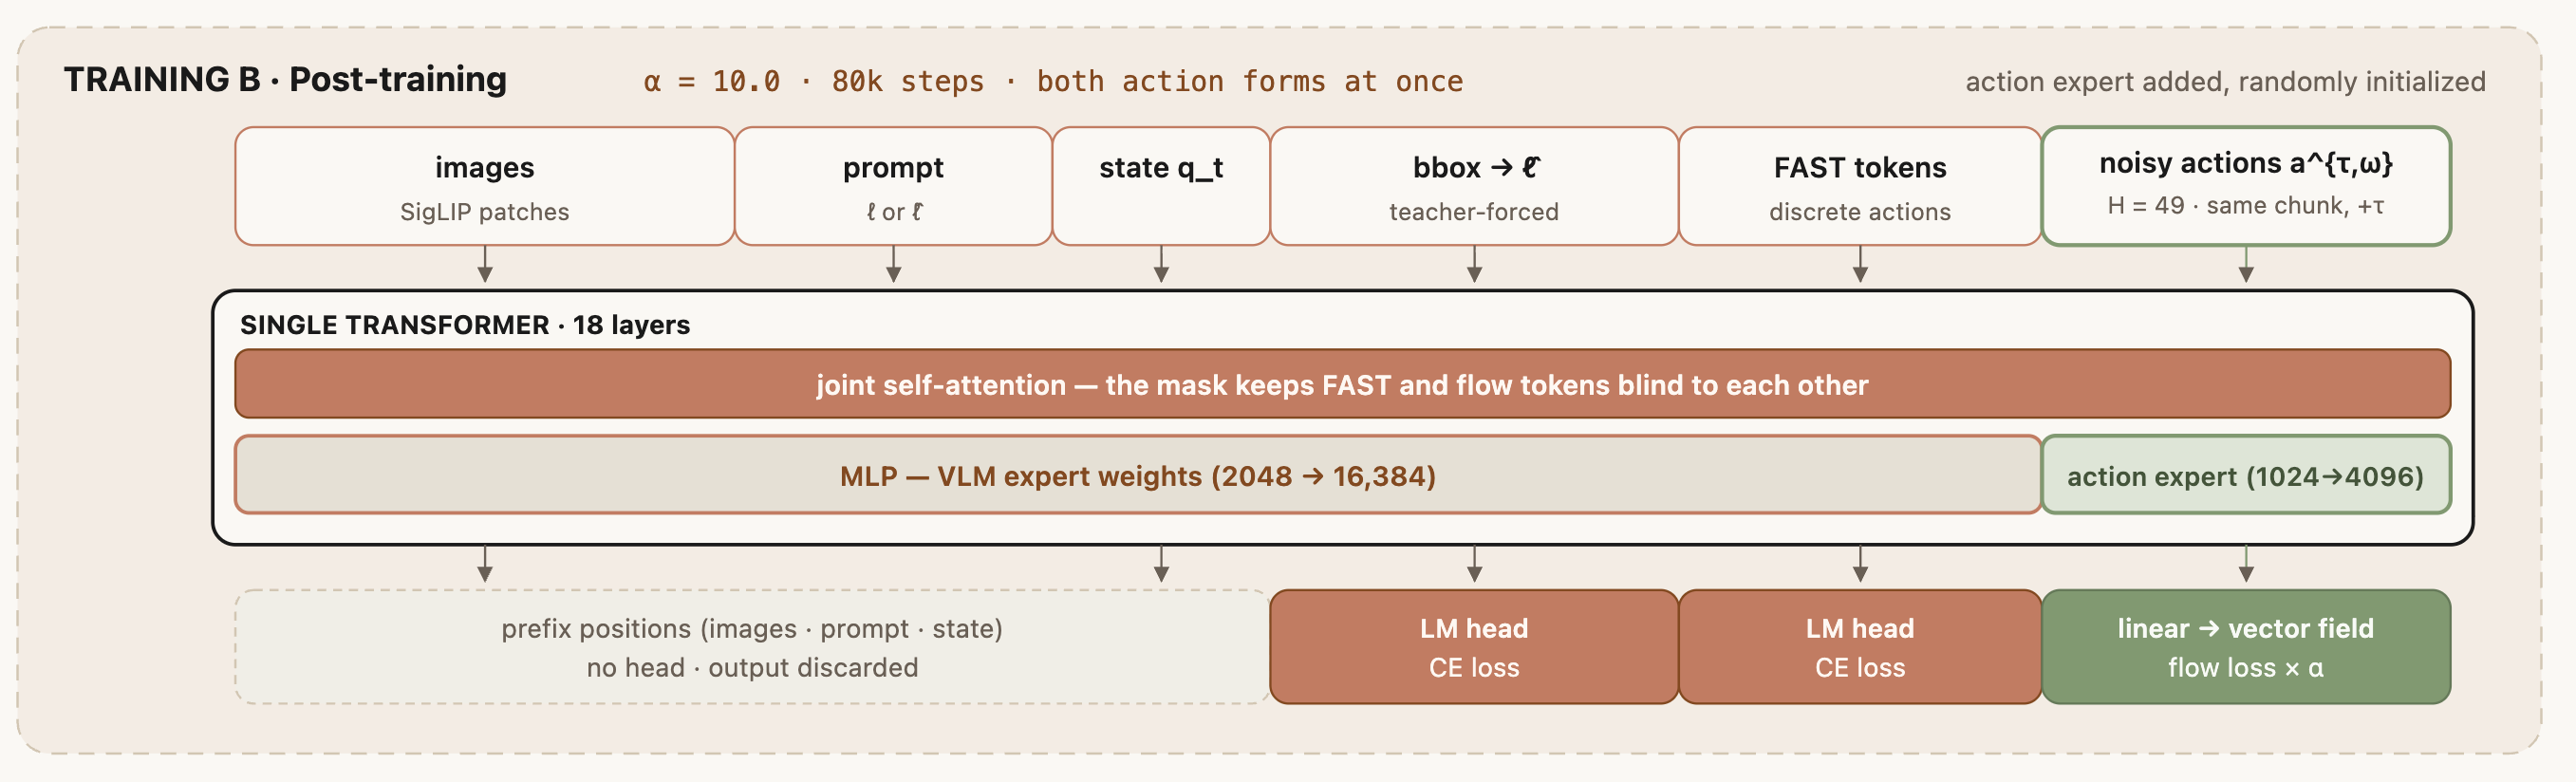
목적: pre-trained VLA를 실제 가정의 mobile manipulation에 특화하고, 빠르고 정밀한 continuous action inference를 위한 Action Expert를 추가한다.
- Action Expert 추가: 약 300M parameter의 Action Expert를 random initialization하여 Flow Matching으로 continuous action chunk를 예측하게 한다.
- 데이터 재구성: task와 가장 관련된 MM·ME robot data 중 성공 episode와 길이 기준을 만족하는 데이터에 집중한다. Laboratory CE data는 제외한다.
- 능력 보존: WD와 ME에 대응되는 HL data를 계속 사용하여 visual-semantic 및 high-level prediction 능력이 사라지지 않도록 한다.
- Verbal Instruction(VI): human supervisor가 현재 상황에 적절한 subtask를 단계별로 선택한 language demonstration을 추가한다.
- 공동 학습: 기존 VLM에는 next-token loss를 계속 적용하고, Action Expert에는 Flow Matching loss를 동시에 적용한다. 논문에서는 α=10.0으로 설정한다.
- 학습 길이: 80k additional gradient steps를 수행한다.
- Masking: FAST action token과 Action Expert embedding은 같은 정답 action에서 만들어지므로 서로 attention하지 못하게 막아 information leakage를 방지한다.
Post-training 결과: 한 모델 안에서 VLM은 “무엇을 할지”에 해당하는 subtask를 예측하고, Action Expert는 그 subtask를 조건으로 “어떻게 움직일지”에 해당하는 continuous action chunk를 생성한다.
Attention Mask
여기서 joint self-attention의 MASK를 논문의 figure을 통해서 살펴보자.
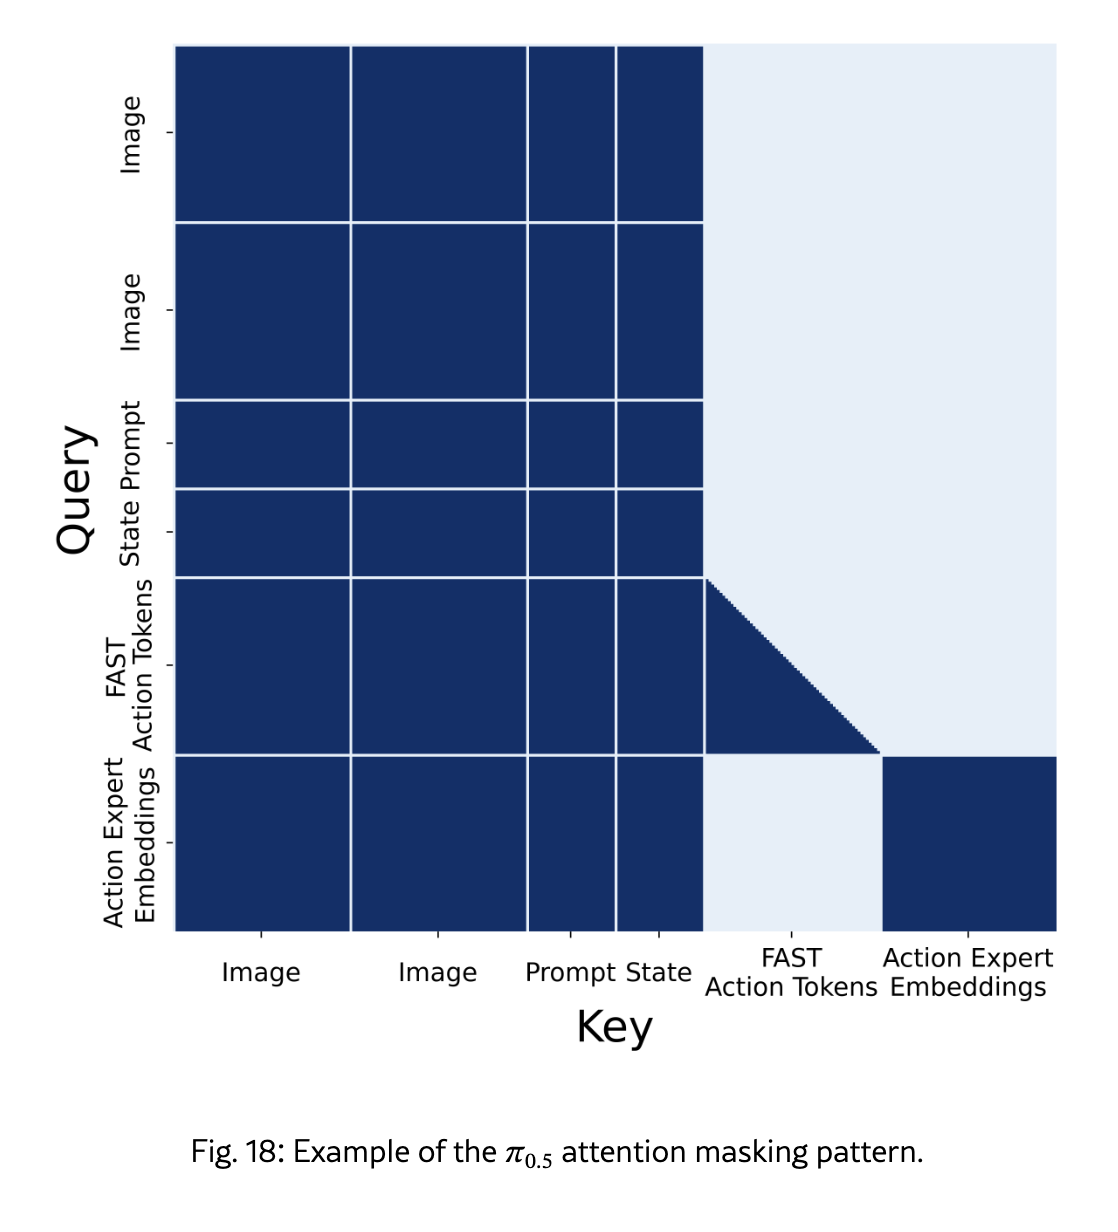
내가 질문하는 즉 관심있는 정보가 뭐냐에 따라서, 찾아올 수 있는 정보를 한정 해버린다.
- image ↔ prompt ↔ state 서로 bidirectional
- Fast Action token 같은 경우는, π₀-FAST에서 살펴보았지만, GPT처럼 토큰을 하나하나 순서대로 예측한다. 따라서, 이전 토큰만 가지고 다음 토큰을 예측하므로 보이는것처럼 (left triangular - causal attention으로 구성하였다.)
- Action embeddings(Action Expert 토큰) → image, prompt, state(prefix) 전부 + action embedding끼리는 서로 bidirectional로 본다. 하지만 FAST action token은 보지 않는다!! 둘 다 같은 정답 action에서 나온 표현이라서, 보게 하면 정답이 새어버린다(information leakage).
- 반대로 VLM 쪽 토큰(prefix, FAST token)은 action embedding을 보지 않는다 → 정보는 VLM → Action Expert 한 방향으로만 흐른다.
결과
- Unseen-home generalization: 학습에서 보지 않은 실제 집에서도 여러 단계의 가사 작업을 수행했다.
- 환경 수 scaling: 학습 장소를 3개에서 104개로 늘릴수록 작업 성공률과 language following 성능이 전반적으로 향상되었다.
- Co-training ablation: 다양한 robot data를 제거하면 성능이 크게 하락했고, web data 제거는 특히 새로운 물체에 대한 언어 이해와 high-level 판단을 약화시켰다.
- 기존 모델 비교: π₀.₅는 π₀와 π₀-FAST+Flow보다 mock-home 평가에서 유의하게 좋은 성능을 보였다.
- High-level inference: 명시적으로 subtask를 예측하는 full π₀.₅가 가장 좋은 결과를 보였다.
- 한 줄 결론: heterogeneous co-training과 hierarchical inference를 결합한 π₀.₅는 open-world generalization에 효과적이었다.
- 남은 한계: 낯선 손잡이, 가림·부분관측, 잘못된 subtask 반복 같은 실패는 여전히 남았다.
내 생각
- 일단 이 파이 모델의 핵심은 트레이닝을 신기한 방법으로 했다. ㅋㅋ 처음에 subtask를 얻고 VLM자체를 학습하는것도 action을 감안해서 했다는게 놀라운 점이다. 그리고 그거를 감안하기 위해서 FAST algorithm을 활용을 한것이다
- 그런데 실제로 추론할때는 FAST x → Diffusion Action chunk를 사용했다. 이게 좀 놀라운 점이기는 한데, 실제 추론에서는 diffusion이 더 정확하다는 점을 시사한다. 즉 fast는 training을 빠르게 하기 위한 수단이라는 점이다.
- FAST는 대규모 action data를 효율적으로 학습하기 위한 표현이고, Flow Matching Action Expert는 전체 continuous action chunk를 빠르게 병렬 생성하여 실시간 제어하기 위한 표현이다. Flow Matching을 쓰는 핵심 이유는 단순히 정확도가 더 높아서가 아니라 추론 속도와 continuous-action 정밀도 때문이다.