
Dyna-2.1 - Taku: A Physical Agent for End-to-End Laundry Workflows
Dyna-2.1은 어떻게 빨래방 workflow 전체를 1시간 동안 혼자 해냈을까? Orchestrator → Policy → Controller 3층 구조와, 사람과 로봇이 같은 말로 움직임을 적는 URR(Unified Robot Representation)을 핵심만 정리한다.
Reference
Dyna-2.1: A Physical Agent for End-to-End Workflows — DYNA
이 글의 그림은 모두 위 Dyna 공식 블로그에서 가져왔다.
Introduction
Dyna 회사에서 새로운 알고리즘과 그리고 새로운 로봇으로 다시한번 세상을 놀라게 했다. 기존에 이동 없이 고정된 상태(stationary)에서 냅킨 수건만 접던 로봇이 이제 움직이면서 세탁기에서 빨래를 꺼내고, 건조기에 넣고, 이후에 꺼내고 빨래를 개는 더 복합적인 workflow로 일을 진행하기 시작하였다. 여기서, 아주 간결하게 핵심적인 중요한 정보들만 꺼내서 이해해보자.
Contents
- Orchestrator
- Training
- URR
1. Orchestrator
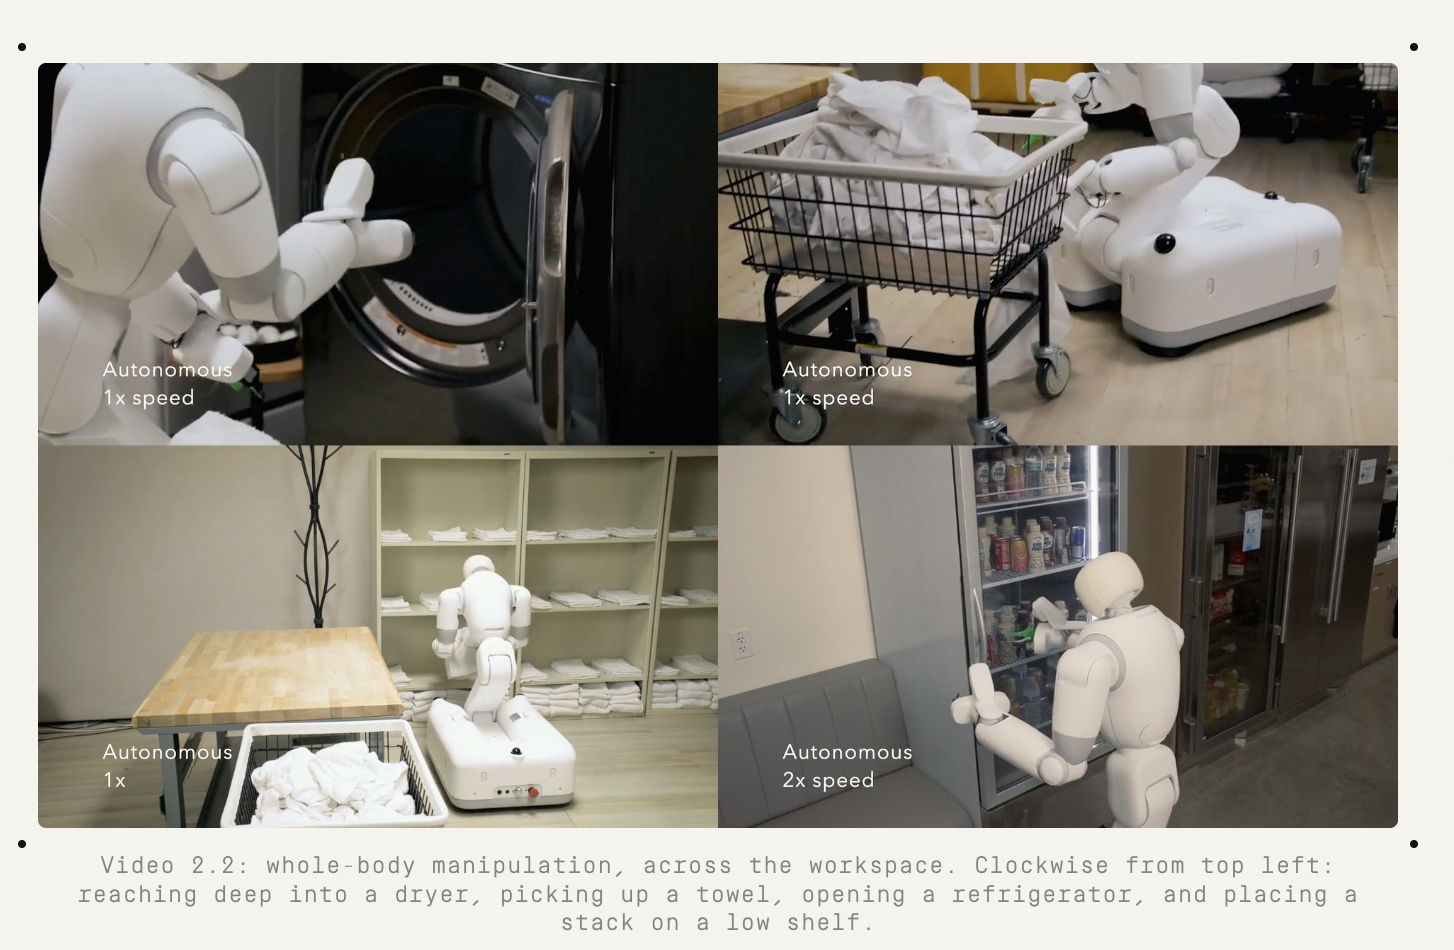
Tech blog에 들어가서 살펴보면, 굉장히 다양한 테스크를 하나의 빨래방 내부에서 보여주는 데모 영상이 있다. 이번에는 TAKU라는 새로운 로봇을 소개하였고, 빨래방에서 진행해야하는 workflow들로 구성하였다. 다양한 테스크들을 진행하는 데모 영상을 블로그 웹사이트에 들어가면 볼 수 있다.
아키텍쳐를 먼저 빠르게 살펴보자. 총 4가지의 large workflow가 존재하고 어떤 상황에서 어떤 workflow를 진행해야하는지를 Orchestrator 가 판단하는 구조이다. 그리고 각각 A → D 의 workflow에서도 세밀한 subtask flow가 존재한다.
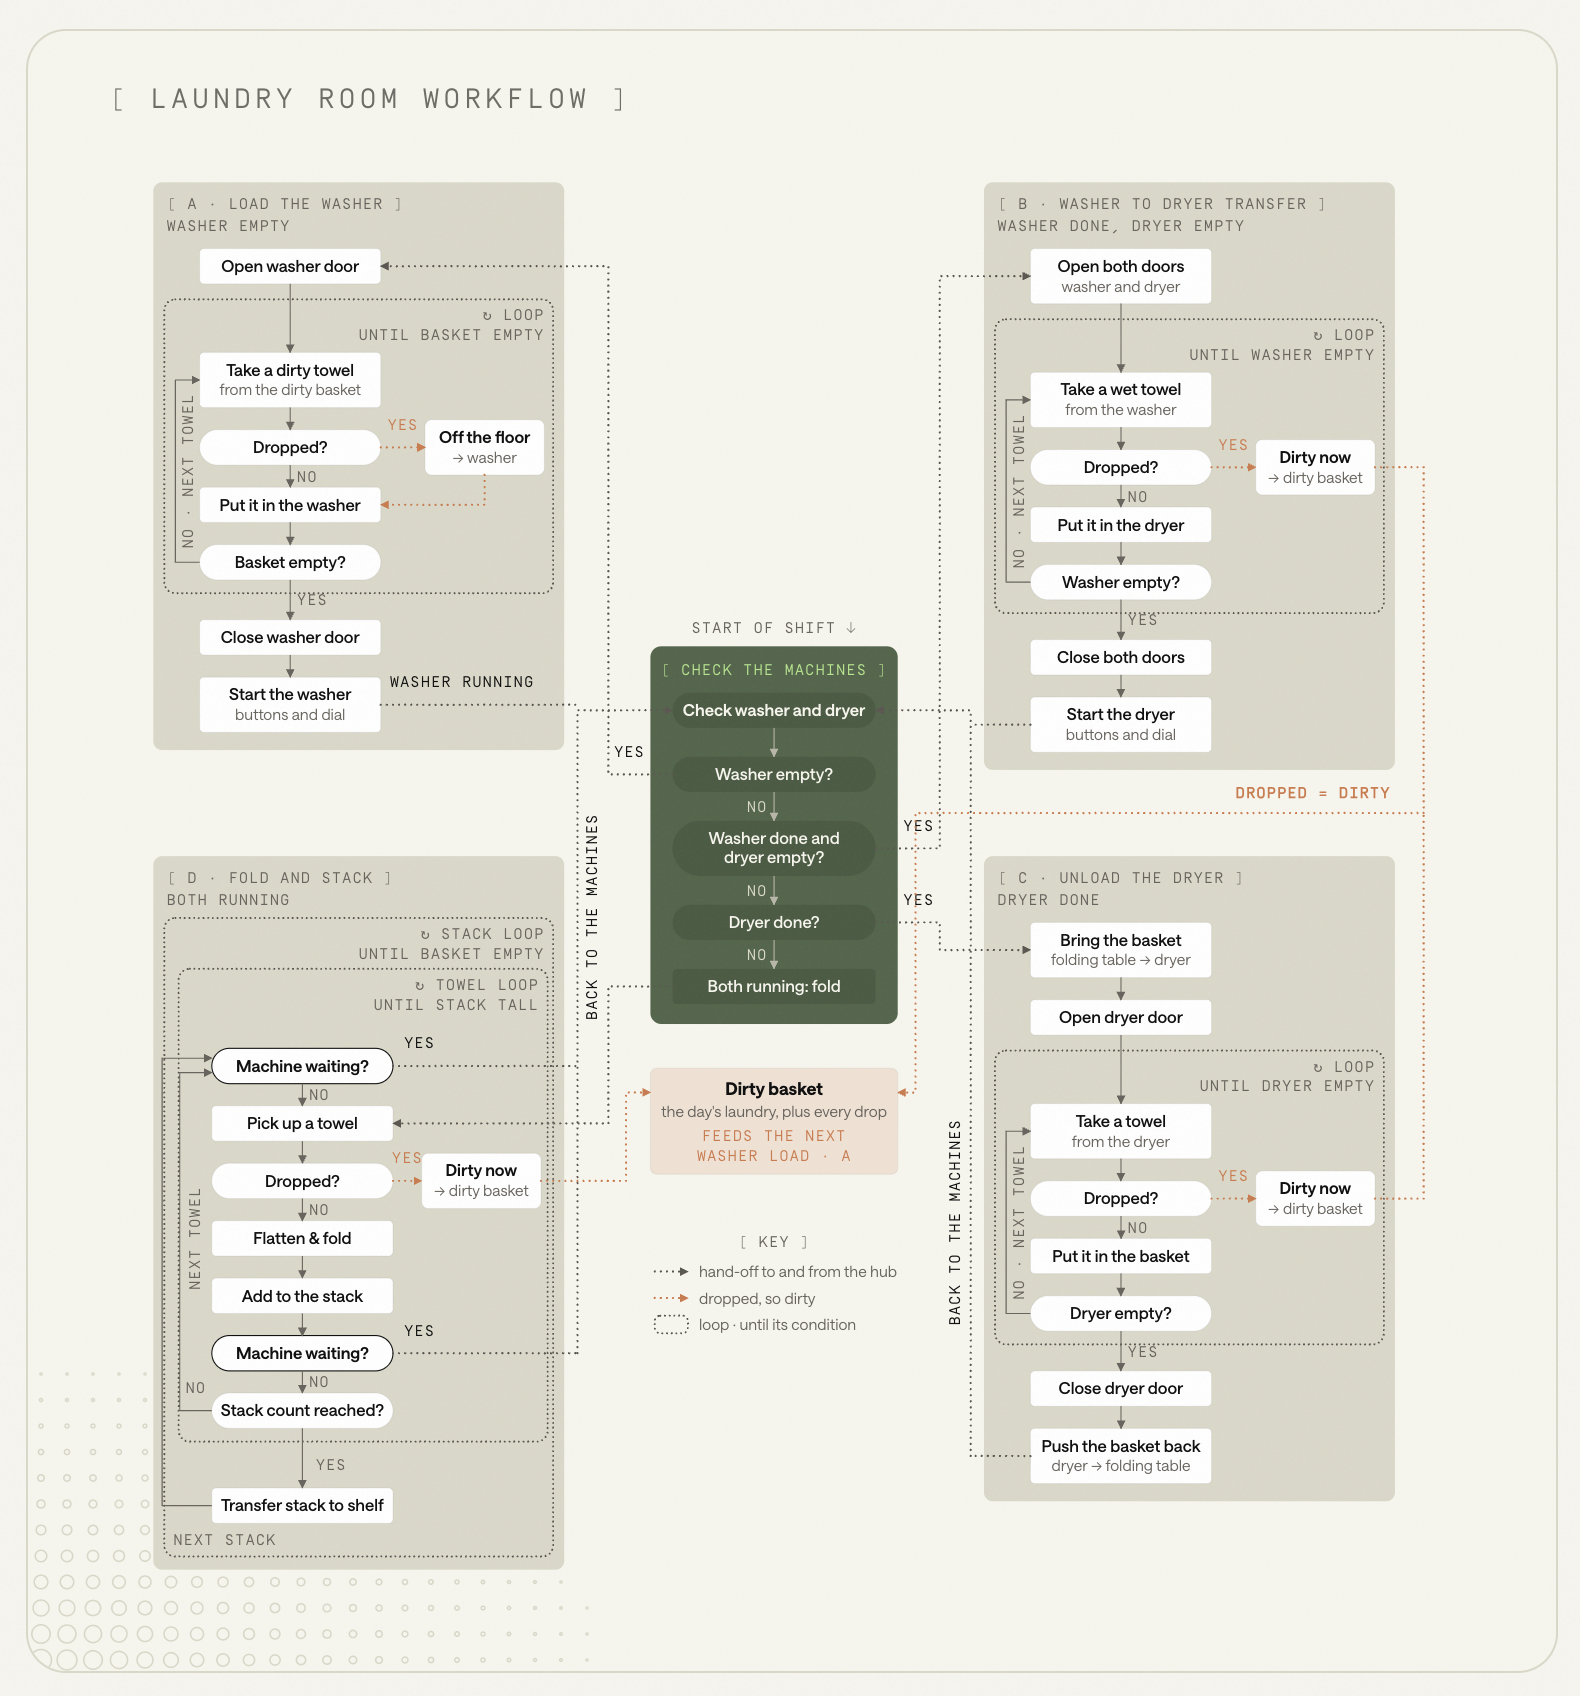
일단 심플하게 이해하면, Orchestrator 가 현재 상황을 판단하고, 지시하며 특정 workflow를 하도록 지시한다. 그리고 각각 개별적인 Workflow에는 이미 정해진 Sub task sequence가 존재하고, 이를 따른다. (인간이 짜 놓은 workflow안에서 움직여야 성공률이 현재까지는 높다는 점을 시사한다.)
다만 주의할 점은, 전체 흐름이 A → B → C → D로 일직선(linear)으로 흘러가지 않는다는 것이다!! 빨래를 개다가도 세탁기나 건조기가 끝나면 하던 걸 멈추고 그쪽으로 가야 한다. 그래서 한 cycle을 13개의 decision point로 쪼개고, Orchestrator가 각 지점에서 다음에 뭘 할지 고른다. 즉 workflow 안의 subtask 순서는 정해져 있지만, 어떤 workflow를 언제 할지는 상황에 따라 non-linear하게 바뀐다.
위 이야기를 다시한번 설명해준게 아래의 그림이다.
그러니까 지휘자 → Policy 모델 → Controller → Body 움직임
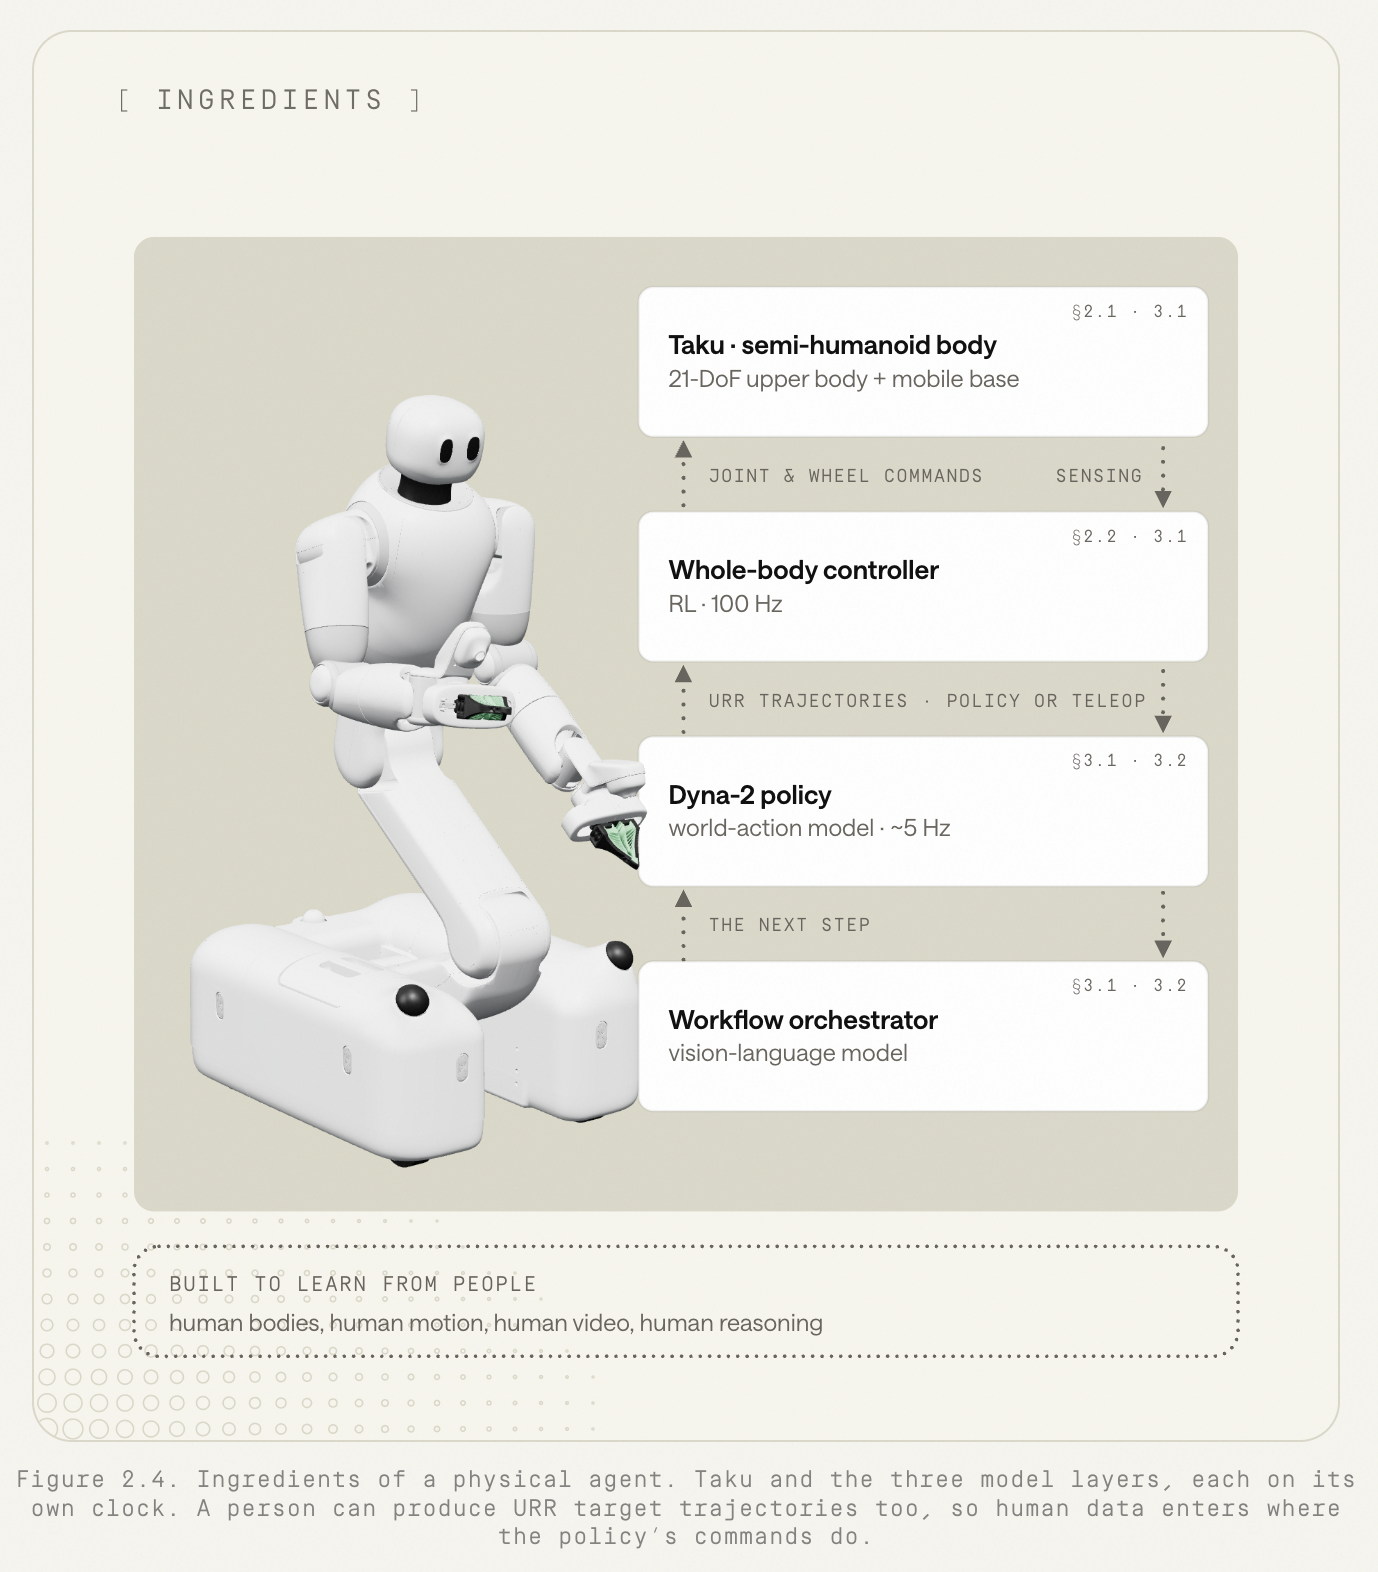
여기서 재미있는 건 각 layer가 서로 다른 속도(timescale)로 돈다는 점이다.
- Whole-body Controller: 100Hz (RL로 학습, 관절·바퀴 명령)
- Dyna-2 Policy: 약 5Hz (URR trajectory 생성)
- Orchestrator: 그보다 더 느리게 (다음 step 결정)
→ 빨리 반응해야 하는 건 아래 layer가, 오래 생각해야 하는 건 위 layer가 맡는 구조다. 그래서 Orchestrator는 아래 layer를 건드리지 않고 더 크고 느린 VLM으로 바꿔 끼울 수도 있다고 한다.
여기서 한가지 재미있는 사실은 URR이라는 새로운 개념이 등장했다는 점이다. 이게 이제 새로운 사실인데, 이는 이후에 바로 살펴볼 예정이다. 기억할 것은 Image + prompt를 받은 policy model → URR이라는 것을 output한다는 것이고, 이게 controller 에 들어가서 최종적으로 관절값을 뽑아낸다는 점이다.
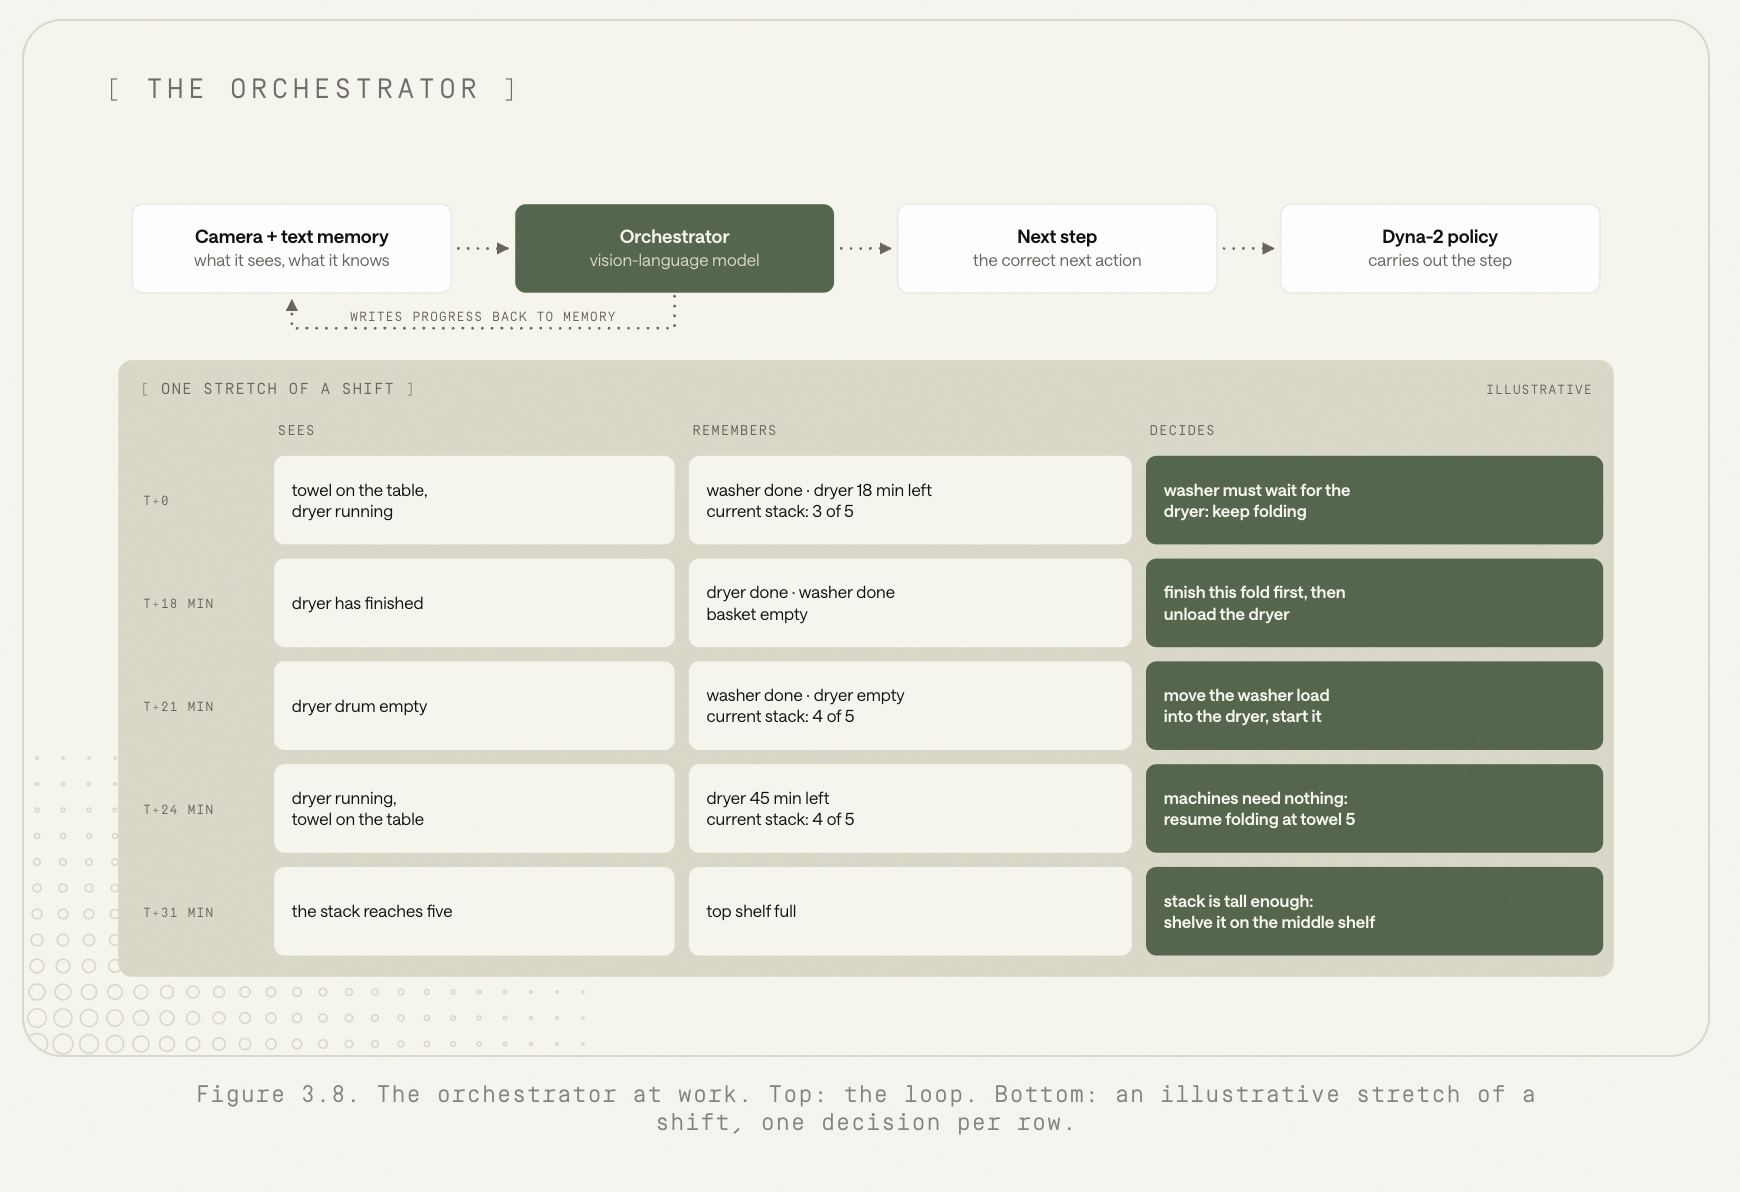
먼저 orchestrator에 대해서 살펴보면, 단순하다 agentic AI 를 생각하면 된다. 이 AGENT가 현재 상황을 인지하고, 과거 기억들도 가지고 있어 지금 현재 작업의 context를 바탕으로 다음 작업을 지시하는 것이다.
여기서 기억은 text memory로 저장된다. e.g) 어떤 step이 끝났는지, 세탁기·건조기 문이 열려 있는지 닫혀 있는지, 수건을 몇 장 갰는지, 어떤 기계가 돌고 있는지. 그래서 세탁기 일을 하고 돌아와도 개던 수건 장수부터 이어서 갤 수 있다.
2. Training
DYNA-2.1의 학습은 하나의 모델을 전부 RL로 학습하는 구조가 아니다. 각 layer가 서로 다른 방식으로 학습된다.
- Dyna-2 Policy: 약 100만 시간의 Human Video + Robot fleet data로 pre-training한다. Human motion을 URR로 변환해서 policy가 예측해야 할 target으로 사용한다.
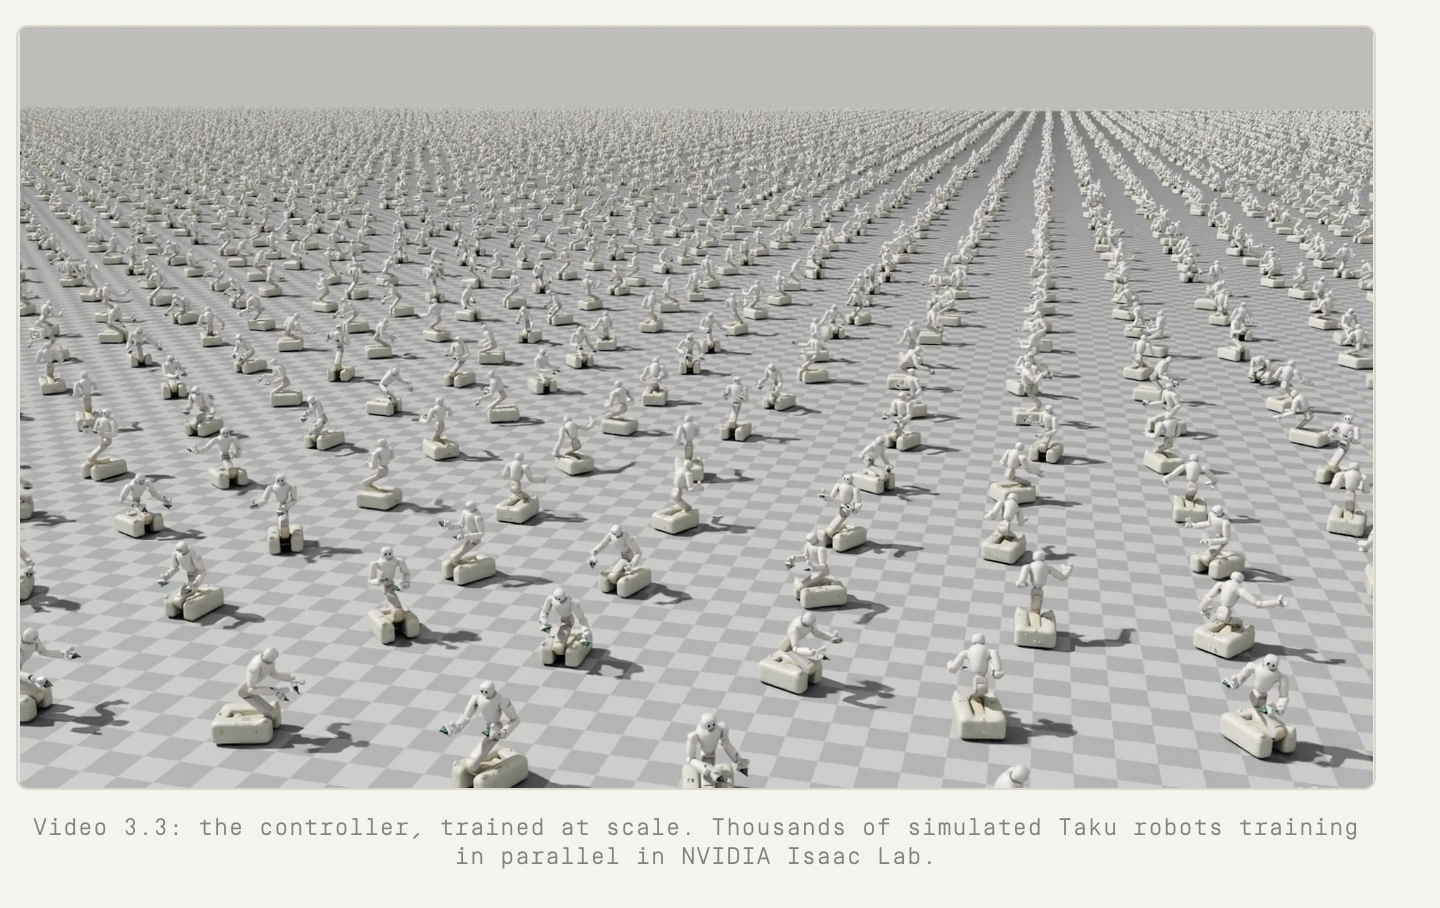
- Whole-body Controller: NVIDIA Isaac Lab에서 Reinforcement Learning으로 학습한다. Human motion에서 얻은 URR trajectory를 tracking target으로 사용하며, 수천 개의 simulated Taku를 병렬로 학습시킨다.
- Orchestrator: 기존 Vision-Language Model을 기반으로 하고, 실제 workflow의 branch와 decision 구조에 맞게 post-training한다.
즉, 간단하게 정리하면,
1
2
3
Human Video + Robot Data → Policy
URR Motion + Simulation → RL Controller
Workflow Data → VLM Orchestrator
특히 흥미로운 점은 하나의 Human demonstration이 Policy에게는 task training data가 되고, 동시에 Controller에게는 simulation에서 따라야 할 motion curriculum이 된다는 점이다.
3. URR
아까전에 이야기를 나누었던, URR에 대해서 자세하게 이야기를 해보자.
왜 이런 새로운 개념을 등장시켰을까?
URR : Unified Robot Representation
블로그에서는 URR의 성질을 3가지로 정리한다.
- Embodiment-agnostic: 사람, humanoid, semi-humanoid, 탁상형 양팔 로봇 모두 같은 format으로 표현한다. 있는(관측되는) body component만 더 쓰거나 덜 쓰면 된다.
- 핵심 task-space constraint를 담는다: 손 위치, 팔 자세, 몸통 자세, 작업공간 안에서의 몸 위치 → manipulation에서 제일 중요한 공간적 조건들이다.
- Lossless: reference frame과 시작 pose만 있으면 relative-pose action 같은 다른 동등한 형식에서도 그대로 복원된다.
→ 나만의 언어: “사람이든 로봇이든 같은 말로 움직임을 적는 공용어”
블로그에서 설명한 URR은 로봇의 각 관절을 몇 도 움직일지 직접 나타내는 joint angle representation이 아니다.
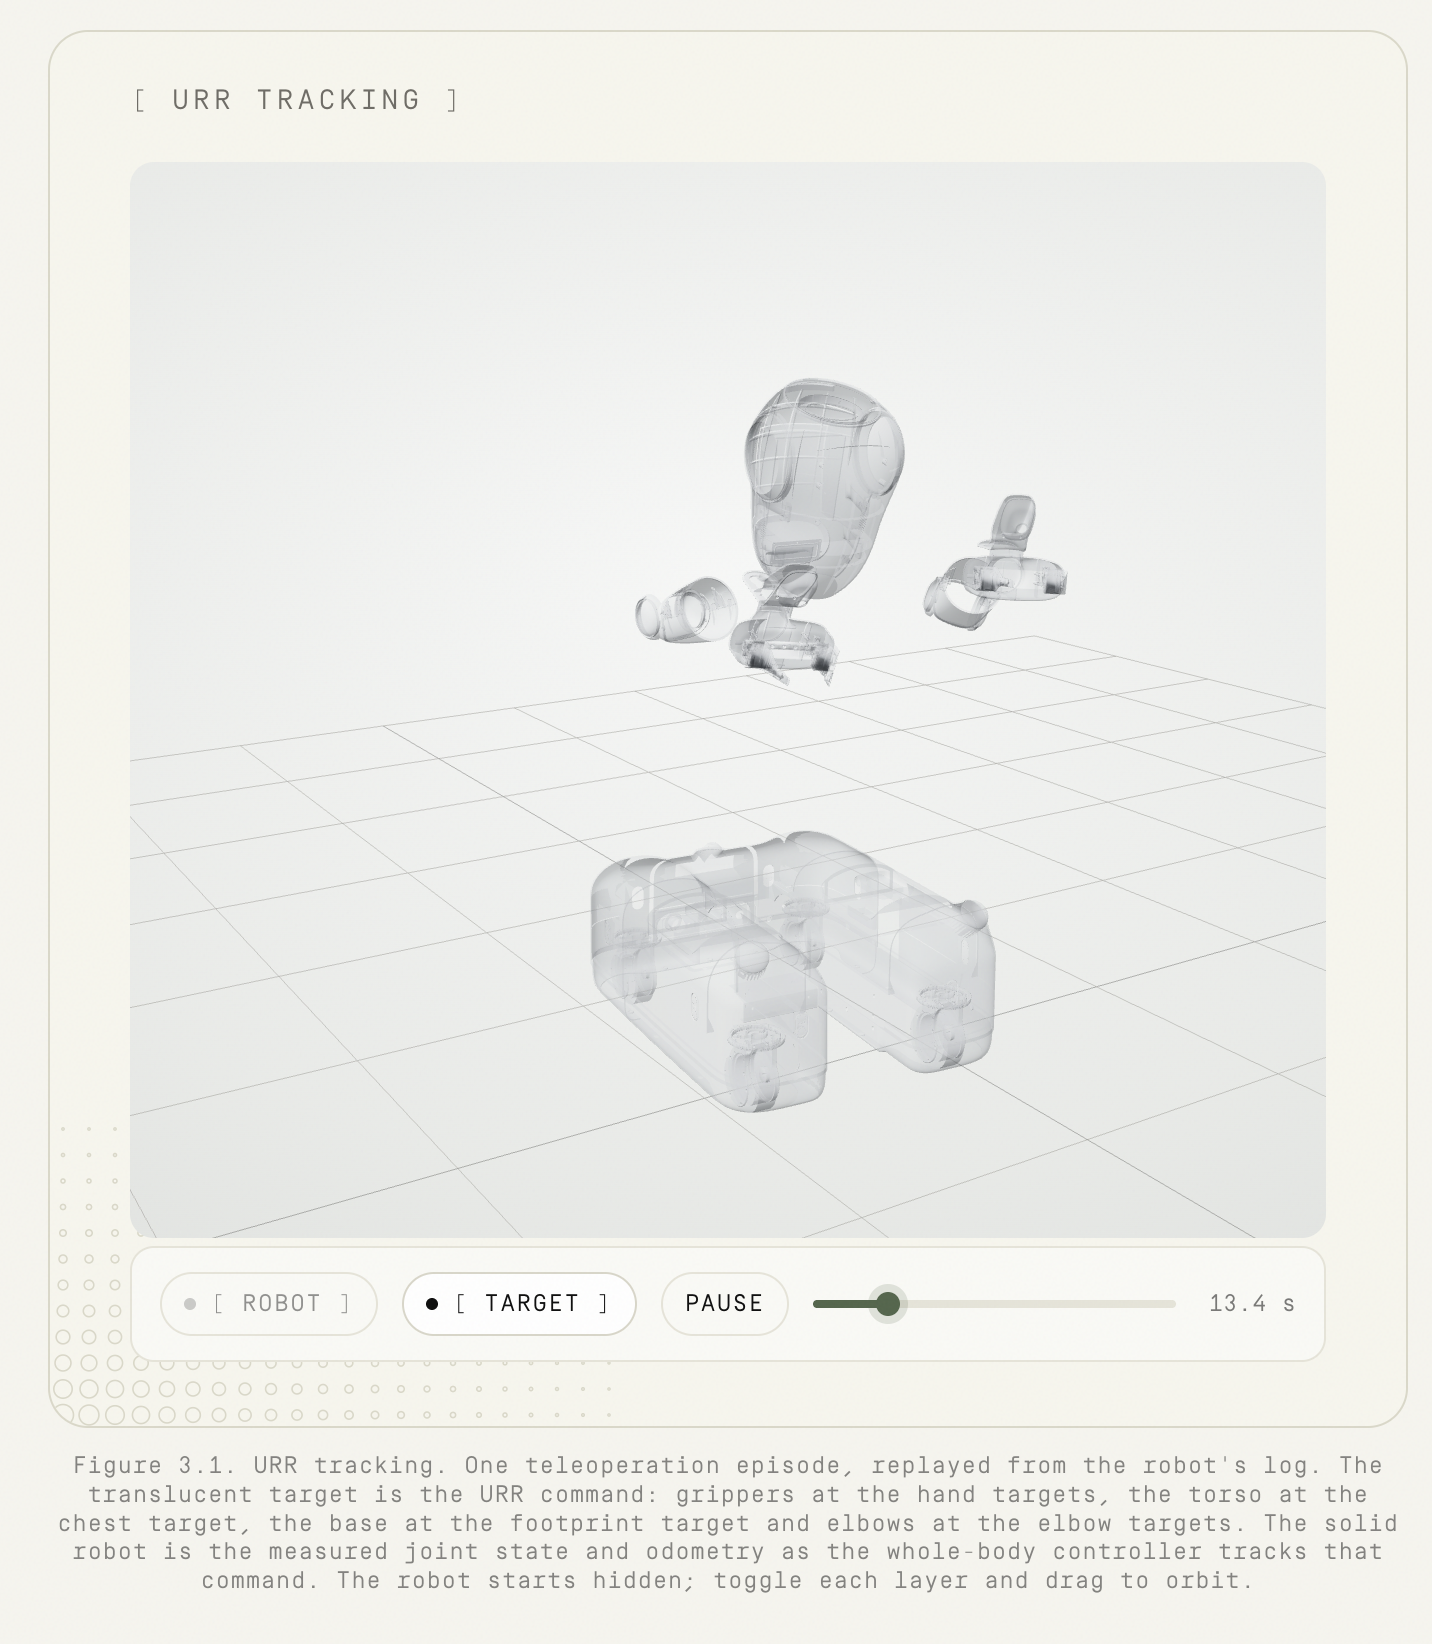
더 정확하게는, 손목(wrist), 팔꿈치(elbow), 가슴(chest), footprint/base와 같은 중요한 body component가 공간상에서 어디에 있어야 하는지를 나타내는 task-space의 whole-body target representation이라고 보면 된다.
즉, URR을 실제 데이터 파일로 열어본다고 상상하면 대략 이런 값들이 시간 순서대로 들어 있다고 이해하면 된다. (공식 파일 포맷이 아니라 이해를 위한 예시 형식이다.)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
timestamp = 0.00

right_wrist:
  position    = [x, y, z]
  orientation = [qx, qy, qz, qw]

right_elbow:
  position    = [x, y, z]

chest:
  position    = [x, y, z]
  orientation = [...]

footprint:
  position    = [x, y, z]
  orientation = [...]
즉, URR은 몸의 중요한 지점들의 Cartesian pose를 시간에 따라 나열한 trajectory라고 이해하면 직관적이다.
예를 들어 사람이 세탁기 안쪽에서 수건을 꺼낸다고 해보자. 사람의 움직임은 단순히 팔 하나만 움직이는 것이 아니다. 오른손은 세탁기 안쪽으로 들어가고, 팔꿈치는 문이나 주변 물체를 피하도록 움직이며, 상체는 앞으로 숙여지고, 필요하면 몸 전체도 세탁기 쪽으로 이동한다.
이걸 사람의 joint angle로 표현하면,
1
2
3
human shoulder = 40°
human elbow    = 75°
...
처럼 표현할 수 있지만, 이 값은 Taku의 관절 구조와 직접 대응하지 않는다.
반대로 URR은
1
2
3
4
right_wrist = [x, y, z, orientation]
right_elbow = [x, y, z]
chest       = [x, y, z, orientation]
footprint   = [x, y, z, orientation]
처럼 공간상의 목표 위치와 자세를 표현한다.
즉,
“어깨 모터를 몇 도 돌려라”
가 아니라
“손목은 여기, 팔꿈치는 여기, 몸통은 여기로 움직여라”
라고 말하는 representation에 가깝다.
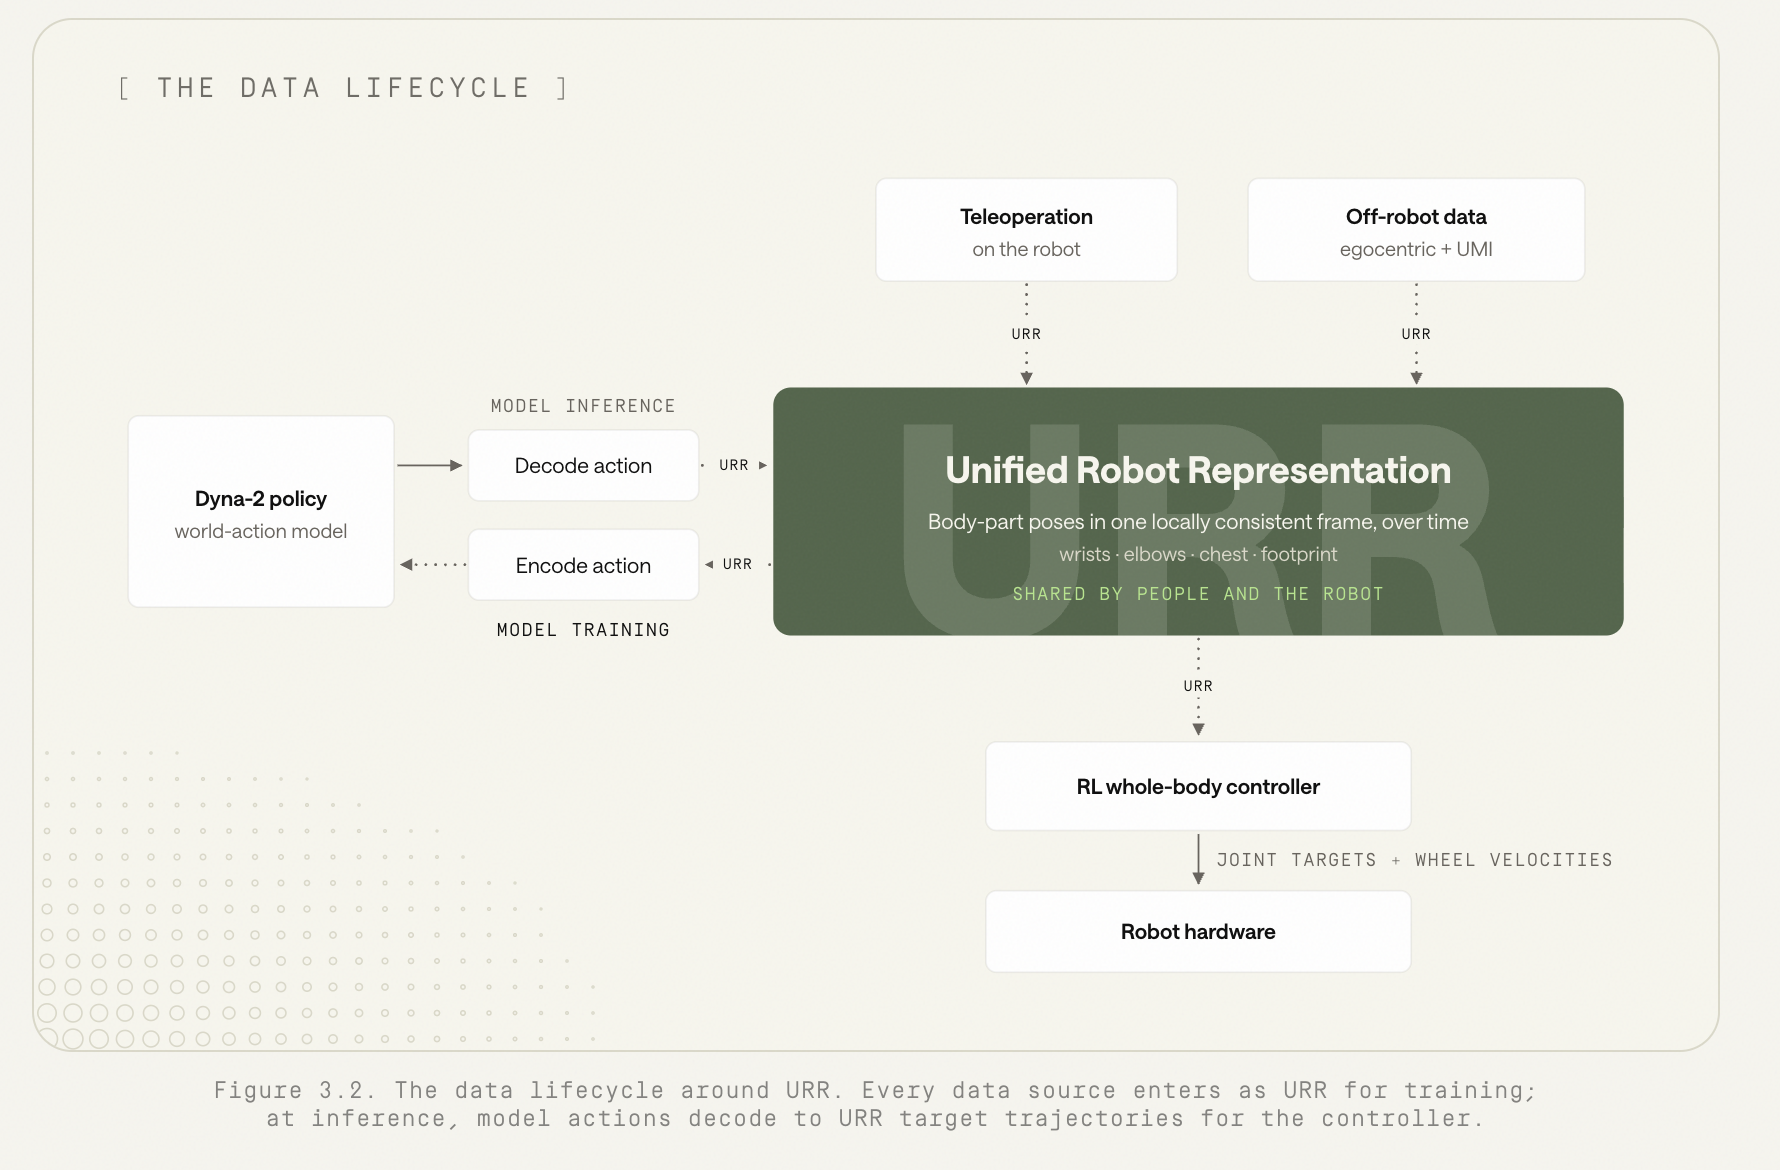
이후 Whole-body Controller가 이 URR trajectory를 받아 실제 Taku의 joint target과 wheel velocity로 변환한다.
1
2
3
4
5
6
7
URR trajectory
      ↓
Whole-body Controller
      ↓
joint targets + wheel velocity
      ↓
Taku motion
3.1 Human Video Data
그러면 왜 굳이 정의했을까????
Human video 에서 추출하기 쉬운 정보 → URR
이라는 생각이 들것이다.
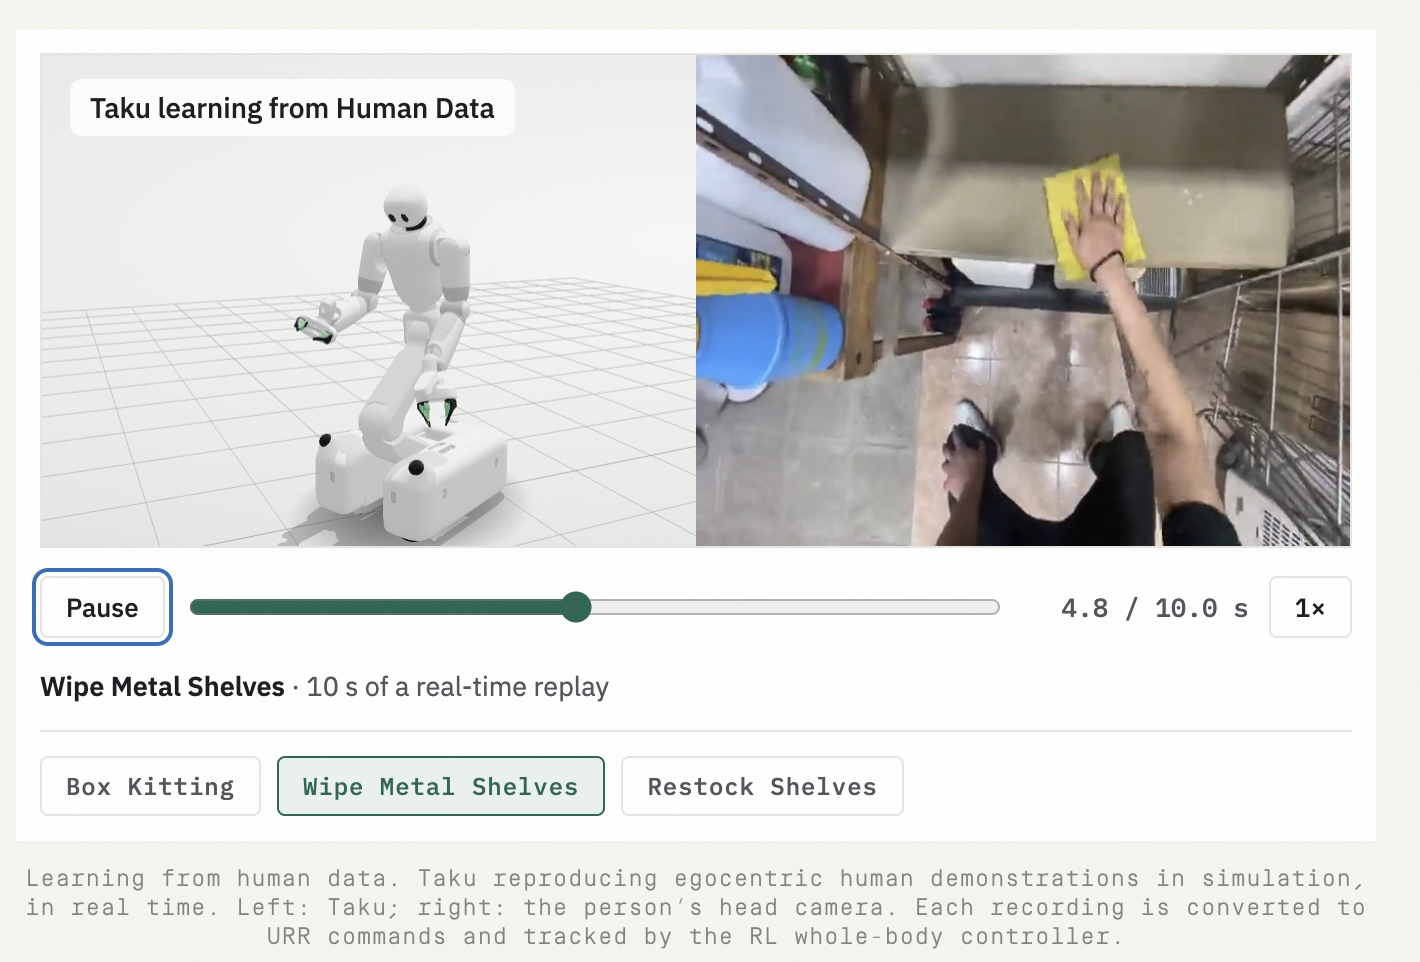
즉, 다이나의 철학은 Scaling Law이다. 로봇 데이터는 로봇·operator 시간이 들고 하드웨어가 바뀌면 쓸모가 줄어드는 반면, 사람이 일하는 모습을 기록한 데이터(egocentric video, motion capture, handheld-gripper demonstration)는 데이터 수집 업체들을 통해 빠르게 늘어나고 있다. 그래서 이 human experience data를 최대한 활용하려고 하는 것이 보인다. 또한 이러한 데이터가 실제 제작하기도 더 쉬울 것이다 (특정한 촬영장치나 장비, 센서등을 들고 얻은 데이터보다)
따라서, Human Video → URR 을 대규모로 얻어내고, 이제 우리는 이거를 정답 data → policy training을 진행 할 수 있게 되는 것이다.
포인트는 이 정답이 로봇에서 policy가 실제로 내보내는 output format(URR)과 똑같다는 것이다. 그래서 robot data로 fine-tuning할 때는 “Taku의 몸에 맞추는 것”만 배우면 된다.
실제로 효과도 있었다. Dyna-2는 human video만으로 pre-training했는데도, 데이터를 한 번도 모은 적 없는 현장의 customer acceptance test를 zero-shot으로 87% 통과했다 (Dyna-1은 46%).
3.2 Policy–Controller 분리: URR → Real Action
URR을 사용하면 task-specific Policy와 low-level Controller를 분리할 수 있다.
새로운 task가 생기면 Policy가 그 task에 맞는 URR trajectory를 생성하면 되고, 실제 관절 제어는 기존 Whole-body Controller가 담당한다.
1
2
3
4
5
6
7
8
9
Task / Observation
      ↓
Policy
      ↓
URR trajectory
      ↓
Whole-body Controller
      ↓
Joint targets + wheel velocity
즉,
Task가 바뀌면 주로 Policy를 학습하고, Hardware가 바뀌면 주로 Controller를 다시 학습한다.
이렇게 task-level intelligence와 robot-specific control을 분리할 수 있다는 점이 URR의 큰 장점이다.
핵심 정리
- Dyna-2.1은 단일 task가 아니라 빨래방 workflow 전체를 1시간 동안 끊김 없이 자율로 해낸 physical agent다.
- 로봇 Taku는 상체는 사람 체형, 하체는 접히는 구조 + 바퀴 4개 base, 7-DoF 팔 2개. 사람의 손목·팔꿈치·가슴 pose가 그대로 닿도록 사람 크기로 만들었다.
- 뇌는 3층이다: Orchestrator(VLM, 느림) → Dyna-2 Policy(약 5Hz) → Whole-body Controller(RL, 100Hz).
- workflow는 non-linear라서 Orchestrator가 13개 decision point에서 text memory를 보고 다음 step을 고른다.
- URR은 손목·팔꿈치·가슴·footprint의 task-space pose trajectory다. 사람과 로봇이 같은 format을 쓰는 공용어 역할을 한다.
- 그래서 하나의 human demonstration이 Policy에게는 task 정답이 되고, Controller에게는 simulation tracking curriculum이 된다.
내 생각
- π 시리즈가 “하나의 거대한 VLA가 다 한다”는 방향이라면, Dyna-2.1은 역할을 layer별로 쪼개고 사람이 짠 workflow 위에서 움직이게 하는 훨씬 제품 지향적인 설계다. 당장 현장에서 몇 시간씩 돌려야 하니 이게 현실적인 선택이라고 본다.
- 제일 인상적인 건 URR이다. joint angle 대신 task-space pose를 action으로 쓰니까, human data는 Policy에, 로봇 몸 차이는 Controller에 몰아넣을 수 있다. 하드웨어가 바뀌어도 Policy 쪽 data가 버려지지 않는다는 점이 scaling 관점에서 크다.