
Step1 Vision Language Action (VLA) Model - basic concepts
로봇이 커피를 옮기는 예시로 policy·dynamics model·planner, 보상과 가치, feedback loop, observation과 state, 입력·출력, 모방학습과 강화학습 데이터, 토큰·임베딩, π₀ 구조, WAM·WFM의 차이와 현재 업계 지도까지 VLA의 기본 개념을 정리한 공부 노트.
Contents
- Policy / Dynamic model / planner
- Goal / reward / value
- Feedback loop
- Observation / State / memory
- Input / Output
- Training Data
- 신경망의 기본 부품 — 토큰, 임베딩
- Vision Language Action (VLA) model
- World Action Model (WAM)
- World Foundation Model (WFM)
- 현재 흐름 — 주요 기업·연구기관과 대표 모델
1. Policy / Dynamic model / planner
Q 로봇이 까페 카운터에서 커피를 집은 다음에 어떤 테이블로 옮기는 작업의 workflow는 어떻게 될까?
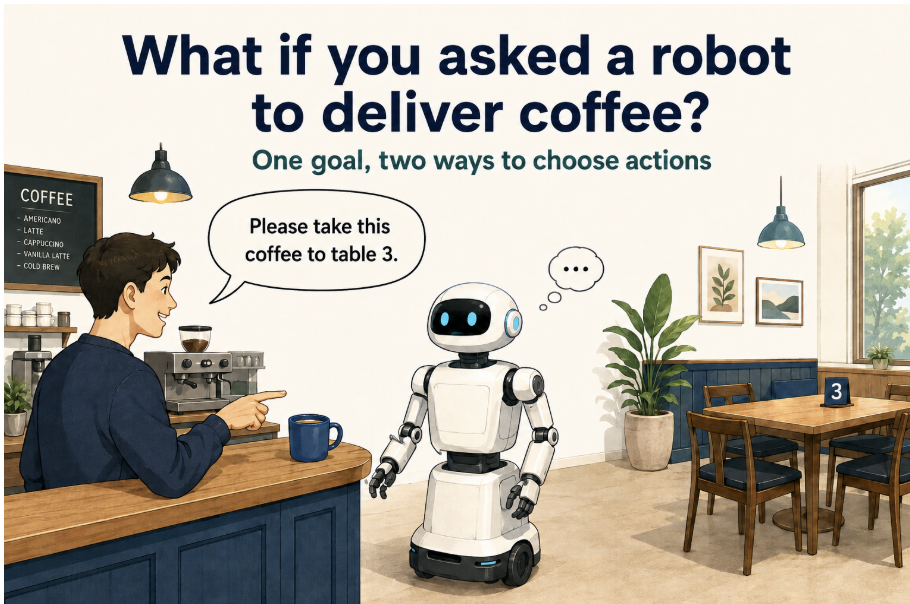 Figure 1.
시나리오1
로봇 현재 상황을 본다 + “커피 집어” 라는 명령
→ 로봇 어떤 행동을 해야할지 생각한다 → 가장 적합한 행동을 수행한다.
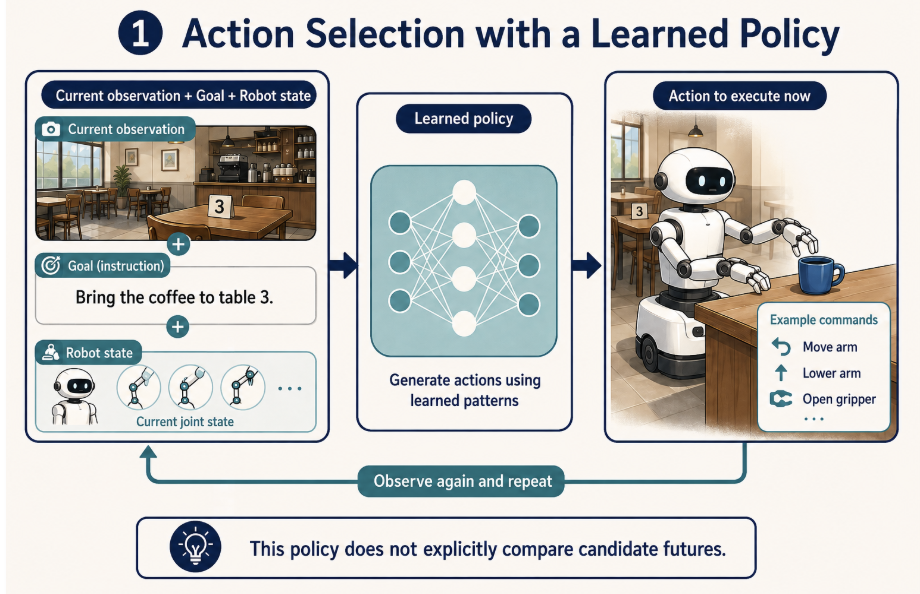 Figure2.
시나리오2
로봇 현재 상황을 본다 + “커피집어”라는 명령
1
2
3
4
5
6
→ 계획모델 (planner) → 행동 후보를 만든다. {행동1,2,3,….n}
    → 행동 1 → Dynamic model → 결과1
    → 행동 2 → Dynamic model → 결과2
    …
→ 계획모델은 최종 n개의 결과중 최적의 행동 i를 고른다.
→ 그 결과에 대응하는 행동i를 수행한다.
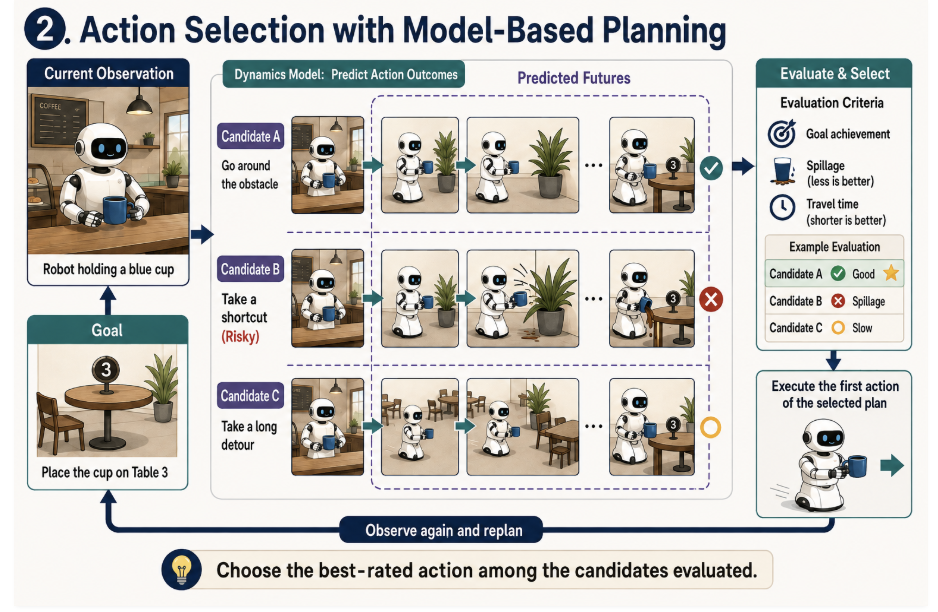 Figure3.
시나리오1 에서, 어떤 행동을 할지 생각하는 모델이 바로 “정책 모델이다”
시나리오2 에서, “동역학 모델, 플래너” 이렇게 2가지 가 필요하다.
즉 플래너는 어떤 행동들을 하면 좋을지 경우의수들을 생각하고, 동역학 모델은 실제로 행동 → 결과를 생각하는 sub model 인 것이다. 그리고 최종적으로 최적의 행동을 고르는 것도 바로 planner.
이 두가지 시나리오에 대해서 꼭 기억하자.
2. Goal / reward / value
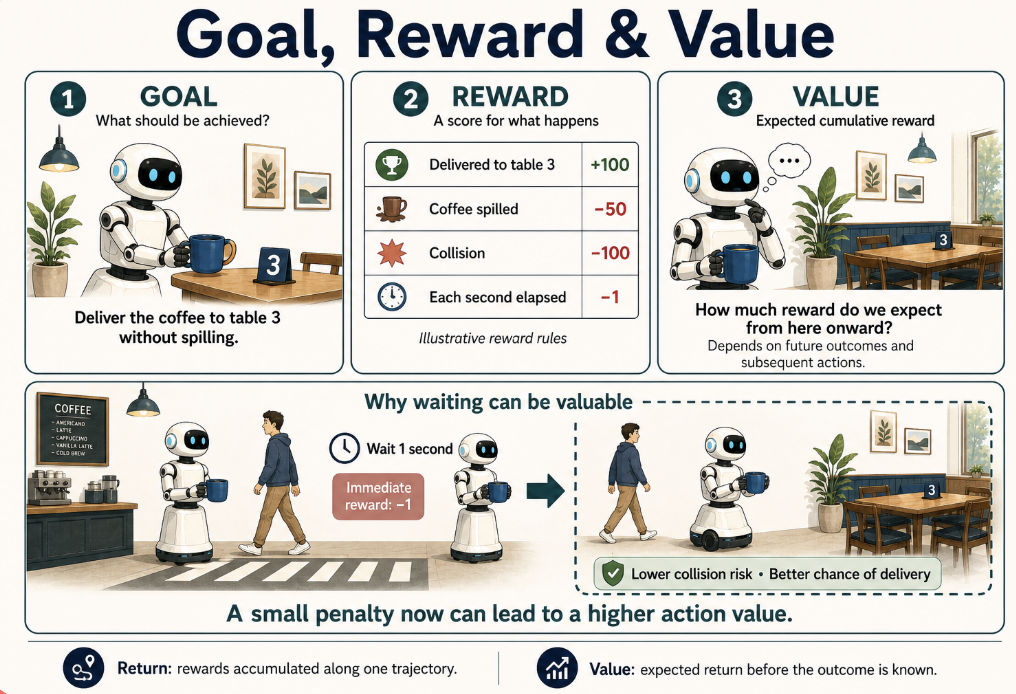
이 로봇의 목표는 다음과 같을 것이다.
커피를 흘리지 않고 3번 테이블에 놓는다
즉 목표는 커피를 어디에, 어떤 조건으로 전달할지 정한다.
그렇다면, 실제로 학습을 진행할때는 로봇이 목표를 잘 달성하는지 안하는지를 수치적으로 채점을 해야한다. 그 채점 항목이 바로 ‘보상’인 것이다.
| 일어난 일 | 보상 예시 |
|---|---|
| 커피를 3번 테이블에 놓음 | +100 |
| 커피를 흘림 | −50 |
| 사람이나 가구와 충돌함 | −100 |
| 시간이 1초 지남 | −1 |
Table 1. 보상 표 예시. (채점표라고 생각하자)
즉 로봇은 다양한 항목에 대해서 채점을 인간으로부터 당할 것이고, 그 채점 총 점수가 바로 가치인 것이다.
마지막으로 가치는 “현재 상태나 행동에서 출발했을때 (inital state → final state) 까지의 보상의 합 = 가치
즉 가치가 높은 쪽으로 로봇은 학습 될 것이다.
Q. 로봇이 3번 테이블에 가까워지려고 움직이는 대신, 잠깐 멈춰서 지나가는 사람을 기다렸어. 이 행동은 시간이 걸려 벌점을 받는데도 가치가 높은 행동일 수 있을까?
→ 로봇이 사람을 먼저 보내려고 1초 기다리면 시간에 대한 보상 −1을 받는다. 하지만 기다리는 행동은 충돌 위험 (-100점) 을 줄이고 커피를 성공적으로 전달할 가능성을 높인다. 따라서 당장의 보상은 음수여도, 앞으로 기대되는 보상의 합인 행동 가치는 더 높을 수 있다.
3. Feedback loop
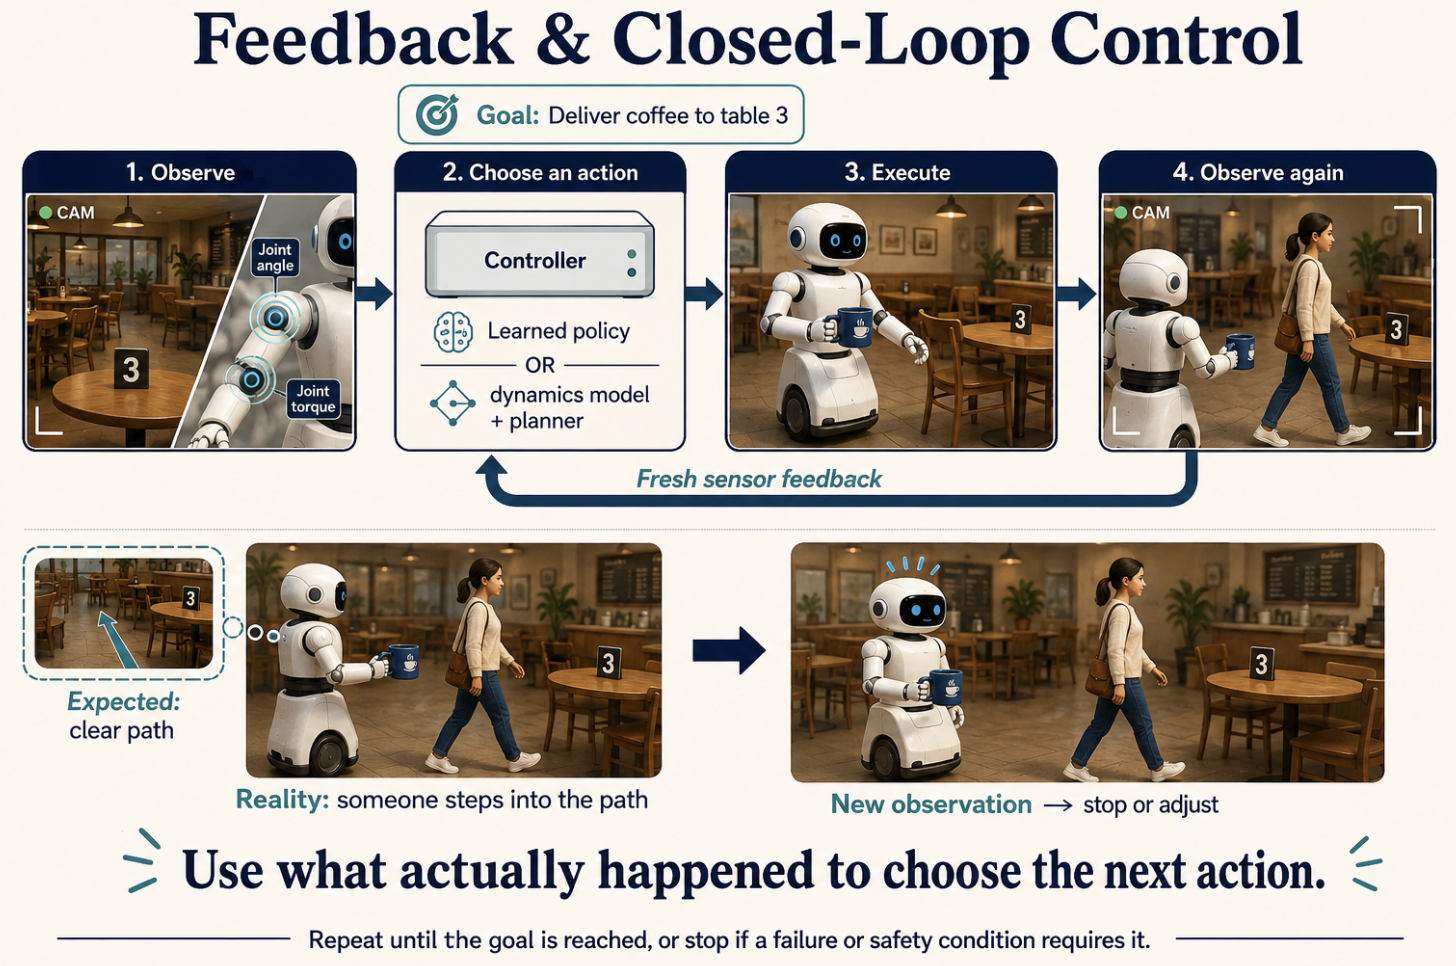
1번에서 이야기한 하나의 flow , observation → action을 우리가 살펴보았다면, 이거를 이제 반복적으로 실제로는 시간에 따라서 진행할 것이다.
- 관측
- 행동 선택
- 실행
- 재관측
- 다음행동생택
→ 목표를 달성할 때까지 반복
4. Observation / State / memory
- Observation - information from the sensor
- 카메라 영상
- 관절 각도
- 힘 센서 측정값
- …
- State - current location of the robot and the environment
- 로봇의 위치
- 주변 사람들의 위치
- 이동방향 (모멘텀)
- 이동속도
- …
- Memory
- 이전 관측 정보
- 이전에 판단한 행동
- Global memory
- …
여기서 중요한 점은, 현재 상태를 추정하는 것, 미래를 예측하는 일을 구분해야한다는 것이다. 그러니까 “사람이 오른쪽으로 움직이고 있다. → 현재 상태 추정, 이 속도로 움직이면 잠시후 로봇 앞을 지나갈것이다 → 미래 예측
5. Input / Output
그렇다면, 여기서 정확하게 로봇의 입력과 출력을 생각해보자. 우리가 지금까지는 단순하게 “커피를 옮긴다” 라고 행동을 예측한다고 말을 했지만, 실제로는 로봇의 엑츄에이터와 모터가 얼마나 움직여야 하는지 정확한 값을 로봇에게 주어야하겠지?
실제 입력 데이터의 스키마는 다음과 같을 것이다.
| 입력 | 커피 배달 예시 | 데이터 형태 예시 |
|---|---|---|
| 작업 지시 | “커피를 3번 테이블로 옮겨줘” | 텍스트 |
| 카메라 관측 | 컵·테이블·사람이 보이는 장면 | 이미지 또는 영상 |
| 로봇 자신의 상태 | 관절 각도·속도, 집게 열림 정도 | 숫자 배열 |
| 추가 센서 정보 | 컵을 잡는 힘, 주변 물체까지의 거리 | 숫자·거리 데이터 |
| 과거 정보 | 최근 영상, 이전 움직임 | 관측 이력 또는 내부 기억 |
출력은 구체적인 움직임을 나타내는 값이야.
예를 들어 “컵 쪽으로 손을 뻗는다”는 행동도 여러 방식으로 표현할 수 있어.
| 출력 방식 | 뜻 |
|---|---|
| 집게의 목표 위치·방향 또는 이동량 | “집게를 오른쪽으로 2cm 이동해라.” |
| 관절의 목표 각도 | “이 관절을 30도로 맞춰라.” |
| 관절의 목표 속도 | “이 관절을 초당 10도로 회전해라.” |
| 관절 토크 | “이 관절에 특정 크기의 회전력을 가해라.” |
| 집게 명령 | “집게를 닫아라.” |
| 이동 베이스 명령 | “앞으로 이동하면서 왼쪽으로 회전해라.” |
6. Training Data
강화학습 vs 모방학습
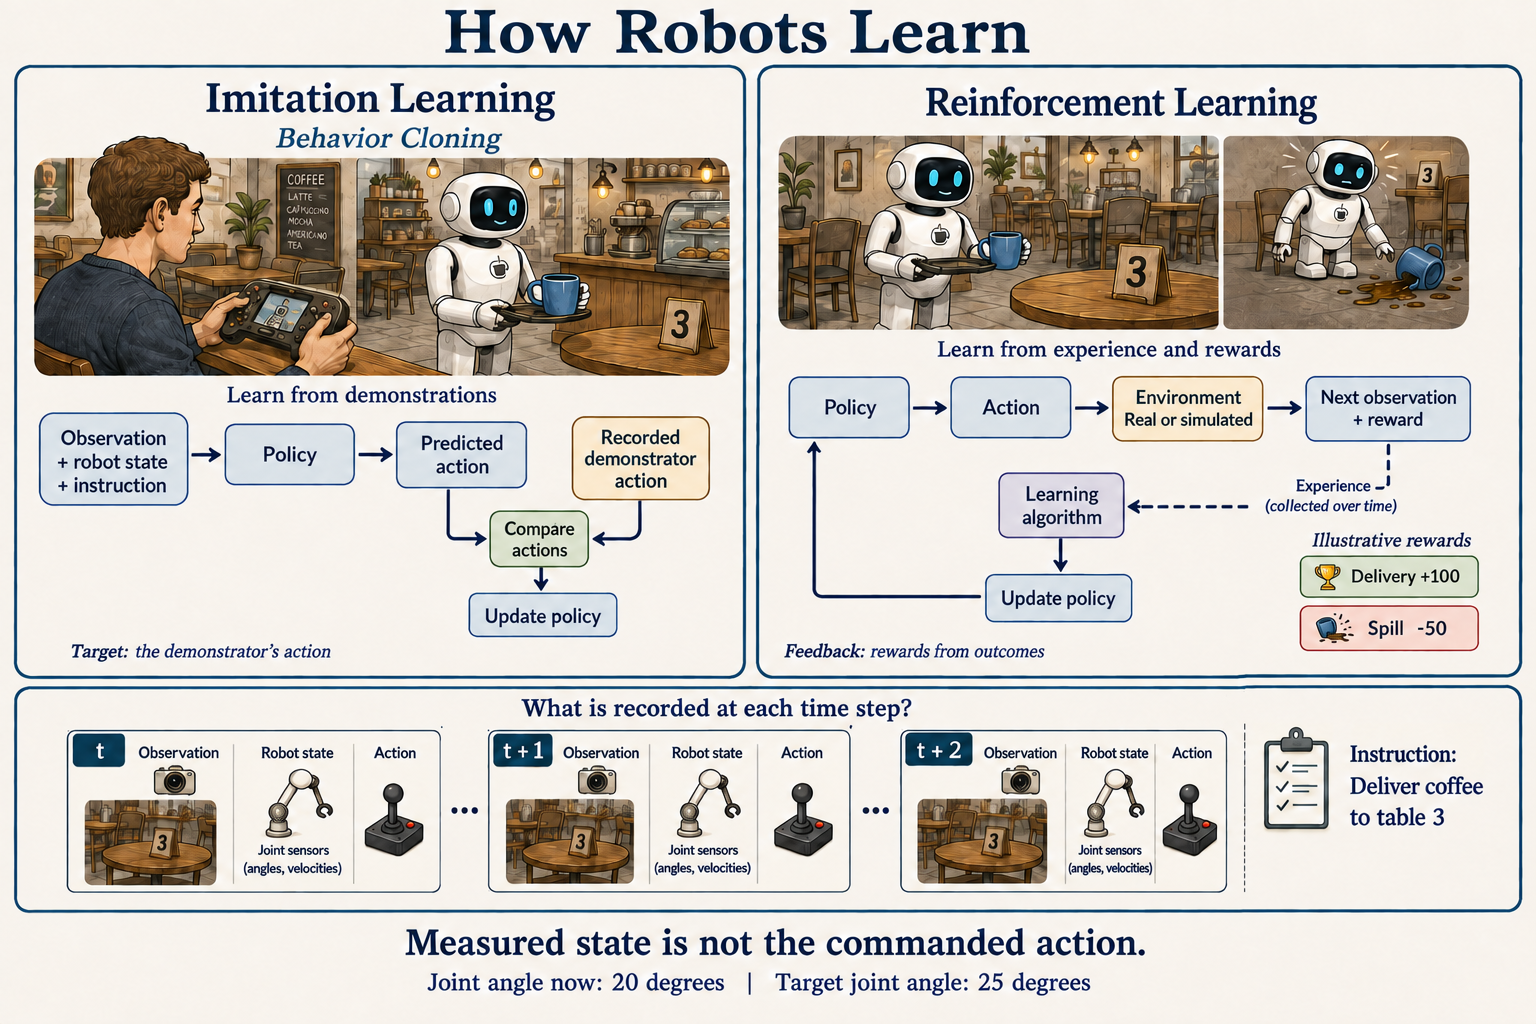 모방학습(행동 복제)과 강화학습의 비교. 아래 시간축은 시연의 기본 기록을 보여주며, 강화학습에는 보상·다음 관측·종료 정보 등이 추가된다. 직접 제작한 개념도.
같은 “커피를 3번 테이블로 옮기는 정책”도 서로 다른 방법으로 학습할 수 있다. 먼저 무엇을 학습의 기준으로 삼는지 구분해보자.
1. 모방학습 — 사람이 보여준 행동에서 배우기
사람이 텔레옵 장치로 로봇을 조종해 컵을 잡고, 이동하고, 테이블에 내려놓는다. 이때 카메라 영상과 로봇 상태, 사람이 내린 행동 명령을 함께 기록한다.
대표적인 방법인 행동 복제(Behavior Cloning)에서는 특정 관측에서 정책이 출력한 행동을 시연자의 행동과 비교한다. 그 차이, 즉 학습 손실이 줄어들도록 정책 모델의 파라미터를 업데이트한다.
관측 + 작업 지시 + 로봇 상태 → 정책이 행동 출력 → 시연 행동과 비교 → 정책 업데이트
여기서 정답은 “커피를 옮겨줘”라는 문장이 아니라, 시연자가 그 순간 내린 집게 이동량이나 목표 관절 각도 같은 행동 값이다. 전체 동작을 시간표대로 외워 재생하는 것과도 다르다. 각 상황에서 어떤 행동을 해야 하는지를 배운다.
환경에서 성공 보상을 따로 받지 않고도 행동 복제로 정책을 학습할 수 있다. 다만 시연에 없던 상황에서는 실수가 생길 수 있다. 행동 복제는 모방학습의 대표적인 방법이지, 모든 모방학습이 행동 복제인 것은 아니다.
2. 강화학습 — 행동의 결과로 받은 보상에서 배우기
강화학습에서는 행동과 그 결과, 보상이 포함된 경험을 이용해 앞으로 얻을 누적 보상의 기대값이 커지도록 정책을 학습한다.
예를 들어 커피를 전달하면 +100, 흘리면 −50, 충돌하면 −100, 1초가 지나면 −1이라는 보상 기준을 사용할 수 있다. 이 숫자는 설명용이며, 사람이 매 순간 직접 채점할 필요는 없다. 센서나 시뮬레이터의 정보를 이용해 프로그램이 보상을 계산할 수 있다.
관측 → 정책이 행동 출력 → 환경에서 실행 → 다음 관측과 보상 기록 → 모은 경험으로 정책 업데이트
환경은 실제 로봇이 움직이는 카페일 수도 있고 시뮬레이터일 수도 있다. 정책 업데이트가 반드시 매 행동 직후 일어나는 것은 아니며, 이미 수집된 경험으로 학습하는 방법도 있다.
사람의 정답 행동을 그대로 따라야 하는 것이 아니라, 장기적으로 좋은 결과를 내는 행동을 배우는 것이다. 사람을 기다리느라 당장 −1점을 받더라도 충돌 위험을 줄이면 더 유리할 수 있다.
모방학습과 강화학습은 함께 사용할 수도 있다. 예를 들어 시연으로 기본 동작을 배운 정책을 보상 기반 학습으로 개선할 수 있다.
두 방법의 비교
| 구분 | 모방학습: 행동 복제 | 강화학습 |
|---|---|---|
| 주요 학습 기준 | 시연자가 그 상황에서 한 행동 | 행동 결과에 대한 보상 |
| 정책을 바꾸는 방향 | 시연 행동과의 차이를 줄임 | 기대 누적 보상을 높임 |
| 커피 배달 예시 | 사람이 조종한 집기·이동 명령을 따라 배움 | 전달 성공, 흘림, 충돌, 시간 등을 고려해 배움 |
그렇다면 실제 학습 데이터에는 무엇이 들어갈까?
특정 작업과 환경에서 시간에 따라 데이터를 기록한다는 출발점은 맞다. 하지만 관절 상태의 시간 변화만으로는 충분하지 않다. 로봇이 무엇을 보았고, 어떤 지시를 받았으며, 어떤 명령을 실행했는지를 함께 알아야 한다.
여러 작업과 환경에서 모은 시연을 하나의 데이터셋으로 묶을 수도 있다. 작업 지시는 시연 전체에서 같을 수 있지만, 관측과 로봇 상태, 행동 값은 시점마다 달라진다.
1. 시연 데이터의 한 시점
| 항목 | 기호 | 커피 배달 예시 |
|---|---|---|
| 시간 | t | 시연 시작 후 경과 시간 |
| 작업 지시 | g | 커피를 3번 테이블로 옮겨줘 |
| 카메라 관측 | o_t | 그 순간의 컵·사람·테이블 영상 |
| 로봇 자신의 상태 | x_t | 측정된 관절 각도·속도, 집게 열림 정도 |
| 시연자의 행동 | a_t | 목표 관절 각도, 집게 이동량, 베이스 속도 등 선택한 행동 표현 |
여기서 x_t는 로봇 자신의 측정 정보이며, 주변 환경까지 포함한 완전한 상태를 뜻하지 않는다. 행동 값의 형태는 앞의 Input / Output에서 정한 표현을 따른다.
측정된 관절 각도 20도는 현재 상태이고, 25도로 움직이라는 명령은 행동이다. 이후 관절이 실제로 25도에 도달했는지는 다시 측정해야 한다.
2. 행동 복제의 입력과 정답
입력: 작업 지시 g + 현재 영상 o_t + 로봇 상태 x_t
정답: 같은 시점에 시연자가 내린 행동 a_t
이러한 샘플을 시간 순서로 모으면 한 번의 시연인 trajectory 또는 episode가 된다. 최근 여러 관측을 입력으로 사용하거나, 앞으로의 행동 여러 개를 정답으로 삼을 수도 있다.
영상·센서·행동 명령은 시간 정보를 맞춰 저장해야 한다. 같은 시점의 관측과 명령이 서로 어긋나면 잘못된 연결을 학습할 수 있다. 기록 간격은 로봇과 작업에 따라 정하며, 반드시 1초 간격인 것은 아니다.
3. 강화학습 데이터에 추가되는 것
강화학습에서는 현재 관측·로봇 상태, 행동, 보상, 다음 관측·로봇 상태, 에피소드 종료 여부 등을 기록한다.
현재 관측·로봇 상태 → 행동 → 보상 + 다음 관측·로봇 상태 + 종료 정보
실제 구현에서는 목표 달성·실패에 따른 종료와 시간 제한에 따른 중단을 구분해서 저장하기도 한다. 작업 지시와 필요한 관측 이력도 함께 사용할 수 있다.
4. 동역학 모델을 학습한다면?
같은 기록을 이용하더라도 학습 대상은 달라진다.
현재 관측·로봇 상태 + 행동 → 다음 관측 또는 상태 예측
정책은 어떤 행동을 할지 배우고, 동역학 모델은 그 행동으로 상황이 어떻게 변할지 배운다. 따라서 데이터셋을 볼 때는 “무엇이 입력이고 무엇이 학습 대상인가?”를 함께 확인해야 한다.
이 절의 핵심
학습 데이터는 단순한 관절 상태의 시간 기록이 아니다. 관측·로봇 상태·행동을 시간에 맞춰 묶고, 학습 방법에 따라 시연 행동이나 보상, 다음 상태를 학습의 기준으로 사용한다.
7. 신경망의 기본 부품 — 토큰, 임베딩
알고리즘에 대해서 분석하기전에 필요한 부품 개념들부터 짚고 넘어가자. 자세하게 짚고 넘어가자 이후에 사용되는 기본적인 개념이기 때문에.
토큰 & 임베딩
우리가 하는 트렌스포머에 넣기 위해서는 백터 형태로 입력이 들어가야하고, 그 작업을 진행해준다고 생각하면 된다. pre processing.
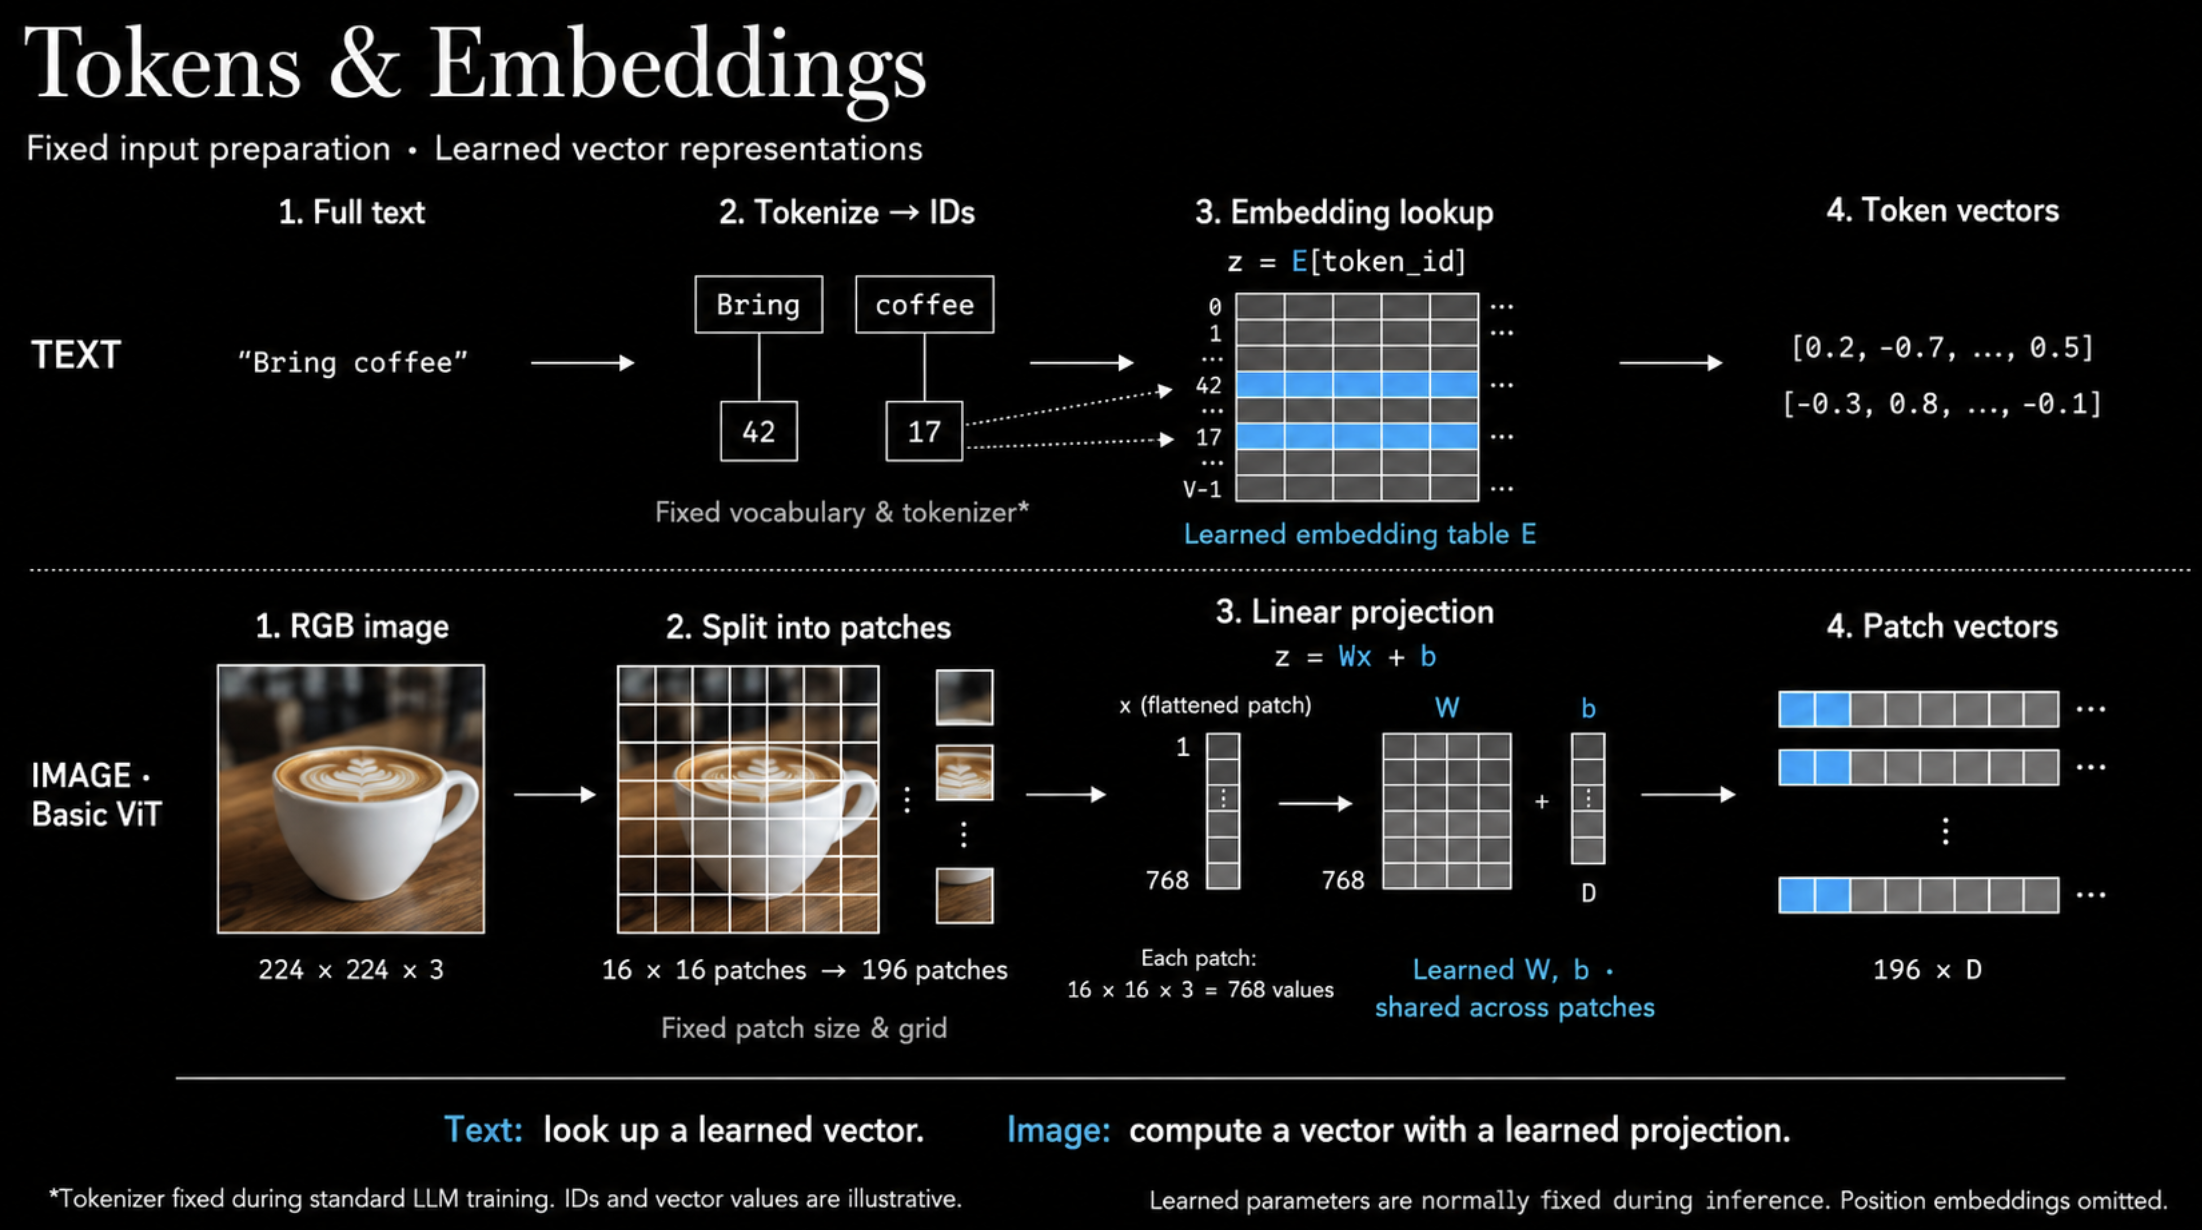
텍스트의 경우,
1
2
3
풀 텍스트
→ 토큰으로 쪼개기  (토큰은 모델에 따라 미리 정해짐)
→ 임베딩에서 백터료 변환 (이 부분은 학습함)
이미지의 경우
1
2
3
이미지 한개를
→ patches로 쪼개고 (쪼개는 방식은 모델에 따라 이미 정해짐)
→ 각 배치들을 embedding에서 벡터로 변환 (이 부분은 학습함)
8. Vision Language Action (VLA) model
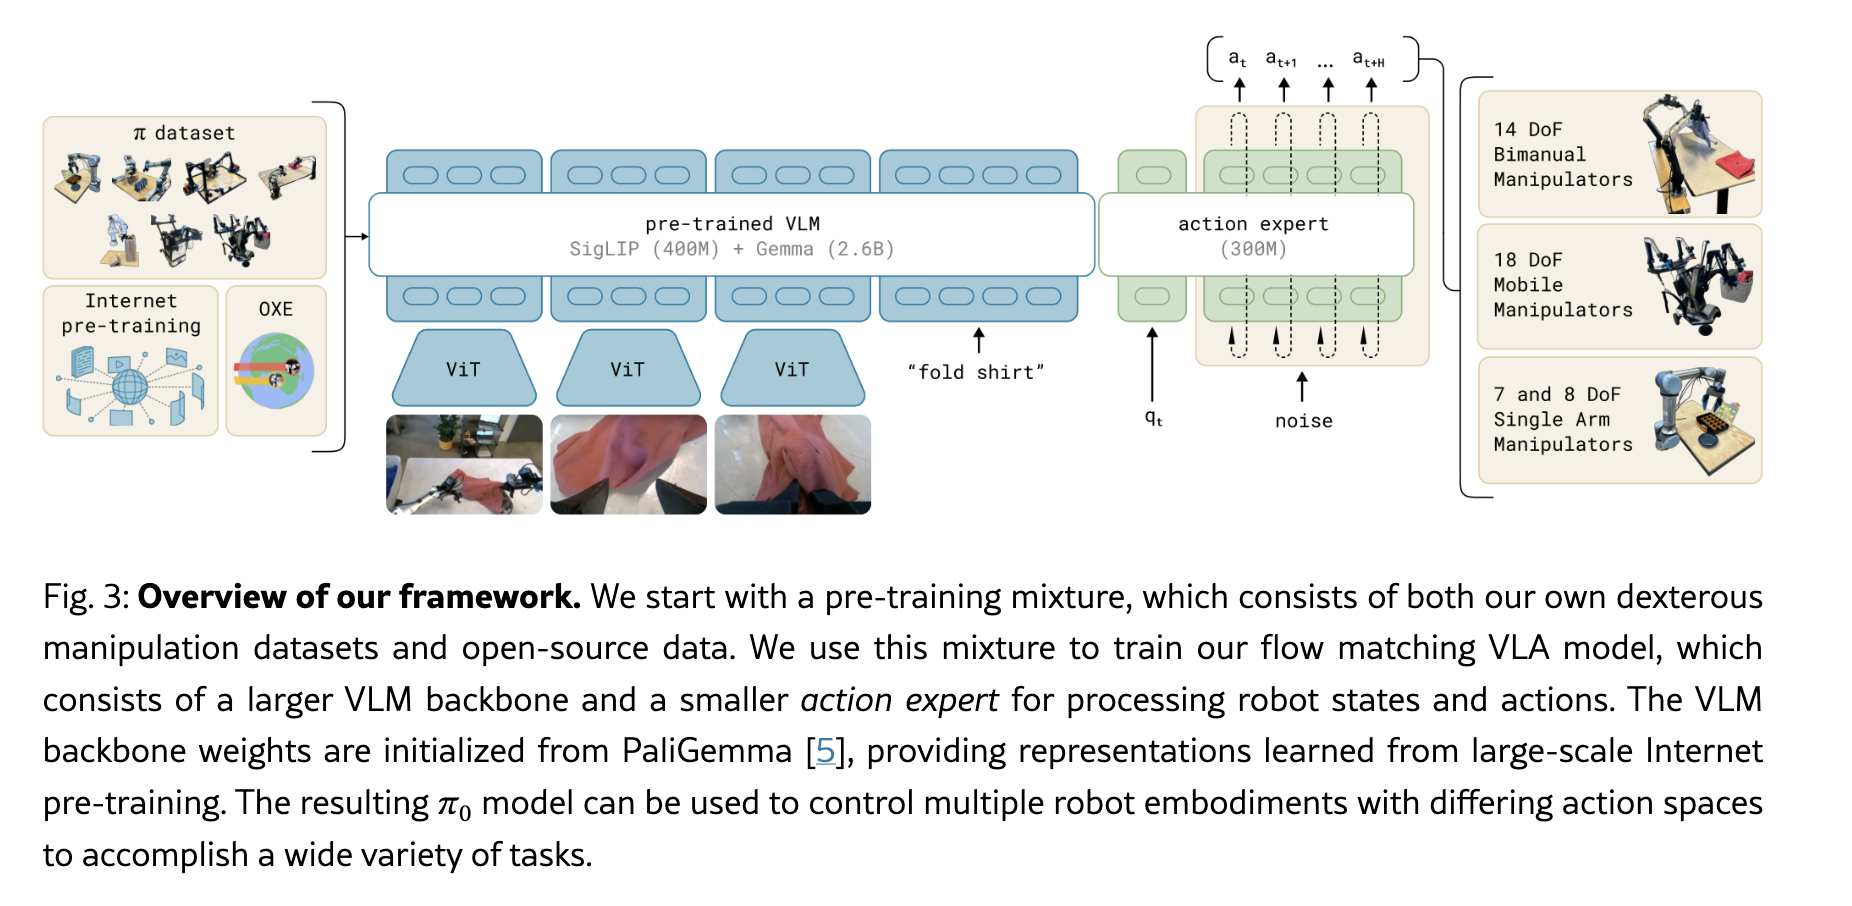 출처: 𝜋_0: A Vision-Language-Action Flow Model for General Robot Control
가장 대표적인 VLA 모델 중 하나인 Physical Intelligence의 π₀를 통해 큰 구조를 이해해보자.
π₀를 아주 단순화하면 다음과 같이 볼 수 있다.
“VLM backbone + Action Expert”
Step1
먼저 여러 카메라에서 들어오는 image와 사용자의 language instruction을 VLM이 처리한다.
1
2
3
4
5
6
7
Camera Images
      ↓
Vision Encoder (ViT)
      ↓
Visual Tokens ─────┐
                   ├─→ VLM Backbone → Scene / Task Representation
Language Prompt ───┘
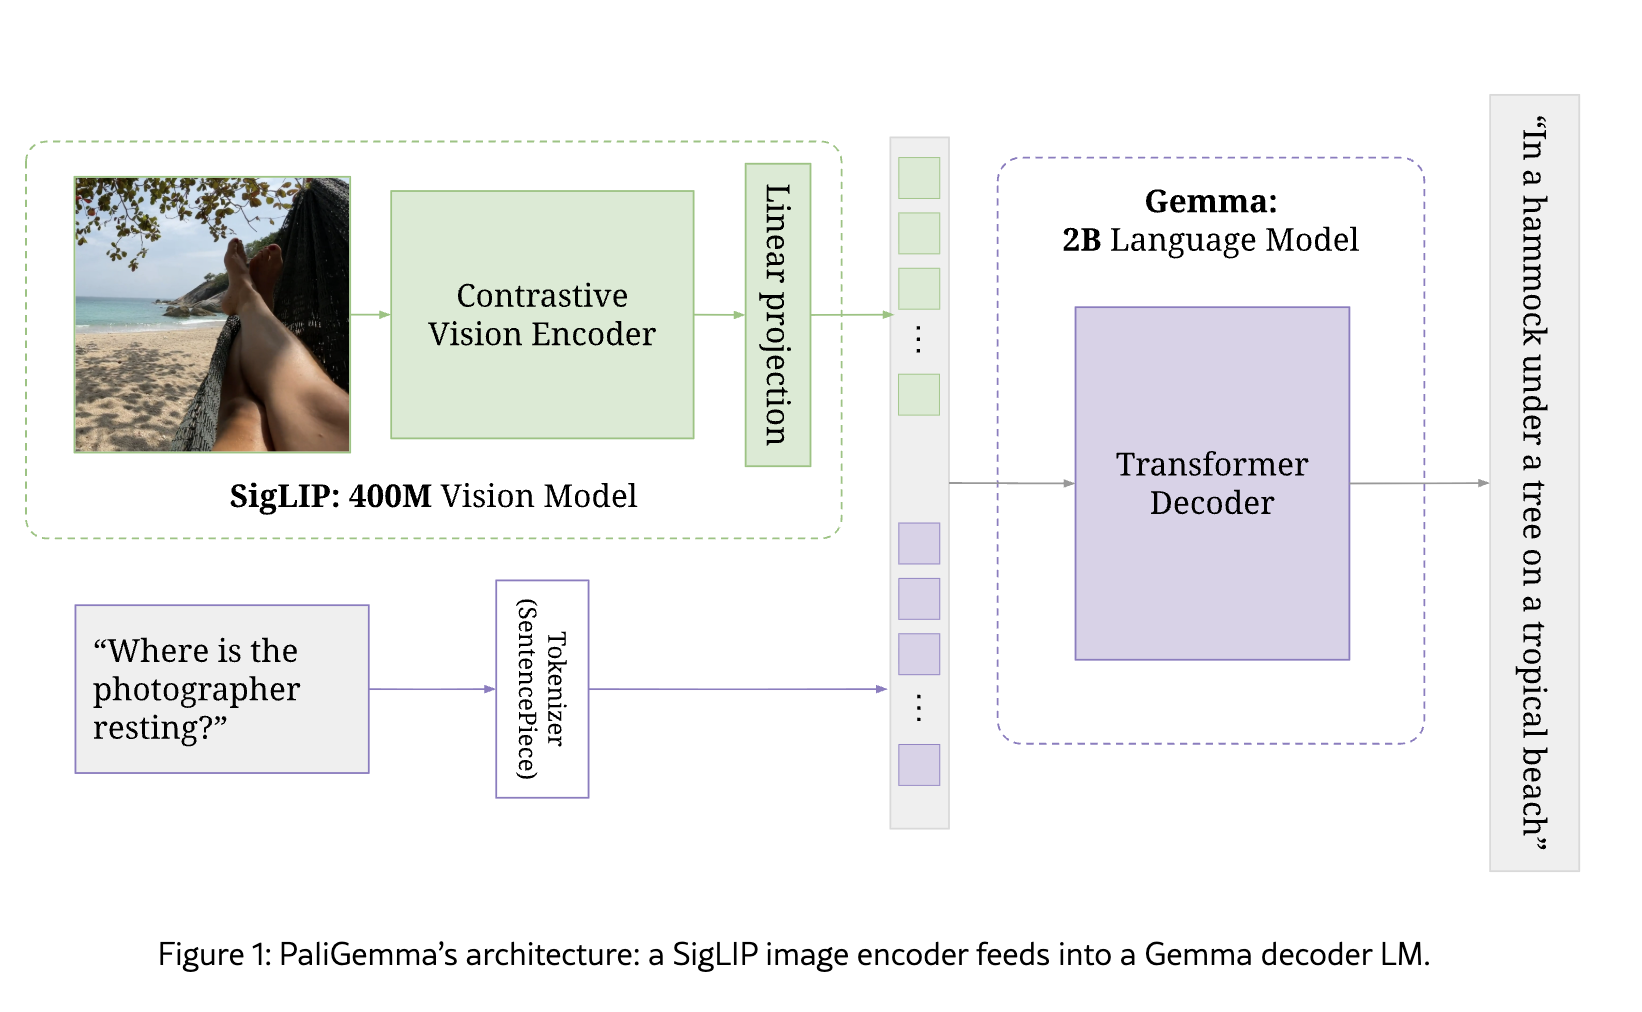 PaliGemma: A versatile 3B VLM for transfer
(여기서 VLM은 구글의 PaliGemma를 사용했다고 말하고 있다)
Gemma - Transformer Decoder Architecture
Google for Developers Blog - News about Web, Mobile, AI and Cloud
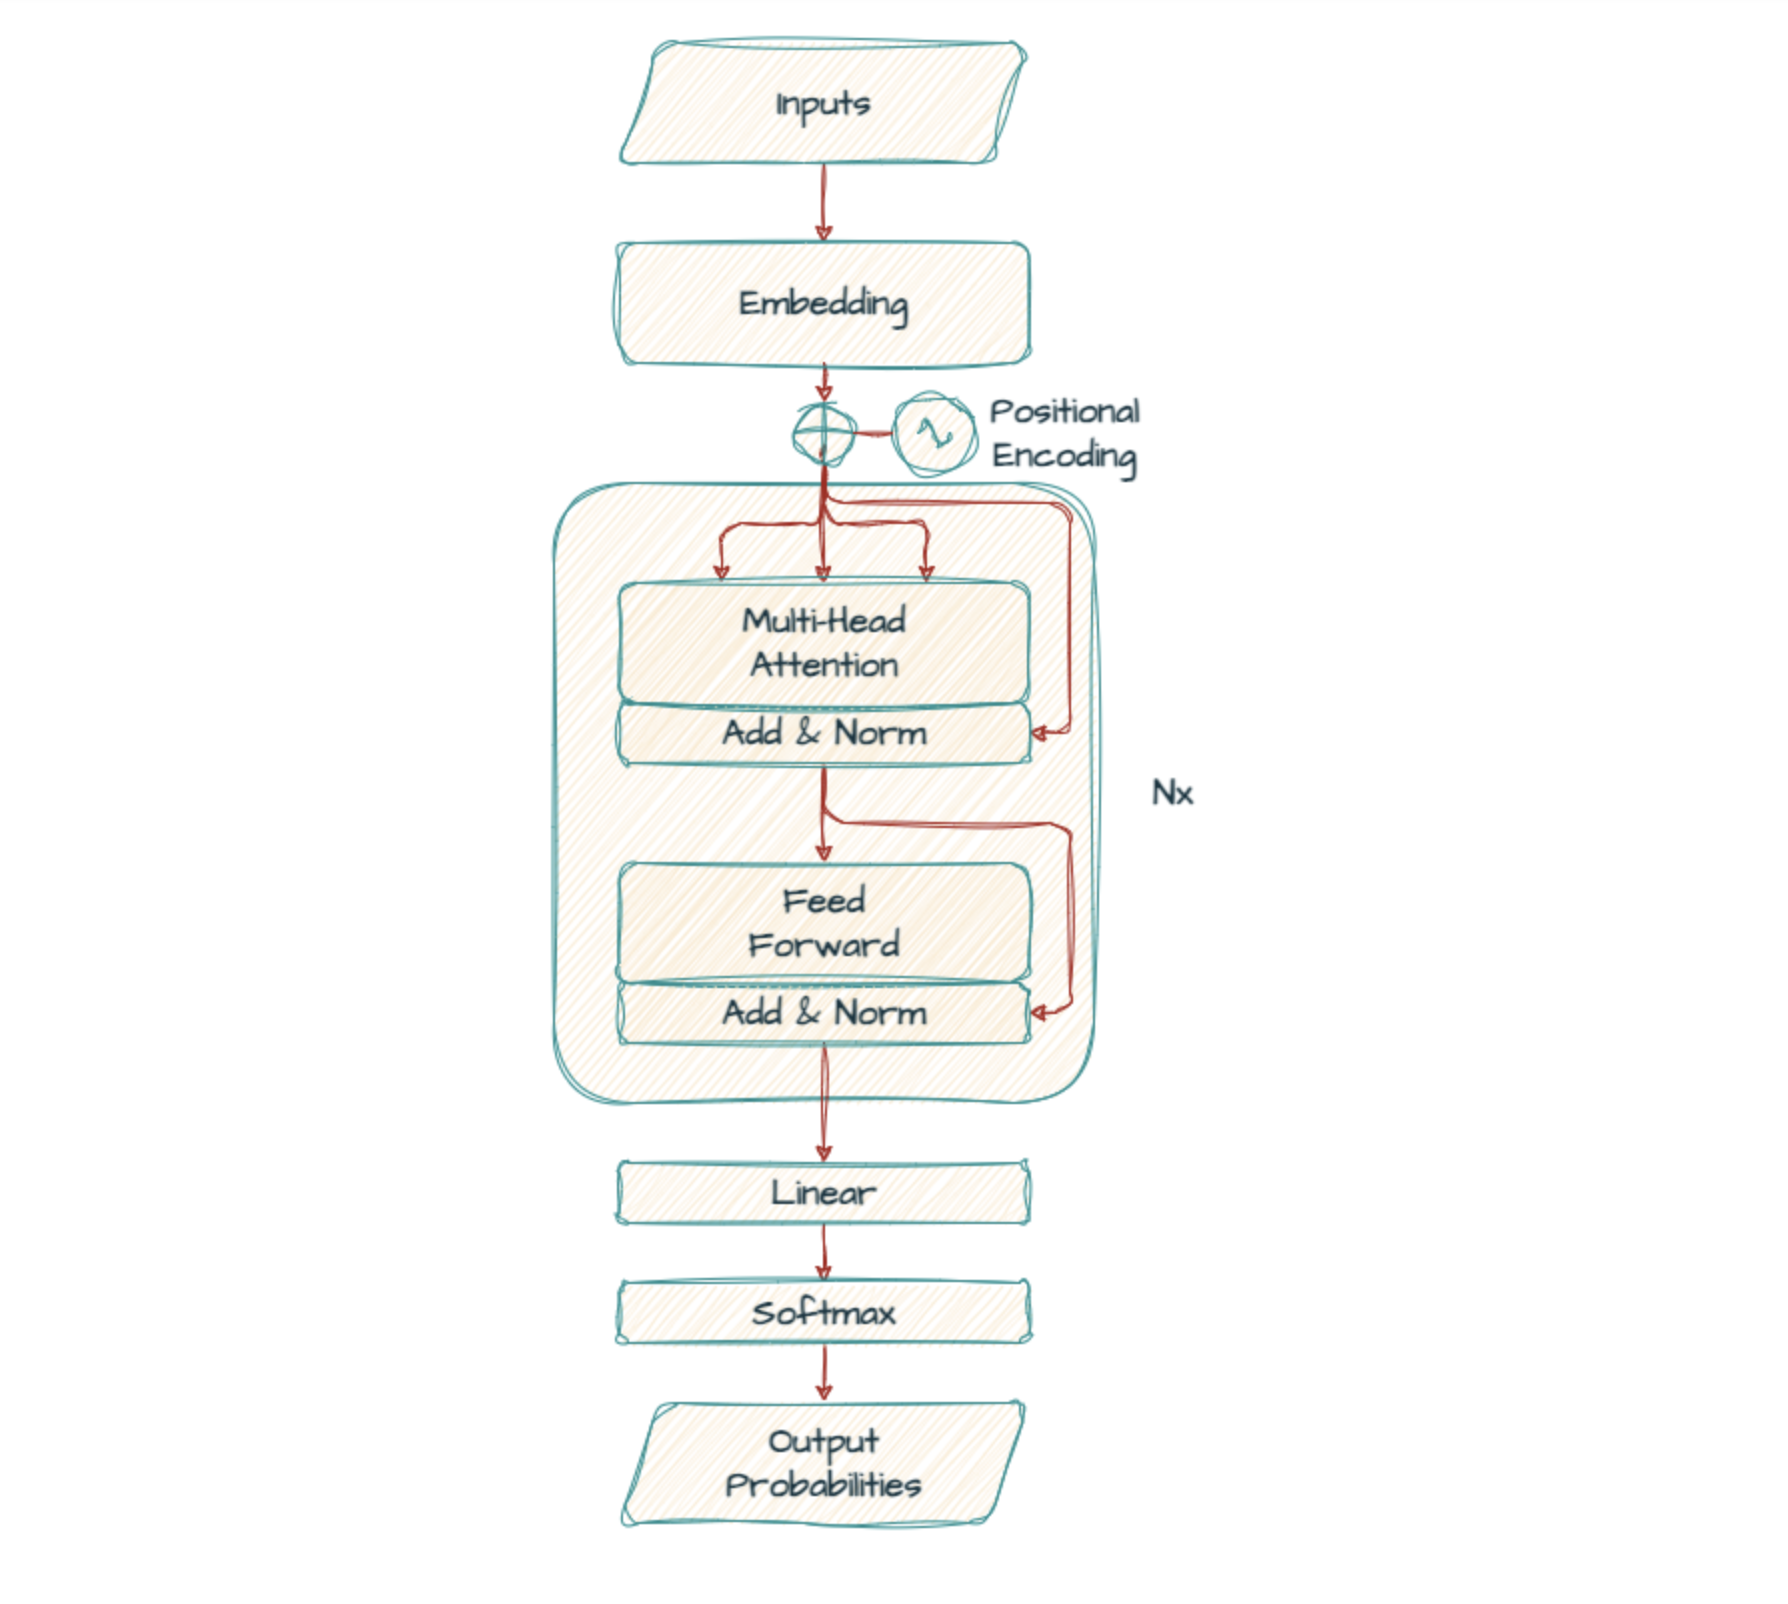
(Transformer Decoder는 이후 실습시간에 따로 다루어 보자.)
즉, 이미지와 명령 프롬트를 가지고, 문맥의 의미를 뽑아내는 역할을 한다고 이해하면 된다.
Step2
로봇의 현재 상태 + action generation + noise가 함께 사용하여 Action Expert가 실제 로봇이 수행해야 할 동작을 생성한다.
1
2
3
4
5
6
Scene / Task Representation + Robot State(q_t) + noise
              ↓
         Action Expert
              ↓
[aₜ, aₜ₊₁, aₜ₊₂, ...]
      Action Chunk
여기서 출력되는 action은 단순한 "move left" 같은 언어가 아니라,
- joint position / velocity
- end-effector movement
- gripper command
등과 같은 continuous robot control signal이다.
π₀에서는 이러한 continuous action을 생성하기 위해 “Flow Matching 기반 Action Expert”를 사용한다.
실제 내부 구조는 이후에 실습시간에 자세하게 알아보자.
9. World Action Model (WAM)
출처: Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models — NVIDIA
VLA가 현재 observation을 보고 바로 action을 예측하는 모델이라면,
WAM(World Action Model)은 세상이 앞으로 어떻게 변할지를 함께 학습 + action까지 연결하는 모델이라고 이해하면 된다.
아주 단순화하면,
1
2
3
4
5
6
VLA
Observation + Language
        ↓
      Policy
        ↓
      Action
1
2
3
4
5
6
WAM
Current World + Action
        ↓
   World Dynamics
        ↓
 Future World + Action
즉 VLA의 핵심 질문이
“지금 이 상황에서 무슨 행동을 해야 하지?”
라면,
WAM은 여기에
“이 행동을 하면 세상이 어떻게 변할까?”
라는 질문까지 같이 학습하는 방향이다.
대표적인 예시: Hydra-0
출처: Hydra-0: Action Flow for Generalist World Modeling and Control
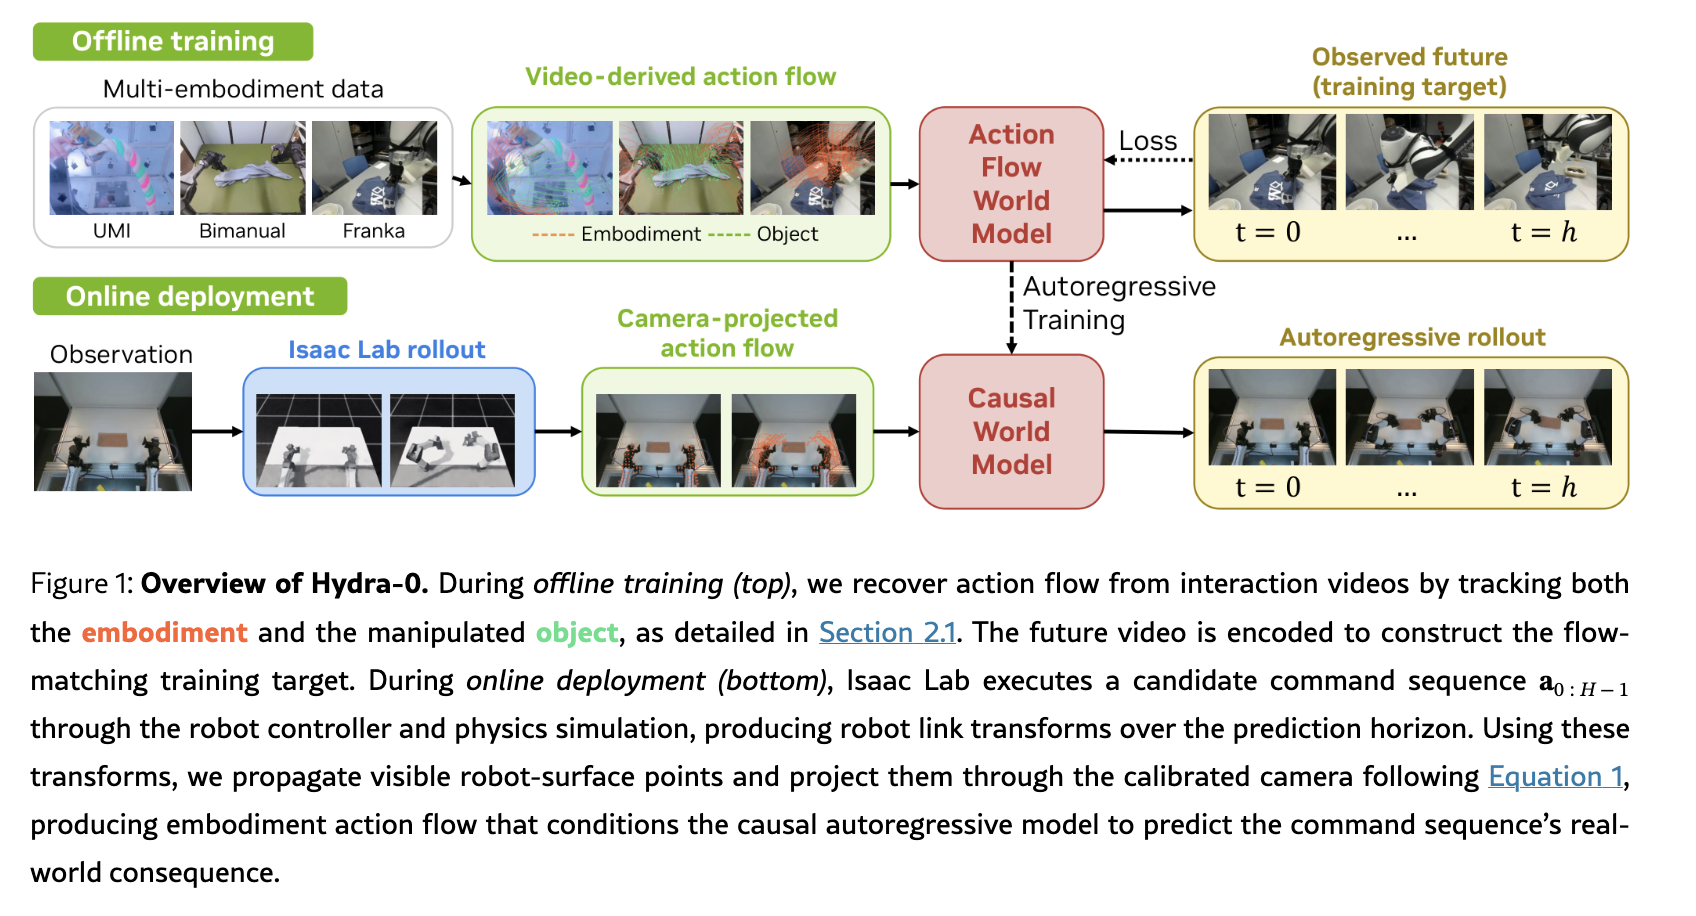
Hydra-0는 action을 단순한 joint angle 값으로만 표현하지 않고 Action Flow, 즉 이미지 안에서 로봇과 물체가 어떻게 움직일지를 나타내는 visual motion 형태로 표현한다. (pi 0.0 의 action model 과 비슷)
1
2
3
4
5
6
7
현재 Image / Video
      +
 Action Flow
      ↓
   Hydra-0
      ↓
Future visual state
따라서 모델은 단순히 action을 출력하는 것을 넘어서, 특정 행동을 했을 때 로봇과 주변 물체가 어떻게 움직일지(action flow)를 학습한다.
Hydra-0의 재미있는 점은 반대 방향도 가능하다는 것이다.
1
2
3
4
5
6
7
원하는 Object Motion
        ↓
     Hydra-0
        ↓
Compatible Robot Motion
        ↓
 Executable Action
즉 원하는 미래의 물체 움직임 → 그 결과를 만들 수 있는 로봇 움직임 → 실제 action으로 연결할 수 있다.
따라서 WAM을 큰 그림으로 보면,
세상의 변화(World Dynamics)를 학습한 뒤, 그 이해를 robot action 생성과 연결하는 모델
이라고 생각하면 된다.
10. World Foundation Model (WFM)
출처: NVIDIA Cosmos World Foundation Models
WFM(World Foundation Model)은 특정 로봇 하나의 policy를 바로 만드는 것이 목적이라기보다, 현실 세계의 공간적 관계와 물리적 변화 자체를 대규모 데이터로 학습한 범용 World Model이다.
LLM을 비유로 생각하면 이해하기 쉽다.
1
2
3
4
5
Internet-scale Text
      ↓
     LLM
      ↓
Language Foundation Model
이에 대응해서 WFM은,
1
2
3
4
5
6
Large-scale Image / Video / Action data
              ↓
             WFM
              ↓
General representation of
space + motion + physical dynamics
즉 “세상은 어떻게 생겼고, 물체는 어떻게 움직이며, 시간이 지나면 무엇이 일어나는가?”를 학습하는 foundation model이라고 볼 수 있다.
대표적인 예시: NVIDIA Cosmos
출처: Cosmos World Foundation Model Platform for Physical AI
NVIDIA는 Cosmos의 WFM을 대규모의 다양한 실제 영상 데이터로 학습한 general-purpose world model로 정의한다.
예를 들어 현재 image/video와 text를 넣으면 이후의 world state를 video 형태로 생성하거나 예측할 수 있다.
1
2
3
4
5
Image / Video + Text
        ↓
   Cosmos WFM
        ↓
Future World / Video
여기서 중요한 것은 WFM 자체가 반드시 robot action을 직접 출력해야 하는 것은 아니라는 점이다.
WFM은 먼저 세상의 dynamics를 학습하는 범용 backbone 역할을 하고, 이후 특정 robot과 task 데이터로 post-training하여 WAM이나 policy model로 발전시킬 수 있다.
NVIDIA의 최신 Cosmos 3는 이 경계를 더 넓혔다. Cosmos 3는 Mixture-of-Transformers 구조에서 vision reasoning + world generation + action generation을 하나의 physical-AI foundation model 안에 통합한다.
출처: NVIDIA Cosmos 3
따라서 WFM의 핵심 아이디어를 아주 크게 보면,
현실 세계의 공간, 움직임, 물리적 상호작용을 대규모 데이터에서 학습하여 다양한 Physical AI 모델의 기반이 되는 foundation model
이라고 이해하면 된다.
VLA vs WAM vs WFM
| Model | 핵심 질문 | 대표 예시 |
|---|---|---|
| VLA | 현재 상황에서 어떤 행동을 해야 하는가? | π₀ |
| WAM | 행동하면 세상이 어떻게 변하며, 어떤 action이 필요한가? | DreamZero, Hydra-0 |
| WFM | 현실 세계 자체의 공간·시간·물리적 dynamics는 어떻게 작동하는가? | NVIDIA Cosmos / Cosmos 3 |
정리하면,
VLA = 보고 이해해서 행동한다.
WAM = 행동과 미래 세계 변화를 함께 모델링한다.
WFM = 그보다 더 넓게 현실 세계 자체의 dynamics를 학습하는 foundation model이다.
11. 현재 흐름 — 주요 기업·연구기관과 대표 모델
기준일: 2026-09-07. VLA·WAM·WFM을 공부할 때 추적할 주요 기업, 연구기관, 공개 연구와 개발 도구를 정리했다. 총 50개 항목이며, 같은 기관이 서로 다른 모델·역할로 여러 번 등장한다. 시장점유율 순위나 모든 기업을 망라한 목록은 아니다. 대학 연구실 표에는 현재 연구의 계보를 이해하는 데 중요한 과거 대표 연구도 포함했다.
표 읽는 법: VLA는 시각·언어에서 행동으로 연결하는 정책 계열, WAM은 세계의 변화 모델링과 행동 생성을 연결하는 계열, WFM은 여러 작업에 재사용하는 범용 월드 모델을 뜻한다. 이 분류는 완전히 배타적이지 않으며, 기업이 쓰는 명칭과 공개된 구조를 함께 반영했다. 구조가 충분히 공개되지 않은 모델은 억지로 VLA/WAM으로 단정하지 않았다. 분류 참고: NVIDIA WAM 기술 해설
공개 상태 주의: ‘발표·보고서 공개’와 ‘코드·가중치 공개’는 다르다. ‘가중치 미확인’은 이번에 확인한 공식 자료에서 배포를 확인하지 못했다는 뜻이다. 공개 코드·가중치도 상업적 이용 조건, 필요한 데이터·GPU, 로봇별 인터페이스를 별도로 확인해야 한다. 아래 날짜는 확인한 대표 발표 시점이며, 모든 제품의 출시일을 뜻하지 않는다.
11-1. 로봇 정책·VLA·WAM — 기업 및 산업 연구팀
| 기업·연구기관 | 대표 모델·프로젝트 | 계열 | 핵심 역할·공부할 포인트 | 공개·실습 상태 | 1차 출처 |
|---|---|---|---|---|---|
| Physical Intelligence (PI) | π₀ → π₀.₅ → π₀.₇ π₀.₇: 2026-04-16 | VLA 월드 모델과 결합 가능 | 여러 로봇·작업에 적용하는 범용 정책. π₀.₇은 외부 월드 모델이 만든 시각적 하위 목표를 받아 행동할 수 있지만, 이를 이유로 모델 자체를 단순히 WAM으로 바꾸어 분류하면 안 된다. | openpi: π₀·π₀-FAST·π₀.₅ 코드·체크포인트 공개. π₀.₇: 보고서 공개, 가중치 미확인. | π₀.₇ openpi |
| Google DeepMind — Robotics | Gemini Robotics 2 ER 2 / On-Device 2 2026-07-30 | VLA + 별도 embodied reasoning 모델 | Robotics 2는 로봇 행동·전신 제어, ER 2는 공간·작업 추론에 초점. 같은 제품군 안에서도 추론 모델과 행동 정책의 역할을 구분해야 한다. | 공식 보고·파트너 접근 중심. 행동 모델과 ER 모델의 제공 경로가 다름. | 공식 발표 |
| NVIDIA — Isaac GR00T | GR00T N1.7 GR00T N1 계열 | VLA / 로봇 파운데이션 정책 | 시각·언어·로봇 상태를 행동으로 연결하는 휴머노이드·로봇 정책. Cosmos나 Isaac Sim과 협력하지만, 정책 모델 자체는 별도 구성요소다. | 공식 코드·모델 배포 경로 공개. 로봇별 후속 학습·설정 필요. | Isaac-GR00T |
| NVIDIA — DreamZero 연구팀 | DreamZero 2026-02 | WAM — 미래 영상·행동 공동 모델링 | 비디오 사전학습에서 얻은 세계 변화 지식을 로봇 행동에 연결한다. 미래 장면과 행동을 함께 다루는 WAM의 대표적인 학습 사례. | 논문·공식 코드 링크 공개. | 공식 프로젝트 |
| NVIDIA 및 대학 공동연구 | Hydra-0 2026-08 | 행동 조건부 월드 모델 • 역방향 행동 생성 | 정방향에서는 로봇 움직임을 조건으로 세계 반응을 생성한다. 역방향에서는 원하는 물체 움직임을 로봇 움직임·행동과 연결한다. 두 사용 모드를 구분해서 읽는 것이 중요하다. | 논문·데모 공개. 공식 페이지의 코드는 ‘coming soon’. | Hydra-0 |
| Dyna Robotics | Dyna-2 2026-08 | WAM | 인간 영상의 세계 변화 학습을 로봇 행동으로 전이. 영상·행동 공동 학습을 지원하지만, 보고서의 일부 변형은 추론 시 미래 영상을 생성하지 않고 행동만 예측한다. | 기술 보고·실기체 데모 공개. 가중치 미확인. | Dyna-2 기술 보고 |
| Figure AI | Helix 02 2026 | VLA / 전신 제어 | 이동과 양손 조작을 연결하는 휴머노이드 정책. Helix는 AI 시스템이고 Figure 로봇은 이를 실행하는 몸체다. | 기술 설명·데모 공개. 가중치 미확인. | Helix 02 협동 조작 사례 |
| 1X / World Model Lab | 1XWM 2026-01-12 | WAM 계열 — 영상 예측 + IDM | 미래 영상을 생성한 뒤 역동역학 모델(IDM)로 NEO가 실행할 행동을 추출한다. DreamZero식 공동 출력과 비교하면 WAM 내부 설계의 차이가 보인다. | 새 1XWM은 보고서·데모 공개. 과거 World Model Challenge의 공개 코드와 구분. | 1XWM World Model Lab |
| Generalist AI | GEN-1 → GEN-1.5 2026-08-19 | 범용 로봇 파운데이션 정책 | 감각·행동 경험을 사전학습하고, 시범을 문맥에 넣어 새로운 작업에 적응하는 physical prompting을 연구한다. 브랜드명만 보고 WAM이라고 단정하지 않는다. | 공식 연구 보고·데모. 가중치 미확인. | GEN-1.5 |
| Skild AI | Skild Brain / S1 2026-08-18 | 범용·다기체 로봇 정책 | 서로 다른 로봇 몸체와 작업에 적용되는 정책. S1은 시범 영상과 경험 문맥으로 작업에 적응하는 in-context learning을 강조한다. | 공식 보고·데모. 가중치 미확인. | S1 Skild Brain |
| Sunday Robotics | ACT-1 → ACT-2 Preview 2026-07-17 | 가정용 로봇 파운데이션 정책 | 인간 시범 데이터와 후속 학습으로 낯선 가정에서도 작업의 신뢰도를 높이는 방향. Sunday의 ACT 모델명은 아래 대학 연구의 ACT 알고리즘과 구분한다. | 프리뷰·기술 보고. 가중치 미확인. | ACT-2 Preview |
| Genesis AI — 기업 | GENE-26.5 2026-05-07 | 로보틱스 전용 멀티모달 파운데이션 모델 | 시각·언어·고유감각·촉각·행동을 연결하고, 로봇 손·데이터 수집·시뮬레이션 평가까지 함께 개발한다. 이름이 같은 시뮬레이터 항목과 구분. | 시스템 기술 보고·데모. 가중치 미확인. | GENE-26.5 |
| Rhoda AI | FutureVision / Direct Video Action | 영상 예측 기반 행동 모델 DVA / WAM 계열 | 세계의 시각적 변화를 예측하고 로봇 행동으로 연결하는 폐루프 접근. VLM에 행동 헤드를 붙이는 전형적 VLA와 비교할 사례. | 공식 기술 소개·데모. 가중치 미확인. | 공식 소개 |
| ByteDance Seed — Robotics | GR-3 / GR-RL 2025 대표 발표 | VLA + 강화학습 후속 학습 | 범용 조작 정책을 만들고 강화학습으로 정확성과 작업 성공을 개선한다. VLA와 RL이 대립하는 개념이 아니라 결합 가능한 요소임을 보여준다. | 논문·기술 보고 공개. 대표 모델 가중치 미확인. | Seed Robotics 연구 목록 |
| AgiBot / 智元机器人 | Genie Operator 2 / GO-2 2026 | 추론·행동 결합 로봇 모델 | 저주파 상위 추론과 고주파 행동 생성을 연결하는 이중 시스템. Google의 Genie 월드 모델, Unitree의 Go2 로봇과 이름을 혼동하지 않는다. | 공식 발표·데모. GO-2 가중치 미확인. | 공식 발표 |
| Galaxea AI / 공동연구팀 | G0.5: 2026-06 Fast-WAM: 공동연구 | G0.5: VLA Fast-WAM: WAM | G0.5는 추론과 행동을 통합한 자기회귀 모델. Fast-WAM은 미래 영상 학습으로 얻은 표현을 활용하되 실제 제어 추론에서 영상 생성을 생략하는 설계를 연구한다. | G0.5 코드·가중치 공개. 비상업적 커뮤니티 라이선스 확인 필요. | GalaxeaVLA Fast-WAM |
| Hugging Face — Robotics | SmolVLA 2025-06-03 LeRobot: 개발 도구 | 경량 VLA + 공개 학습 생태계 | 작은 모델·저비용 로봇으로 데이터 수집부터 학습·추론까지 연결하는 실습 입구. SmolVLA는 모델, LeRobot은 여러 정책을 다루는 도구다. | 코드·가중치·학습 안내 공개. | SmolVLA |
| Ai2 — Allen Institute for AI | MolmoAct 2 2026-05 MolmoBot / MolmoSpaces | VLA / embodied AI | 언어·시각 추론과 연속 행동 생성을 연결한다. 별도 MolmoBot·MolmoSpaces 연구는 시뮬레이션 중심 학습·평가와 연결된다. | MolmoAct 2 코드·가중치·데이터 공개. | MolmoAct 2 공식 코드 Embodied AI |
| Toyota Research Institute + Boston Dynamics | Large Behavior Models (LBM) Atlas: 로봇 몸체 | 범용 행동 모델 / 전신 제어 | 대규모 행동 학습을 실제 휴머노이드의 이동·조작에 연결한다. LBM이라는 명칭만으로 WAM 또는 WFM이라고 판단하지 않는다. | 협력 연구·기술 설명·데모 공개. 가중치 미확인. | 공동연구 Atlas와 학습 제어 |
| Robbyant / Ant Group | LingBot-VA 2026 | WAM / Video-Action Model | 영상과 행동을 함께 모델링하는 로봇 정책. 비디오 기반 사전학습이 제어로 연결되는 구현을 살펴볼 공개 연구 사례. | 논문·공식 코드 공개. | LingBot-VA |
| Sereact | Cortex 2.0 2026-04 | 산업용 WAM | 산업 현장의 조작 경험을 월드 모델·정책에 연결한다. 연구실 벤치마크뿐 아니라 배포·실패·재학습의 연결을 볼 사례. | 기술 논문 공개. 가중치 미확인. | Cortex 2.0 논문 |
| Mimic Robotics | mimic-video 2025-12 | Video-Action Model / WAM 계열 | 비디오 모델의 사전학습을 로봇 제어 일반화에 활용한다. VLM에서 출발한 정책과 비디오 모델에서 출발한 정책을 비교할 사례. | 논문 공개. 가중치 미확인. | mimic-video 논문 |
11-2. 월드 모델·공간 지능 — 범용 기반과 인접 분야
이 표의 모델이 모두 로봇 관절 명령을 직접 출력하는 것은 아니다. 예측·환경 생성·학습·평가·계획 중 어디에 쓰이는지 구분해서 보자.
| 기업·연구기관 | 대표 모델·프로젝트 | 계열 | 핵심 역할·공부할 포인트 | 공개·실습 상태 | 1차 출처 |
|---|---|---|---|---|---|
| NVIDIA — Cosmos | Cosmos 3 Cosmos 계열 | WFM / 멀티모달 월드 모델 | 세계의 변화·물리적 상호작용을 다루는 범용 기반. 영상 생성·추론·행동 관련 작업과 로봇별 후속 학습에 활용한다. Isaac Sim이라는 물리 시뮬레이터와는 다르다. | 모델·후속 학습 도구 공개 경로 제공. 모델별 라이선스 확인. | Cosmos 공식 페이지 |
| World Labs | Atlas: 2026-09-01 Marble: 앞선 모델·제품 | 공간 지능 / 멀티모달 월드 모델 | 텍스트·이미지·영상·3D 정보를 공유 공간 문맥으로 처리해 장면을 생성·재구성한다. 공개된 공간 생성 능력과 검증된 로봇 제어 능력을 동일시하지 않는다. | Atlas: 선택 파트너 early access. Marble 제품·API와 구분. | Atlas 공식 발표 |
| Meta FAIR | V-JEPA 2 / 2-AC: 2025 V-JEPA 2.1: 2026-03 | 잠재 표현 예측형 월드 모델 | 픽셀을 매번 생성하기보다 추상적 표현을 예측한다. 2-AC는 행동 조건부 예측·계획을, 2.1은 표현 학습의 발전을 읽는 자료로 구분한다. | V-JEPA 계열 코드·체크포인트 공개. 모델·작업별 배포 확인. | Meta V-JEPA V-JEPA 2.1 |
| Google DeepMind — Genie | Genie 3 2025-08-05 Project Genie | 상호작용형 월드 모델 | 사용자 입력에 반응하는 환경을 생성한다. Genie는 월드 모델 계열이고, Gemini Robotics는 로봇 정책·추론 계열이다. | 공식 연구 발표·프로토타입. 공개 가중치 미확인. | Genie 3 발표 모델 페이지 |
| AMI Labs | 월드 모델·기억·계획 연구 특정 공개 모델명 미확인 | 추상 표현 기반 월드 모델 연구 | 행동의 결과를 예측하고 기억·추론·계획에 연결하는 방향. Yann LeCun이 참여하는 AMI Labs와 Meta의 공개 V-JEPA 모델은 기관·결과물 차원에서 구분한다. | 연구 방향·팀 공개. 이 표에서 확정할 모델·체크포인트는 미확인. | AMI Labs 공식 사이트 |
| Runway | GWM Worlds 2 2026-09-03 | 실시간 영상·오디오 월드 모델 | 카메라 이동과 텍스트 행동·사건에 반응하는 지속적 세계 생성. 로봇 관절 제어보다 상호작용 환경 생성에 가까운 공개 사례다. | 연구 발표·프리뷰. 공개 가중치 미확인. | GWM Worlds 2 |
| Microsoft Research | Muse / WHAM / WHAMM 2025 대표 연구 | 게임 환경의 월드·행동 모델 | 게임 화면과 컨트롤러 입력을 모델링하고 상호작용 환경을 생성한다. 여기서의 action은 게임 행동이며, 곧바로 실제 로봇 토크를 뜻하지 않는다. | 초기 WHAM 가중치·샘플 데이터·도구 공개. 후속 모델별 제공 범위 구분. | Muse / WHAM WHAMM |
| Odyssey | Odyssey-2 Max / Agora-1 2026 | 상호작용형·다중 에이전트 월드 모델 | 연속적인 세계 변화와 에이전트 상호작용을 생성하는 방향. 범용 로봇 정책보다는 학습된 환경·시뮬레이션 관점에서 볼 기업. | 공식 연구 소개·프리뷰. 버전별 API·접근 조건을 별도로 확인. | Odyssey-2 Max Agora-1 |
| Wayve | GAIA-3 2025-12-02 | 자율주행 월드 모델 | 주행 장면·조건을 생성해 자율주행 시스템을 평가한다. 실제 운전 정책과 그 정책을 시험하는 월드 모델의 역할 차이를 볼 사례. | 공식 기술 보고. 공개 가중치 미확인. | GAIA-3 |
| Waabi | Waabi World Waabi Driver: 별도 운전 시스템 | 학습 기반 자율주행 시뮬레이션 | 현실적인 가상 주행 상황을 만들어 정책을 시험하고 개발한다. 학습된 시뮬레이터의 현실 일치도와 평가 신뢰성이 핵심이다. | 기업 개발 플랫폼·연구 공개. 범용 공개 시뮬레이터와 구분. | 시뮬레이터 연구 설명 |
| Robotics and AI Institute | ParticleFormer: 2025 Real-is-Sim: 2026 | 3D 월드 모델 / 동적 디지털 트윈 | 물체·재질의 변화를 3D 표현으로 예측하거나 실제 상태와 연결된 디지털 트윈을 활용한다. 변형체·접촉·sim-to-real 연구에 특히 연결되는 방향. | 논문·공식 프로젝트 정보 공개. | ParticleFormer Real-is-Sim |
11-3. 대학 연구실과 공개 연구 — 알고리즘을 공부할 때 따라갈 계보
아래 연구는 여러 기관의 공동 결과인 경우가 많다. 한 연구실의 단독 소유 모델이라는 뜻이 아니라, 논문을 따라가며 만날 핵심 연구 그룹을 정리한 것이다.
| 대학·연구 그룹 | 대표 연구·프로젝트 | 계열 | 공부할 포인트 | 공개·실습 상태 | 1차 출처 |
|---|---|---|---|---|---|
| UC Berkeley — RAIL / BAIR 관련 연구진 Sergey Levine | Octo / OpenVLA 2024, 공동연구 | 범용 로봇 정책 / VLA | 다양한 로봇 데이터를 함께 학습하고 새 로봇으로 전이한다. Octo의 diffusion 정책과 OpenVLA의 VLM 기반 행동 예측을 비교하면 좋다. | 코드·가중치·학습 경로 공개. | Octo OpenVLA |
| Stanford — IRIS Lab Chelsea Finn | ACT / ALOHA: 2023 Mobile ALOHA: 2024 OpenVLA 공동연구 | 모방학습 / 행동 청크 / VLA | 시범 데이터에서 행동 시퀀스를 배우는 기본 구조. ACT는 알고리즘, ALOHA는 데이터 수집·로봇 시스템이다. PI와 연구진이 겹쳐도 대학 연구실 자체는 별도 기관. | 논문·코드·하드웨어 설계 공개. | IRIS Lab Mobile ALOHA OpenVLA |
| Stanford — REAL Lab 및 Columbia 공동연구 계보 Shuran Song | Diffusion Policy: 2023 UMI: 2024 | 생성형 행동 정책 / 인간 시범 데이터 | 행동을 diffusion으로 생성하는 방법과, 로봇 밖에서 수집한 인간 조작 데이터를 정책 학습으로 연결하는 방법. Diffusion을 쓴다고 모두 월드 모델인 것은 아니다. | 코드·수집 장치 설계·학습 안내 공개. | Diffusion Policy UMI REAL Lab |
| MIT CSAIL — Improbable AI 및 공동연구팀 | RialTo 2024 | Real-to-Sim-to-Real / RL | 실제 환경을 가상 환경으로 옮기고 정책을 강화한 뒤 다시 실제 로봇으로 전이한다. 시뮬레이션 배경을 로봇 학습과 연결하기 좋은 연구. | 논문·프로젝트 소개 공개. | MIT 공식 연구 소개 |
| UC San Diego — 로봇 학습 연구진 | TD-MPC2 2024 | 잠재 동역학 모델 + 계획 / 모델 기반 RL | 월드 모델이 예측한 결과를 이용해 행동을 고르는 고전적 model-based 접근을 이해하기 좋다. 반드시 영상 생성이나 거대 WFM을 요구하지 않는다. | 논문·코드·실험 자료 공개. | TD-MPC2 |
| CMU Robotics Institute + 공동연구팀 | RoboAgent 2023–2024 | 범용 모방학습 / 다중 작업 정책 | 시각적 일반화와 행동 청크 학습을 결합해 다양한 조작 기술을 배운다. 거대 VLA 이전·주변의 정책 학습 계보를 이해할 사례. | 공개 프로젝트·코드·데이터 경로 제공. | RoboAgent |
| ETH Zurich — Robotic Systems Lab | 다리 로봇·전신 제어 연구 ANYmal 관련 연구 | 로봇 동역학 / 학습 기반 제어 | 언어 명령 이전에 필요한 균형·보행·접촉·실기체 제어를 연구한다. VLA/WAM이 로봇 전체 제어 문제를 자동으로 대체하는 것은 아님을 보여주는 연구 축. | 랩 논문·프로젝트 공개. 실습 자료는 개별 프로젝트별 확인. | RSL 공식 사이트 |
| NYU — 로봇 학습 연구진 | Dobb-E 2023–2024 | 가정 환경의 모방학습 / 정책 적응 | 실제 가정에서 시범 데이터를 수집하고 작업별 정책을 학습하는 공개 시스템. 데이터 수집 비용과 실환경 일반화 문제를 공부하기 좋다. | 코드·데이터·하드웨어 관련 자료 공개. | Dobb-E |
11-4. 로봇 하드웨어·시뮬레이터·개발 인프라 — 모델과 구분
| 기업·프로젝트 | 대표 제품·도구 | 종류 | VLA·WAM·WFM과의 관계 | 접근·공개 상태 | 1차 출처 |
|---|---|---|---|---|---|
| NVIDIA — Isaac / Omniverse | Isaac Sim / Isaac Lab | 물리 시뮬레이터 / 로봇 학습 도구 | 로봇·센서·환경을 구성하고 데이터를 만들거나 정책을 학습·검증한다. Isaac Sim은 예측을 학습한 WFM 자체가 아니며, Cosmos·GR00T와 역할이 다르다. | 개발 소프트웨어·문서 공개. 라이선스·시스템 요구사항 별도 확인. | Isaac Sim |
| Google DeepMind — MuJoCo | MuJoCo | 물리 시뮬레이션 엔진 | 운동·접촉 등 물리 법칙을 계산하는 실험 환경. 데이터에서 동역학을 배우는 월드 모델과 비교할 기준점. | 오픈소스 엔진·문서 공개. | MuJoCo |
| Genesis — 오픈소스 시뮬레이션 프로젝트 | Genesis simulation framework | 물리 시뮬레이션 / embodied AI 개발 도구 | 가상 환경에서 로봇과 물체의 상호작용을 계산한다. 위의 Genesis AI 기업·GENE 모델 항목과 이름만으로 동일시하지 말고, 각각의 공식 자료를 따라가야 한다. | 코드·개발 문서 공개. | Genesis 문서 |
| Tesla | Optimus | 휴머노이드 하드웨어 + AI 시스템 | Optimus는 로봇 제품·시스템 이름이다. 공개된 제품명만으로 내부 정책을 특정 VLA나 WAM 구조라고 단정하지 않는다. | 공식 기술 소개·데모. 범용 외부 정책 가중치 미확인. | Tesla AI |
| Unitree | G1 / H1 / Go2 등 | 휴머노이드·사족 로봇 플랫폼 | 연구자·기업이 학습 정책을 탑재하는 몸체와 개발 플랫폼. 같은 Unitree 로봇에도 서로 다른 기관의 정책이 올라갈 수 있다. | 제품·개발 자료 제공. 로봇 구매와 정책 모델 공개는 별개. | Unitree 공식 사이트 |
| Apptronik | Apollo 계열 | 휴머노이드 하드웨어·통합 시스템 | Gemini Robotics 파트너 생태계의 실제 로봇 플랫폼. 몸체를 만드는 회사와 범용 정책을 만드는 회사의 협업 사례. | 기업·파트너 중심 접근. 정책 모델 공개와 구분. | DeepMind의 파트너·로봇 설명 |
| Agility Robotics | Digit / Agility Arc | 물류 로봇 / 운영 플랫폼 | 실제 작업 배포와 여러 로봇의 운영을 담당하는 축. Digit은 몸체, Arc는 운영 플랫폼이며 둘 다 곧바로 WFM 모델명을 뜻하지 않는다. | 상용 제품·서비스 중심. | 공식 솔루션 |
11-5. 기반 언어·시각 모델 — 기존 메모의 Gemma·GPT 위치
이 표는 최신 범용 모델 순위를 정하려는 것이 아니라, 로봇 모델 안에서 쓰이는 기반 모델의 역할을 구분하기 위한 것이다.
| 개발 기관 | 모델 계열 | 종류 | 정확한 위치 | 공개·접근 | 1차 출처 |
|---|---|---|---|---|---|
| Gemma / PaliGemma | 언어·멀티모달 모델 계열 / VLM | Gemma를 단순히 ‘Vision Transformer’라고 쓰면 부정확하다. PaliGemma 같은 VLM을 기반으로 별도의 행동 생성 모듈을 연결할 수 있다. ViT는 시각 인코더의 구조를 가리키는 별도 개념. | 공개 가중치·문서. 모델별 라이선스와 지원 모달리티 확인. | Gemma PaliGemma | |
| OpenAI | GPT 계열 GPT-4o는 멀티모달의 과거 대표 사례 | 언어·멀티모달 기반 모델 | GPT 계열 전체를 텍스트 전용 모델이라고 볼 수는 없다. 다만 범용 멀티모달 능력과 로봇 관절·토크를 출력하는 제어 정책은 다른 역할이다. | API·서비스 중심. 로봇 정책 체크포인트와 별도 분류. | GPT-4o 시스템 카드 |
마지막 정리 — 이 표에서 읽어야 할 흐름
① VLA → WAM → WFM이라는 일방향 세대교체가 아니다. VLA 정책의 발전, 비디오·월드 모델 기반 행동 학습, 범용 세계 표현·예측이 병행되고 서로 결합한다. PI π₀.₇과 NVIDIA WAM 해설을 비교해서 읽자.
② WAM도 하나의 고정된 구조가 아니다. DreamZero의 공동 모델링, 1XWM의 영상→IDM→행동, Fast-WAM의 영상 생성 없는 추론처럼 학습·실행 방식이 다르다. 따라서 ‘미래 영상을 언제나 그리면서 행동한다’는 정의는 너무 좁다. DreamZero · 1XWM · Fast-WAM
③ 모델·몸체·환경·도구를 분리해서 외우자. GR00T는 정책, Cosmos는 월드 모델 계열, Isaac Sim은 시뮬레이터다. World Labs의 Atlas는 모델이고 Boston Dynamics의 Atlas는 로봇이다. GR00T · Cosmos · Isaac Sim · World Labs Atlas · Boston Dynamics Atlas
④ 공부 순서 제안: 이미 본 π₀로 VLA 구조를 정리한 뒤, DreamZero와 1XWM으로 WAM 설계를 비교하고, V-JEPA·Cosmos·Atlas로 서로 다른 월드 모델의 출력·표현을 비교한다. 실습 후보는 공개 자료가 있는 openpi·OpenVLA·SmolVLA·Diffusion Policy에서 고르고, 시뮬레이션 연결은 Isaac Sim·MuJoCo·RialTo를 따로 공부한다. 이는 위 표를 활용하기 위한 학습 순서 제안이지 성능 순위가 아니다.