
Liquid AI - LFM2 Paper Review
Liquid AI의 LFM2는 Attention을 그대로 줄이는 대신, edge hardware에서 직접 측정하며 GQA와 Short Convolution을 섞은 backbone을 찾았다. Architecture, Training, Inference, Evaluation과 on-device LLM의 memory 이야기를 정리한다.
Reference
LFM2 Technical Report — Liquid AI
Introduction
지난주 샌프란시스코에서 Long Horizon Agents Hackathon에 참여했다. 비록 수상은 못했지만, 그때 처음 제대로 알게 된 회사가 Liquid AI였다.
Liquid는 한마디로 말하면 작고 빠른 on-device foundation model을 만드는 회사다. Cloud GPU에 의존하는 대신, smartphone·laptop·embedded device 안에서 직접 AI를 돌리는 것을 강하게 밀고 있다.
그래서 이번 글에서는 Liquid의 핵심 모델인 LFM2를 보면서,
“왜 굳이 Transformer의 Attention 구조를 바꾸려고 했고, 어떻게 local device에서 더 빠르게 만들었는가?”
를 중심으로 살펴보려고 한다.
LFM2도 Qwen이나 Llama 계열처럼 local deployment가 가능한 open-weight LLM이지만, 차이는 처음부터
- edge hardware latency
- memory constraint
를 architecture 설계에 넣었다는 점이다.
Liquid는 Snapdragon 같은 embedded SoC CPU에서 실제 latency와 memory usage를 측정하면서 architecture를 찾았다.
(쉽게말하면, 핸드폰 구속조건을 미리 만들어주고, “그 안에서 최적을 찾아” 라고 실험을 진행한 것이다.)
즉 단순히 “작은 Transformer”를 만든 것이 아니라,
“Transformer를 그대로 줄이는 대신, local hardware에 더 잘 맞는 backbone을 다시 설계해보자.”
라는 접근이다.
자 지금부터, paper의 architecture부터 하나씩 뜯어보자.
Contents
- Architecture
- Training
- Inference
- Evaluation
- My thoughts
Architecture
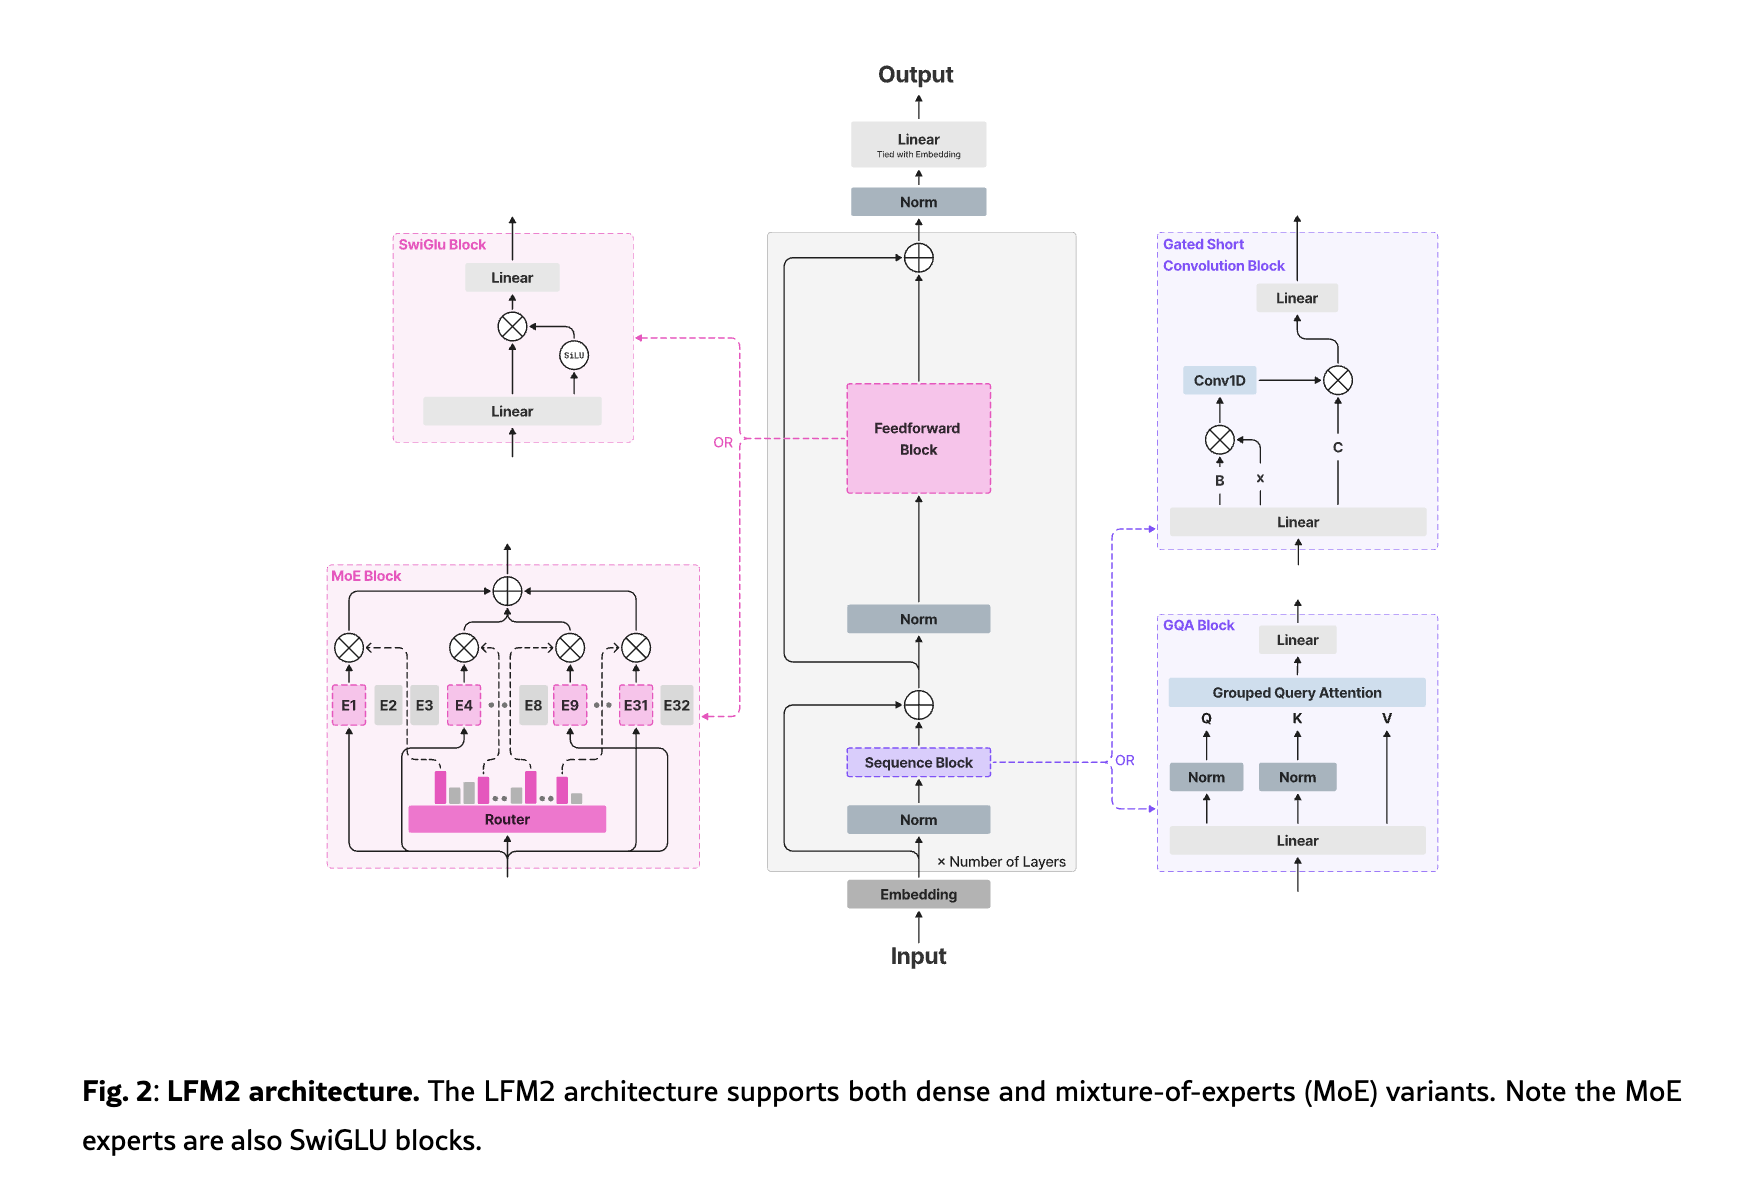
일단 architecture diagram부터 보자.
처음 보면 눈에 띄는 것이 두 개의 or이다.
1
2
3
4
5
Sequence Mixing
GQA  or  SCB

Feed Forward
SwiGLU  or  MoE
즉 모든 layer가 똑같은 Transformer block으로 구성된 것이 아니다.
첫 번째 선택은 token들 사이의 정보를 어떻게 섞을 것인가이다.
- GQA: 멀리 있는 token까지 보는 global Attention
- SCB: 주변 token을 빠르게 처리하는 Short Convolution
두 번째 선택은 각 token representation을 어떻게 변환할 것인가이다.
- SwiGLU: 일반적인 dense Feed Forward Network
- MoE: 일부 expert만 활성화하는 sparse Feed Forward Network
이 중 LFM2 architecture의 가장 중요한 novelty는 첫 번째인 GQA + SCB hybrid structure이다.
하나씩 살펴보자.
GQA
GQA는 Grouped Query Attention이다.
일반적인 Multi-Head Attention에서는 아래 그림 맨 왼쪽에서처럼 각 Query head가 자기 Key/Value head를 따로 가진다.
1
2
3
4
Q1 → K1, V1
Q2 → K2, V2
Q3 → K3, V3
Q4 → K4, V4
문제는 inference 때 이전 token들의 K/V를 계속 저장해야 해서 KV Cache가 커진다는 것이다.
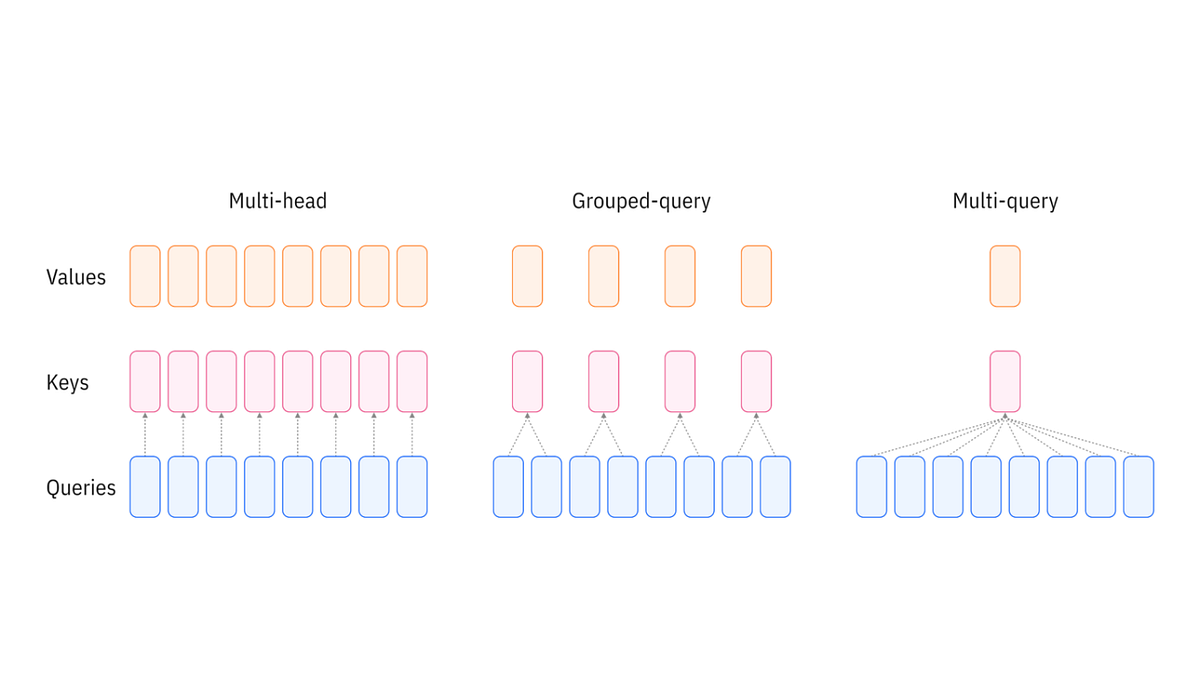
따라서, GQA는 여러 Query가 같은 Key/Value를 공유한다.
1
2
3
4
5
Q1 ┐
Q2 ┘ → K1, V1

Q3 ┐
Q4 ┘ → K2, V2
따라서 Attention의 global-context 능력은 유지하면서 저장해야 할 K/V 양을 줄일 수 있다.
GQA = Attention은 유지하되 KV Cache와 memory bandwidth 비용을 줄이는 방법
SCB
SCB는 Short Convolution Block이다. 여기가 LFM2에서 가장 중요한 부분이다.
(우리가 Convolutional block 하면 Image detection → CNN 이 바로 생각날 것이다. 똑같은 개념이다. 그러니까, 결국에 CNN에서 어떤 patch 안에서 Convolution 연산을 통해서 하나의 값으로 변환하였다. 똑같이 1 Dimensional 로 적용하는것이 바로 Short Convolution block에서 우리의 연산이다.)
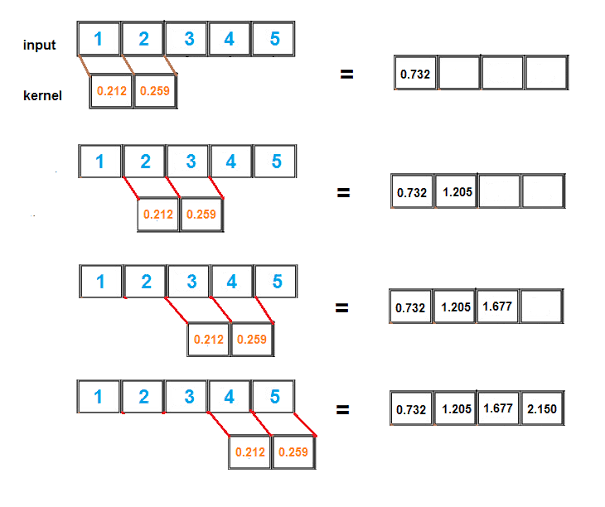
Attention은 현재 token이 필요하면 멀리 떨어진 token까지 볼 수 있다. 반면 Short Convolution은 위 사진에서 우리가 보는 것처럼 kernel의 길이만큼을 현재 token 주변으로 연산을 진행하기 떄문에, 짧은 local pattern을 extraction하는 역할을 하는 것이다.
1
2
Local information  → Short Convolution
Global information → GQA
즉 Liquid는 모든 layer에서 expensive global attention을 쓰는 대신, 가까운 정보는 convolution으로 싸게 처리하고 정말 긴 거리 dependency가 필요할 때만 GQA를 사용한다.
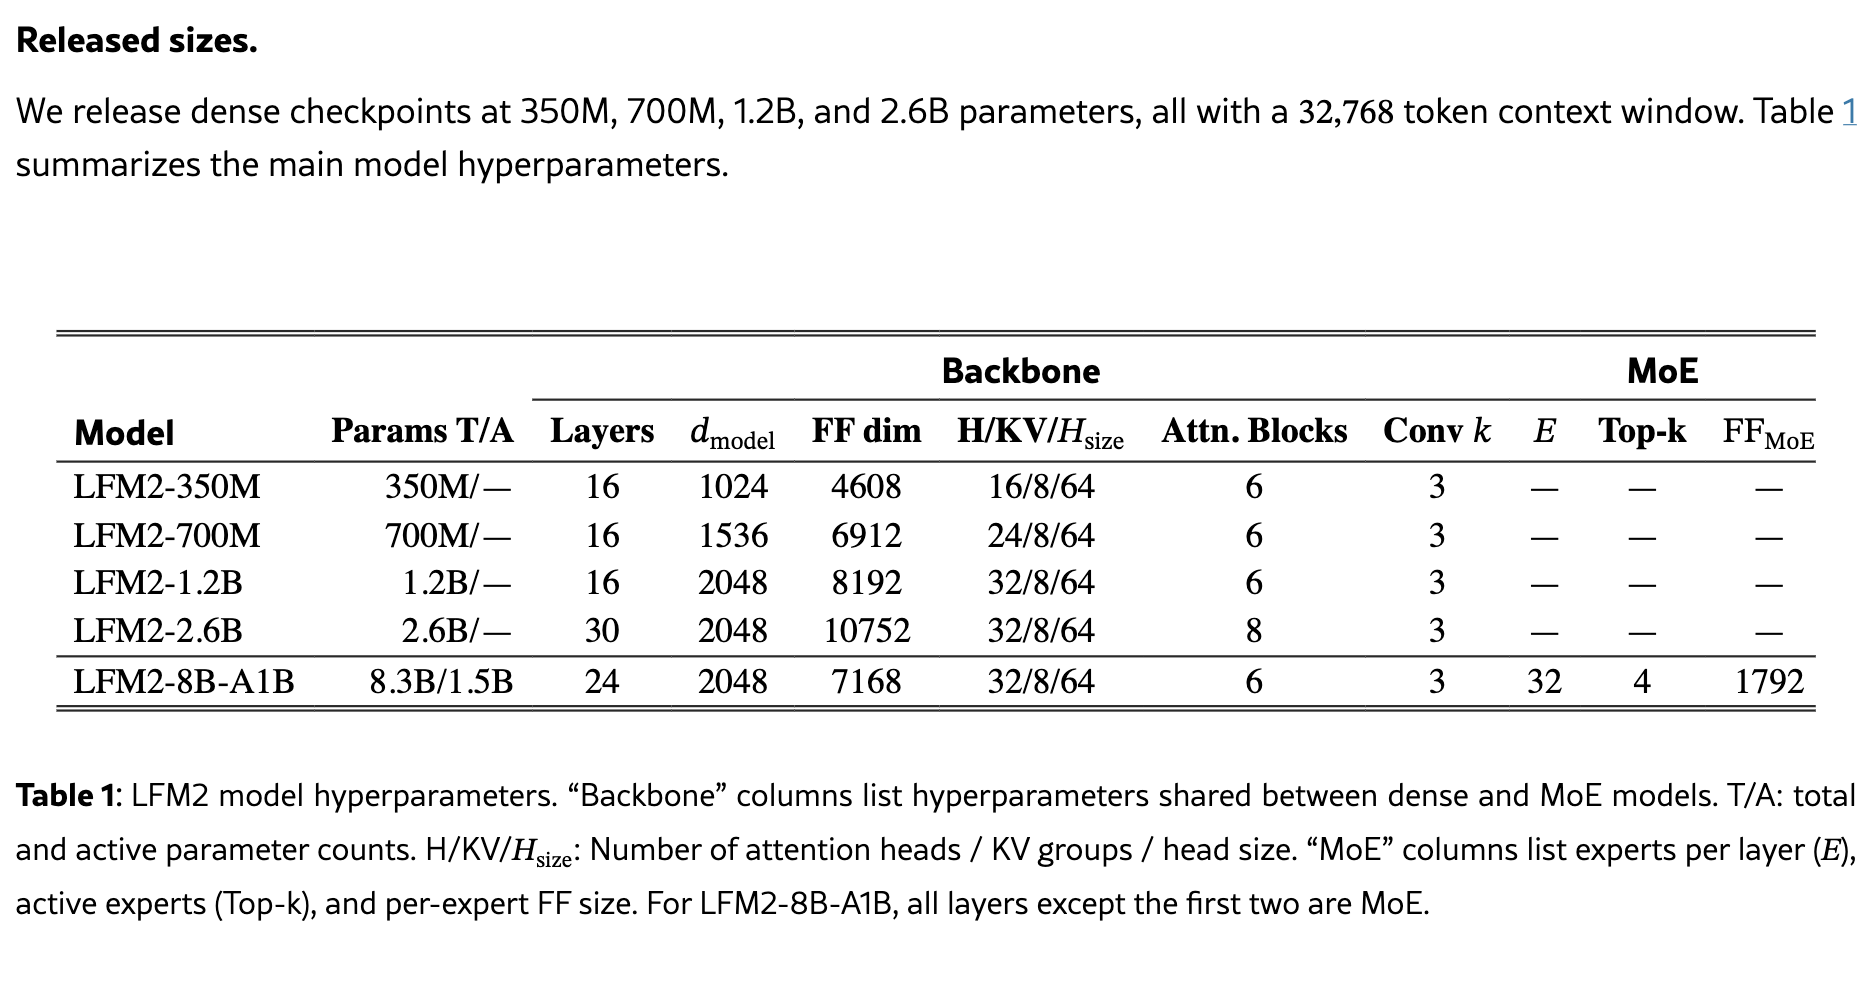
대표적인 LFM2 backbone은 총 16개의 sequence-mixing block 중
- 10개가 gated short convolution,
- 6개가 GQA
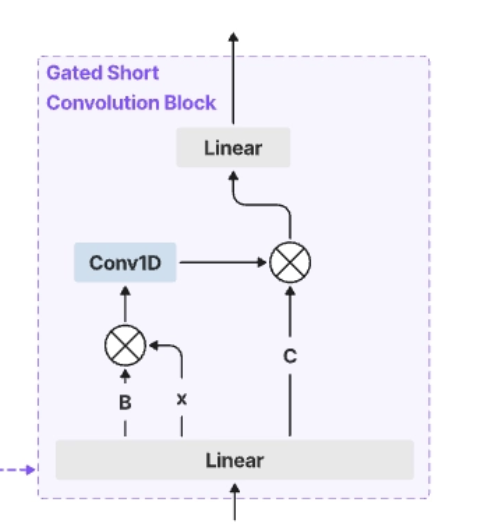
Short convolution 앞뒤에는 input-dependent gate가 붙는다. (어떤 특징을 얼마나 내보낼지, 이것도 학습하는것.
1
2
3
4
5
6
7
8
9
10
11
Input
 ↓
Linear
 ↓
Gate
 ↓
Short Convolution
 ↓
Gate
 ↓
Linear
핵심은 Convolution이 Attention보다 무조건 좋다는 것이 아니다. Local information은 convolution으로 싸게 처리하고, global information은 attention으로 처리하도록 역할을 나눈 것이 핵심이다.
MoE
MoE는 Mixture of Experts이다. 모든 LFM2 모델에 들어가는 것은 아니고, LFM2-8B-A1B 같은 sparse model에서 사용한다.
Dense FFN에서는 모든 token이 같은 큰 Feed Forward Network를 통과하지만, MoE에서는 여러 expert를 준비해두고 token마다 일부 expert만 선택한다.
1
2
3
4
5
Token
 ↓
Router
 ↓
Expert 3 + Expert 7 등 일부만 활성화
예를 들어 LFM2-8B-A1B는 총 parameter는 약 8.3B지만 한 token을 처리할 때 active parameter는 약 1.5B 수준이다.
큰 model capacity는 가지되, 매번 전체 parameter를 계산하지 않는 방식
이라고 이해하면 된다.
SwiGLU
SwiGLU는 Transformer 계열에서 많이 쓰이는 Feed Forward Network activation 구조이다.
GQA나 SCB가 token들 사이의 정보를 섞는 역할이라면, SwiGLU FFN은 각 token representation 자체를 비선형적으로 변환하는 역할을 한다.
1
2
3
4
5
Sequence Mixing
GQA or SCB
      ↓
Feed Forward
SwiGLU
즉 LFM2의 novelty는 SwiGLU 자체보다는 GQA와 Short Convolution을 어떻게 섞었는가에 더 가깝다.
Hardware-in-the-loop Architecture Search
그렇다면 왜 하필 10개의 SCB와 6개의 GQA일까?
Liquid는 architecture를 먼저 만든 뒤 마지막에 hardware benchmark를 한 것이 아니라, 처음부터 실제 target hardware에서 여러 구조를 돌려보면서 architecture를 찾았다.
1
2
3
4
5
6
7
8
9
Candidate Architecture
        ↓
실제 Edge CPU에서 실행
        ↓
Latency / Memory / Quality 측정
        ↓
Architecture 수정
        ↓
다시 실행
이를 hardware-in-the-loop architecture search라고 부른다.
즉 목표는 단순히 FLOPs가 적은 모델이 아니라,
실제 phone, laptop, embedded CPU에서 빠르게 동작하는 foundation model
이었다.
Training
Architecture가 효율적이라고 해서 모델이 자동으로 똑똑해지는 것은 아니다. LFM2는 작은 parameter 수에서 성능을 최대한 끌어올리기 위해 training 쪽에도 여러 최적화를 넣었다.
1. Pretraining + Knowledge Distillation
LFM2 계열은 대략 10~12T tokens 규모로 pretraining되었다.
여기서 Liquid는 단순 next-token prediction뿐 아니라 Knowledge Distillation을 적극적으로 사용한다.
쉽게 말하면 큰 teacher model이
“이 context에서는 다음 token들의 probability를 이렇게 생각한다.”
라는 richer signal을 주고, 작은 LFM2가 이를 따라 배우도록 하는 것이다.
1
2
3
4
5
6
7
Training Text
    ↓
Teacher Model
    ↓
Soft probability distribution
    ↓
LFM2 Student
정답 token 하나만 알려주는 것보다, teacher의 전체적인 판단 즉 확률까지 전달할 수 있기 때문에 작은 모델이 제한된 parameter를 더 효율적으로 사용할 수 있다.
이게 가능한 이유는 우리가 이미 성능이 좋은 모델을 가지고 있고, 적은 파라메터 모델을 여기서 학습시키고 있기 때문이다
2. Curriculum Learning
Training data를 완전히 무작위로만 던지는 것이 아니라 difficulty를 고려해 순서를 조절한다.
1
2
3
4
5
쉬운 data
 ↓
중간 난이도
 ↓
어려운 data
사람이 쉬운 문제부터 어려운 문제로 가는 것과 비슷한 아이디어이다.
3. Post-training
Pretraining 이후에는 모델을 실제 assistant처럼 만들기 위해 post-training을 수행한다.
1
2
3
4
5
6
7
Pretraining
    ↓
SFT
    ↓
Preference Optimization
    ↓
Model Merging
SFT에서는 instruction following, coding, RAG, function calling 같은 downstream task를 학습하고, 그 다음 preference optimization을 통해 여러 답변 중 어떤 답변이 더 좋은지를 학습한다.
Pretraining에서 세상을 배우고, Post-training에서 사람의 instruction을 따르는 방법을 배운다.
이거는 이제 로봇학습하는거랑 똑같다, 일단 egocentric data를 가지고 세상을 전체적으로 이해하고, 이제 post training에서는 로봇이 특정한 테스크를 이제 직접 수행할 수 있도록 관련된 데이터로 학습시키는 것)
Inference
LFM2 inference의 핵심은 단순하다.
Attention layer 자체를 줄이고, 남은 Attention도
GQA로 만들어 memory access를 줄인다.
일반 Transformer에서는 sequence가 길어질수록 KV Cache가 커지고 token 하나를 생성할 때마다 memory에서 많은 데이터를 읽어야 한다. LFM2에서는 대부분의 sequence mixing을 short convolution이 담당하기 때문에 이 부담을 줄일 수 있다.
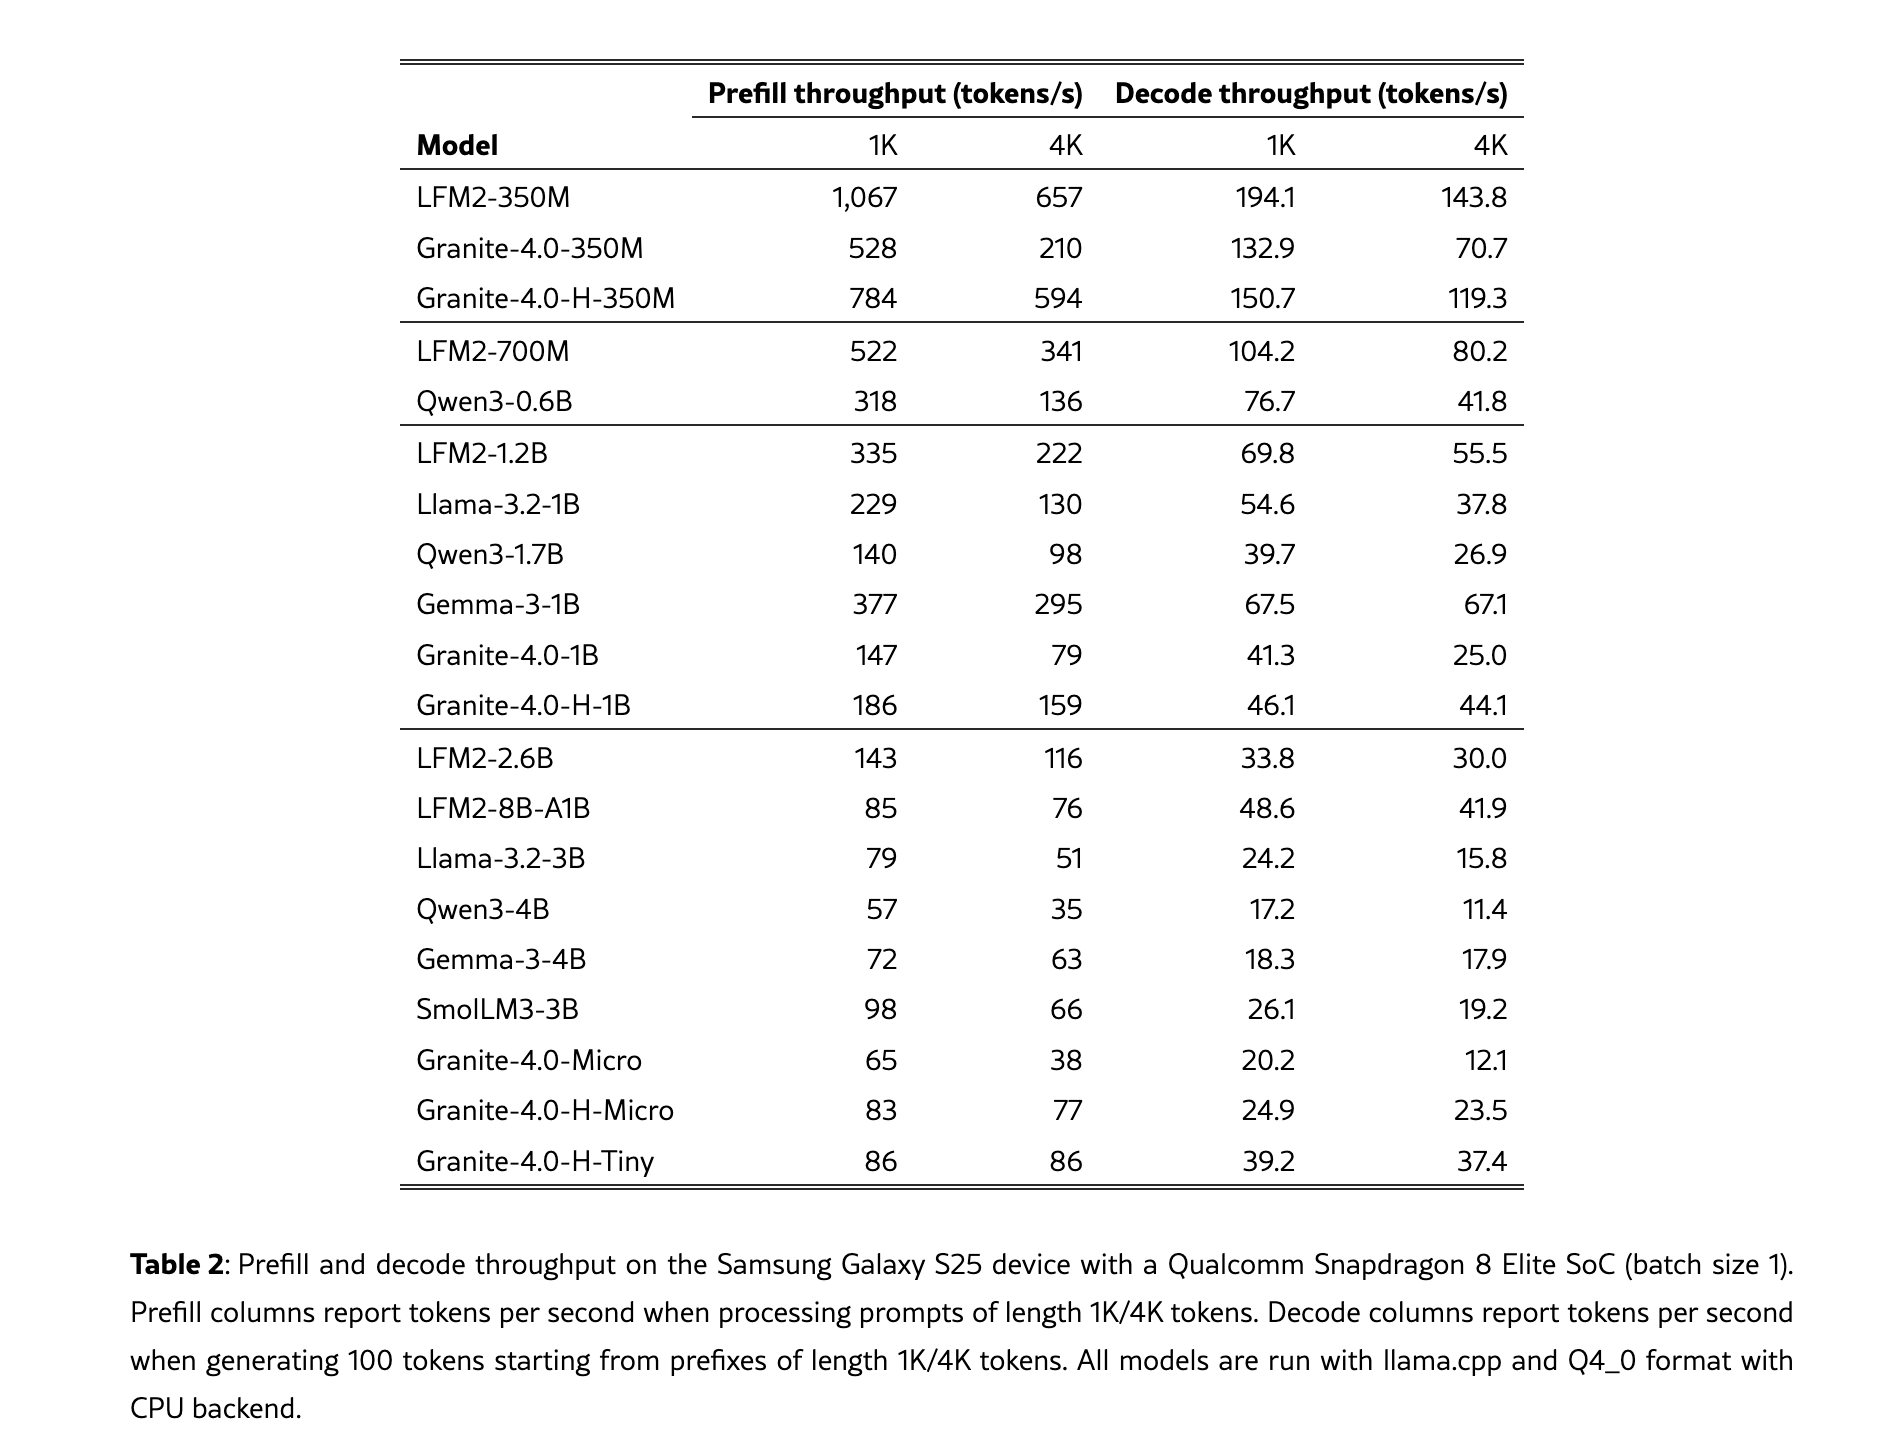
논문에서 발표한 위 테이블은 실제 삼성 갤럭시 S25 이바이스에서 이 로컬 LLM을 돌려보고 토큰 아웃풋 속도를 비교한 것이다. 여기서, Liquid는 비슷한 크기의 모델 대비 CPU에서 prefill과 decode 모두 최대 약 2× 빠른 결과를 보고했다.
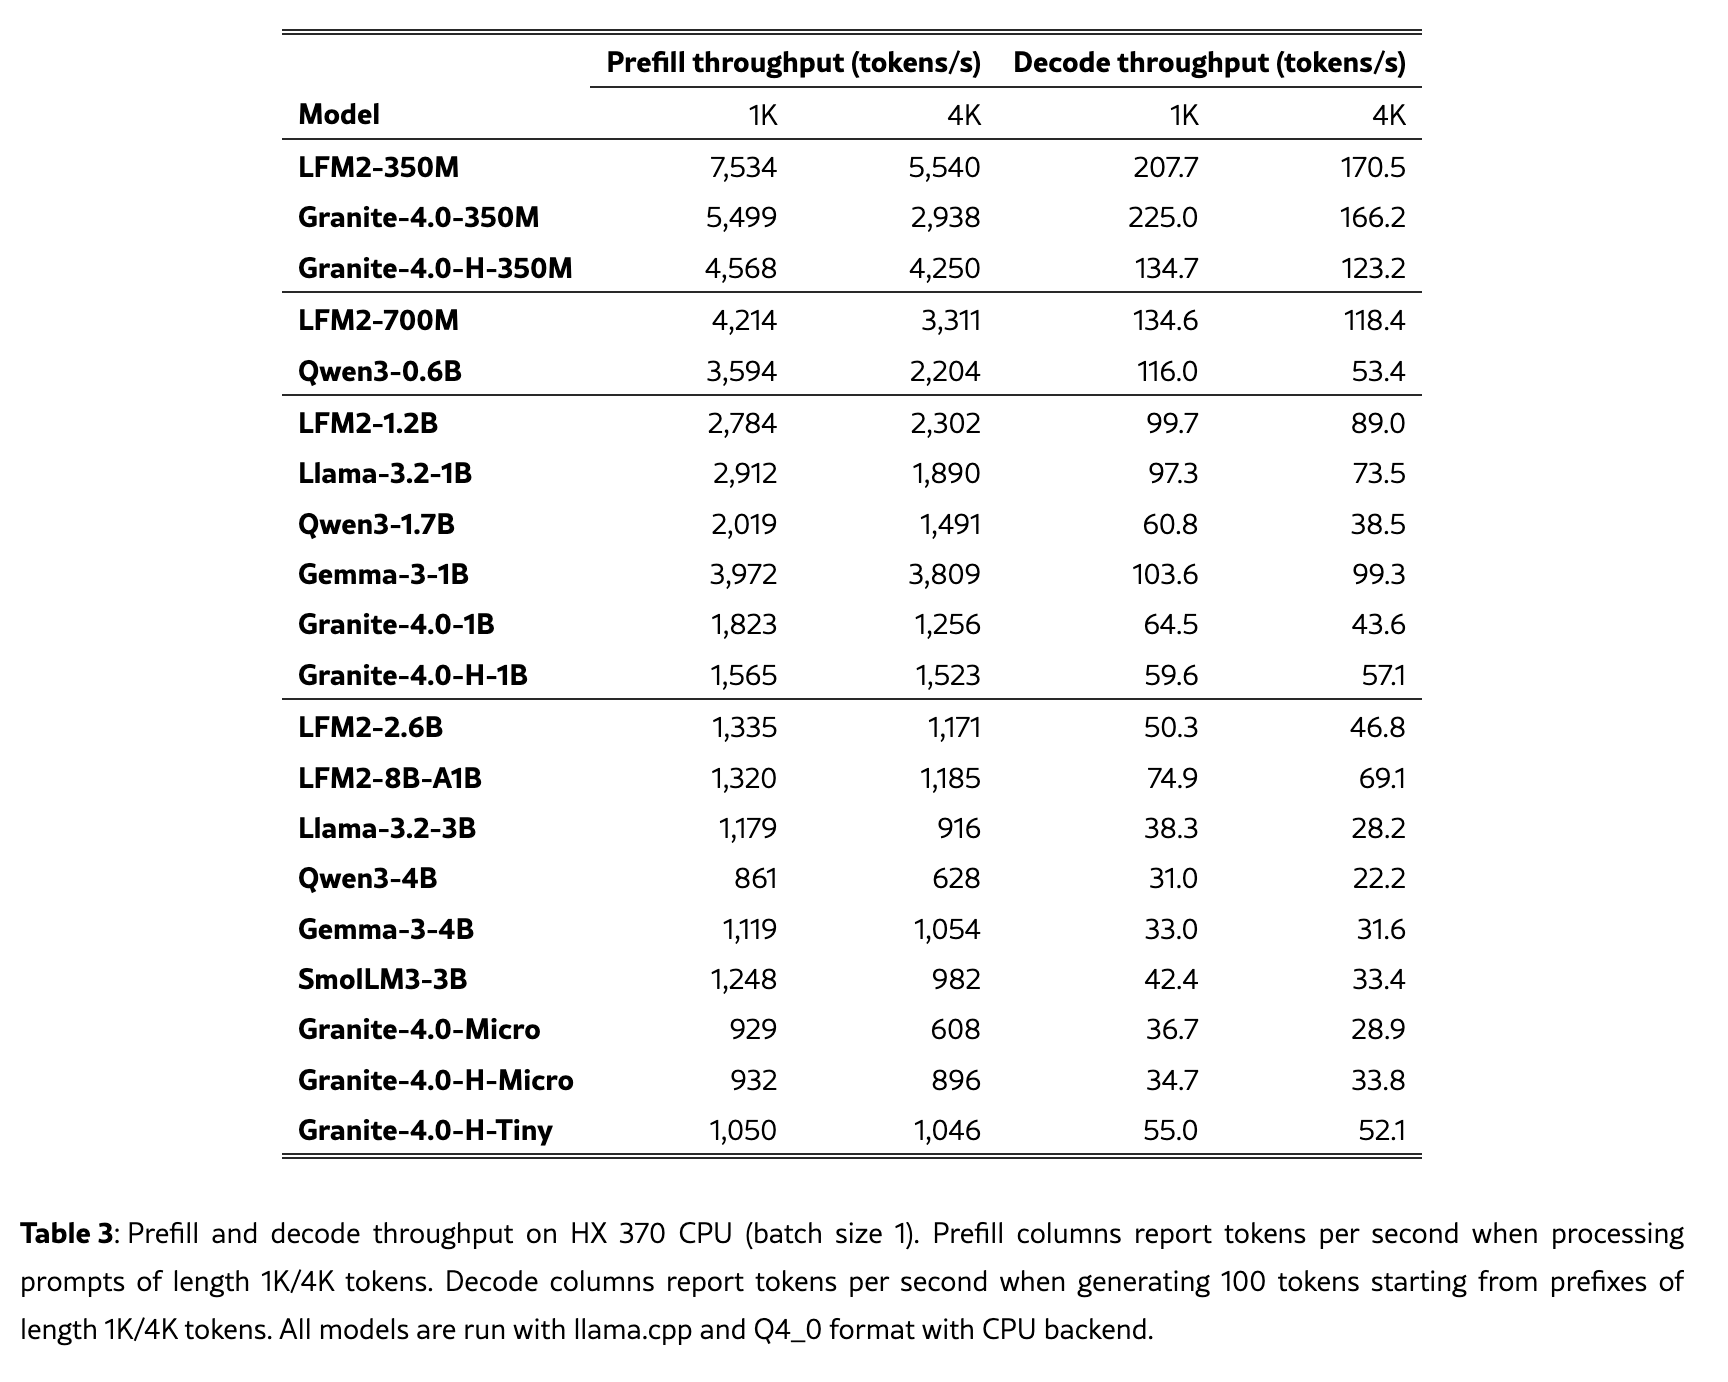
그 다음으로, 같은 실험을 이제 AMD RYZEN CPU 해서 한 결과도 다음과 같다.
Evaluation
LFM2는 350M부터 8B급까지 여러 크기로 공개되었고, 작은 parameter 수 대비 instruction following, reasoning, coding 등에서 경쟁력 있는 결과를 보여준다. 하지만 이 paper에서 내가 더 중요하게 본 것은 단순 benchmark 1등 여부가 아니다.
Liquid가 최적화하려는 목적 자체가 조금 다르기 때문이다.
1
2
3
4
5
6
7
8
기존 관점
Quality ↑

Liquid 관점
Quality ↑
+ Latency ↓
+ Memory ↓
+ 실제 Edge Hardware에서 실행 가능
즉 가장 똑똑한 모델이 아니라 device 안에서 실제로 쓸 수 있을 만큼 똑똑하면서 빠른 모델을 목표로 한다.
그래서 LFM2를 볼 때는 accuracy 하나보다 quality-latency trade-off를 같이 보는 것이 더 중요하다.
My thoughts
1. On-device LLM 의 핵심
일단 on-device LLM이 잘 돌아가려면 단순히 parameter 수를 줄이는 것보다, device가 감당해야 하는 memory와 data movement를 줄이고 latency를 낮추는 것이 핵심이다.
- Memory footprint 감소 → 모델 weight와 KV Cache가 device memory 안에 들어가야 한다.
- Memory bandwidth 사용량 감소 → 매 token마다 memory에서 너무 많은 데이터를 읽어오지 않아야 한다.
- Latency 감소 → 실제 사용자가 느끼는 응답 속도가 빨라야 한다.
즉 단순히 ‘가중치 개수가 적다’보다,
얼마나 적은 memory traffic으로 얼마나 빠르게 inference를 수행하느냐
가 더 중요한 문제이다.
2. LFM2가 효율화한 방식
- Multi-Head Attention → Grouped Query Attention
- 여러 Query head가 K, V를 공유한다.
- 따라서 KV Cache 크기와 memory bandwidth 사용량이 감소한다.
- 일부 Attention Block → Short Convolution Block
- 모든 layer에서 global attention을 수행하지 않고, local information은 convolution으로 처리한다.
- 따라서 Attention/KV Cache 의존성과 memory traffic, latency를 줄일 수 있다.
- Dense FFN vs MoE는 별도의 trade-off
- Dense LFM2에서는 SwiGLU FFN을 사용한다.
- 큰 sparse variant에서는 여러 SwiGLU expert를 둔 MoE를 사용해 전체 capacity는 크게 유지하면서 token당 active compute만 줄인다.
좋은 architecture를 만든 뒤 device에 올린 것이 아니라, device constraint 안에서 좋은 architecture를 찾았다
3. Running in CPU vs GPU vs NPU vs TPU — Memory는 어떻게 쓰이는가?
모델 weight는 어디에 올라가 있고, 계산할 때마다 어디서 가져오는가? 그리고 KV Cache 같은 cache는 그냥 RAM에 있는 것인가?
모델의 parameter는 inference 동안 계속 필요하다.
예를 들어 Linear layer가
1
Y = XW
를 계산하려면 weight matrix W를 매번 읽어야 한다.
CPU에서는 보통 weight가 system RAM에 있고, 계산 순간에는 일부가 CPU cache(L1/L2/L3)를 거쳐 core로 들어간다.
1
2
3
4
5
6
7
SSD
 ↓ model load
RAM
 ↓
CPU Cache
 ↓
CPU Core
GPU에서는 보통 weight를 VRAM에 올려둔다.
1
2
3
4
5
6
7
SSD / RAM
 ↓ model load
VRAM
 ↓
GPU on-chip cache / shared memory / registers
 ↓
GPU Compute Units
여기서 on-device LLM에서 memory bandwidth가 중요한 이유가 나온다.
모델이 2GB라고 하면 token 하나를 계산할 때마다 모든 2GB를 문자 그대로 통째로 복사한다는 뜻은 아니지만, 각 layer를 지날 때마다 상당한 양의 weight를 memory에서 읽어야 한다. 그래서 계산량이 작더라도 weight를 얼마나 빨리 공급하느냐가 bottleneck이 될 수 있다.
CPU Cache는 KV Cache와 다르다
여기서 이름 때문에 가장 헷갈리는 부분이 있다.
CPU Cache와 KV Cache는 완전히 다른 개념이다.
- CPU/GPU hardware cache: 자주 쓰는 데이터를 compute unit 가까이에 잠시 보관하는 hardware memory
- KV Cache: Transformer가 이전 token들의 Key/Value activation을 다음 token 생성에 재사용하기 위해 저장하는 모델-level data structure
KV Cache는 보통 RAM이나 VRAM 같은 main device memory 안에 존재한다.
1
2
3
4
5
VRAM
├─ Model Weights
├─ KV Cache
├─ Current Activations
└─ 기타 runtime buffer
즉 KV Cache라는 이름 때문에 CPU의 L3 cache 같은 것과 같은 것으로 보면 안 된다.
CPU vs GPU vs NPU vs TPU
아주 단순화하면 차이는 이렇다.
| Hardware | 주 메모리 | 강점 |
|---|---|---|
| CPU | System RAM | 범용성, 큰 memory 접근 |
| GPU | VRAM | 대규모 병렬 matrix 연산 |
| NPU | Unified/System Memory 또는 전용 memory | 저전력 AI inference |
| TPU | HBM 등 accelerator memory | 대규모 tensor 연산에 특화 |
핵심은 어느 hardware든 결국,
Weight와 KV Cache를 memory에 저장하고 → 필요한 데이터를 compute unit까지 계속 공급해야 한다.
는 점은 같다.
그래서 on-device LLM에서는 단순 FLOPs뿐 아니라 model size, KV Cache size, memory bandwidth, 그리고 data movement가 매우 중요하다.