
Helix 2.5 & Index: Zero-Shot 30-Home Generalization
Figure의 Helix 2.5는 대규모 human behavior dataset인 Index로 pretraining해서, 처음 보는 30개의 집에서 추가 학습 없이 일했다. 문제 정의, Index, 9% → 56% 결과, scaling law, 그리고 DYNA 2.1과의 차이를 정리한다.
Reference
Helix 2.5: Zero-Shot 30-Home Generalization
Introducing Index: Building The World’s Largest and Most Diverse Physical Dataset
Introducing Helix 02: Full-Body Autonomy
Introduction
Figure에서 새로운 Helix 2.5를 공개하였다.
기존 Helix 02가 보여준 것은 꽤 강력했다. 카메라 pixel을 입력으로 받아 locomotion + manipulation을 하나의 neural policy로 수행하면서, 식기세척기를 비우고 물건을 정리하는 것과 같은 long-horizon task를 수행하였다.
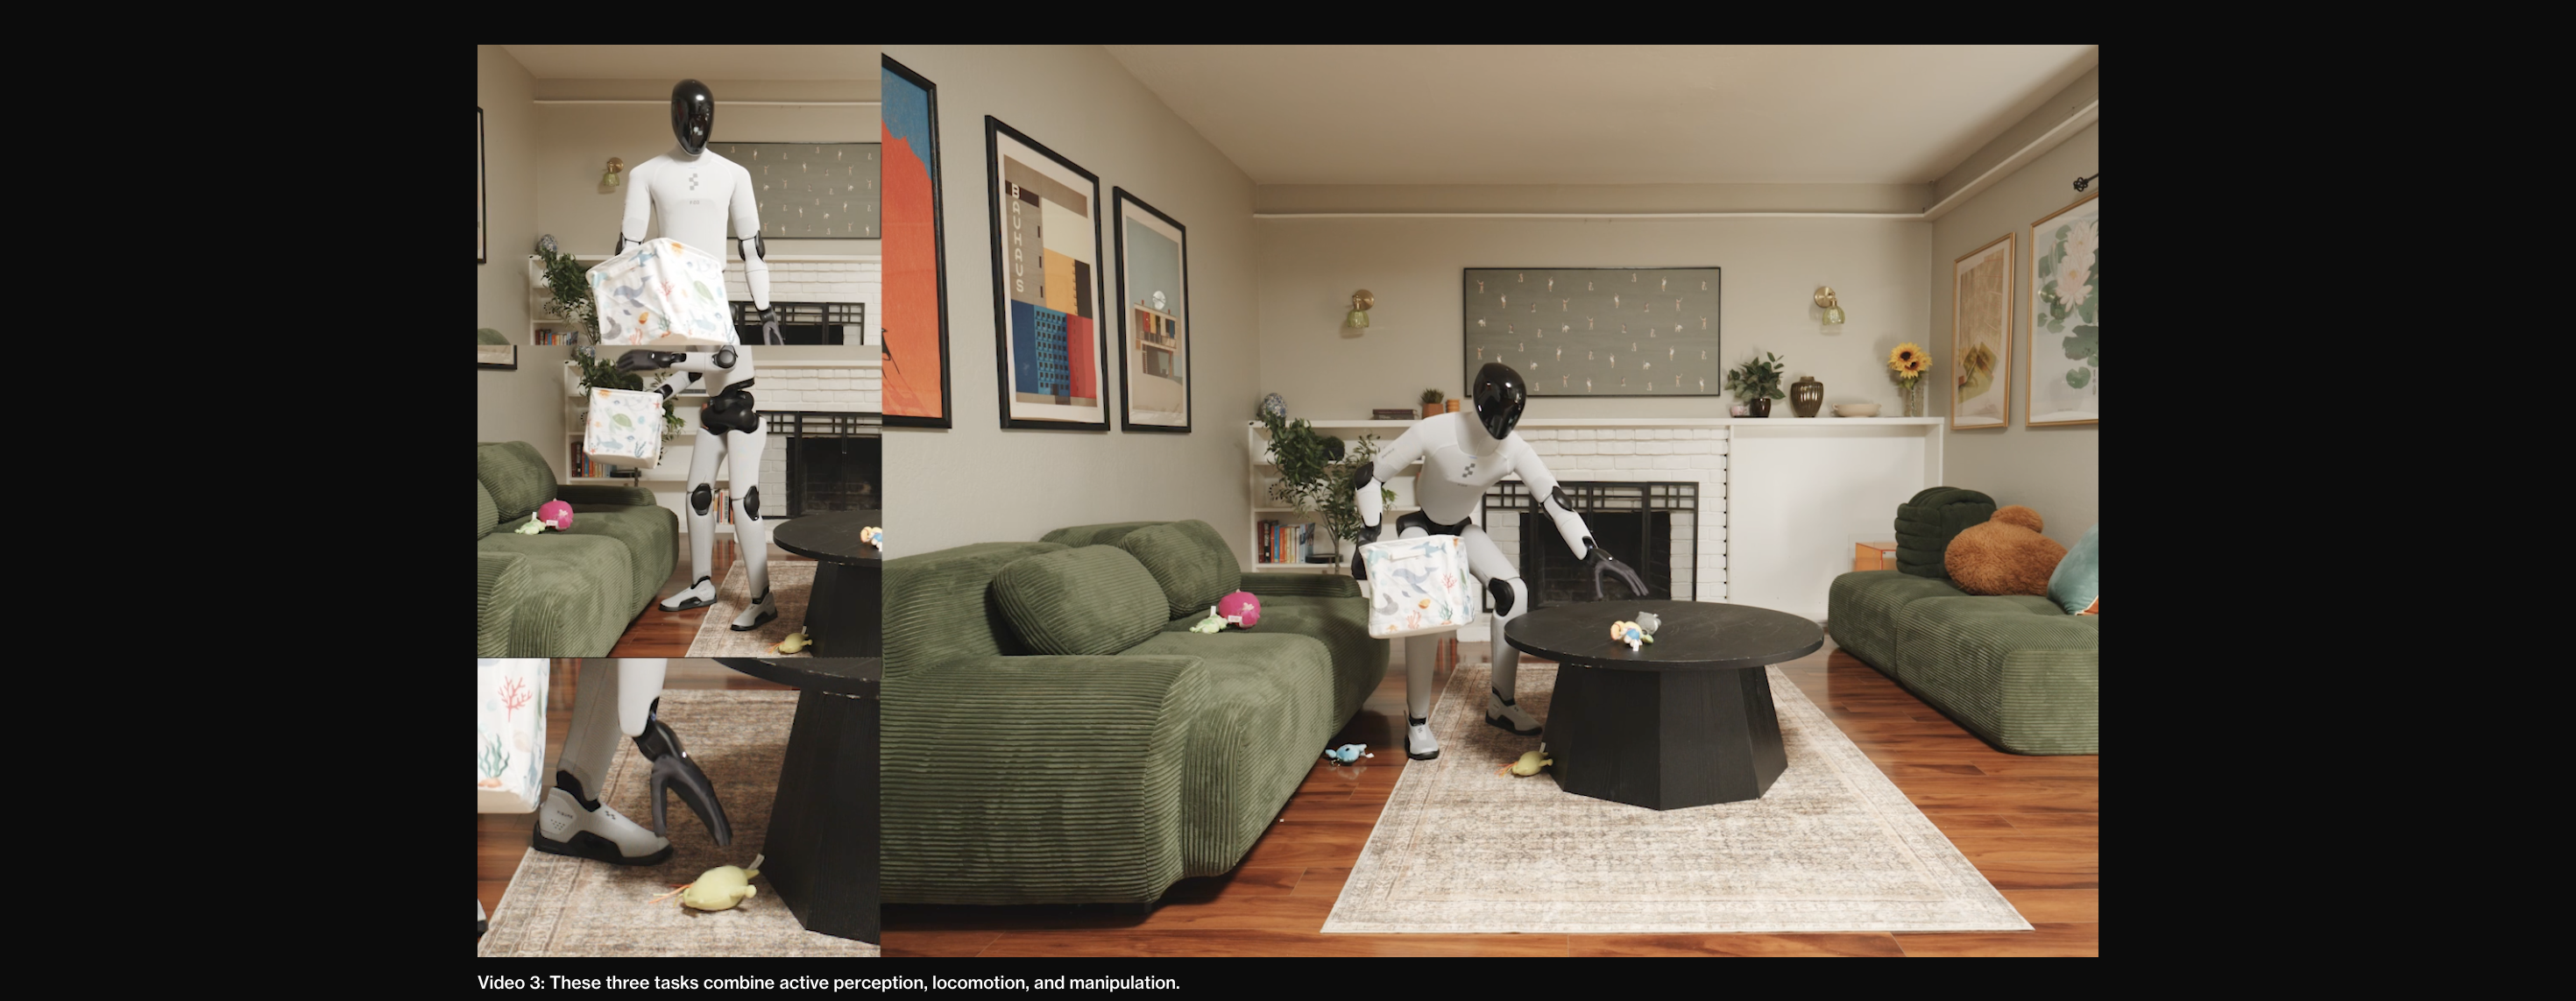
하지만 기존 방식에는 한 가지 큰 문제가 있었다.
Robot이 실제로 일할 환경에서 데이터를 다시 수집해야 했다.
즉, 집 A에서 잘 동작하도록 학습한 robot을 집 B로 옮겼을 때 다시 데이터를 모으고 fine-tuning해야 한다면, 수백만 개의 집에 robot을 배치하는 것은 현실적으로 어렵다.
Helix 2.5는 이 질문을 던진다.
“사람처럼, 처음 가본 집에서도 추가 학습 없이 바로 일을 할 수 있을까?”
Figure는 이를 위해 대규모 Human Behavior Dataset인 Index를 이용해 Helix 2.5를 pre-training하고, 처음 보는 30개의 실제 집에서 테스트하였다.
Contents
- Helix 2.5가 해결하려는 문제
- Index: Human Data Scaling
- Pretraining → Task Specification → Zero-shot Generalization
- Scaling Law
- DYNA 2.1, Skild 와의 차이.
1. 문제 정의: Environment-specific Data Collection
Helix 02 역시 whole-body autonomy를 보여주었지만, Figure가 밝힌 중요한 한계는 robot이 실제로 동작할 장소에서 데이터를 수집했다는 점이다.
For instance, whenever we need to sent the robot to a new house,
1
2
3
4
5
6
7
새로운 집
  ↓
Robot data collection
  ↓
Training / Fine-tuning
  ↓
Deployment
이 과정을 반복해야 한다면 scaling이 어렵다.
Helix 2.5의 목표는 이 단계를 없애는 것이다.
1
2
3
4
5
6
7
Massive Pretraining
      ↓
Task를 한 번 학습
      ↓
처음 보는 집 / 처음 보는 물체
      ↓
바로 실행
즉, 핵심은 Task Generalization이라기보다 Environment Generalization이다.
Figure가 말하는 zero-shot은 새로운 task를 설명만 듣고 바로 수행한다는 뜻이 아니다. (이게 Skild AI와의 차이, General Purpose Robotic Intelligence 추구하는 회사)
Tidying, towel folding, bed making이라는 behavior 자체는 task-specific data로 학습하지만, 평가에 사용한 30개의 집과 물체에서는 단 한 번도 데이터를 수집하거나 fine-tuning하지 않았다.
2. Index: Human Data Scaling
Helix 2.5에서 가장 중요한 것은 새로운 architecture보다 Index라는 Human Behavior Dataset이다.
Figure는 robot data만으로는 충분히 빠르게 scaling하기 어렵다고 판단하고, 전 세계 사람들이 실제 환경에서 수행하는 행동을 대규모로 수집하기 시작하였다. (여기서 재미있는게, 기존에는 Data vendor 업체들로부터, 데이터를 구매하였지만, 신뢰도, 데이터 퀄리티, 등등의 문제로 Figure회사가 직접 수집하는 플랫폼을 제작하였다.)
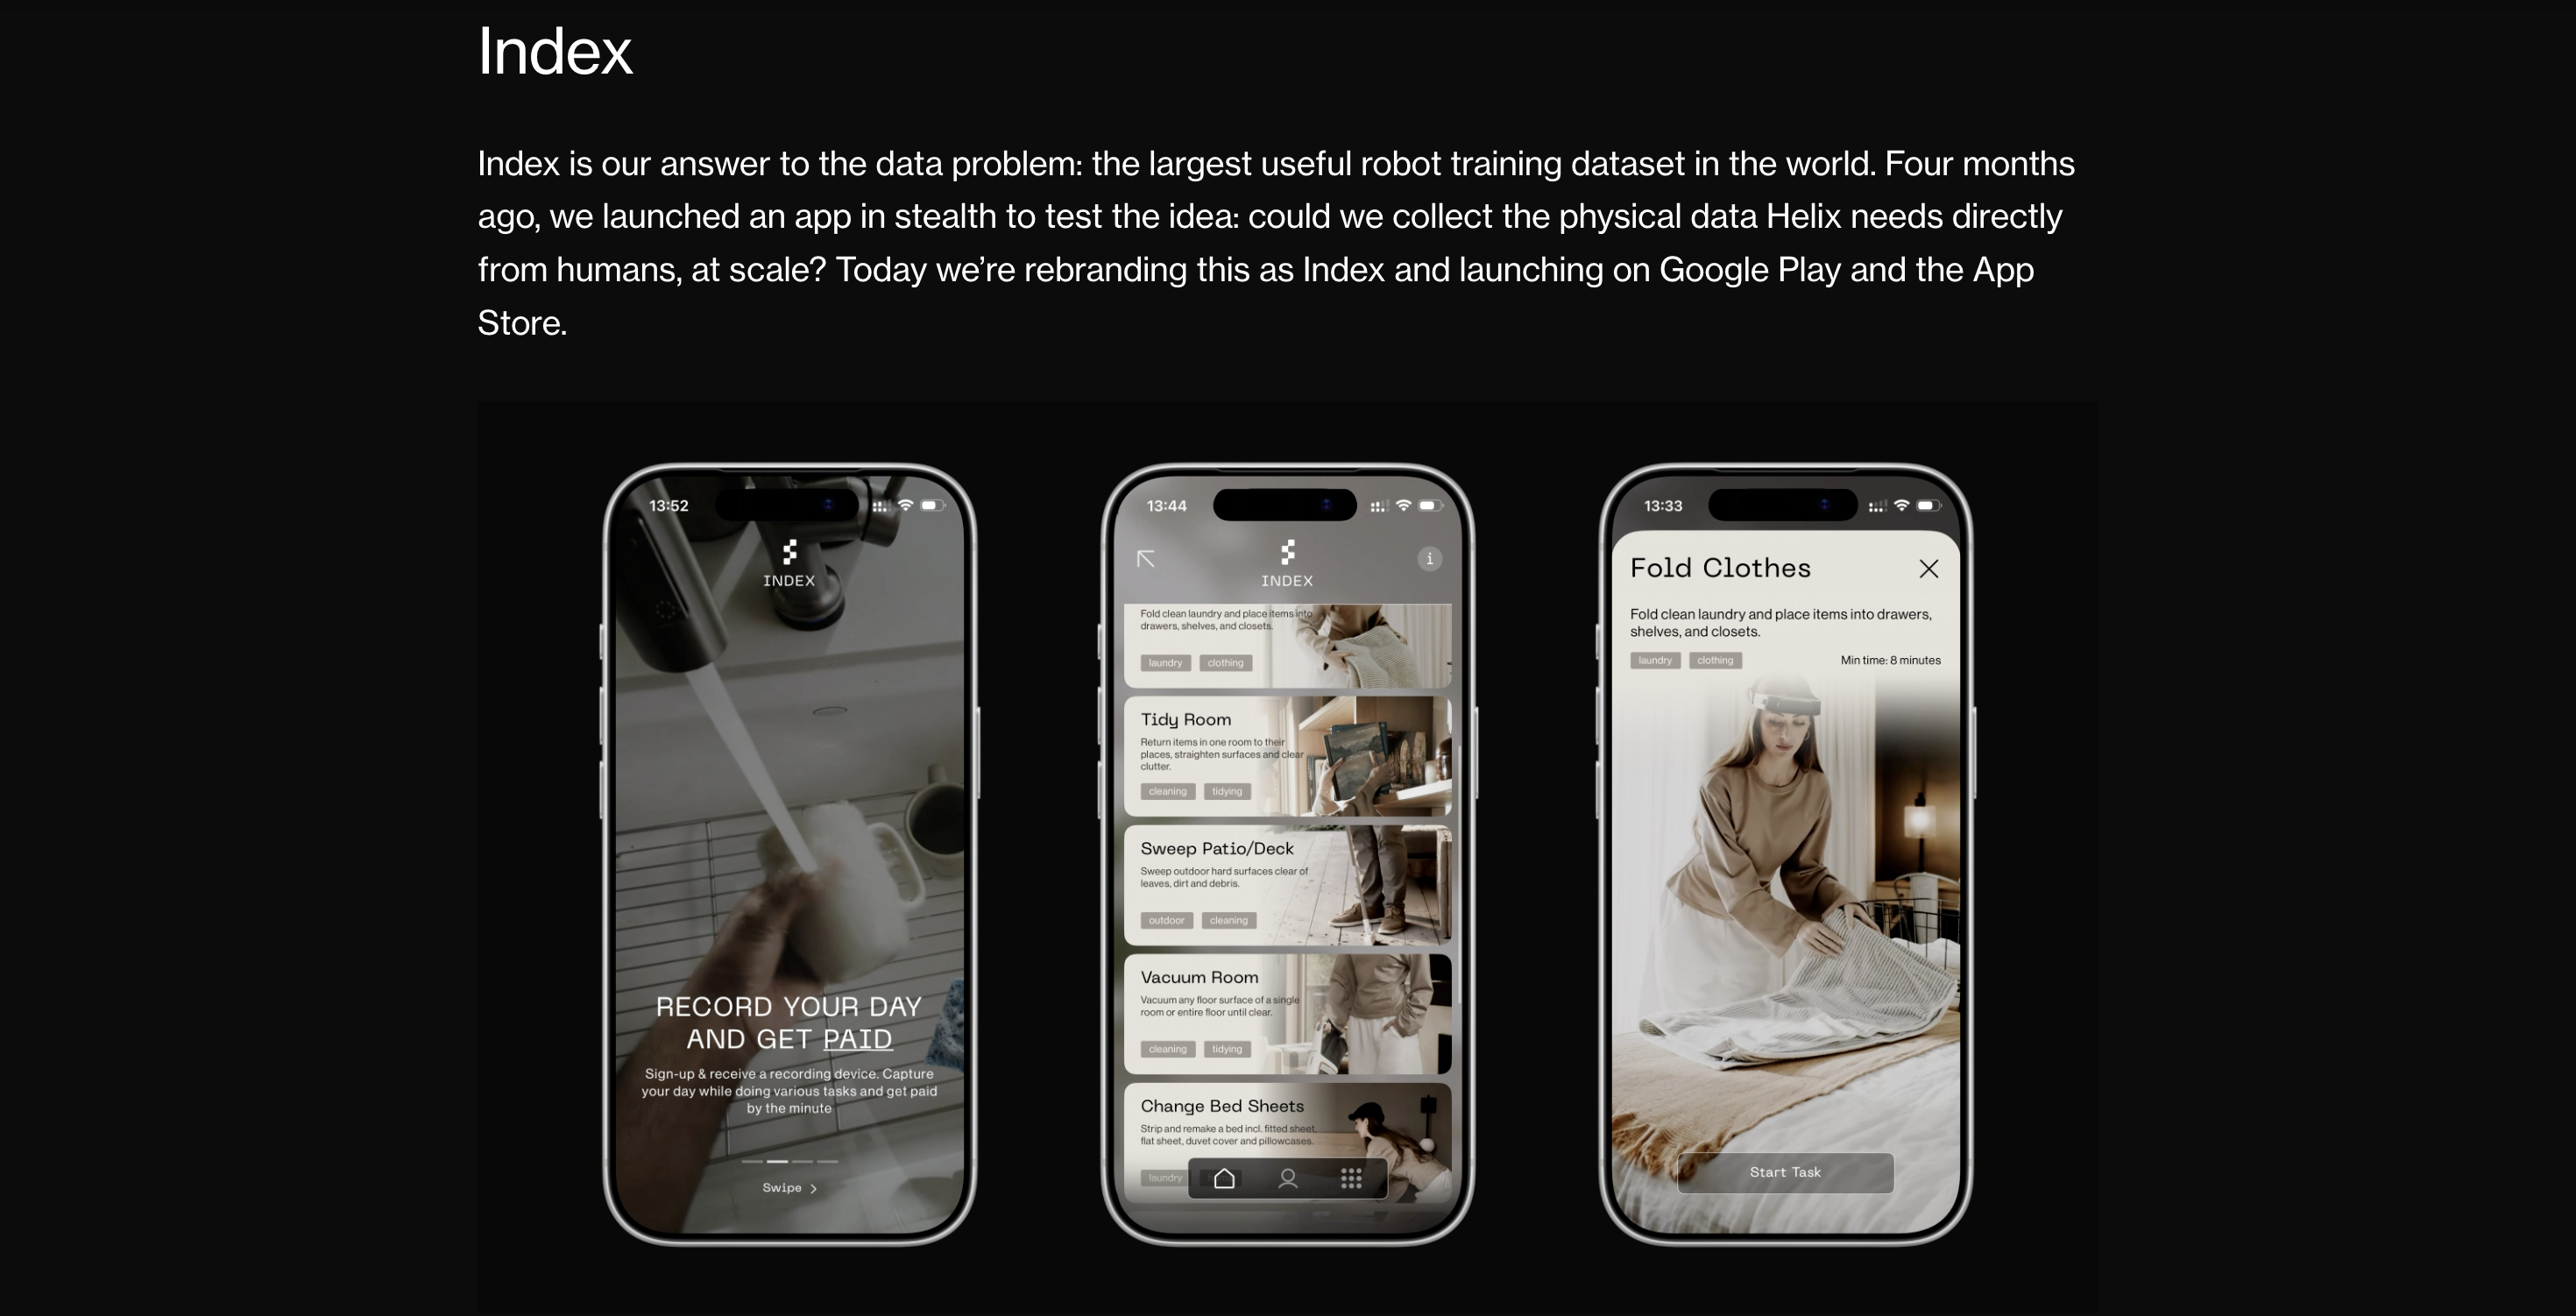
Index 공개 당시 Figure는,
- 100개 이상의 국가
- 44,000명 이상의 weekly active creators
- 1,600만 개 이상의 human video
- 초당 약 30분 이상의 video upload
규모를 발표하였다.
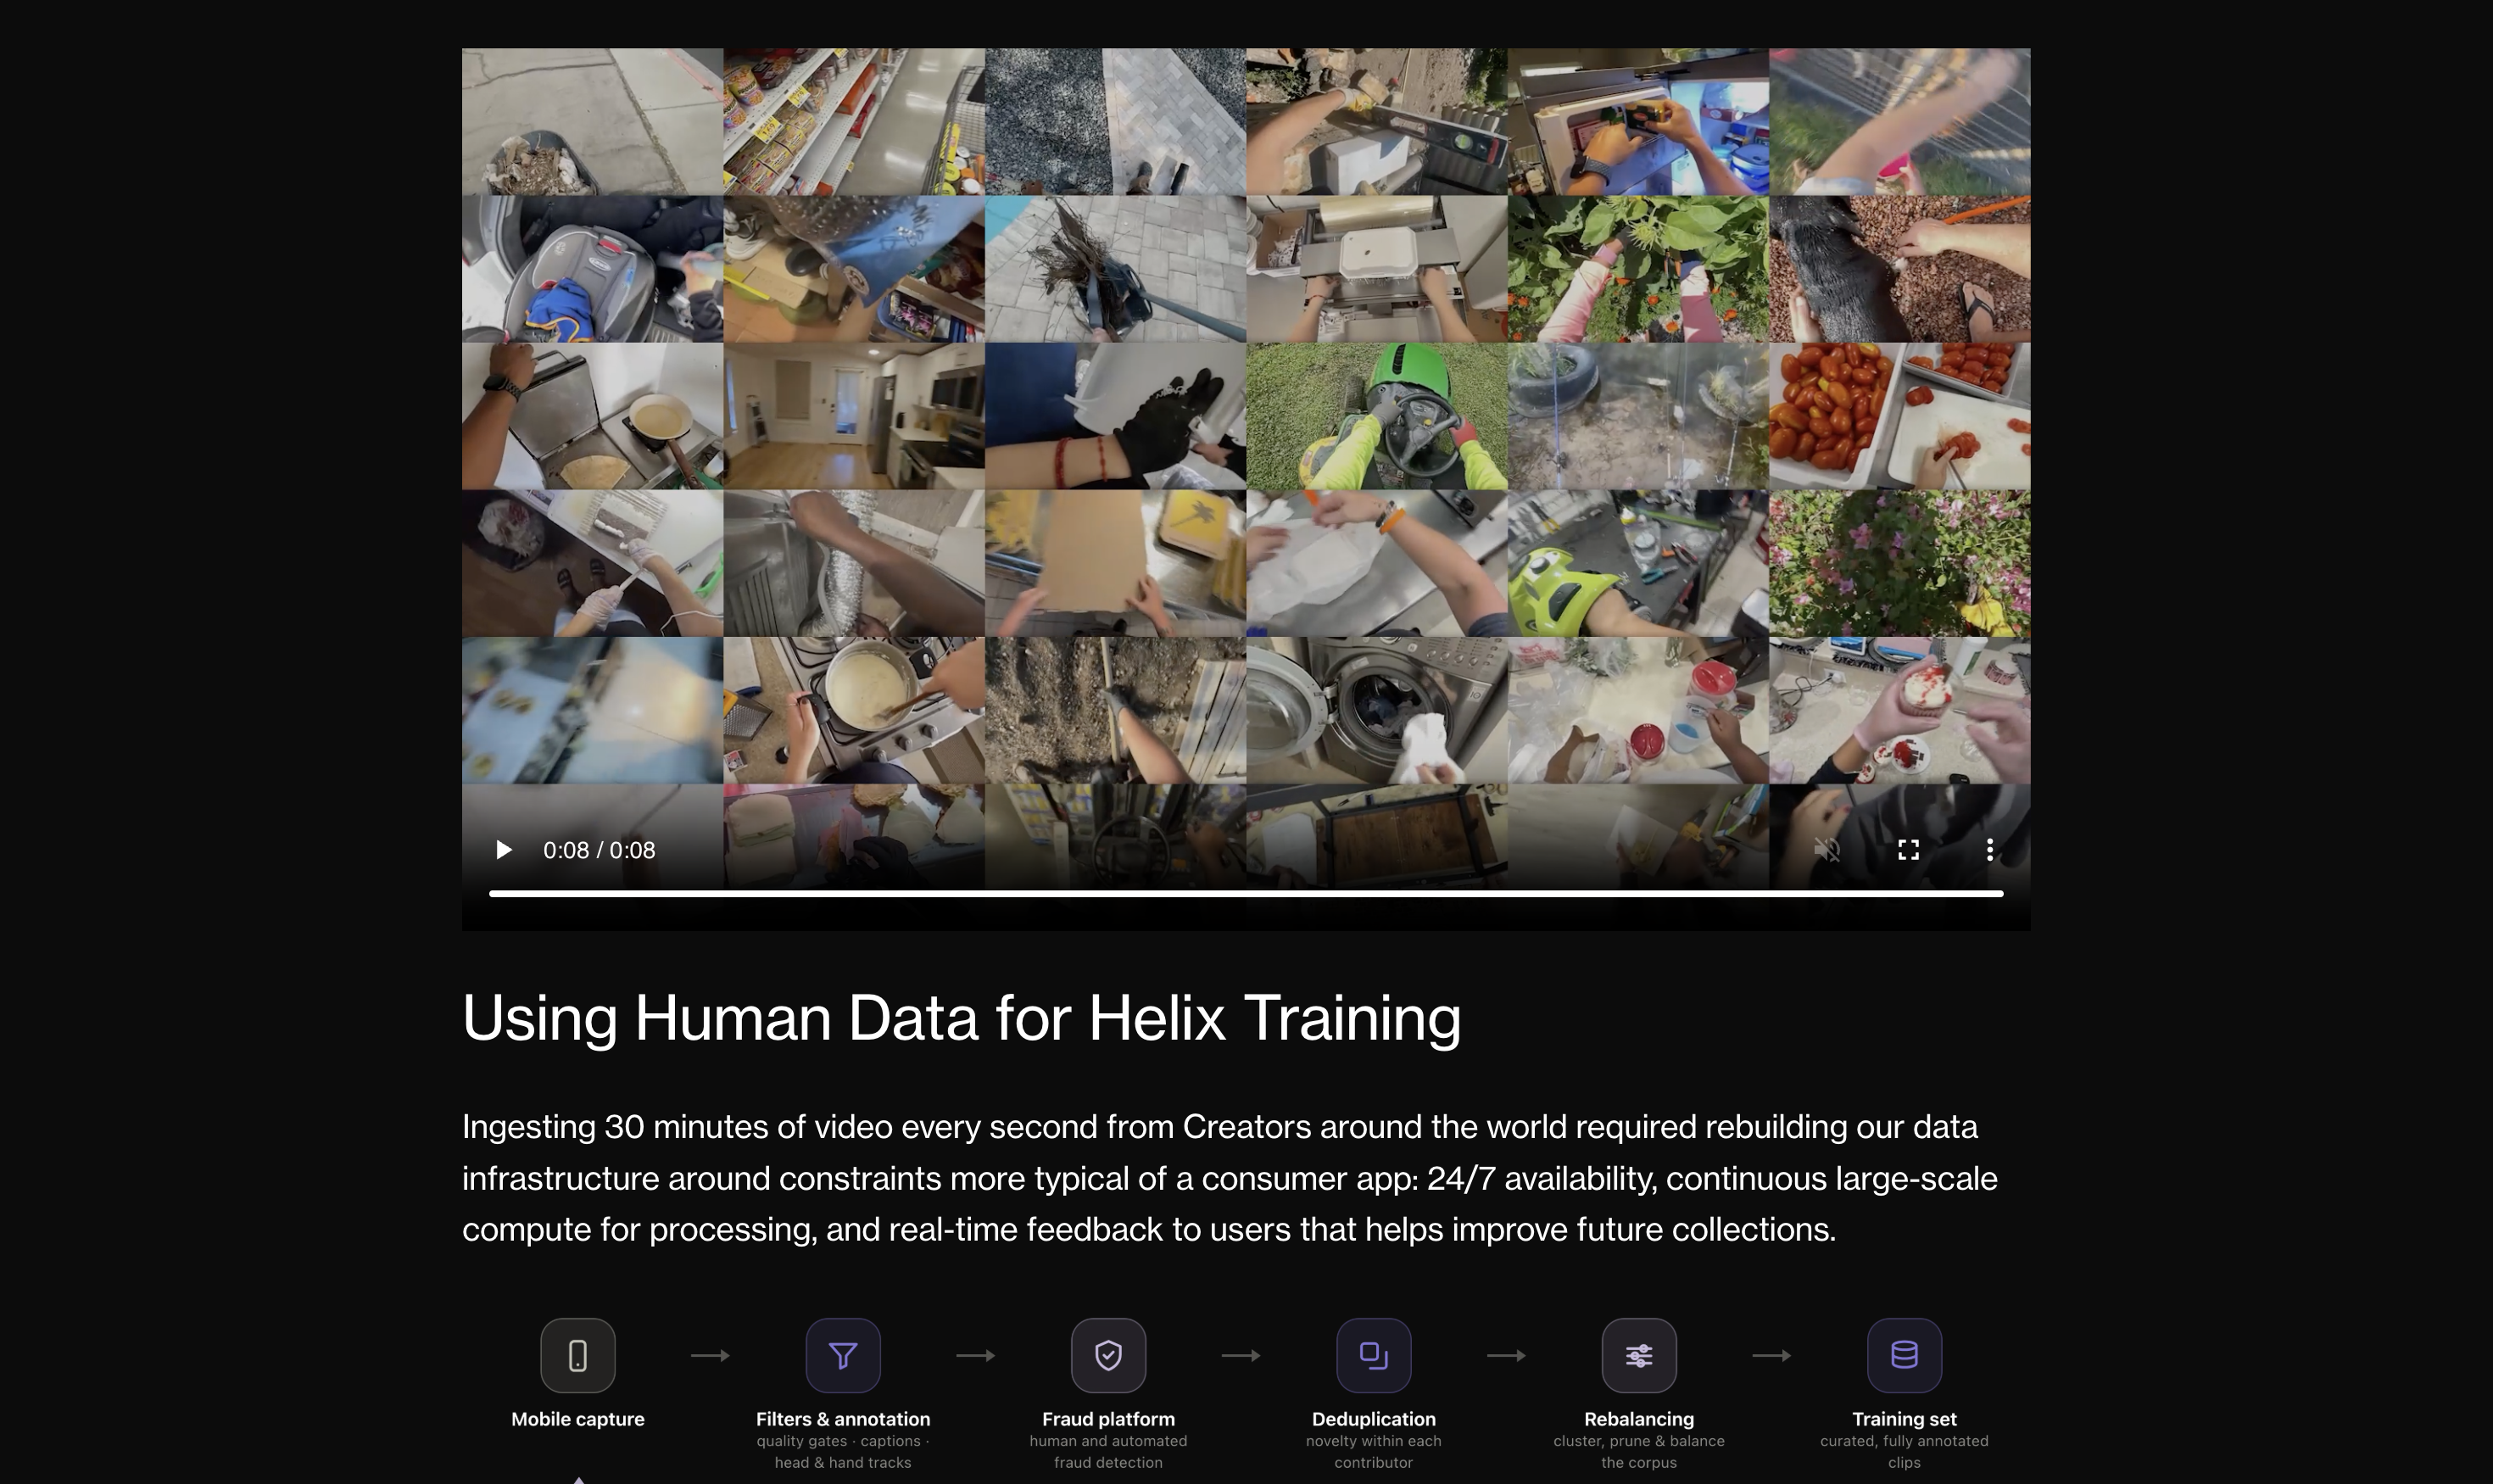
Helix 2.5 발표 시점에는 약 초당 35분의 human experience가 새롭게 생성되고 있다고 밝혔다.
즉 Figure의 철학도 DYNA와 굉장히 비슷하다.
Robot intelligence를 scaling하려면 Robot Data만으로는 부족하다. Human Experience를 사용해야 한다.
다만 Figure는 DYNA의 URR처럼 명시적인 중간 representation을 전면에 내세우기보다는, Human behavior 자체를 foundation model의 pretraining data로 대규모 사용한다.
3. Pretraining → Task Specification → Zero-shot Generalization
Helix 2.5의 전체 과정을 아주 단순화하면 아래와 같다.
1
2
3
4
5
6
7
8
9
10
11
12
13
Massive Human Behavior Data (Index)
              ↓
       Helix 2.5 Pretraining
              ↓
      Foundation Model
              ↓
     Task-specific Data
              ↓
  특정 Behavior로 Adaptation
              ↓
Unseen Home / Unseen Object
              ↓
       Zero-shot Execution
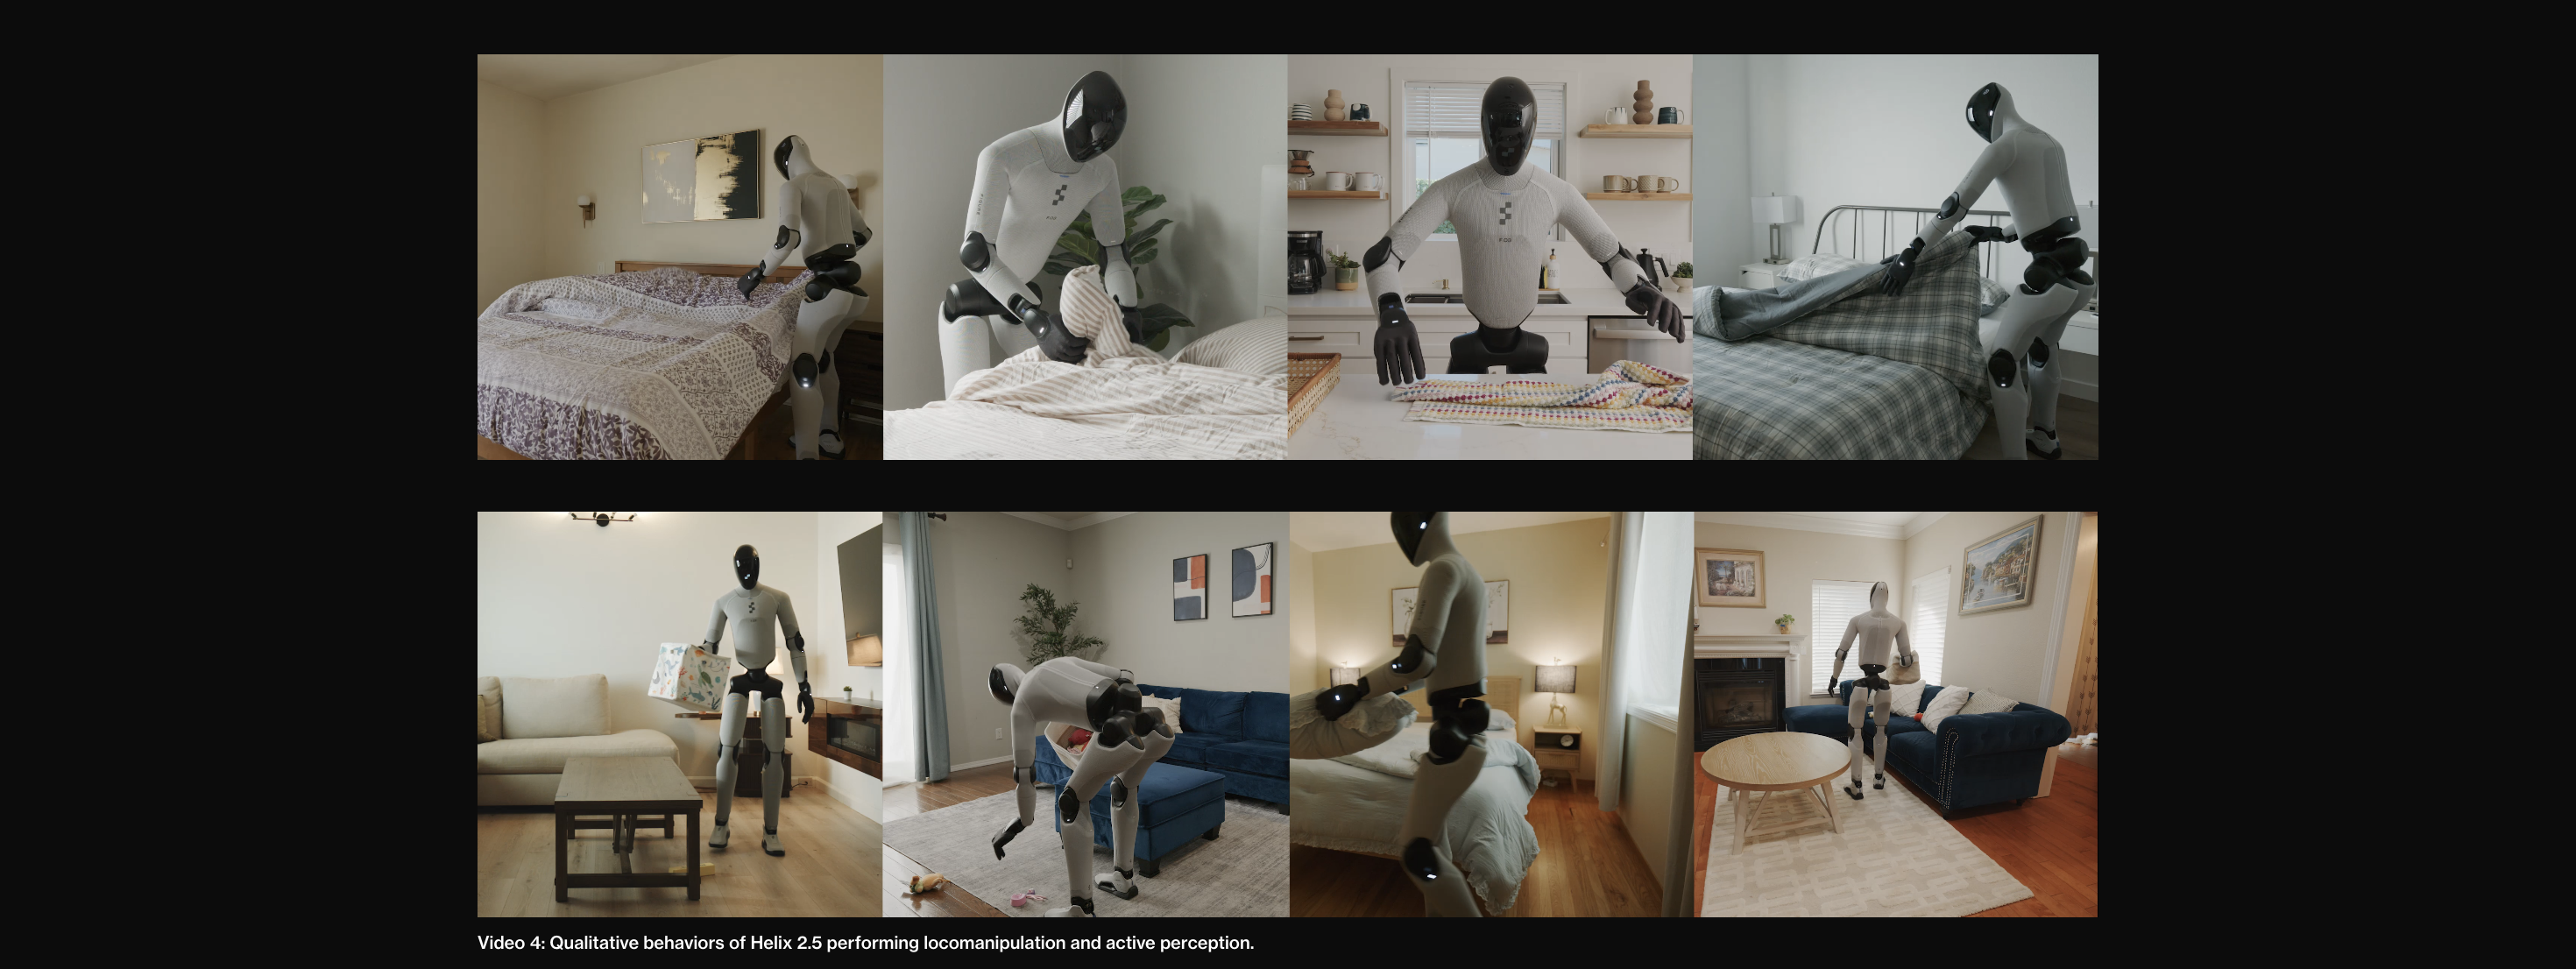
Figure는 하나의 Index-pretrained base model에서 세 가지 behavior를 만들었다.
그리고 Bay Area의 30개의 처음 보는 실제 집으로 robot을 가져가 테스트하였다.
여기서 중요한 조건은,
평가하는 집이나 물체에 대해 data collection / fine-tuning / adaptation을 전혀 하지 않았다는 것이다.
결과적으로 Index 없이 동일한 task data만 사용해 처음부터 학습한 model은 zero-shot trial에서 9% 성공한 반면,
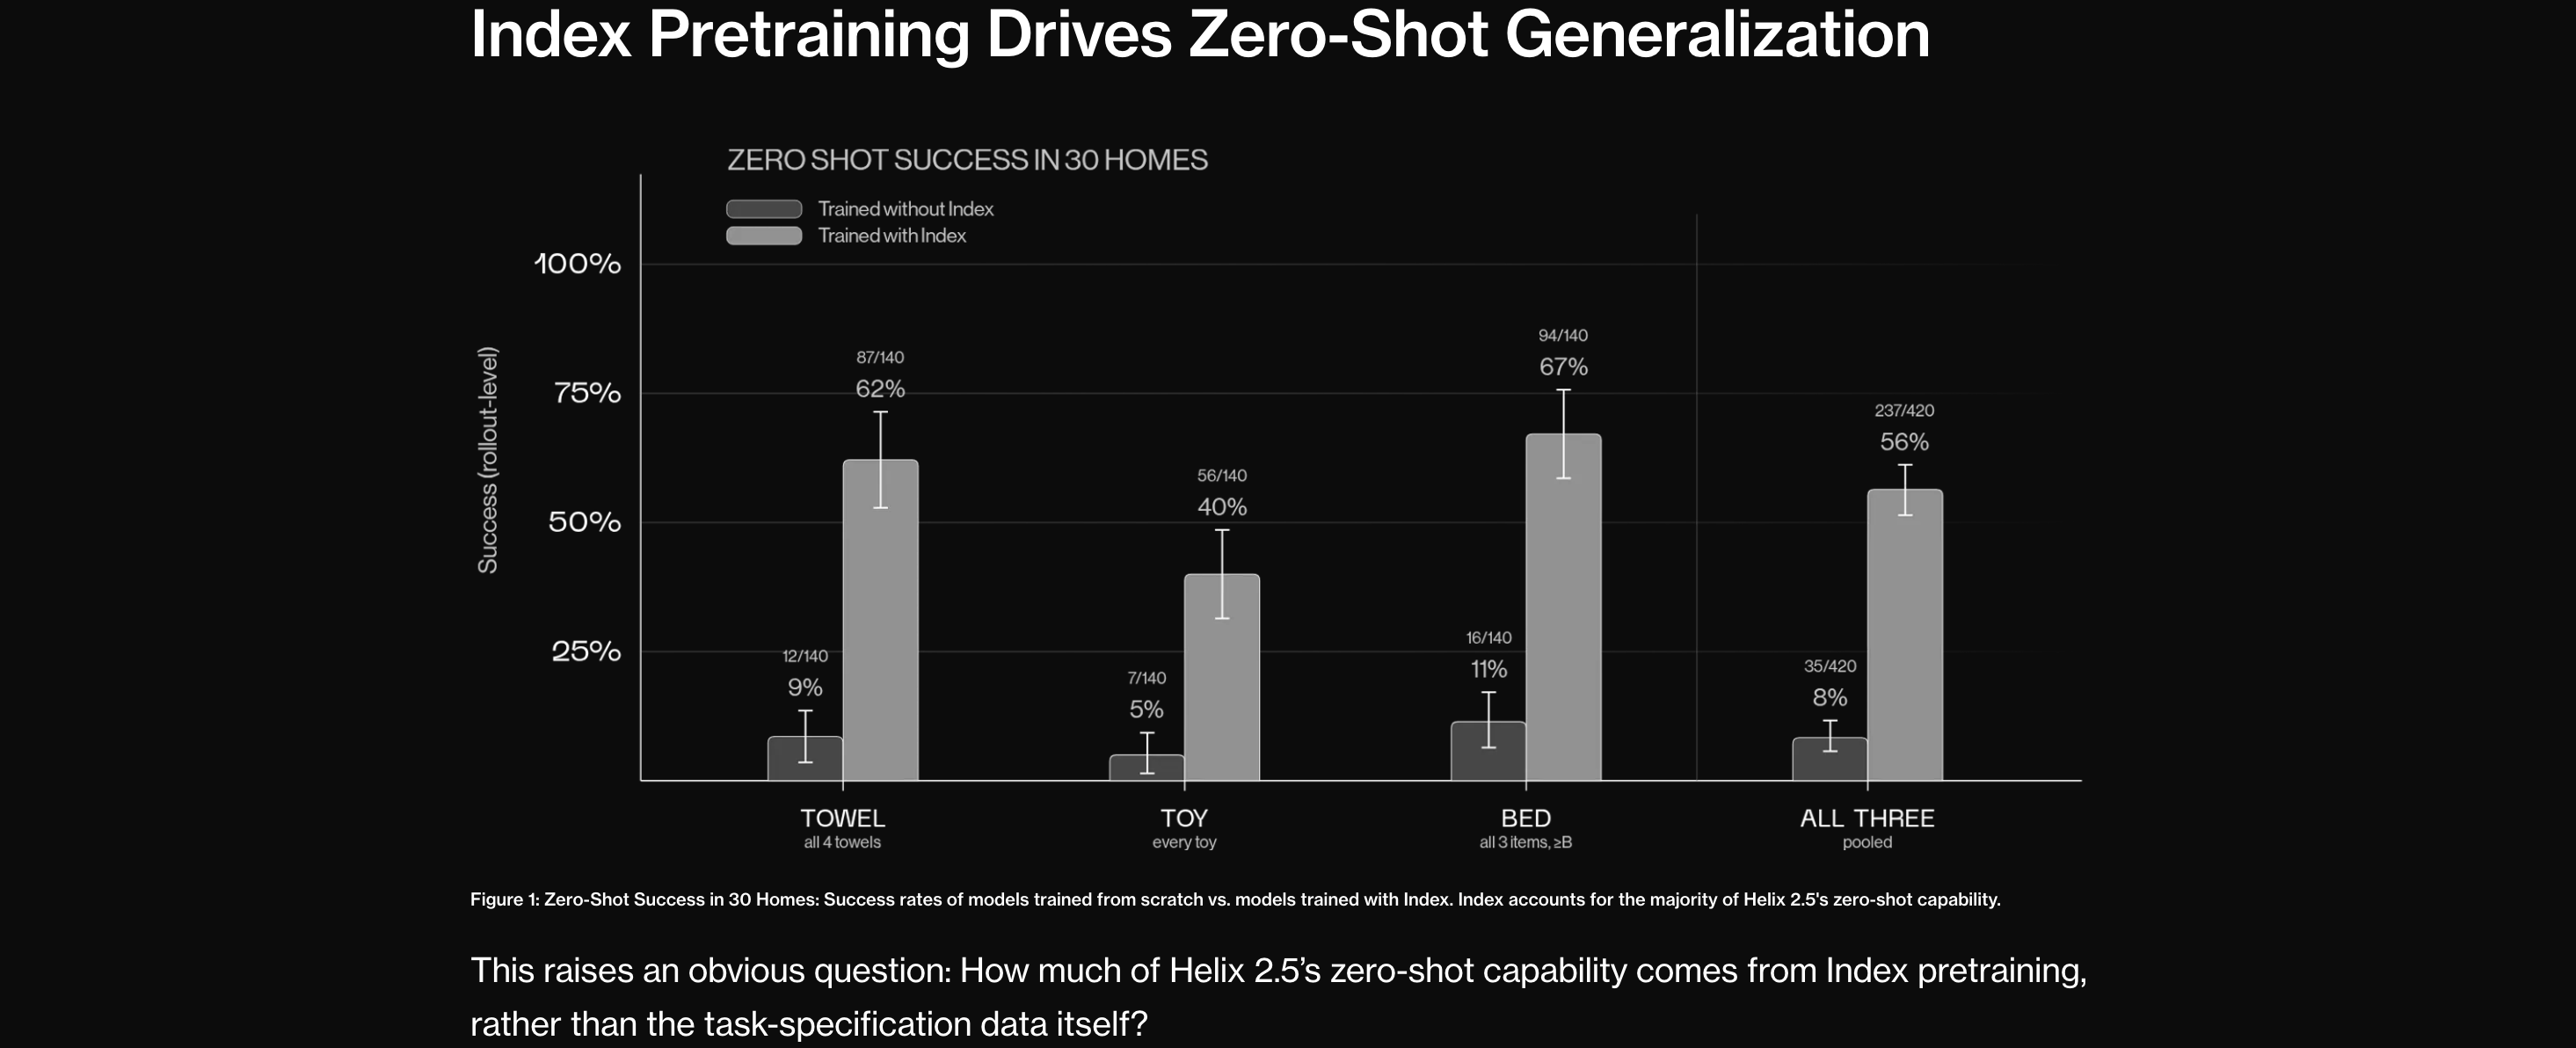
Index로 pre-training된 Helix 2.5는 56% 성공하였다.
즉,
1
2
3
4
5
6
Same Architecture
Same Task Data
Same Training Setting

Scratch Training      → 9%
Index Pretraining     → 56%
Figure는 이 차이가 Human Experience Pretraining 자체가 generalization을 크게 만든다는 증거라고 주장한다.
또한 representative Helix 02 behavior 대비 task-specific data는 절반만 사용하면서, 30개의 unseen home으로 behavior scope를 확장했다고 밝혔다.
4. Scaling Law
여기서 가장 흥미로운 결과가 나온다.
Figure는 Index pretraining data를 반복적으로 2배씩 증가시키면서 downstream robot action prediction 성능을 측정하였다.
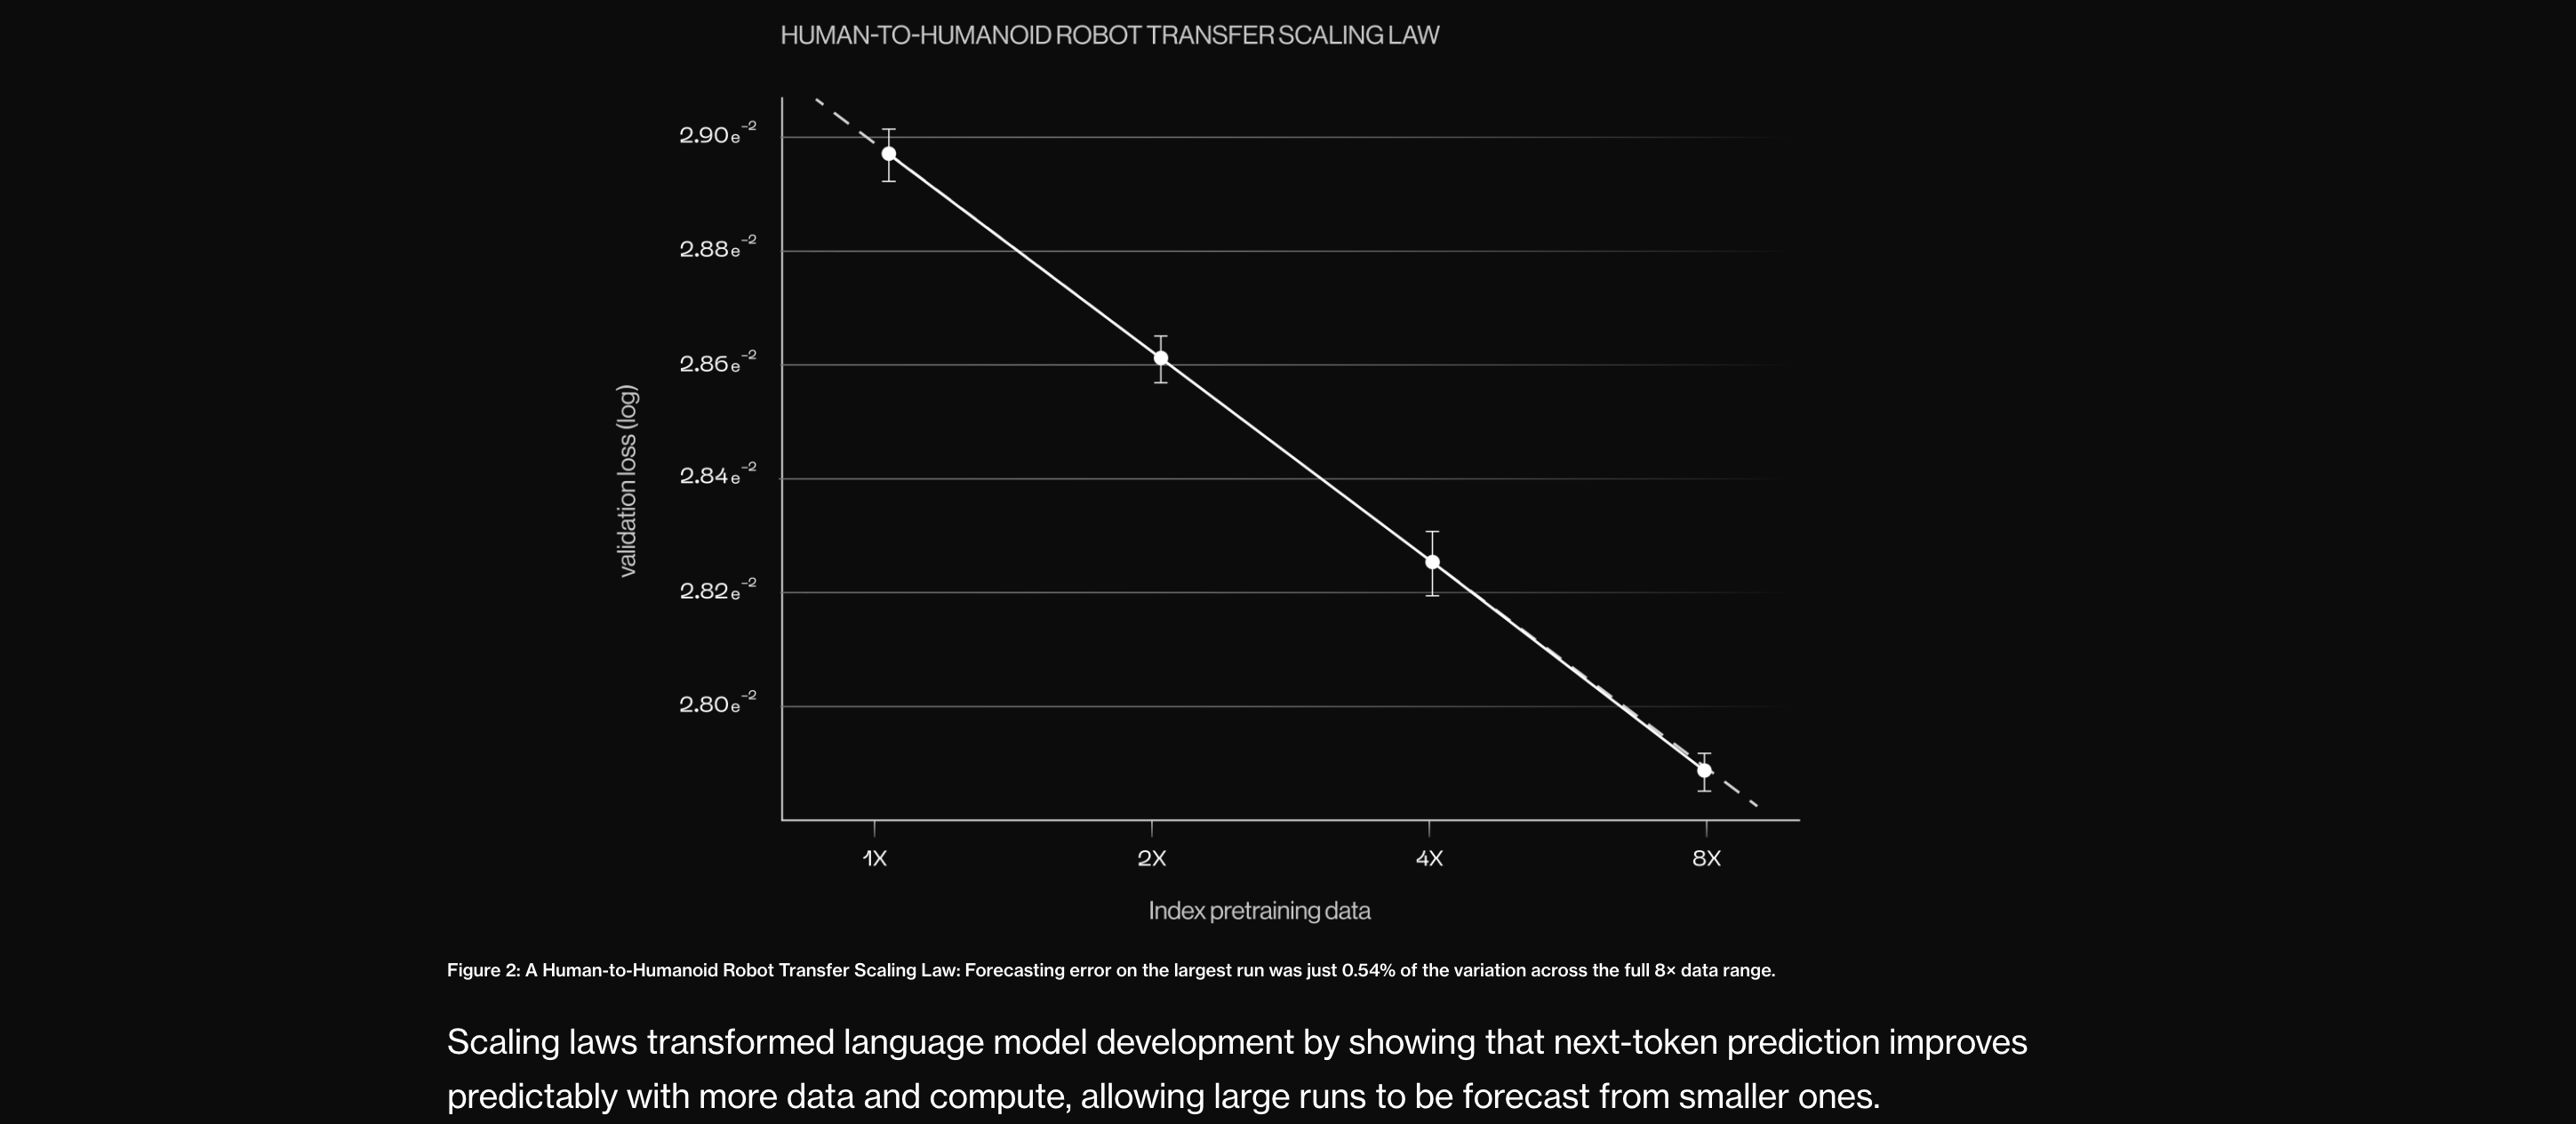
그 결과,
Human pretraining data가 증가할수록 robot transfer 성능도 매끄럽게 향상되는 scaling behavior
를 관찰하였다.
Figure는 가장 큰 training run의 loss까지 사전에 네 자리 소수점 수준으로 예측할 수 있을 만큼 smooth한 scaling curve가 나타났다고 주장한다.
즉 Figure가 보고 있는 미래는 굉장히 단순하다.
1
2
3
4
5
6
7
8
9
More Human Data
      +
More Compute
      ↓
Better Physical World Representation
      ↓
Less Robot-specific Data
      ↓
Better Zero-shot Generalization
이는 LLM에서 이미 익숙한
Pretrain broadly → Specify once → Generalize at deployment
라는 전략을 robotics에 그대로 가져오려는 시도라고 볼 수 있다.
5. DYNA 2.1과 비교하면?
DYNA 2.1과 Helix 2.5는 놀랄 정도로 같은 문제를 바라보고 있다.
“Robot demonstration만으로 Physical AI를 scaling할 수 있는가?”
두 회사 모두 답은 사실상 No에 가깝다.
하지만 접근 방식이 조금 다르다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
DYNA
Human Video
   ↓
URR
   ↓
Policy
   ↓
Whole-body Controller
   ↓
Robot

========================================

Figure
Human Behavior (Index)
   ↓
Foundation Model Pretraining
   ↓
Task-specific Adaptation
   ↓
Zero-shot Environment Transfer
   ↓
Robot
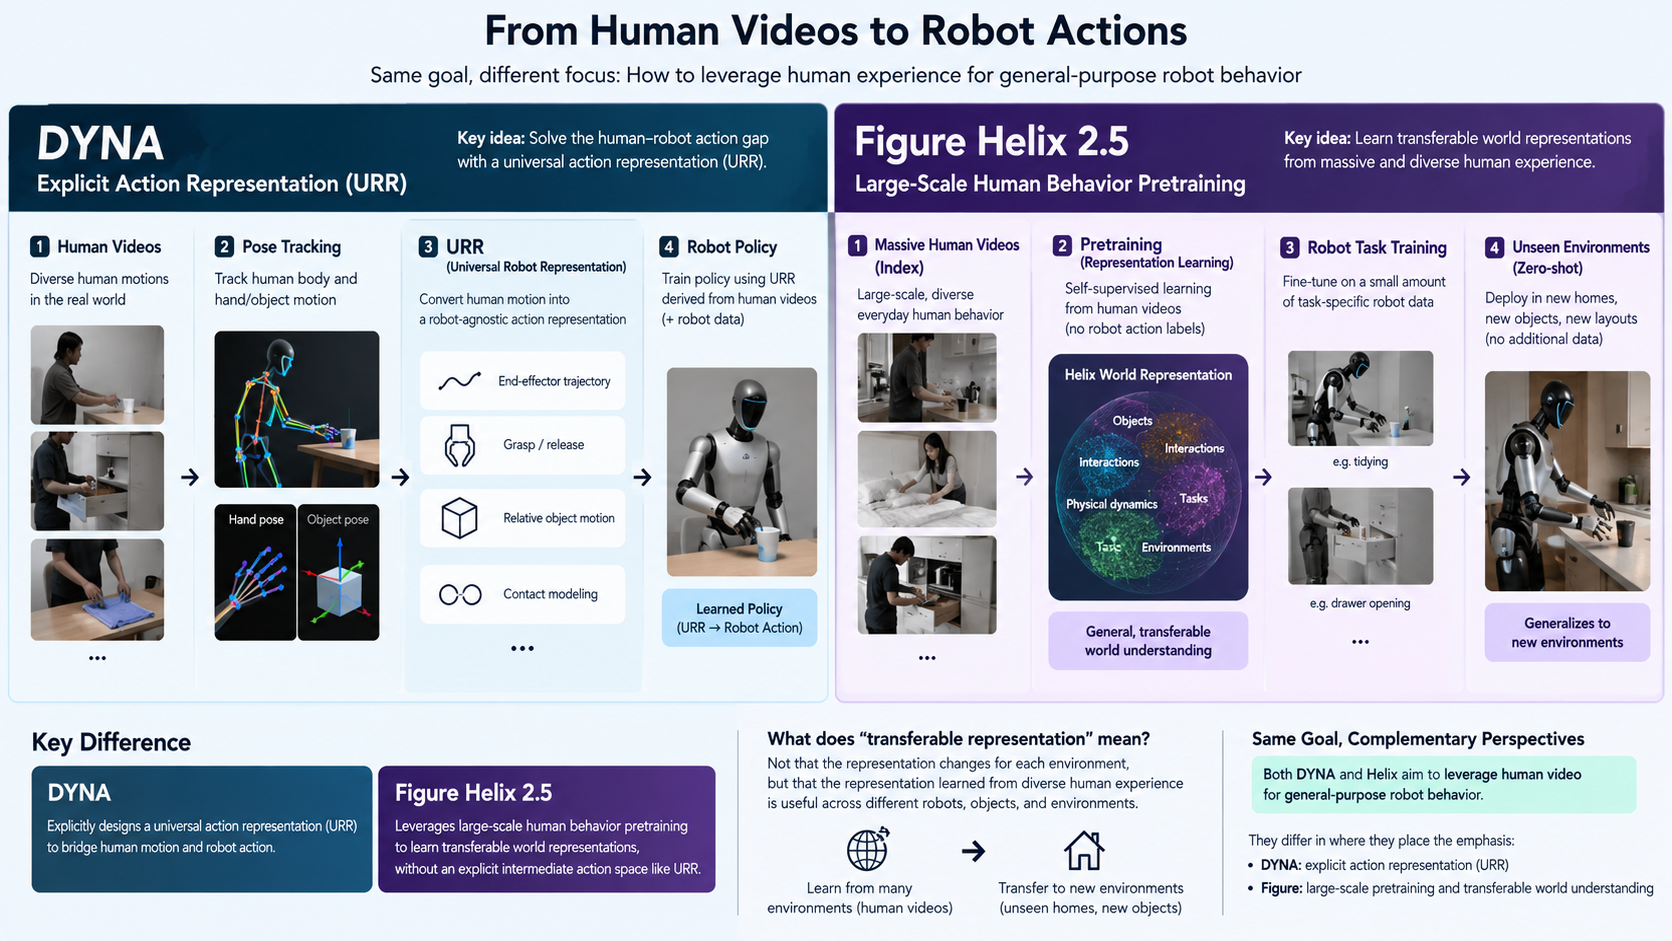
DYNA는 Human과 Robot 사이의 action representation 문제를 URR이라는 explicit intermediate representation으로 해결하려 한다.
반면 Figure는 대규모 Human Behavior Pretraining 자체에서 transferable representation을 학습시키는 방향에 더 가깝다.
따라서 Helix 2.5에서 가장 중요한 takeaway는 새로운 robot skill 하나가 아니다.
Human experience를 충분히 크게 pre-training하면, robot이 각 deployment environment를 하나씩 다시 학습하지 않아도 될 가능성이 보이기 시작했다는 것.
그리고 Figure가 보여준 9% → 56%의 차이는 지금까지 공개된 결과 중 이 주장에 대한 꽤 직접적인 evidence이다.
Key Takeaway
Helix 2.5를 한 문장으로 정리하면,
“Robot을 모든 집에서 다시 학습시키는 대신, Human Experience를 대규모로 미리 학습시켜 처음 보는 집에서도 바로 generalize시키자.”
라고 볼 수 있다.
이번 결과가 general humanoid robotics가 해결되었다는 의미는 아니다. 실제 성공률도 56% 수준이며, 세 가지 behavior에 한정된 실험이다.
하지만 중요한 것은 Human Data → Robot Generalization에서 measurable scaling law가 나타났다는 점이다.
DYNA 2.1의 URR과 함께 보면, 현재 Physical AI 회사들이 향하고 있는 방향이 꽤 명확하게 보인다.
Robot Data Scaling → Human Experience Scaling → General Physical Foundation Model