
Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models
Dyna-2는 100만 시간의 사람 egocentric 영상으로 world-action model을 학습해, human → robot transfer scaling law를 처음 보여줬다. 아키텍처, 학습·추론 방식, 실험 결과, 그리고 WAM vs VLA 비교를 정리한다.
Reference
Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models — DYNA
이 글의 그래프와 사진은 위 Dyna 공식 블로그에서 가져왔다.
Overview
- Human video → scale up 가능 (egocentric)
- Future world + future action을 같이 학습해야한다.
- World Modeling Knowledge → robot action transfer
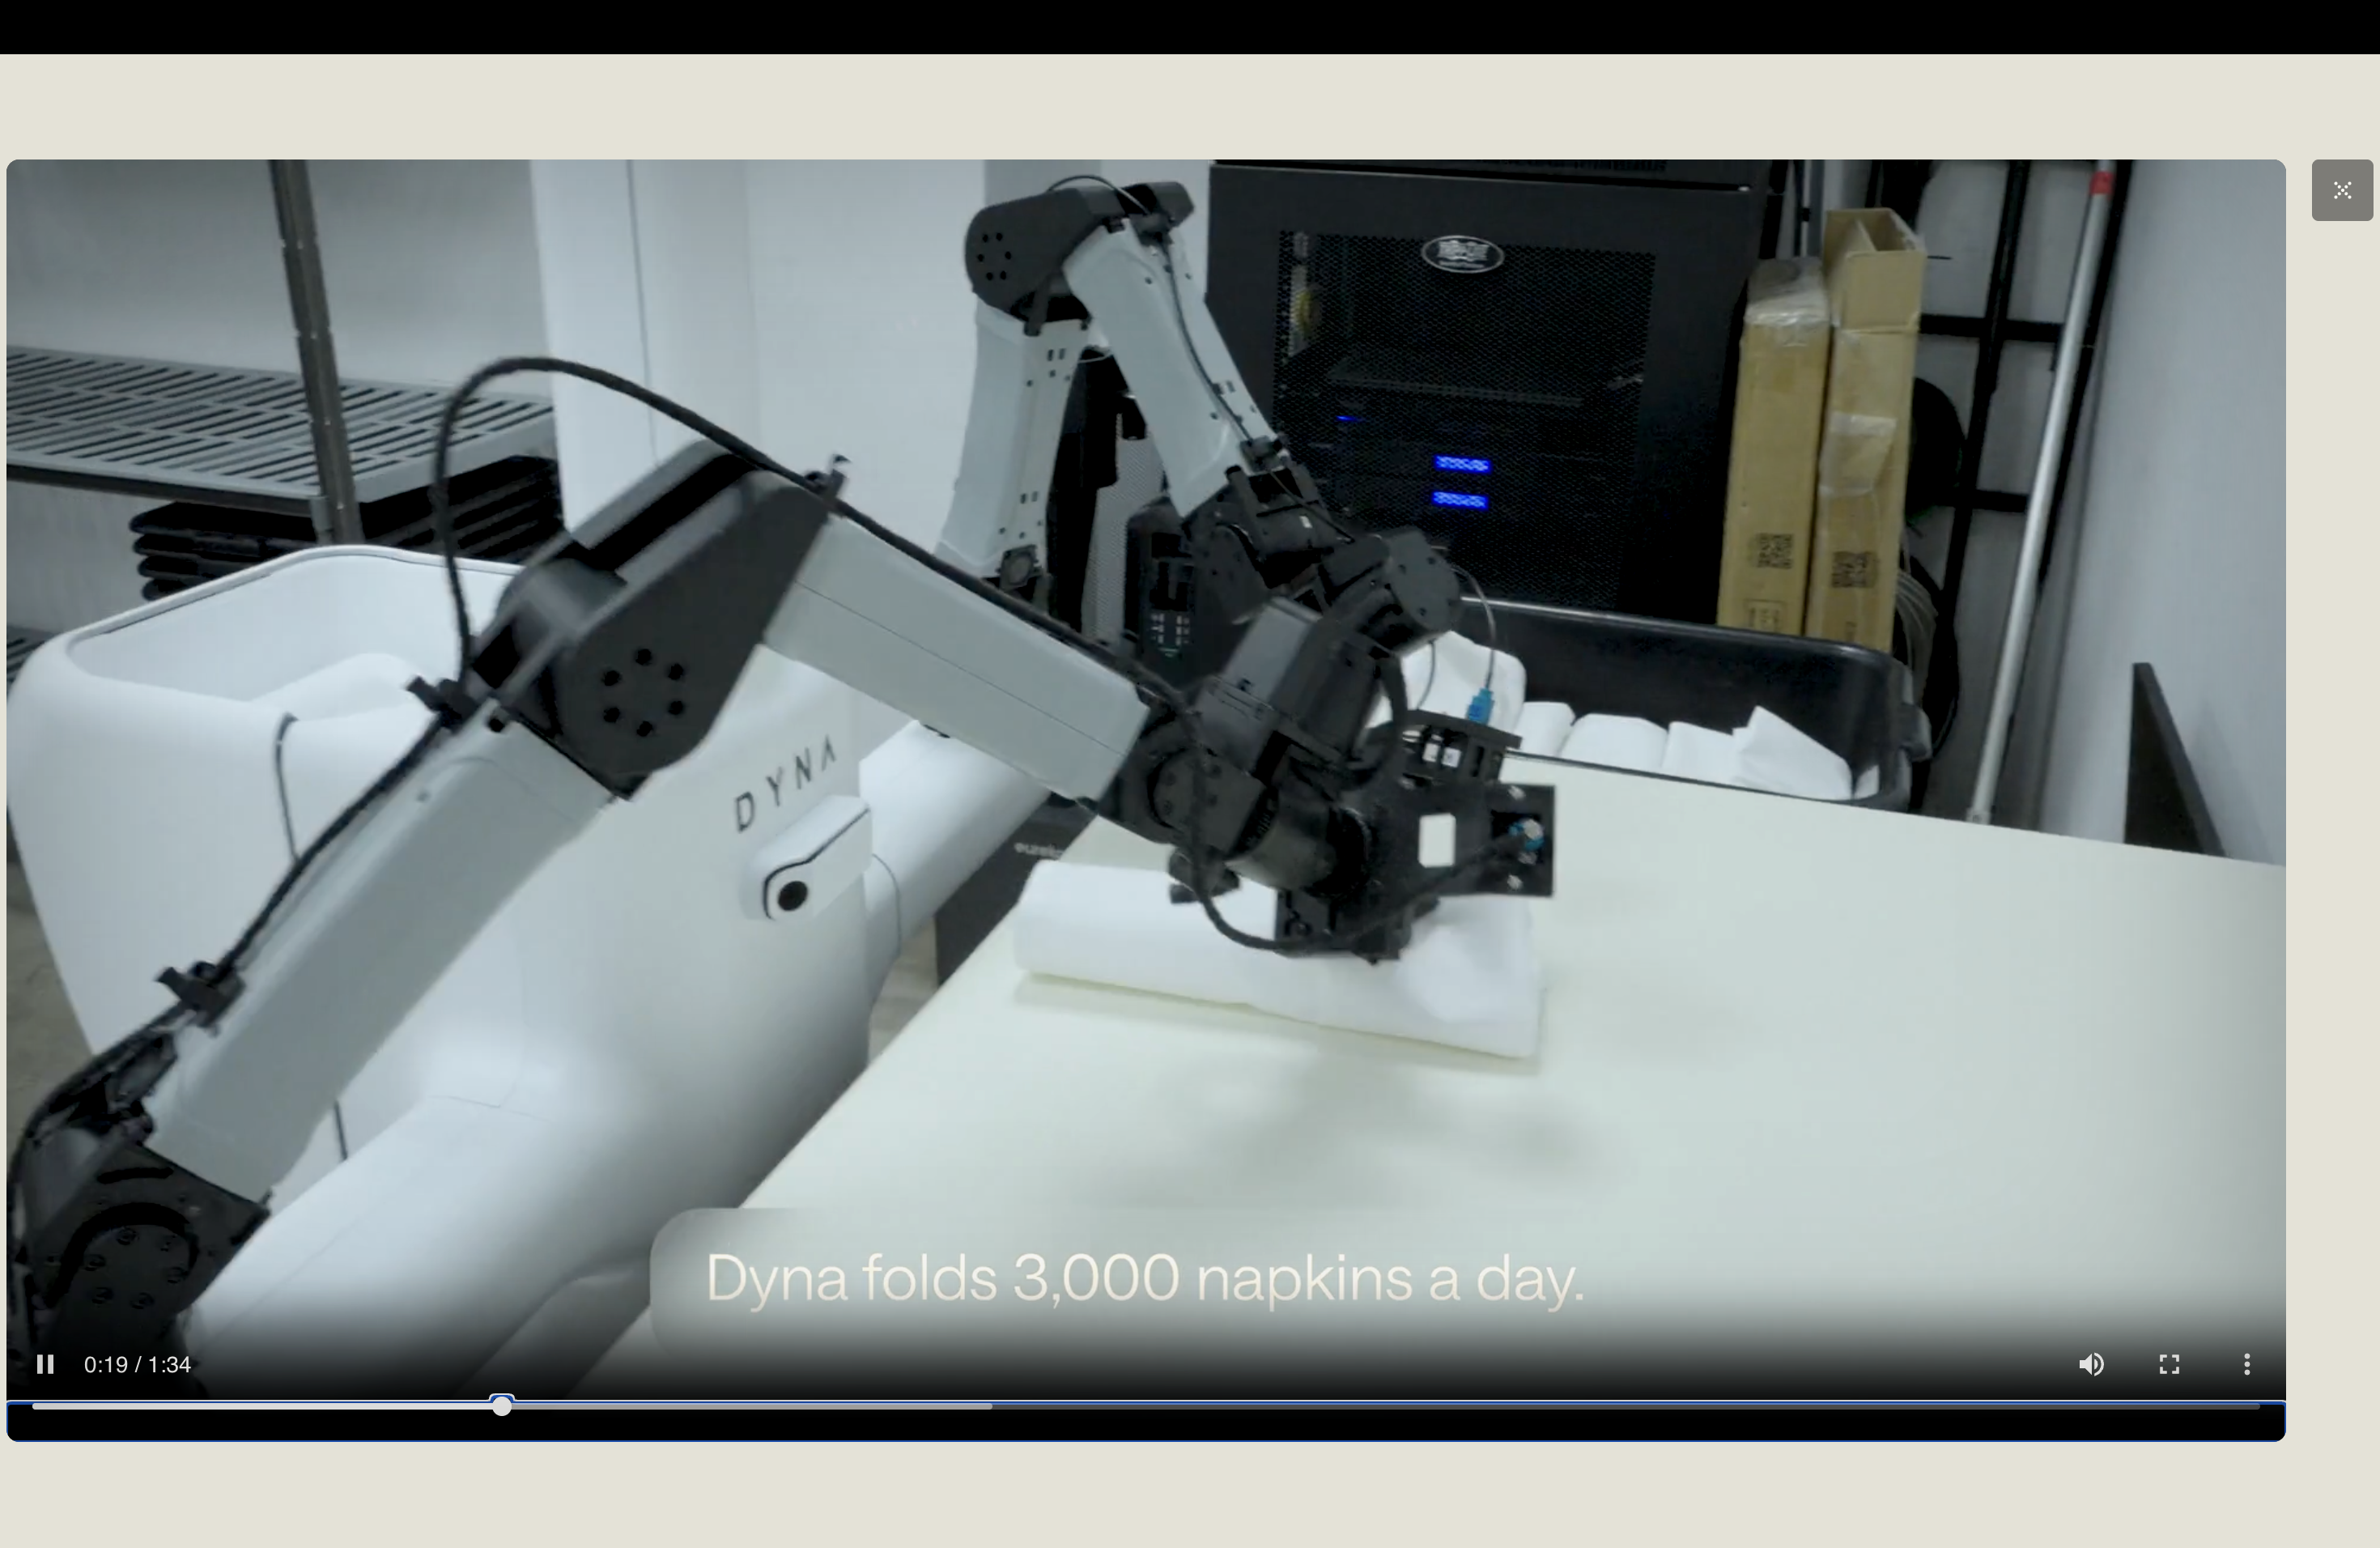
지금 가장 핫한 회사 중 하나인 dyna에 대해서 알아보자. 이 회사는 정말 말도 안된다. 그러니까, 이미 로봇이 제품화에 성공하였다. 하루에 수천 개를 접는 수준이라고 알려져 있으며, 레스토랑에서 구매를 시작하였다. 헬스장, 호텔 등등 다양한 고객들을 확보하며 성장하고 있다.
이 회사의 가장 최신 모델인 Dyna 2, tech blog를 리뷰해보며, 두 가지 질문을 가지고 회사를 분석해보자.
Introduction
From first principles, we believe the answer follows from the goal itself: a general purpose robot should eventually be capable of doing any economically valuable task that is currently being done by humans.
Data should be:
“sensorized recording (e.g., video) of humans performing those very tasks, which already exists at effectively unbounded scale and carries exactly what a manipulation policy needs to learn”
- data - egocentric human videos (1M hours) - 깨어 있는 시간 기준으로 약 170 years
(무려 사람이 깨어 있는 시간으로 170년치의 인간 영상데이터를 가지고 학습을 했다고 한다…… 단순히 24시간으로 나누면 약 114년)
Scaling Law
Dyna-2의 출발점은 굉장히 단순하다. 로봇의 데이터는 부족하다. 그렇다면 만연한 데이터에 맞춰서 알고리즘을 짜는 것은??
“로봇 데이터를 직접 엄청 많이 모으는 건 너무 비싸다. 그런데 인간이 물건을 만지고, 접고, 열고, 조립하는 영상은 세상에 엄청 많다. 그럼 인간 영상을 보고 로봇이 manipulation을 배울 수 없을까?”
→ Human Egocentric video data. → Robot trajectory data
(주의할 점은, 세상을 영상으로도 가지고 있고, 로봇 경로데이터도 추출해서 가지고 있으니 2가지 종류의 데이터가 있다는 사실이다)
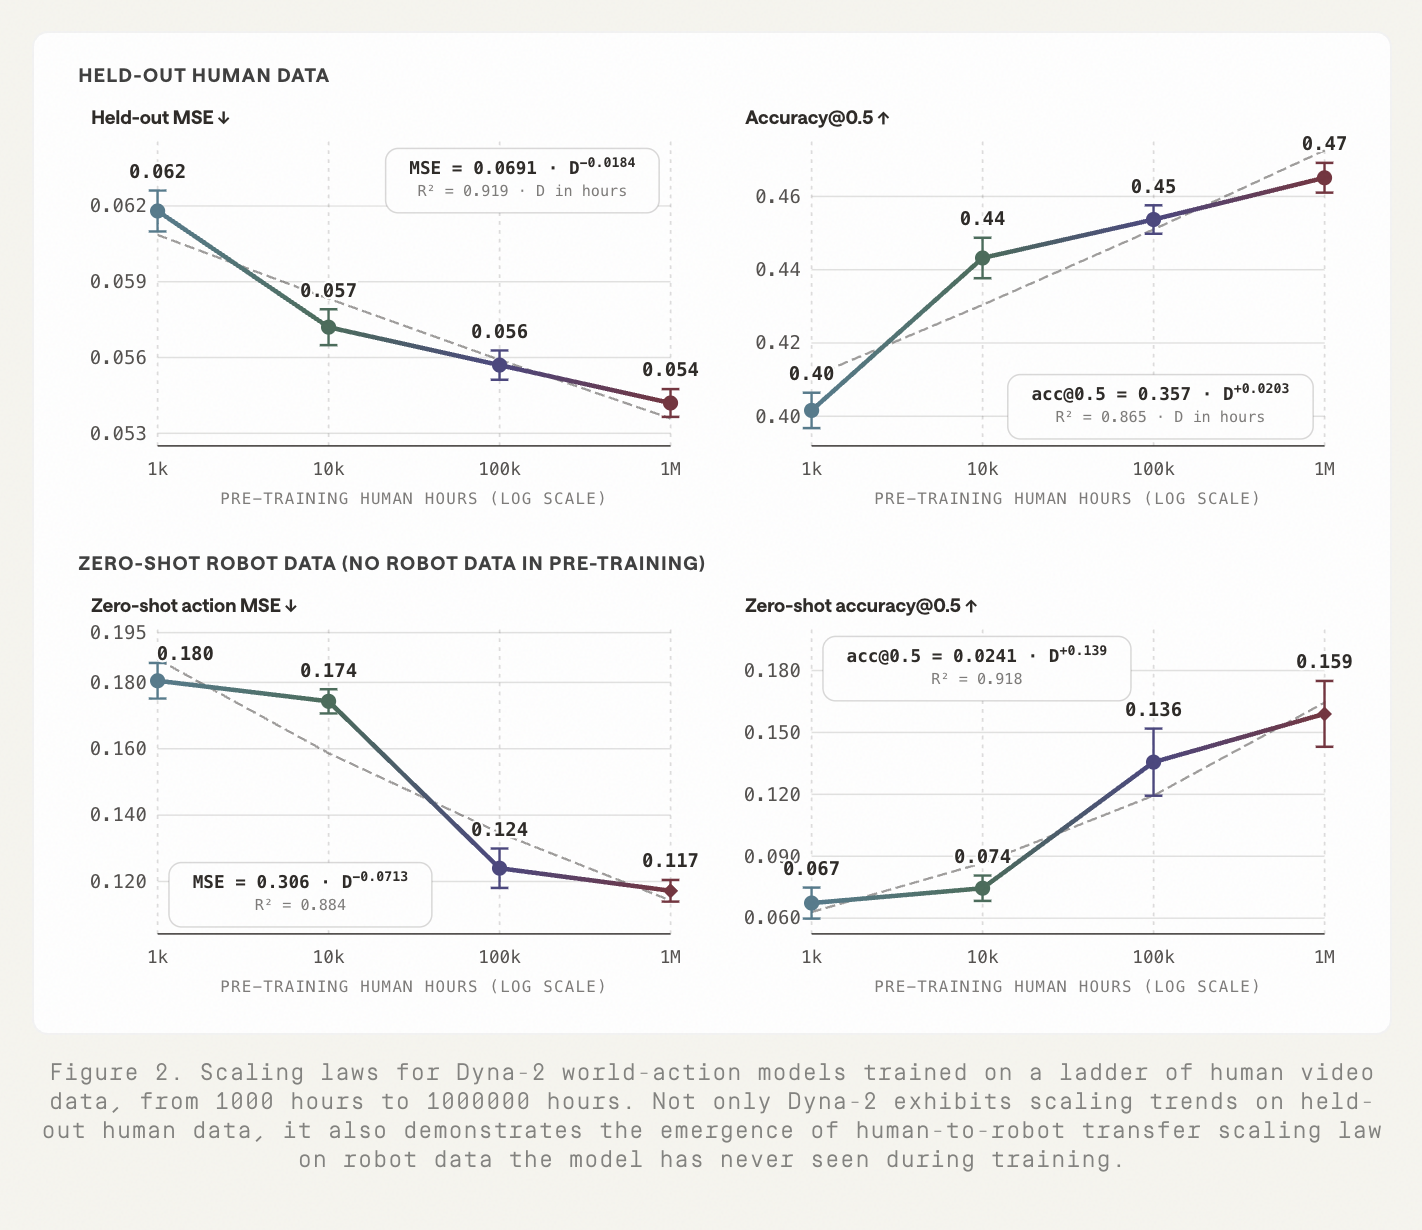
그리고 놀라운 점은, LLM에서 보여줬던 scale law를 그대로 Robot 모델에서도 보여주었다는 점에서 굉장히 의미가 있다.
Architecture(VLA vs WAM)
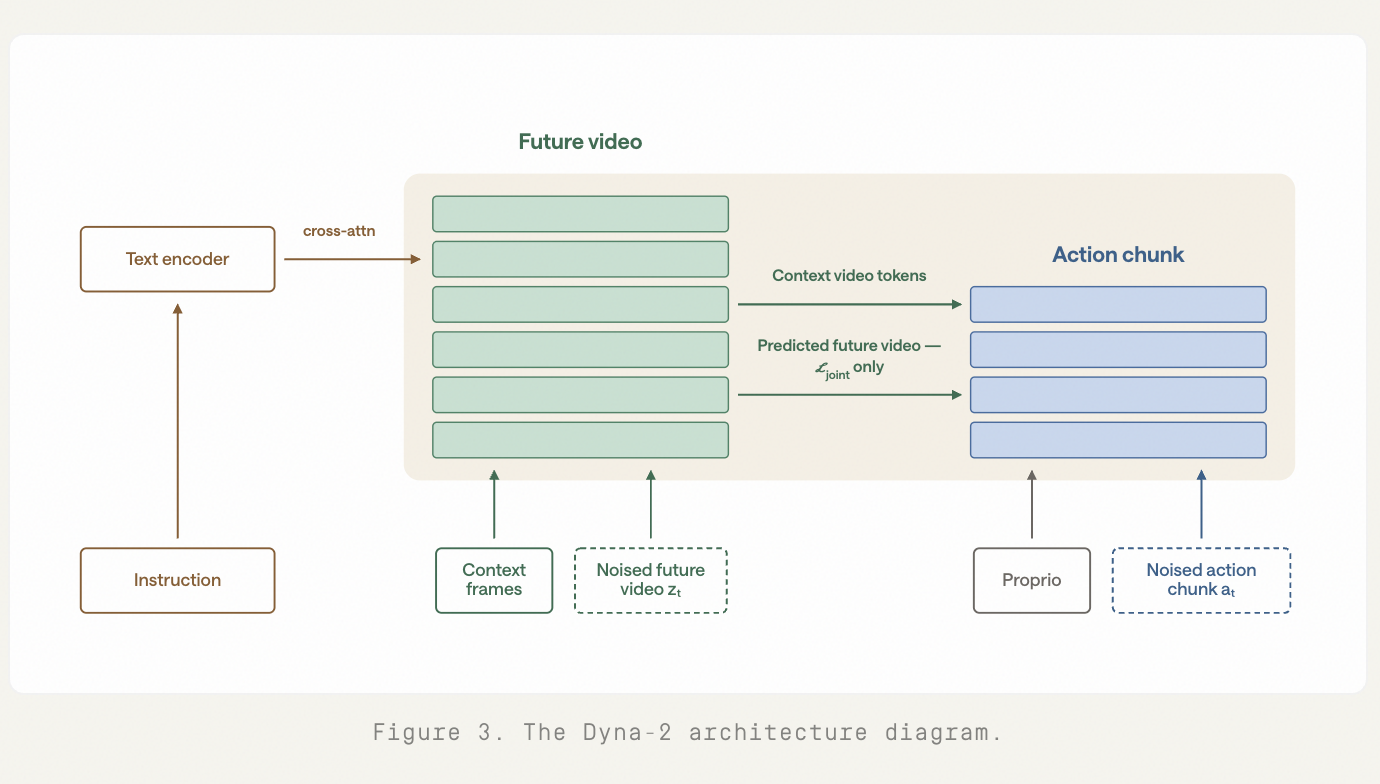
여기서 다른 것들은 전부 VLA와 익숙하겠지만, 핵심은 action stream으로 흘러가는 video 정보가 아래 두가지라는 것이다. (video와 action은 각자 따로의 DiT layer를 갖고, attention으로 서로를 본다. mixture-of-transformers 구조)
- Context video tokens = 로봇이 이미 실제로 본 과거/현재 영상의 token. 즉 short-term visual memory에 가까운 정보이다. action token이 기본으로 보는 건 이것뿐이다.
- Predicted Future video - “video latent space로 압축된 뒤 token sequence”
- 그림에서 점선(“ℒ joint only”)으로 표시돼 있듯이, ℒ_joint 변형에서만 action과 연결된다. scaling law에 쓴 기본 모델에서는 action이 이 정보를 보지 않는다.
- DiT4DiT와 비교하면 차이가 분명하다. DiT4DiT는 추론 때도 video DiT의 중간 hidden feature를 action에 넘겨주지만, Dyna-2 기본 모델은 추론 때 미래 영상을 아예 보지 않는다. video 학습은 shared representation을 좋게 만드는 데만 쓰인다.
- Text(instruction)는 action token에 직접 들어가지 않는다. video token이 text를 cross-attention으로 보고, action은 그 video token을 통해 간접적으로 영향을 받는다. proprioception은 action transformer에 바로 들어간다.
자 이제 아키텍쳐를 살펴보았고, 정확히 학습과 추론이 어떻게 일어나는 지를 살펴보자.
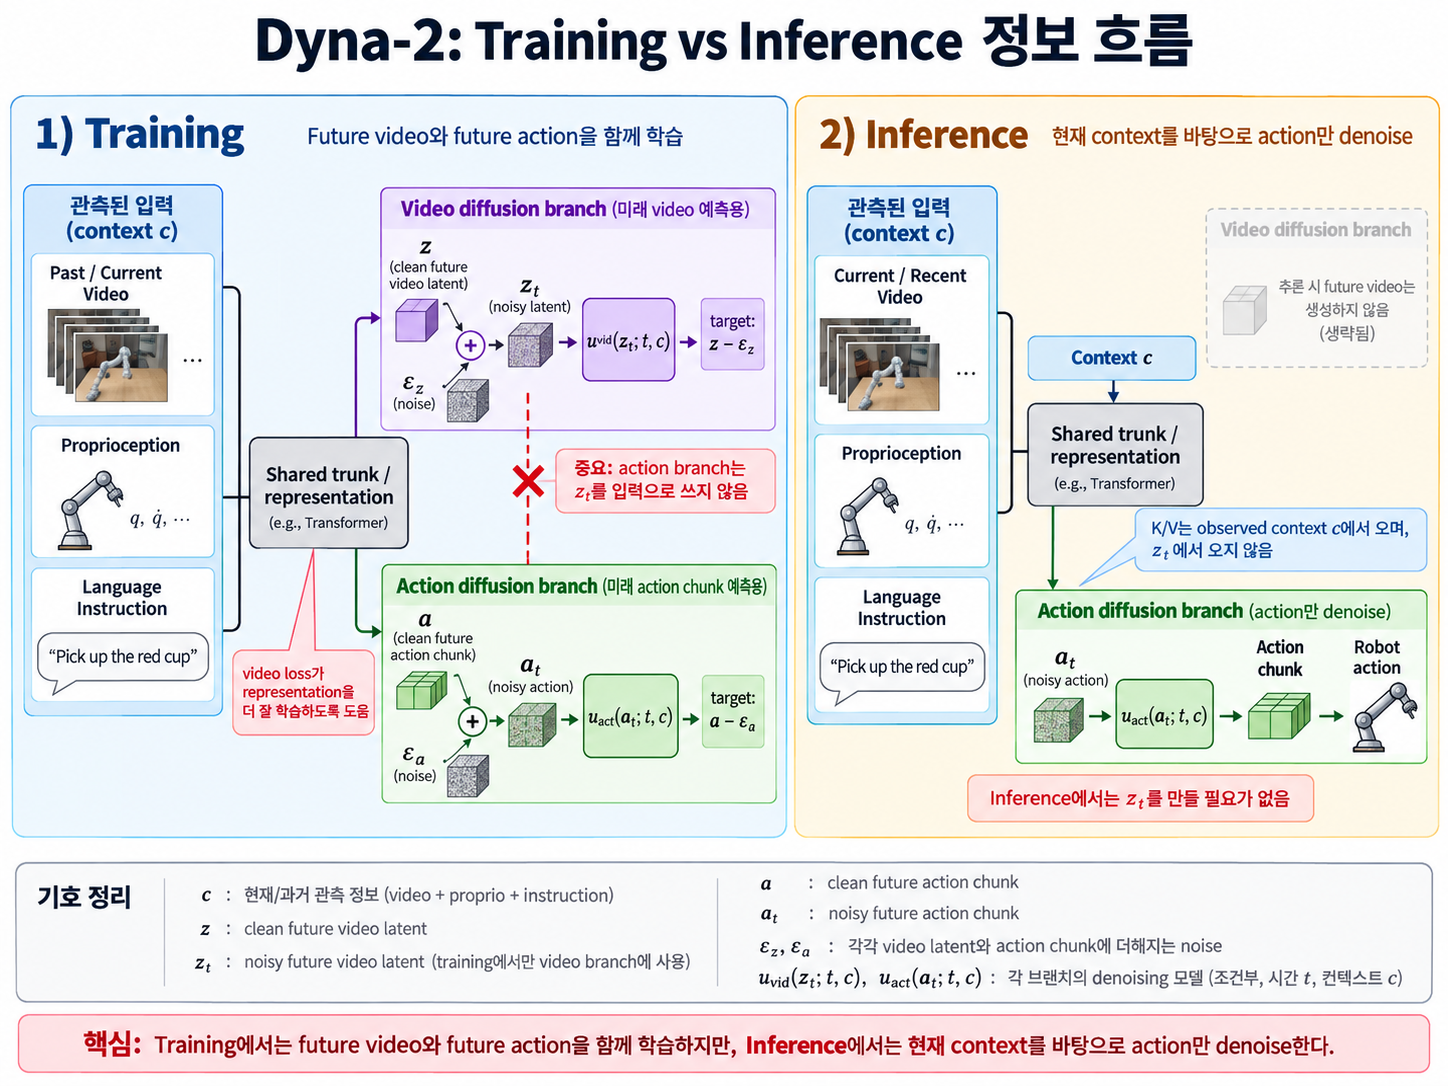
간략하게 설명하면 다음과 같다.
- 학습 단계에서는 Video diffusion과 Action diffusion 두 objective를 함께 학습한다.
- 두 branch는 각각 미래 video와 action을 예측하지만, 일부 representation을 공유한다.
- 추론 단계에서는 Action diffusion branch만 사용하여 action chunk를 생성한다.
그러면 자연스럽게 이런 질문이 생긴다.
Video diffusion branch는 추론에서 쓰지도 않는데 왜 학습할까?
Video diffusion branch는 일종의 보조 학습 목표(auxiliary objective) 이다.
(조림을 만들 때 사용하는 마늘이나 양파와 비슷하다. 최종 요리에서는 건져낼 수도 있지만, 조리 과정에서 메인 재료에 맛을 더해준다.)
마찬가지로 Video diffusion은 모델이 현재 장면으로부터 미래가 어떻게 변할지를 예측하도록 강제한다. 이를 통해 shared Transformer의 representation이 물체의 움직임, 접촉, 상태 변화 등 환경의 dynamics를 더 잘 표현하도록 학습된다.
동시에 Action diffusion loss는 이 representation이 어떤 action을 수행해야 하는지도 잘 표현하도록 학습한다.
따라서 training 동안 representation은
future dynamics를 이해하는 능력 + action을 생성하는 능력
을 함께 갖도록 학습되고, inference에서는 이렇게 학습된 representation을 이용해 Action diffusion만 실행한다.
Training loss function
Dit4Dit와 동일하게 Video diffusion, Action diffusion 두가지를 학습한다.
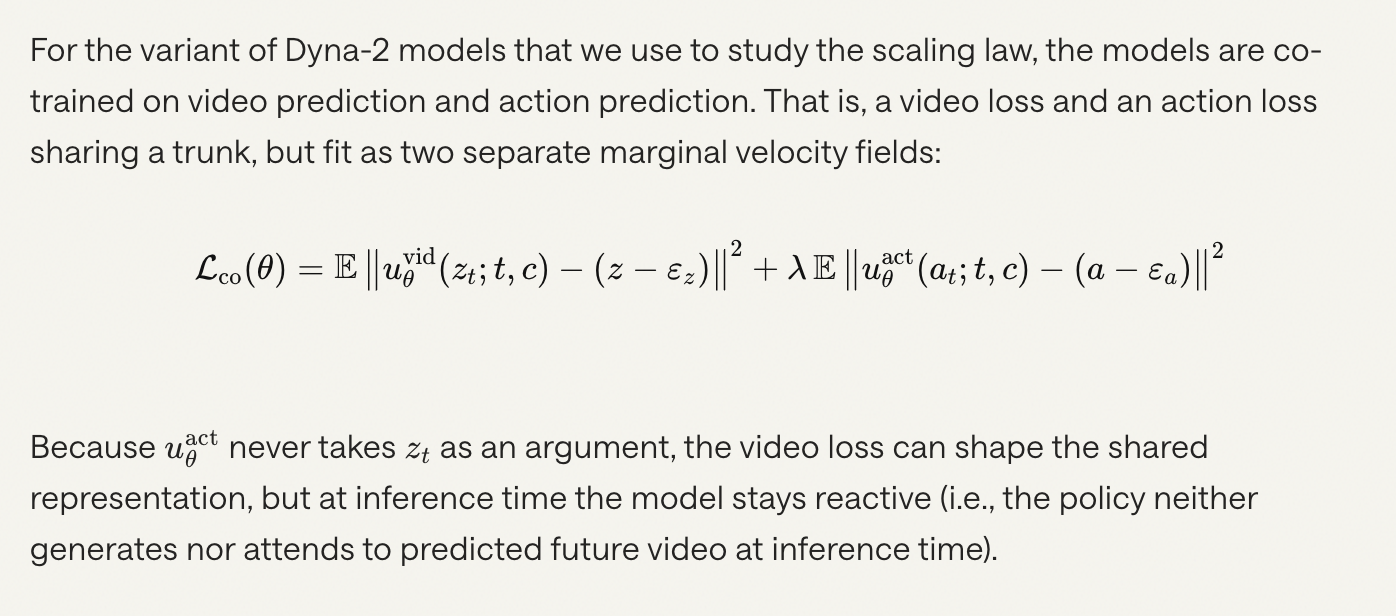
training 단계에서 핵심적인것은, 왼쪽이 video diffusion 학습 오른쪽에 action chunk diffusion 학습인데, 여기서 중요한 것은 action diffusion에서 video의 latent z_t가 쓰이지가 않는 다는 점이 핵심이다.
Inference
- Action flow는 noisy action 자체를 입력으로 받는다: $u_\theta^{act}(a_t; t,c)$
- (language는 action에 직접 들어가지 않고 context video token을 거쳐서 들어간다.) 여기서 $c$는 conditioning information의 묶음이다.
- 기본 co-training / scaling-law variant의 inference는 다음처럼 이해하면 된다.
- 여기서 다시말하지만 핵심은 z_t를 사용하지 않는다는 점이 핵심이다. → “The policy neither generates nor attends to predicted future video at inference time”
핵심 구분
- $c$ = 이미 관측된 정보 → memory / condition
- predicted future video tokens = 앞으로의 장면을 denoise하며 만드는 정보 → imagination / prediction
- 기본 inference: $a_t+c$만 사용
- $L_{joint}$: 여기에 predicted future video tokens까지 추가로 연결
Experiment Results
핵심 결론: Dyna-2는 단순히 “human video가 많을수록 좋아진다”가 아니라, future video prediction(world modeling)을 같이 학습해야 human → robot transfer scaling이 나타난다는 것을 실험으로 보여준다.
1. Human-data scaling law
- Pre-training data를 1K → 10K → 100K → 1M hours로 증가시키고, held-out human manipulation data에서 평가.
- MSE, L1, accuracy@0.5, accuracy@0.1 모두 데이터 증가에 따라 monotonic improvement.
- 특히 precision metric인 accuracy@0.1은 전체 scale ladder에서 약 51% 증가, MSE는 약 12% 개선.
- 결론: 같은 human embodiment 안에서는 manipulation prediction 성능이 1M hours까지 power-law 형태로 계속 향상됨.
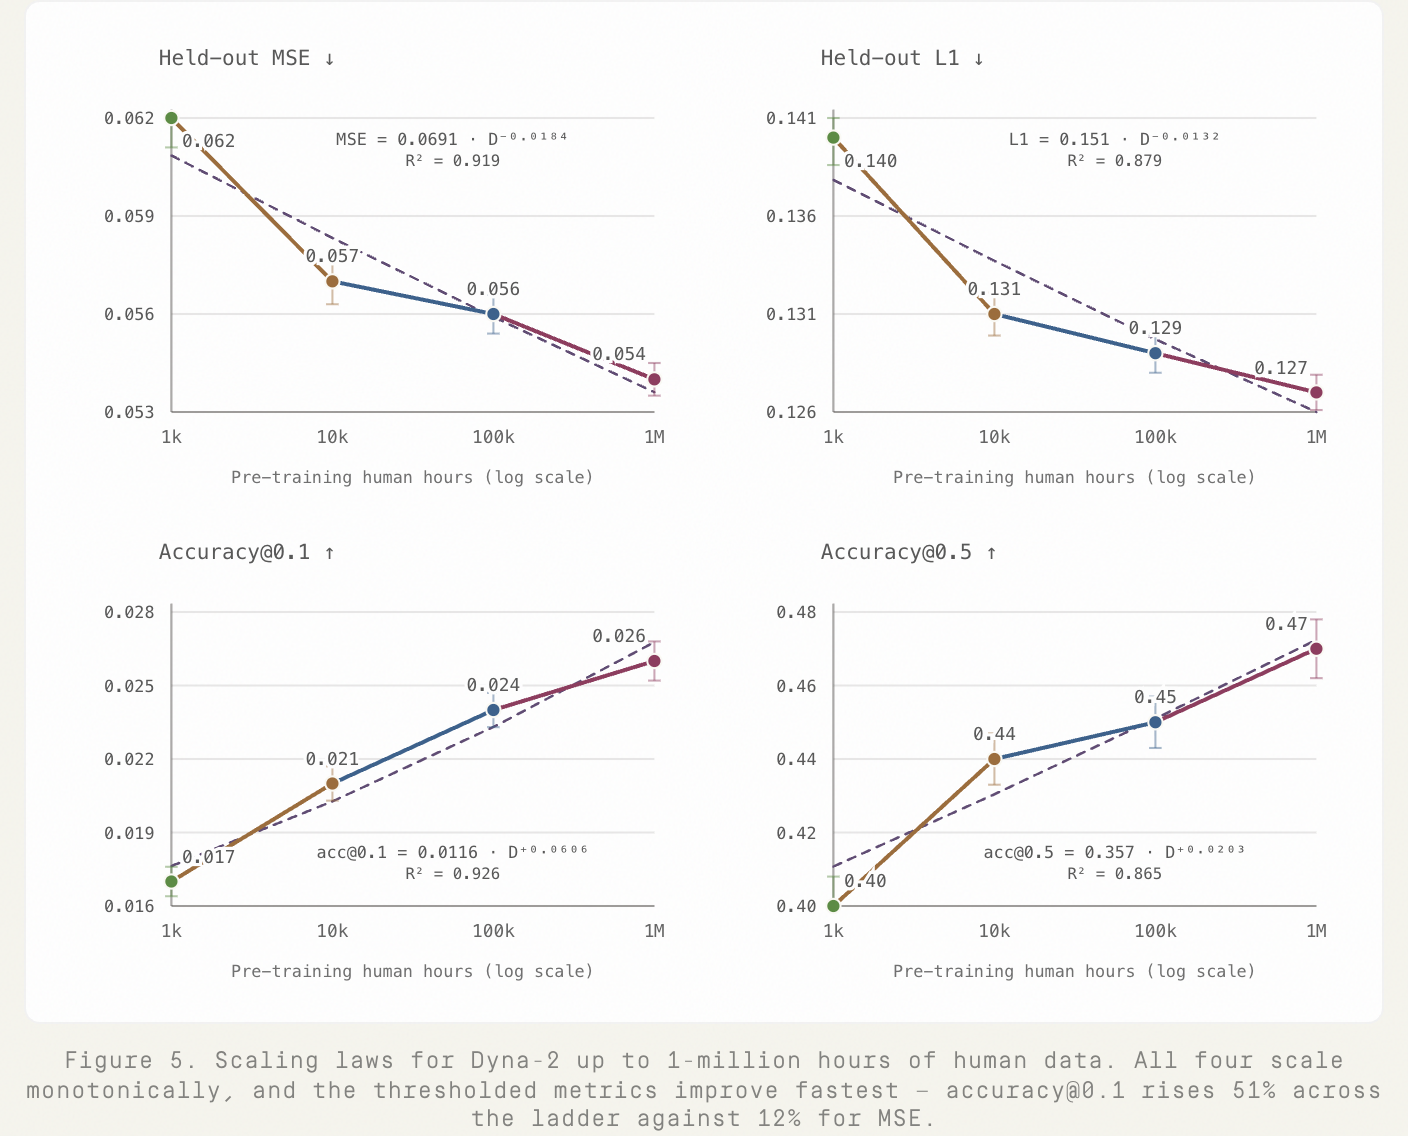 Dyna-2 블로그 Figure 5: human data 1K → 1M hours에 따른 held-out human 평가 지표
2. Human → Robot transfer scaling law
- Human data로만 pre-train하고, pre-training에서 한 번도 보지 않은 robot dataset 39 tasks에 zero-shot offline evaluation.
- 39 tasks = 두 종류의 양팔 YAM 플랫폼. Dyna 내부 benchmark 12개 + xdof ABC 27개
- robot data는 cloth handling, knot tying, packing, cleaning, food service, assembly 등 다양한 manipulation task를 포함.
- human pre-training scale이 커질수록 robot prediction metric도 monotonic하게 개선.
- 특히 10K → 100K hours 사이에서 큰 inflection이 관찰됨.
- 핵심: human data scale 자체가 embodiment gap을 넘어 robot prediction을 개선할 수 있다는 결과.
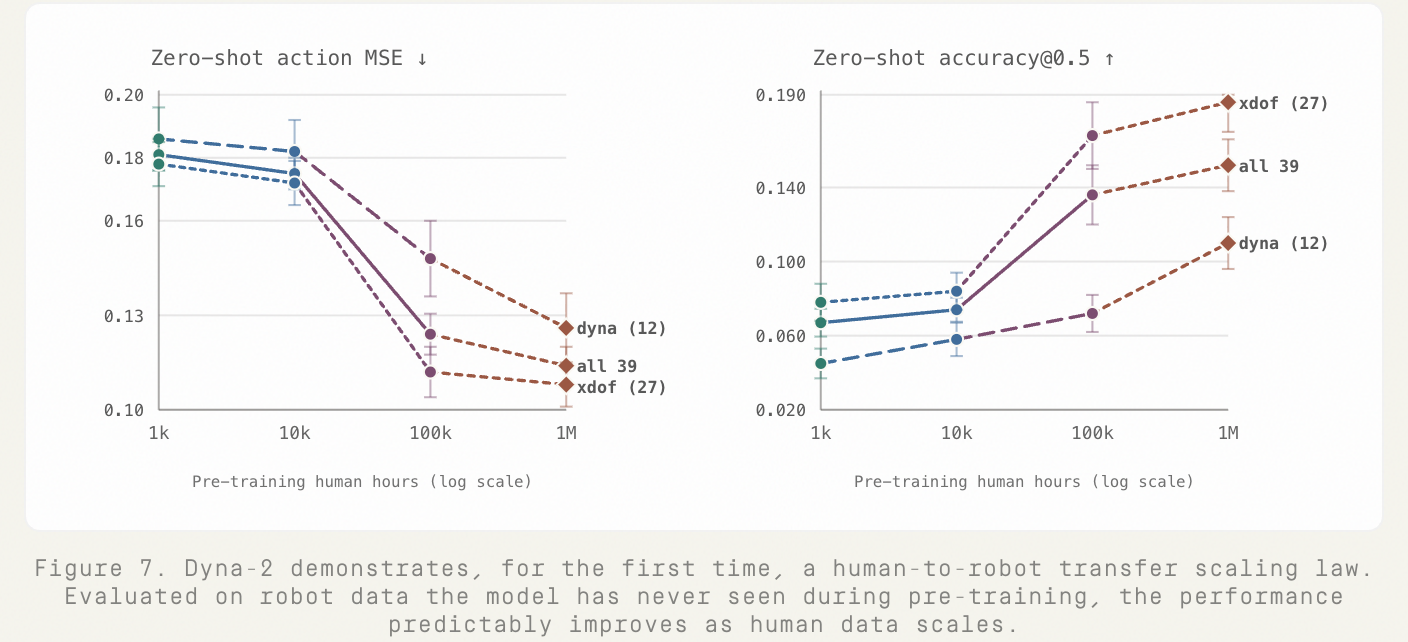 Dyna-2 블로그 Figure 7: pre-training에서 본 적 없는 robot data 39 tasks에 대한 zero-shot 지표. dyna 12 tasks + xdof 27 tasks
3. 실제 robot post-training에서도 scaling이 유지되는가?
- 각 1K / 10K / 100K / 1M human-pretrained checkpoint를 동일한 robot task data로 post-train.
- 14개의 real-robot tasks, 3가지 embodiment에서 평가. (task당 robot data는 최대 10시간)
- 11 tasks: 6-DOF YAM 양팔 + parallel-jaw gripper
- 2 tasks: 같은 팔에 20-DOF dexterous hand(WUJI-2)
- 1 task (language following): semi-humanoid 초기 prototype
- 평균 normalized score:
- 1K: 20%
- 10K: 28%
- 100K: 45%
- 1M: 53%
- 1M-hour model이 14개 task 중 9개에서 best.
- Lockbox Key Turning: 100K 이하에서는 실패, 1M-hour model은 90% 성공.
- Bottle Cap Untwisting: pre-training scale에 따라 10% → 10% → 40% → 50%로 향상.
- 별도로, 단 10분의 teleoperation data만으로 두 개의 다섯손가락 로봇 손으로 bottle cap을 여는 것까지 fine-tune했다고 한다.
- Language task(Targeted Drink Retrieval): 58% → 83%.
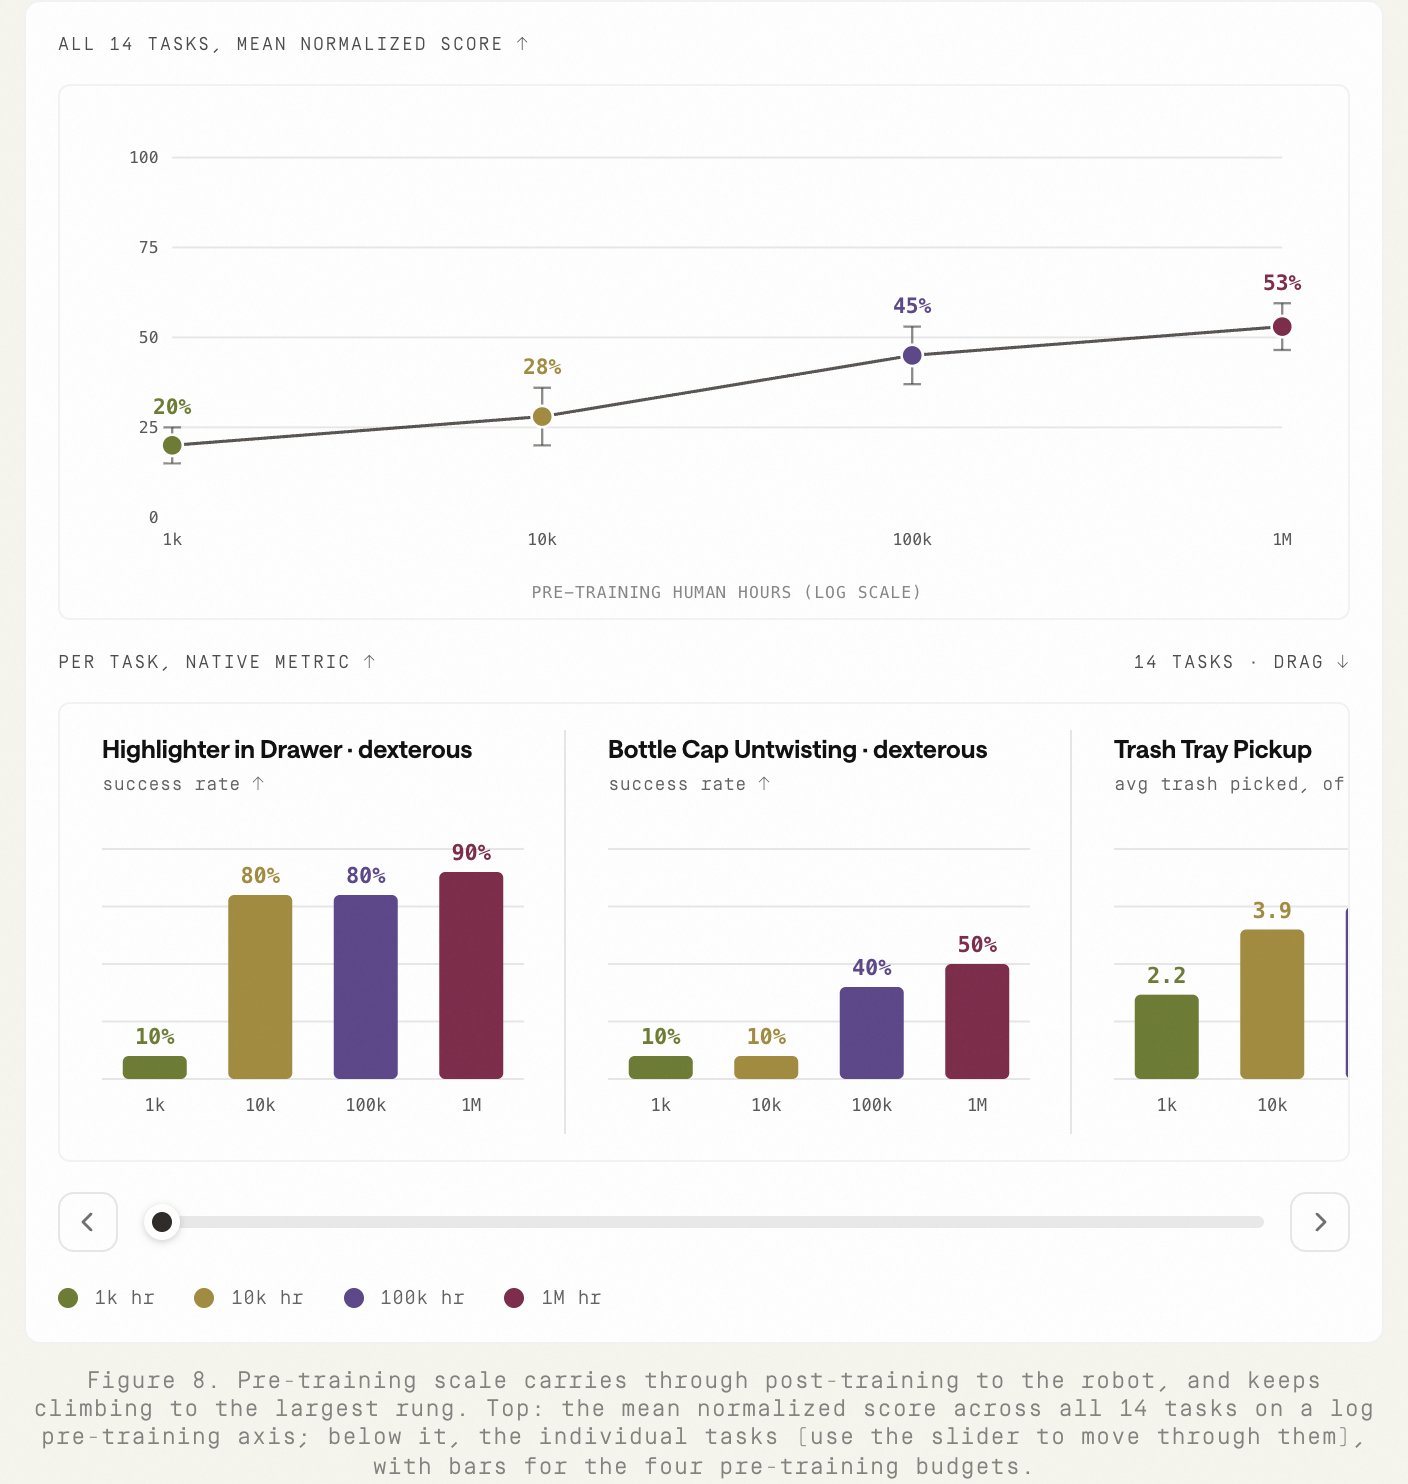 Dyna-2 블로그 Figure 8: 위는 14 tasks 평균 normalized score, 아래는 task별 결과
4. 무엇이 cross-embodiment scaling을 만드는가?
세 가지 training recipe를 같은 action-data scale에서 비교:
- Action-only: action loss만 사용
- Joint: 같은 dataset에서 action + future video를 함께 예측
- Video co-training: joint + action label이 없는 추가 human video도 future-video prediction에 사용
결과:
- Joint > Action-only: 모든 action scale에서 39/39 robot tasks 전부 joint가 우세.
- Action-only는 scale이 커질수록 severe overfitting이 나타남.
- Joint는 overfitting이 줄지만, data scale에 따라 계속 좋아지는 scaling은 약함.
Video co-training만 action data가 증가할수록 확실하게 scaling.
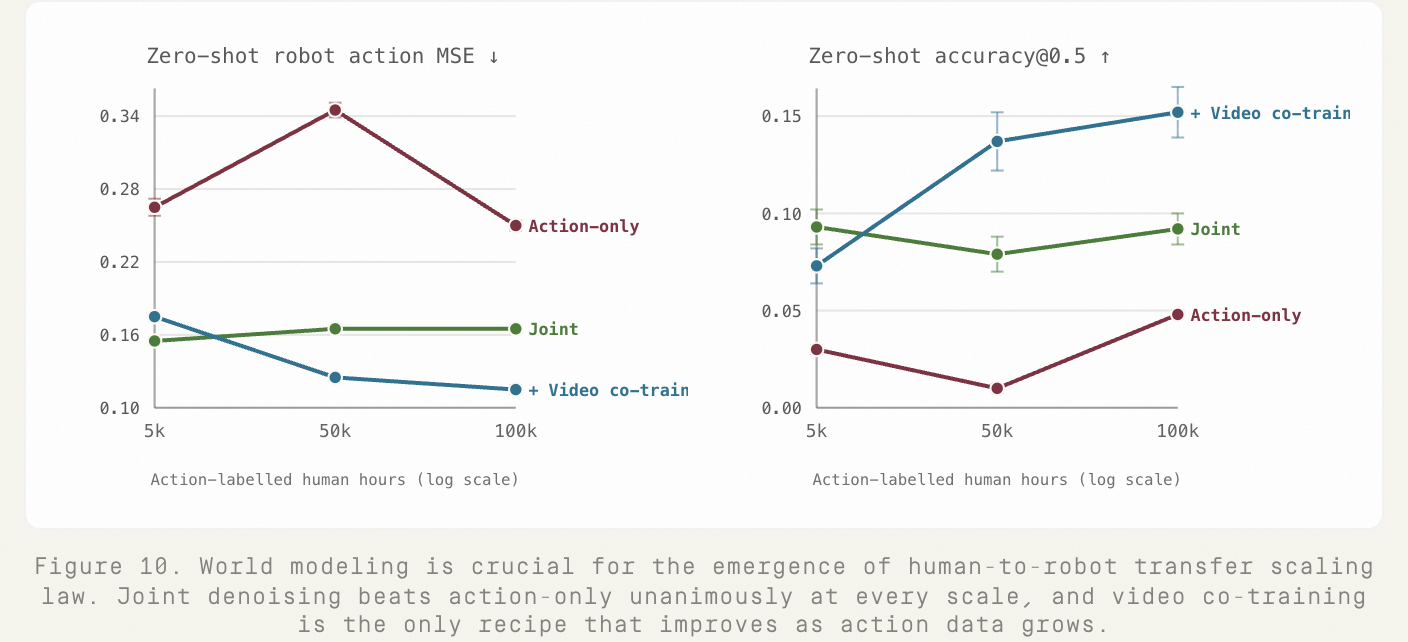 Dyna-2 블로그 Figure 10: Action-only vs Joint vs Video co-training
5. Video is the new scaling axis
- Action-labelled human data를 고정하고, video-only data만 증가시켜 실험.
- 예: action data 50K hours 고정, video-only data를 0 → 1K → 10K → 50K hours로 증가.
- 더 큰 setting에서도 action data 250K hours에 video-only 0 → 250K → 750K hours를 추가.
- 결과: video-only data를 scale하는 것만으로 held-out robot generalization이 monotonic하게 향상.
- 반면 held-out human evaluation은 거의 좋아지지 않거나 약간 나빠질 수 있음.
- 해석: video world-modeling의 가장 큰 효과는 same-embodiment fit이 아니라 cross-embodiment generalization.
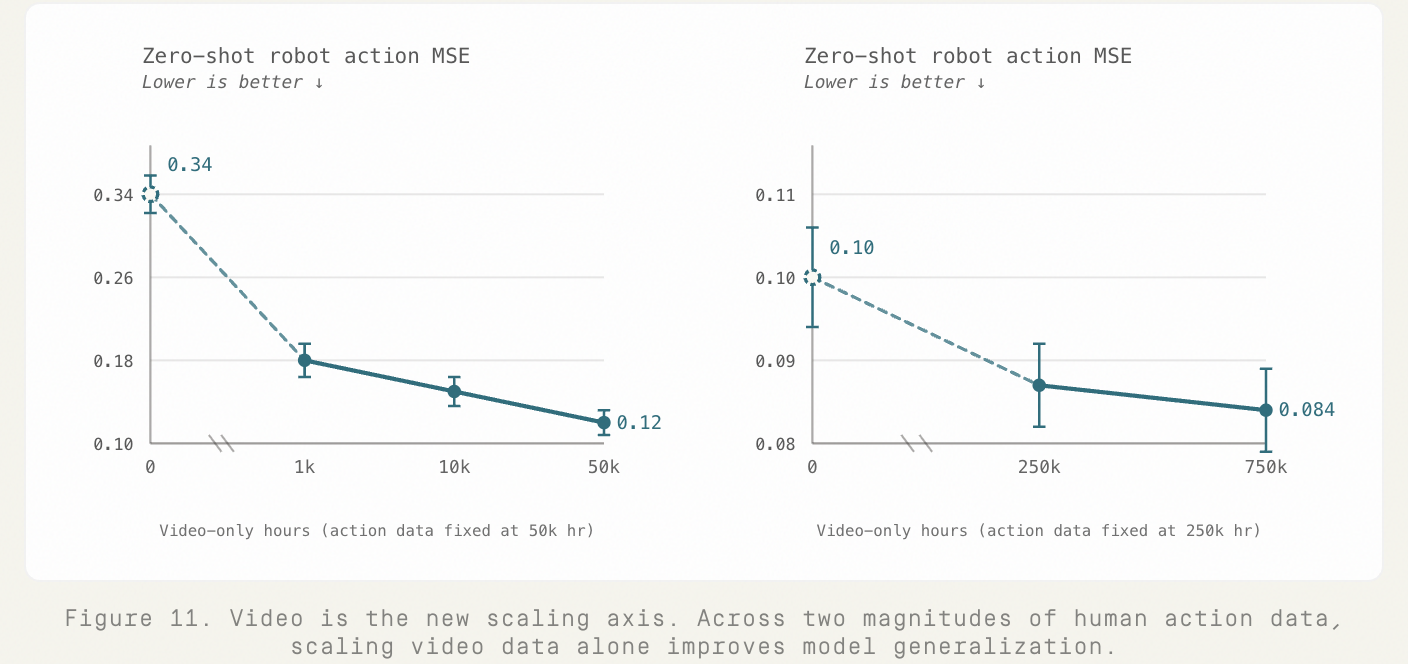 Dyna-2 블로그 Figure 11: action data는 고정하고 video-only data만 늘렸을 때 robot MSE
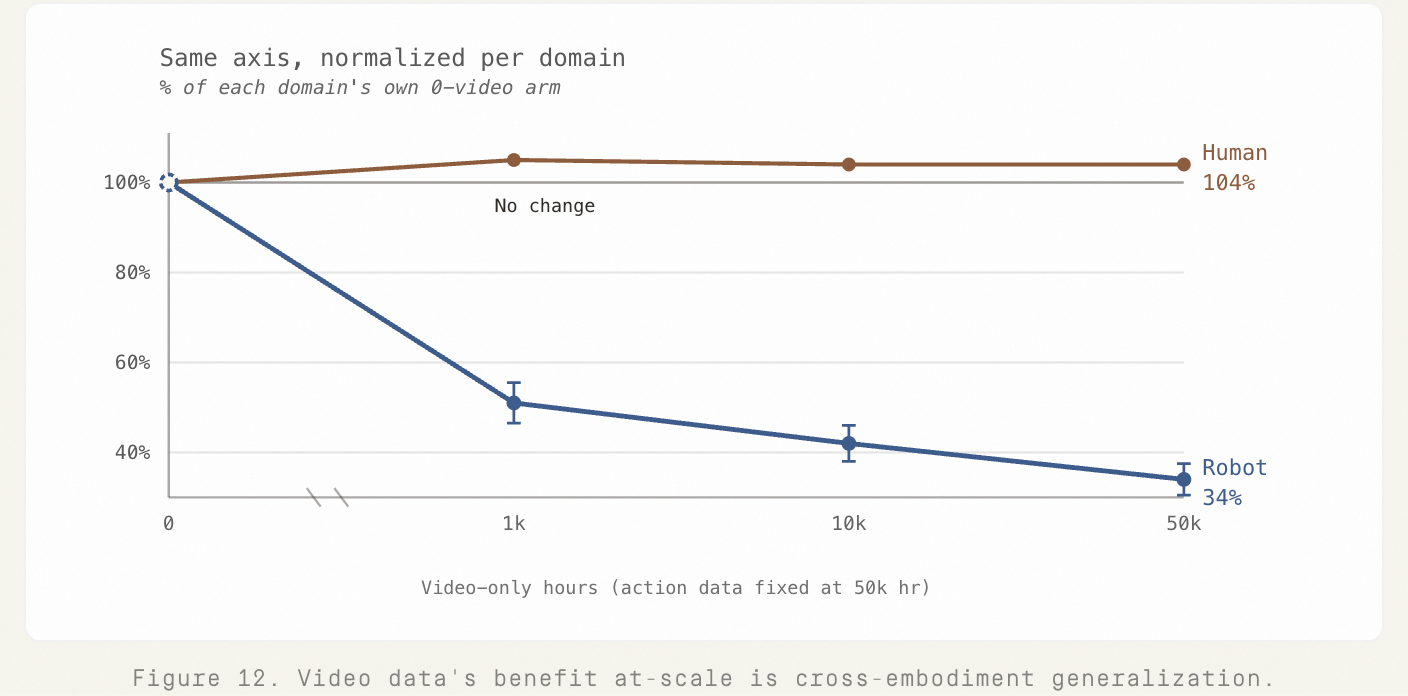 Dyna-2 블로그 Figure 12: 같은 축에서 비교하면 human 평가는 그대로(104%), robot 평가는 크게 좋아짐(34%). MSE라서 낮을수록 좋다
6. 추가 실험 결과
- Zero-shot real-world deployment: unseen customer site에서 production pass rate가 Dyna-1 46% → Dyna-2 87%. → 새로운 환경 적응
- Language following: action-only pre-training 35% → video co-training early Dyna-2 67% → full Dyna-2 96%.
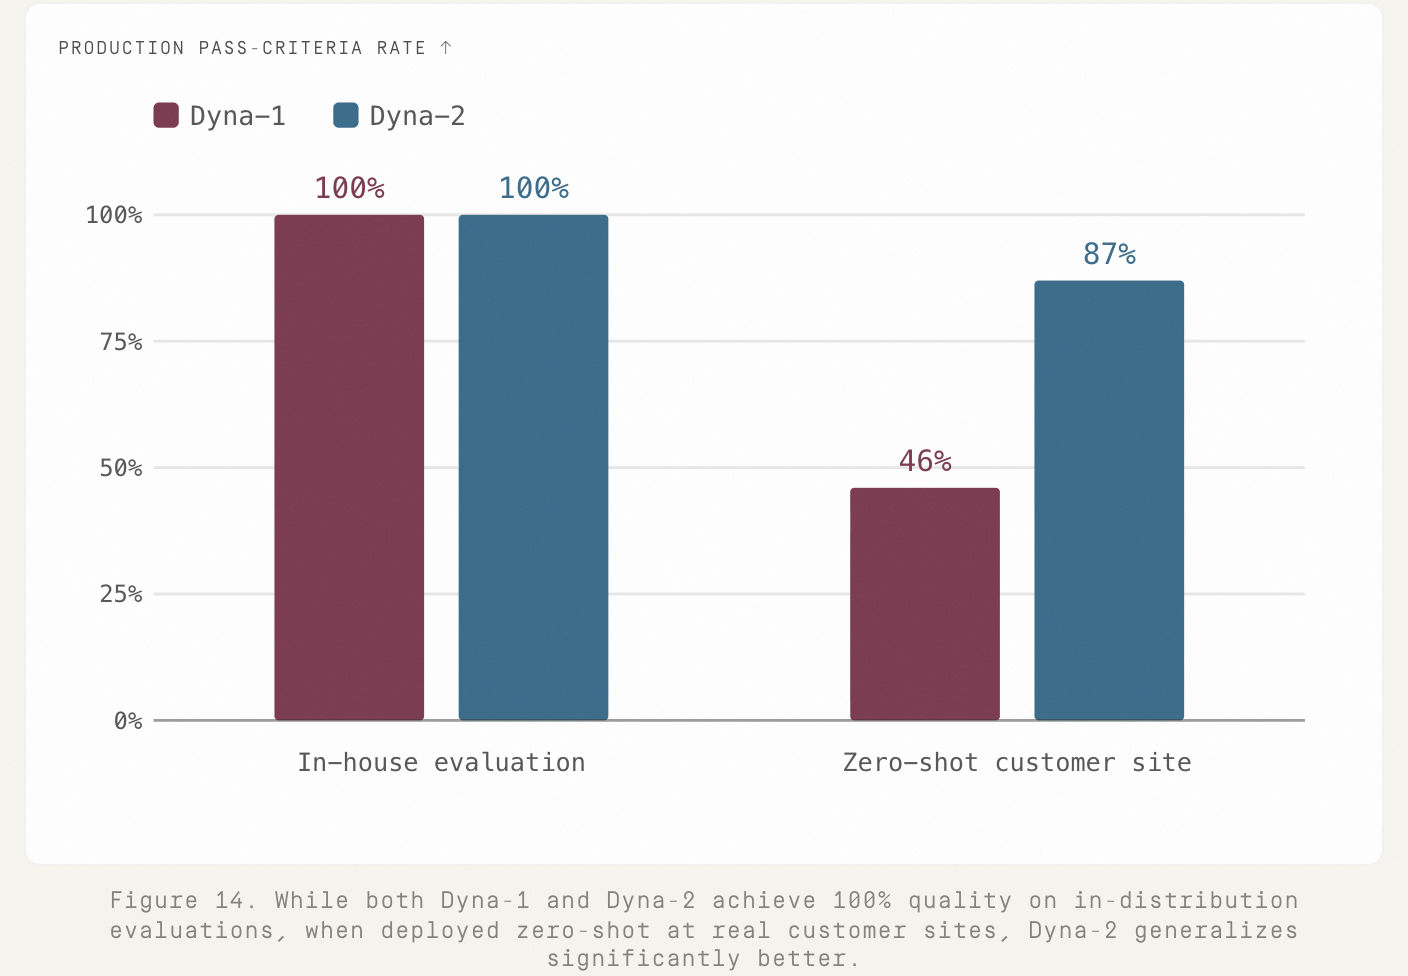 Dyna-2 블로그 Figure 14: in-house에서는 둘 다 100%, 처음 가보는 고객 현장에서는 Dyna-1 46% vs Dyna-2 87%
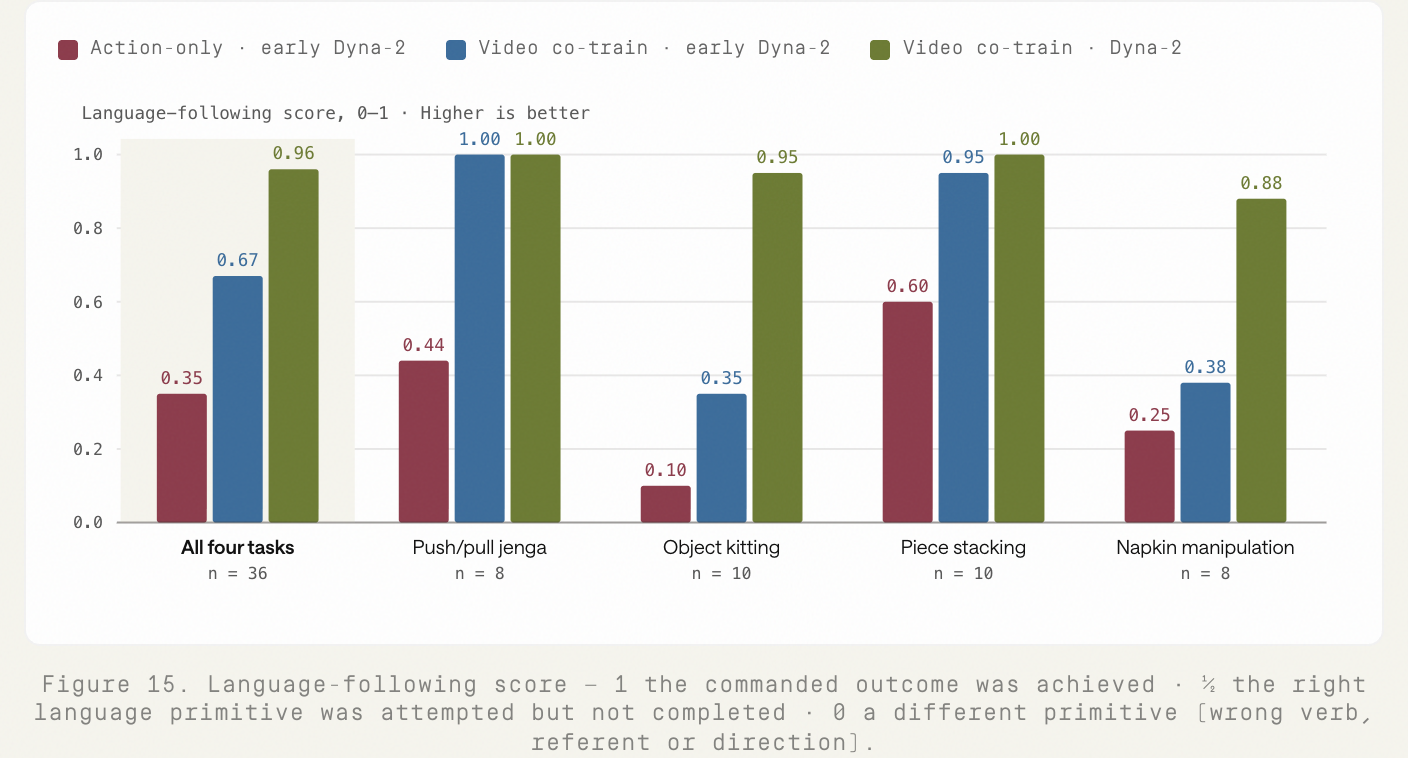 Dyna-2 블로그 Figure 15: language-following score
- Robustness: altered lighting, dark environment, top camera loss, 반복적인 disturbance에서도 task를 지속.
- Goal persistence: fixed number of cycles를 수행하는 것이 아니라 실제 goal state가 충족될 때까지 행동을 계속하는 qualitative behavior를 보임.
- One-step video generation: distillation 후 3-second, 3-view future video inference를 약 10.2 s → 110 ms, 약 93× speedup.
WAM vs. VLA
이 비교의 핵심은 “WAM이 더 크거나 더 많은 데이터를 써서 이긴다”가 아니라, 같은 data / post-training / hyperparameter 조건에서 world-modeling 구조 자체가 어떤 이점을 주는가를 보는 것이다.
비교 설정
- VLA baseline = Dyna-1
- Qwen3-VL-4B에서 initialize된 production VLA architecture
- vision + language representation에서 action을 직접 predict
- WAM = early Dyna-2
- video-diffusion 기반 world-action architecture
- 당시 버전은 현재 Dyna-2보다 오히려 불리한 조건: 1M-hour pre-training도 없었고, 최신 world-modeling recipe도 완성 전
- 두 모델은 same pre-training data, same post-training data, same hyperparameters로 비교.
- 각 architecture마다 3개의 서로 다른 pre-training checkpoint에서 post-training하여 checkpoint bias를 줄임.
결과
- 7개 benchmark task 전체를 pooling했을 때:
- WAM success rate = VLA의 1.55×
- WAM quality grade = VLA의 1.12×
- checkpoint와 task를 동일하게 맞춘 head-to-head 비교:
- WAM 승리: 65%
- VLA 승리: 29%
- Tie: 6%
- VLA가 이긴 대부분의 경우는 가장 이른 pre-training checkpoint에서 발생. 즉 pre-training이 진행될수록 WAM의 advantage가 더 커짐.
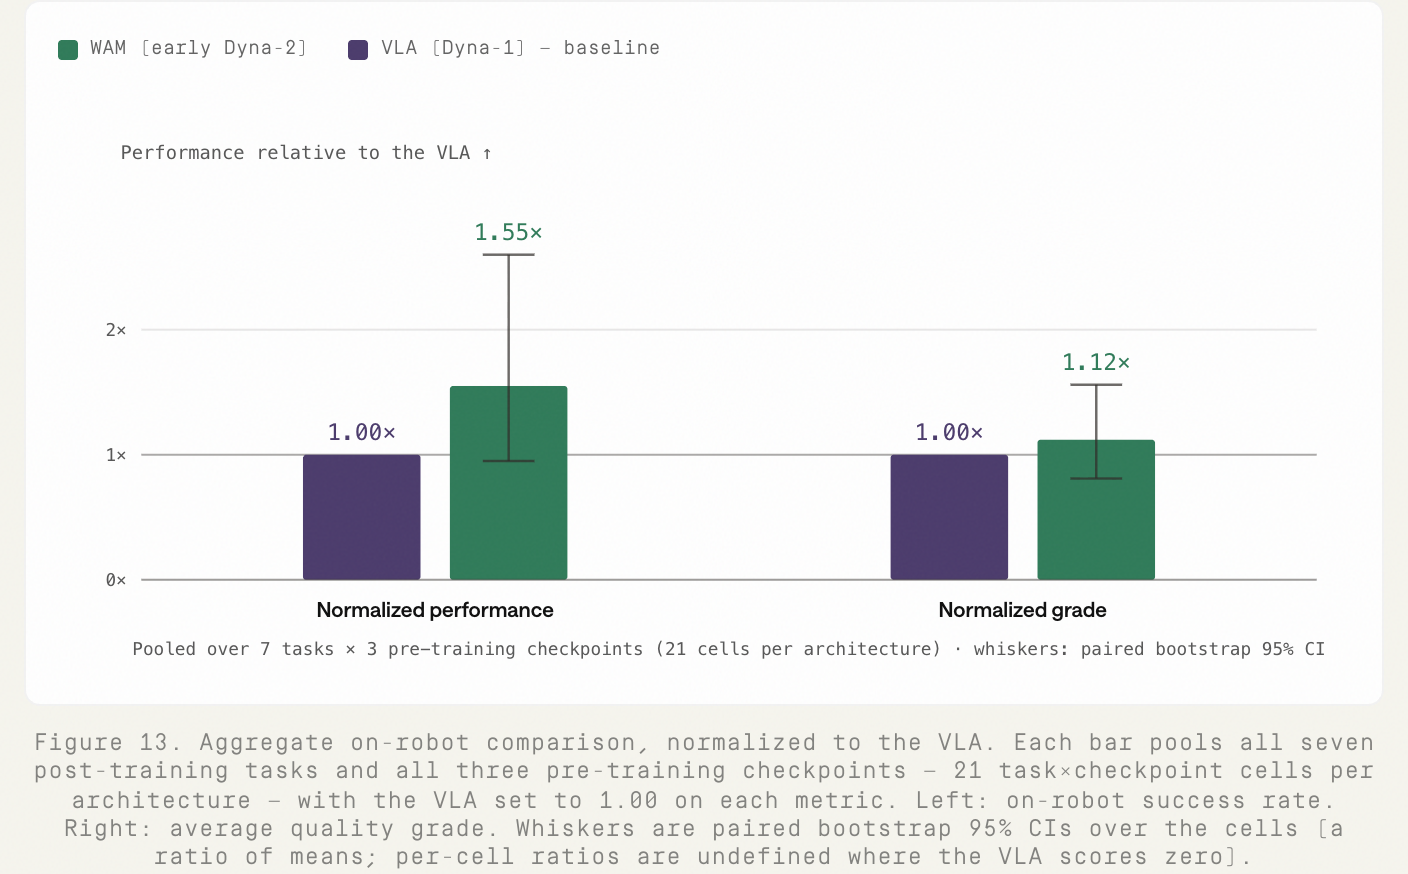 Dyna-2 블로그 Figure 13: VLA를 1.00으로 놓고 normalize한 on-robot 비교
Qualitative difference
- Vegetable chopping에서 Dyna-2가 Dyna-1보다 더 얇고 균일한 cut을 생성하고 expert demonstration에 더 가까움.
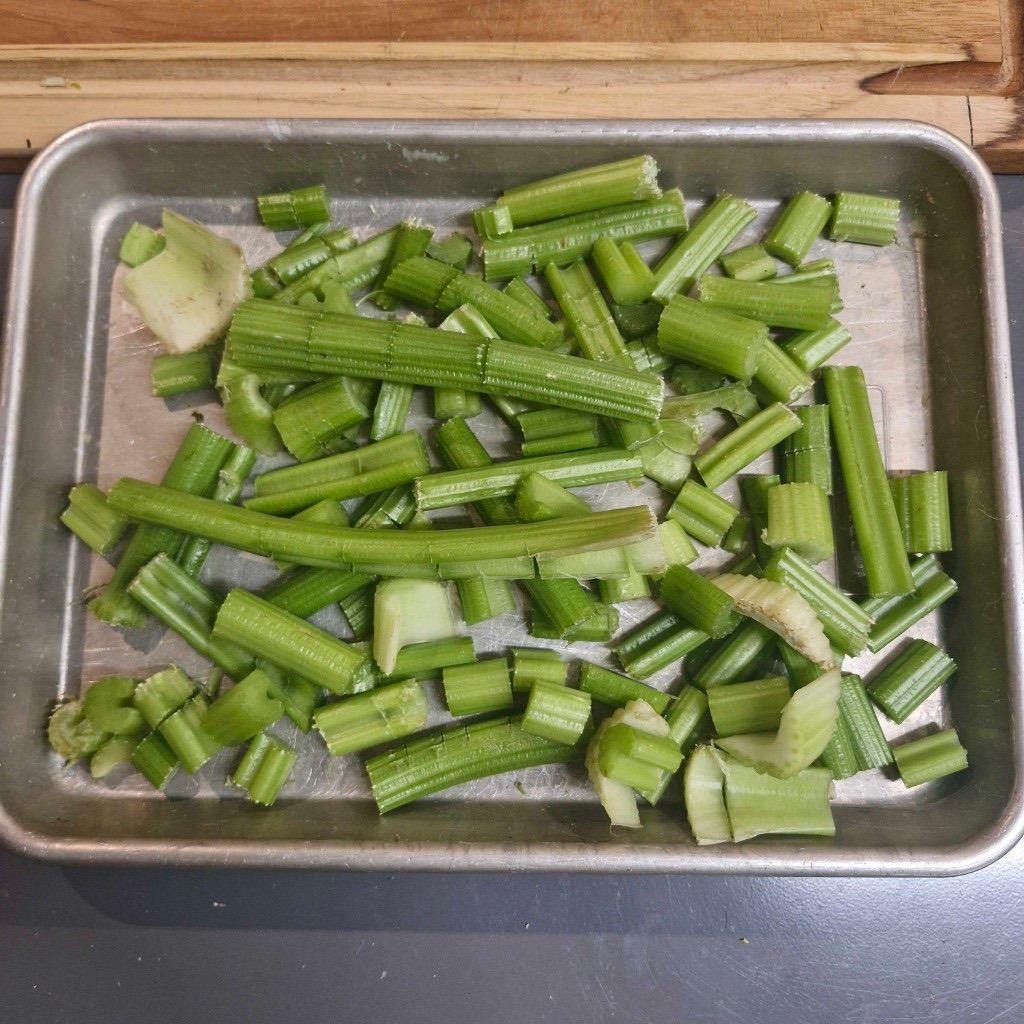 VLA = Dyna-1이 자른 셀러리
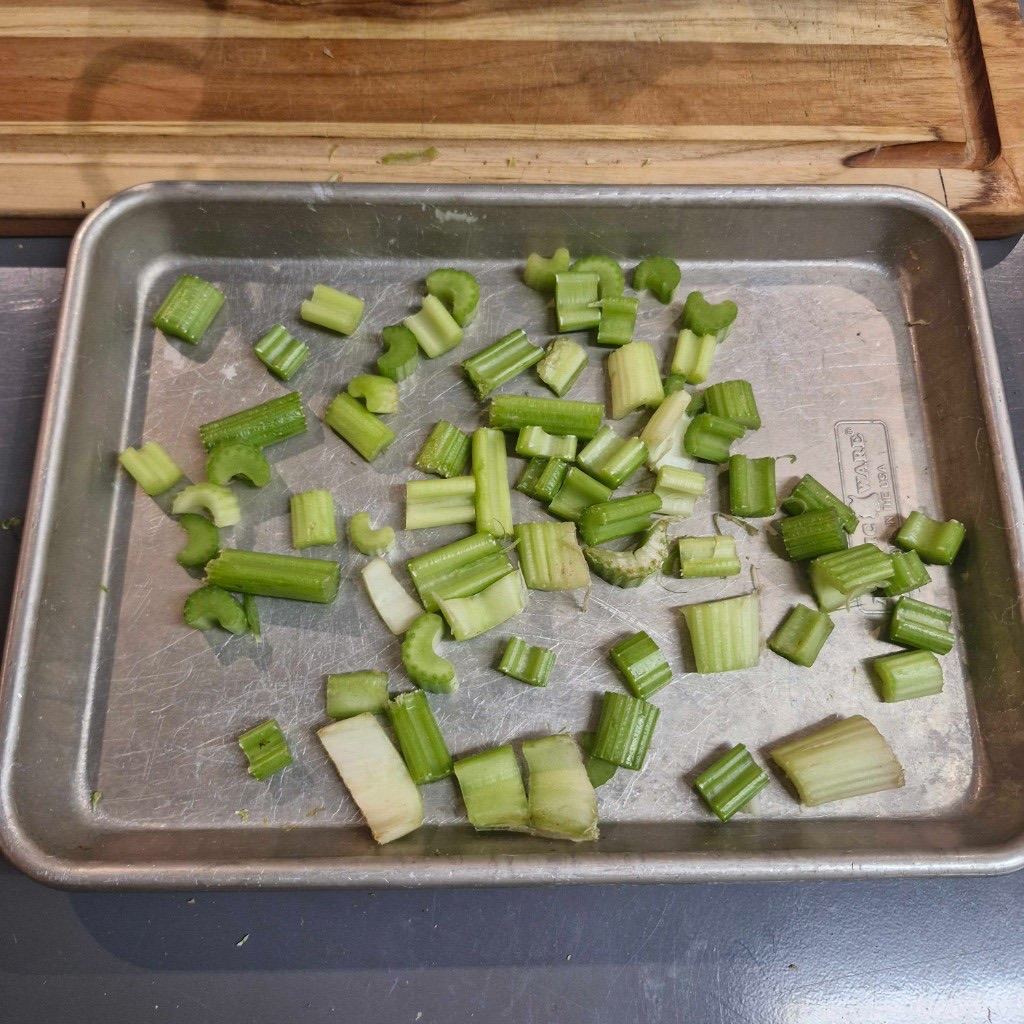 WAM = early Dyna-2가 자른 셀러리
- Dyna-1은 small post-training dataset 환경에서 disturbance에 brittle했지만, Dyna-2는 lighting 변화 / darkness / 일부 visual input loss / 반복 disturbance에서도 task를 계속 수행.
왜 WAM이 VLA보다 강할 수 있는가?
- VLA는 기본적으로
를 직접 학습한다.
- WAM은 action prediction과 함께
를 같이 학습한다.
- 따라서 representation이 단순 object/semantic feature뿐 아니라 motion, contact, temporal evolution, object transformation을 담도록 강제된다.
- 이 world-modeling objective가 새로운 embodiment에서도 재사용 가능한 physics/dynamics prior를 형성한다고 Dyna는 해석한다.
VLA: “현재 장면에서 무슨 action을 해야 하지?”를 직접 학습
WAM: “현재 장면이 앞으로 어떻게 변해야 하지?” + “그 변화를 만들 action은 무엇이지?”를 함께 학습
→ Dyna-2의 실험에서는 이 world prediction objective가 robustness, language following, cross-embodiment transfer에서 유리하게 작용했다.
주의할 점
- 이 결과만으로 모든 WAM이 모든 VLA보다 항상 우월하다고 일반화할 수는 없음.
- 비교 대상은 Dyna 내부의 specific architecture인 Dyna-1 vs early Dyna-2이고, 논문도 community 전체에서 WAM vs VLA 우열에 아직 consensus가 없다고 명시.
- 다만 이 연구의 강한 empirical message는 action-only scaling보다 world-modeling + video scaling이 embodiment generalization을 훨씬 잘 만든다는 점이다.
나의 생각
- Joint training이 action-only보다 좋은 사실 자체는 이미 어느 정도 알려져 있었다. 같은 trajectory에서 video와 action이 서로 매핑된 paired data를 사용하고, action loss와 future-video/world-modeling loss를 같이 주는 방식이다.
- Dyna-2에서 더 흥미로운 부분은 action-labeled data의 양을 고정한 상태에서, action과 직접 매핑되지 않은 추가 egocentric video-only data를 더 넣었을 때도 robot performance가 계속 좋아졌다는 점이다.
- 즉 핵심은 단순히 “video + action을 같이 학습하면 좋다”가 아니라,
라는 scaling이 나타났다는 것이다.
- 이것은 robot action data를 더 많이 수집하지 않아도, 대규모 human video를 통해 world dynamics prior를 확장하면 cross-embodiment transfer가 가능하다는 의미로 볼 수 있다.
- 따라서 Dyna-2의 가장 강한 메시지는 Action scaling보다 Video scaling이 새로운 성능 축이 될 수 있다는 점이라고 생각한다.
Training recipe를 최종적으로 이해한 방식
- Action-only: action-labeled human data로 action loss만 학습한다. World prediction objective가 없고, scaling/generalization이 가장 약하다.
- Joint: 같은 sample 안에 video와 pseudo-action이 pair로 존재하므로, future video와 future action을 함께 joint modeling한다. (내 추정) 아키텍쳐 그림의 “ℒ joint only” 점선을 보면, 이 경우에만 action stream이 predicted future-video stream까지 직접 attend하는 것으로 보인다. 단, 실험의 “Joint” 레시피가 이 ℒ_joint 구조와 같은지는 원문에 명시돼 있지 않다.
- Video co-training: 기존 paired action-video data는 유지하면서, action label이 없는 대규모 human video를 추가한다. 추가 video에는 action pair가 없으므로 video prediction loss만 걸린다. (내 추정) 기본 모델처럼 action branch는 predicted future-video latent를 직접 입력받지 않는 것으로 보인다. 대신 shared representation/world prior가 좋아져 robot generalization이 향상된다.
핵심: Dyna-2의 scaling law는 future video를 action에 직접 보여줘서 성능이 오른 것이 아니라, unpaired human video를 대규모로 추가해 world-model representation을 더 강하게 만들었더니 robot action 성능도 같이 오른 것이다.