
DiT4DiT: Jointly Modeling Video Dynamics and Actions
DiT4DiT는 Video DiT가 미래를 상상하는 과정의 중간 hidden feature를 꺼내 Action DiT에 넘긴다. 핵심 흐름, 3개의 timestep, 그리고 hidden layer는 누가 정하는지까지 정리한다.
Reference
DiT4DiT: Jointly Modeling Video Dynamics and Actions for Generalizable Robot Control
Overview
핵심: Video Action Model (VAM)
- bidirectional Video Diffusion Transformer (DiT)
- 미래를 상상하는 힘을 학습한다.
- 구성: Video DiT = Cosmos-Predict2.5-2B (language 조건은 Cosmos-Reason1 embedding) + Action DiT = GR00T-N1의 action head 구조
(1) can video generation itself serve as an effective training objective for robust action policies?
(2) how should the spatiotemporal representations learned by video models be extracted and coupled with action generation?
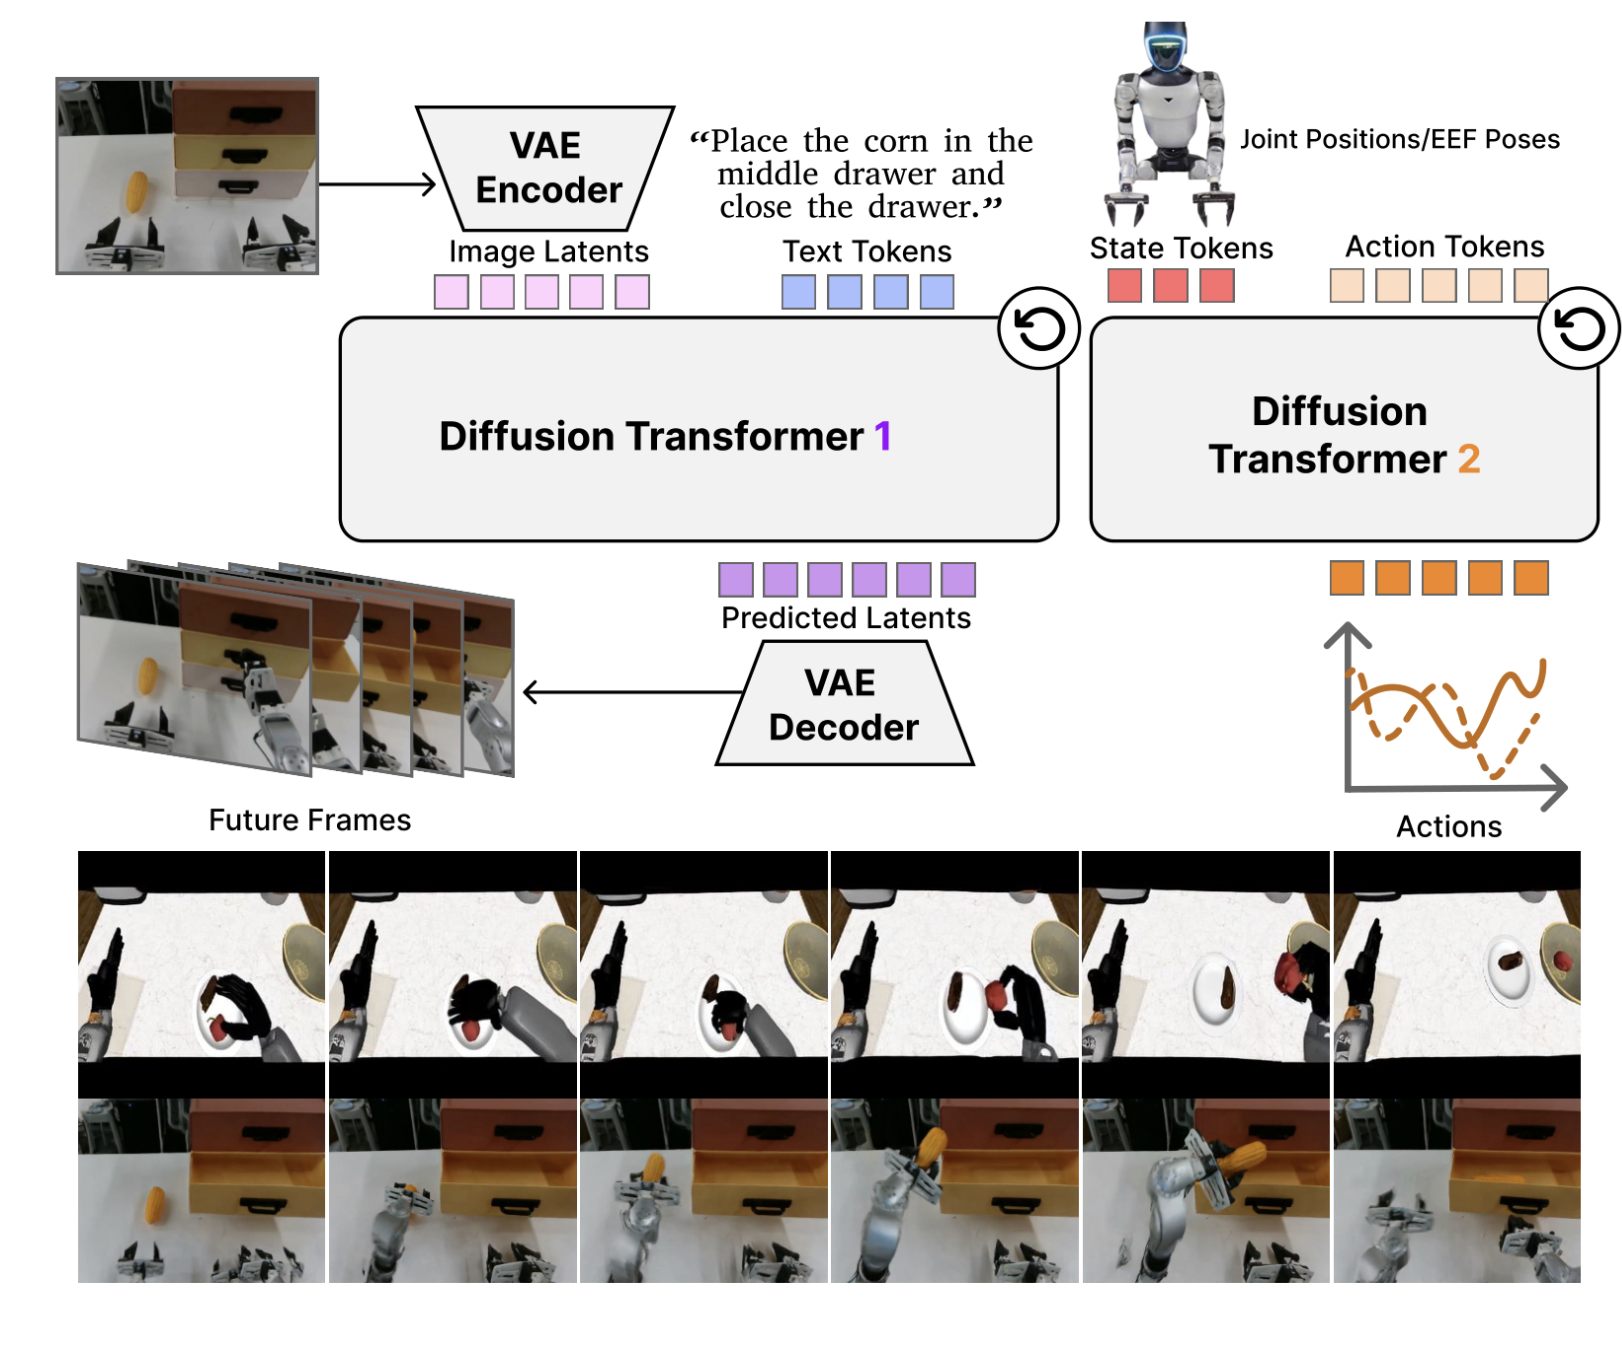 전체 아키텍쳐
Video DiT: 핵심 흐름
- 현재/미래 관측을 latent로 압축
- $o_t, o_{t+1}$: pixel-space observation
- $z_t^0, z_{t+1}^0$: clean latent
- 미래 latent에 noise를 넣고 복원 문제를 만든다 (Diffusion mechanism)
그리고 Video DiT는 현재 상태와 language를 조건으로 noisy future latent를 clean future latent 방향으로 복원한다. (training 단계에서)
\[v_{\theta}^{\mathrm{video}}\left(z_{t+1}^{\tau_v},\tau_v \mid z_t^0,l\right)\] \[z_{t+1}^{\tau_v} \xrightarrow{\tau_v \to 0} z_{t+1}^0\]즉, 현재 장면 $z_t^0$ + instruction $l$을 보고 미래 장면이 어떻게 변할지를 학습한다.
- 여기서 noise 정도는 $\tau_v$ (video 학습용 timestep, uniform 샘플링)로 쓴다. 3번의 feature 추출용 $\tau_f$와는 다른 timestep이다 (아래 “3개의 timestep” 참고).
- 최종 future video가 아니라 중간 hidden feature를 사용
(그러니까 중간 hidden feature → action 디노이징에 사용함)
여기서 $\mathcal{H}[\cdot]$는 forward hook으로, Video DiT 내부의 hidden activation을 추출한다.
따라서 $h_t^{\tau_f}$는 단순 image feature가 아니라 future dynamics를 포함한 visual token으로 볼 수 있다.
- 이 feature를 Action DiT가 사용 (Cross - attention을 사용한다)
즉, Action DiT는 Video DiT가 미래 dynamics를 학습하면서 만든 feature를 참고해서 action을 생성한다.
- Action DiT는 GR00T-N1의 action head 구조를 가져왔다. 각 block은 AdaLN으로 diffusion timestep $\tau_a$를 주입하고, cross-attention으로 video feature를 본다.
- 조건은 video feature만이 아니다. 로봇의 proprioceptive state $s$도 함께 들어간다.
핵심: Video DiT는 미래 비디오를 생성하도록 학습되지만, DiT4DiT는 최종 생성 영상을 쓰지 않고 그 생성 과정 중간의 dynamics-aware hidden feature를 action prediction에 사용한다.
Loss function - training
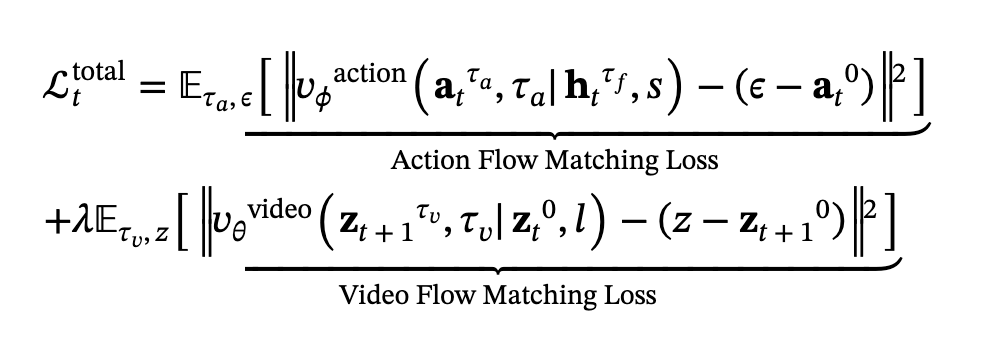
총 2개의 diffusion model 이 현재 있는 것이고, diffusion model의 학습 방식은 각 타임스탭마다 얼마나 디노이징 해야하는지 그 속도가 바로 학습 대상이다. 따라서, 두개에 대해서 각각 속도를 ground truth와 비교한다. 그리고 scale paramter : lambda를 사용한다.
\[\mathcal{L}^{\mathrm{total}}=\mathbb{E}\left[\left\|v_{\phi}^{\mathrm{action}}\left(a_t^{\tau_a},\tau_a \mid h_t^{\tau_f},s\right)-(\epsilon-a_t^0)\right\|^2\right]+\lambda\,\mathbb{E}\left[\left\|v_{\theta}^{\mathrm{video}}\left(z_{t+1}^{\tau_v},\tau_v \mid z_t^0,l\right)-(z-z_{t+1}^0)\right\|^2\right]\]- 앞 항: action flow matching loss. 정답 속도는 $\epsilon-a_t^0$ (noise − clean action)
- 뒷 항: video flow matching loss. 정답 속도는 $z-z_{t+1}^0$
- 두 DiT를 한 번에 같이(joint) 학습한다. text encoder와 VAE는 freeze.
3개의 timestep (tri-timestep)
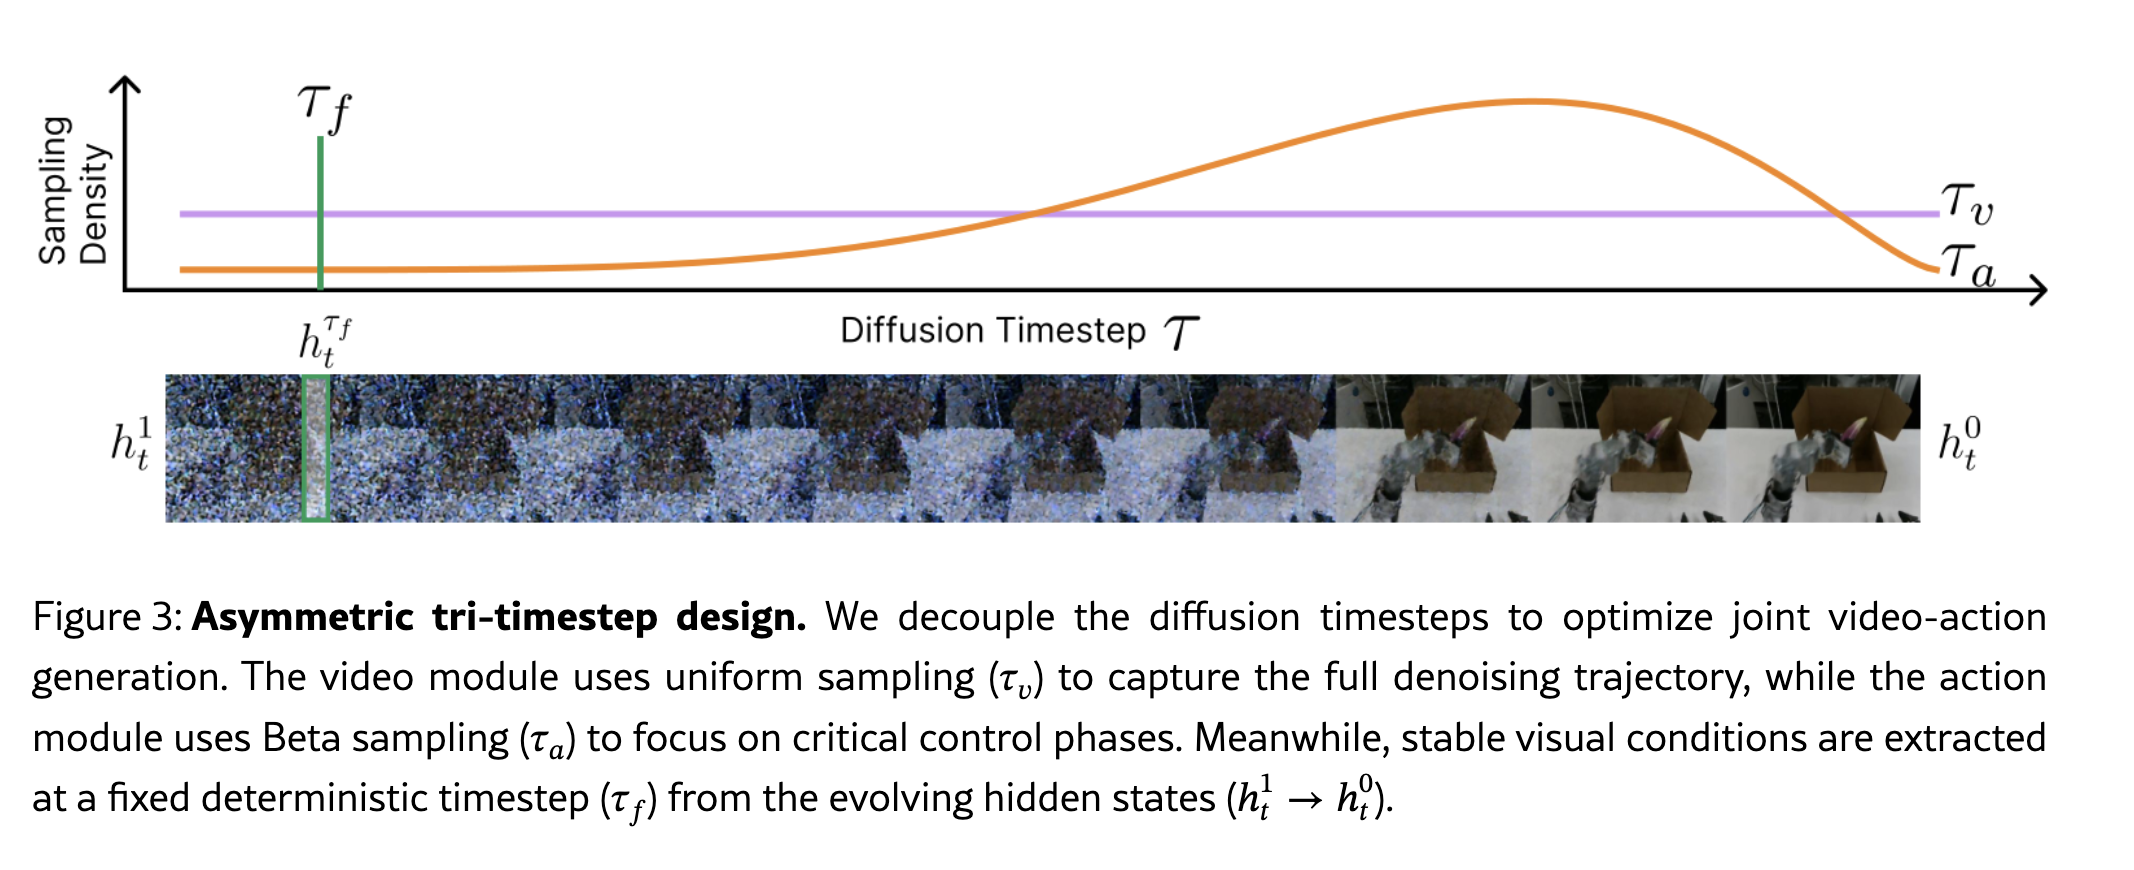
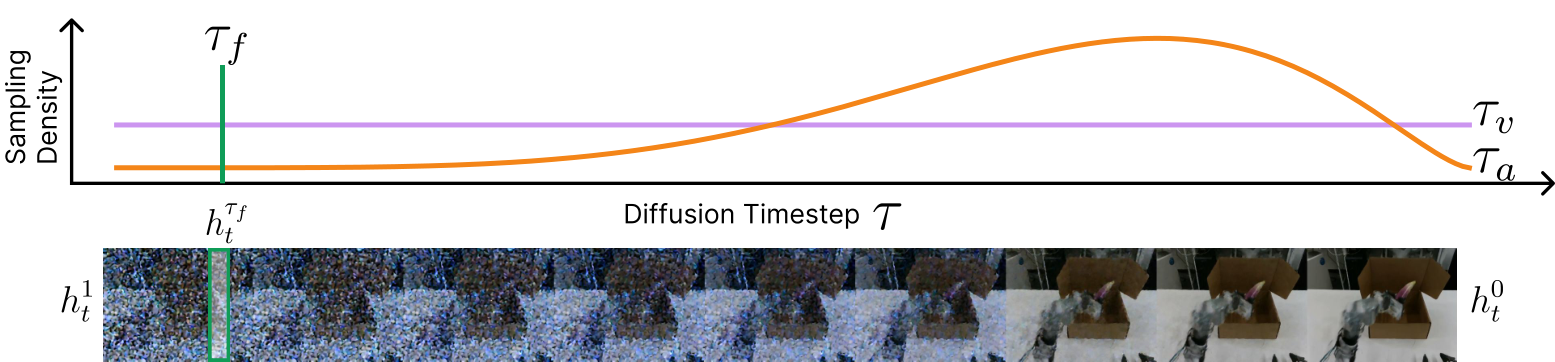 논문 Figure 3: 3개의 timestep을 분리해서 쓴다
- $\tau_v$ (video 학습): uniform 샘플링. 전체 denoising 궤적을 골고루 학습하기 위함
- $\tau_f$ (feature 추출): action에 넘겨줄 hidden feature를 뽑는 지점. 추론 때는 고정값으로 써서 action 쪽에 항상 안정적인 입력을 준다 (그림의 초록 선: 거의 noise에 가까운 초반 지점)
- $\tau_a$ (action 학습): Beta 분포로 샘플링. 학습을 특정 noise 구간에 집중시킨다
참고: 논문 본문은 τ_f가 “고정”이라고 하지만, 학습 알고리즘(Algorithm 1)에서는 τ_f를 {0/T, …, T/T}에서 uniform으로 뽑는다. 즉 학습 땐 샘플링, 추론 땐 고정으로 이해하면 된다.
Denoising
추론(inference) 때의 흐름:
- 현재 관측을 VAE로 encoding → $z_t^0$
- 미래 latent 자리에 pure noise를 넣고, Video DiT를 $\tau_f$에서 forward 1번만 돌린다 → hook으로 $h_t^{\tau_f}$ 추출. 미래 영상을 끝까지 생성하지 않는다.
- Action DiT만 noise에서 시작해 $h_t^{\tau_f}$와 $s$를 조건으로 4 step 디노이징 → action chunk (horizon 16)
즉 무거운 video 생성 루프는 추론 때 돌지 않고, video model은 “미래를 상상하는 feature extractor” 역할만 한다.
Hidden layer는 누가 정하나?
연구자가 실험(ablation)으로 골라서 고정한 하이퍼파라미터다. 학습으로 정해지는 값이 아니다.
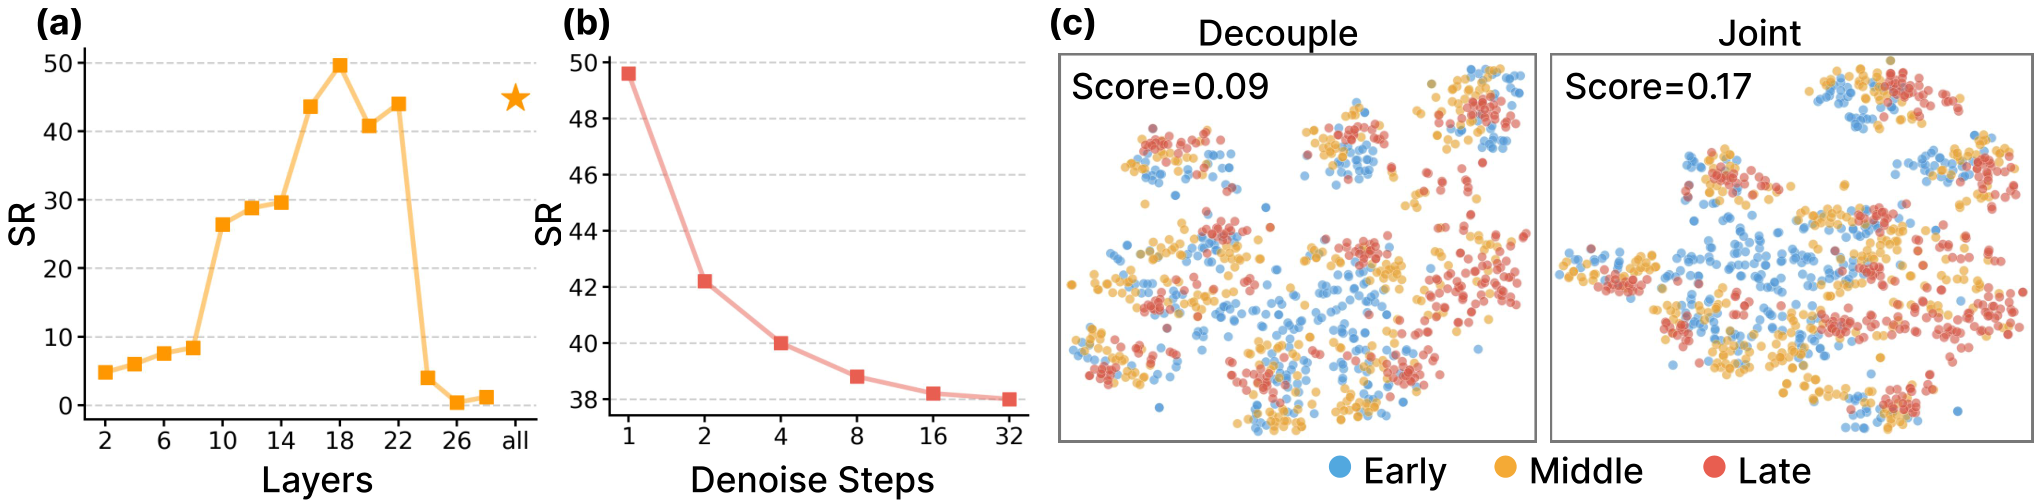 논문 Figure 8: (a) 추출 layer별 성공률, (b) feature 추출 시 denoising step 수별 성공률, (c) joint 학습 vs 분리 학습 feature의 t-SNE
- (a) 어떤 layer? Video DiT(Cosmos-Predict2.5-2B, 28 blocks)의 layer별로 feature를 뽑아 RoboCasa 5개 task 성공률을 비교했다.
- layer 2–8: 성능 낮음 → 저수준 텍스처 위주라 행동에 필요한 의미 정보가 부족
- layer 18: 최고 성능 → 중간~깊은 layer가 물리/장면 이해와 추상화의 균형점
- layer 24–28: 성능 급락 → 마지막 layer는 픽셀 복원에 과하게 특화돼서 제어에 필요한 정보가 빠짐
- 전체 layer 평균(“all”): 꽤 좋지만 layer 18보다 약간 낮음
- 그래서 config에
Extract Layer = 18로 고정한다 (부록 Table 4).
- (b) 몇 step 디노이징한 feature? 1 step(=forward 1번)이 가장 좋고, step을 늘릴수록(1→32) 성능이 계속 떨어진다. 많이 디노이징할수록 feature가 특정 미래 영상의 픽셀 디테일에 과하게 맞춰지기 때문이라는 해석이다.
- (c) joint 학습의 효과: 두 DiT를 같이 학습하면 feature가 task 진행 단계(Early → Middle → Late)별로 더 잘 정리된다 (silhouette score 0.09 → 0.17).
정리: layer(18)와 τ_f, denoising step 수(1)는 모두 사람이 ablation으로 정한 값이다. 학습 가능한 layer 가중치 같은 건 없다.
장단점
- 장점
- 미래 비디오를 직접 생성하지 않고 중간 hidden feature만 사용해서 계산량을 줄임
- 단순 이미지 feature보다 motion / temporal dynamics 정보를 더 많이 포함
- 대규모 video generation model의 pretrained knowledge를 그대로 활용 가능
- action model이 직접 physics를 처음부터 배우는 부담을 줄일 수 있음
- hidden feature를 여러 layer에서 뽑거나 평균할 수 있어 representation 선택에 유연함
- 단점
- hidden feature가 정말 action에 최적인 representation이라는 보장은 없음
- 어떤 layer, 어떤 flow timestep $\tau_f$에서 feature를 뽑는지에 따라 성능이 민감함 (실제로 논문 ablation에서 layer 18 → 24만 바꿔도 성공률이 거의 0으로 떨어진다)
- Video DiT 자체가 크기 때문에 전체 시스템은 여전히 무거움
- video model이 학습한 dynamics와 실제 robot interaction dynamics 사이에 domain gap이 있을 수 있음
- hidden feature는 해석하기 어려워서, 실제로 어떤 물리 정보를 담는지 명확하지 않음
결과
- LIBERO 평균 98.6%: 대규모 action 데이터로 pre-train한 기존 VLA(π₀.₅ 등)보다 높다. 특히 long-horizon suite에서 강하다.
- RoboCasa GR1 (24 tasks) 평균 50.8%: GR00T-N1.5 / N1.6보다 각각 9.0 / 10.0%p 높다. 논문은 sample efficiency가 10배 이상 좋아졌다고 보고한다.
- Unitree G1 실제 휴머노이드: 실제 로봇 task와 zero-shot 일반화(처음 보는 물체, 카테고리 변화, 개수 변화)에서도 baseline보다 높은 성공률을 보인다.
처음 질문에 대한 답
- video generation 자체가 action policy의 학습 목표로 효과가 있나? → 있다. 미래 영상을 예측하는 loss를 action loss와 같이 학습하면, 정적인 image-text pre-training보다 dynamics를 더 잘 담은 representation이 생긴다 (t-SNE에서 진행 단계별 구분이 더 뚜렷해짐).
- video model의 representation을 어떻게 뽑아서 action과 연결하나? → 최종 영상이 아니라 중간 layer(18)의 hidden feature를, 고정 timestep $\tau_f$에서 forward 1번으로 뽑고, Action DiT가 cross-attention으로 참조한다.