
V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
V-JEPA 2는 미래 영상을 그리지 않고 미래의 representation을 예측한다. 인터넷 영상 100만 시간으로 pretrain하고 로봇 영상 62시간으로 action-conditioned world model을 만든 뒤, policy 없이 planning으로 로봇을 움직이는 방법을 정리한다.
Reference
V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning — Meta, 2025. V-JEPA 2-AC를 통해 latent action-conditioned world model + planning을 보여줌.
이 글의 그림은 모두 위 논문(arXiv v1)에서 가져왔다.
핵심 내 생각
핵심은 미래 자체를 생성할 것인가, 미래의 representation을 예측할 것인가의 차이다.
기존 generative WAM은 DiT가 미래 video/action을 생성하도록 학습되고, 그 과정의 hidden state가 world dynamics를 담게 된다.
- Context → DiT → future video/action prediction
반면 JEPA는 미래 pixel/video를 직접 생성하지 않는다.
- Context → Encoder → $z_t$
- Future observation → Target Encoder → $z_{t+1}$
- Predictor: $z_t \rightarrow \hat{z}_{t+1}$
- 학습 목표: $\hat{z}_{t+1} \approx z_{t+1}$
즉 JEPA의 핵심은 새 decoder로 hidden state를 뽑는 것이 아니라, 미래 observation의 latent representation 자체를 prediction target으로 삼는 것이다.
여기서 Joint Embedding은 특정 hidden state 하나를 뜻하는 게 아니라, 현재와 미래 observation을 같은 latent space에 embedding해서 비교·예측한다는 개념이다.
- Hidden state는 모델마다 정의가 다르다. Transformer의 특정 layer, 여러 layer의 조합, 혹은 별도 encoder의 output을 latent representation으로 사용할 수 있다. 그래서 중요한 건 “몇 번째 layer인가?”보다 어떤 학습 objective가 그 representation에 어떤 정보를 담도록 만들었는가이다.
0. 왜 JEPA인가?
한 줄 요약: V-JEPA 2는 인터넷 영상 100만 시간으로 “세상이 어떻게 변하는지”를 pixel이 아니라 representation 공간에서 배우고, 로봇 영상 62시간만 더 보고 나서 policy 없이 planning(탐색)으로 로봇을 움직인다.
지금까지 본 WAM(DiT4DiT, Dyna-2)은 전부 미래 영상을 생성(denoise)하는 것을 학습 목표로 썼다. 근데 여기서 질문이 하나 생긴다.
로봇이 컵을 잡으려면, 미래 영상의 배경 나뭇잎 하나하나까지 그려낼 수 있어야 할까??
JEPA(Joint-Embedding Predictive Architecture, LeCun 2022)의 답은 아니다이다. pixel을 다 맞추는 건 쓸데없이 어렵고(배경 텍스처, 조명 같은 예측 불가능한 디테일까지 맞춰야 함), 정작 행동에 필요한 건 “컵이 어디로 가는지” 같은 추상적인 정보다. 그래서 JEPA는 정답도 encoder를 통과시킨 representation으로 만들고, 그 representation을 예측하게 한다.
- Generative(MAE, video diffusion): 정답 = pixel / video latent → 디테일까지 다 복원해야 함
- JEPA: 정답 = encoder가 뽑은 representation → 예측 가능한 추상 정보만 맞추면 됨
(나만의 언어: generative는 “미래 사진을 그려봐”, JEPA는 “미래를 요약한 메모를 맞혀봐”)
1. 전체 그림
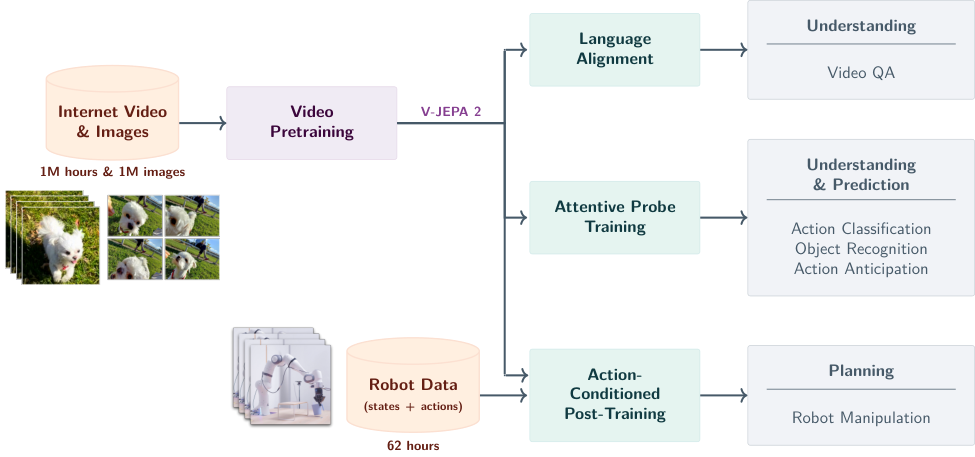 논문 Figure 1: 인터넷 영상·이미지로 V-JEPA 2를 pretrain하고, 그 encoder를 Understanding / Prediction / Planning에 재사용한다
학습은 크게 2단계다.
- Stage 1 — V-JEPA 2 pretraining (action 없음): 인터넷 영상 + 이미지 100만 시간 이상으로 video encoder를 self-supervised 학습
- Stage 2 — V-JEPA 2-AC post-training (action 있음): encoder는 freeze하고, 로봇 영상 62시간(Droid)으로 action-conditioned predictor만 새로 학습
그리고 학습된 encoder를 3가지 용도로 평가한다.
- Understanding: 영상 분류(Something-Something v2 77.3% top-1), LLM에 붙여서 Video QA(PerceptionTest 84.0)
- Prediction: 사람 행동 예측(Epic-Kitchens-100 action anticipation, recall@5 39.7 — 이전 최고 대비 44% 향상)
- Planning: V-JEPA 2-AC로 로봇 zero-shot 조작 ← 이 글에서 제일 중요한 부분
2. Stage 1: V-JEPA 2 — representation 공간에서 mask denoising
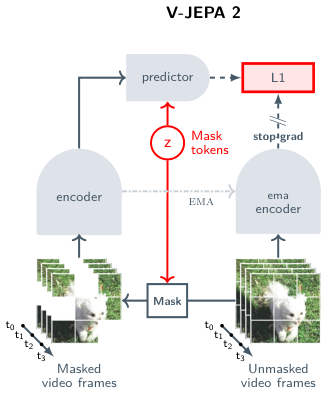 논문 Figure 2 왼쪽: V-JEPA 2 pretraining 구조
흐름은 다음과 같다.
- 영상을 $2\times16\times16$ (T×H×W) 크기의 tubelet(patch)으로 자른다.
- 일부 patch를 mask해서 지운 영상 $x$를 encoder $E_\theta$에 넣는다.
- encoder output + 지워진 위치를 알려주는 mask token $\Delta_y$를 predictor $P_\phi$에 넣어서, 지워진 부분의 representation을 예측한다.
- 정답은 안 지운 원본 영상 $y$를 EMA encoder $E_{\bar\theta}$에 넣어서 만든다.
- loss는 mask된 patch에만 건다. pixel이 아니라 representation끼리 L1으로 비교한다.
- $\mathrm{sg}(\cdot)$: stop-gradient. 정답 쪽으로는 gradient가 안 흐른다.
- $\bar\theta$: encoder weight의 EMA(exponential moving average). 정답을 만드는 encoder는 학습되는 encoder를 천천히 따라간다.
Q. 왜 EMA + stop-grad가 필요할까??
정답도 encoder가 만들기 때문에, 그냥 두면 encoder가 모든 입력을 같은 상수 벡터로 보내버리면 loss가 0이 된다. 이걸 representation collapse라고 한다. 정답 쪽을 gradient 없이 천천히 움직이는 EMA encoder로 만들면 이 꼼수를 못 쓰게 된다. (pixel을 정답으로 쓰는 MAE는 정답이 고정이라 이 문제가 없다 → JEPA만의 고민)
V-JEPA → V-JEPA 2로 오면서 scaling한 4가지
- Data: 영상 2M → 22M개 (VideoMix22M, 100만 시간+)
- Model: ViT-L 300M → ViT-g 1B+
- 학습 길이: 90K → 252K iteration (warmup-constant-decay schedule)
- 해상도: 짧고 작은 clip으로 학습하다가 마지막 cooldown 때만 64 frame, 고해상도로 올림 (progressive resolution)
- 위치 정보는 3D-RoPE(시간·높이·너비 축으로 나눠서 RoPE 적용)를 써서 큰 모델 학습을 안정화
3. Stage 2: V-JEPA 2-AC — action-conditioned world model
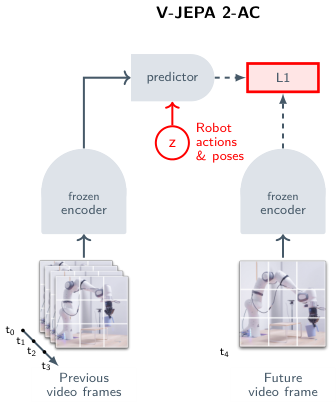 논문 Figure 2 오른쪽: encoder는 frozen, predictor가 로봇 action과 pose를 조건으로 다음 frame의 representation을 예측
Stage 1 모델은 “영상이 어떻게 흘러가는지”는 알지만, “내가 이렇게 움직이면 어떻게 되는지” 는 모른다. 그래서 action을 조건으로 받는 predictor를 새로 붙인다.
데이터
- Droid 데이터셋의 62시간 로봇 영상 (Franka 팔 + 2-finger gripper, 고정된 외부 카메라)
- unlabeled: reward, task 종류, 성공/실패 여부 같은 정보는 안 쓴다. 영상 + end-effector state만 쓴다.
- 4초 clip, 4fps → 16 frame, 256×256
- state $s_k$: 7D (위치 3 + 방향 3 + gripper 1)
- action $a_k$: 인접 frame 사이 state의 변화량 (7D). 즉 action label을 따로 모은 게 아니라 state 차이로 만든다.
모델
- encoder: Stage 1의 ViT-g를 freeze, frame마다 따로 encoding → $z_k \in \mathbb{R}^{16\times16\times1408}$
- predictor: 약 300M, 24 layer transformer
- 입력: $(a_k, s_k, z_k)$를 시간 순서대로 interleave
- block-causal attention: 각 시점의 token은 같은 시점 + 과거 시점의 action/state/patch만 볼 수 있다 (미래는 못 봄)
Loss는 2개
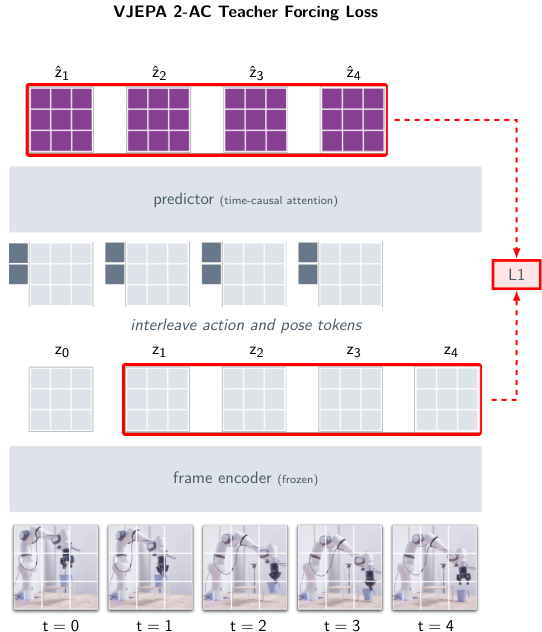 논문 Figure 6 왼쪽: Teacher forcing loss
- (1) Teacher forcing loss: 매 시점마다 진짜 현재 representation을 넣고, 바로 다음 시점 representation을 맞힌다.
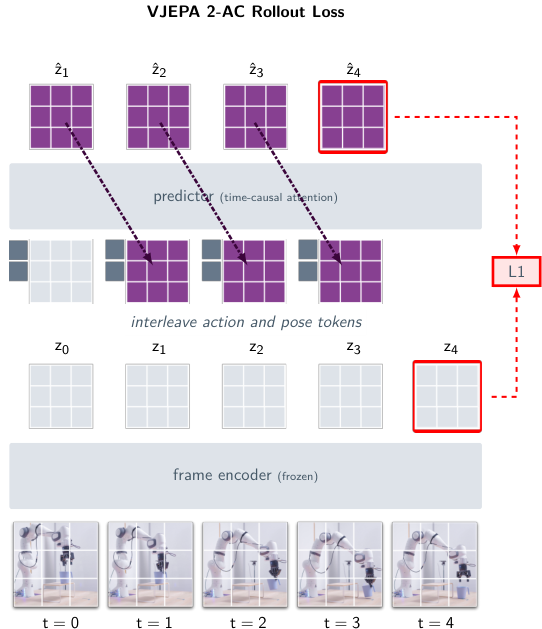 논문 Figure 6 오른쪽: Rollout loss
- (2) Rollout loss: predictor가 자기가 예측한 값을 다시 입력으로 넣으면서 몇 step 굴린 뒤, 마지막 결과를 정답과 비교한다. (논문은 2 step)
왜 rollout loss가 필요할까?? → planning할 때는 미래의 진짜 representation이 없으니까 자기 예측을 다시 넣으면서 굴려야 한다. teacher forcing만 하면 학습 때와 추론 때 입력 분포가 달라서 오차가 쌓인다. 그래서 학습 때부터 “자기 예측으로 굴리는 연습”을 시키는 것이다.
4. 추론: policy가 없다 → planning으로 action을 찾는다
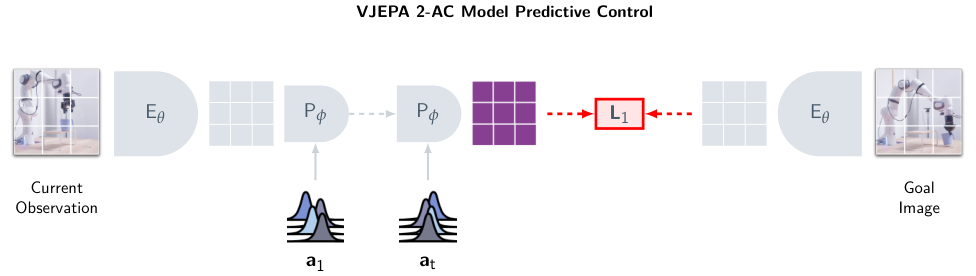 논문 Figure 7: 목표 이미지의 representation과, world model이 상상한 미래 representation 사이의 L1 거리를 줄이는 action을 찾는다
여기가 DiT4DiT, Dyna-2와 제일 다른 부분이다. V-JEPA 2-AC에는 action을 직접 뱉어내는 policy(action head)가 없다. 대신
- 현재 이미지 $x_k$와 목표 이미지 $x_g$를 encoder에 넣어서 $z_k$, $z_g$를 만든다.
- 후보 action sequence $\hat a_{1:T}$를 world model에 넣고 굴려서 “그렇게 움직이면 T step 뒤에 어떻게 될지”를 상상한다.
- 상상한 결과가 목표와 얼마나 먼지를 energy로 정의한다.
- 4. 이 energy가 제일 작은 action sequence를 CEM(Cross-Entropy Method) 으로 찾는다. (후보를 많이 뽑음 → 좋은 것들로 분포를 좁힘 → 반복)
- 5. 찾은 sequence 중 첫 action만 실행하고, 새로 관측한 뒤 다시 planning한다 (MPC, receding horizon).
(나만의 언어: policy는 “보고 바로 반사적으로 움직이는 것”, 여기는 “머릿속으로 여러 번 시뮬레이션 해보고 제일 좋은 걸 고르는 것”)
5. 결과
로봇 zero-shot 조작 — Droid에 없는 두 연구실의 Franka 팔에 추가 데이터 수집 없이 바로 배치, task별 10회 시도 평균
- Reach: Octo 100% / V-JEPA 2-AC 100%
- Grasp (컵 / 박스): Octo 15% / 0% → 65% / 25%
- Reach with object (컵 / 박스): Octo 15% / 70% → 75% / 75%
- Pick-&-Place (컵 / 박스): Octo 15% / 10% → 80% / 65%
- 비교 대상 Octo는 1M+ trajectory로 pretrain하고 Droid 전체로 behavior cloning fine-tune한 VLA다. V-JEPA 2-AC는 Droid 중 2.3만 trajectory(62시간)만 썼다.
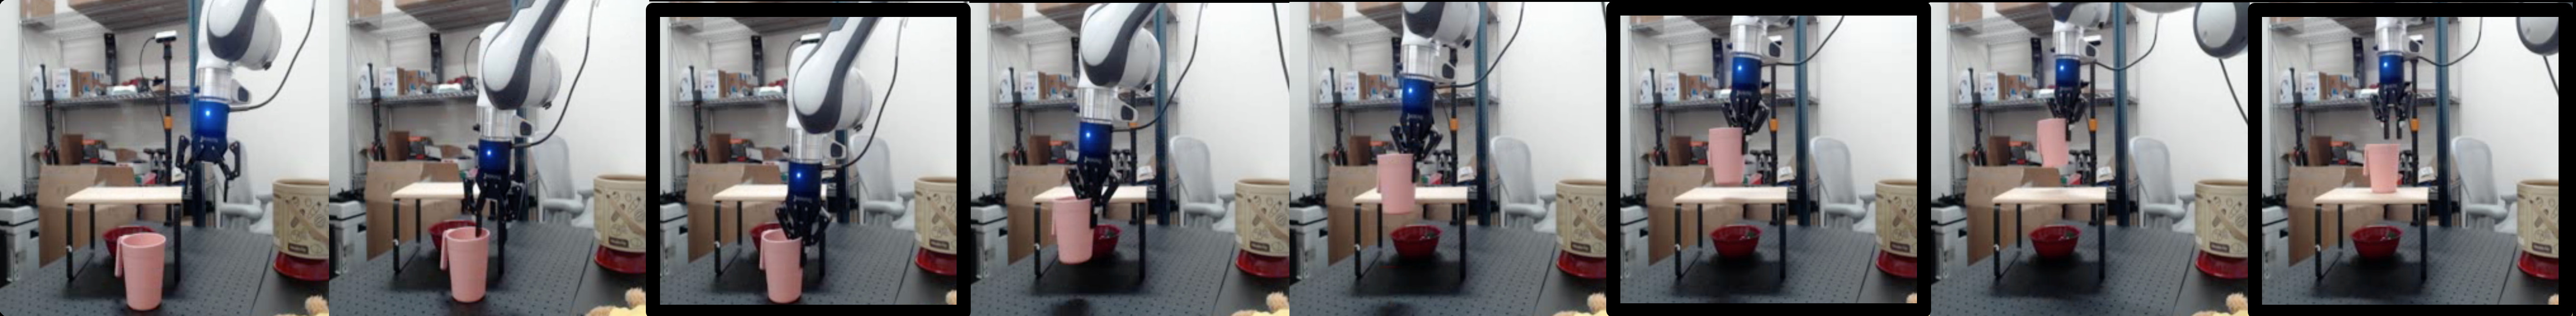 논문 Figure 10: Pick-&-Place 실행. 테두리 친 frame이 sub-goal을 달성하고 다음 목표로 넘어가는 순간
주의: Pick-&-Place는 목표 이미지 1장으로 푼 게 아니다. “잡은 모습” → “목표 근처로 옮긴 모습” → 최종 목표, 이렇게 sub-goal 이미지 3장을 순서대로 준다.
Generative world model(Cosmos)과의 비교 (Lab 2, 같은 CEM planning)
- Cosmos: action 하나 계산에 4분 → pick & place 한 번에 1시간 넘게 걸림. Reach 80%, 나머지는 0~20%
- V-JEPA 2-AC: 후보를 10배 더 많이 뽑고도 action 하나에 16초. Reach 100%, Grasp(컵/박스) 60%/20%, Pick-&-Place(컵/박스) 80%/50%. 박스 Grasp(20%)만 Cosmos와 같고 나머지는 모두 더 높음
→ pixel을 생성하는 world model로 planning하면 너무 느리다. representation 공간에서 예측하니까 planning이 현실적인 속도가 된다. 이게 JEPA 방식의 가장 실용적인 장점이다.
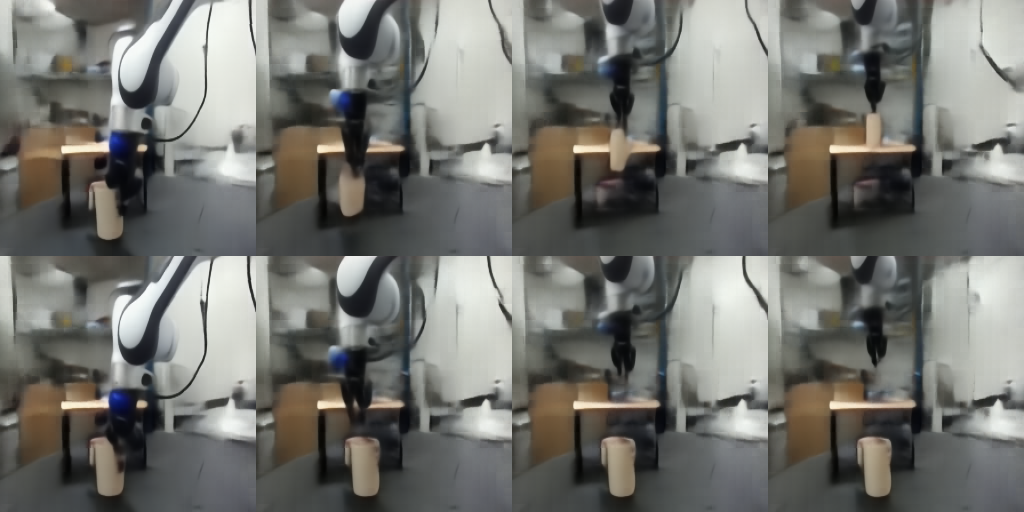 논문 Appendix B.3: 같은 action sequence를 gripper 닫은 상태(위) / 연 상태(아래)로 넣었을 때 world model이 상상한 미래. 연 상태에서는 컵이 안 따라온다
Q. 생성을 안 한다면서 위 그림은 뭐지?? → 학습·planning에는 전혀 안 쓰고, 사람이 보려고 따로 붙인 feedforward frame decoder로 representation을 이미지로 바꿔본 것이다. 배경이 흐린 건 decoder가 작아서이고, 그래도 “gripper를 열면 컵이 안 따라온다” 같은 직관적인 물리는 representation 안에 들어 있다는 걸 보여준다.
6. 한계
- 카메라 위치에 민감: 카메라 calibration 없이 영상만 보고 action 좌표축을 추론해야 해서, 로봇 base가 화면에 안 보이면 world model이 헷갈린다. 실제로 카메라 위치를 여러 번 바꿔보고 잘 되는 곳을 골랐다고 한다.
- 긴 horizon planning이 어렵다: autoregressive로 굴릴수록 오차가 쌓이고, horizon이 길어지면 탐색할 action 조합이 기하급수적으로 늘어난다. 그래서 Pick-&-Place도 sub-goal 이미지가 필요했다.
- 목표를 이미지로 줘야 한다: “컵을 상자에 넣어”처럼 언어로 목표를 주는 건 아직 안 된다.
7. 정리: 지금까지 본 WAM과 비교
- DiT4DiT: 미래 영상을 생성(denoise) 하도록 학습 → 그 중간 hidden feature를 Action DiT가 받아서 action을 생성
- Dyna-2: 미래 영상 + action을 같이 생성하도록 학습 → 추론 때는 action branch만 돌림 (미래 영상은 안 봄)
- V-JEPA 2-AC: 미래 영상을 생성하지 않고 미래의 representation을 예측 → action은 네트워크가 뱉는 게 아니라 planning(탐색)으로 찾음
앞의 두 개는 결국 “action을 출력하는 policy”를 만드는 방향이고, V-JEPA 2-AC는 “결과를 예측하는 world model을 만들고 action은 그걸로 고른다”는 방향이다. 그래서 reward나 task label 없이 로봇 영상만으로 학습할 수 있지만, 대신 목표 이미지와 planning 시간이 필요하다.