
DreamZero: World Action Models are Zero-shot Policies
DreamZero는 하나의 Joint Video-Action DiT 안에서 미래 영상과 action을 같은 timestep으로 함께 denoise한다. Dyna-2와의 차이, joint flow matching, causal attention mask와 KV cache, 그리고 실험 결과를 정리한다.
Reference
DreamZero: World Action Models are Zero-shot Policies
이 글의 그림은 위 논문(arXiv 2602.15922)에서 가져왔다.
Overview
핵심 내용
DYNA(Dyna-2)랑 다른 점: Dyna-2도 하나의 모델 안에서 trunk를 공유하지만, action이 미래 영상 latent를 보지 않는다 (video loss는 representation을 좋게 만드는 보조 역할). DreamZero는 하나의 Joint Video-Action Diffusion Transformer 안에서 video와 action이 같은 timestep을 공유하며 같이 denoise되고, action이 같은 step에서 생성 중인 미래 영상 latent를 attention으로 직접 본다.
Data
- Main robot / embodiment: AgiBot G1을 중심으로 학습한다. (별도로 Franka 로봇의 공개 데이터셋 DROID로 학습한 모델도 있다.)
- 논문 전체 학습 데이터는 AgiBot G1 teleoperation data 약 500 h (7.2K episodes)이며, 반복 demonstration만 모으기보다 서로 다른 task·environment에서 나온 heterogeneous / diverse trajectories를 중요하게 본다.
- Cross-embodiment: 다른 robot인 YAM의 video-only data, 그리고 human video-only demonstrations도 활용한다. Action label이 없어도 video prediction objective를 통해 transfer 가능하다는 것이 핵심이다. 다른 로봇(YAM) video 20분, 또는 사람 영상 12분만으로 처음 보는 task 성능이 42% 이상 상대적으로 좋아졌다.
- Few-shot embodiment adaptation에서는 AgiBot G1 기반 모델을 YAM으로 옮길 때 약 30분의 play data만 사용하고도 zero-shot generalization을 유지하는 실험을 한다.
Training
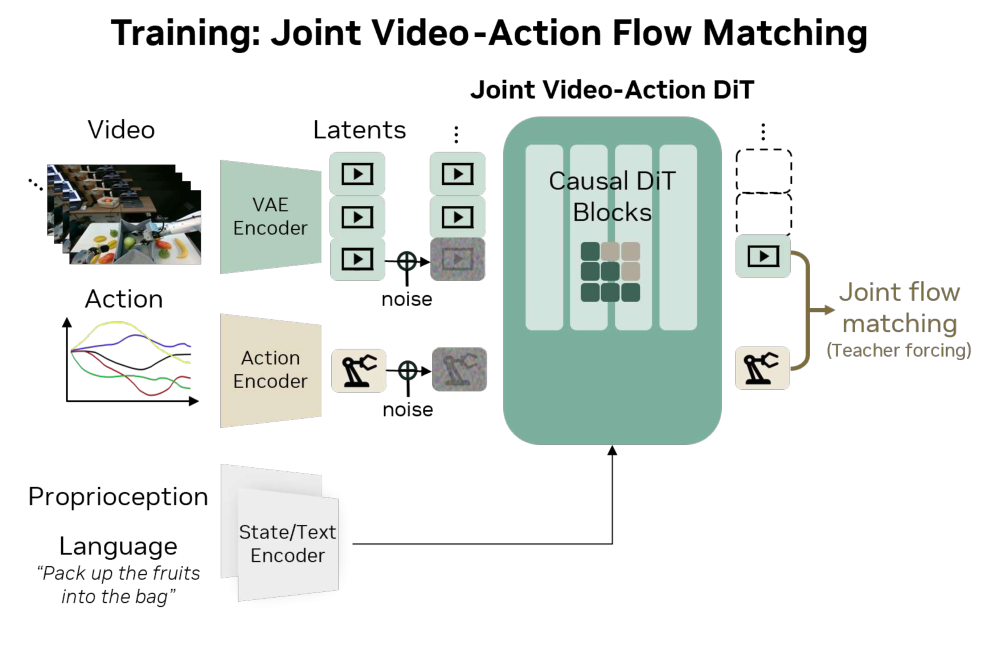 논문 Figure 4 왼쪽: Training — Joint Video-Action Flow Matching
Model
기존에 존재하는 World Foundation Model 사용 → Wan2.1-I2V-14B-480P (Team Wan, 2025), a 14B image-to-video diffusion model, as the backbone for DreamZero.
1. Pretraining (두 단계)
- (0) Video pretraining (DreamZero가 하는 게 아님): Wan2.1은 이미 web-scale video로 학습된 모델이다. DreamZero는 이 가중치를 그대로 가져와서 시작한다.
- (1) Robot pretraining (DreamZero가 하는 학습): 아래 내용이 robot data로 직접 하는 joint video-action 학습이다.
- 즉 처음부터 robot policy를 학습하는 것이 아니라, web-scale video에서 이미 배운 spatiotemporal / physical dynamics prior를 가져온다.
- DreamZero는 backbone을 크게 바꾸지 않고 state encoder, action encoder/decoder 같은 최소한의 robot-specific module만 추가한다. 카메라가 여러 대면 구조를 바꾸지 않고 여러 view를 이어 붙여 한 프레임으로 넣는다.
- Robot pretraining 단계에서는 clean past/current video context를 조건으로 future video latent + future action latent를
joint flow matching으로 학습한다. - Teacher forcing: 현재 noisy chunk는 이전의 clean chunk들을 context로 보고 denoise한다.
2. Post-training
- 특정 downstream task / environment에 맞게 추가 robot data로 fine-tuning한다.
- 중요한 점은 task-specific post-training을 해도 pretrained video model에서 얻은 environment generalization을 최대한 유지하려는 것이다.
- 논문에서는 post-training 이후에도 DreamZero가 VLA 대비 높은 environment generalization을 유지한다고 보고한다.
한 줄 요약: video foundation model pretraining → heterogeneous robot data로 joint video-action pretraining → 필요하면 task-specific post-training.
JOINT FLOW MATCHING이 무엇일까?
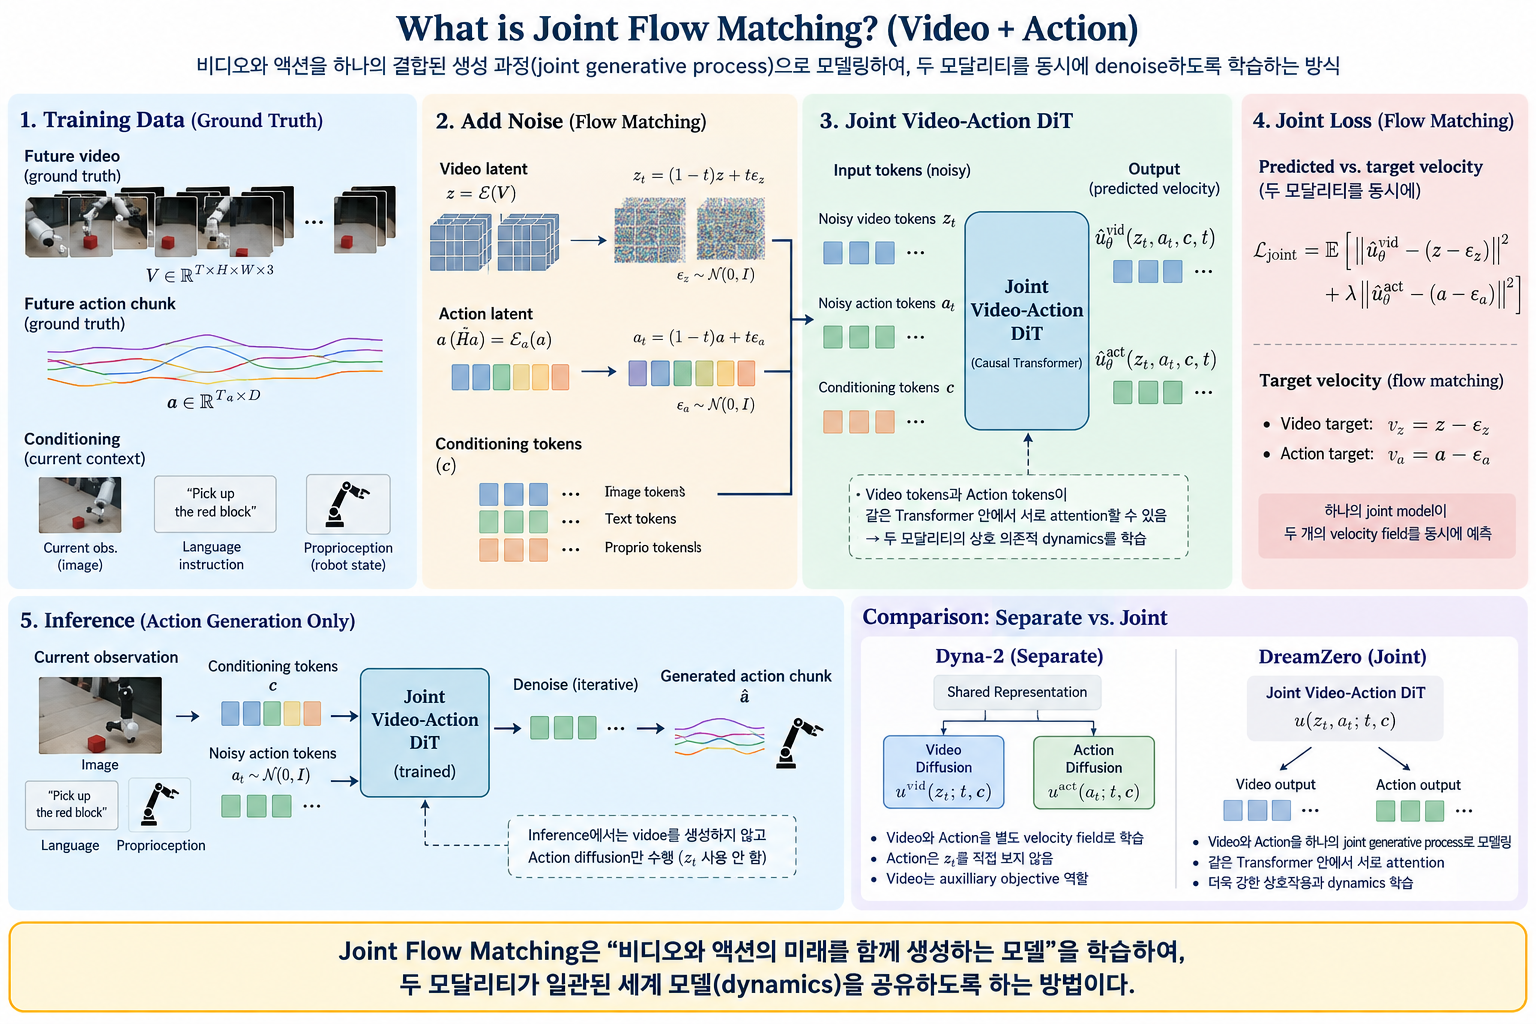 Joint Flow Matching 정리 그림
즉, 여기서 재미있는 사실은 우리가 ‘하나의’ joint Video - Action Diffusion transformer를 사용한다는 점이다. 그 transformer의 output은 각각 velocity이다.
(diffusion model은 결국 노이즈로부터 truth로 가려면 어디로 가야할지 각 타임스탭마다 속도가 output인거를 잊지말자)
학습할 때의 Loss는 DYNA(Dyna-2)와 비슷해 보이지만 차이가 있다. Dyna-2는 video 항과 action 항을 따로 더하고 λ로 가중치를 주는 반면(각자 따로의 velocity field), DreamZero는 video와 action을 하나로 이어 붙인 joint velocity에 대해 loss 하나를 쓰고, 두 modality가 같은 timestep을 공유한다.
이제 추론 단계로 넘어가보자.
Inference
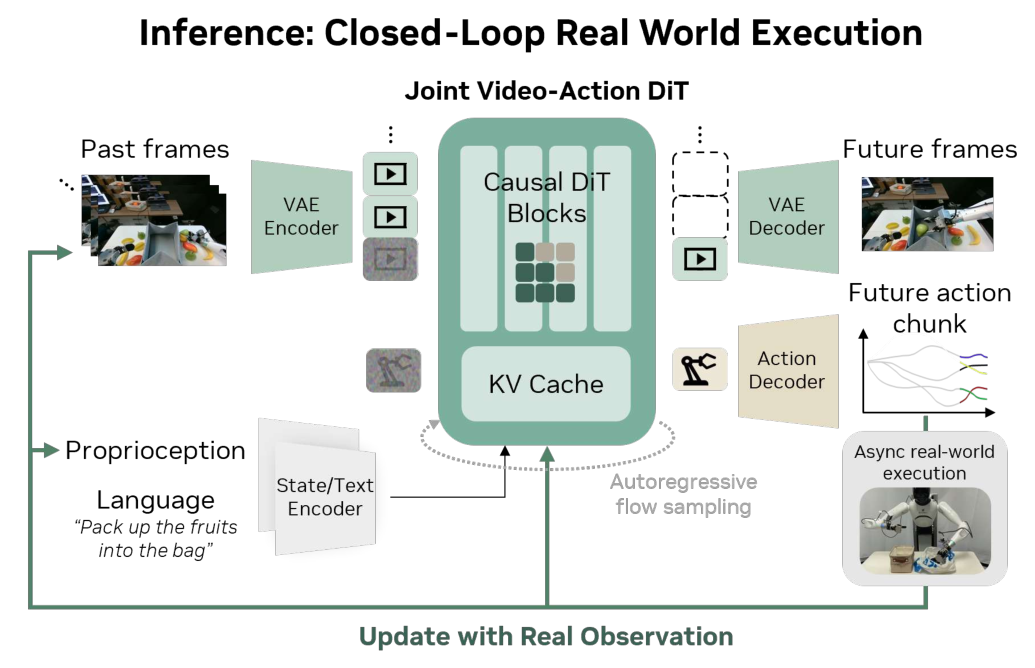 논문 Figure 4 오른쪽: Inference — closed-loop 실행과 KV cache 교체
입력: c = past real frames, language, proprioception → Past frames는 VAE encoder를 거쳐 clean video latent/context가 되고, language/state도 encoder를 거쳐 conditioning이 된다. 여기서, 생성해야 할 것은 두 가지: noisy future-video latent와 noisy future-action latent.
이제, Joint DiT가 denoise해서 future frames + future action chunk를 동시에 만든다. action chunk는 실제 robot에 비동기로 실행하고, 실행 후 새로 들어온 real observation으로 predicted frame을 KV cache에서 교체한다. (그래서 예측 오차가 쌓이지 않는다.)
14B나 되는 큰 모델인데도 실시간이 되는 이유: DreamZero-Flash(적은 denoising step으로도 action을 뽑도록 학습), 병렬화·캐싱, 양자화·CUDA kernel 최적화로 38배 빨라져서 약 7Hz로 action chunk를 만든다.
Joint Flow Matching 정리 그림
왜 Joint Video-Action DiT인가?
- DreamZero의 핵심 차별점은 video와 action을 서로 분리된 두 model에서 학습하는 것이 아니라 하나의 DiT backbone 안에서 같이 denoise한다는 점이다.
- 한 chunk의 입력을 단순화하면:
- $\mathcal{C}_k$: 이전 clean video/action chunk context
- $c$: language condition
- $q_k$: proprioception
- $z_{t_k}^{k}$: noisy future-video latent
- $a_{t_k}^{k}$: noisy future-action latent
Joint DiT는 최종적으로 두 modality의 velocity를 같이 예측한다.
\[v^k = [z_1^k,a_1^k]-[z_0^k,a_0^k]\]즉 video velocity + action velocity를 하나의 joint objective로 학습한다.
- 기호 주의: 논문은 noisy latent를 z_t = t·z₁ + (1−t)·z₀ 로 정의한다. z₁이 clean data, z₀가 noise라서 v는 noise → data 방향이다. (Dyna-2와 같은 표기이고, DiT4DiT는 t→0이 clean이라 방향 표기가 반대다.)
QKV / Attention에서 실제로 무슨 일이 일어나나?
모든 token/latent hidden을 한 hidden sequence $X$로 보고 각 layer에서
\[Q=XW_Q,\qquad K=XW_K,\qquad V=XW_V\]를 만든다.
핵심은 action token도 Q/K/V를 만들고, video latent token도 Q/K/V를 만든다는 점이다.
- 예를 들어 action hidden이 Query가 되면:
- $Q_{action}$: “현재 action latent를 어느 방향으로 움직여야 하지?”
- $K_{video}$: video hidden 중 어떤 미래 dynamics 정보가 관련 있는지 찾는 주소
- $V_{video}$: 실제로 가져오는 video dynamics 정보
- 따라서 허용된 attention mask 안에서는
로 video dynamics가 action hidden에 섞인다.
- 반대로 video Query가 action K,V를 보는 것도 가능해서, video future와 action future가 같은 hidden space에서 서로 정렬된다.
- 다만 아무 token이나 미래를 다 볼 수 있는 것은 아니고 causal attention mask를 사용한다. 현재 noisy chunk는 이전 clean chunks를 볼 수 있지만 미래 chunk 정보가 역으로 leak되지는 않도록 제한한다.
- 이 causal structure 덕분에 autoregressive generation과 KV cache가 가능하다.
핵심: Joint DiT = 같은 Transformer 안에서 video와 action이 QKV를 통해 직접 정보를 주고받으며 joint velocity field를 학습하는 구조.
Mask
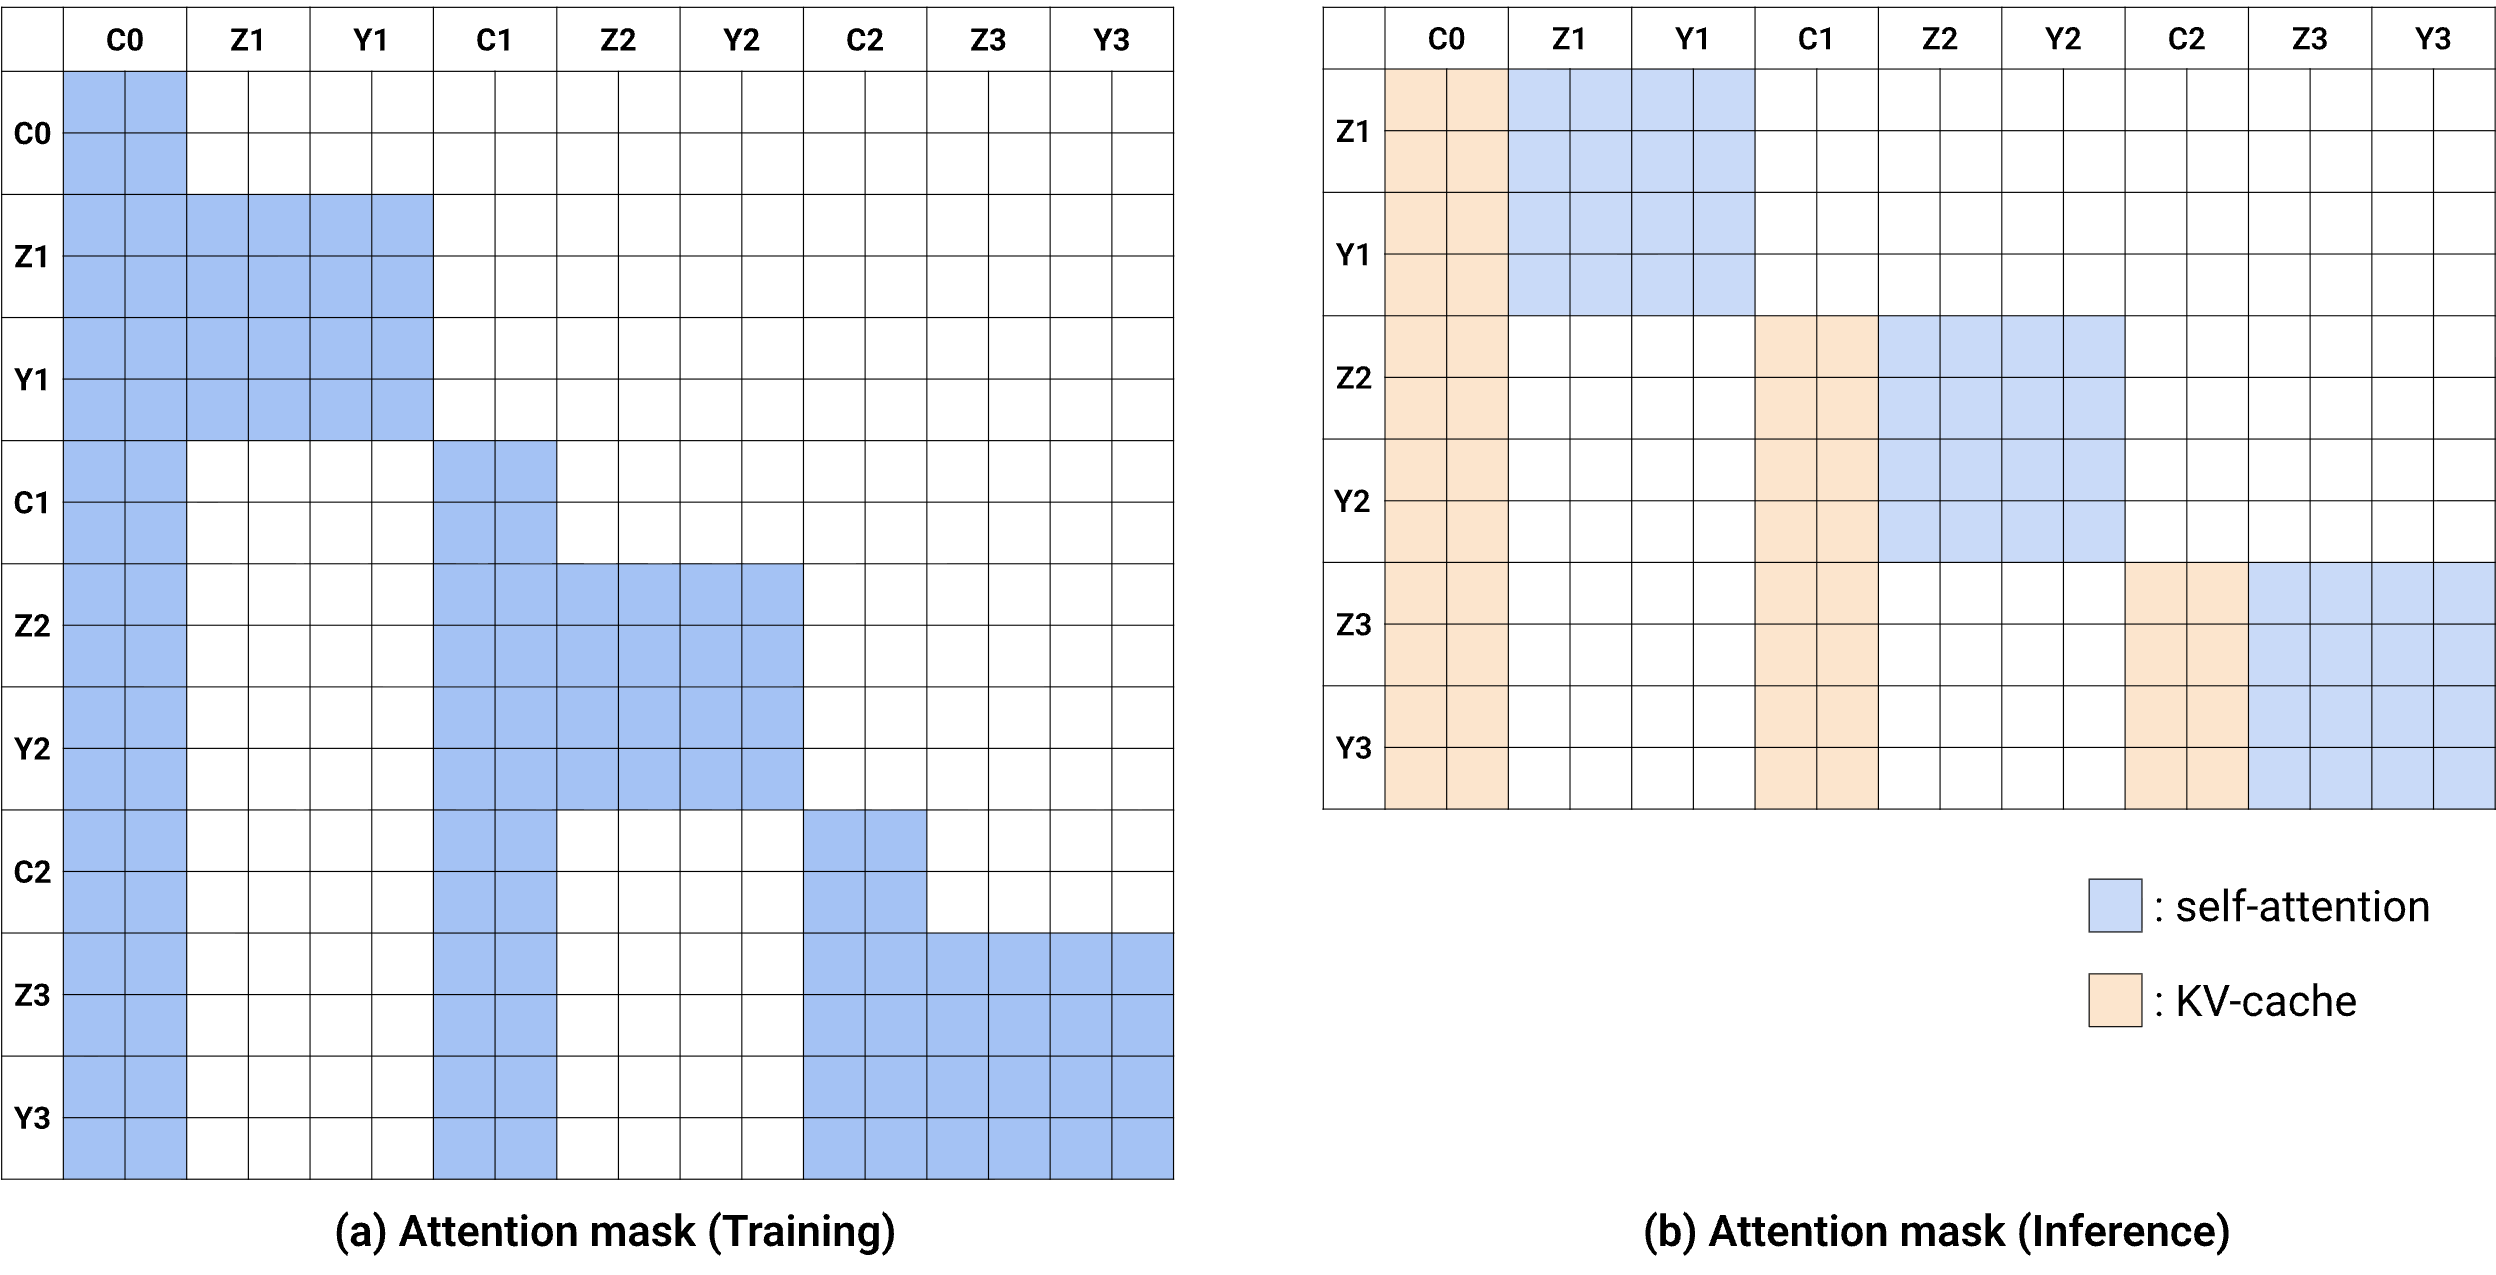 논문 Figure 14: (a) 학습 때 attention mask, (b) 추론 때 attention mask. row = Query, column = Key/Value
여기서 causal mask를 보면 구조가 더 명확해진다. 먼저 0 → 1 → 2 → 3은 video의 시간 순서(time series)라고 보면 된다. 즉 과거에서 미래 방향으로 frame/action block이 진행된다.
또한 이 figure에서 row = Query(Q), column = Key/Value(K,V) 이다. Attention은 Query가 어떤 Key를 참조할 수 있는지를 mask로 제한하고, 실제 정보는 그 Key에 대응되는 Value에서 가져온다.
예를 들어 Y3를 보자.
Y3= 현재 block의 noisy future-action latent가 Query가 된 경우- 참조 가능한 K/V:
C0, C1, C2= 지금까지 누적된 real visual history / conditioning framesZ3= 같은 generation block에서 동시에 denoise 중인 noisy future-video latentY3= 같은 action block 내부 token들
즉 Y3는 과거의 실제 visual state뿐 아니라, 같은 denoising step에서 생성 중인 Z3의 visual future representation도 함께 참고할 수 있다.
중요한 점은 Z3와 Y3 자체가 velocity가 아니라는 것이다. 둘은 각각 noisy video latent / noisy action latent이고, Joint DiT의 최종 output이 이 둘을 noise에서 data 방향으로 이동시키는 video velocity + action velocity이다.
따라서 DreamZero의 핵심은 단순히 video prediction과 action prediction을 따로 수행하는 것이 아니라, 같은 Transformer 안에서 video와 action이 Q/K/V를 통해 서로 직접 정보를 주고받으면서 joint denoising한다는 점이다.
한 줄 요약: row는 Query, column은 Key/Value이며, action
Y3는 과거 real observations(C0,C1,C2)와 같은 step의 future-video latent(Z3)를 동시에 attention할 수 있다.
Results
- 일반화: 처음 보는 task·환경에서 최신 pretrained VLA보다 평균 task progress가 2배 이상 높다. 특히 처음 보는 동작(verb/motion)에서 차이가 크다.
- Post-training 후에도: task별 post-training을 해도 환경 일반화가 유지돼서, VLA보다 평균 task progress가 10% 높다.
- Cross-embodiment: 다른 로봇(YAM) video 20분 또는 사람 영상 12분만 추가해도 처음 보는 task 성능이 42% 이상 상대적으로 좋아진다.
- Few-shot embodiment adaptation: AgiBot G1으로 학습한 모델을 30분 play data만으로 YAM에 옮겨도 zero-shot 일반화가 유지된다.
- Real-time: 14B 모델을 38배 빠르게 만들어 약 7Hz로 closed-loop 제어가 가능하다.