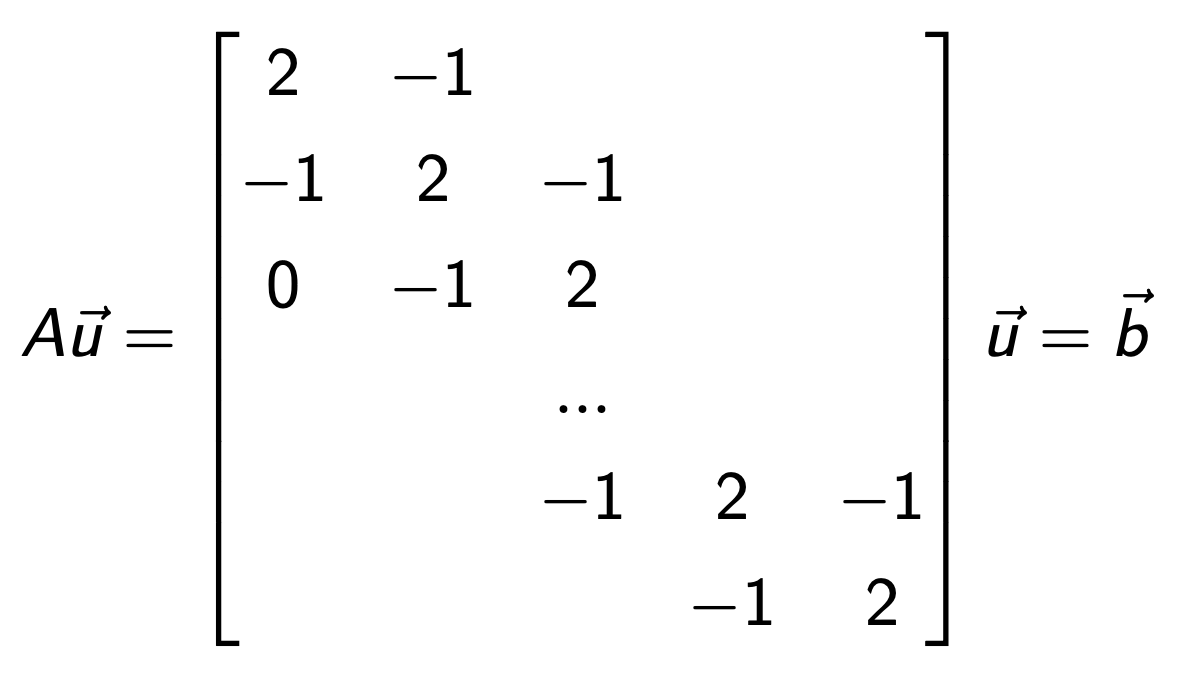
Ch8. Krylov subspace
Ch8. Krylov subspace Ax = b 풀고있다 우리는.
Ch8. Krylov subspace Ax = b 풀고있다 우리는.
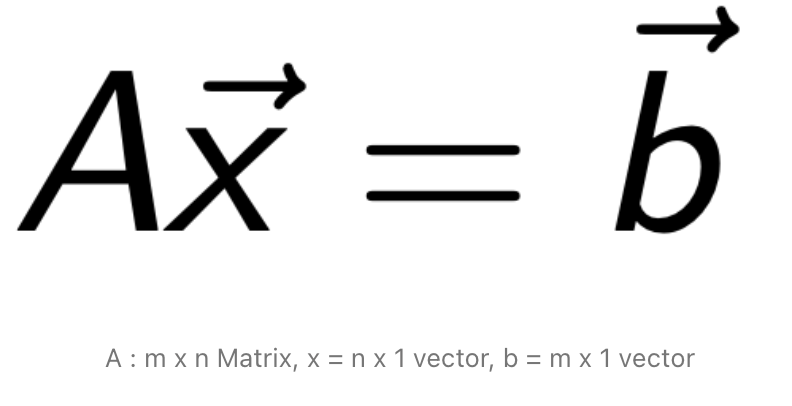
위 문제를 풀기위해 direct method만 지금까지 다루었지만, 사실 연산량 측면에서는 Iterative Method가 더 이득이다. (Large sparse Matrix인 경우 특히 더) Iteartive Method의 큰 틀

Ch7 State of Equation - last of direct method. 지금 우리는 Computational Linear Algebra content 절반에 와있다. The problem we are trying to s
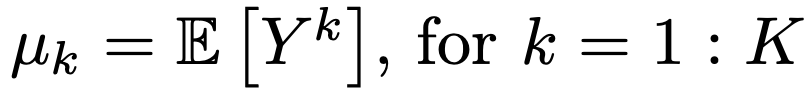
Ch4 Statistics - Other Estimation Methods - MAP, Regularization 지난시간 Maximum Likelihood Estimatino (MLE)에 대해서 다루었고, 이번시간에는 그 변형 혹은
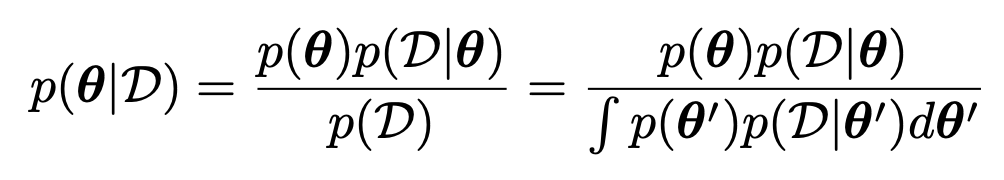
Ch2에서 다루었지만, 확률의 개념은 Two Concepts. 1. Frequentist 확률 = 무한 반복 실험에서 사건이 일어나는 장기 상대도수(long-run frequency) 예: 동전을 무한히 던졌을 때 앞면이 나올 비율이
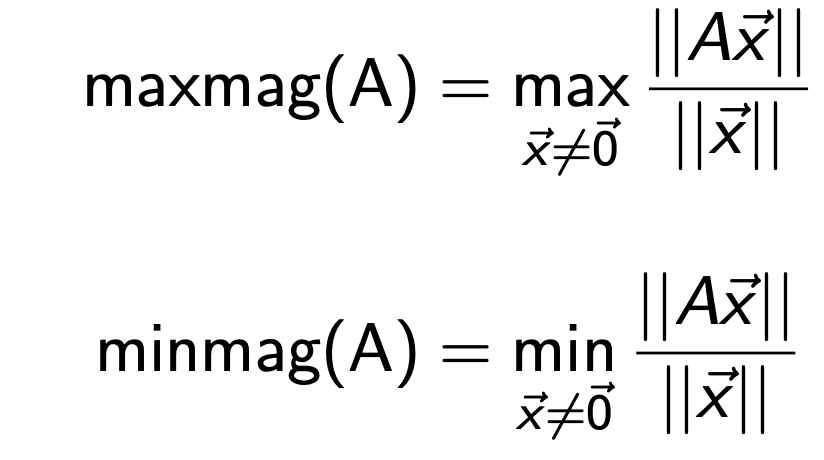
Ch6. Conditioning and Stability - part2 지난시간에 Condition Number의 formula에 대해서 자세하게 다루었다. 핵심을 요약하자면, Non singular Matrix A 에 대해서 다음과
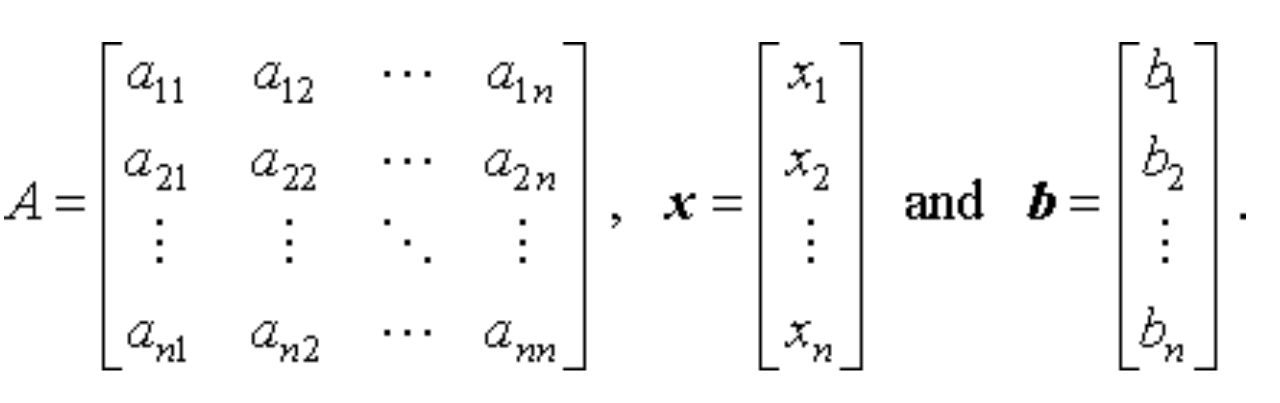
우리가 지금까지 무엇을 하고 있는지 간단히 정리해보자. 1. 우리의 목표는 선형 방정식 Ax=b 푸는 것 2. 가장 단순한 방법은 x=A−1 b , 이 방식은 A 가 nonsingular 한 경우에만 가능하다. 게다가 역행렬 A−1
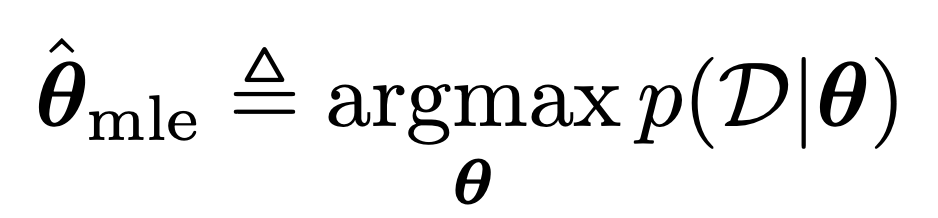
지금까지 우리는 regression classification 하기 위해서, 확률모델을 어떻게 설계해야하는 지 모델에 집중했다면, 이제 최적의 모델 파라메터 θ 를 어떻게 찾아야 하는지를 살펴보자. 정의는 다음과 같다. Maximum
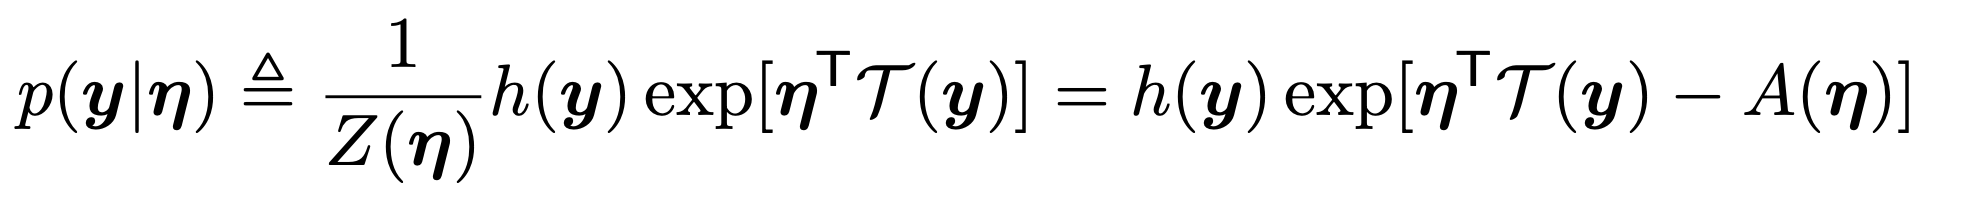
이번 시간에는 굉장히 중요한 Exponential Family 에서 다루어 보자. 원리는 간단하다. 다양한 posterial pdf form 이 존재하고, 이를 일반화한 하나의 식으로 표현한 것. (각 Term의 의미는 추후에 보자)
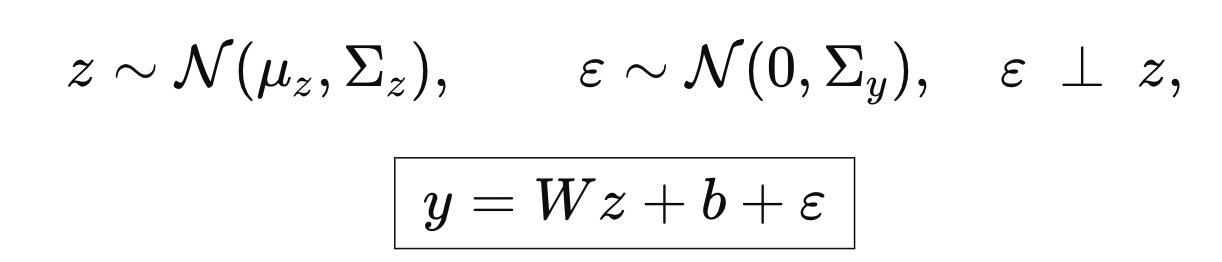
ch3 probability - part2, Linear Gaussian systems (시작하자마자 상황극을 해보자) 우리가 공장에서 센서로 측정한 결과값(y) 으로, 제품의 완성도(z) 를 예측하는 모델을 계발한다고 가정하자. 여
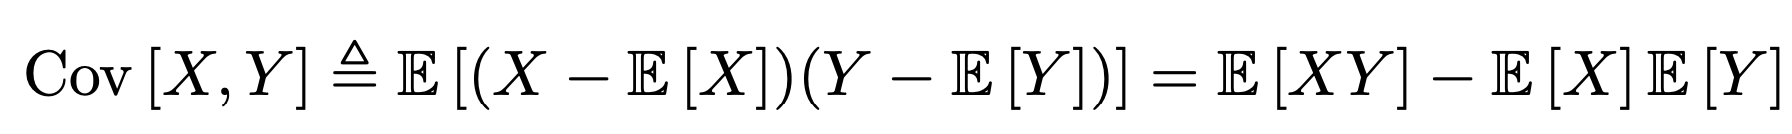
바로 본론으로 들어가자. 어떤 서로다른 변수들의 분포를 나타내는 기본적인 도구가 바로 Covariance(공분산) 이다. Definition of Covariance. 이제 변수가 벡터의 형태라면, 다음과 같이 Covariance M
Ch3 Probability - Multi model - GMM 우리의 목표는 주어진 데이터를 가지고, 데이터의 분포를 설명하는 하나의 모델을 만드는 것. (그래야 주어지지 않은 데이터의 값을 예측할 수 있다.) 그 모델을 우리는 지