
Skild AI - In-context Learning
Skild AI의 S1은 시연 영상 하나만 보고 처음 보는 작업을 해낸다. In-context Learning이 무엇인지, 데이터를 어떻게 보는지, VLA와의 차이와 Emergent Properties, 그리고 hardware·task generalization에 대한 생각을 정리한다.
카네기 멜런 대학교 교수님 두명이 창업한 회사 Skild AI 의 로봇에 대해서 오늘은 리뷰를 진행해보자.
일단 이 로봇은 다른 회사들과 상당히 다른 방식으로 로봇을 학습시키고 추론한다는 점에서 독특한 색깔이 있다.
- Zero shot Inference - 처음 본 영상만 넣어주면, 그 task를 수행해 낸다.
- 로봇의 종류와 상관없이 하나의 Policy model을 학습으로 구축한다. - Omni Policy Model
What is In-context Learning?
1
2
3
인간이 배우는 것을 생각해보자, "나한테 저 머그컵을 줘" 라고 한다면,
우리는 머그컵을 옮기는 일을 수없이 경험하지 않고, 그냥 그 일을 수행해 낼 수 있을 것이다.
왜냐하면 비슷한 작업을 수없이 많이 해왔기 때문이다.
From JIM FAN, chef of Nivida Robotics Team
Once you have enough data, many behaviors can actually be zero-shot. For example, you don’t even need fine-tuning to pick up a novel object. The model “just knows” what to do given a similar scene in the training distribution. Whether in-context learning truly works or not also depends on how far away the test is from training.
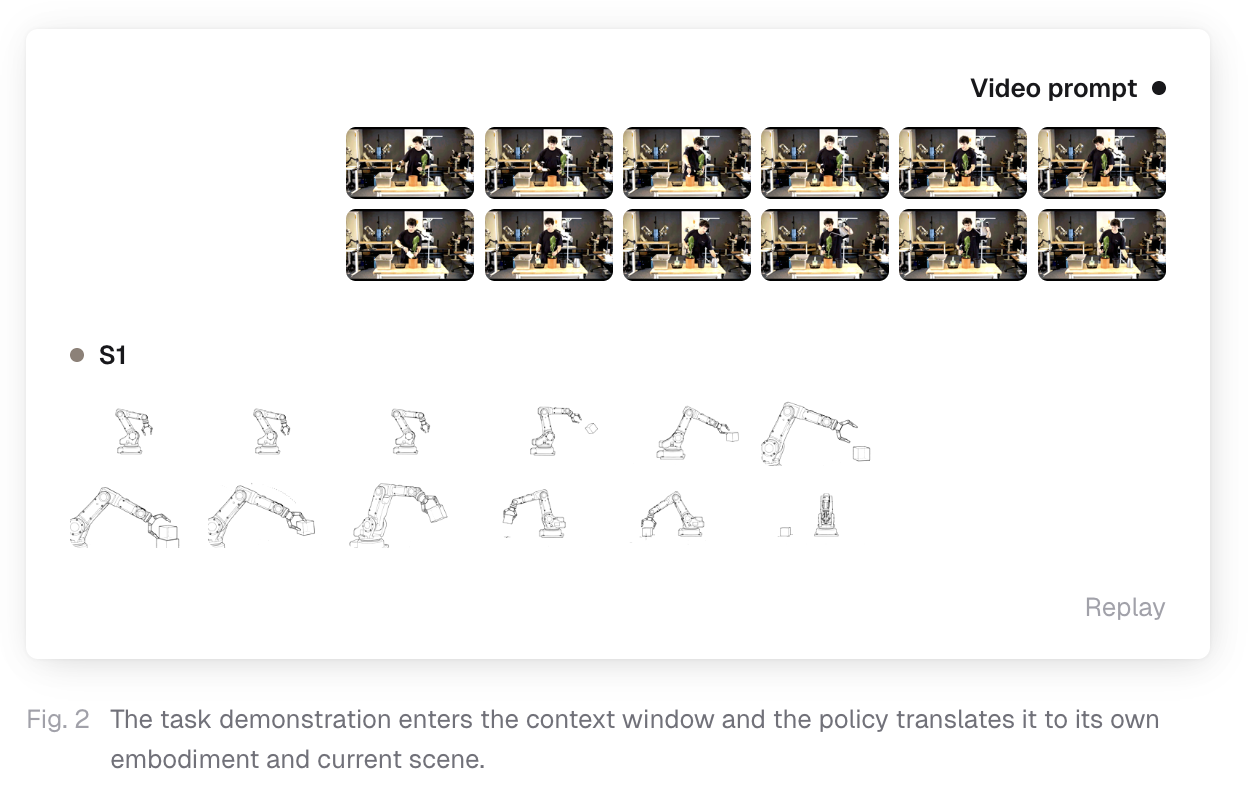
이게 이제 Skild AI 의 핵심이다. 그러니까, 그냥 세상의 다양한 테스크들을 진행하면서, “테스크를 수행하는 것” 자체를 배운다는 것이다. 즉 배우는 것을 배운다라고 생각하면 좋다.
즉 단순하게 영상을 하나 input으로 넣어주어서, 시연하는 것만 보여주면 이제 그 일을 해보지 않았어도, Fine tunning학습하지 않았어도 그 일을 해내도록, 학습 시킨다는 것이 핵심이다.
Data
Skild는 로봇 학습 데이터의 가치를 다음 세 가지로 구분한다.
1
2
3
1. Hardware Proximity: 실제 배포할 로봇과 데이터가 얼마나 유사한가?
2. Diversity: 얼마나 다양한 작업, 환경, 행동을 포함하는가?
3. Scalability: 데이터를 얼마나 저렴하고 빠르게 확장할 수 있는가?
그리고, 이제 데이터 종류 4가지에 따라서 우리는 하단의 3가지 판단기준으로 평가 할 수 있다.
| 데이터 종류 | Hardware Proximity | Diversity | Scalability |
|---|---|---|---|
| Robot Teleoperation | 높음 | 낮음 | 낮음 |
| UMI | 중간 | 중간 | 중간 |
| Egocentric Video | 낮음 | 높음 | 높음 |
| Simulation | 중간 | 낮음 | 높음 |
(여기서, UMI = Universal Manipulation Interface는 참고로, 인간이 로봇팔 없이, Gripper만 가지고 작업을 하 데이터 수집 방법이다)
여기서 Skild AI 가 강조하는 부분이 바로 데이터의 다양성이다. 즉, 최대한 다양한 작업들을 배우면서, 그리고 수행하면서 테스크 수행 자체를 학습하는 것이 바로 이 모델의 핵심 무기이기 때문이다.
VLA vs ICL
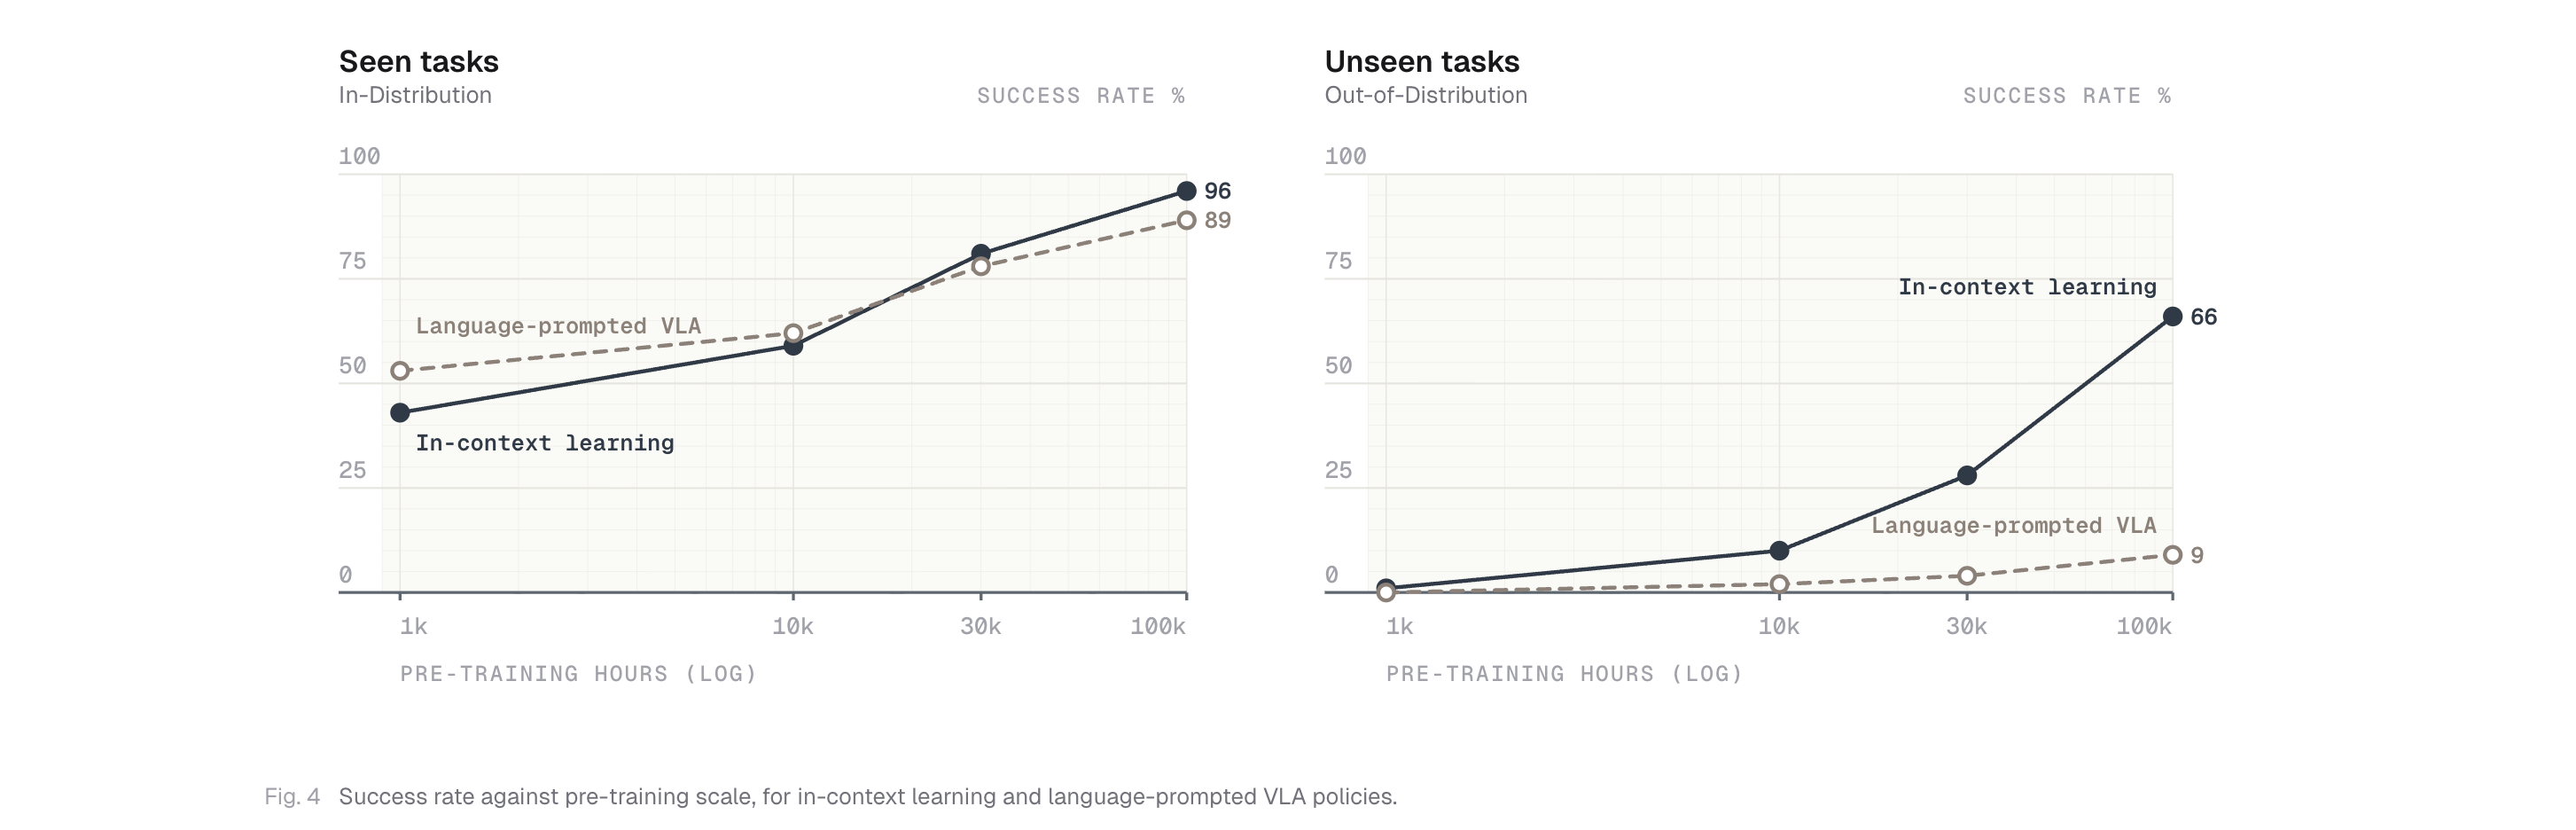
여기서 재미있는 그래프를 하나 공개하는데, 같은 데이터로 점진적으로 늘리면서(x축) 학습을 진행하였을 때, VLA와 ICL은 학습한 테스크에 대해서는 비슷한 성공률을 보인다. 하지만, 학습하지 않은 테스크에 대해서 급격하게 많은 차이를 보이는 것을 알 수 있다.
The surprising part is that the gap between ICL and VLA widens exponentially as pre-training data increases - this gives great hope for scaling laws of ICL.
Emergent Properties
여기서 ICL로 학습하였을 때, 가지는 여러 특징들은 다음과 같다.
Robustness to perturbations (환경 변화에 대한 강건성):
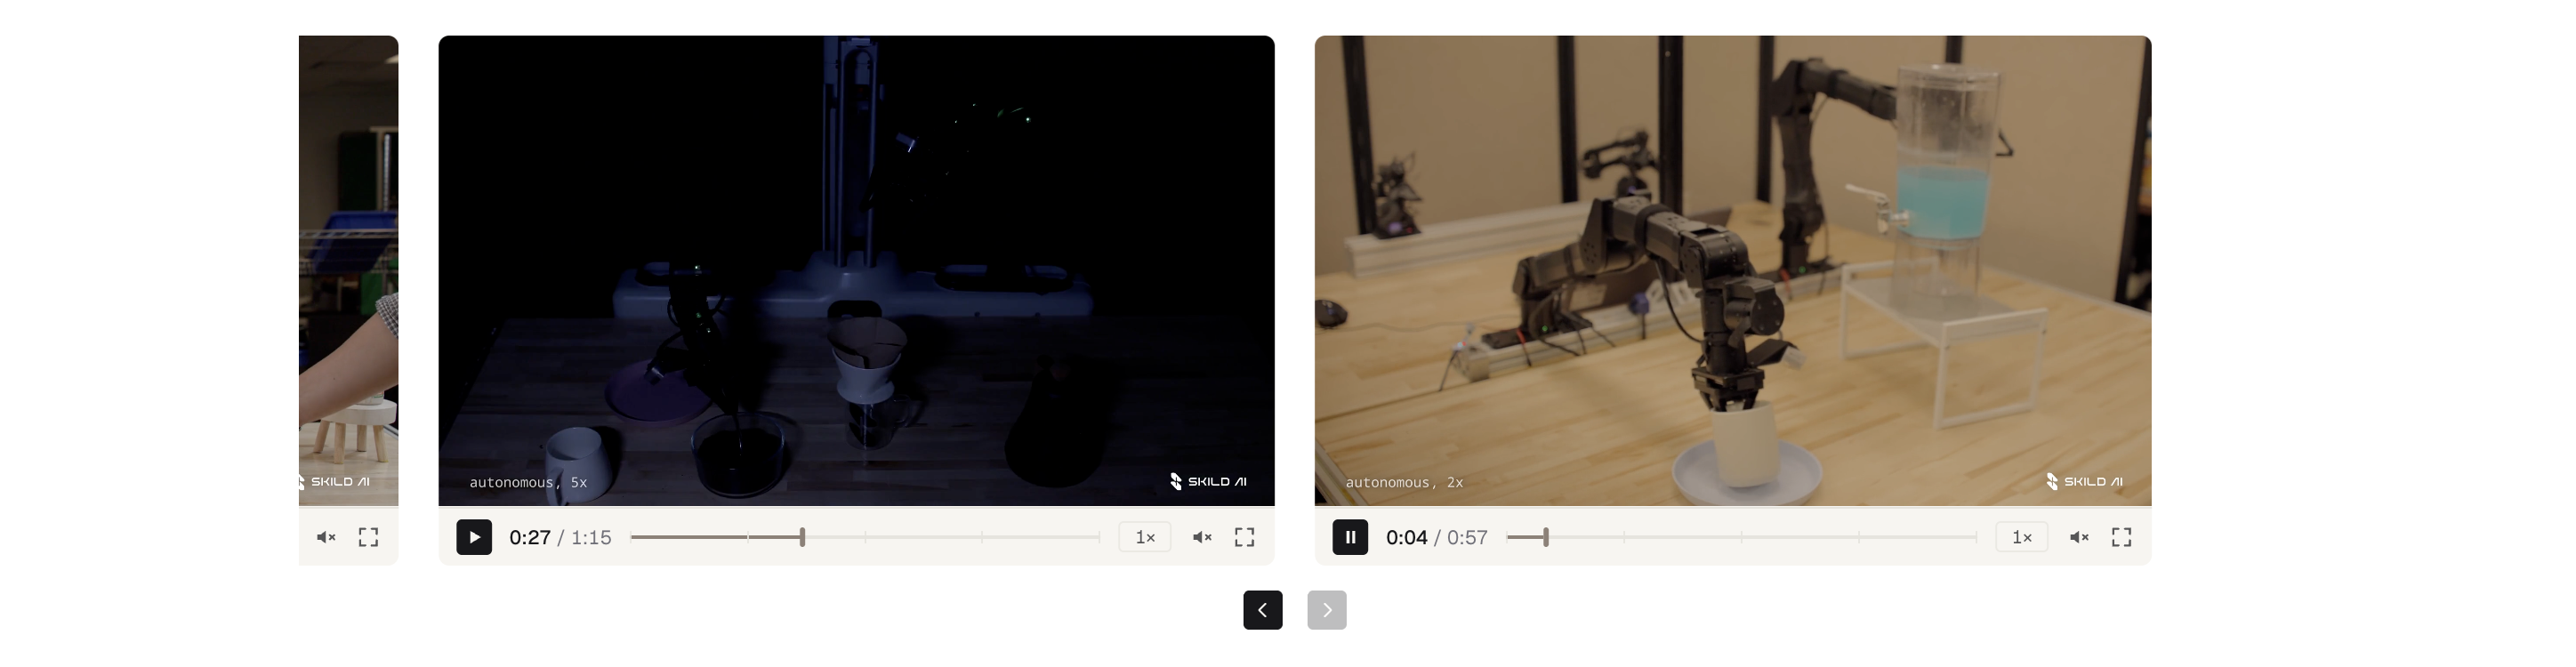
재미있는 사실이 실행 도중 물체를 옮기거나 바꾸고 조명까지 변경했는데도 작업을 이어서 완료했다. 시연 영상을 단순히 복제하는 것이 아니라, 현재 관측에 맞춰 행동을 조정한다는 사례를 보여주는 것.
Mistake recovery (실수 복구)
실수를 하였을 때, 중지하는 것이 아니라 recovery를 진행하여 테스크를 완료 해낸다는 점에서 VLA와 차별점이 있다.
Common-sense behavior (상황에 맞는 판단)
시연에서는 물뿌리개를 사용했지만 현장에 컵만 있으면 컵으로 물을 준다. 유리잔에 주스가 이미 거의 차 있으면 가득 붓지 않고 조금만 보충한다.
Demonstration correction (시연의 실수까지 수정)
시연자가 달걀을 일찍 떨어뜨려 흘리는 상황에서도 로봇은 더 조심스럽게 행동했다. 시연을 그대로 따라 할 궤적으로 보기보다 달성해야 하는 목표의 힌트로 활용하는 것이다. (즉 prompt를 보고 판단하는 능력도 있다는 것이다)
Robustness to distribution shifts (학습 환경과 달라져도 일반화)
물체 위치·각도 변경(L2–L3), 비슷한 기능의 다른 물체로 교체(L4), 반대쪽 팔 사용이 필요한 배치(L5)를 시험했다. 가장 어려운 L5 조건에서 언어 기반 VLA의 성능 저하가 ICL보다 최대 3배 컸다고 보고했다. 반면 시연 영상과 실제 현장의 차이가 너무 커져 실행 계획 자체가 달라지면 ICL도 성능이 떨어진다.
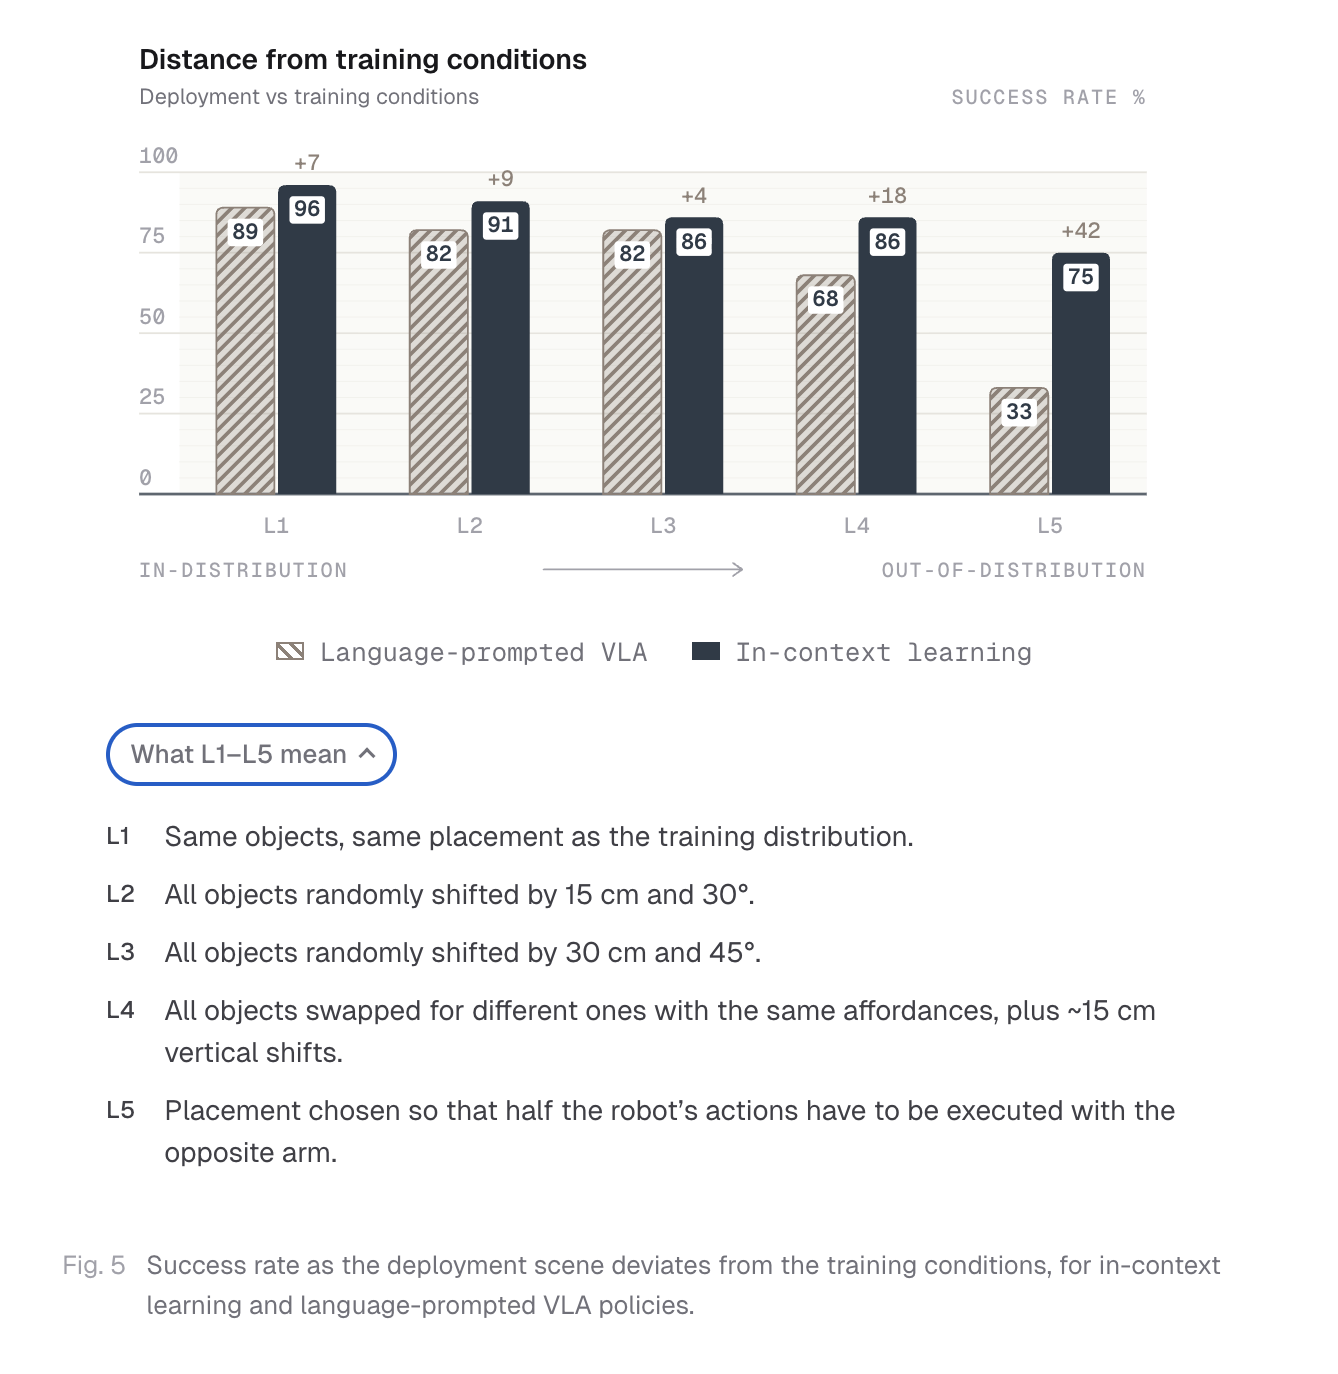
Demonstration efficiency (시연 1개의 가치): 미학습 작업에서 영상 시연 1개로 얻은 ICL 성공률(66%)에 도달하려면, 비교 대상 VLA를 약 380개 로봇 teleop 에피소드로 추가 학습해야 했다(실험치 사이 보간 추정). 약 50–100시간의 수집량에 해당한다. 단, VLA는 2,000개 시연으로 post-training했을 때 성공률 86%로 더 높아졌다.
My thought
1. Hardware generalization
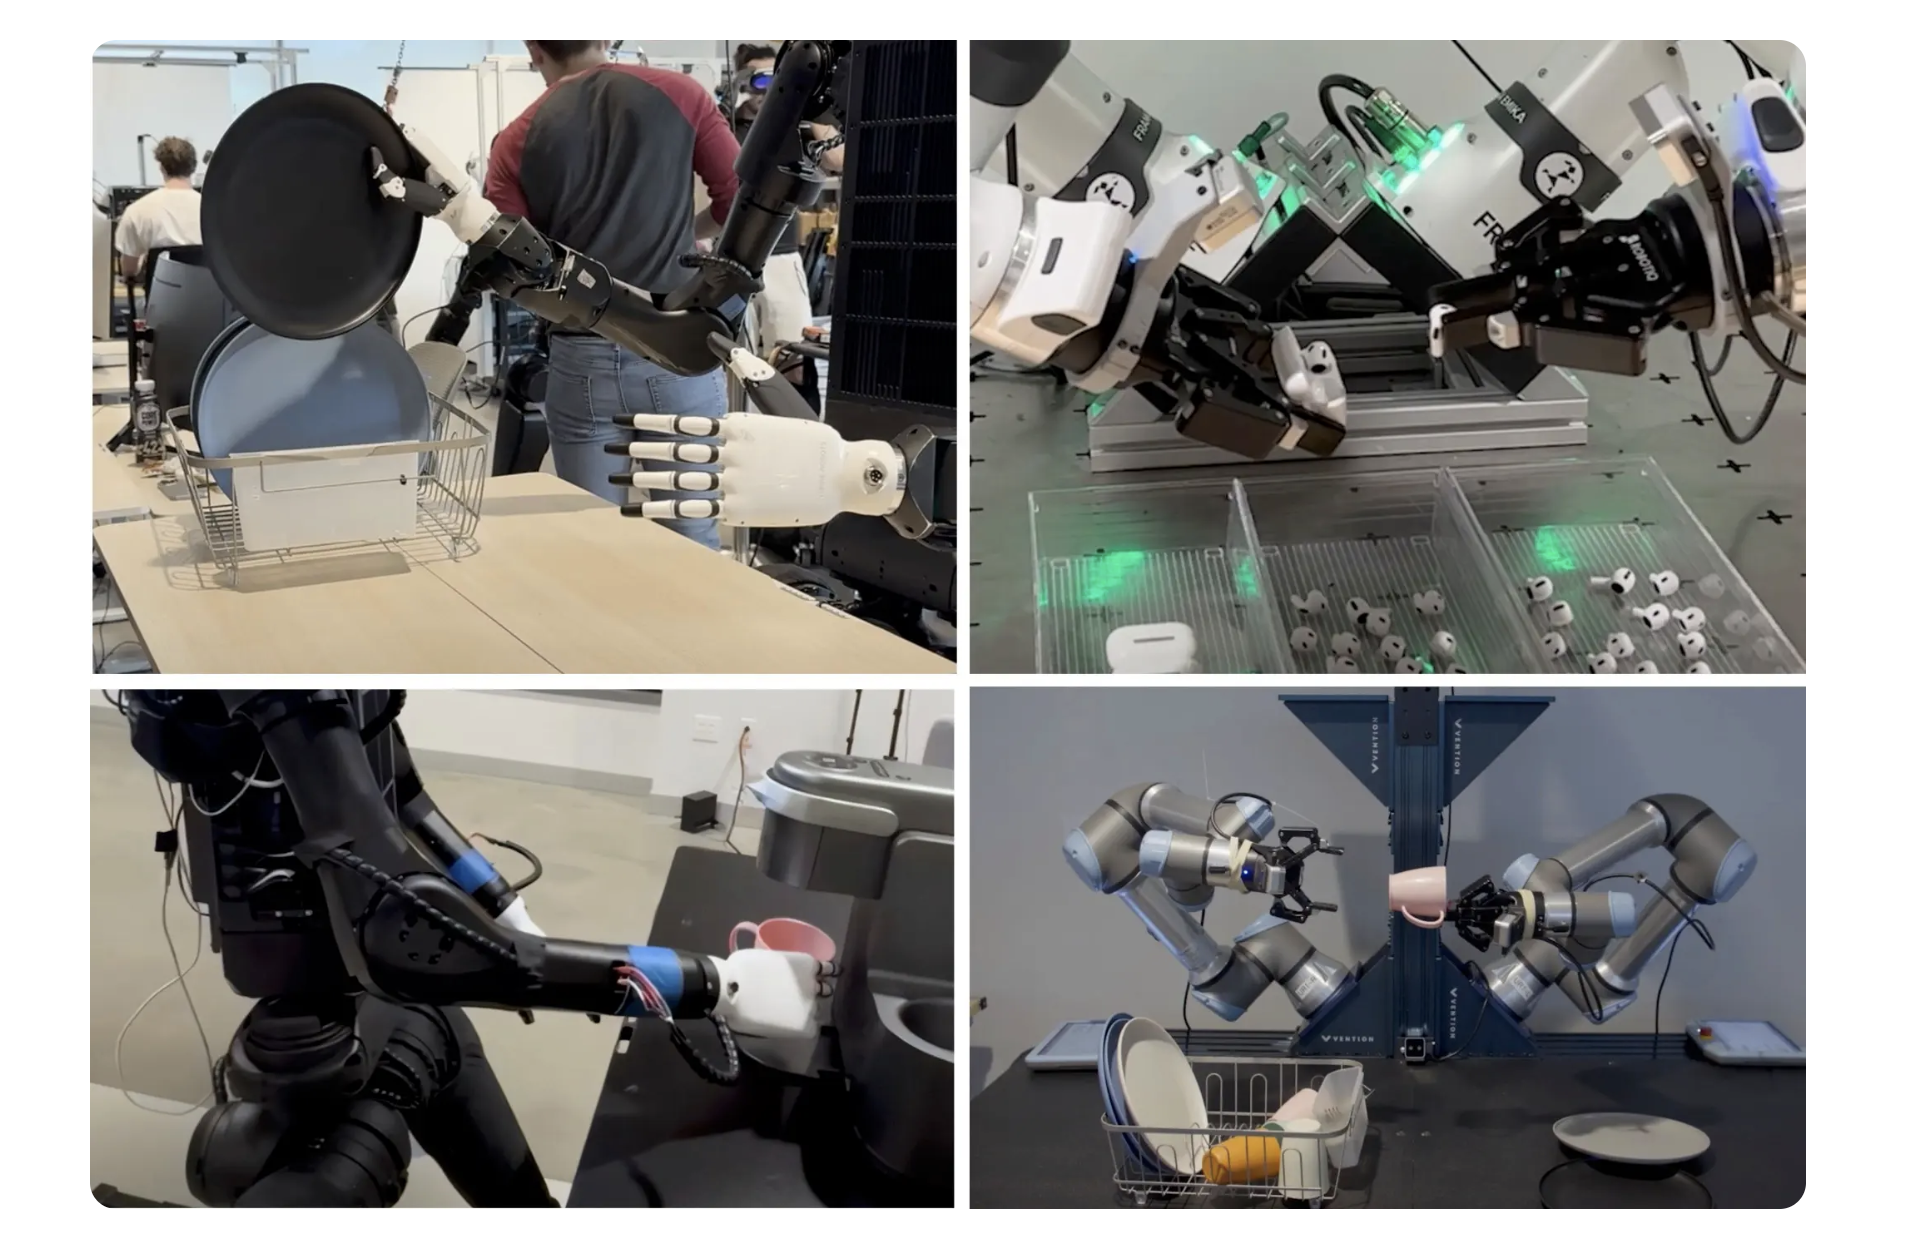
일단 정리를 해보면, 지금 현재 로봇은 연구하는 곳들마다 하드웨어가 조금씩 다르다. 즉, 핸드폰이 처음 나올때 그때의 상황인 것이다. 다시 말해서, 핸드폰의 기능은 다들 똑같이 정의를 하지만, Hardware가 다른것이다. 여기서, 하드웨어가 바뀌어도 똑같은 테스크를 성공할 수 있도록 학습을 시키는 것이 이 들의 목표이다.
2. Task generalization
두번째는 이제, 우리가 결국 최종적으로 로봇의 모습은 하나의 로봇이 수많은 테스크들을 인간이 할 수 있는 테스크들 차 세차, 설거지, 강아지 산책, 집안 청소, 공장 가동 등등에 사용하고 싶을 수 있다.
인간을 생각해보자. 직업에 따라서 서로 학습한 테스크들이 다르지만, 하나의 직업에 대해서는 다양한 테스크들을 진행할 수 있다. 또한, 직업에 상관없이 우리가 general하게 할 수 있는 테스크들이 있다. 여기서 이 skild AI 는 테스크의 genralization을 위해서 학습해야한다고 설명한다. 즉, 테스크를 배우는 방법을 배운다 라고 이해하면 될것이다.
인간 비유로 옮기면 이렇게 볼 수 있다.
- 공통 교육 → 다양한 작업과 로봇 데이터를 이용한 사전학습
- 소방관·경찰관 등등 직업별로 의 업무 묶음 → 사전학습에서 접할 수 있는 여러 작업 분포
- 오늘 처음 맡은 구체적인 업무를 시범으로 봄 → S1에 시연 영상을 입력
- 그 자리에서 수행 → 모델 가중치를 바꾸지 않고 행동
핵심은 소방관 정책, 경찰관 정책을 각각 반드시 만들어야 한다는 게 아니다. Skild는 하나의 사전학습된 정책이 여러 작업을 수행하고, 새로운 작업은 시연 영상을 문맥으로 받아 적응하는 것을 S1의 목표로 설명하고 있는 것이다.