GR00T N1.7 Code Scratch - Part 2
공식 GR00T N1.7 LIBERO-Spatial 체크포인트로 시뮬레이터 eval 을 돌려 SmolVLA 와 비교하고 (66% vs 94%), 내 GR00T DiT 안에서 attention mask 가 어디에 들어가는지 뜯어본다.
Introduction
part1 에서는 attention 을 torch.nn.MultiheadAttention 에 맡겼다. 이번 part2 에서는 먼저 공식 GR00T 체크포인트로 LIBERO eval 을 돌려보고, 그 다음 그 안에서 mask 가 정확히 어떻게 만들어지고 어디에 적용되는지 를 뜯어보자.
- part1 - 기본 모델 코드 구조
- part2 - Eval and Attention Mask
Contents
- Eval 환경 - LIBERO 시뮬레이터 세팅
- 공식 GR00T N1.7 체크포인트 가져오기
- Eval 결과 - SmolVLA (0.45B) vs GR00T (3B)
- Attention Mask - 내 GR00T DiT 안에서 mask 는 어디에?
- Summary
1. Eval 환경 - LIBERO 시뮬레이터 세팅
part1 에서 GR00T 구조는 직접 짜봤는데, 문제는 내 DiT 는 랜덤에서 시작하는 거라 바로 점수를 낼 수는 없다. 그래서 먼저 NVIDIA 가 LIBERO 로 이미 파인튜닝해서 올려둔 공식 GR00T 를 같은 시험장에 넣어서 “원본은 얼마나 잘하나” 를 보기로 했다.
학습은 데이터 (녹화된 시연) 로 하지만, eval 은 시뮬레이터 로 한다. 모델이 action 을 내면 → 로봇이 진짜로 움직이고 → 성공했는지 판정. 즉, 데이터셋이 기출문제 풀이 영상이고 시뮬레이터가 실제 시험장이다.
(흔한 방식이다. LIBERO 가 MuJoCo 기반으로 태스크 환경을 쉽게 만들 수 있게 해두었기 때문이다)
1
2
3
LIBERO      (task 정의: 부엌, 그릇, 서랍, "put the bowl on the plate")
  └─ robosuite   (로봇 팔 제어: Franka Panda 7축 + gripper)
       └─ MuJoCo      (물리 엔진: 충돌, 중력, 마찰)
설치는 LeRobot extra 한 줄이면 위 3 개가 버전 맞춰서 다 따라온다. 문제는 렌더링. 모델 입력이 카메라 사진이라 시뮬레이터가 매 step 3D 장면을 사진으로 찍어줘야 한다.
(참고로, RunPod 같은 GPU 서버에는 모니터가 없다. 그래서 화면 없이 GPU 메모리 안에서만 찍는 EGL 모드로 바꿔야 한다.)
1
2
3
4
apt-get install -y libegl1 libgl1 libglvnd0 libgles2 libosmesa6 cmake ffmpeg   # EGL 시스템 라이브러리
pip install "lerobot[libero,groot]==0.6.1"                                       # hf-libero, robosuite 1.4, mujoco 3.8

export MUJOCO_GL=egl PYOPENGL_PLATFORM=egl      # 모니터 없는 서버에서 GPU 로 렌더링
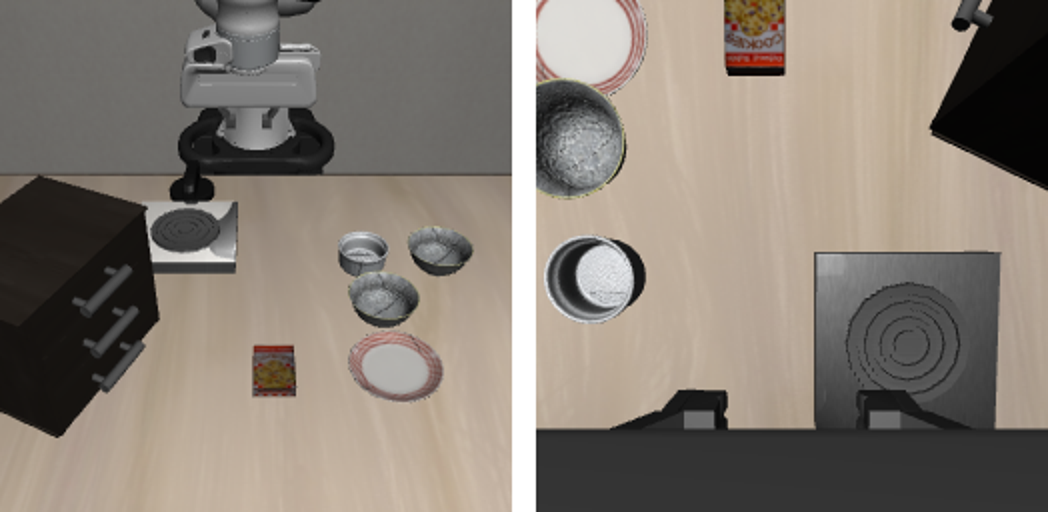
장면 하나 띄워서 찍어본 카메라 2 대. 왼쪽이 3인칭 (agentview), 오른쪽이 손목 카메라 (eye-in-hand). 둘 다 256 x 256.
진행하면서 얻은 꿀팁들을 정리해보자.
1. 카메라 이름이 모델마다 다르다
환경은 카메라를 image / image2 로 주는데, 모델은 학습 때 쓴 이름을 기대한다. 이름이 안 맞으면 바로 Feature mismatch 에러.
| 모델 | 3인칭 | 손목 | rename_map |
|---|---|---|---|
SmolVLA (lerobot/smolvla_libero) | camera1 | camera2 | image → camera1, image2 → camera2 |
GR00T (nvidia/gr00t17-lerobot-libero_spatial-640) | image | wrist_image | image2 → wrist_image |
2. 진행바의 성공률은 믿으면 안 된다
lerobot-eval 을 돌리면 진행바에 running_success_rate=0.0% 가 계속 찍힌다. 그래서 처음엔 다 실패하는 줄 알았는데, 영상을 보니 로봇이 그릇을 접시 위에 정확히 놓고 episode 가 일찍 끝나 있었다 (LIBERO 는 성공하면 바로 끝남). 끝나고 저장되는 eval_info.json 을 보니 successes: [True, True, True]. 진행바 표시만 버그고 최종 집계는 정상이다. 그래서 점수는 항상 eval_info.json 에서 읽는다.
2. 공식 GR00T N1.7 체크포인트 가져오기
Hugging Face 에 NVIDIA 가 suite 마다 따로 파인튜닝한 체크포인트를 올려뒀다. 이번에는 Spatial 용을 썼다. (그러니까 pretrained model + Fine-tuning with Libero spatial )
| 항목 | 값 |
|---|---|
| 모델 | nvidia/gr00t17-lerobot-libero_spatial-640 (object / goal / 10 도 있음) |
| 구조 | Cosmos-Reason2-2B (Qwen3-VL) backbone + flow matching DiT action head, 총 약 3B |
| 학습 | LeRobot 0.6.1, 20,000 step x batch 320, IPEC-COMMUNITY/libero_spatial 데이터 |
| 입력 | image (3인칭), wrist_image (손목), state [8] |
| 출력 | action [7], embodiment libero_sim, gripper 부호 변환 (action_decode_transform: libero) 은 체크포인트가 알아서 |
최종 eval 명령어는 결국 이거 하나.
1
2
3
4
5
6
7
lerobot-eval \
  --policy.path=nvidia/gr00t17-lerobot-libero_spatial-640 \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --env.type=libero --env.task=libero_spatial \
  --eval.n_episodes=10 --eval.batch_size=1 \
  --rename_map='{"observation.images.image2": "observation.images.wrist_image"}' \
  --output_dir=/workspace/eval_groot_spatial
RunPod A40 ($0.59/h) 한 장, setup 5 분 + eval 약 38 분 (episode 당 약 23 초). 비용 약 $0.5.
3. Eval 결과 - SmolVLA (0.45B) vs GR00T (3B)
비교 전에: 두 체크포인트는 각각 무엇으로 파인튜닝됐나
둘 다 “사전학습 (pretrained) 모델 → LIBERO 로 파인튜닝” 이지만, 파인튜닝에 쓴 데이터 범위가 다르다. 각 체크포인트의 train_config.json 을 직접 열어서 확인했다.
SmolVLA (lerobot/smolvla_libero) | GR00T (nvidia/gr00t17-lerobot-libero_spatial-640) | |
|---|---|---|
| 사전학습 출발점 | lerobot/smolvla_base | nvidia/GR00T-N1.7-3B |
| 파인튜닝 데이터 | lerobot/libero 전체 (episodes=None → 1,693 개, Spatial / Object / Goal / Long 4 suite 다) | IPEC-COMMUNITY/libero_spatial 만 (Spatial 전용, suite 마다 모델이 따로) |
| 파인튜닝 양 | 25,000 step x batch 32 = 80 만 샘플 (4 suite 나눠서 → Spatial 에는 대략 20 만) | 20,000 step x batch 320 = 640 만 샘플 (전부 Spatial) |
| 모델 크기 | 0.45B | 3B |
즉 SmolVLA 는 4 과목을 한 모델로 같이 공부한 학생이고, GR00T 는 공간 (Spatial) 문제만 약 30 배 더 푼 학생 이 Spatial 시험을 본 것. 아래 점수는 이 차이를 염두에 두고 봐야 한다.
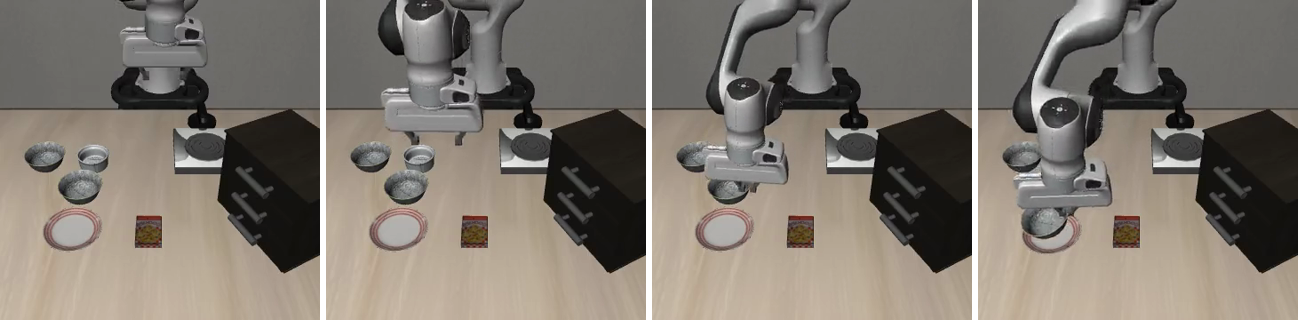
먼저 task 0 만 3 episode 로 환경 확인 (try). 3 / 3 성공. 그릇을 집어서 → 접시 위로 옮겨서 → 내려놓는다.
그리고 본 eval. LIBERO-Spatial 10 task x 10 episode = 100 번. SmolVLA 도 똑같은 조건 (lerobot-eval, 20 Hz, EGL, 같은 init state) 으로 돌린 결과랑 나란히 놓았다.
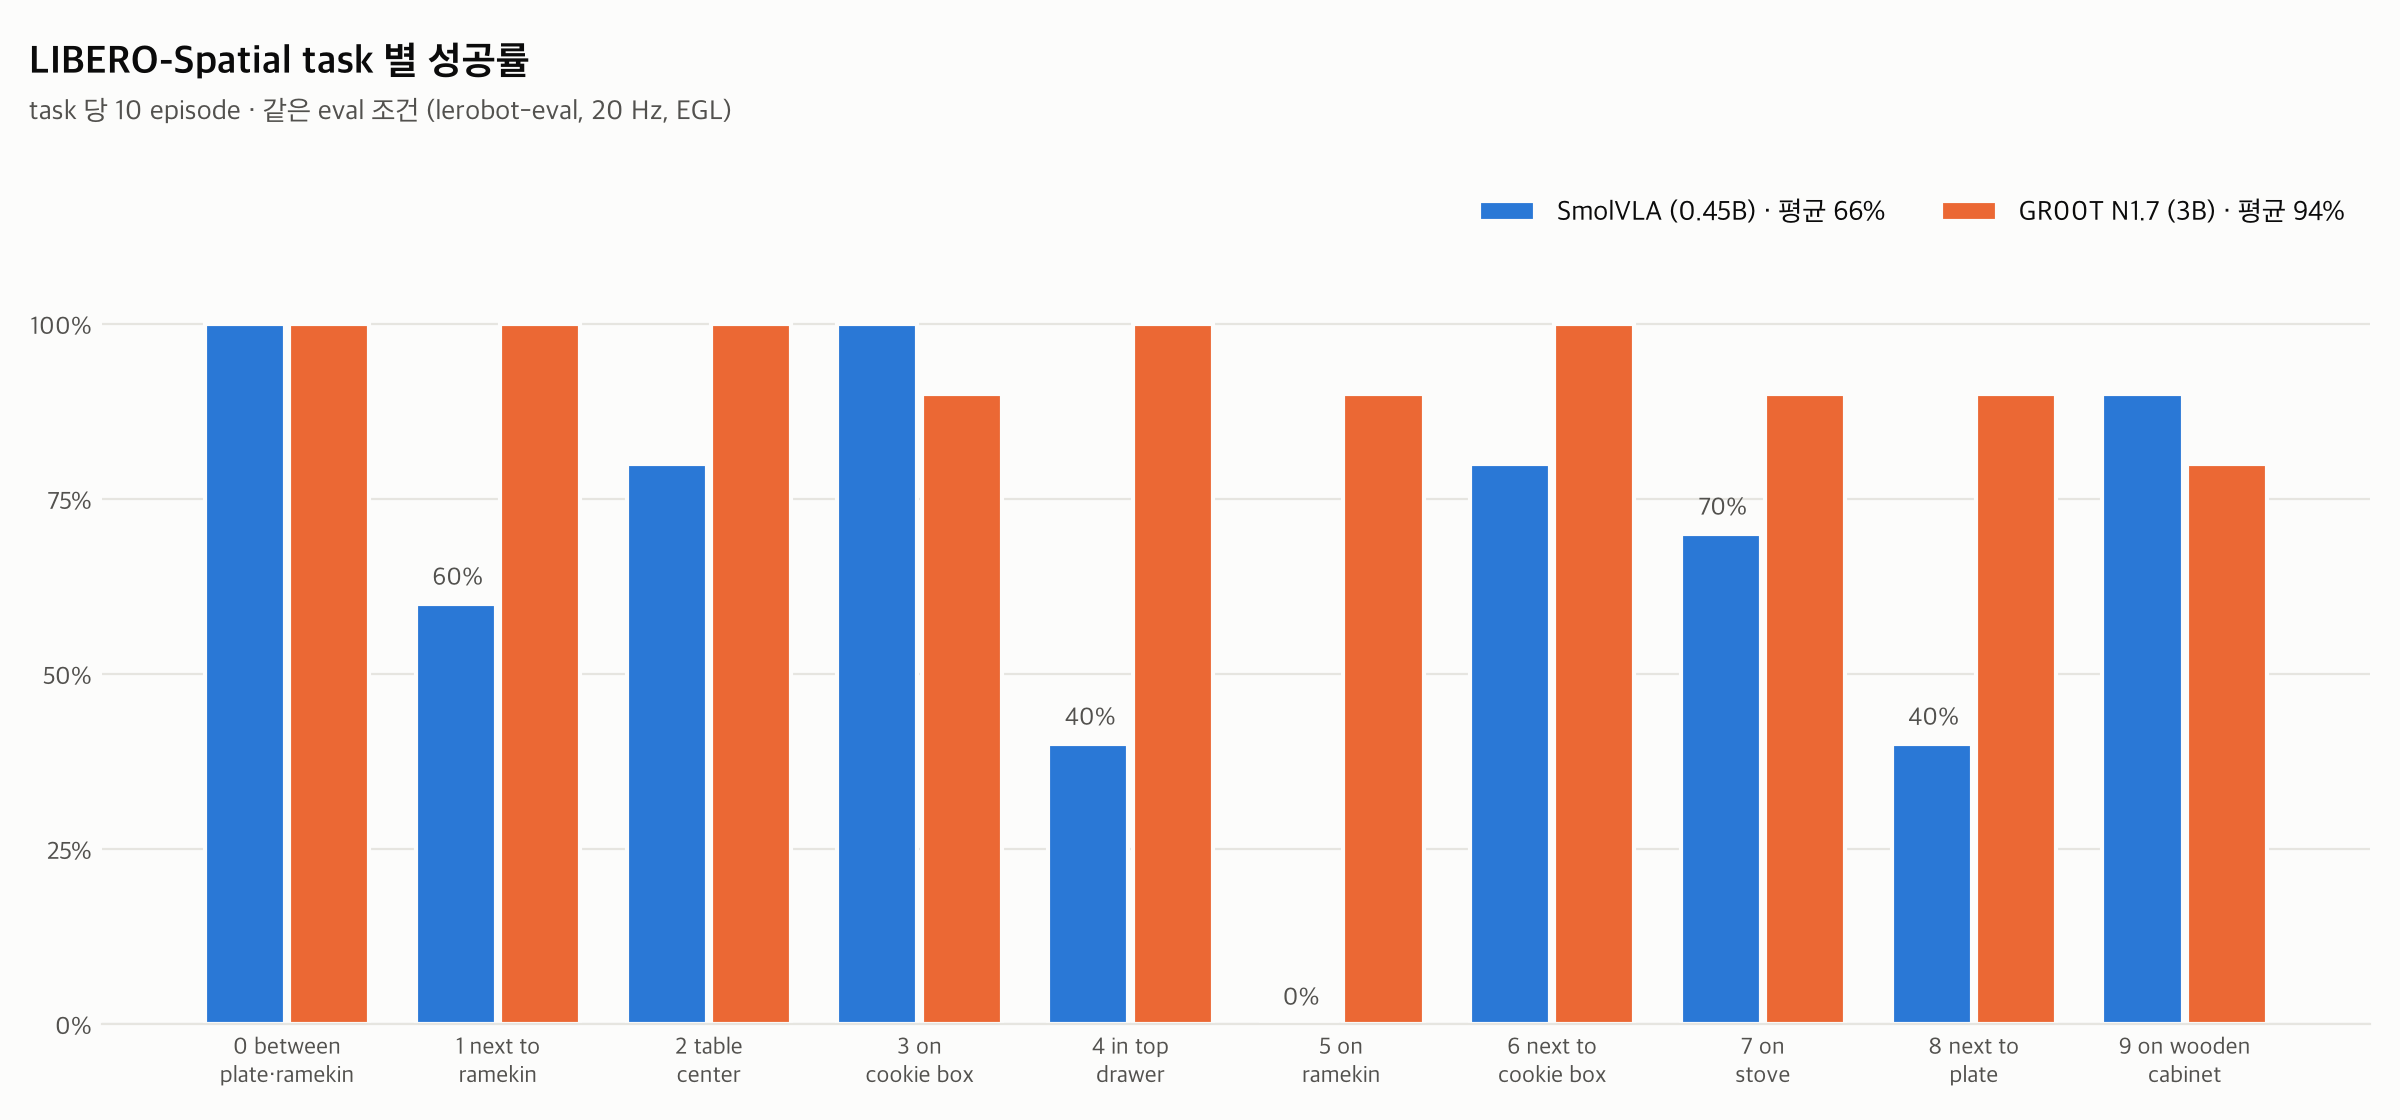
SmolVLA 66% (66 / 100) vs GR00T 94% (94 / 100)
| task | 지시문 (pick up the black bowl … and place it on the plate) | SmolVLA | GR00T |
|---|---|---|---|
| 0 | between the plate and the ramekin | 10/10 | 10/10 |
| 1 | next to the ramekin | 6/10 | 10/10 |
| 2 | from table center | 8/10 | 10/10 |
| 3 | on the cookie box | 10/10 | 9/10 |
| 4 | in the top drawer of the wooden cabinet | 4/10 | 10/10 |
| 5 | on the ramekin | 0/10 | 9/10 |
| 6 | next to the cookie box | 8/10 | 10/10 |
| 7 | on the stove | 7/10 | 9/10 |
| 8 | next to the plate | 4/10 | 9/10 |
| 9 | on the wooden cabinet | 9/10 | 8/10 |
- 10 개 task 가 전부 “검은 그릇을 집어서 접시에 놓기” 이고 어느 그릇이냐 (위치 관계) 만 다르다. 그래서 Spatial suite.
- SmolVLA 가 약한 곳은 집기 어려운 위치 다. 서랍 안 (task 4), ramekin 위 (task 5), 접시 바로 옆 (task 8). GR00T 는 이런 곳에서도 90% 이상.
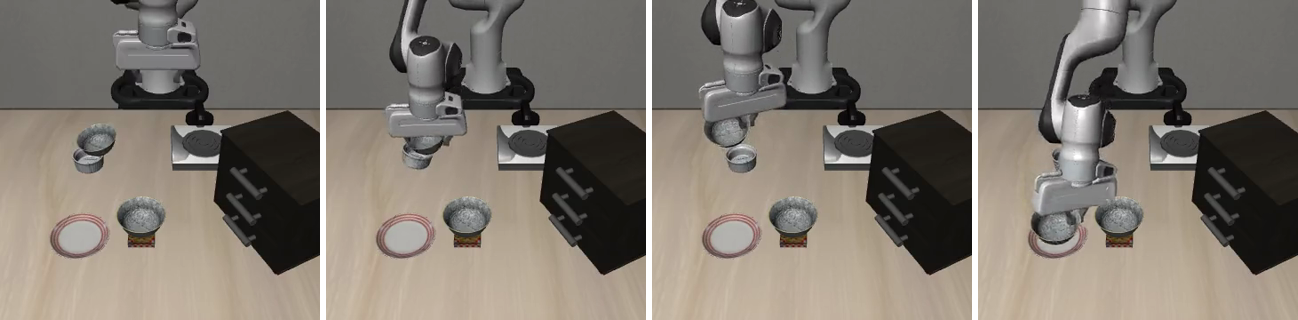
task 5 - SmolVLA 0 / 10 인 곳에서 GR00T 성공 장면
그릇이 작은 ramekin 위에 얹혀 있어서 집기 까다로운 task. GR00T 는 위에서 내려와 그릇만 집어 올리고, 접시까지 옮겨서 내려놓는다.
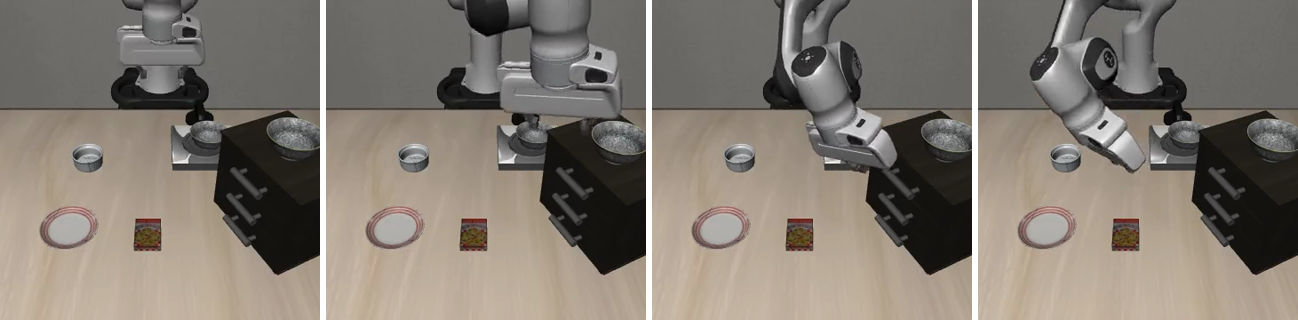
task 9 - GR00T 실패 장면 (ep 0)
그릇이 나무 캐비닛 위 에 있는 task. 팔이 캐비닛 쪽으로 가서 손을 뻗지만 그릇을 못 잡고 280 step (최대) 이 끝난다. GR00T 가 제일 낮았던 task (8 / 10).
4. Attention Mask - 내 GR00T DiT 안에서 mask 는 어디에?
part1 에서 내 DiT 는 attention 을 torch.nn.MultiheadAttention 에 맡겼다. 그럼 mask 는 어디서 만들어지고 어디에 들어갈까. 결론부터 말하면 mask 는 딱 한 군데, cross-attention 의 key 쪽 padding 에만 들어간다.
1) mask 의 출처: Qwen processor 의 attention_mask
배치 안 문장 길이가 다르면 processor 가 padding 을 넣는다. GR00T 는 Qwen 설정을 따라 왼쪽 padding (padding_side = "left"). 그때 같이 나오는 attention_mask (진짜 토큰 1 / pad 0) 를 그대로 저장해 둔다.
1
2
3
4
5
6
encoded = self.processor(text=texts, images=frames, padding=True, return_tensors="pt")
out = self.vlm(**encoded, output_hidden_states=True, return_dict=True)
hidden = out.hidden_states[self.config.select_layer]       # 16 번째 블록 hidden  [B, L_vl, 2048]
self.pad_mask = encoded["attention_mask"].bool()            # [B, L_vl]  True = 진짜 토큰
# N1.7 DiT 는 이 토큰 전체에 cross-attn. 예전 블록 마스크는 전부 한 블록.
self.att_1d_mask = torch.zeros_like(self.pad_mask)
- VLM 안쪽 (Qwen) 은 decoder 라서 자기 내부에서 causal mask 를 알아서 쓴다. 우리가 따로 만들 건 없다.
att_1d_mask가 전부 0 = 내 SmolVLA 구조 코드에서 만든 블록 mask 로 치면 “전부 한 블록”. 즉 DiT 입장에서는 VL 토큰들 사이에 순서 / 블록 구분이 없다.
2) self-attention: mask 없음
DiT 의 self-attn 토큰은 [state 1 | action 40] = 41 개. 여기는 padding 도 없고 (chunk 길이 고정), 서로 전부 본다 (양방향). 그래서 mask 를 안 넘긴다.
1
2
h = self.adaln_self(x, cond)
h = self.self_attn(h, h, h, need_weights=False)[0] + x          # mask 없음 -> 41 토큰 전부 서로 봄
내 SmolVLA 구조 코드에서는 action 끼리 causal ([1]*16) 이었는데, GR00T DiT 는 action 끼리 양방향이다. π0 랑 같은 쪽이다.
3) cross-attention: key_padding_mask 에 pad 만
action 토큰 (query) 이 VL hidden (key / value) 을 볼 때, 왼쪽에 붙은 pad 토큰만 가려야 한다.
1
2
3
4
y = self.adaln_cross(h, cond)
y = self.cross_attn(
    y, context, context, key_padding_mask=~context_pad, need_weights=False
)[0] + h
여기서 ~ (not) 가 핵심이다. 의미가 서로 반대라서 뒤집어 줘야 한다.
| True 의 의미 | |
|---|---|
Qwen attention_mask (= context_pad) | 진짜 토큰 (봐도 됨) |
nn.MultiheadAttention 의 key_padding_mask | 무시할 토큰 (가림) |
그래서 ~context_pad 로 넘겨야 pad 만 가려진다. 이거 안 뒤집으면 진짜 토큰을 다 가리고 pad 만 보게 되는데, 에러는 안 나고 조용히 학습이 망가진다.
정리: 내 SmolVLA 구조 vs 내 GR00T
| 내 SmolVLA 구조 | GR00T DiT | |
|---|---|---|
| VLM 과 action 연결 | layer 별 KV cache 공유 (self / cross 번갈아) | VLM 16 번째 hidden 하나를 cross-attn |
| mask 만드는 곳 | 1D pad + 1D att → make_att_2d_masks → 4D float mask | processor 의 attention_mask 하나 |
| action 끼리 | causal | 양방향 (mask 없음) |
| pad 처리 | 2D mask 안에 같이 들어감 | key_padding_mask=~pad |
GR00T 쪽이 mask 가 훨씬 단순하다. VLM 과 action 을 layer 마다 섞지 않고 “VLM 은 VLM 대로 끝까지 읽고, DiT 는 그 결과만 cross-attn 으로 본다” 는 구조라서.
5. Summary
- 공식 체크포인트로 eval 환경부터 검증 하는 게 먼저다. 내 모델 점수가 낮을 때 “모델 문제냐, 환경 문제냐” 를 바로 나눌 수 있다.
- 같은 LIBERO-Spatial 100 episode 에서 SmolVLA 66% vs GR00T 94%. 차이는 집기 까다로운 위치 (서랍 안, ramekin 위, 접시 옆) 에서 크게 났다. 단, 학습 데이터 범위 / 학습량 / 모델 크기가 다 달라서 “공식 체크포인트끼리의 기준점” 으로 본다.
- eval 할 때 걸리는 건 모델보다 주변 설정 이었다: 카메라 이름 (
--rename_map), 진행바 성공률 버그, config 안의 내부 경로, gated repo 토큰. - 내 GR00T DiT 의 mask 는 cross-attn 의
key_padding_mask하나뿐이고,True의미가 반대라서~로 뒤집어야 한다. - 다음: 내 GR00T (DiT 랜덤 시작) 를 줄여서 LIBERO 로 학습 → 같은 eval 로 비교.