SmolVLA (Inference) - part1 (VLM)
lerobot의 SmolVLA 코드를 직접 뜯어서 추론 과정 중 VLM 부분을 따라가본다. 입력 생성 → preprocessing → prepare_* → embed_prefix → VLM 16 layers → KV Cache까지, attention mask와 RoPE, GQA를 코드와 함께 정리한다.
실습 목표 자체는 실제로 VLA의 코드를 뜯어 분석해보는 것이다. (lerobot → SmolVLA)
- Inference
- VLM (이번시간)
- Action Expert (다음시간)
- Training (다다음시간)
SmolVLA: A vision-language-action model for affordable and efficient robotics
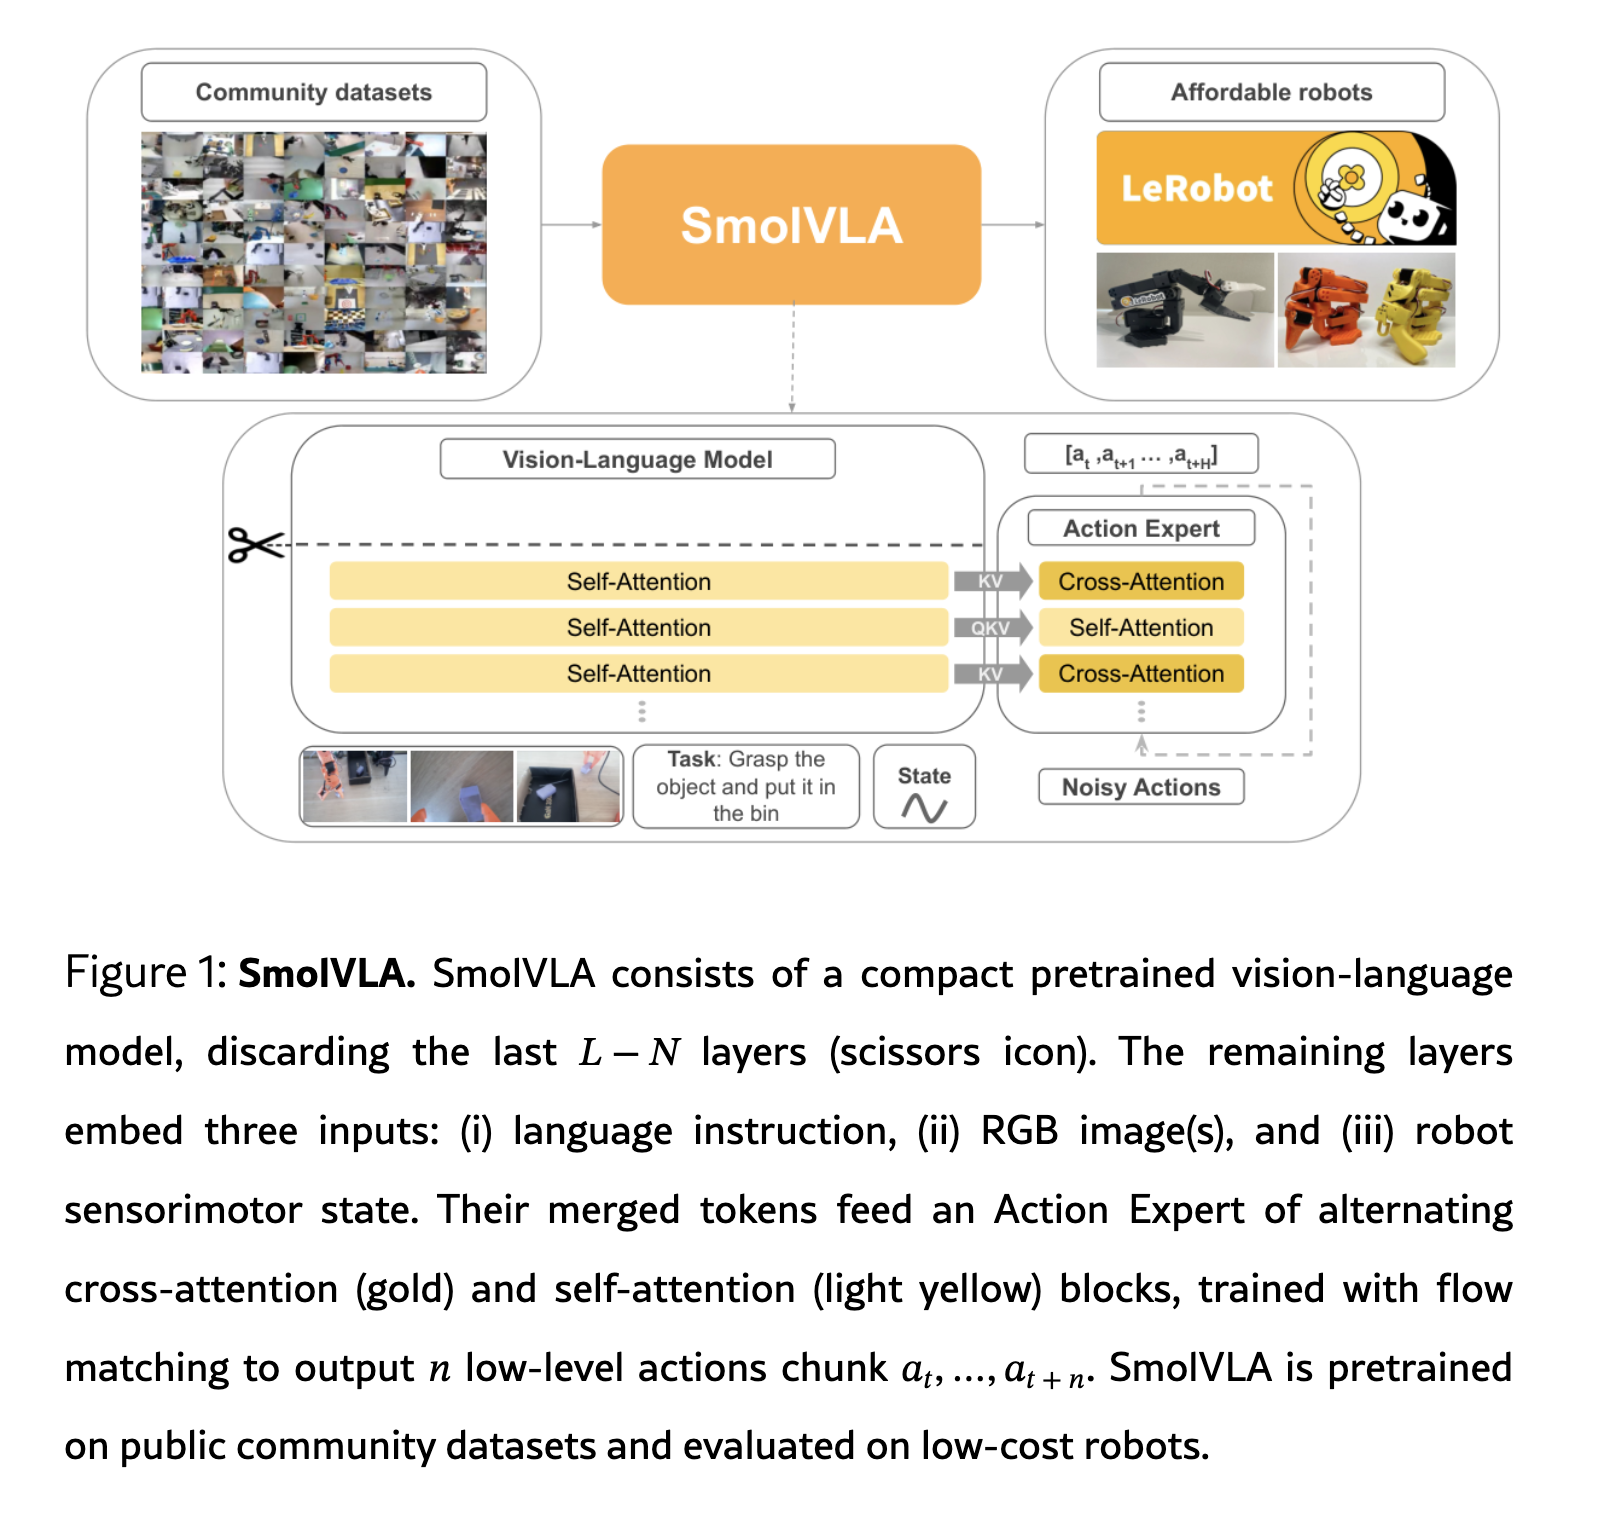
일단 실습용 로봇을 굉장히 저렴하게 30~40만원정도? 로 판매를 하고 있고 데이터 수집, 학습까지 실제로 할 수 있을 정도로 제작된 아주 행복한 SmolVLA의 코드를 정독해서 읽어보고자 한다. 사실 밖으로 보면 VLA의 구조가 별게 없는 것 같지만, 실제로 코드를 뜯어보면 정말 다양한 테크닉들이 숨겨져있다. 들어가보자.
Inference overall Workflow
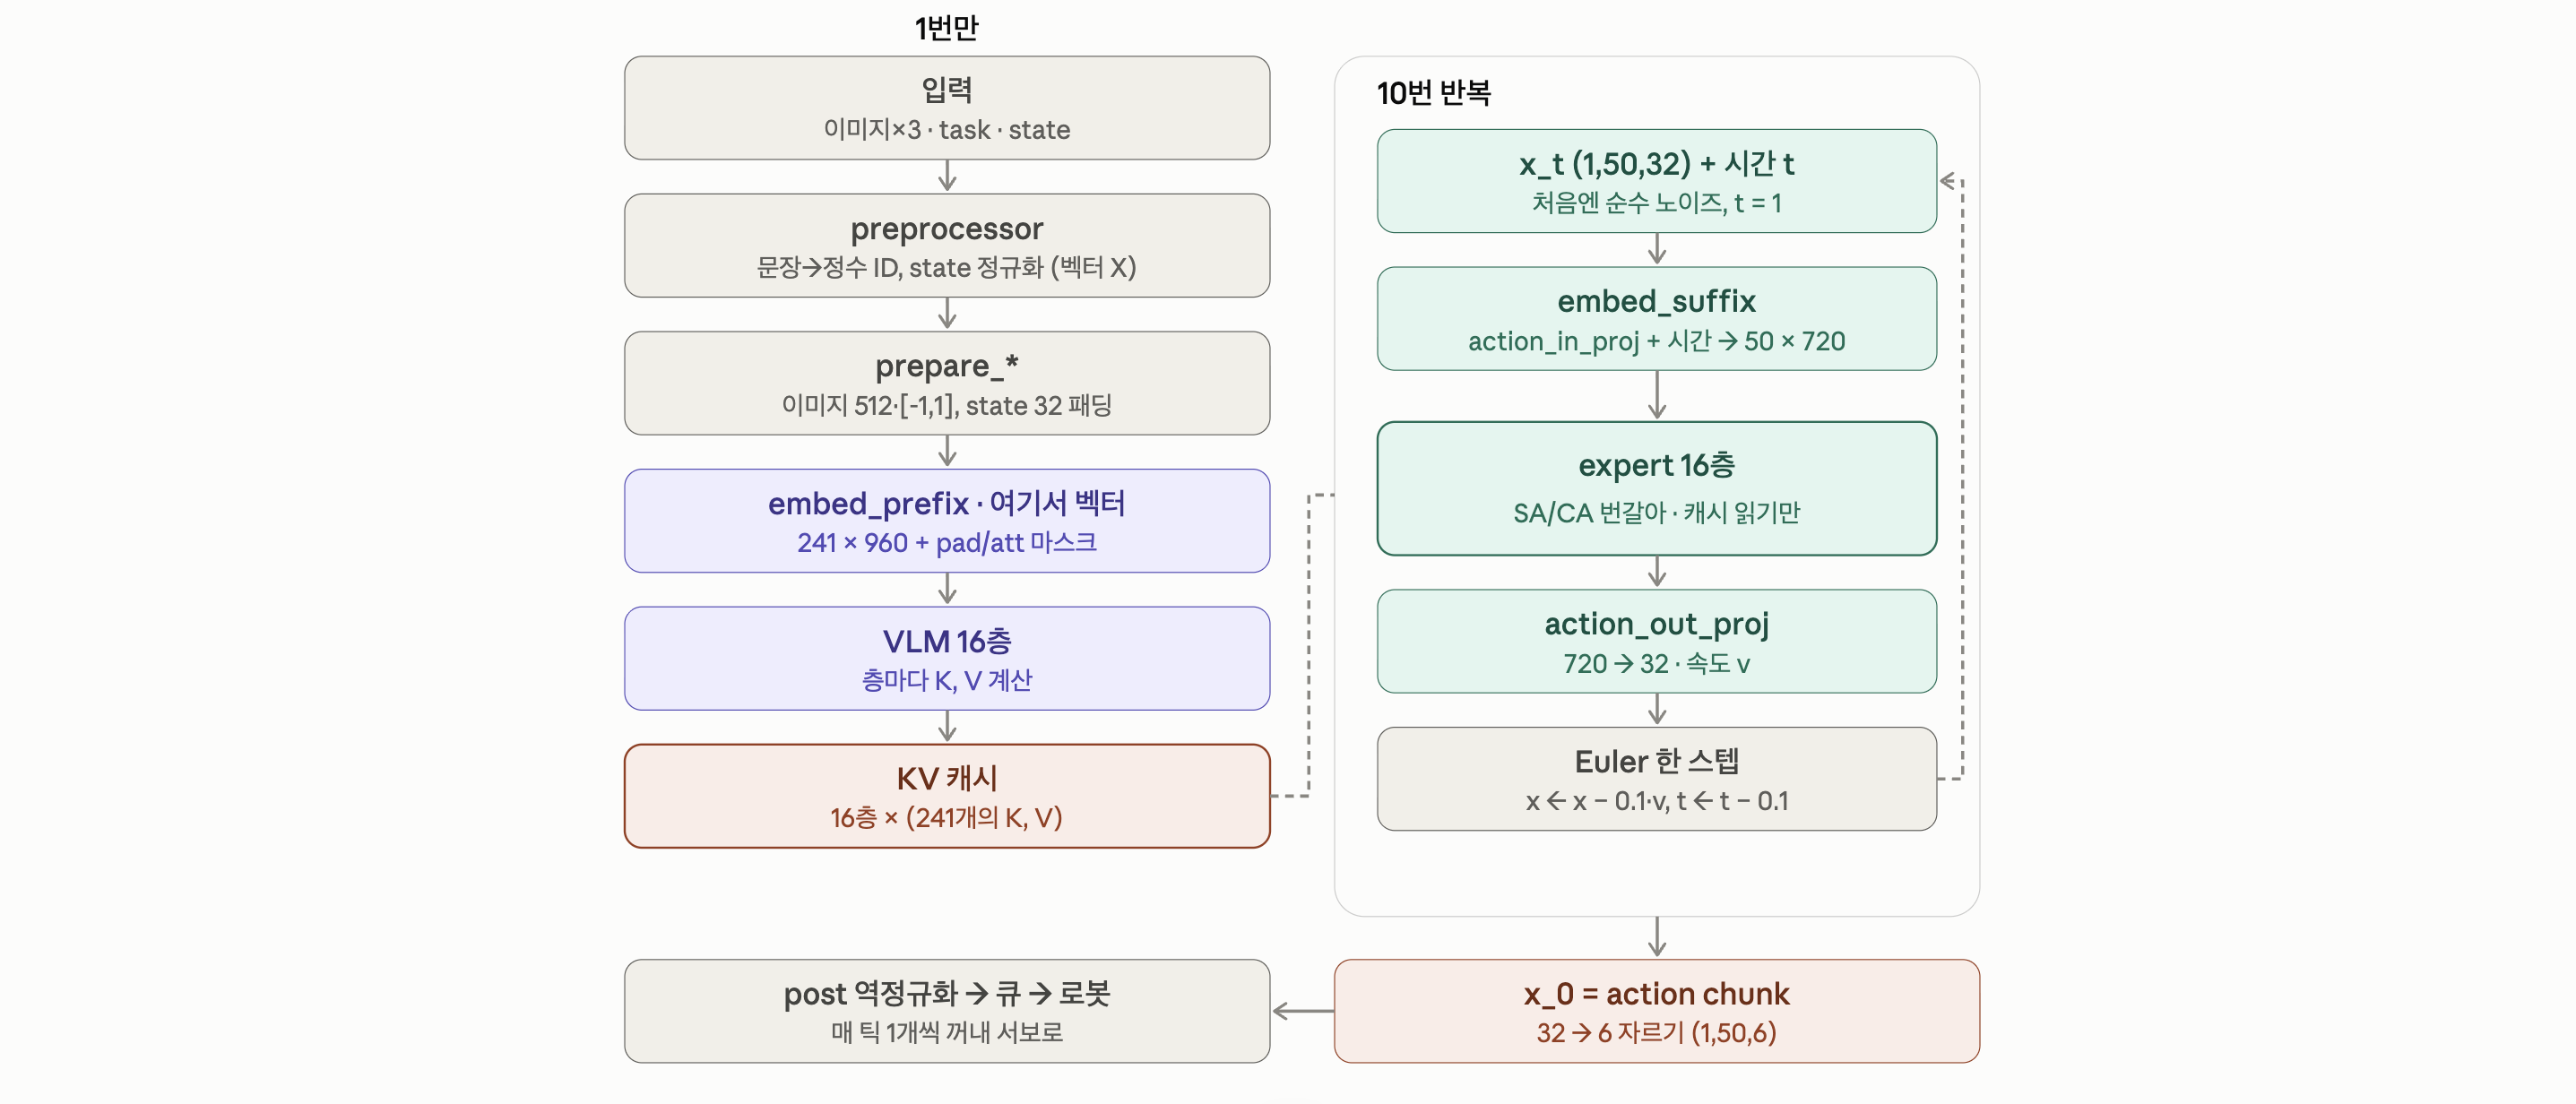
일단 전체적으로 흐름을 이해해보자. 크게 좌측의 VLM 우측의 Action Expert 이렇게 2가지로 이해를 하면 된다. 좌측의 VLM같은 경우는 말 그대로 그냥 image, prompt, state 3가지를 input으로 넣어서 KV Cache를 output하는 것을 목표로 둔다.
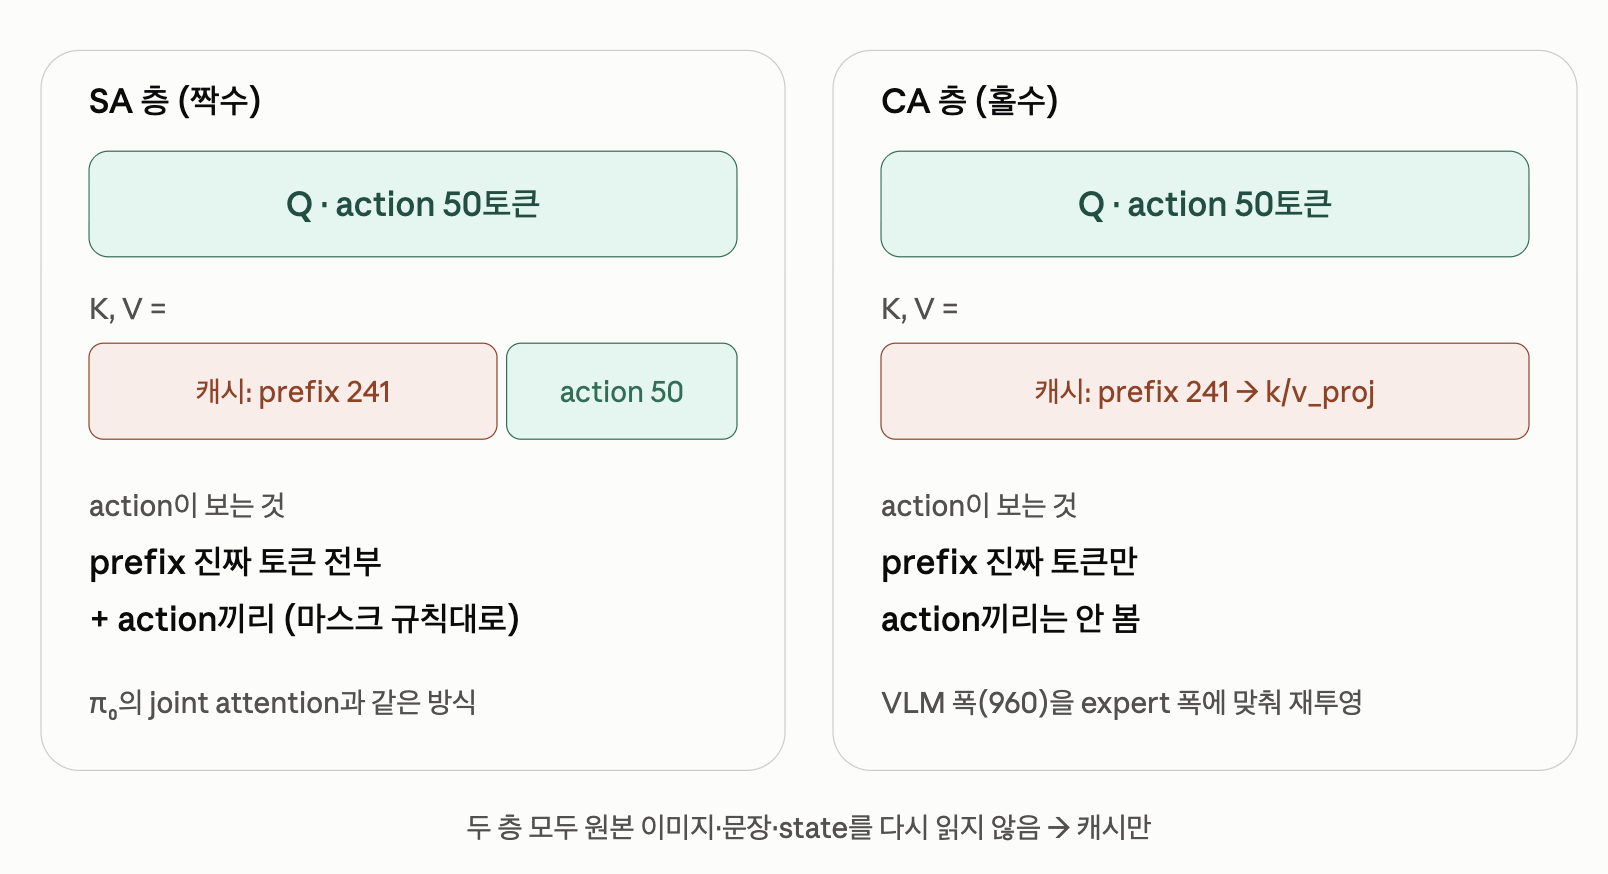
그리고 거기서 추출된 KV Cache를 이제 Action Expert 에서 Cross-attention, Self-attention 용도로 사용하는 것이다. 실제 Action Expert 내부 구조에서는 이제 Self attention과 Cross attention 두개가 이제 공존하는 그런 구조를 띄고 있다. 그러니까 이제 거기서 KV Cache (Prefix) 가 둘다 들어가게 되는 것이다.
(실제 코드에서는 layer가 홀수냐 짝수냐로 두가지를 번갈아 가면서 사용하였다.)
오늘 파헤칠 메인 워크플로우는 위 구조중에서 앞부분인 VLM workflow를 자세하게 코드를 들여다 보면서 파헤쳐 보자. 코드는 감사하게 lerobot에서 오픈소스로 공개한 SmolVLA 가 존재한다.
VLM workflow
- input: image x 3 , task, state
- preprocessor
- prepare_*
- embed_prefix
- VLM 16 layers
- KV Cache
Step0 env settings
일단 환경은 MacBook Air에서 진행을 해보자. 먼저 맨처음에 github repo → lerobot 을 다운로드 받는다.
1
2
3
git clone https://github.com/huggingface/lerobot.git
cd lerobot
pip install -e ".[smolvla]"
그리고 이제 그 다음에 Config을 다운로드 받고 그리고 이어서 바로 기본적인 세팅에 들어가보자.
여기서 핵심은 3가지이다.
- Config - 모델 설계도
- Policy - 설계도를 바탕으로 만든 실제 robot policy model
- Pre, Post - preprocessing, postprocessing을 위한 인스턴스
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# Step 0 - setting, download pretrained model and config

import torch
from lerobot.configs import PreTrainedConfig
from lerobot.policies import make_pre_post_processors
from lerobot.policies.smolvla.modeling_smolvla import SmolVLAPolicy

MODEL_ID = "lerobot/smolvla_base"
DEVICE = "cpu"

# 모델 설계도를 다운받는 것. (레이어 갯수 등등)
config = PreTrainedConfig.from_pretrained(MODEL_ID)
config.device = DEVICE

# create policy model based on that config file.
policy = SmolVLAPolicy.from_pretrained(MODEL_ID, config=config)
policy.eval()

# create preprocessor and post processor instance based on the config file.
pre, post = make_pre_post_processors(policy.config,
                                     pretrained_path = MODEL_ID,
                                     preprocessor_type = "smolvla",
                                     device = DEVICE)
Step1 Generate Input
자 그 다음으로는 이제 실제로 임의의 input을 그냥 만들어보자. 이미지 3장과 task를 만든다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# Step1 create input

from lerobot.utils.constants import OBS_STATE
import torch


raw = {
    "observation.images.camera1": torch.rand(3,256,256),
    "observation.images.camera2": torch.rand(3,256,256),
    "observation.images.camera3": torch.rand(3,256,256),
    OBS_STATE: torch.rand(6), # 6 DOF robot
    "task": "pick up the red cube and place it in the box",
}

# 실제로 확인해보기. (디버깅)
for k, v in raw.items():
    print(k, v.shape if isinstance(v, torch.Tensor) else v)
Step2 Preprocessing (tokenizer, normalization, …)
그 다음으로 이제, preprocessing을 진행하는데 굉장히 쉽다.
1
2
3
4
5
6
7
8
9
10
11
12
13
# Step 0 에서 정의한 pre processor instance
# create preprocessor and post processor instance based on the config file.
pre, post = make_pre_post_processors(policy.config,
                                     pretrained_path = MODEL_ID,
                                     preprocessor_type = "smolvla",
                                     device = DEVICE)


# Step2 preprocessor
state_before = raw[OBS_STATE].clone()

batch = pre(raw)
코드는 정말 간단하지만, 사실 pre - instance에 들어간 입력이 다음 순서대로 가공이 이루어지는 것이다.
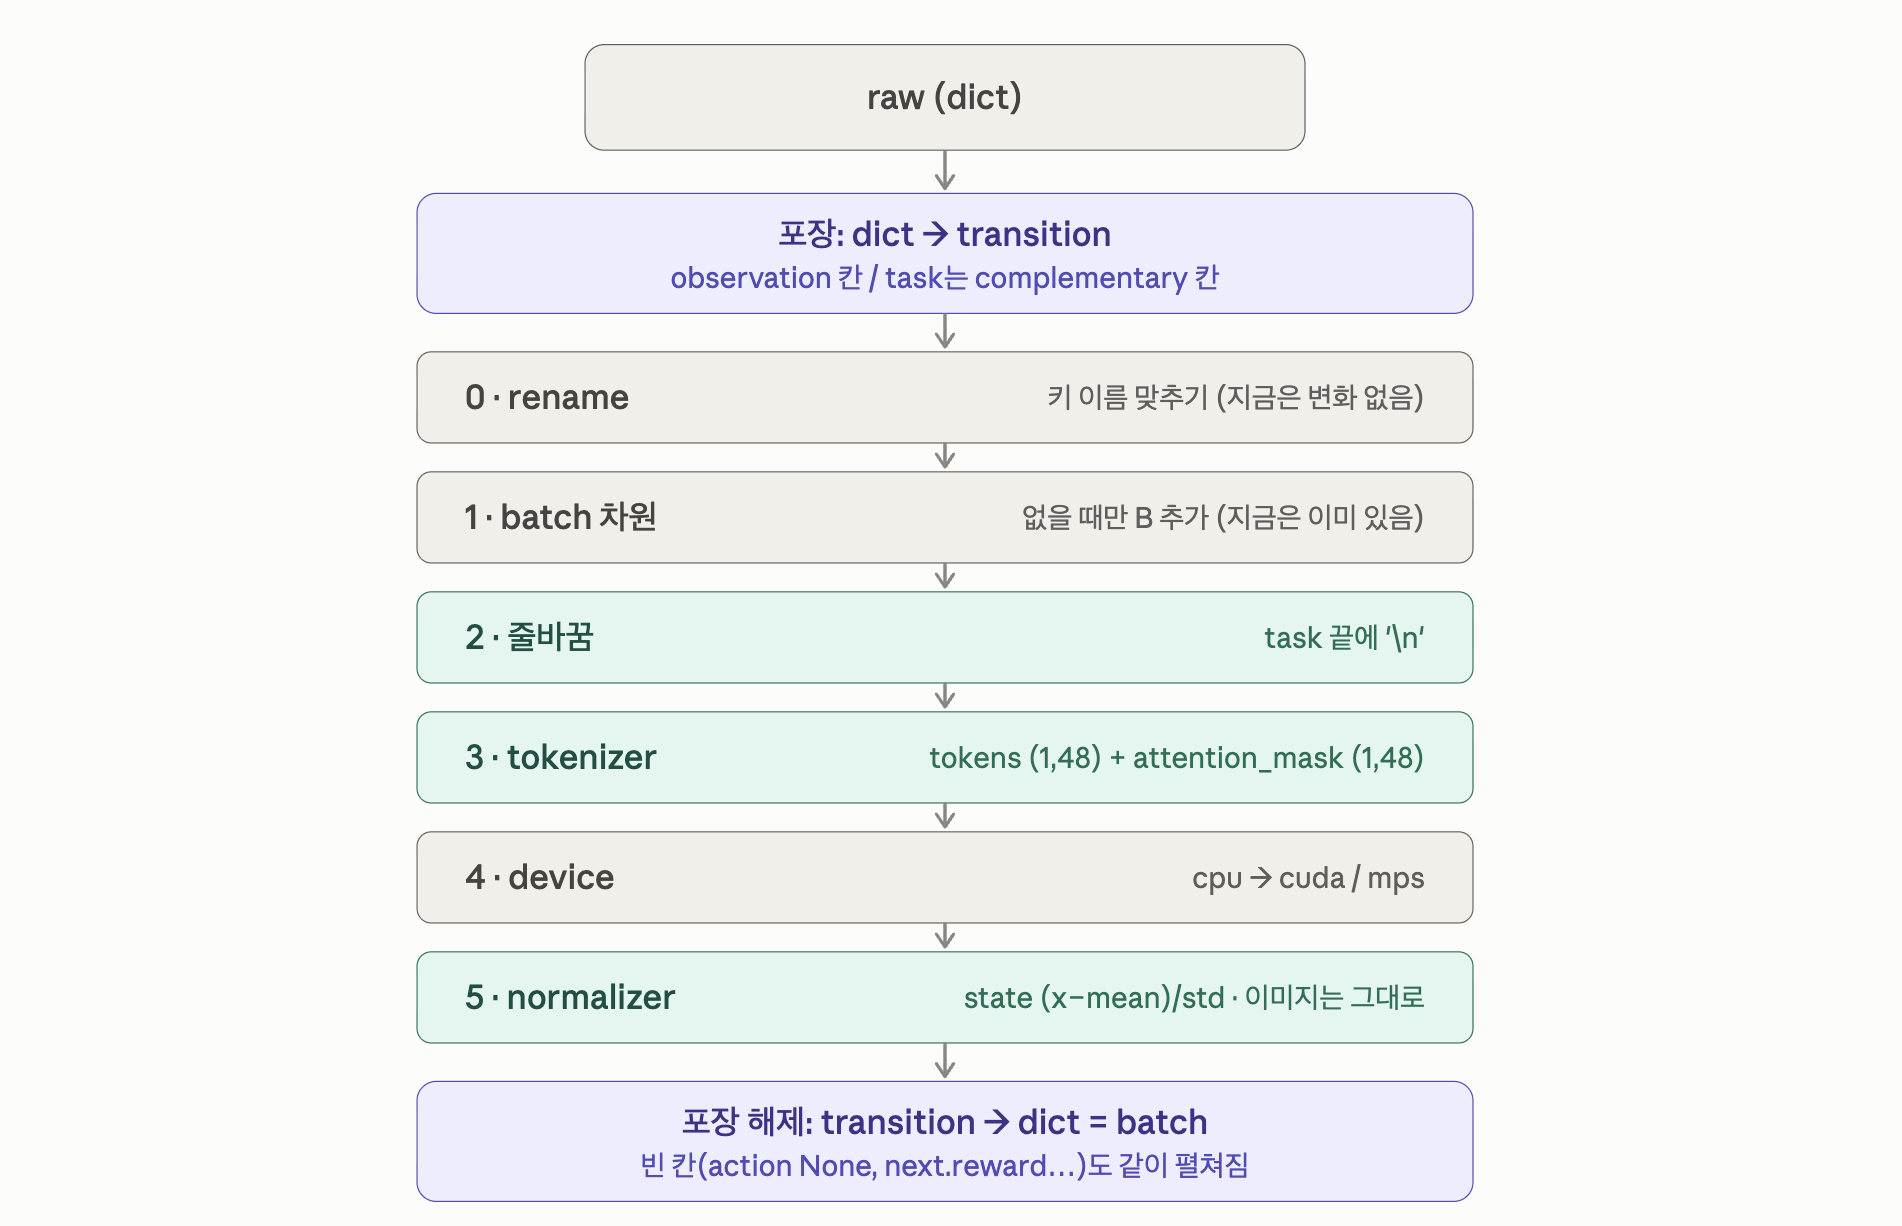 자세한 내부 과정은 source code에 담겨져 있다
자 그렇다면 최종적으로 나온 Batch에 어떤 정보들이 있는지를 살펴보자.
1
2
3
4
5
6
print("====raw -> batch  ====")
for k, v in batch.items():
    if isinstance(v, torch.Tensor):
        print(f"{k}: {v.shape} {v.dtype} {v.device}")
    else:
        print(f"{k}: {v}")
1
2
3
4
5
6
7
8
9
10
11
12
13
====raw -> batch  ====
action: None
next.reward: 0.0
next.done: False
next.truncated: False
info: {}
task: ['pick up the red cube and place it in the box\n']
observation.images.camera1: torch.Size([1, 3, 256, 256]) torch.float32 cpu
observation.images.camera2: torch.Size([1, 3, 256, 256]) torch.float32 cpu
observation.images.camera3: torch.Size([1, 3, 256, 256]) torch.float32 cpu
observation.state: torch.Size([1, 6]) torch.float32 cpu
observation.language.tokens: torch.Size([1, 48]) torch.int64 cpu
observation.language.attention_mask: torch.Size([1, 48]) torch.bool cpu
여기서 한가지 보고 가야할게 바로 language.attention_mask이다. boolean list로 이루어져 있고, 실제로 prompt가 48개의 토큰으로 이루어져있는데 우리가 작성한 “pick up the ~”가 모두 48개는 아니다. 따라서 나머지 부분을 패딩 토큰으로 채워넣고, 그리고 이제 마스크로 표시를 해놓는 것이다.
1
2
3
4
5
tokens = batch["observation.language.tokens"][0]
mask = batch["observation.language.attention_mask"][0]

print("tokens:", tokens)
print("mask:", mask)
1
2
3
4
5
6
7
8
9
10
11
12
#output

tokens: tensor([18188,   614,   260,  2382, 20636,   284,  1379,   357,   281,   260,
         3985,   198,     2,     2,     2,     2,     2,     2,     2,     2,
            2,     2,     2,     2,     2,     2,     2,     2,     2,     2,
            2,     2,     2,     2,     2,     2,     2,     2,     2,     2,
            2,     2,     2,     2,     2,     2,     2,     2])
mask: tensor([ True,  True,  True,  True,  True,  True,  True,  True,  True,  True,
         True,  True, False, False, False, False, False, False, False, False,
        False, False, False, False, False, False, False, False, False, False,
        False, False, False, False, False, False, False, False, False, False,
        False, False, False, False, False, False, False, False])
Step3 Prepare_*
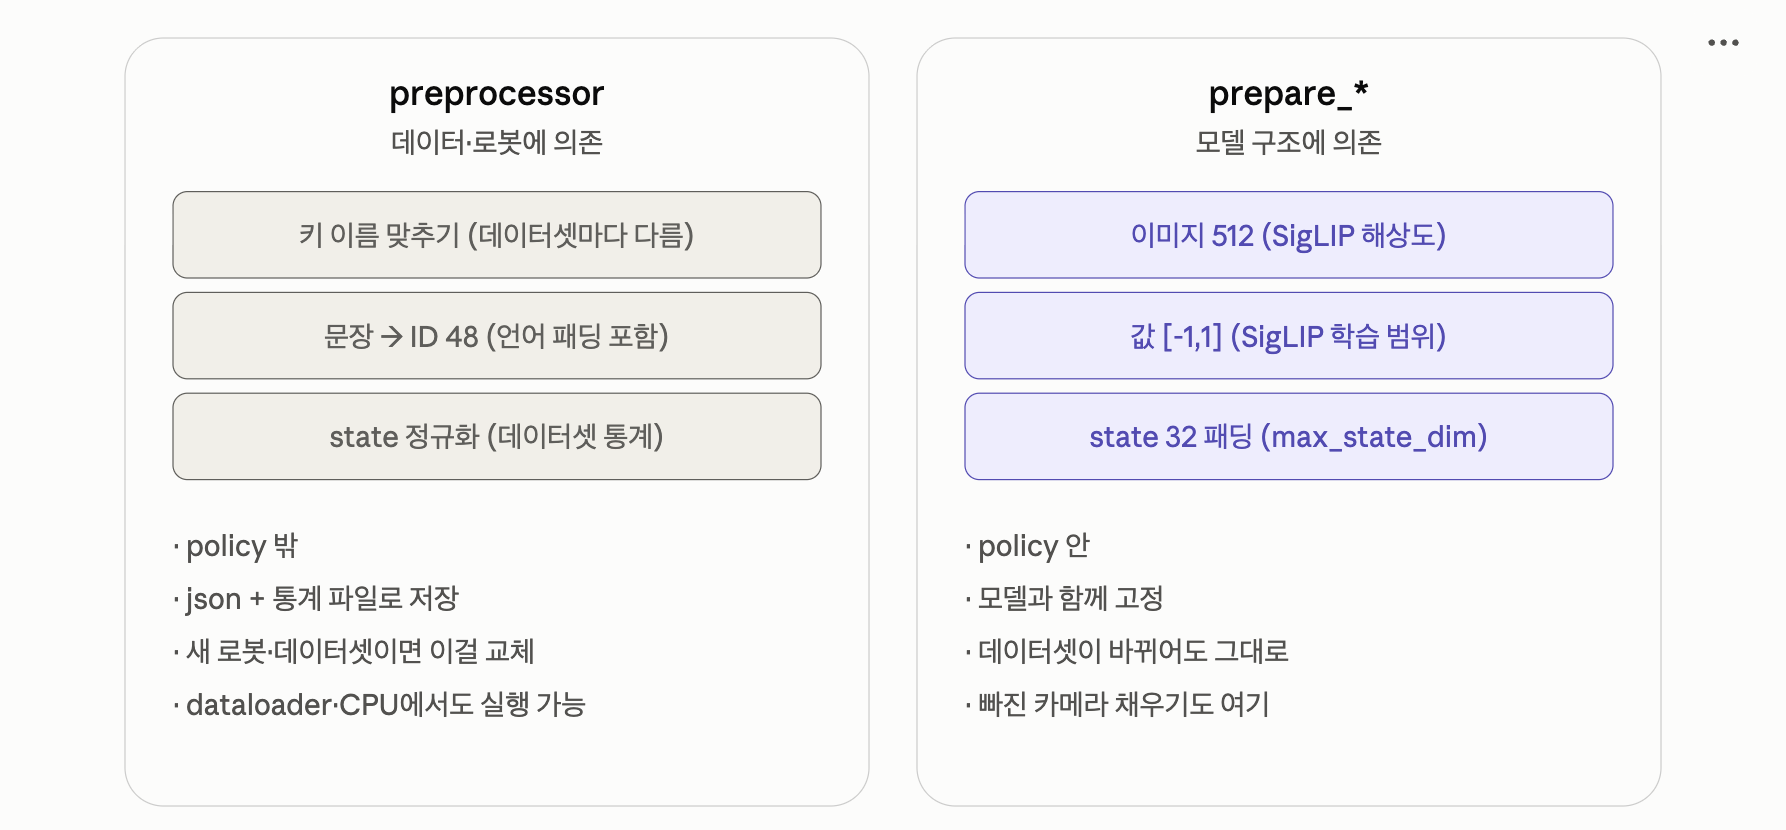
그러니까 생각을 해보면, 같은 데이터, 로봇에 대해서 우리가 policy모델의 구조를 막 바꿔가면서 실제 실험을 진행할 것이다. 즉 정책 모델에 따라서, 데이터의 dimension이나 구조가 살짝살짝 바뀌어야 한다는 것이다. 따라서, prepare_*단계를 별도로 설정하여 놓고, 가공하는 단계를 넣어놓은 것이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# Step3 Prepare_* 모델구조가 요구하는 형태로 변환 (모델에 맞춤)
images, img_masks = policy.prepare_images(batch)
state = policy.prepare_state(batch)

lang_tokens = batch["observation.language.tokens"]
lang_masks = batch["observation.language.attention_mask"]


print("====batch -> prepare_* ====")

# 이미지: 카메라 3개가 리스트로 묶임
print("images     :", len(images), "x", images[0].shape)
print("img_masks  :", len(img_masks), "x", img_masks[0].shape, img_masks)
print("image range: before", batch["observation.images.camera1"].min().item(), "~", batch["observation.images.camera1"].max().item())
print("             after ", images[0].min().item(), "~", images[0].max().item())

# state: 6 → 32 패딩
print("state      :", batch["observation.state"].shape, "->", state.shape)
print("state[0]   :", state[0])

# 언어: 그대로
print("lang_tokens:", lang_tokens.shape)
print("lang_masks :", lang_masks.shape)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# output

====batch -> prepare_* ====
images     : 3 x torch.Size([1, 3, 512, 512])
img_masks  : 3 x torch.Size([1]) [tensor([True]), tensor([True]), tensor([True])]
image range: before 4.0531158447265625e-06 ~ 0.9999984502792358
             after  -0.9934494495391846 ~ 0.9839168787002563
state      : torch.Size([1, 6]) -> torch.Size([1, 32])
state[0]   : tensor([0.0010, 0.8829, 0.1929, 0.0569, 0.4176, 0.2784, 0.0000, 0.0000, 0.0000,
        0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000,
        0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000,
        0.0000, 0.0000, 0.0000, 0.0000, 0.0000])
lang_tokens: torch.Size([1, 48])
lang_masks : torch.Size([1, 48])
이번에 우리가 사용할 SmolVLA policy model을 위해서 바뀐점은 다음과 같다.
| 항목 | 바뀐 점 | 이유 |
|---|---|---|
| 이미지 형태 | dict 안의 키 3개 → 리스트 3개 | 다음 단계에서 카메라 순서대로 하나씩 임베딩하기 위해 |
| 이미지 크기 | 256 → 512 | SmolVLA config의 resize_imgs_with_padding=(512, 512) |
| 이미지 범위 | [0,1] → [-1,1] | 비전 인코더(SigLIP)가 기대하는 범위 |
img_masks | 전부 True | 3개 카메라가 모두 있음. 빠진 카메라가 있으면 False |
| state | (1,6) → (1,32) | state_proj가 32차원 입력으로 고정. 앞 6개는 원래 값, 뒤 26개는 0 |
| 언어 | 변화 없음 | pre에서 이미 끝남 |
Step4 embed_prefix
이제 가장 중요한 token → embedding vector 단계를 거쳐야한다. 이 단계에서는 우리가 지금까지 가공했던 prefix 를 임베딩으로 전환하는 단계이다.
1
2
3
4
5
6
7
8
9
10
11
# Step4 Embed_prefix
model = policy.model
with torch.no_grad():

    # 이미지 한장이 토큰 몇개가 되는지 따로 확인해보자.
    one_img_tokens = model.vlm_with_expert.embed_image(images[0])

    # 이게 그냥 메인 메서드.
    prefix_embs, prefix_pad_masks, prefix_att_masks = model.embed_prefix(
        images, img_masks, lang_tokens, lang_masks, state
    )
사실 policy.model 에 있는 embed_prefix 라는 메서드를 쓰기만 하면 된다.
나온 결과는 총 3가지이고 각각 어떤 정보가 담겨있는지 살펴보자. 총 241개의 토큰이 각각 960 디멘션의 벡터로 표현된 텐서이다. 241개인 이유는 이미지 3장 + 태스크 프롬프트 + state 이렇게 3가지 토큰의 합인 것.
1
2
3
4
5
print("prefix_embs:\n")
print(prefix_embs)
print("prefix_embs   :", prefix_embs.shape, prefix_embs.dtype)
print("prefix_pad_masks:", prefix_pad_masks.shape)
print("prefix_att_masks:", prefix_att_masks.shape)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17

tensor([[[ 1.5300e+02,  9.4000e+01, -6.2000e+01,  ...,  1.4800e+02,
          -1.4300e+02, -9.1000e+01],
         [ 7.9000e+01,  7.3500e+01,  7.5500e+01,  ...,  1.4900e+02,
          -1.7600e+02,  5.6250e+01],
         [ 6.5938e+00,  7.7000e+01, -6.7500e+01,  ...,  2.8000e+02,
          -1.2800e+02,  7.0000e+01],
         ...,
         [ 2.2344e+00, -1.4297e+00, -2.5156e+00,  ...,  8.9062e-01,
           6.9531e-01,  4.2480e-02],
         [ 2.2344e+00, -1.4297e+00, -2.5156e+00,  ...,  8.9062e-01,
           6.9531e-01,  4.2480e-02],
         [-3.0420e-01, -1.7291e-01, -2.4357e-01,  ...,  2.1553e-01,
           3.7929e-02,  2.0679e-02]]]) -> 우리가 원하던 임베딩 벡터
prefix_embs   : torch.Size([1, 241, 960]) torch.float32
prefix_pad_masks: torch.Size([1, 241])
prefix_att_masks: torch.Size([1, 241])
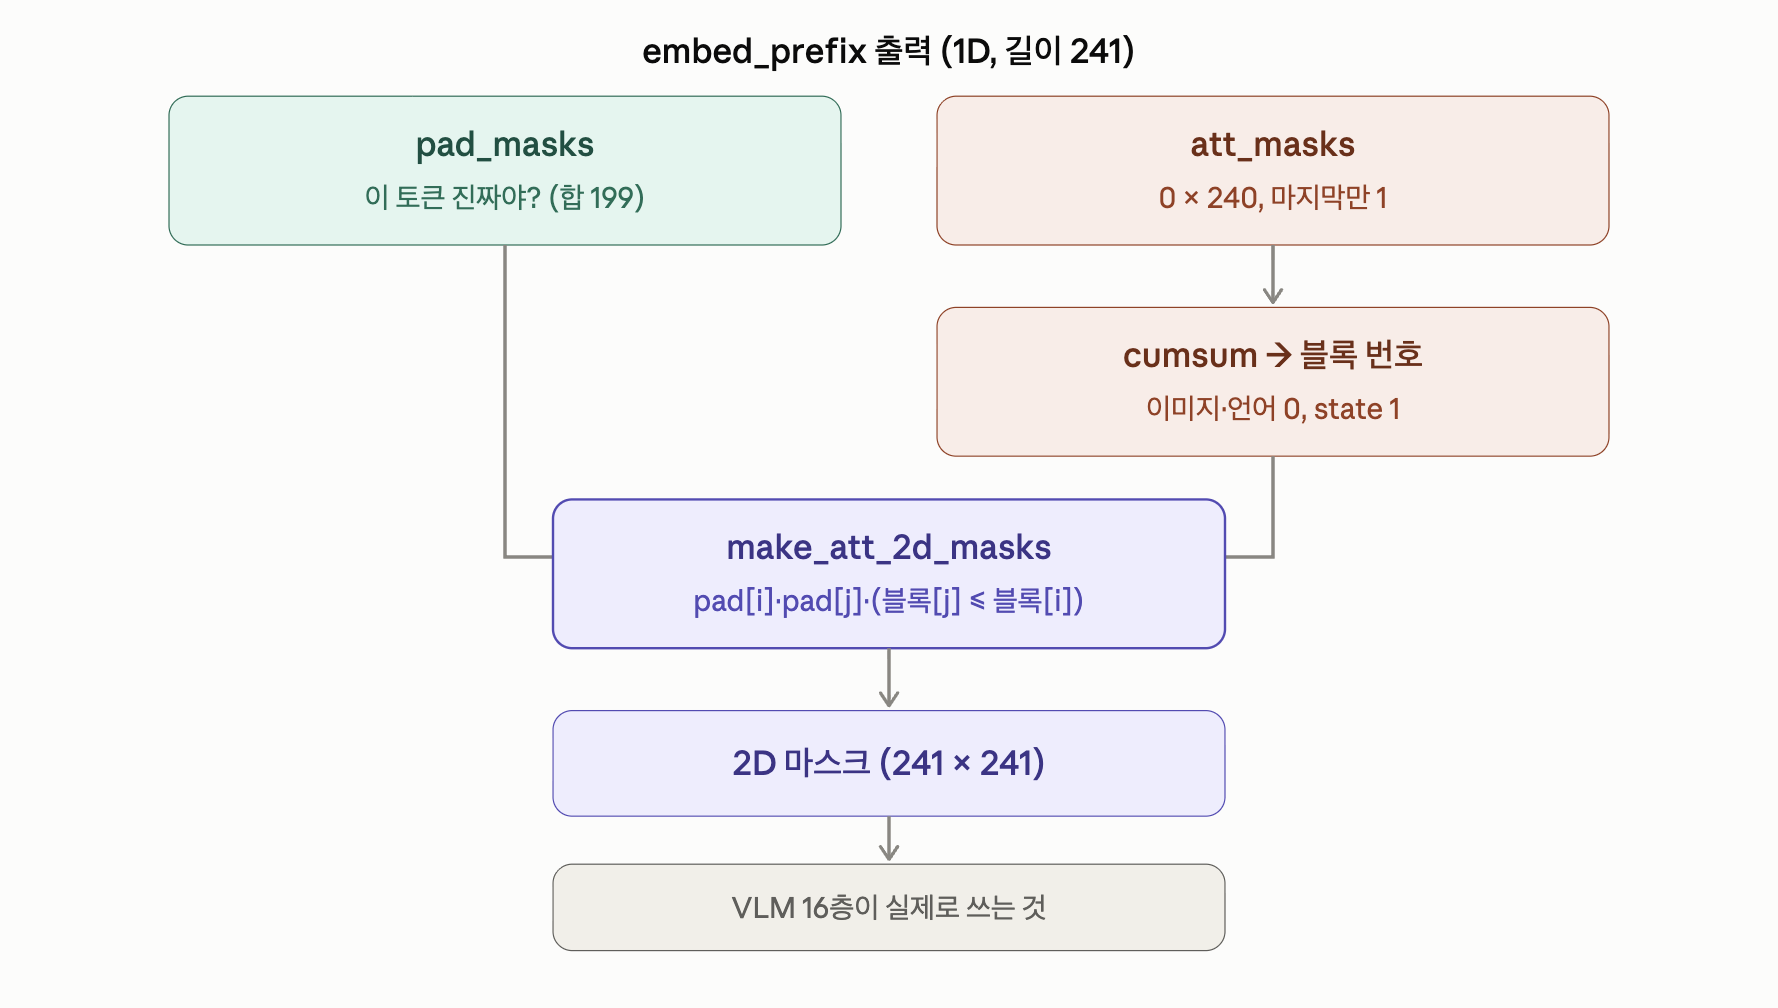
살짝 여기서 햇갈리지만 정신 바짝 차리고 Mask 2가지를 이해해보자. pad_masks 는 사실 가장 간단하다 우리가 텍스트 state image 모두 상황마다 토큰의 갯수가 다를 것이기 때문에 우리는 실제 받은 토큰이외의 부분을 넉넉하게 잡고 패딩으로 채워넣어 줬다. 그 부분을 boolean 으로 저장해놓은 것이 바로 pad_masks.
Attention Mask
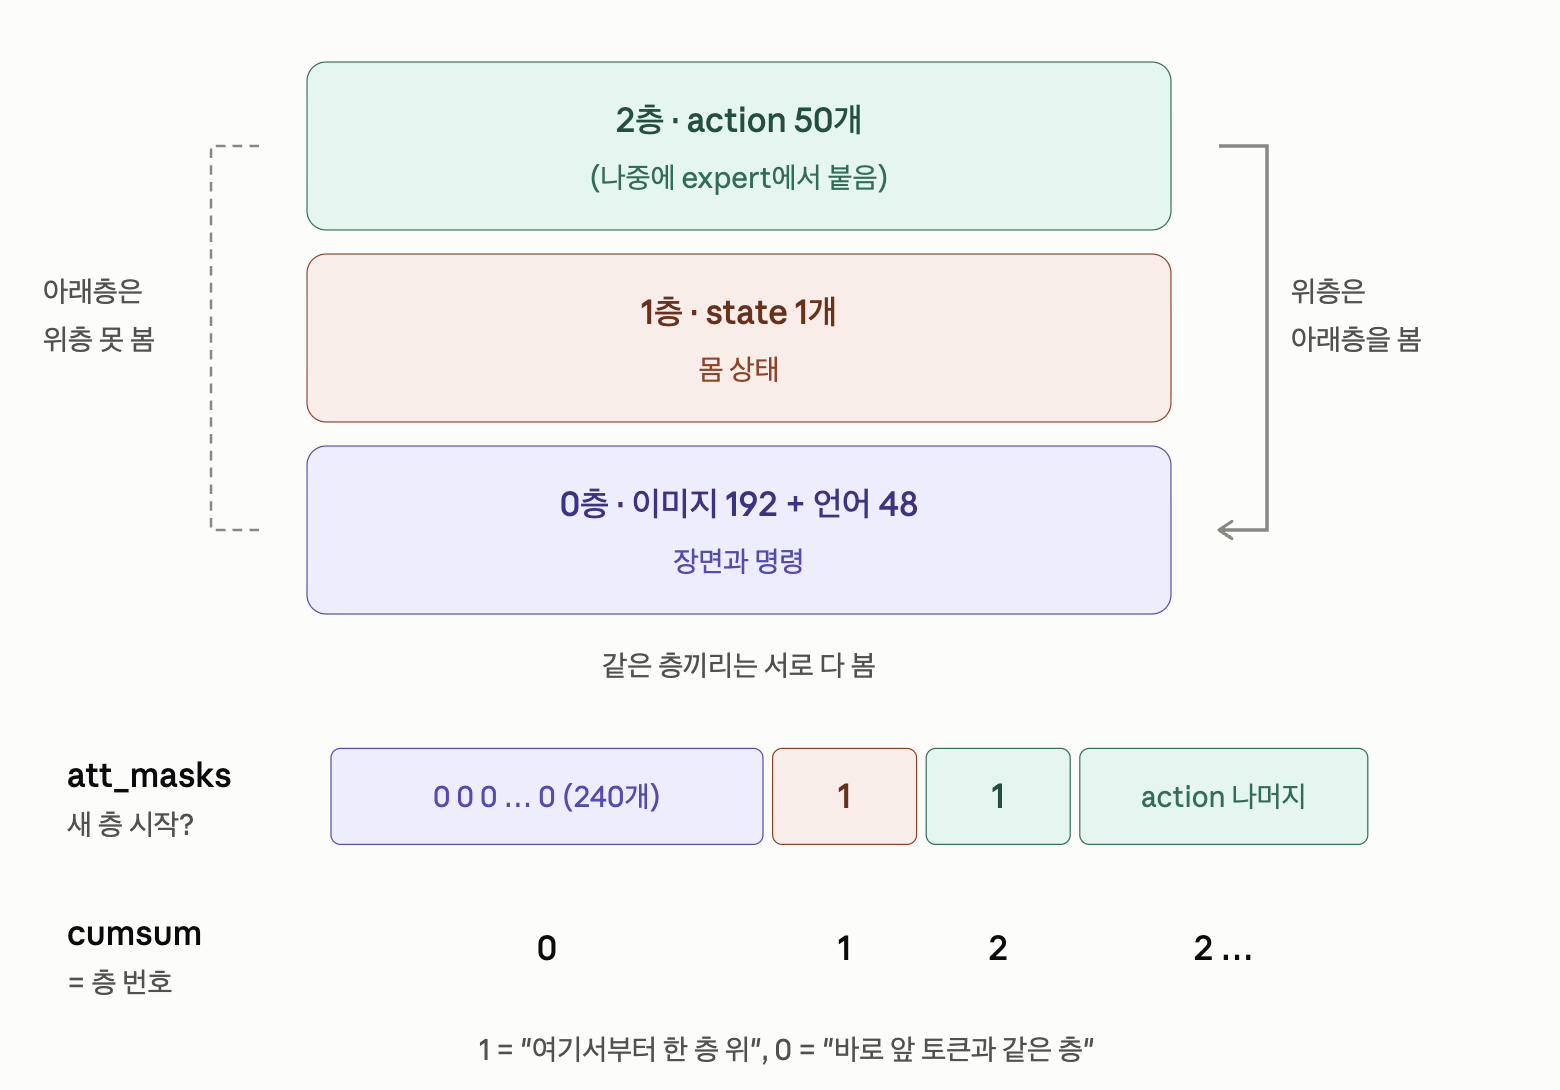
중요한 개념 중 하나이기 때문에 제대로 짚고 넘어가자. NanoGPT 시간에도 배웠지만, Attention mask의 핵심은 누가 누구를 참고하고, 누구는 누구를 참고할 수 없는지 그 접근 권한에 있다. 여기서 로봇은 총 3가지 블락으로 계급을 나누었고, 아래층은 위를 보지 못하도록 설계가 되어있는 것이다.
“누가 누구를 본다라는 의미는”
“Query를 던졌을때, Key, Value로 참고 할 수 있다” 라는 말이다.
재미있는 것은 우리가 얻은 prefix_att_masks를 output해보면, 다음과 같다.
1
2
3
4
5
6
prefix_att_masks:

tensor([[False, False, False, False, False, False, False, False, False, False,
         False, False, False, False, False, False, False, False, False, False,
	        ...
          True]])
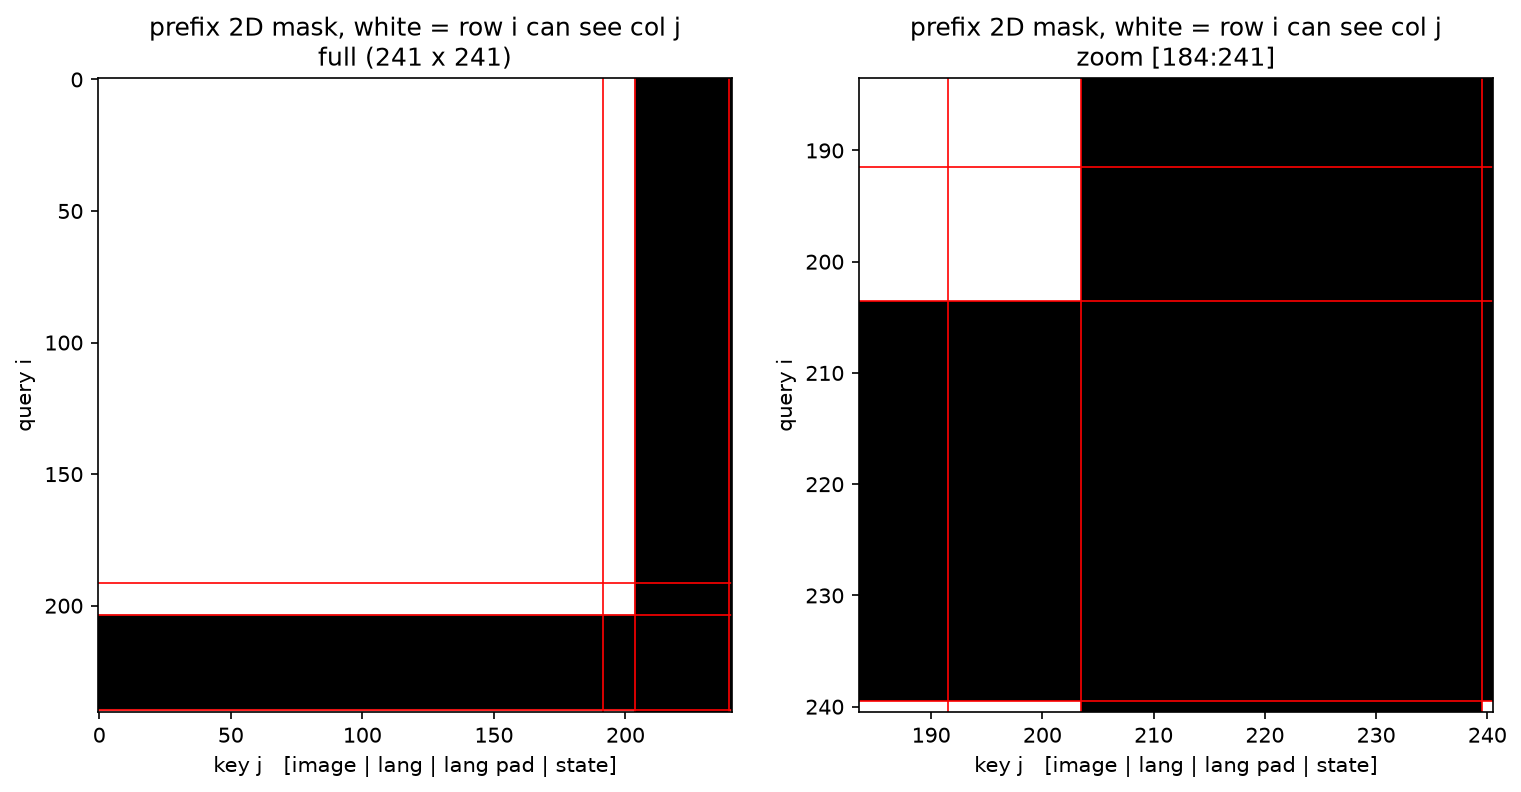
여기서 각 토큰이 몇번째 층에 속해있는지가 적혀있는 것이다. 그리고, 이제 계층구조를 이용하면 우리는 Query × Key 2D attention mask를 형성 할 수 있게 된다. 결국에 재미있는 것은 state 한개의 토큰만 1층이고 나머지는 0층이라서, state만 유일하게 나머지를 전부 다 볼 수 있다. 또한, padding 부분 토큰들은 검정색으로 칠해진 것을 알 수 있다.
(이 바꾸는 연산 작업은 lerobot/policies/common/vla_utils.py 에 메서드가 존재한다.)
여기서 재미있는게 사실은, att_masks의 0/1 자체가 층 번호는 아니다. 1은 “여기서 한 층 올라간다”는 계단 표시이고, cumsum(누적합)을 해야 층 번호가 됨!!!.
att_masks : [0, 0, …, 0, 1] ← “여기서 계단 올라감” 표시
cumsum : [0, 0, …, 0, 1] ← 실제 층 번호
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
def make_att_2d_masks(pad_masks: Tensor, att_masks: Tensor) -> Tensor:  # see openpi (exact copy)
    """Copied from big_vision.

    Tokens can attend to valid inputs tokens which have a cumulative mask_ar
    smaller or equal to theirs. This way `mask_ar` int[B, N] can be used to
    setup several types of attention, for example:

      [[1 1 1 1 1 1]]: pure causal attention.

      [[0 0 0 1 1 1]]: prefix-lm attention. The first 3 tokens can attend between
          themselves and the last 3 tokens have a causal attention. The first
          entry could also be a 1 without changing behaviour.

      [[1 0 1 0 1 0 0 1 0 0]]: causal attention between 4 blocks. Tokens of a
          block can attend all previous blocks and all tokens on the same block.

    Args:
      input_mask: bool[B, N] true if its part of the input, false if padding.
      mask_ar: int32[B, N] mask that's 1 where previous tokens cannot depend on
        it and 0 where it shares the same attention mask as the previous token.
    """
    if att_masks.ndim != 2:
        raise ValueError(att_masks.ndim)
    if pad_masks.ndim != 2:
        raise ValueError(pad_masks.ndim)

    cumsum = torch.cumsum(att_masks, dim=1)
    att_2d_masks = cumsum[:, None, :] <= cumsum[:, :, None]
    pad_2d_masks = pad_masks[:, None, :] * pad_masks[:, :, None]
    return att_2d_masks & pad_2d_masks
Step5 VLM 16 layers
일단 여기서 핵심은 2D Mask 와 position ids 두가지를 먼저 제작하고, 그리고 그것을 이제 vlm_with_expert 내부에 forward로 넣어주는 것이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
# Step5 VLM 16 layers : prefix를 넣고 KV cache 만들기
from lerobot.policies.common.vla_utils import make_att_2d_masks

# 1) 마스크 2D로 변환 (층 규칙 + 패딩)
prefix_att_2d_masks = make_att_2d_masks(prefix_pad_masks, prefix_att_masks)   # (1, 241, 241)

# 2) 위치 번호: 진짜 토큰만 0, 1, 2, ... 로 셈 (패딩은 번호가 안 올라감)
prefix_position_ids = torch.cumsum(prefix_pad_masks, dim=1) - 1               # (1, 241)

# 3) VLM forward
with torch.no_grad():
    outputs, past_key_values = policy.model.vlm_with_expert.forward(
        attention_mask=prefix_att_2d_masks,
        position_ids=prefix_position_ids,
        past_key_values=None,              # 아직 캐시 없음 → 새로 만들어서 채움
        inputs_embeds=[prefix_embs, None], # [VLM 입력, expert 입력]: expert는 쉼
        use_cache=True,                    # 캐시를 만들어서 돌려달라
    )

prefix_out, suffix_out = outputs


# Step6 KV cache 확인
print("\n ===== Step6 KV cache ===== ")
print("type          :", type(past_key_values).__name__)
print("num layers    :", len(past_key_values.layers))
print("layer0 keys   :", past_key_values.layers[0].keys.shape)     # [B, kv_heads, L, head_dim]
print("layer0 values :", past_key_values.layers[0].values.shape)
print("layer15 keys  :", past_key_values.layers[15].keys.shape)
여기서 이제 Prefix → {image, text, state}를 의미하고, suffix → action expert의 output이라고 이해하면 된다. 이제 최종적으로 우리가 원하는 KV Cache를 얻었고, 이는 이제 output 해보면 다음과 같다.
1
2
3
4
5
6
7
8
 # output

 ===== Step6 KV cache =====
type          : DynamicCache
num layers    : 16
layer0 keys   : torch.Size([1, 5, 241, 64]) # [B, kv_heads, L, head_dim]
layer0 values : torch.Size([1, 5, 241, 64])
layer15 keys  : torch.Size([1, 5, 241, 64])
자 여기까지가 1번 과정이었고, 이 KV 연산된 값이 그대로 이제 Expert의 Self and Cross attention 내부로 들어가는 구조이다.
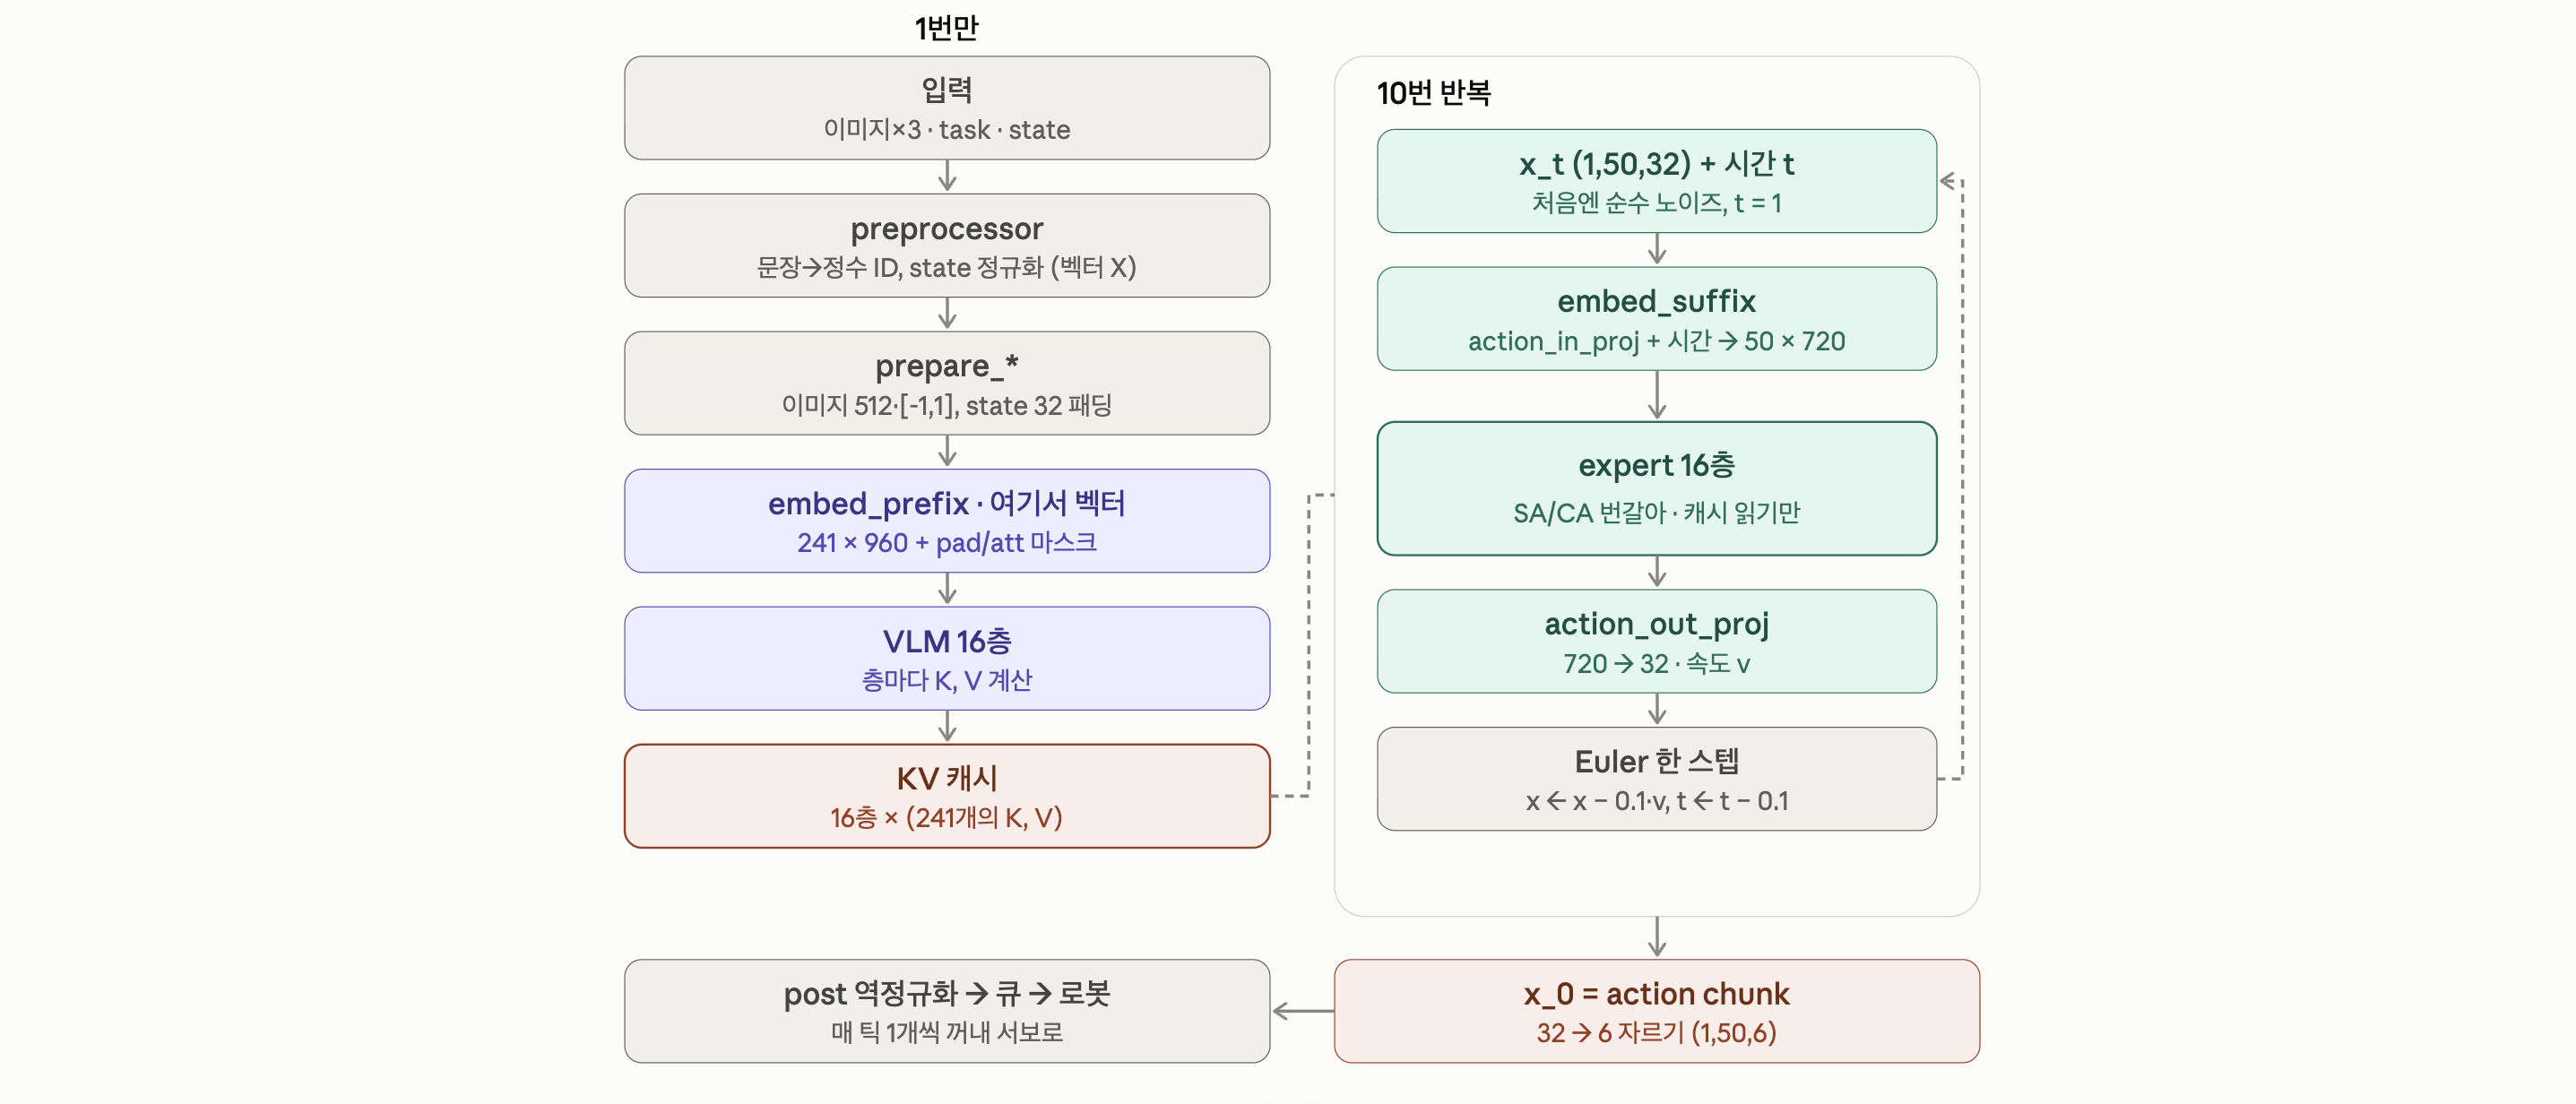
다음시간에는 2번째, 10번 반복하는 Action Expert loop를 파헤쳐 보자…. 여기서 마지막 forward 부분을 세밀하게 파보고 이번 블로그는 여기까지만 정리하자.
Step5* - Forward
전체적인 KV Cache 구조는 다음과 같이 16개 의 layer으로 이루어져 있고 그리고 이제 거기서 나오는 K,V 값을 이제 그다음 Action Expert로 넘겨주는 그런식으로 작업이 진행 되는 것.
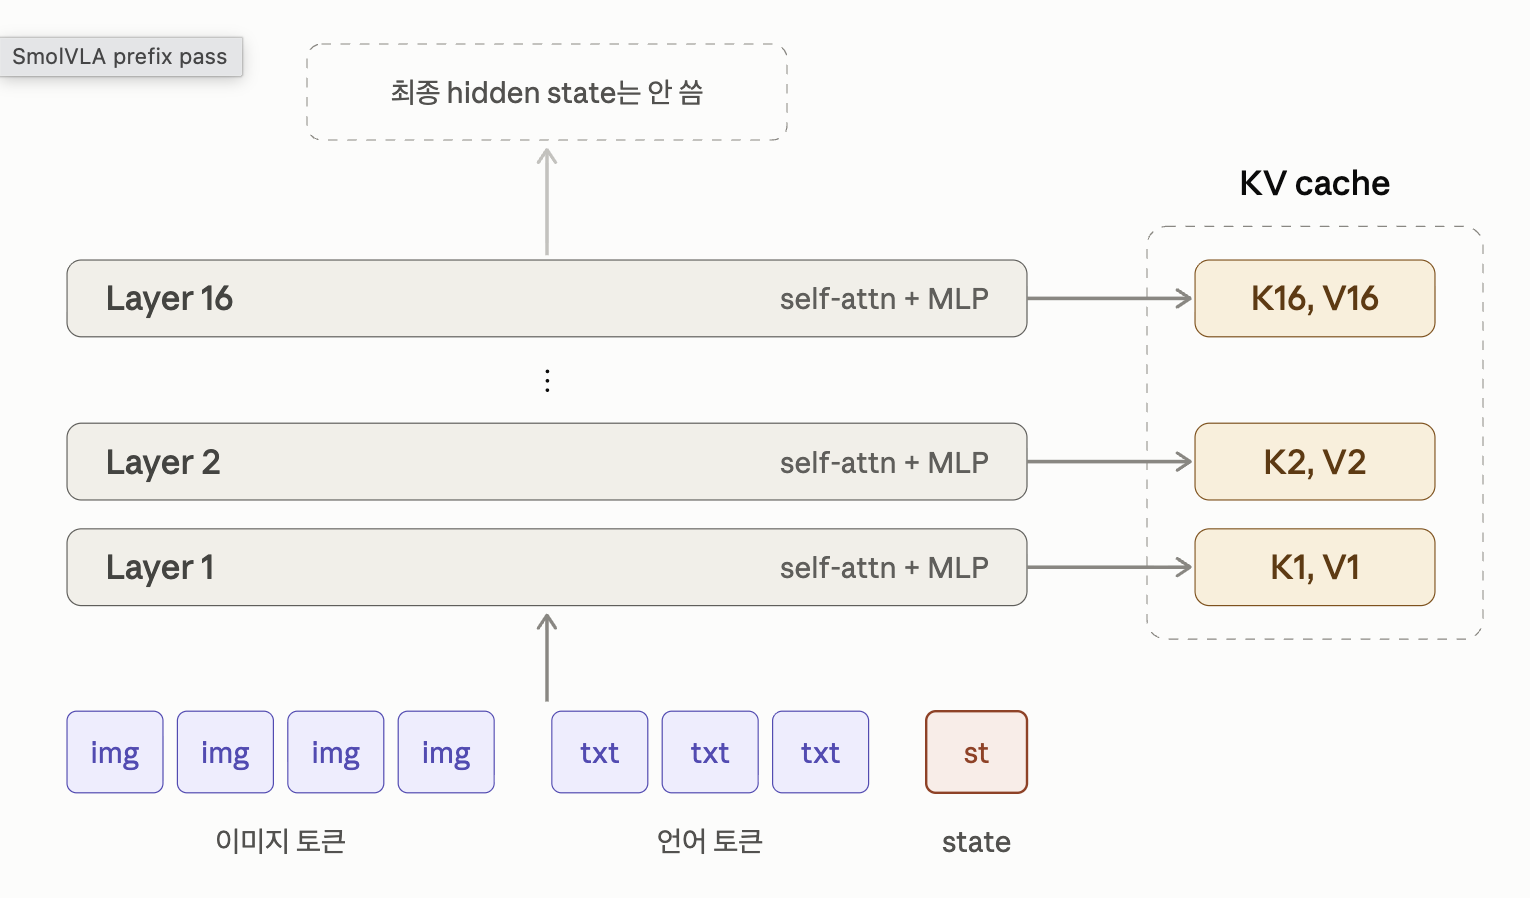
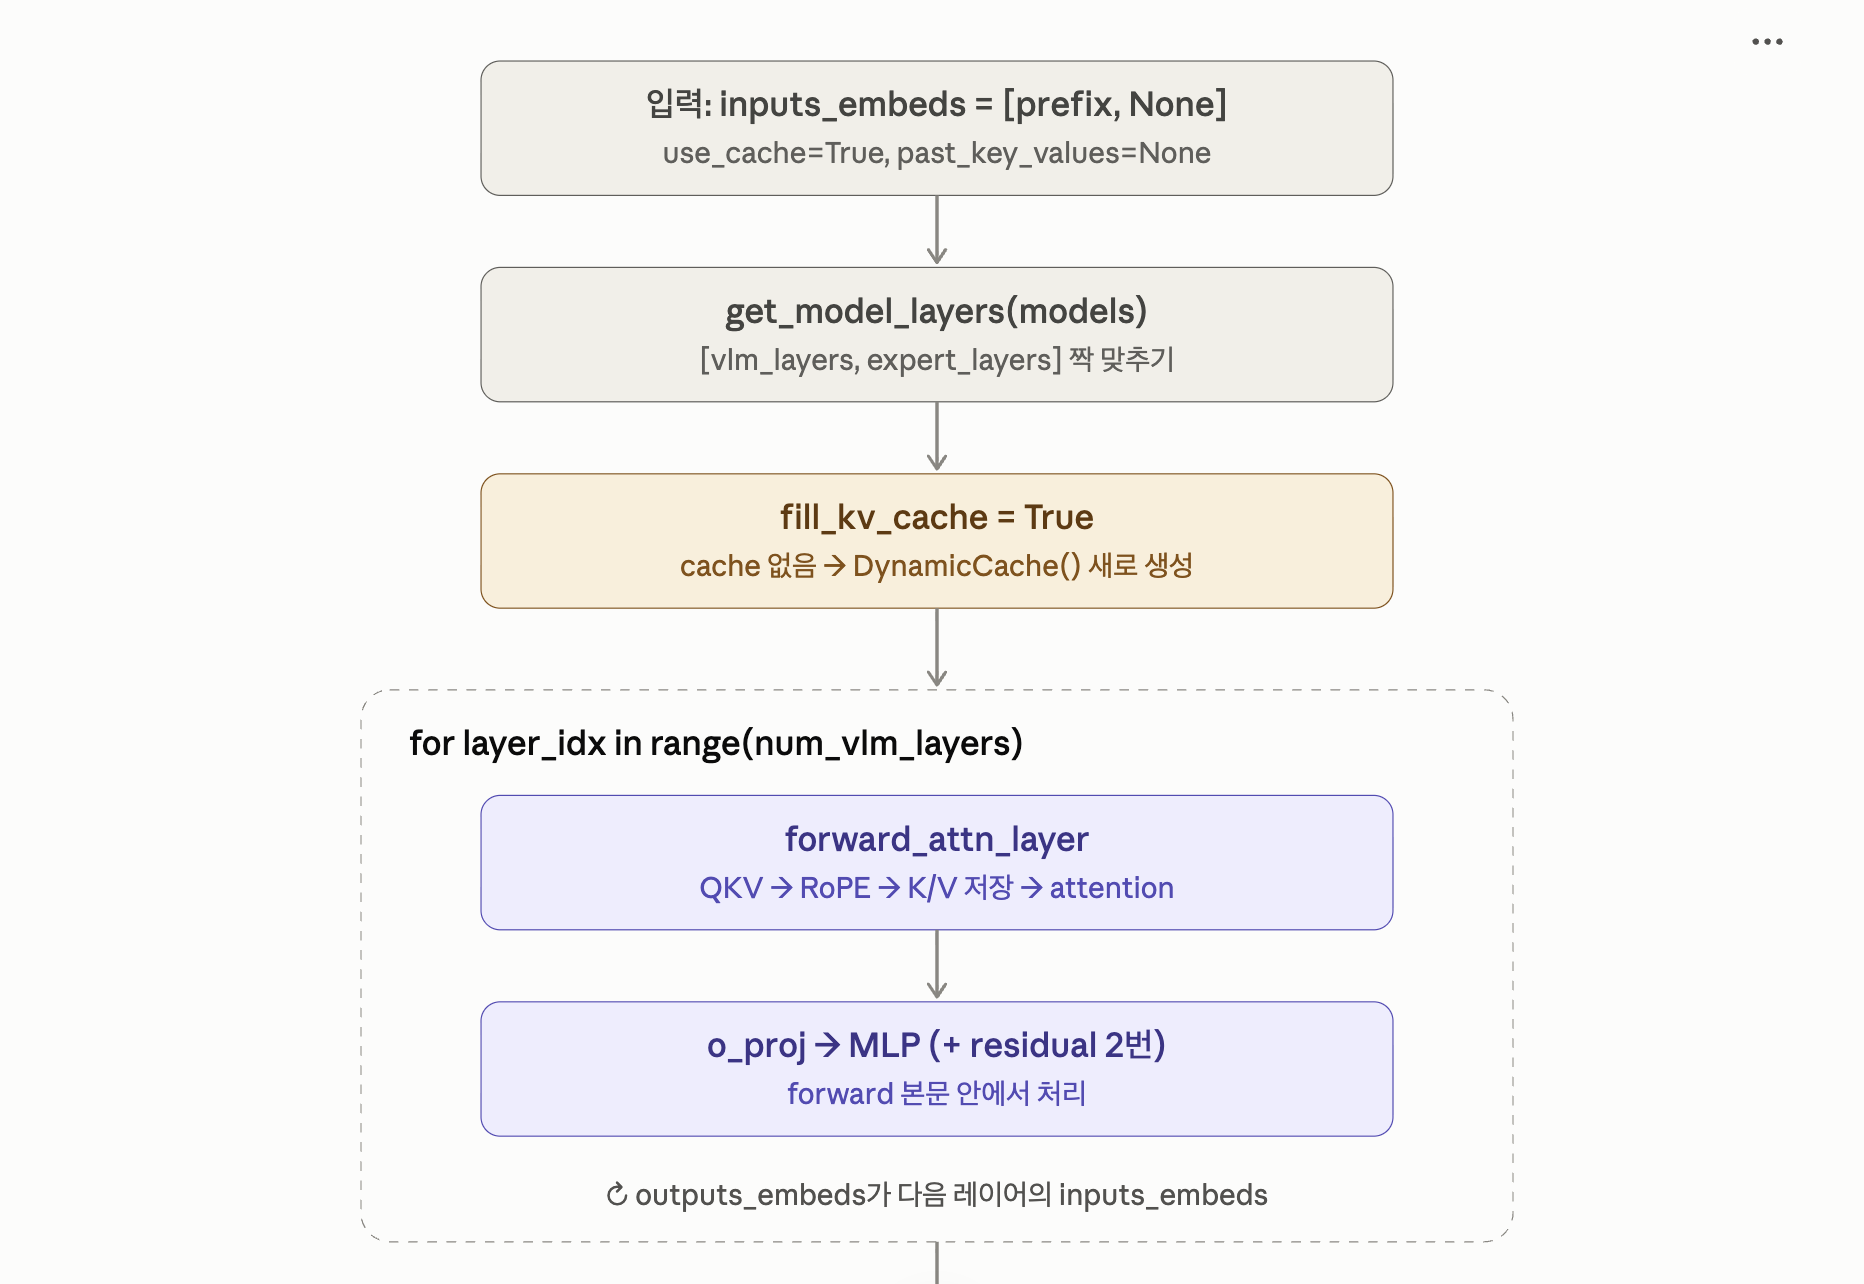
여기서 Forward에 들어가는 input_embeds를 잘 기억해야하는게 prefix, none 으로 들어간다. (Expert output 이 없기 때문에 None이다). 그리고 이제 16개의 layer의 반복문에 들어간다. 여기서 우리가 아는 Attention layer은 forward_attn_layer에서 진행이 된다.
Forward_attn_layer on each 16 layers
전체적인 흐름은 다음과 같다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# lerobot/policies/smolvla/smolvlm_with_expert.py
def forward():
  ...
     num_layers = self.num_vlm_layers
     head_dim = self.vlm.config.text_config.head_dim
     for layer_idx in range(num_layers):
         if (
             fill_kv_cache
             or "cross" not in self.attention_mode
             or (self.self_attn_every_n_layers > 0 and layer_idx % self.self_attn_every_n_layers == 0)
         ):
             att_outputs, past_key_values = self.forward_attn_layer(
                 model_layers,
                 inputs_embeds,
                 layer_idx,
                 position_ids,
                 attention_mask,
                 batch_size,
                 head_dim,
                 use_cache=use_cache,
                 past_key_values=past_key_values,
             )
각 layer마다 forward_attn_layer 의 메서드를 호출한다. 이 메서드가 이제 input_embeds를 가지고 실제로 attention 연산을 하는 layer이라고 생각하면 된다. 그렇다면 여기서 정확하게 차원을 항상 기억해야한다.
- input_embeds: [ Batch = 1, # of tokens = 241, embedding dimension = 960]
- att_outputs: same as input
- past_key_values: 는 레이어들마다 K, V 값을 저장하고 이는 Head size (5) 와 head dimension (64) 으로 나누어져 있다.
1
2
3
4
5
6
past_key_values (DynamicCache)
 ├─ layers[0]  : keys [1, 5, 241, 64], values [1, 5, 241, 64]
 ├─ layers[1]  : keys [1, 5, 241, 64], values [1, 5, 241, 64]
 │   ...
 └─ layers[15] : keys [1, 5, 241, 64], values [1, 5, 241, 64]
                       B  H   L   D
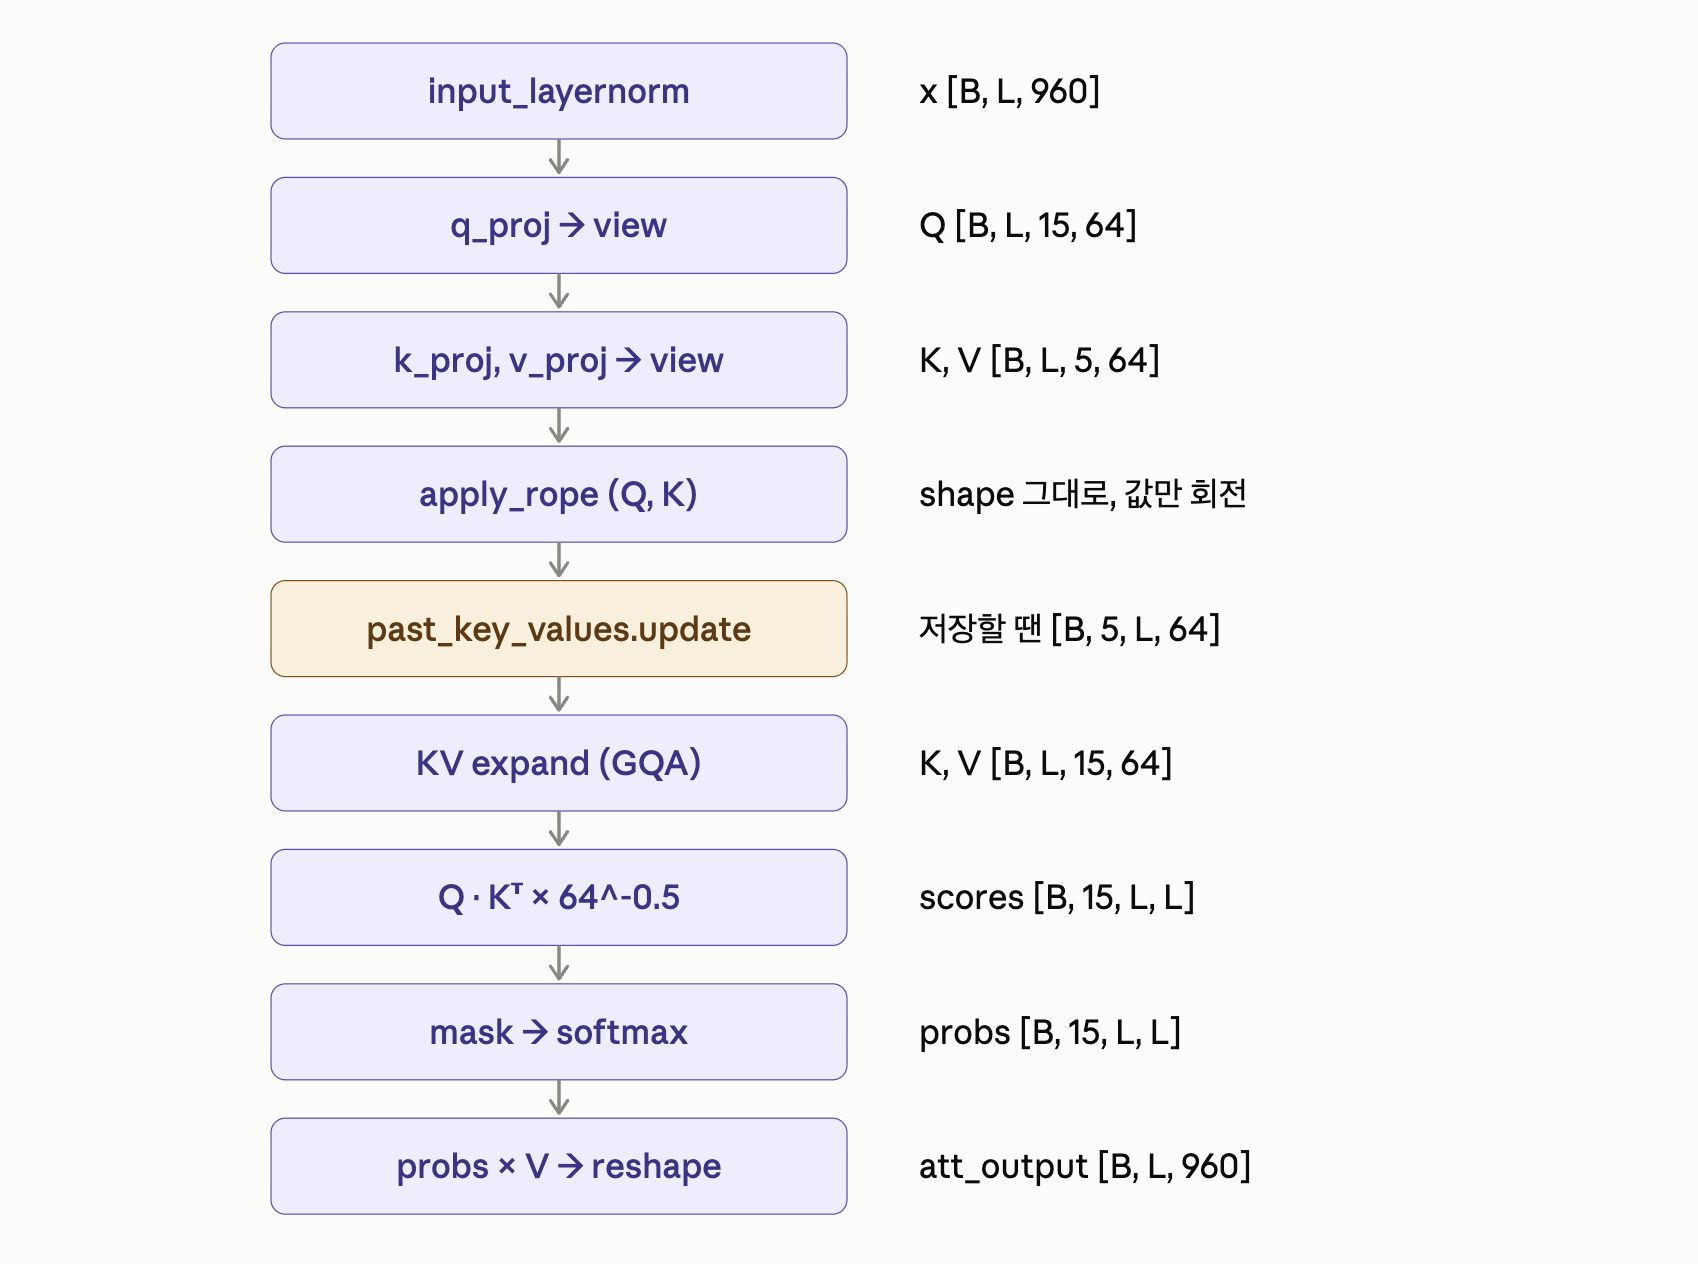
forward_attn_layer 을 이제는 살펴보자.
과정이 굉장히 세부적으로 많지만 정형화 되어있다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
# forward_attn_layer method at the smolvlm_with_expert.py

...

# hidden_states -> input_layernorm에 먼저 넣는다. RMSNorm 을 사용.
hidden_states = layer.input_layernorm(hidden_states)


input_shape = hidden_states.shape[:-1]
hidden_shape = (*input_shape, -1, layer.self_attn.head_dim)

hidden_states = hidden_states.to(dtype=layer.self_attn.q_proj.weight.dtype)

# 이제 Q,K,V 연산을 진행해주고 그리고 list에 저장해서 넣는다.
query_state = layer.self_attn.q_proj(hidden_states).view(hidden_shape)
key_state = layer.self_attn.k_proj(hidden_states).view(hidden_shape)
value_state = layer.self_attn.v_proj(hidden_states).view(hidden_shape)

query_states.append(query_state)
key_states.append(key_state)
value_states.append(value_state)
자 그러니까 여기서 이제 hidden shape이라는거는 여기서 그 Q, K, V head를 여러개로 쪼개는 것에 대해서 우리는 이미 다루었다. 그 각각 head_dim = 64으로 설정하여 여러개의 W_q,k,v 연산을 진행한다. 여기서 이제 self_attn.q_proj , k_proj, v_proj이 부분들은
transformers 파이썬 패키지 → models/llama/modeling_llama.py 의 class init 에 정의되어있다.
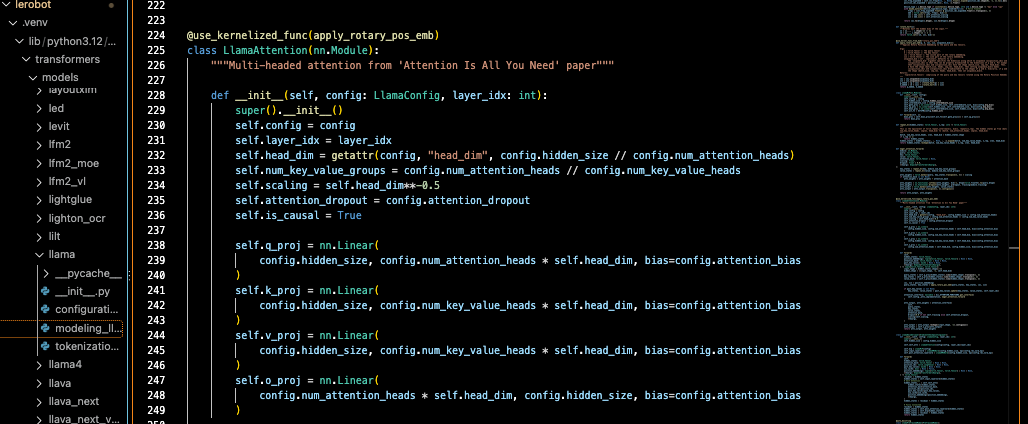
여기서 이제 어느순간 # of head and head_dim으로 디멘션이 바뀌어 있는 상황이다.
q,k,v dimension = (B,L,H,D)
이후 코드를 읽다보면 우리가 배웠던 RoPE도 적용이 되어 있다.
1
2
3
4
5
attention_mask_ = _attention_mask
position_ids_ = _position_ids

query_states = apply_rope(query_states, position_ids_)
key_states = apply_rope(key_states, position_ids_)
논문: RoFormer: Enhanced Transformer with Rotary Position Embedding (arXiv 2104.09864)
그 개념은 간단하다. 토큰의 위치를 회전 각도로 이해하는 것이다. 즉 각 토큰의 Q, K 벡터를 그 토큰의 위치만큼 회전시켜서 위치 정보를 넣는다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
def apply_rope(x, positions, max_wavelength=10_000):
    """
    Applies RoPE positions [B, L] to x [B, L, H, D].
    """
    d_half = x.shape[-1] // 2
    device = x.device
    dtype = x.dtype
    x = x.to(torch.float32)

    freq_exponents = (2.0 / x.shape[-1]) * torch.arange(d_half, dtype=torch.float32, device=device)
    timescale = max_wavelength**freq_exponents
    radians = positions[..., None].to(torch.float32) / timescale[None, None, :].to(torch.float32)

    radians = radians[..., None, :]

    sin = torch.sin(radians)  # .to(dtype=dtype)
    cos = torch.cos(radians)  # .to(dtype=dtype)

    x1, x2 = x.split(d_half, dim=-1)
    res = torch.empty_like(x)
    res[..., :d_half] = x1 * cos - x2 * sin
    res[..., d_half:] = x2 * cos + x1 * sin

    return res.to(dtype)
RoPE 핵심: 내적이 상대 거리(m − n)에만 의존한다
64차원을 32쌍으로 나누고, 쌍마다 2D 평면에서 위치만큼 회전시키는 것이다. (x1 * cos - x2 * sin 부분이 2D 회전 공식)
- 위치 m의 Query → m·θ 만큼 회전
- 위치 n의 Key → n·θ 만큼 회전
내적은 두 벡터 사이 각도로 결정된다 (a · b = |a||b|cos(사이 각도)). 둘 다 회전시키면 각자 몇 도 돌았는지는 사라지고, 얼마나 더 돌았는지 (m − n)·θ 만 남는다.
1
(R_m q) · (R_n k) = qᵀ R_mᵀ R_n k = qᵀ R_(n−m) k   # m, n이 따로 남지 않고 n−m 하나로 합쳐짐
| Query 위치 m | Key 위치 n | Q 회전 | K 회전 | 각도 차이 | |
|---|---|---|---|---|---|
| 문장 앞쪽 | 3 | 2 | 30° | 20° | 10° |
| 문장 뒤쪽 | 103 | 102 | 1030° | 1020° | 10° |
절대 위치는 달라도 “바로 옆 토큰”이라는 관계가 같으면 어텐션 점수도 같다. 즉 모델이 “1칸 앞 토큰과의 관계”를 한 번 배우면 문장 어디서든 똑같이 쓸 수 있다.
- Q, K에만 적용하고 V에는 적용하지 않는다 (위치는 “누구를 볼지” = QKᵀ 에만 필요)
- 위치 번호로
position_ids = cumsum(pad_masks) - 1을 사용한다- shape는 그대로
[B, L, H, D], 값만 회전한다- 회전된 K가 그대로 KV Cache에 저장된다
이제 여기서 최종적으로 attention output 즉 토큰 값을 내뱉는게 attention output 이다. 이 부분은
smolvlm_with_expert.py → eager_attention_forward() 메서드에 적혀있다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57

def eager_attention_forward(
    self, attention_mask, batch_size, head_dim, query_states, key_states, value_states
):
    num_att_heads = self.num_attention_heads
    num_key_value_heads = self.num_key_value_heads
    num_key_value_groups = num_att_heads // num_key_value_heads

    sequence_length = key_states.shape[1]

    # Q - [B, L, 15, 64]
    # K - [B, L, 5,  64]
    # V - [B, L, 5,  64]


    # Q랑 연산을 위해서 K, V 를 다시 5 -> 15
    key_states = key_states[:, :, :, None, :].expand(
        batch_size, sequence_length, num_key_value_heads, num_key_value_groups, head_dim
    )
    key_states = key_states.reshape(
        batch_size, sequence_length, num_key_value_heads * num_key_value_groups, head_dim
    )

    value_states = value_states[:, :, :, None, :].expand(
        batch_size, sequence_length, num_key_value_heads, num_key_value_groups, head_dim
    )
    value_states = value_states.reshape(
        batch_size, sequence_length, num_key_value_heads * num_key_value_groups, head_dim
    )

    # Attention here is upcasted to float32 to match the original eager implementation.
    query_states = query_states.to(dtype=torch.float32)
    key_states = key_states.to(dtype=torch.float32)

    query_states = query_states.transpose(1, 2)  # (B, L, 15, 64) -> (B, 15, L, 64)
    key_states = key_states.transpose(1, 2)      # (B, L, 15, 64) -> (B, 15, L, 64)

    att_weights = torch.matmul(query_states, key_states.transpose(2, 3)) # (B, 15, L, L)
    att_weights *= head_dim**-0.5

    # 여기서 마스킹 실시.
    att_weights = att_weights.to(dtype=torch.float32)
    big_neg = torch.finfo(att_weights.dtype).min  # -2.3819763e38  # See gemma/modules.py
    masked_att_weights = torch.where(attention_mask[:, None, :, :], att_weights, big_neg)
    probs = nn.functional.softmax(masked_att_weights, dim=-1)
    probs = probs.to(dtype=value_states.dtype)

    att_output = torch.matmul(probs, value_states.permute(0, 2, 1, 3))
    # (B, 15, L, L) x (B, 15, L, 64) -> (B, 15, L, 64)

    att_output = att_output.permute(0, 2, 1, 3)  # (B, L, 15, 64)

    # we use -1 because sequence length can change -> [B, L, 960]
    att_output = att_output.reshape(batch_size, -1, num_key_value_heads * num_key_value_groups * head_dim)

    return att_output
Summary
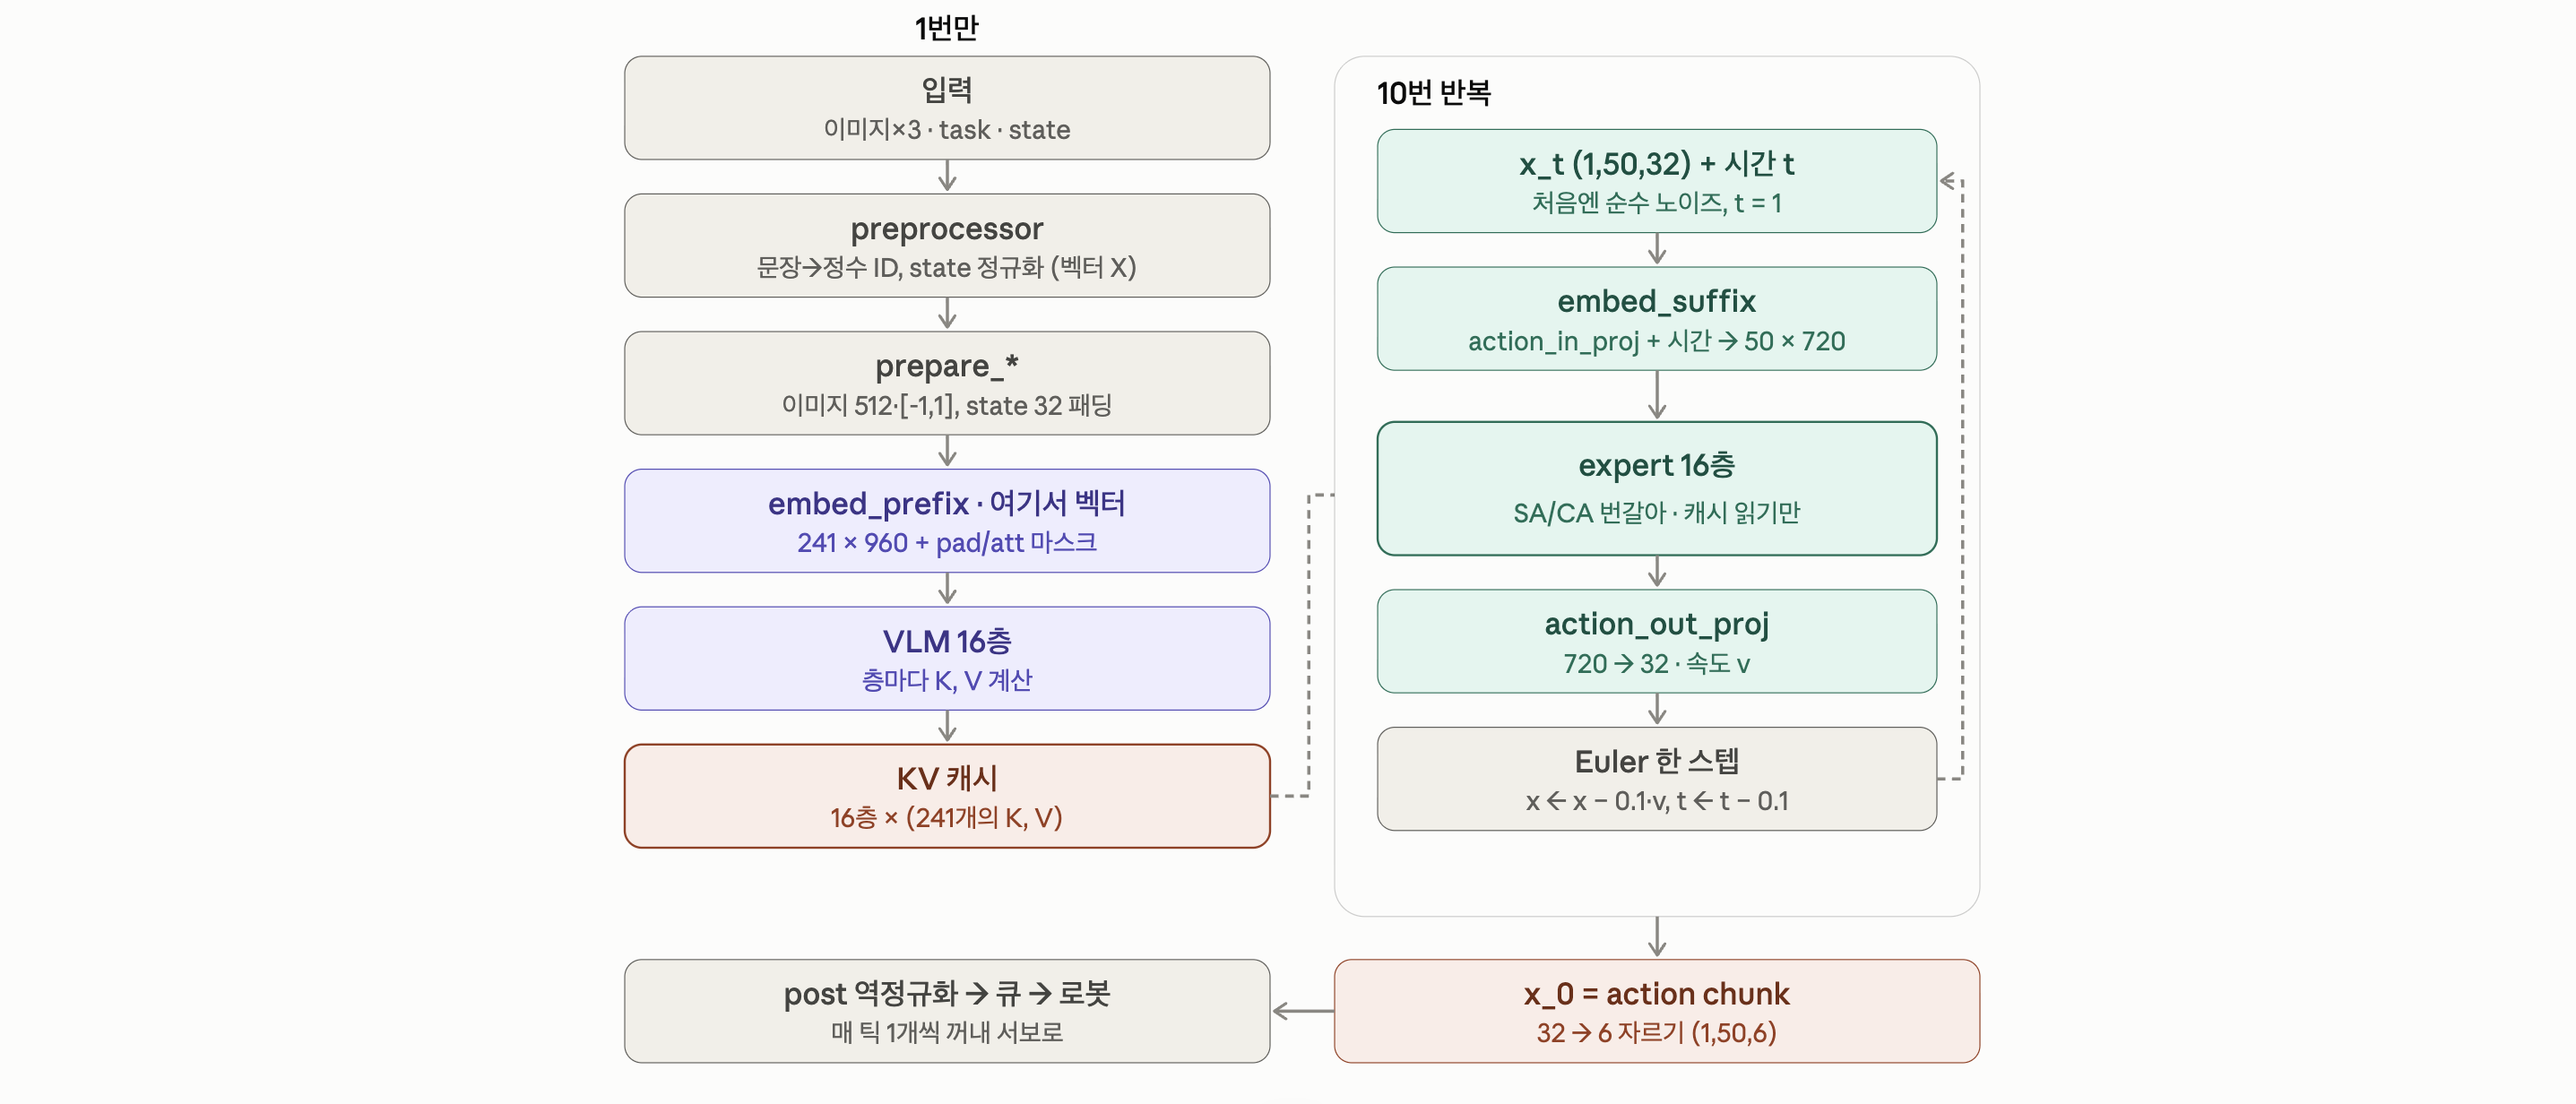
정리를 해보면 결국에는 이번시간에는 5개의 과정에 대해서 알아보았다. 물론 VLM 즉 앞부분에 관한 이야기만 진행했는데도 굉장히 길었다. 다음 시간에 Action Expert이제 정말 메인을 들어가보자.
- 입력된 데이터를 선가공
- 이후에 모델에 맞게 후가공
- Embedding vector로 전환
- Attention 연산 진행
- KV Cache (past) 로 저장.
배운것들
- Attention Masking
- RoPE
- GQA (Grouped Query Attention)
- KV Cache
- Layer skipping (VLM 16 layers): VLM을 끝까지 다 쓰는 게 아니라 앞쪽 16개 layer까지만 쓴다. SmolVLA 논문에서 중간 layer feature로도 충분하다고 해서 속도를 크게 아낀 부분.
- Padding + position_ids: 길이가 다른 입력을 패딩으로 맞추고 pad_masks로 표시한다. 위치 번호는
cumsum(pad_masks) - 1로 진짜 토큰만 셈다. - State zero-padding (6 → 32): 로봇마다 관절 수가 다르니까 최대 32차원으로 고정하고 남는 칸은 0으로 채운다. → 하나의 모델로 여러 로봇을 다룰 수 있게.
- 이미지 정규화 [0,1] → [-1,1] + 512 resize(padding): 비전 인코더(SigLIP)가 기대하는 범위와 크기에 맞춘다.
- RMSNorm (Pre-Norm): attention 들어가기 전에 input_layernorm(RMSNorm)부터 거친다. LayerNorm에서 평균 빼는 걸 생략한 가벼운 버전.