
Study VLA - Flow matching 2
Flow matching에 조건 c를 넣어 원하는 곳으로 보내고, 점 하나가 아니라 궤적 16칸(Action Chunk)을 한 번에 뽑아본다. 왜 chunk로 뽑아야 하는지, 왜 회귀가 아니라 flow matching인지를 장애물 회피 toy 실험으로 직접 확인한다.
Introduction
이전 블로그 Flow matching1에서는 노이즈를 “반달 위 아무 데나”로 보냈다.
이번엔 “위쪽 달로 가”처럼 원하는 곳을 지정할 수 있게 만들어본다. 이게 조건부 생성이다.
VLA에서 “컵을 집어” / “서랍을 열어” 지시에 따라 다른 액션이 나오는 거랑 같은 구조다. 지금은 조건 c가 숫자 0, 1이지만 VLA에선 c = 이미지 + 지시문이다.
그러니까, 우리가 가진 정보(이미지와 프롬프트)를 주면서 이제 prior (조건이 되는 것)
→ 이거에 맞춰서 트레젝토리를 형성해야하므로,
1
2
3
이전 블로그:  (x_t, t)       → v
오늘 블로그:  (x_t, t, c)    → v     ← c 하나 추가된 게 전부다
c = {image, prompt}
Step1 - 데이터: 정답 + 라벨
1
2
3
c = torch.randint(0, 2, (n,))                         # 각 점이 어느 반달인지
x = torch.where(c[:, None] == 0, upper, lower)        # c=0이면 위쪽, c=1이면 아래쪽
return x, c
- 1단계랑 같은 반달인데 정답 x1이랑 그 정답의 라벨 c를 같이 돌려준다.
- 로봇으로 치면 시연 데이터에 “이건 컵 집는 시연” 같은 지시문이 같이 붙어 있는 거다.
Step2 - 모델: c를 입력에 추가
1
2
3
4
5
self.c_embed = nn.Embedding(2, 32)      # 라벨 번호 → 학습되는 벡터 32개

def forward(self, x, t, c):
    return self.net(torch.cat([x, self.t_embed(t), self.c_embed(c)], dim=-1))
    #                          2  +     32        +      32       = 66 입력
nn.Embedding(2, 32)= 라벨마다 벡터 32개짜리 표 한 줄씩. 0번 줄, 1번 줄. 이 숫자들도 학습된다
Step3 - 학습: loss는 그대로
1
2
3
4
5
6
x1, c = sample_data(1024)
x0 = torch.randn_like(x1)
t = torch.rand(1024, 1)
x_t = (1 - t) * x0 + t * x1
target = x1 - x0
loss = ((model(x_t, t, c) - target) ** 2).mean()    # ← c만 같이 넣음
- loss 식은 한 글자도 안 바뀐다. 모델한테 “이 정답은 c번 반달 거야”라는 힌트를 같이 줄 뿐이다.
loss가 1.88 → 1.35로 내려갔다
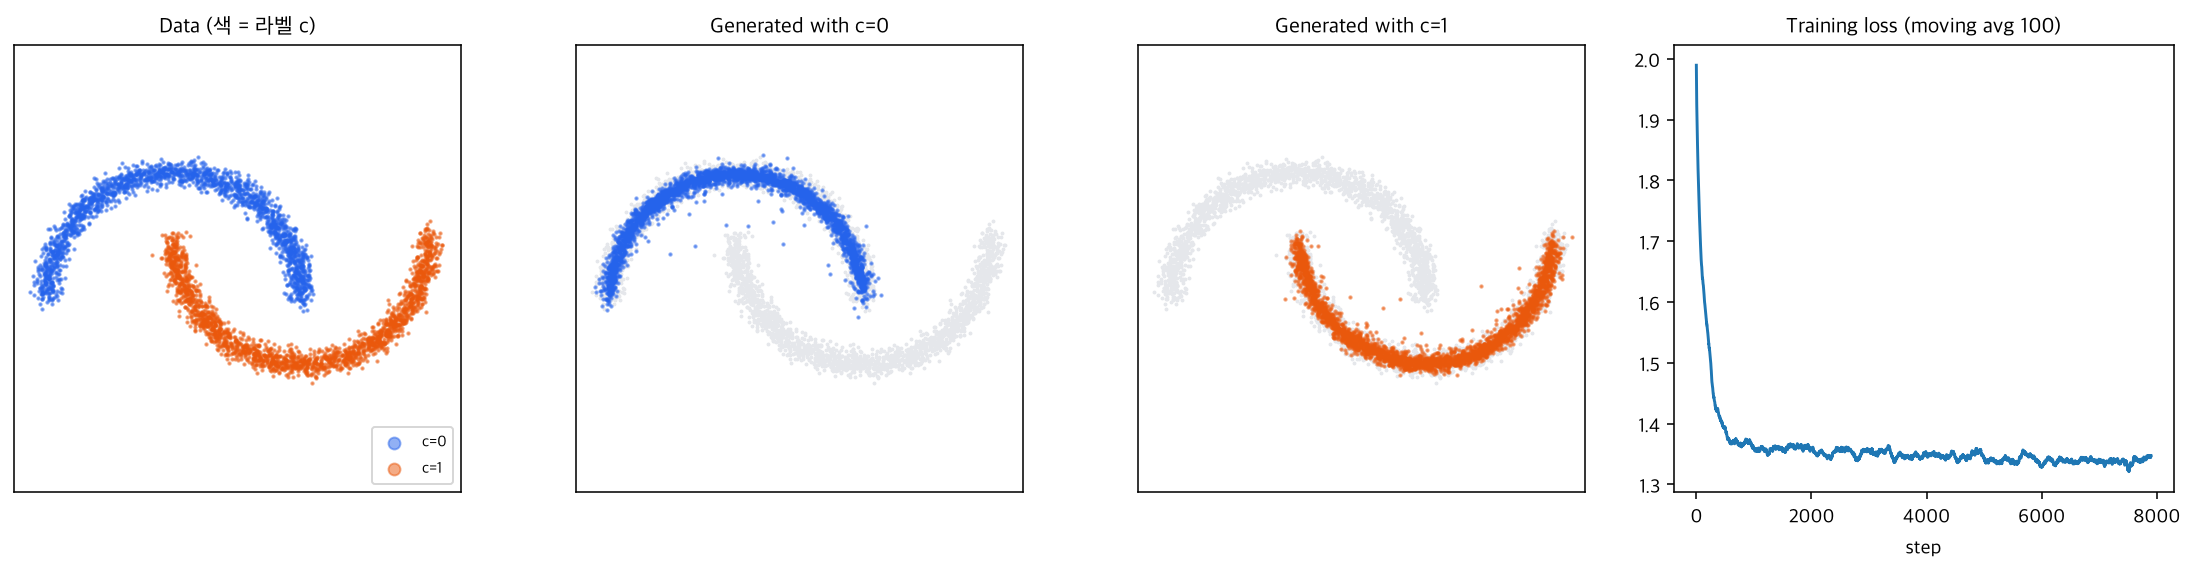
왜 내려갔냐
- 모델이 낼 수 있는 최선의 답 = 자기가 보는 정보로 가능한 정답 속도들의 평균이다.
- loss 바닥 = 그 정답 속도들이 평균에서 얼마나 흩어져 있냐(분산)다. 모델이 아무리 좋아도 이건 못 줄인다.
- c를 주면 후보가 반달 두 개 → 반달 하나로 줄어서 흩어진 정도가 작아진다. 정보를 더 주면 분산은 줄면 줄었지 절대 안 늘어난다.
t 구간별로 loss를 재보면 (차원 평균)
| t | 1단계 | 2단계 | 차이 |
|---|---|---|---|
| 0.0 ~ 0.1 | 2.21 | 1.32 | 0.88 |
| 0.2 ~ 0.3 | 2.71 | 1.78 | 0.94 |
| 0.5 ~ 0.6 | 1.97 | 1.39 | 0.58 |
| 0.7 ~ 0.8 | 1.07 | 0.90 | 0.17 |
| 0.9 ~ 1.0 | 0.98 | 0.98 | 0.00 |
- t ≈ 0 (차이 큼): x_t가 거의 노이즈라 어느 반달로 갈지 모른다. c가 그걸 알려주니까 크게 도움된다.
- t ≈ 1 (차이 0): x_t가 이미 거의 정답 위라 위치만 봐도 어느 반달인지 안다. c는 쓸모가 없다.
- t ≈ 1에서도 loss가 약 1 남는 이유: 정답 속도 = x1 − x0 인데 x1은 알지만 어떤 노이즈 x0에서 출발했는지 모른다. 노이즈 분산이 1이라서 딱 1이 남는다.
loss 바닥 = “모델이 보는 정보로는 구분 못 하는 정답들의 흩어짐”. 조건을 넣으면 구분할 수 있는 게 늘어나서 바닥이 내려간다. 특히 어디로 갈지 제일 모호한 t ≈ 0 근처에서 효과가 크다.
Step4 - 추론: 원하는 c를 넣는다
1
2
3
for i in range(10):
    t = torch.full((n, 1), i * 0.1)
    x = x + 0.1 * model(x, t, c)     # c를 내가 정해서 넣는다
- 위 그림 가운데 두 개가 결과다. c = 0 넣으면 위쪽 반달에만, c = 1 넣으면 아래쪽 반달에만 생긴다.
같은 노이즈, 다른 조건
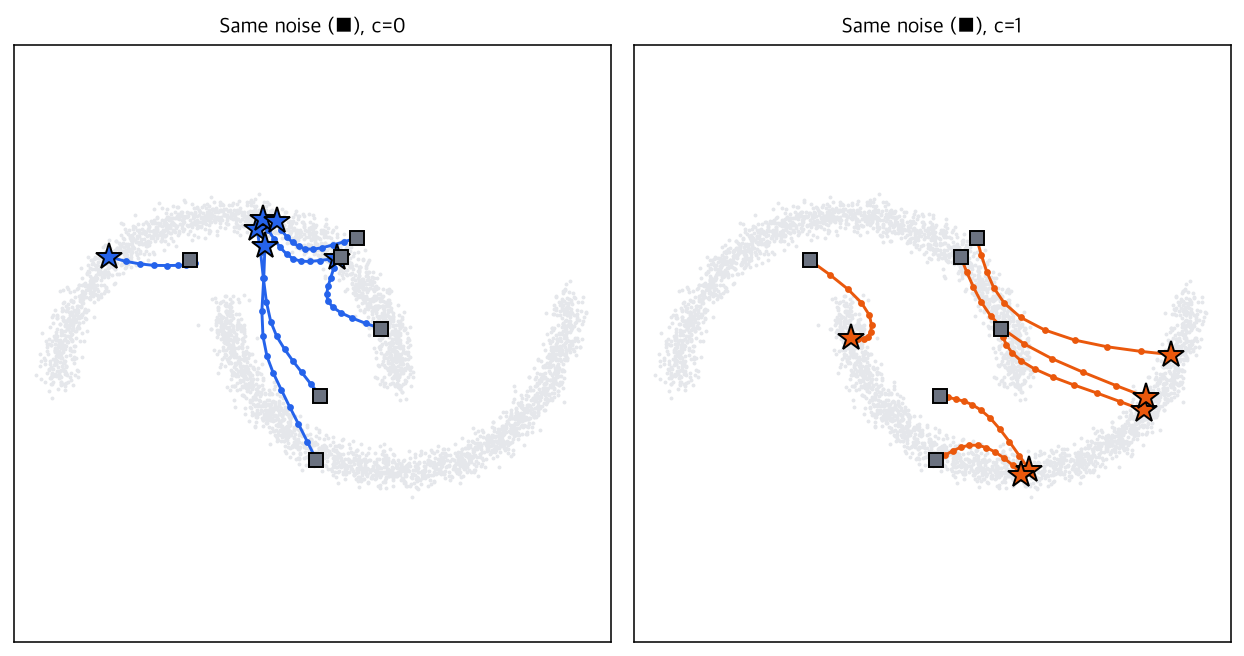
- 회색 ■이 똑같은 노이즈 6개다. c만 바꿨는데 도착지가 완전히 달라진다.
- 로봇으로 치면 같은 노이즈에서 출발해도 지시문이 “컵 집어”면 컵 집는 액션, “서랍 열어”면 서랍 여는 액션이 나오는 거다.
조건이 화살표 지도 자체를 바꾼다
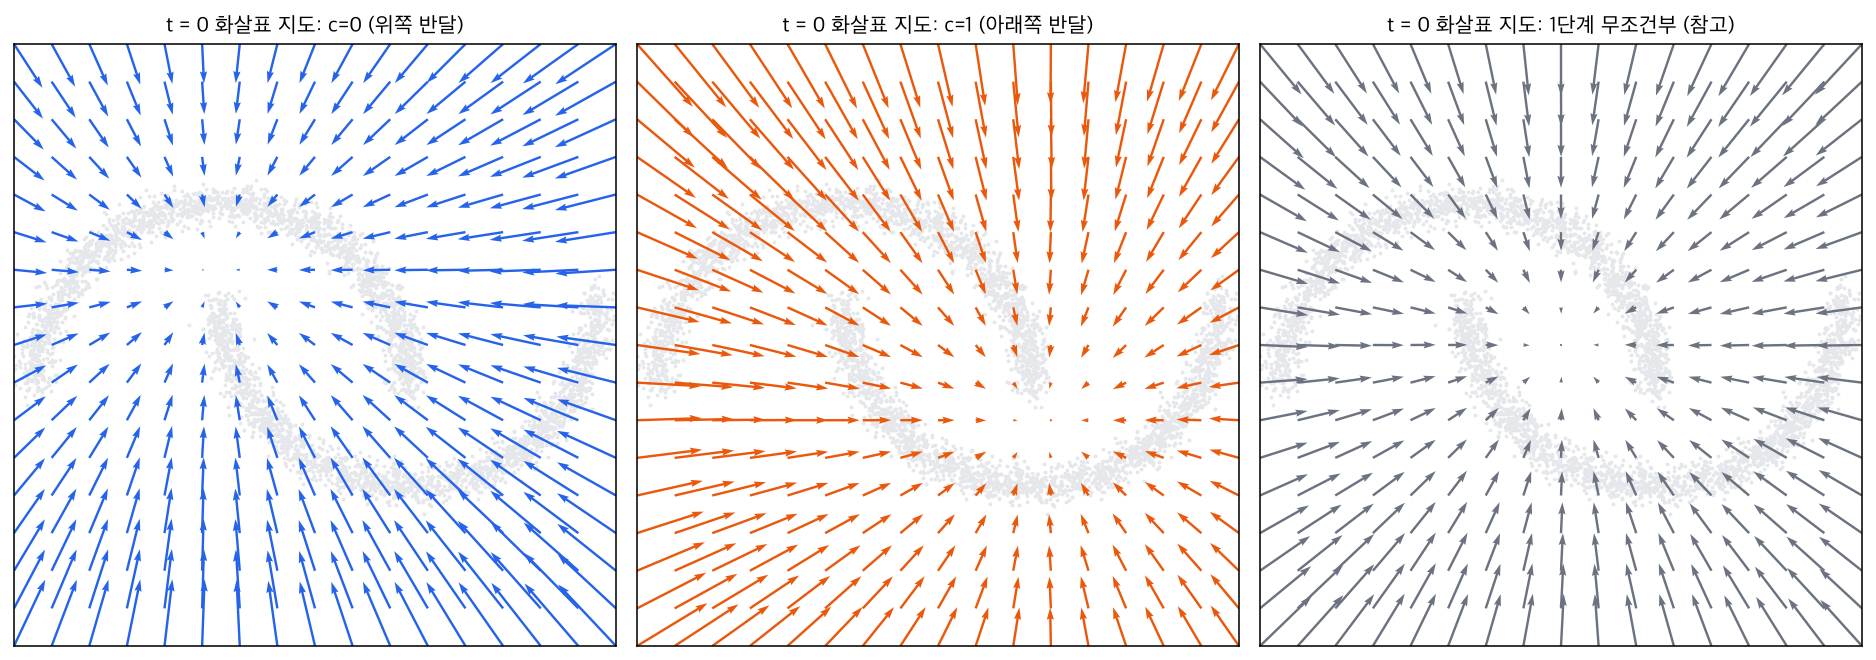
t = 0 화살표 지도. 1단계(오른쪽)는 전부 전체 데이터의 가운데를 향했다. 2단계에선 c = 0이면 위쪽 반달의 가운데, c = 1이면 아래쪽 반달의 가운데를 향한다.
- t = 0에서 평균 방향으로 가는 건 똑같다. 다만 c 덕분에 “어떤 정답들의 평균”인지가 좁혀진 거다.
조건 c = 정답 후보를 좁혀주는 힌트. 화살표 지도가 c마다 따로 생긴다.
근데 조건을 줘도 정답은 여전히 여러 개(반달 전체)다. VLA도 마찬가지로 이미지 + 지시문이 있어도 “컵을 집는 방법”은 여러 가지다. 그래서 조건이 있어도 회귀가 아니라 flow matching이 필요하다.
지금까지는 액션이 점 하나 (x, y)였다. 이번엔 드디어 시간에 따른 액션 여러 개 = Action Chunk를 한 번에 뽑는 것으로 최종적으로 살펴보자. (이게 실제로 로봇 액션 모델이 내뱉는 아웃풋이다)
Step5 - 데이터: 장애물 회피 궤적
1
2
3
4
5
side = torch.randint(0, 2, (n, 1)) * 2 - 1        # -1 왼쪽, +1 오른쪽 (50:50)
amp = 0.5 + 0.3 * torch.rand(n, 1)                # 얼마나 크게 돌아가는지
y = torch.linspace(-1, 1, 16)                     # 아래 → 위로 전진
x = side * amp * torch.sin(math.pi * (y + 1) / 2) # 가운데에서 가장 크게 벗어남
traj = torch.stack([x, y], dim=-1)                # (n, 16, 2)
- 시작 (0, -1) → 목표 (0, 1). 가운데 장애물을 왼쪽 또는 오른쪽으로 돌아가는 시연이 반반 섞여 있다.
- Flow matching1 맨 앞에 나온 회귀 vs 생성 모델 그림이랑 같은 상황이다.
Step6 - 모델: 궤적 전체를 한 번에 본다 (16개의 노이즈)
1
2
3
def forward(self, x, t):                                   # x: (B, 16, 2)
    h = torch.cat([x.reshape(B, 32), self.t_embed(t)], -1) # 16칸 × 2 = 32개로 펼침
    return self.net(h).reshape(B, 16, 2)                   # 출력도 16칸 전부의 속도
- MLP라서 궤적을 숫자 32개로 쭉 펼쳐서 넣는다. 출력도 32개 → 다시 (16, 2)로.
- 중요한 건 모델이 16칸을 동시에 본다는 것. 그래서 3번째 칸 속도를 정할 때 10번째 칸이 어디 있는지도 고려할 수 있다.
“16칸을 동시에 본다”는 게 무슨 뜻이냐
- 첫 Linear 레이어(32 → 512)에서 hidden 하나하나가 입력 32개 전부랑 연결돼 있다. 그래서 출력 32개(16칸의 속도) 하나하나가 입력 16칸 전부의 영향을 받는다.
- per-step 모델은 입력이 자기 칸 2개 숫자뿐이라 다른 칸을 아예 못 본다.
실험: 16칸을 전부 장애물 정중앙 직선(x = 0)에 두고 8번 칸 하나만 왼쪽/오른쪽으로 살짝 옮겨봤다 (τ = 0.5). 값은 각 칸이 x 방향으로 가려는 속도 (+ 오른쪽, − 왼쪽).
| 8번 칸 위치 | 칸4 | 칸12 | 칸1, 칸16 (시작/끝) |
|---|---|---|---|
| 왼쪽 (−0.2) | −0.15 | −0.16 | 0.01 |
| 가운데 (0) | +0.04 | +0.08 | 0.01 |
| 오른쪽 (+0.2) | +0.22 | +0.31 | 0.01 |
- 칸 8 하나만 옮겼는데 멀리 떨어진 칸4, 칸12가 같은 쪽으로 따라간다. “중간이 왼쪽으로 기울었으니 이 궤적은 왼쪽 회피구나” 하고 전체가 맞춰진다.
- 시작/끝 칸은 항상 같은 자리라 속도가 거의 0이다.
- 디노이징 중에 어느 칸이든 살짝 한쪽으로 기울면 나머지가 따라가서 궤적 전체가 한 쪽으로 정해진다. 이게 지그재그가 안 생기는 이유다.
Step7 - 학습: loss 그대로
1
2
3
4
5
x0 = torch.randn_like(x1)        # (B, 16, 2) 노이즈 — 칸마다 랜덤
t = torch.rand(B, 1)             # 궤적 하나당 t 하나 (16칸 전부 같은 t)
x_t = (1 - t) * x0 + t * x1
target = x1 - x0
loss = ((model(x_t, t) - target) ** 2).mean()
- 노이즈는 칸마다 다르게 랜덤이다. 칸 위치(T)는 고정, 값만 랜덤.
- 시간 t(τ)는 궤적 하나당 하나다. 16칸이 항상 같은 τ에서 같이 움직인다.
Step8 - 추론: 16칸이 한꺼번에 이동
1
2
3
x = torch.randn(n, 16, 2)                     # 16칸 전부 노이즈에서 출발
for i in range(10):
    x = x + 0.1 * model(x, i * 0.1)           # 16칸이 한꺼번에 이동
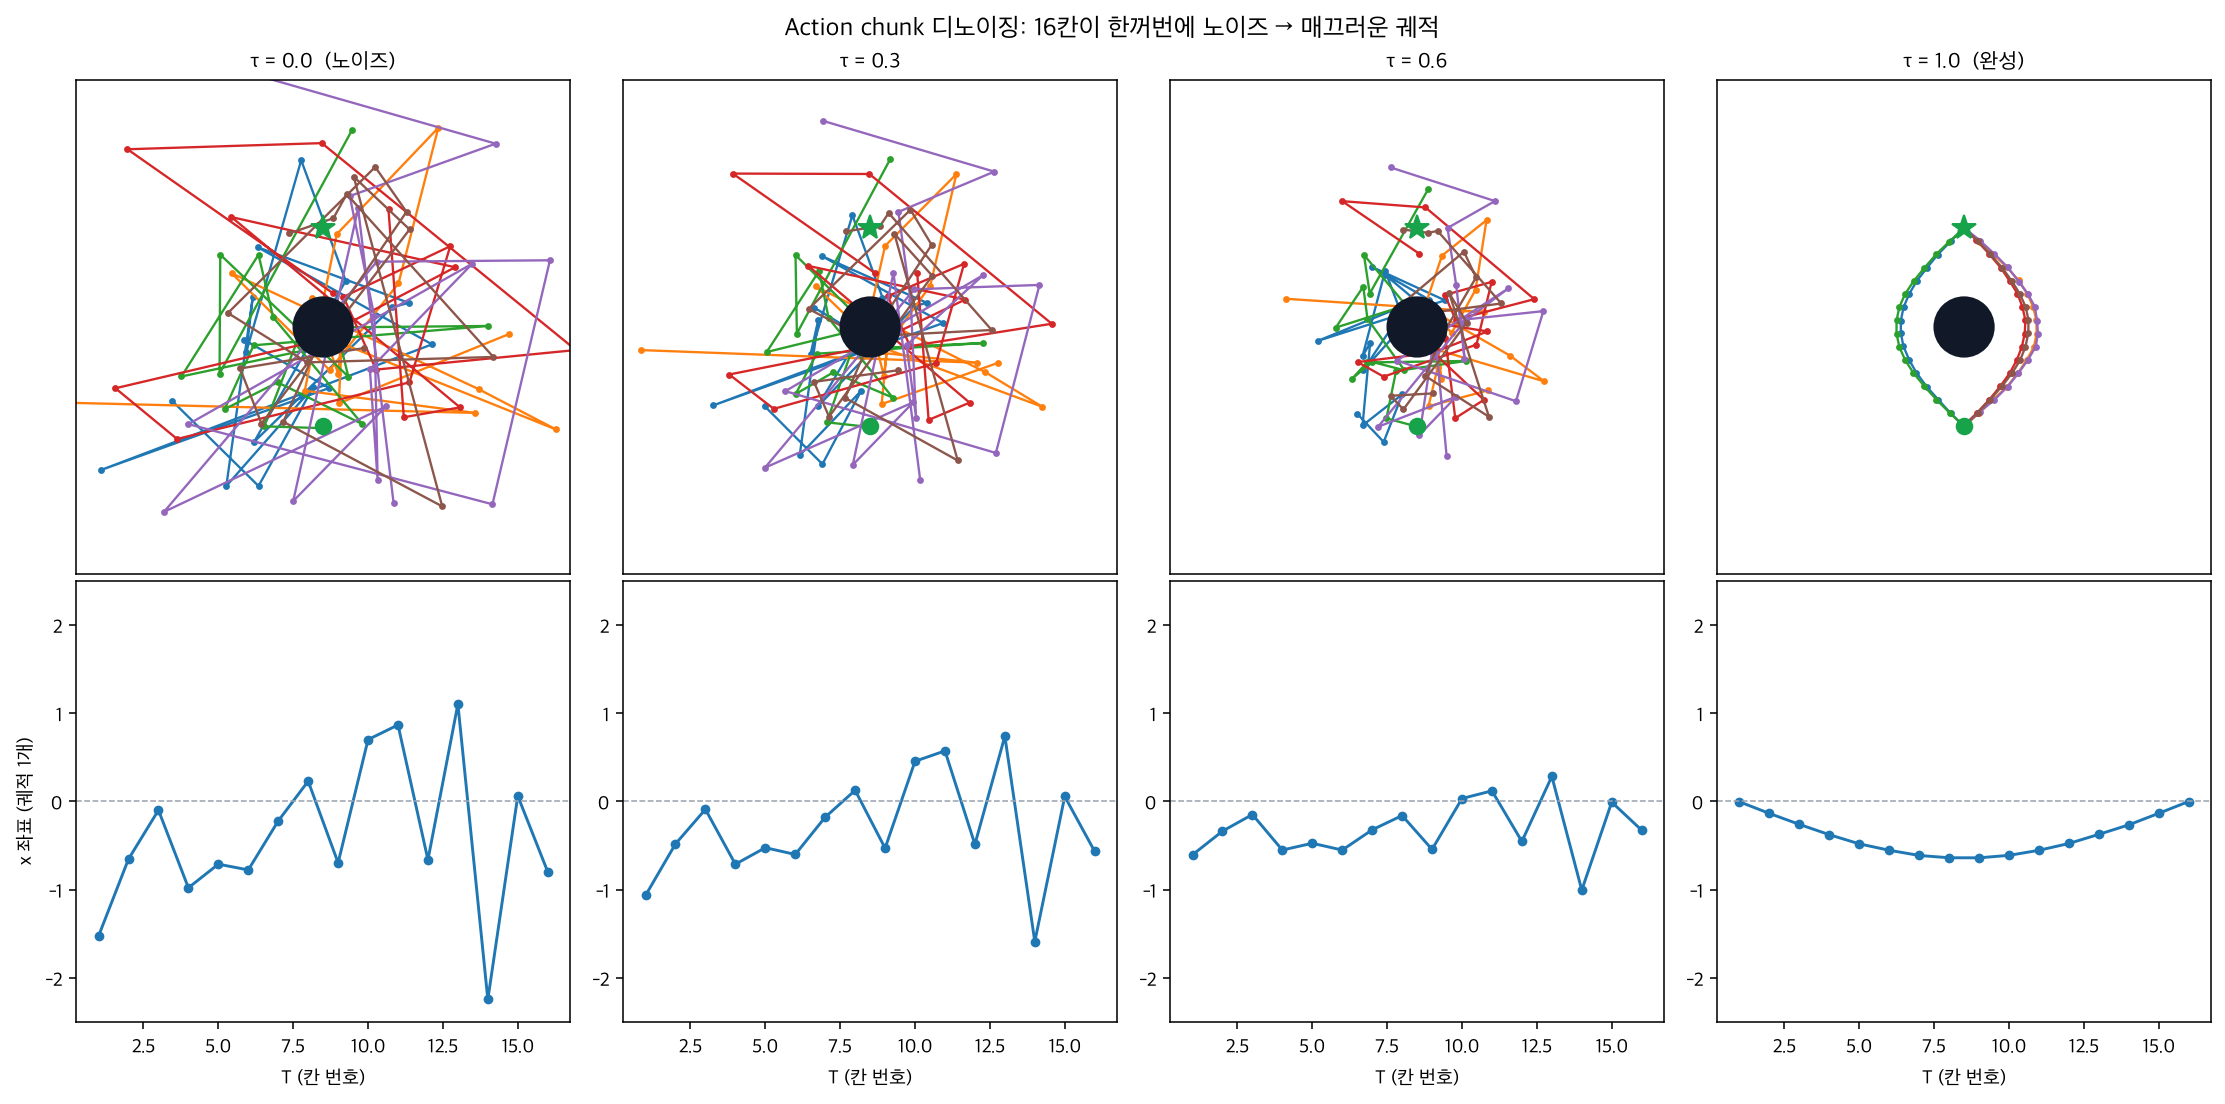
위: 궤적 6개가 τ = 0 (노이즈) → 1.0 (완성)으로 정리되는 과정. 아래: 그중 하나를 가로축 T(칸 번호), 세로축 x 좌표로 그린 것. 처음에 봤던 τ / T 그림을 실제로 만든 거다.
- 들쭉날쭉한 노이즈가 τ가 올라갈수록 점점 매끄러워지고, τ = 1에서 장애물을 피하는 부드러운 궤적이 된다.
Step9 - 왜 chunk로 뽑아야 하냐
비교를 위해 칸마다 따로 생성하는 모델 (per-step)도 만들었다. 경유점 하나 + 몇 번째 칸인지만 보고 그 칸만 생성한다. 다른 칸이 어디 있는지는 모른다.
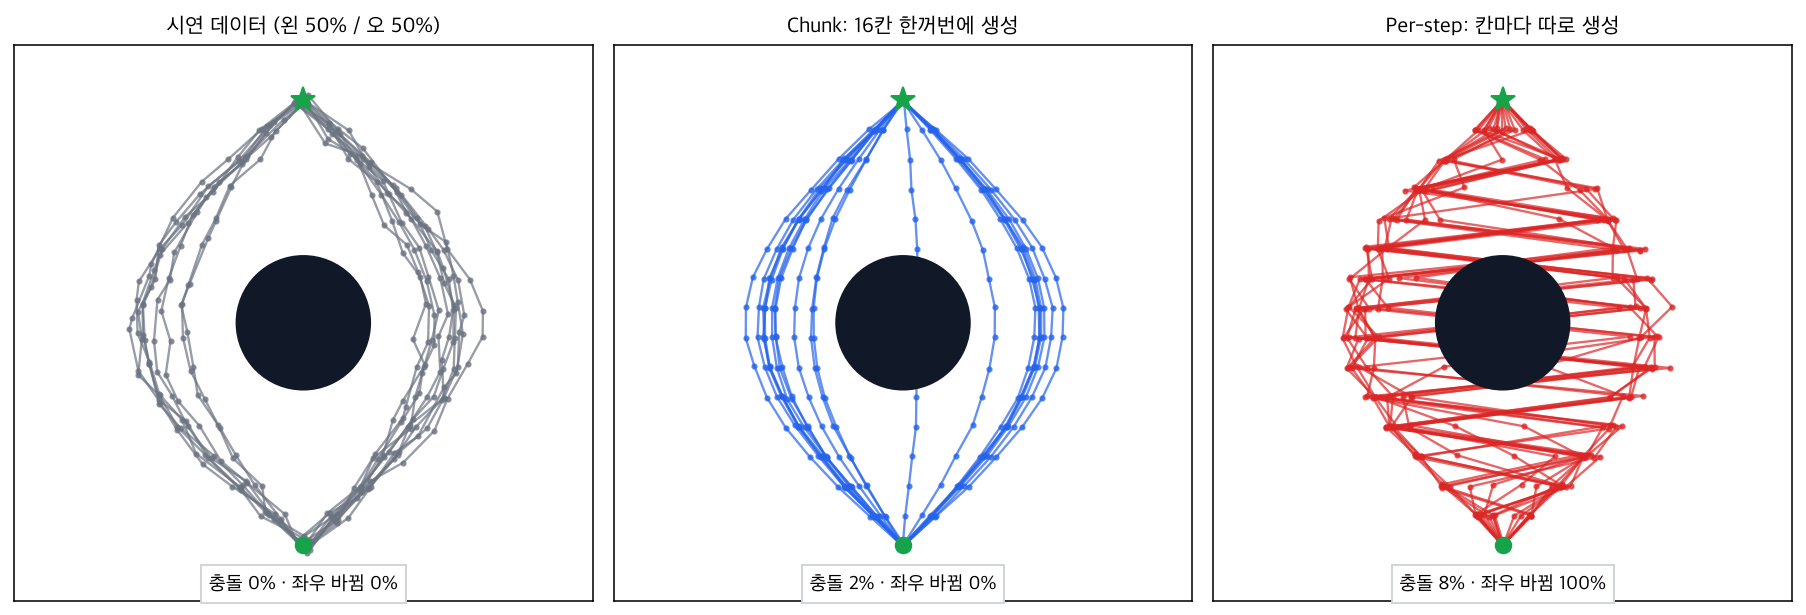
| 충돌 | 중간에 좌우가 바뀜 | |
|---|---|---|
| 시연 데이터 | 0% | 0% |
| Chunk | 1.8% | 0.1% |
| Per-step | 7.9% | 99.8% |
- Per-step: 칸마다 “왼쪽? 오른쪽?”을 50:50으로 따로 고른다. 칸 하나하나는 다 정답 위치인데 이어 붙이면 왼↔오를 오가는 지그재그가 된다. 로봇이 이러면 장애물을 가로질러서 부딪힌다.
- Chunk: 16칸을 한 번에 보니까 궤적 전체가 한 쪽으로 일관되게 간다.
- 참고로 chunk도 1.8%는 충돌한다. 그림 가운데 직선으로 가는 궤적 하나가 그거다. “왼쪽으로 갈 노이즈”와 “오른쪽으로 갈 노이즈”의 경계에 걸친 노이즈는 어중간한 곳에 떨어질 수 있다. (Flow matching1에서 반달 사이에 흩어진 점들이랑 같은 현상)
Action chunk = 궤적 전체를 하나의 샘플로 뽑는 것. 그래서 “왼쪽으로 갈지 오른쪽으로 갈지” 같은 결정을 궤적 단위로 한 번만 한다.
칸마다 따로 뽑으면 칸마다 다른 결정을 내서 섞여버린다. π₀, ACT, Diffusion Policy가 전부 chunk를 쓰는 이유다.
마지막으로 Flow matching1 맨 처음에 던진 질문으로 돌아가보자. “왜 회귀가 아니라 생성 모델이냐?” 처음엔 개념도로만 그렸는데, 이번엔 진짜로 두 모델을 학습시켜서 비교해본다.
Step10 - 실험 설정: 회귀 vs Flow matching
Step5의 장애물 회피 데이터에서 장애물 위치만 좌우로 움직이게 바꿨다. 장애물 위치 ox가 로봇이 보는 관측이다.
1
2
3
ox = (torch.rand(n, 1) * 2 - 1) * 0.5          # 장애물 x 위치: -0.5 ~ 0.5 (관측)
p_right = torch.sigmoid(-ox / 0.05)             # 장애물이 왼쪽에 있으면 오른쪽으로, 가운데면 50:50
side = torch.where(torch.rand(n, 1) < p_right, 1.0, -1.0)
- 장애물이 한쪽으로 치우치면 → 시연은 넓은 쪽으로만 간다. 정답 하나.
- 장애물이 가운데 근처면 → 시연이 왼쪽 / 오른쪽 반반. 정답 두 개.
같은 데이터로 두 모델을 학습한다.
| MSE 회귀 | Flow matching | |
|---|---|---|
| 입력 | 관측 ox | 관측 ox + 노이즈 섞인 궤적 + τ |
| 출력 | 궤적 16칸 (정답 바로) | 궤적 16칸의 속도 (10스텝 반복) |
| loss | ‖model(ox) − 시연 궤적‖² | Step7이랑 같은 flow matching loss |
1
2
3
4
5
# 회귀: 관측 → 궤적. 노이즈도 τ도 없어서 같은 관측이면 항상 같은 궤적
loss = ((reg_model(ox) - x1) ** 2).mean()

# Flow matching: Step7이랑 똑같고 관측 ox만 조건으로 추가 (Step2의 c 자리)
loss = ((flow_model(x_t, t, ox) - (x1 - x0)) ** 2).mean()
- 관측 ox는 작은 MLP(
Linear → SiLU → Linear)로 벡터 32개로 바꿔서 넣는다. VLA에서 VLM이 이미지 + 지시문을 벡터로 바꾸는 역할을 아주 작게 흉내낸 거다. - 두 모델 MLP 크기는 똑같다. 차이는 정답 하나를 맞히냐 vs 분포를 배우냐 뿐이다.
Step11 - 결과: 장애물이 정중앙일 때
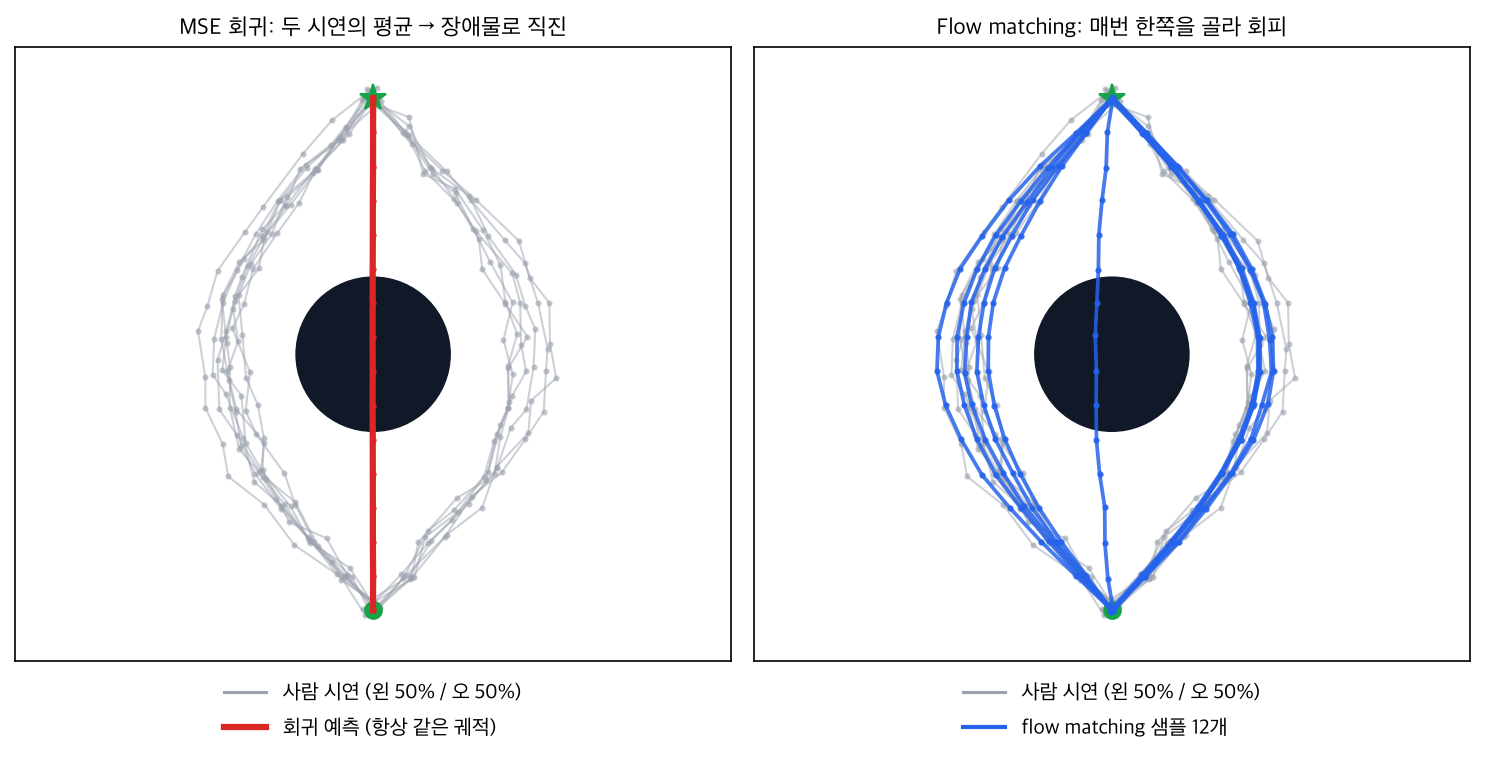
- 회귀 (빨강): 왼쪽 시연 + 오른쪽 시연의 평균 = 정중앙 직선. 장애물에 그대로 박는다. 충돌률 100%.
- Flow matching (파랑): 샘플마다 왼쪽이나 오른쪽 하나를 골라서 회피한다. 충돌률 3.8%.
- 회귀는 학습을 못한 게 아니다. MSE를 최소로 만드는 답이 수학적으로 평균이라서 정확히 그걸 배운 거다.
- FM의 3.8%는 Step9에서 본 거랑 같은 이유다. 왼쪽/오른쪽 경계에 걸린 노이즈가 가운데로 떨어진 경우 (오른쪽 그림 가운데 선 하나).
Step12 - 결과: 장애물 위치별로 보면
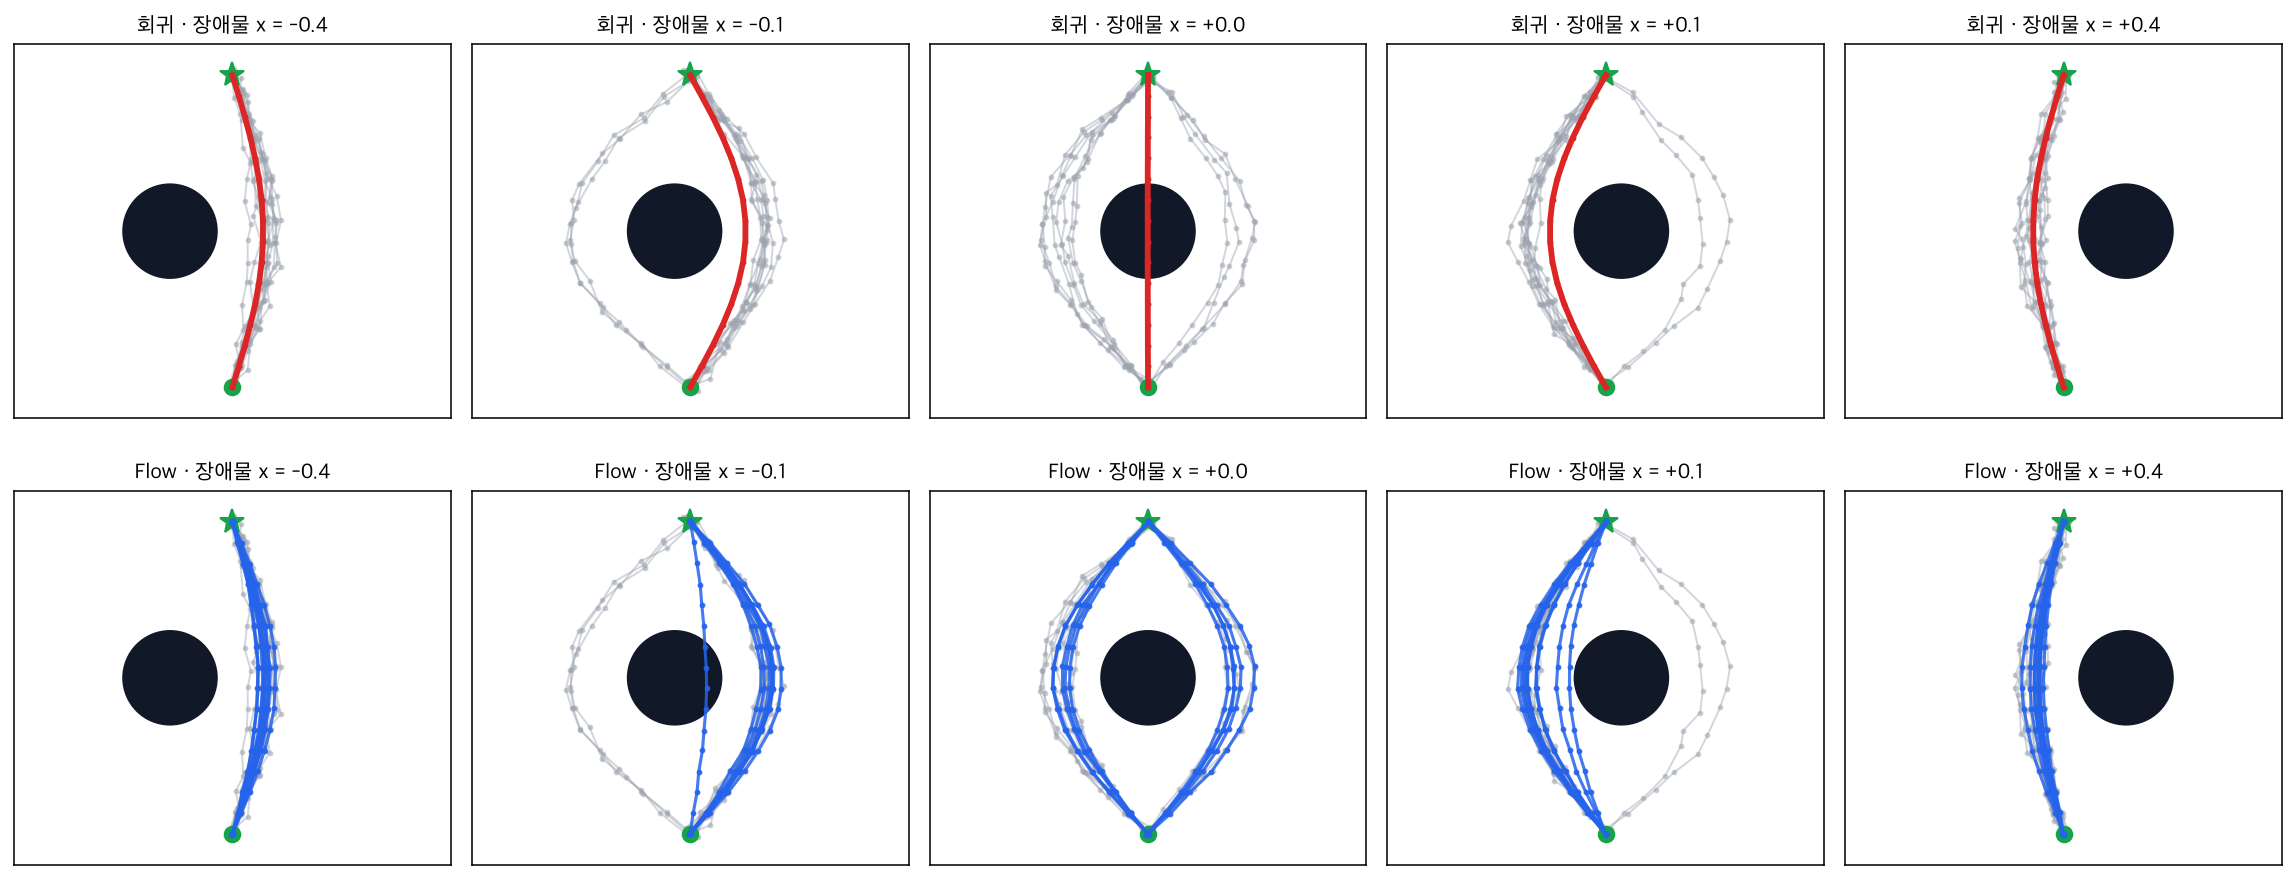
위: 회귀, 아래: flow matching. 회색은 그 위치에서의 사람 시연.
- 장애물이 ±0.4 (치우침): 시연이 한쪽뿐이다. 회귀도 flow matching도 둘 다 잘 피한다.
- 장애물이 ±0.1: 시연이 한쪽으로 쏠려 있어서(대부분 넓은 쪽) 회귀 평균도 그쪽으로 기운다. 아직 괜찮다.
- 장애물이 0.0: 시연이 반반으로 갈린다. 회귀만 무너진다.
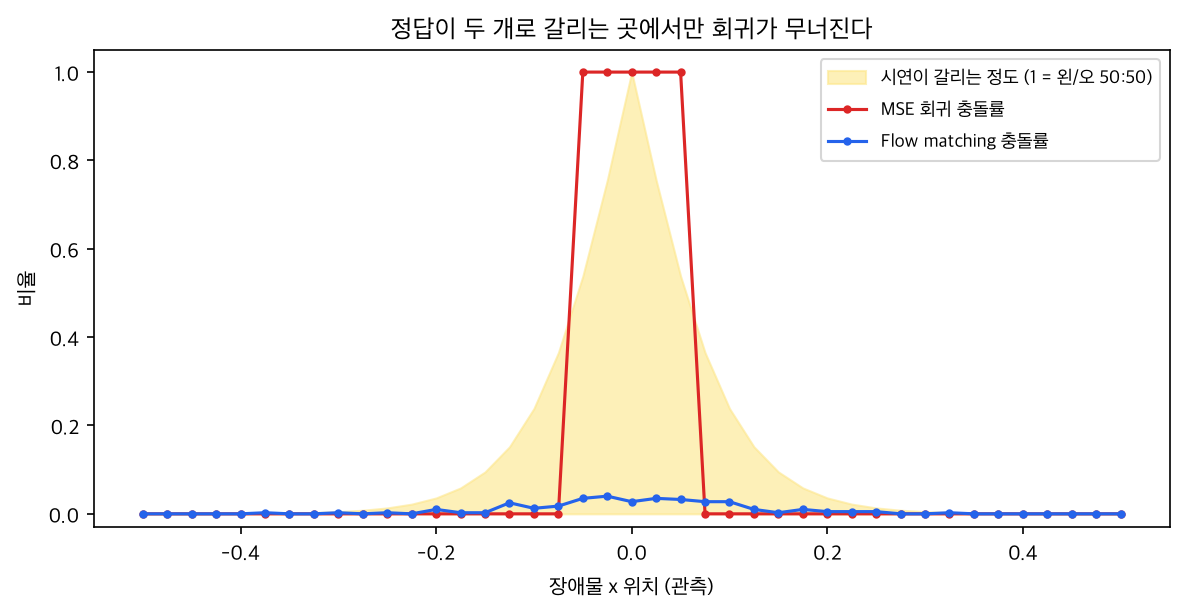
| 충돌률 | 장애물 가운데 (0.0) | 장애물 치우침 (±0.4) |
|---|---|---|
| MSE 회귀 | 100% | 0% |
| Flow matching | 3.8% | 0% |
- 노란 영역 = 시연이 왼/오로 갈리는 정도. 회귀 충돌률(빨강)이 정확히 노란 영역 꼭대기에서만 치솟는다.
- 즉 회귀가 항상 나쁜 게 아니다. 정답이 여러 개로 갈리는 상황에서만 정확하게 실패한다.
회귀 = “정답 하나”를 가정한다. 정답이 하나뿐인 상황에선 잘 되지만, 정답이 여러 개면 그 평균을 내고 그 평균은 아무 정답도 아닐 수 있다 (장애물 정중앙).
Flow matching = “정답들의 분포”를 배워서 그중 하나를 고른다. 실제 로봇 시연은 같은 상황에서도 사람마다, 매번 다르게 움직이니까 정답이 여러 개인 게 기본이다.
이게 π₀, SmolVLA 같은 VLA가 Action Expert로 flow matching을 쓰는 이유다.