
Part 2. Cosmos Predict2.5 — How NVIDIA Generates Robot Data
Cosmos Predict2.5는 text, image, video를 받아 영상을 만드는 world model이다. Reason1 텍스트 인코더와 DiT 구조, 2억 개 clip을 남기는 video curation pipeline, 그리고 pre-training → 도메인별 SFT → Model Soup → RL → distillation까지의 학습 과정을 정리한다.
Introduction
일단 최근에 Cosmos3 (2026.09) 모델이 등장을 하였고, 센프란시스코 엔비디아 비디오 해커톤에서 Cosmos3를 처음 접하게 되었다.
(사실 그 전부터 이야기는 들었지만, 실제로 구조를 들여다 본적은 처음이었다.)
그냥 신기 그 자체였다 왜냐하면, Multimodal 이 모든 이미지, 비디오, 음성, 액션 을 input - output하는 모델이 존재한다는 게 신기하고, 보자마자 이거 로봇 데이터 생성 무제한으로 하려고 하는구나, 라는 엔비디아의 비전이 보였다.
Cosmos 3: Omnimodal World Models for Physical AI
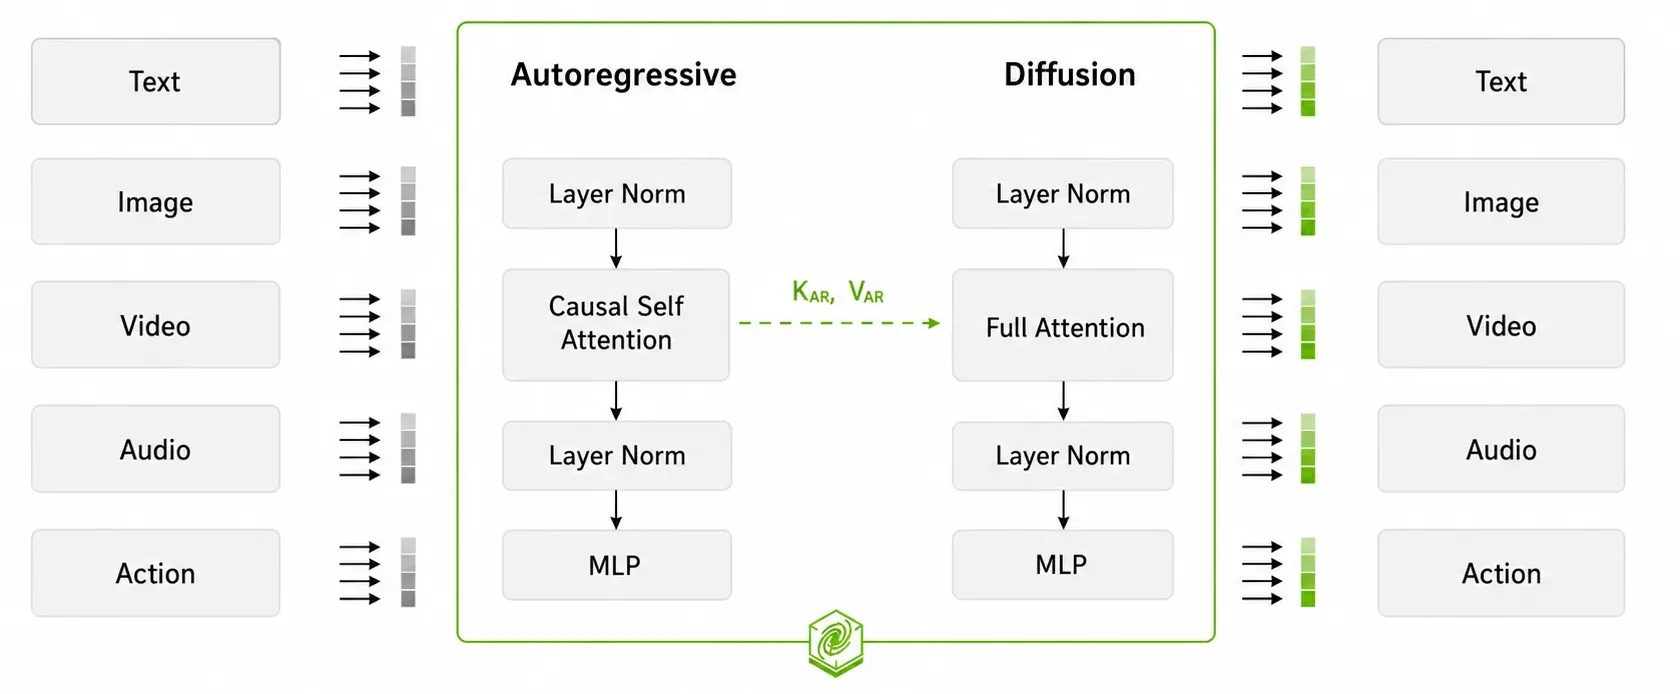
Cosmos3의 구조를 보기전에, 이제 Cosmos 이전 버전들을 살펴보기로 하였고, 오늘은 그중에서도
- Cosmos Predict 2.5
를 오늘은 빠르게 살펴보자.
Architecture
Predict모델 계열은 text, image, video → video generation을 하는 모델이고, Transfer은 video edit이다.
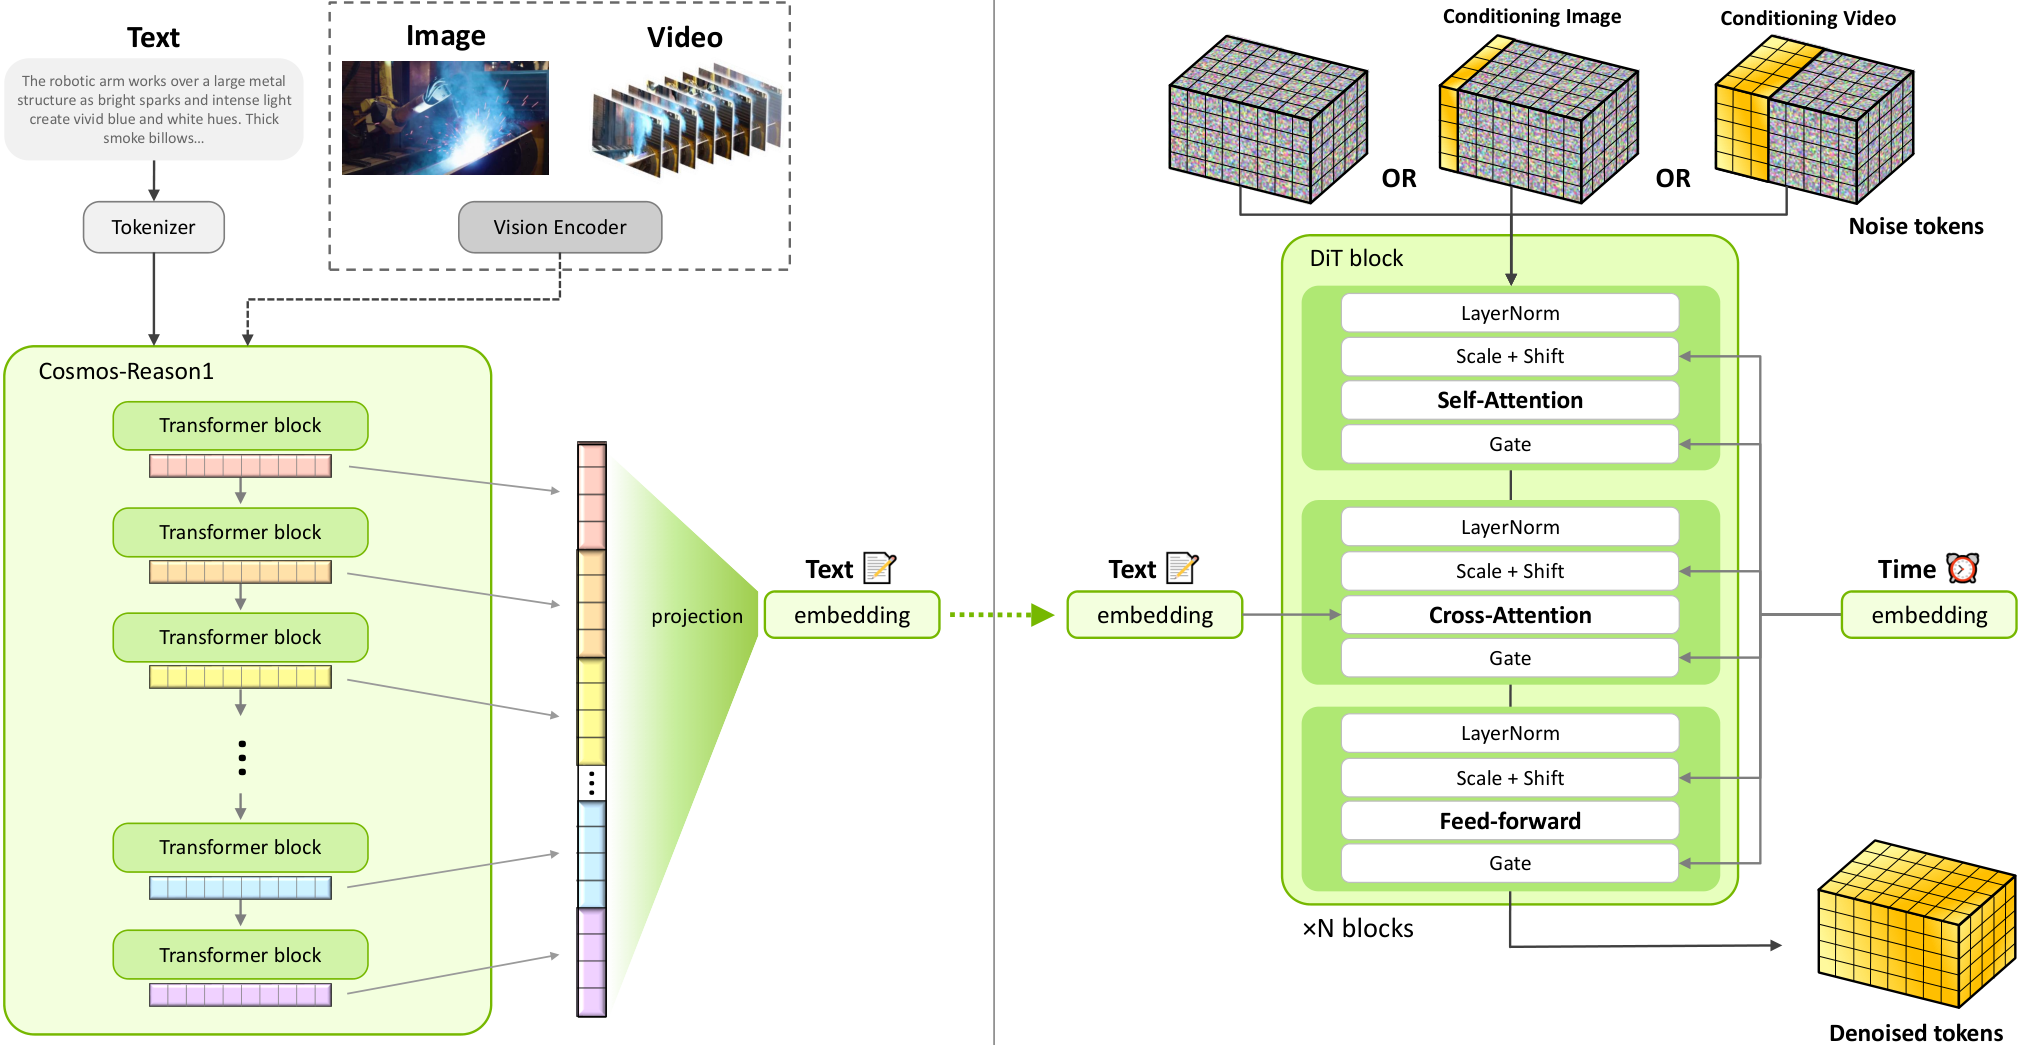
자 이제, 자세한 Architecture을 들어가보자.
- 여기서, 맨처음에 Cosmos-Reason1모델이 image, video , text input 이 들어가고 Decoder only Transformer를 거쳐서 Sequential 한 output token이 나오고 이를 projection 하여 임베딩 벡터로 우리가 얻게 된다. (단순하게 말하면, Cosmos Reason1을 먼저 거친다.)
- 그리고 두번째로는 여기서 얻은 특징을 K,V로 디노이징 과정과 Cross-Attention 을 거친다는 것이 핵심이다. 따라서, 최종적으로는 denoised token 즉 하나의 영상으로 output이 도출된다.
엔비디아에서 공개하는 모델들은 파라메터수가 적은 것과 큰 것 이렇게 2가지를 항상 같이 공개한다.
| Predict2.5-2B | Predict2.5-14B | |
|---|---|---|
| Layer 수 | 32 | 36 |
| Model dim | 2048 | 5120 |
| Head 수 | 16 | 40 |
Training
여기서 가장 중요한게 학습 방식이다, 데이터를 어떻게 얻었으며 어떤 방식과 순서로 학습을 진행했는 지를 찾아보자.
전체 흐름 한줄 요약
데이터 정제 (2억 개 clip)
→ Pre-training (해상도·task를 점점 어렵게)
→ 도메인별 SFT
→ Model Merging
→ RL
→ Timestep Distillation
1. Data - Video Curation Pipeline
사실 영상 생성 모델에서 제일 노가다이면서 제일 중요한 게 데이터 정제다. 쓰레기 영상을 넣으면 쓰레기 영상이 나오니까. (이게 실제로도 가장 어려운 작업이다, 엔비디아는 이 process를 opensource 로 공개하였고, 이 방식으로 총 학습을 진행했다. 자세히, Predict2.5는 원본 영상 3,500만 시간(약 2억 개 영상) 을 가지고 시작해서, 최종적으로 2억 개의 학습용 clip 만 남긴다.
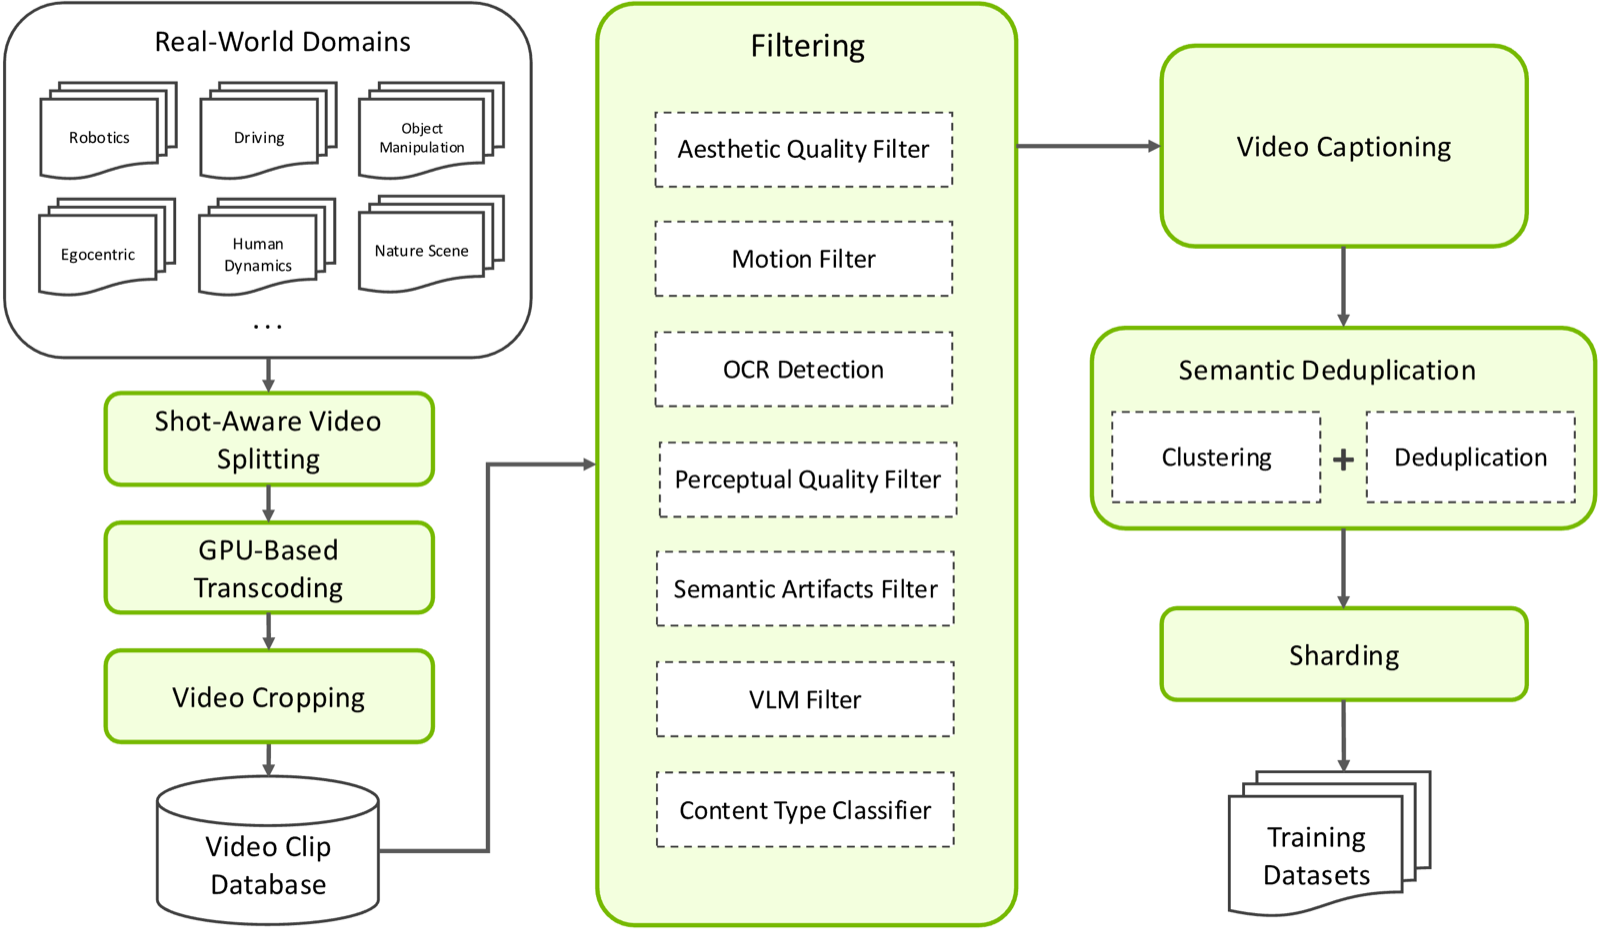
논문 원문 · Figure 1 Video Curation Pipeline
파이프라인은 총 7단계이다.
- Shot-aware Video Splitting: 긴 영상을 장면 전환(shot boundary) 기준으로 자른다. → 장면이 확 바뀌는 순간이 학습에 섞이면 안되니까.
- GPU-based Transcoding: GPU로 영상 포맷을 통일한다.
- Video Cropping: 검은 테두리, padding을 잘라낸다. 그리고 5초 미만 clip은 버린다. → 여기까지 오면 5~60초짜리 clip이 60억 개가 된다.
- Filtering: 진짜 핵심. 아래에서 따로 설명.
- Captioning: 각 clip에 설명 텍스트를 단다.
- Semantic Deduplication: 의미상 비슷한 영상을 지운다.
- Sharding: 학습할때 꺼내 쓰기 좋게 나눠서 저장한다.
Filtering - 60억 개 중에 4%만 살아남는다
필터는 싼 것부터 비싼 것 순서로 건다. 비싼 필터를 60억 개에 다 돌릴 수는 없으니까.
- Aesthetic Quality Filter: 보기 좋은 영상인지 점수를 매긴다.
- Motion Filter: 움직임이 너무 없거나 이상한 clip을 거른다. (world model인데 가만히 있는 영상은 배울게 없다)
- OCR Filter: 자막, 글자가 너무 많이 덮인 영상을 거른다.
- Perceptual Quality Filter: 노이즈, 깨짐, 왜곡 같은 기술적인 화질 문제를 거른다. (DOVER 같은 방식)
- Semantic Artifacts Filter: 영상 속 영상(video-in-video), 어색한 전환 같은 의미상 이상한 영상을 거른다.
- VLM Filter: 마지막으로 VLM(Qwen2.5-VL)이 직접 보고 한번 더 거른다. → 제일 정확하지만 제일 비싸서 맨 마지막에 둔다.
그리고 Content Type Classifier로 영상 종류를 분류해서, 게임, 애니메이션, 만화, CG 같은 물리적으로 현실이 아닌 영상은 제외한다. → Physical AI용 world model이니까 현실 물리를 따르는 영상만 남기는 것.
결과적으로 60억 개 중에 약 4% 만 통과해서 2억 개 clip 이 pre-training 데이터로 사용.
Captioning
- 각 clip을 5초 단위로 쪼개서 Qwen2.5-VL-7B(VLM)로 caption을 단다.
- 주인공 물체, 그 물체의 움직임, 장면의 핵심 정보를 위주로 쓰도록 prompt를 짰다.
- caption은 short / medium / long 3가지 길이로 만든다. → 짧은 prompt가 들어오든 긴 prompt가 들어오든 대응할 수 있게.
Semantic Deduplication & Sharding
- Dedup: embedding으로 clustering을 하고, 같은 cluster 안에서 비슷한 영상끼리 비교해서 해상도가 제일 높은 것만 남긴다. 새 영상이 들어오면 기존 영상들과 비교하는 online 방식이라 데이터가 계속 늘어나도 된다.
- Sharding: 26가지 영상 종류 + 해상도 + 화면비 + 길이 기준으로 나눠서 저장한다. → 나중에 “720p 로봇 영상만 뽑아줘” 같은 curriculum 학습, 도메인 비율 조절이 쉬워진다.
Predict1 vs Predict2.5 데이터 비교
| Predict1 | Predict2.5 | |
|---|---|---|
| 원본 영상 | 2,000만 시간 | 3,500만 시간 |
| 필터 통과율 | 30% | 4% |
| 최종 학습 clip | - | 2억 개 |
→ 데이터는 더 많이 모으고, 필터는 훨씬 빡세게 걸었다는 것.
Domain Specific Data
일반 데이터 말고도 Physical AI에 중요한 5개 도메인은 따로 모았다: Robotics, Autonomous Driving, Smart Spaces(공장, 창고), Human Dynamics, Physics
여기서 로봇 데이터는 이렇다.
| Dataset | Embodiment | 영상 수 (central view 기준) |
|---|---|---|
| AgiBot-Beta | 양팔 | 194k |
| DROID | 단일 팔 | 39k (wrist) + 좌우 각 51k |
| Bridge | 단일 팔 | 36k |
| 1X | 양팔 | 17k |
| RoboMIND | 양팔 / 휴머노이드 | 16k |
| GR00T | 양팔 | 3k |
| OpenX | 단일 팔 | 500 |
- 해상도 낮은 영상, 거의 안 움직이는 영상은 버리고, 너무 느린 로봇 영상은 재생 속도를 올려서 데이터셋끼리 동작 속도를 맞췄다. (이거 은근 디테일)
- 로봇 caption은 처음 장면 → 로봇 동작을 시간 순서대로, 어떤 부위(arm, wrist, gripper)가 어떻게(직선, 회전) 움직이는지까지 쓰게 했다. 그리고 데이터셋에 원래 있던 task 설명, step instruction 같은 metadata를 prompt에 같이 넣어서 hallucination을 줄였다.
2. Training
2-1. Flow Matching
Predict1은 EDM 방식의 diffusion이었는데, Predict2.5는 Flow Matching 으로 바꿨다. 수학적으로는 같은 과정인데, 모델이 뭘 예측하냐가 다르다. → Flow Matching은 노이즈에서 데이터로 가는 방향(velocity) 을 예측한다.
1
2
3
x_t = (1 - t) * x + t * ε        # 원본 x와 노이즈 ε를 t 비율로 섞음 (t ~ logit-normal)
v_t = ε - x                      # 정답 velocity
Loss = || u(x_t, t, c) - v_t ||²  # c = text embedding, 조건 프레임 등
2-2. Pre-training - 쉬운 것부터 어려운 것으로
한번에 720p 영상을 학습시키는게 아니라, 해상도 와 task 두 축으로 난이도를 점점 올린다.
| Stage | Task | 해상도 |
|---|---|---|
| 1 | Text2Image | 256p |
| 2 | Text2Image + Video2World | 256p |
| 3 | Text2Image + Video2World | 480p |
| 4 | Text2Image + Video2World | 720p |
| 5 | Text2Image + Video2World + Text2World | 720p |
- 처음엔 사진 한장 잘 그리는 법 부터 배우고(Text2Image), 그 다음에 움직임을 배운다.
- Video2World 학습할때는 조건 프레임을 1개 또는 5개 주고 나머지 92개 또는 88개 프레임을 생성하게 한다. (총 93 프레임 = latent 24 프레임)
- 마지막에 Text2World(조건 프레임 0개)를 추가한다. 이때는 조건 프레임을 0 / 1 / 2개를 0.5 / 0.25 / 0.25 확률로 뽑는다. → 그래서 하나의 모델로 Text2World, Image2World, Video2World가 다 되는 것.
- 조건 프레임은 noise 섞인 프레임 옆에 그대로 concat하고, mask token으로 “이건 조건” 표시를 한다. loss는 생성해야 할 프레임에만 건다.
여기서 재밌는 디테일 하나.
학습을 했더니 프레임 사이가 갑자기 툭 끊기는 artifact 가 생겼다고 한다. 원인을 보니 노이즈가 아주 큰 구간(high-noise)의 학습 샘플이 너무 적었던 것. → 그래서 학습 샘플의 5%를 노이즈 상위 2% 구간에서 일부러 뽑도록 바꿨더니 해결됐다. (high-noise 구간 = 영상의 큰 구조와 움직임을 정하는 구간이라 여기를 덜 배우면 흐름이 깨진다)
2-3. Post-training ① 도메인별 Supervised Fine-Tuning + Model Merging
- 고품질 데이터를 5개 도메인으로 나눈다: Object Permanence(10.4M), High Motion(1.0M), Complex Scenes(1.6M), Driving(3.1M), Robotic Manipulation(730K)
- 여기서 재밌는건 하나의 모델에 다 섞어서 학습하는게 아니라, 도메인마다 모델을 따로 SFT 한다는 것이다. → 데이터 섞는 비율을 고민할 필요가 없음. (각 30k iteration)
- 그리고 4K 고화질 영상으로 learning rate를 0까지 내리는 cooldown 모델도 하나 따로 만든다.
- 마지막으로 이 모델들을 Model Merging 으로 하나로 합친다. Model Soup, TIES, DARE-Linear, DARE-TIES를 다 해봤고, 결국 제일 단순한 Model Soup (가중치 평균) 을 골랐다.
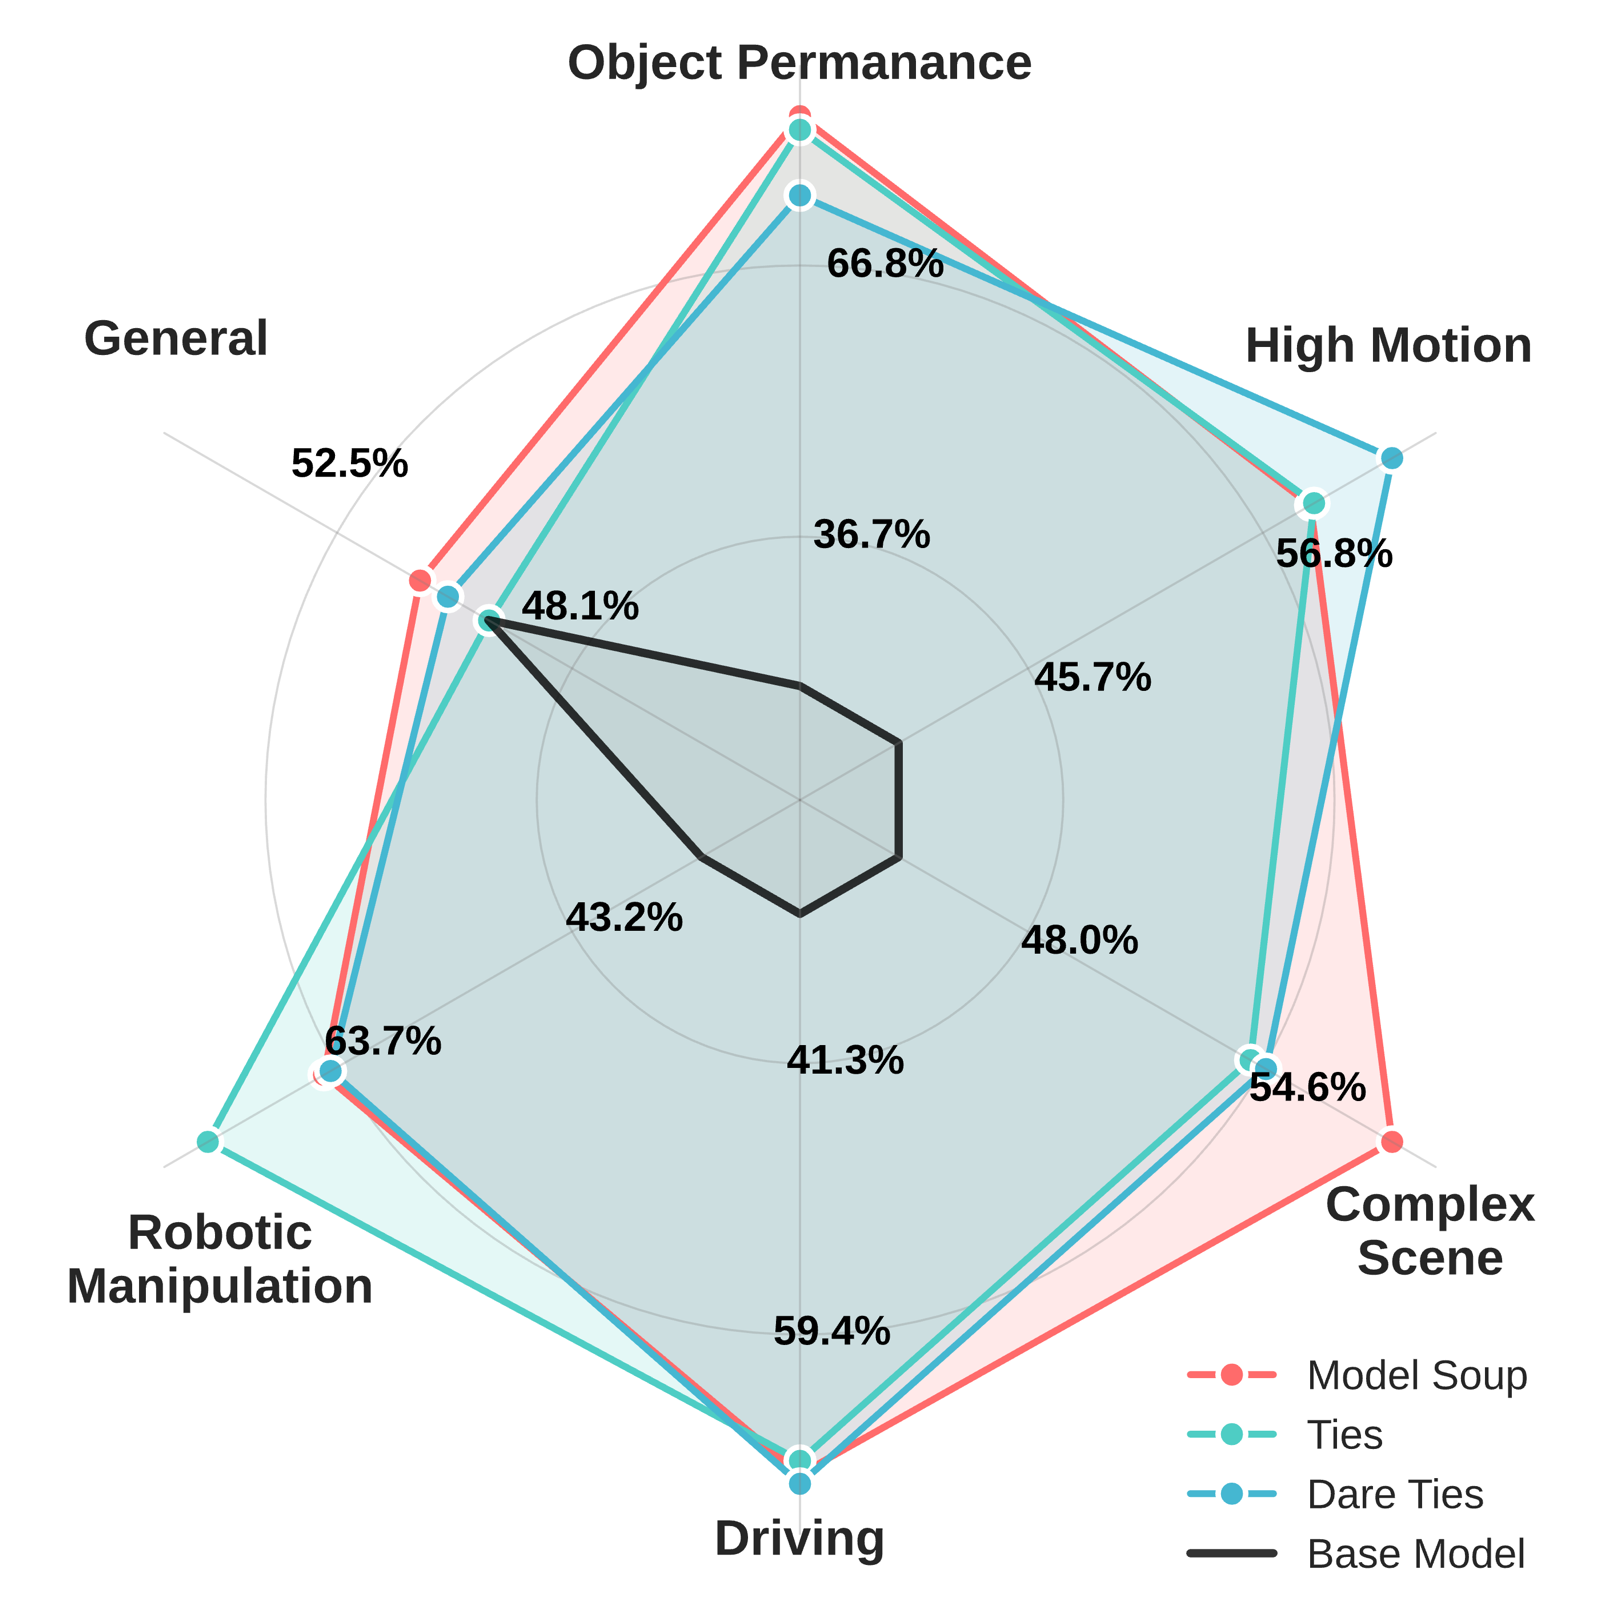
논문 원문 · Figure 4 합친 모델이 모든 도메인에서 Base 모델보다 좋고, General 성능도 유지한다
나만의 언어로 하면,
“각 과목 전문가를 따로 키운 다음에 머리를 합친다”
“같은 스승한테 배운 제자들이라 생각하는 방식(가중치 배치)이 비슷해서, 평균을 내도 말이 된다.”
2-4. Post-training ② RL
- LLM에서 쓰는 RL(GRPO)을 영상 생성에 그대로 가져왔다.
- 보상 모델은 VideoAlign (VLM 기반)이고, 텍스트 정합성, 움직임 품질, 화질 3가지를 점수로 준다.
- 조건 하나당 영상 8개를 생성하고, 그 8개 안에서 점수를 정규화해서 advantage로 쓴다. (GRPO랑 똑같음)
- reward hacking(점수만 잘 받는 이상한 영상)을 막으려고 원래 diffusion loss도 같이 건다.
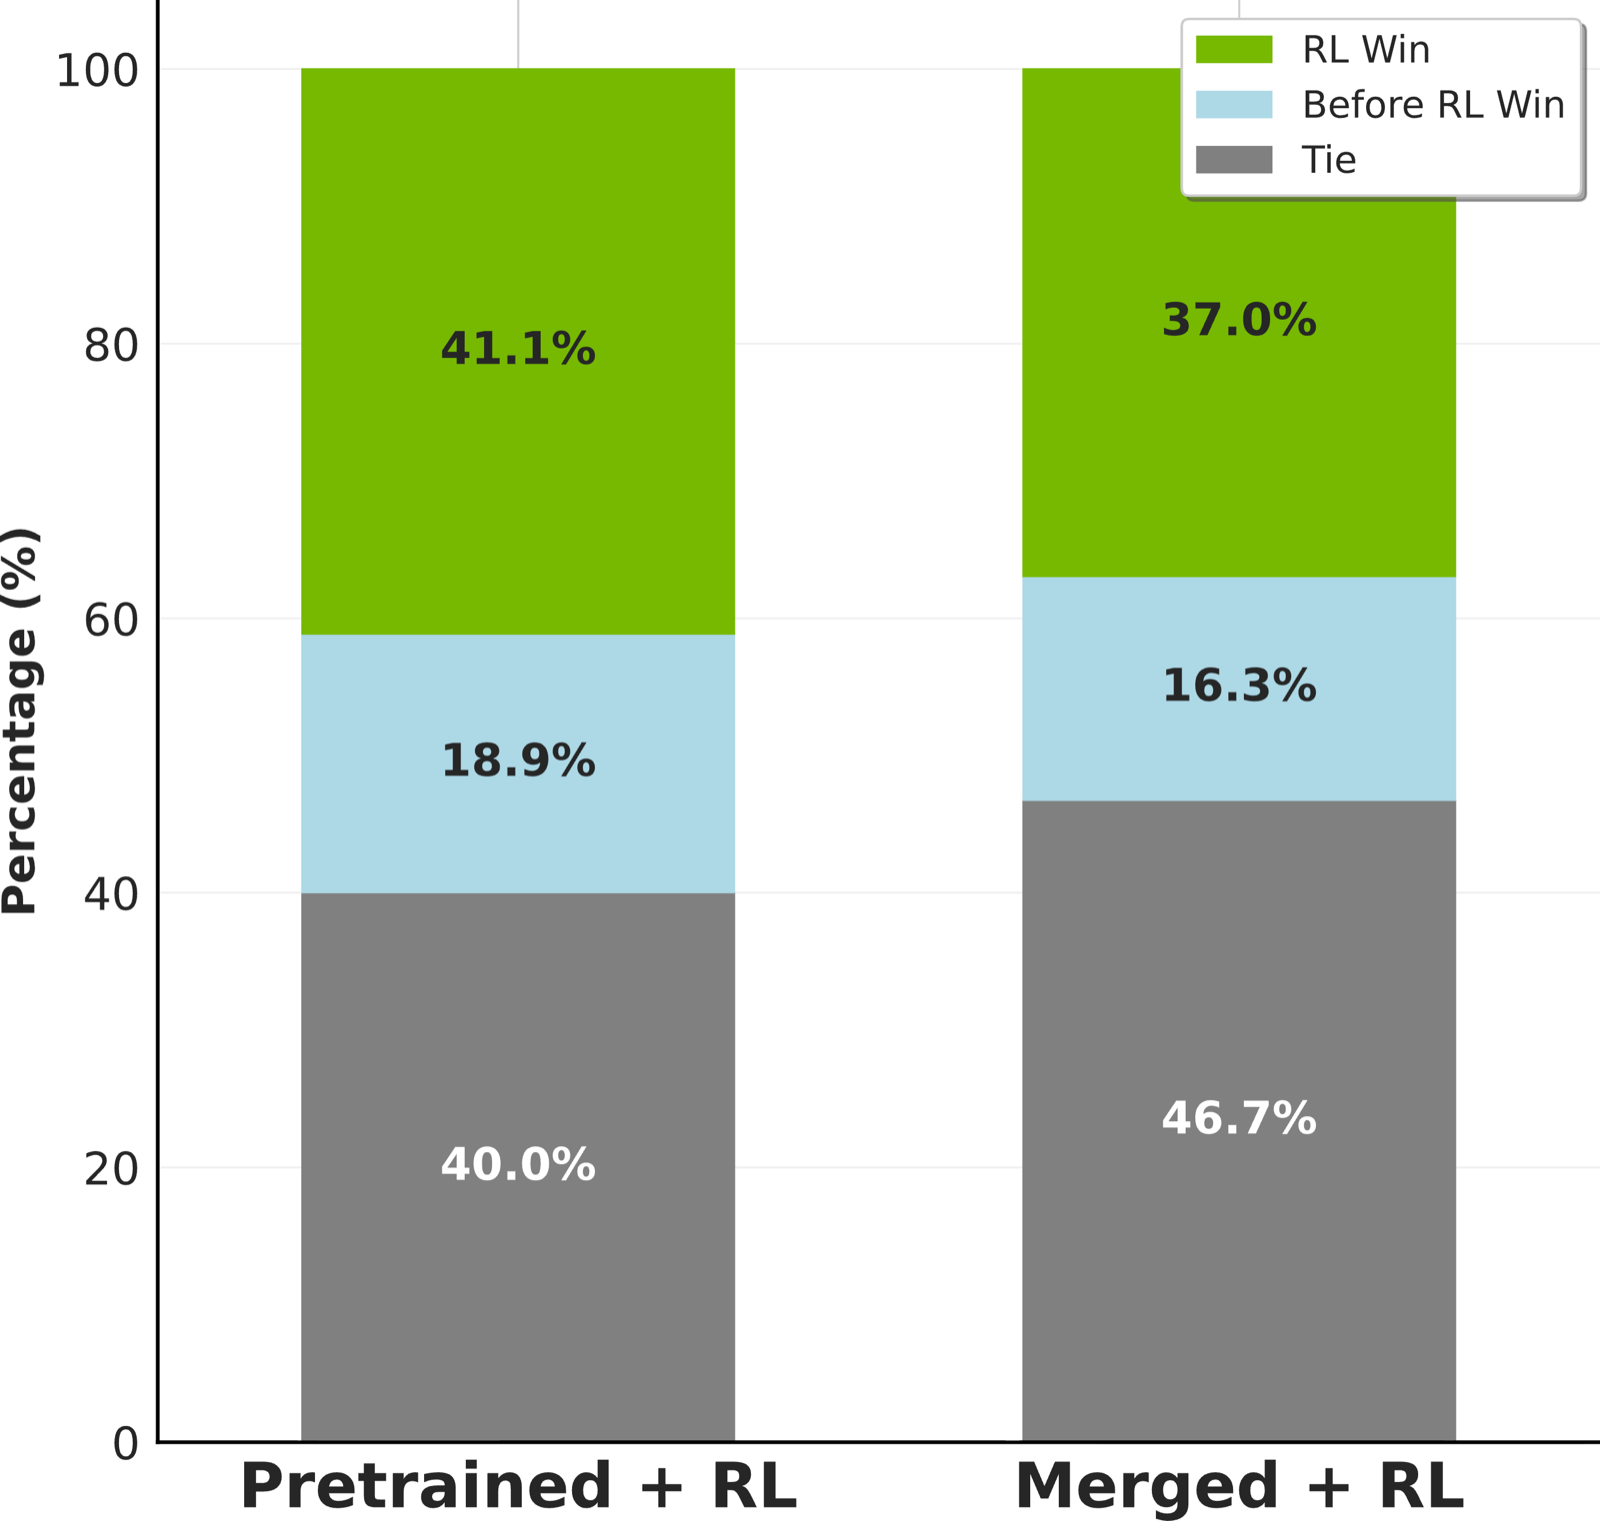
논문 원문 · Figure 5 사람 투표에서도 RL 후 영상이 더 선호된다
2-5. Timestep Distillation
마지막으로 속도. diffusion은 step을 많이 밟아야 해서 느린데, rCM 이라는 distillation으로 4 step 만에 생성하도록 만들었다. 점수는 teacher랑 거의 같다. (Text2World overall 0.768 → 0.764)
정리하면, Predict2.5 학습의 핵심은 3가지이다.
- 데이터: 60억 개 clip 중 4%만 남기는 빡센 필터 + 현실 물리가 아닌 영상 제외
- Pre-training: 사진 → 영상, 256p → 720p로 점점 어렵게 + 하나의 모델로 Text/Image/Video2World
- Post-training: 도메인 전문가 SFT → Model Soup로 합치기 → RL로 다듬기 → 4 step distillation
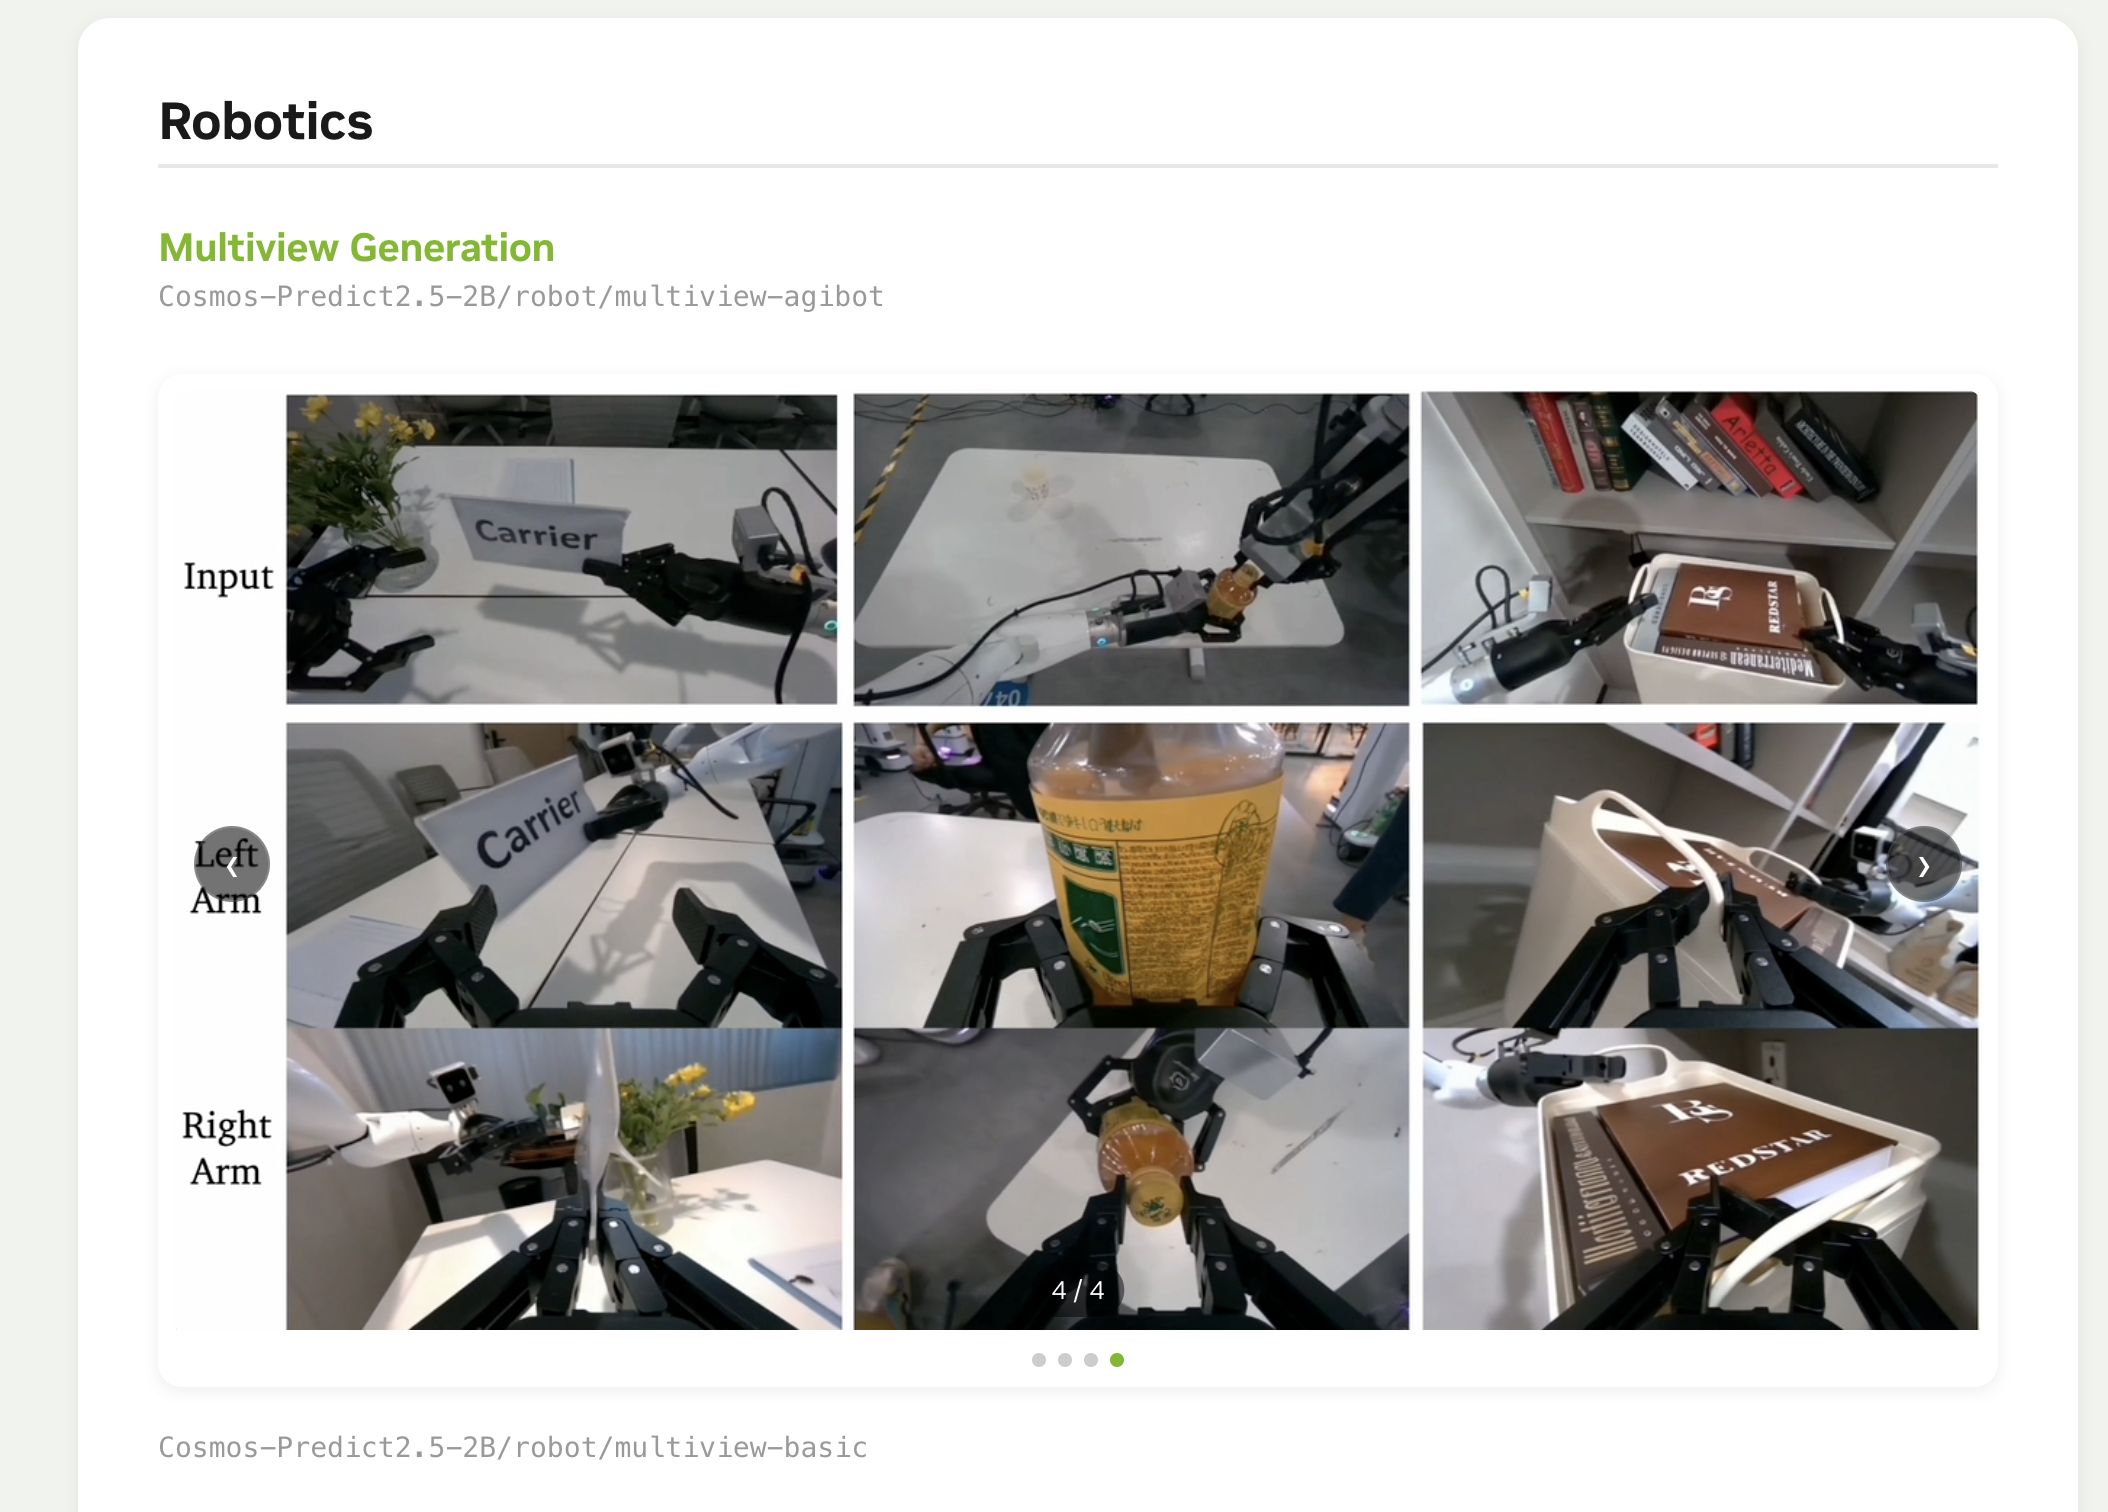
이제 이것을 활용해서 다양한 분야, 즉 정의한 전문가 6개의 영역에 대한 영상을 제작할 수 있고, 우리의 관심사인 로봇의 학습용 데이터를 제작할 수 있게 된다.
Reference
- World Simulation with Video Foundation Models for Physical AI (arXiv 2511.00062) — 메인 논문. Predict 2.5 + Transfer 2.5 구조·학습 둘 다 여기
- Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control (arXiv 2503.14492) — Transfer의 원조. multi-control ControlNet 구조, 2.5와 비교용
- Cosmos Predict 2.5 & Transfer 2.5 (Hugging Face 블로그) — 논문 전에 가볍게 훑는 공식 요약
- DreamGen: Unlocking Generalization in Robot Learning through Video World Models (arXiv 2505.12705) — Predict로 로봇 데이터 만드는 실제 사례