
Geometry-Change VLA (GC-VLA) - HABILIS Brain 0
투모로로보틱스의 HABILIS Brain 0(GC-VLA)는 '장면이 어떻게 바뀌는가'를 토큰으로 먼저 배우고, 그 위에서 액션을 배운다. Geometry-Change Token, 4단계 학습, 데이터, 추론, LIBERO 결과까지 정리한다.
Introduction
오늘은 한국에서 최전선에서 로봇 학습을 진행중인 회사 중 하나인, 투모로로보틱스에서 최신 (2026.09)에 발표한 정책 모델, 논문을 리뷰해보자. 기존 해외 기업들의 VLA와 비슷할 것 같다고 솔직하게 예상을 했지만, Unique한 특징을 지닌다. 어떤 특징이 있고, 왜 그렇게 특징을 잡았는지를 하나하나 살펴보자. 투모로 로보틱스라는 회사에서 발표한 정책 모델이름은, HABILIS Brain 0 이고, 아카이브를 참고해서 리뷰 블로그를 작성해보자.
핵심 아이디어를 한문장으로 표현한게 바로 이것이다. 로봇의 형체에 상관이 없이 단지 visual interface geometry change를 기반으로 학습을 시킨다는 것. → 관절값이 다른 여러 로봇 하드웨어에 대해서도 적용가능함.
This design is motivated by the goal of learning an
embodiment-agnostic visual interfacethat can be pretrained across robot and egocentric video before robot-specific action alignment.
(!!그리고 여기서 egocentric video = 사람이 머리에 카메라 달고 찍은 영상이다. 즉, 로봇 액션 라벨이 없는 사람 영상까지 pretraining에 쓸 수 있다는 게 포인트)
Contents
- Architecture
- Training
- Data
- Inference
- Results
- Future work & Company vision
Architecture
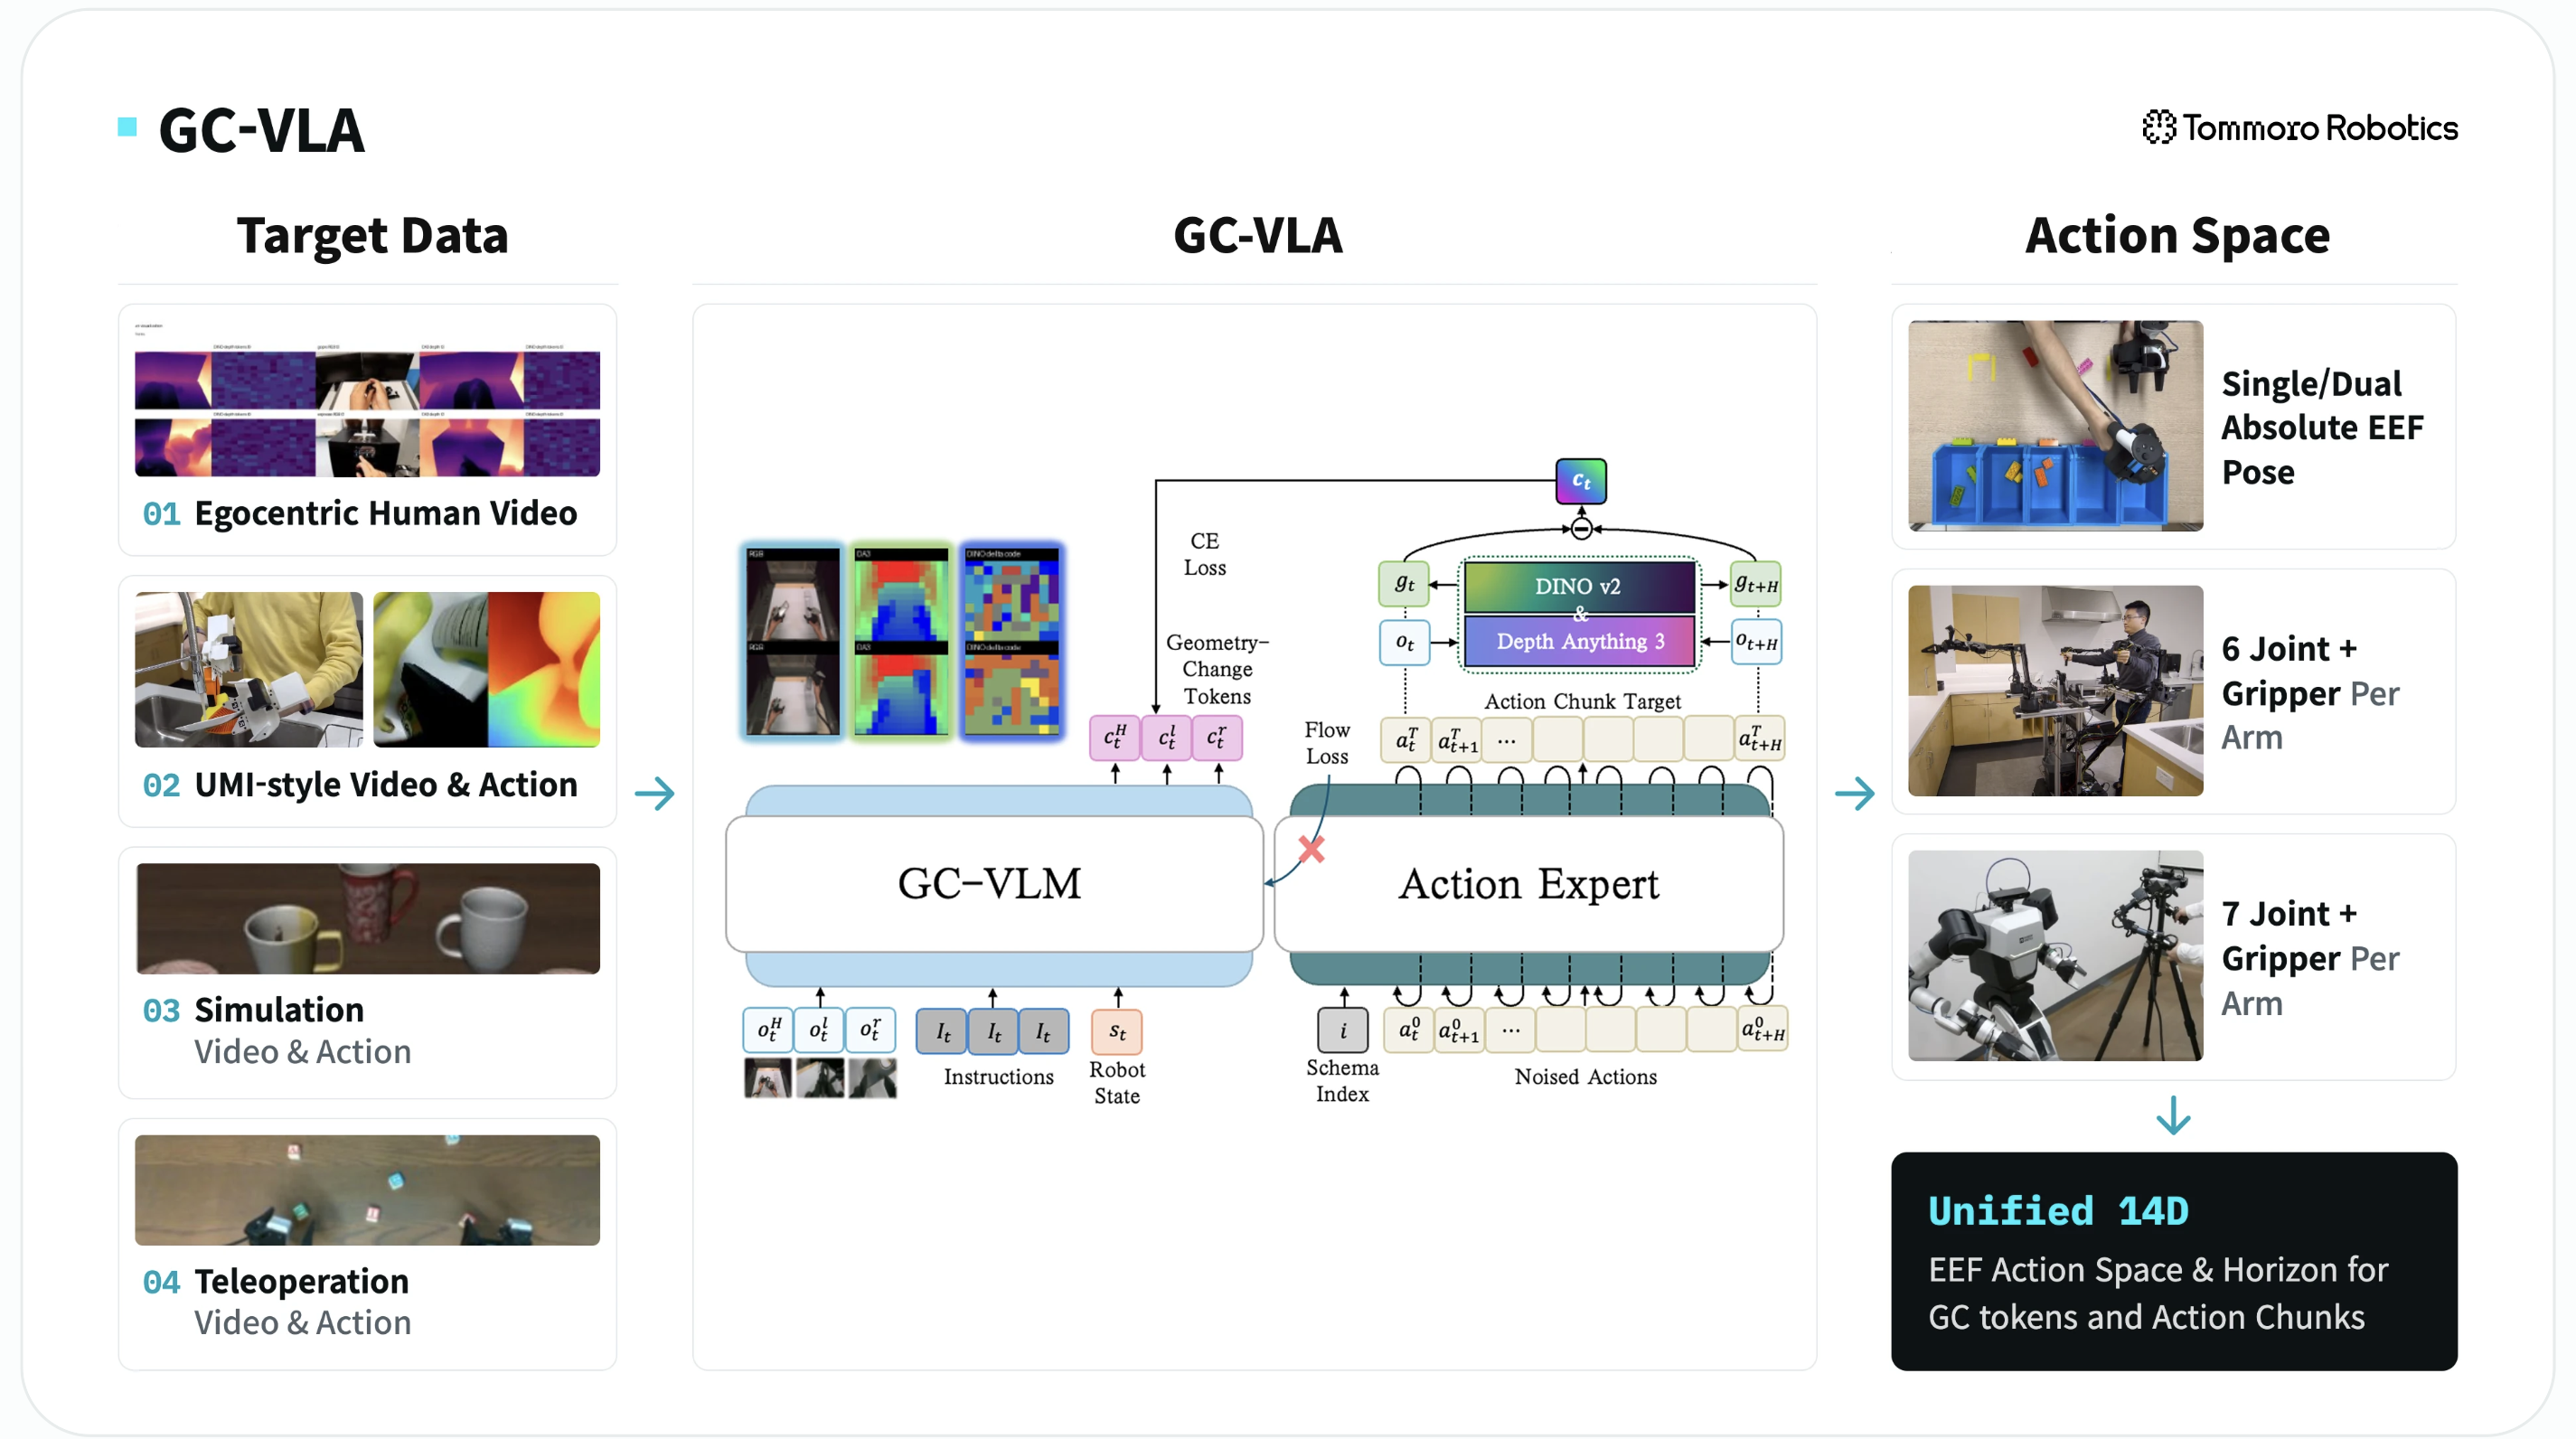
아주 재미있는 아키텍쳐이다. 일단, 내가 이해하기로 기존 VLA와 다른 핵심 특징은 3가지이다.
- Geometry-Change Tokens ($y^{GC}$)
- GC - VLM
- DINO & Depth Anything3 (정답 토큰 만드는 용도, offline)
1. Geometry-Change Token
여기서 Geometry - Change Token 이 이 논문의 핵심 포인트이다. 즉, 현재 프레임과 약 0.5초 뒤 프레임 사이에 장면의 geometry(물체의 위치, 모양 → 기계공학으로 치면 Deformation, Motion)가 얼마나, 어디서 바뀌었는지를 token으로 표현한다는 것이다.
- 카메라 view 하나당 10×10 grid = 100개의 discrete token (LLM이 다음 단어 ID를 맞히듯이 token ID를 맞히는 분류 문제)
- head 카메라 1개 + wrist 카메라 2개 = 총 300개 token
- head view는 장면 전체의 변화, wrist view는 그리퍼–물체가 닿는 국소적인 변화를 담당한다.
!!여기서 햇갈리면 안되는게, 논문에서 $c_t$라는 기호는 따로 있다. Stage4 GCRF가 받는 96차원 context 벡터가 $c_t$이다. 그래서 이 글에서는 geometry-change 토큰을 $y^{GC}$라고 부르겠다.
2. GC-VLM
GC-VLM은 기존 VLM(Molmo2-ER)이 output으로 Geometry-Change token을 예측하도록 학습을 진행한 모델이다.
- Backbone: Molmo2-ER (36 layer)
- 그 위에 transformer block 12개를 추가하는데, 새로 random init 하는게 아니라 앞쪽 12개 block을 그대로 복사해서 초기화한다. → 이미 잘 학습된 가중치에서 출발하는 것.
- 이 추가된 12개 block이 geometry-change 예측을 담당하는 윗층이 된다.
그리고 이 GC 정보를 Action Expert에 넘겨주는 통로가 GeometryReader이다. learned query로 GC hidden state를 pooling하고, Action Expert의 몇몇 block에 cross-attention으로 더해준다. 재밌는건 output projection을 0으로 초기화해서, 학습 초기에는 아무것도 안 하는 no-op에서 시작한다는 것. (원래 액션 경로를 망가뜨리지 않으려고)
3. DINO & Depth Anything3
처음에 나는 Action Expert가 만든 액션 chunk로부터 미래 관측을 얻고, 그걸 DINO/DA3에 넣는다고 이해했는데 → 아니다!!
정답 토큰은 데이터셋에 실제로 찍혀 있는 미래 프레임 $o_{t+H}$ 로 학습 전에 미리(offline) 만들어둔다. Action Expert와는 아무 상관이 없다.
1
2
3
4
5
현재 RGB o_t,  미래 RGB o_t+H  (H ≈ 0.5초, 데이터셋에 있는 실제 프레임)
-> Depth Anything3 : RGB -> pseudo-depth map (깊이 지도)
-> DINOv2 : depth map -> feature (10x10 grid)
-> Δe = e_t+H - e_t   (feature 차이)
-> quantize -> view당 100개의 discrete token ID = 정답 y_GC
즉 Depth Anything3가 깊이 정보를 만들고, DINOv2는 Segmentation을 하는게 아니라 그 depth map을 feature로 요약하는 역할이다. 결국 “깊이 지도가 어디서 얼마나 바뀌었는가”를 토큰으로 포착하는 것.
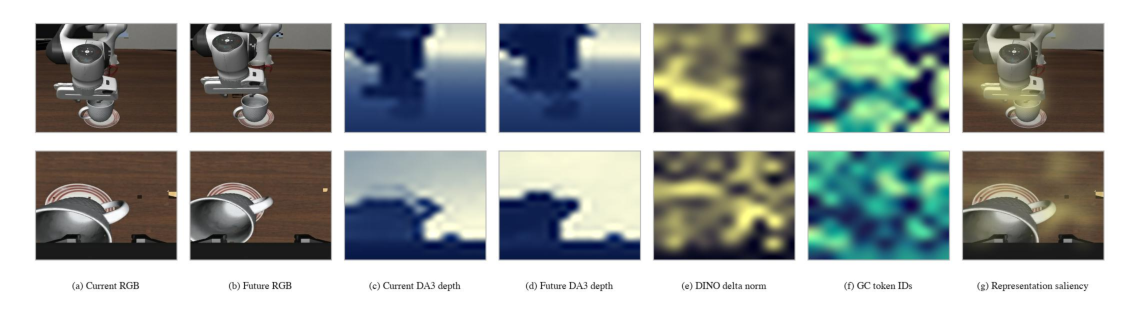
논문 원문 · Figure 2 (a) 현재 RGB (b) 미래 RGB (c–d) DA3 depth (e) DINO feature 차이 크기 (f) 양자화된 GC token ID (g) 현재 이미지 위 overlay
그리고 이제 GC-VLM은 현재 프레임만 보고 이 정답 토큰 ID를 맞히도록 cross entropy로 학습하는 것이다.
\[\mathcal{L}_{GC} = \mathrm{CE}\left(g_{GC}(F_\Theta(x_t)),\ y^{GC}_{t,H}\right)\]Future frames are labels, not inputs.
→ 미래 프레임은 정답으로만 쓰이고 절대 입력으로 들어가지 않는다. (들어가면 cheating이니까)
Training
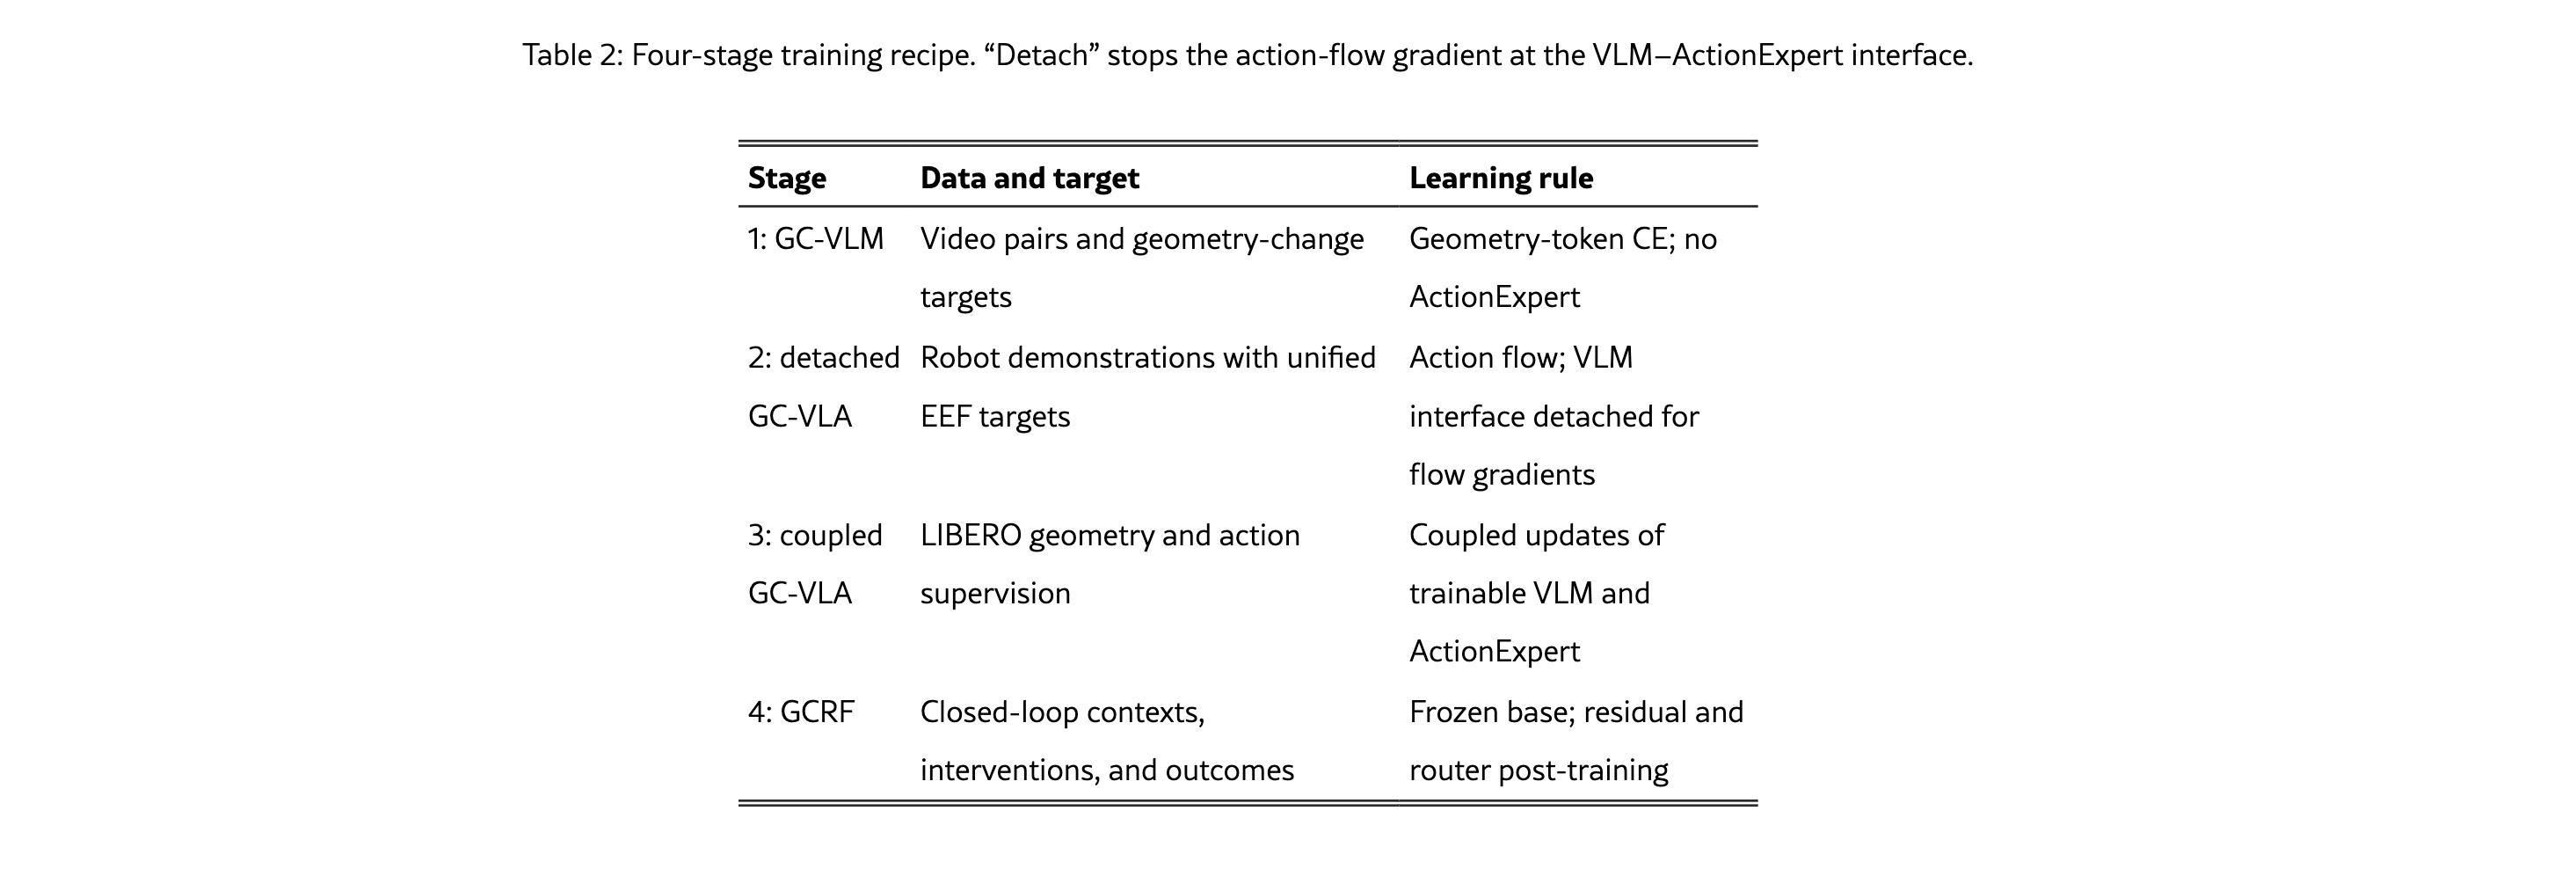
아주아주 신기하게도, 이 논문은 총 4가지 Stage로 트레이닝을 실시한다.
Stage 1 trains a geometry-change vision-language model (GC-VLM).
Stage 2 introduces a continuous ActionExpert and aligns it with robot actions while stopping action-flow gradients at the VLM interface.
Stage 3 enables these gradients to update the trainable VLM components jointly with the ActionExpert.
Stage 4 freezes GC-VLA and applies Geometry-Conditioned Residual Flow (GCRF), using a binary intervention router and a single bounded residual velocity policy learned from closed-loop feedback.
| Stage | 데이터 | Loss | 학습되는 것 |
|---|---|---|---|
| 1: GC-VLM | 영상 frame pair (사람 영상 포함) | GC token CE | GC-VLM만 (Action Expert 없음) |
| 2: detached | 로봇 demo (EEF action) | CE + λ·Flow Matching | 둘 다, 단 액션 gradient는 VLM에서 차단 |
| 3: coupled | LIBERO | CE + λ·Flow Matching | 둘 다, 액션 gradient도 VLM까지 흐름 |
| 4: GCRF | closed-loop rollout 성공/실패 | BCE + advantage | Residual policy, Router, Value head만 (나머지 Frozen) |
Stage1
GC-VLM is initialized from Molmo2-ER and trained on current–future frame pairs with offline geometry-change targets. Robot-action labels are not required, and no ActionExpert is used in this stage.
맨처음에 우리가 할 것은 GC-VLM을 학습시키는 일이다. 그리고 여기에 사용된 것이 바로, Molmo2-ER 이라는 pretrained model을 기반으로 학습을 시켰다고 밝히고 있다.
여기서 액션 라벨이 필요 없다는 게 핵심이다. → 그래서 사람 egocentric 영상(HoloAssist)도 여기에 넣을 수 있는 것.
Stage2
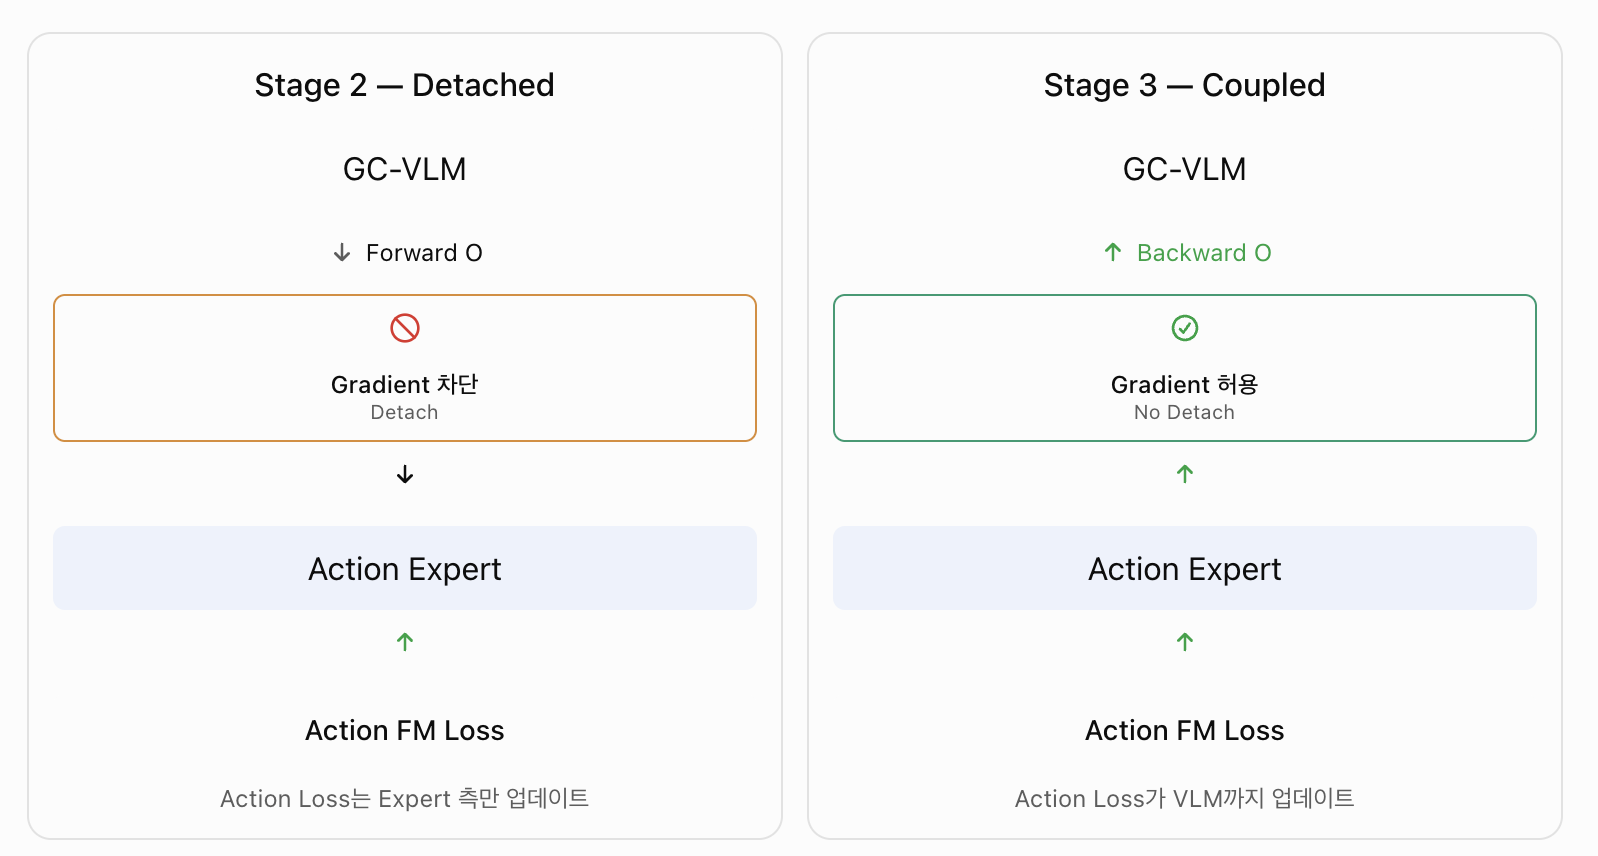
자 이제 Action Expert (Flow Matching 기반 continuous action model)를 붙여서 로봇 액션을 학습시키는데, 여기서 포인트는 gradient를 어디까지 흘려보내냐이다.
1
2
3
4
현재 관측 x_t -> GC-VLM -> hidden h_t
  ├─ GC head      -> GC token 예측      : L_CE (정답은 offline으로 만든 y_GC)
  └─ Action Expert(h_t, q_t) -> action chunk : L_FM (flow matching)
                    ↑ L_FM의 gradient는 여기서 차단 (stop-gradient), VLM으로 안 넘어감
즉 GC-VLM을 얼리는 게 아니다!! geometry loss로는 GC-VLM이 계속 학습되고, 액션 loss만 VLM 안으로 못 들어오게 막는 것이다. → 아직 덜 학습된 Action Expert가 Stage1에서 열심히 만든 geometry 표현을 망가뜨리지 않도록.
Stage3
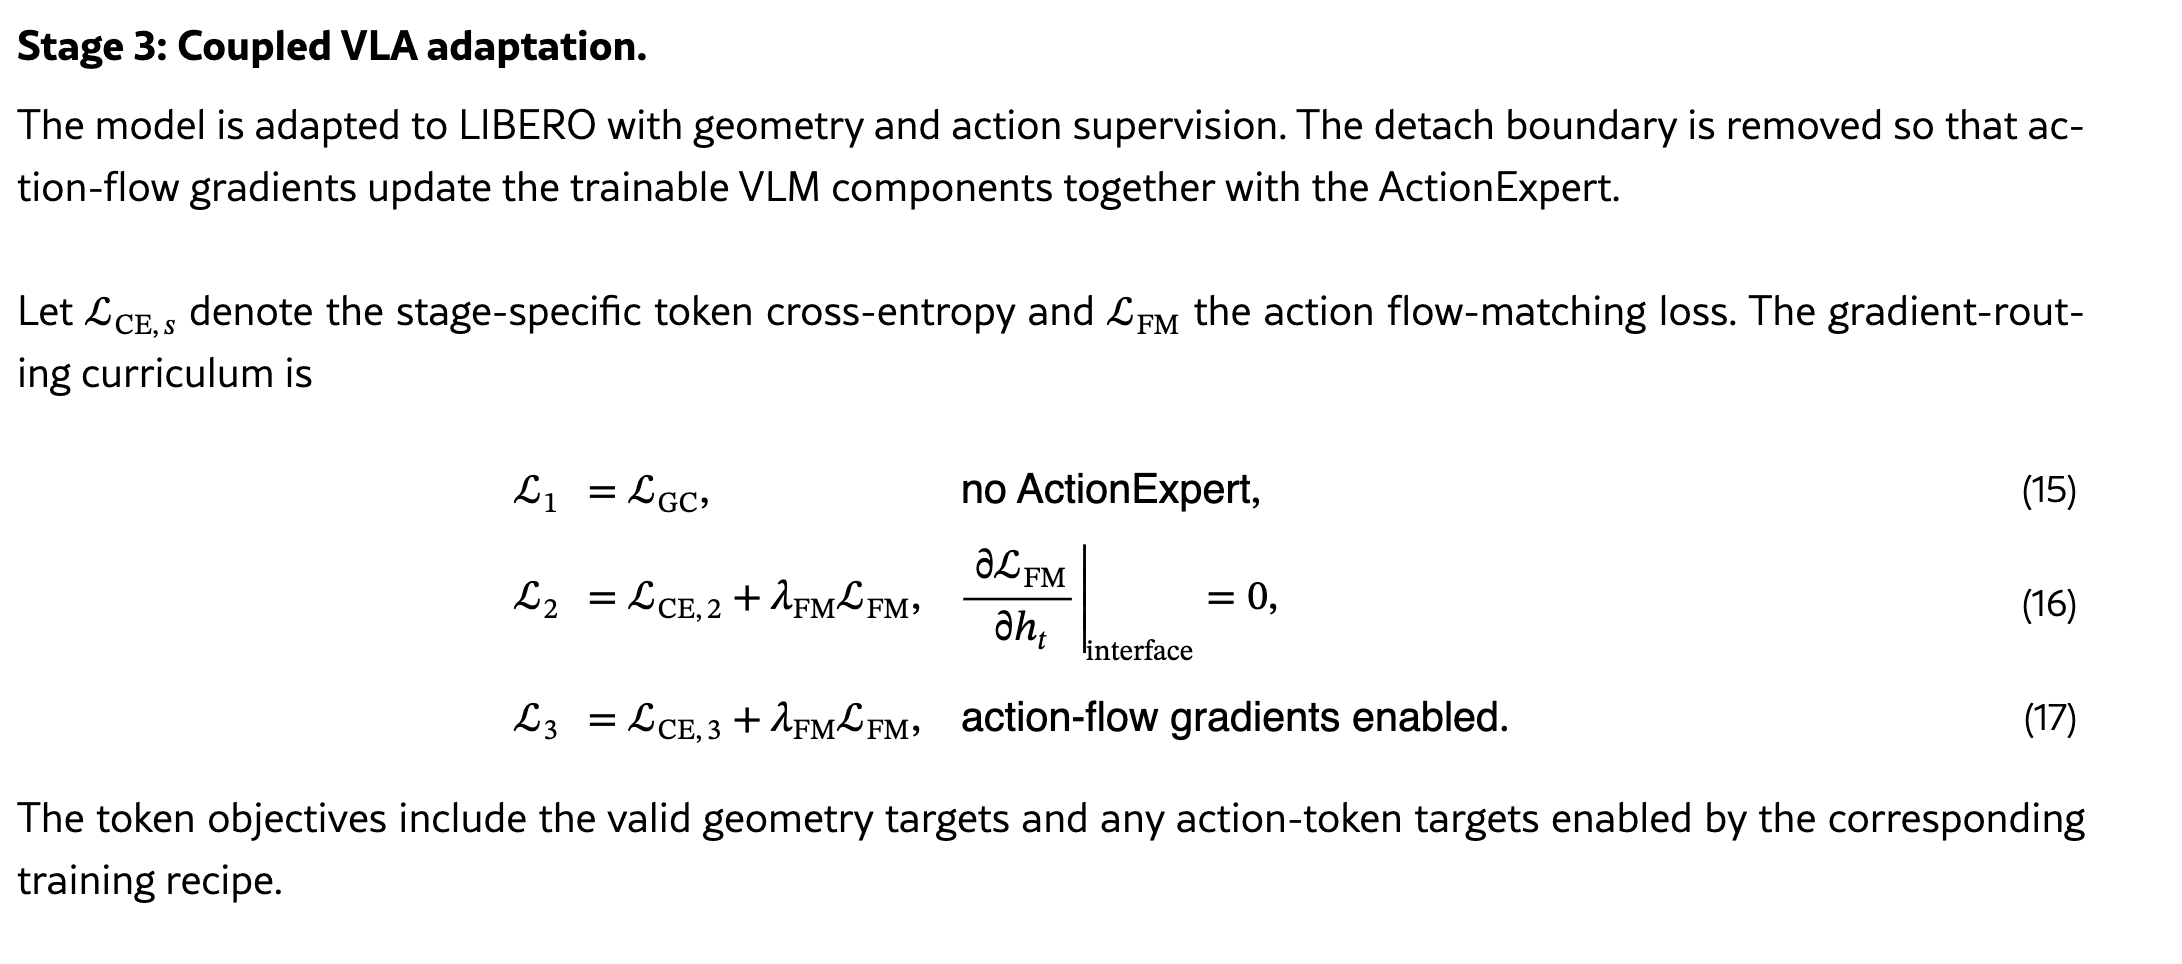
여기서 Stage3는 이제 재미있는 사실이 action expert의 가중치만 수정하는 것이 아니라 GC-VLM 또한 같이 수정한다는 것이다. 즉 Stage2에서 막아뒀던 액션 gradient를 풀어서 VLM까지 흘려보낸다.
\[\mathcal{L}_3 = \mathcal{L}_{CE} + \lambda_{FM}\,\mathcal{L}_{FM} \quad (\text{stop-gradient 해제})\]나만의 언어로 정리하면 → Stage2 = “VLM은 보는 법만 배우고, 액션은 옆에서 따로 배워라”, Stage3 = “이제 액션 잘하는 방향으로 보는 법도 같이 맞춰라”. 데이터는 LIBERO를 사용한다.
Stage4
Stage 4에서는 Stage 3까지 학습한 GC-VLA를 Frozen하고, Closed-loop 실행에서 얻은 성공/실패 피드백으로 별도의 Geometry-Conditioned Residual Flow(GCRF) 를 학습한다.
여기서 Velocity는 로봇 팔의 물리적 속도가 아니라, Action Expert가 Noise → Action Chunk를 생성하는 Flow Matching Velocity이다.
\[v_{final}=v_{base}+b_t\,\epsilon\tanh(z_t)\]- $v_{base}$: 기존 Frozen Action Expert의 Flow Velocity
- $z_t$: Residual Policy가 생성한 보정 벡터
- $b_t\in\{0,1\}$: 보정 적용 여부를 결정하는 Router
- $\epsilon\tanh(z_t)$: 크기가 제한된 보정 Velocity
즉 Action을 완성한 뒤 수정하는 것이 아니라, Flow Integration 과정에서 Velocity를 수정해 최종 Action Chunk를 바꾼다.
그리고 Residual Policy가 보는 입력이 바로 논문의 $c_t$이다. (기존 액션 velocity 32차원 + GC feature 32차원 + flow history 32차원 = 96차원) 여기 GC feature도 DA3/DINO를 다시 돌리는게 아니라 모델 내부 표현에서 가져온다.
어떻게 학습할까? (Loss)
Closed-loop 실행에서 Context $c$, Residual $z$, 성공/실패 $y\in\{0,1\}$를 수집한다.
- Value Head: $Q(c,z)$가 성공 여부를 예측하도록 Binary Cross Entropy(BCE) 로 학습한다. 성공한 Residual이 보정 없음(No-op)보다 높게 평가되도록 Margin도 사용한다.
- Residual Policy: $A(c,z)=Q(c,z)-Q(c,0)$를 Advantage로 정의하고, No-op보다 유리한 보정을 더 잘 생성하도록 학습한다.
- Intervention Router: Closed-loop 피드백을 사용해 언제 보정할지 학습한다.
논문은 Policy의 최적화 방향은 설명하지만 전체 Loss 계수와 Router의 정확한 Loss 식은 공개하지 않는다.
결론: Stage 4는 기존 VLA를 다시 학습하는 것이 아니라, 성공/실패 피드백으로 Action Flow의 생성 경로를 미세 보정하는 Post-training이다.
Data
Stage마다 쓰는 데이터가 다르다. 핵심만 보면,
| 데이터 | S1 | S2 | S3 | 역할 |
|---|---|---|---|---|
| HoloAssist | O | – | – | 사람 egocentric 영상, 액션 loss 없음 |
| ALOHA | O | – | – | 양팔 wrist 카메라 geometry pretraining |
| Hy-Embodied, HABIT, MolmoAct, Bimanual YAM, FMB/DROID100 | O | O | – | geometry + 액션 둘 다 |
| Austin Sailor / Berkeley UR5 / Berkeley Fanuc | – | O | – | 단일 팔 demo → EEF 액션으로 변환 |
| LIBERO | – | – | O | downstream 적응 + 평가 |
여기서 봐야할 포인트는 2가지이다.
- Stage1에만 들어가는 데이터(HoloAssist, ALOHA)가 있다. → 액션 라벨이 없어도 “장면이 어떻게 바뀌는가”는 배울 수 있으니까. 이게 embodiment-agnostic이라는 주장의 근거.
- 로봇마다 관절 구성이 다르니까 액션은 전부 EEF(End-effector, 로봇 손끝 기준) 좌표로 통일했다. 관절값이 아니라 손끝 위치/자세로 맞춰버리는 것.
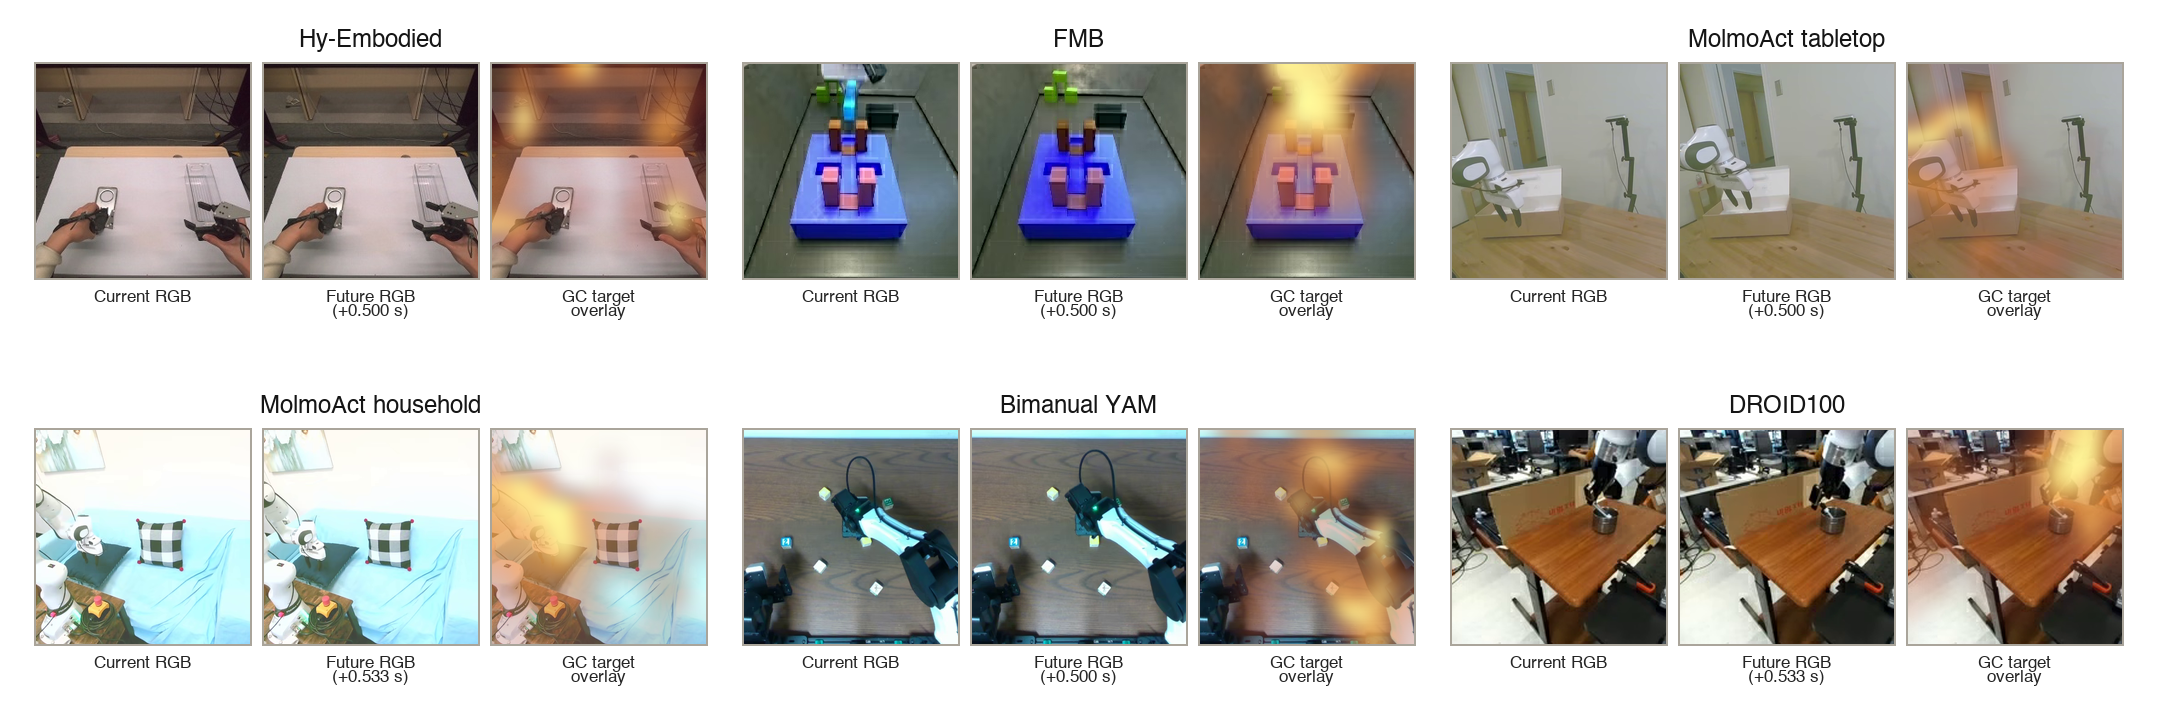
논문 원문 · Figure 3 데이터 소스별 geometry-change 정답 예시 (현재 RGB / 미래 RGB / GC overlay)
아쉬운 점은 몇 시간, 몇 episode를 썼는지 같은 데이터 규모는 공개하지 않았다는 것.
Inference
학습할때는 DA3, DINOv2, 미래 프레임까지 다 썼지만, 추론할때는 훨씬 단순하다.
1
2
3
4
5
입력: 언어 지시 + 현재 RGB (multi-view) + 로봇 state q_t
-> GC-VLM (DA3, DINOv2는 아예 안 돌림!!)
-> GeometryReader -> Action Expert
-> flow 10 step 적분 (+ Stage4 Router가 켜면 residual velocity 더함)
-> action chunk (LIBERO 기준 horizon 10)
즉 DA3, DINOv2는 정답 만드는 용도로만 쓰고 버리는 것이다. 추론 비용이 늘지 않는다는 게 장점.
(다만 latency나 몇 Hz로 도는지는 논문에 안 나와있다.)
Results
평가는 LIBERO (4개 suite × 10 task × 50 초기상태 = 2,000 rollout) 하나로만 했다.
| Method | Spatial | Object | Goal | Long | Avg |
|---|---|---|---|---|---|
| π0.5 | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| GR00T N1.7 | 97.7 | 97.5 | 98.5 | 94.4 | 97.0 |
| ABot-M0.5 | 100.0 | 99.8 | 99.4 | 98.4 | 99.4 |
| Online SRPO (RL) | 98.8 | 100.0 | 99.4 | 98.6 | 99.2 |
| HABILIS Brain 0 (+GCRF) | 99.4 | 100.0 | 99.4 | 99.4 | 99.55 |
- Stage1–3까지만 하면 95.20%, Stage4 GCRF를 붙이면 99.55% (+4.35%p). 특히 제일 어려운 LIBERO-Long에서 99.4로 제일 높다.
- 다만 비교군 중 99점대는 대부분 RL/closed-loop post-training을 한 모델들이라, GCRF 없는 95.20은 π0.5보다 낮다는 점은 같이 봐야한다.
Ablation (재밌는 것만)
- Geometry-change target vs 현재 depth만: 같은 조건에서 현재 depth만 토큰으로 쓰면 82.1%, head+wrist depth 변화량을 쓰면 86.1% (+4.0%p) → “지금 모양”보다 “어떻게 바뀌는가”가 액션에 더 유용하다는 근거.
- Residual을 어디에 넣을까: flow 10 step 전부에 나눠 넣으면 97.5%, 마지막 액션에 한방에 넣거나 첫 step에 몰아 넣으면 86.5% → 앞에서 말한 “Flow 과정에서 Velocity를 수정”하는 방식이 실제로 효과가 있다.
- GeometryReader를 빼도 82.5% → 80.0%로 통계적으로 유의미한 차이는 없었다. → 성능은 Reader보다는 backbone이 GC pretraining으로 배운 표현 쪽에서 오는 것 같다는게 논문의 해석.
LIBERO-PRO (perturbation 평가)
물체 위치를 바꾸거나, 지시를 바꾸는 등 흔들어놓은 LIBERO-PRO에서는 평균 51.09% 로 π0.5(53.35%)보다 살짝 낮다. 그래도 Task perturbation 축에서는 21.45%로 비교군 중 가장 높다. (π0.5는 0.8%)
→ 솔직하게, LIBERO 99.55%는 LIBERO 분포에 맞춰 post-training한 결과라는걸 감안하고 봐야 한다.
Future work & Company vision
논문에 Future work 섹션은 따로 없고, Limitations에서 스스로 인정하는 부분은 이렇다.
- 99.55%는 GC pretraining + LIBERO 위 closed-loop post-training을 합친 결과라서, pretraining 효과만 따로 떼어서 말할 수 없다.
- LIBERO-PRO 결과도 GCRF가 얼마나 기여했는지는 분리되지 않았다.
그리고 내가 보기에 다음에 꼭 보고싶은 것.
- 실제 로봇 결과. 지금은 시뮬레이션(LIBERO)만 있다.
- 사람 영상(HoloAssist)을 뺐을 때 얼마나 떨어지는지. embodiment-agnostic이 핵심 주장인데 이걸 직접 보여주는 ablation이 없다.
- 데이터 규모, 모델 전체 크기, latency 공개.
그래도 “액션 라벨 없이, 장면이 어떻게 바뀌는지를 먼저 배우고 → 그걸로 액션을 배운다”는 방향은 사람 영상을 대량으로 쓸 수 있는 길이라 아주 흥미롭다. 투모로로보틱스가 이걸 실제 로봇에서 어떻게 보여줄지 기대된다.