GR00T N1.7 Code Scratch - Part 1
NVIDIA GR00T N1.7 을 코드부터 직접 짜본다. 왜 GR00T 인지, LIBERO 데이터 열어보기, Qwen3-VL(Cosmos-Reason2) VLM backbone, AdaLN 을 쓰는 DiT action head, 그리고 GrootPolicy 의 masked MSE / flow target / attention mask 까지.
Introduction
지금까지 π0 스타일 VLA 를 직접 만들어서 PushT 66% 까지 왔다. 이번에는 NVIDIA 의 오픈 VLA GR00T 를 코드부터 뜯어보고, 내가 직접 짠 코드에 NVIDIA 사전학습 가중치를 끼워서 LIBERO 로 fine-tune 해보자.
Groot blog를 총 2가지 파트로 구성할 예정이다.
- part1 - 기본 모델 코드 구조
- part2 - Eval and Attention Mask
(nn.MultiheadAttention 안의 attention mask 는 별도 글 로 따로 뜯어봤다)
이번시간에 part1을 들어가보자.
일단 자세한 GROOT 아키텍쳐는 Huggingface 에 이미 올라와 있는 상황이다.
(nvidia/GR00T-N1.7-3B, 논문: GR00T N1 White Paper (arXiv 2503.14734))
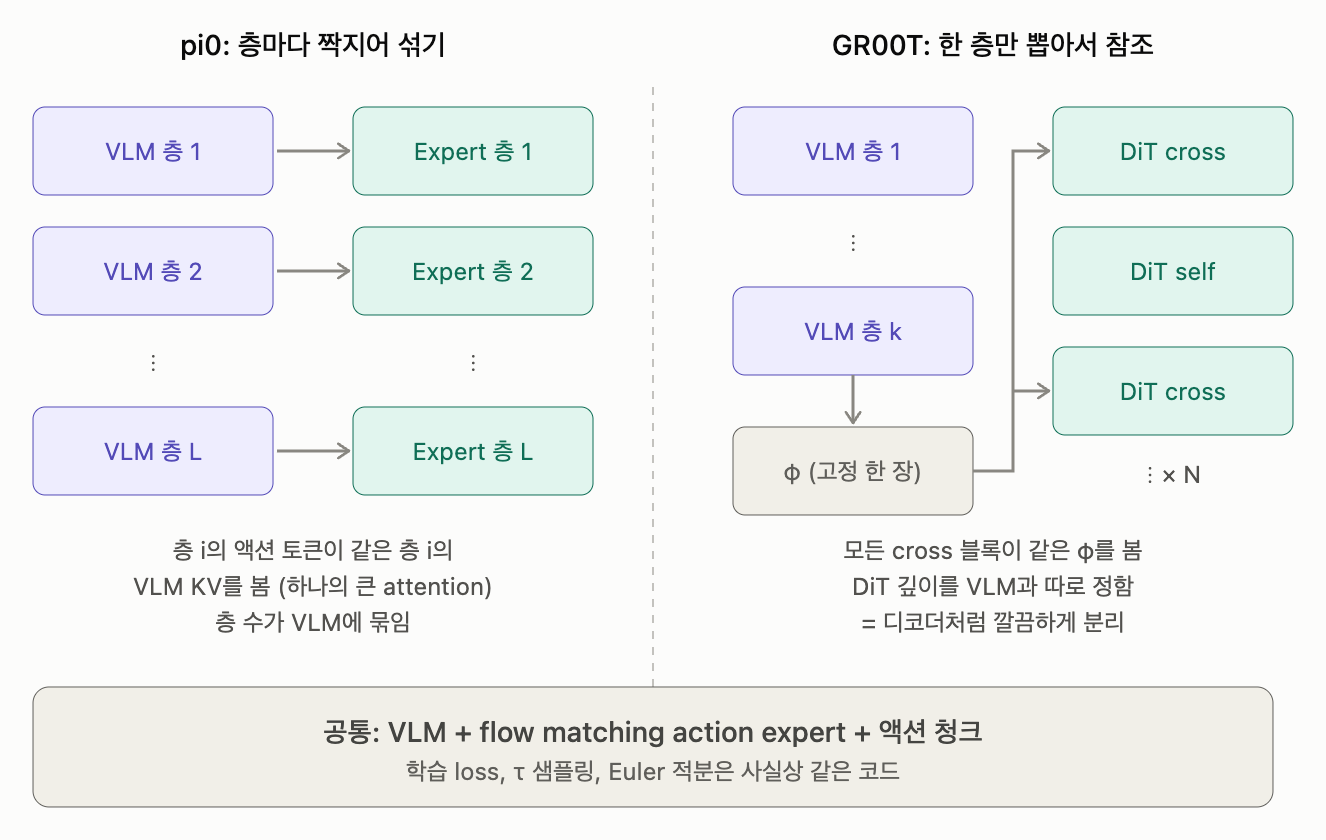
내부 구조를 간략하게 보면, 사실 우리가 지금까지 다루었던 SmolVLA, π0 이랑 거의 유사한 구조의 아키텍쳐를 지닌다. 다른 점은 그냥 VLM을 한번에 통과시키고 나온 hiddenstate를 그대로 모든 DiT layer에 K,V로 넣어준다. 물론 hiddenstate는 Cross-attention 일 때만 K, V 로 쓰이고, self attention 에서는 쓰이지 않는다.
그리고 DiT = Diffusion Transformer인데 사실상 우리가 원래 하던 Flow-matching과 거의 흡사하다. 바로 Velocity를 output하는 것이 결국 목표이며 이 방향은 denoising의 방향성과 크기를 결정한다.
Why Groot?
로봇 학습하시는 분들과 VLA 논문들을 보면 사실 굉장히 많은 사람들이 Groot 모델을 사용하고 계신다. 분명히 이유가 있을 것이다.
- Opensource + 상업적으로 사용도 가능하다. (Apache 2.0)
- GR00T는 양팔(bimanual), 반-휴머노이드, 그리고 대규모 휴머노이드 데이터를 섞어서 학습했고, checkpoint 도 같이 공개한다.
- Fine-tuning이 저렴하다. (VLM을 얼리기 때문)
- 오픈소스 시뮬레이션 프레임워크 Isaac Lab-Arena 와 LeRobot 에서 GR00T 를 바로 쓸 수 있다.
- Isaac Lab-Arena 란 이곳에서 우리는 데이터셋, 정책모델을 바꿔가면서 로봇학습을 진행시킬 수 있는 통합 플랫폼이다.
→ 결론적으로, 아키텍쳐 공개되어있고, 사전학습 가중치 있고, Lerobot 레퍼런스 구현까지 있다. 시작하기 딱좋은 패키지이다.
이게 굉장히 중요한건데, Groot를 만약에 처음부터 학습한다?? 그러면 Runpod GPU server를 대여해서 쓴다고 가정하자 그러면 정확히 얼마가 드냐면,
- Runpod의 H100 SXM Pod 공개 가격인 GPU 1장당 시간당 약 $2.69~$3.99
| 가정한 사용량 | GPU 대여료 |
|---|---|
| 총 1만 GPU시간 | 약 $2.7만~4만 |
| H100 1,000장 × 100시간 | 약 $26.9만~39.9만 |
| H100 1,000장 × 1만 시간 | 약 $2,690만~3,990만 |
개인이 감당할 수 있는 규모가 아니게 된다.;;
참고로 GR00T N1 논문을 보면 사전학습에 H100 최대 1,024 장, 약 5만 GPU시간을 썼다고 한다. 위 가격으로 계산하면 GPU 대여료만 약 13.5만~20만 달러다 (데이터 만드는 비용, 실패한 실험들은 빼고도).
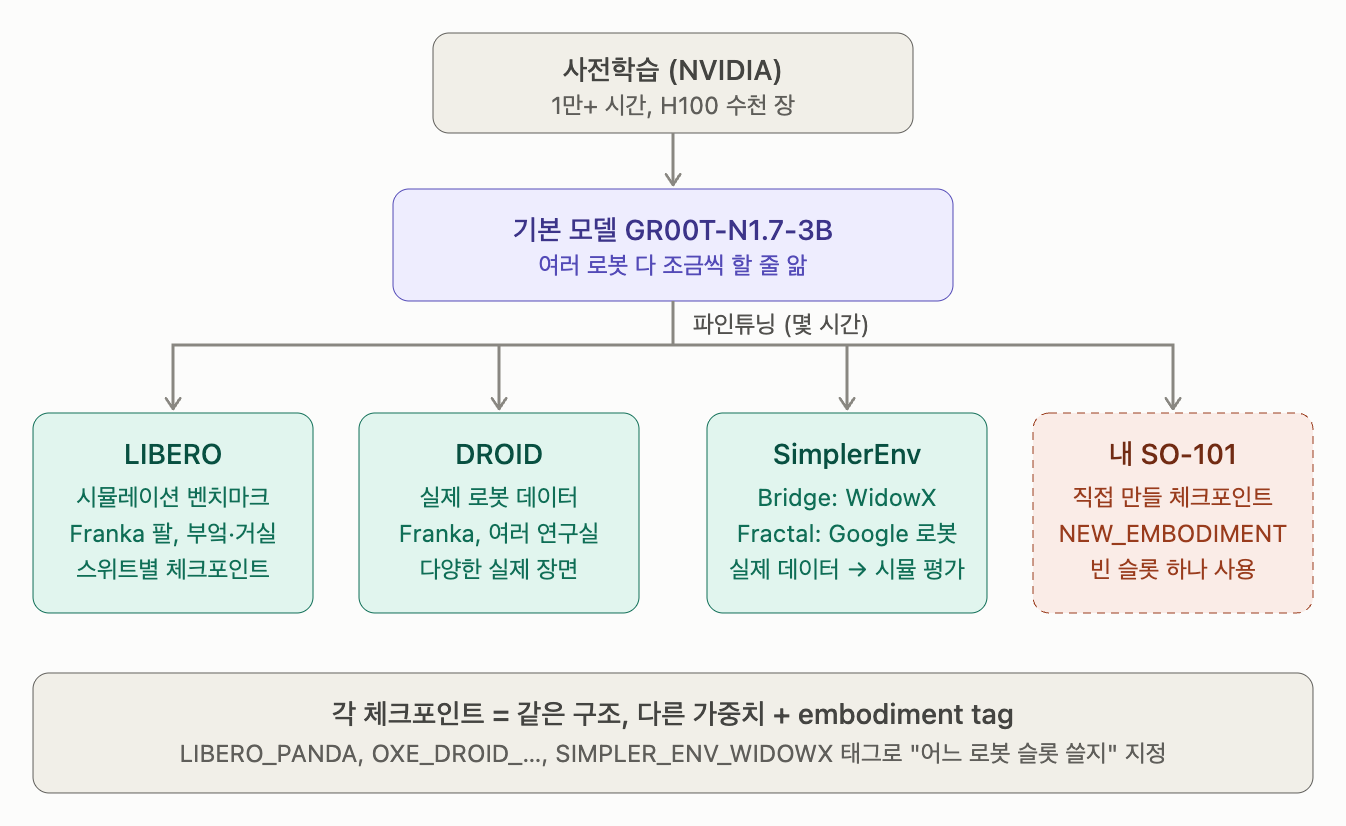
그리고 더해서 위 사진처럼 벤치마크 별로 fine-tune 된 Check point 들이 존재한다. 그러니까, LIBERO, DROID, SimplerEnv 라는 ‘시험지(벤치마크)’가 이미 사람들 사이에서 consensus 로 정리가 되어있는 상황이다. 그래서 이제 우리는 저걸로 테스트를 해서 학습이 잘 되었는지 구조는 잘 짜졌는지를 바로 점검 할 수 있게 된다. (이후에 직접 SO-101 로봇을 구매해서 테스트도 할 예정이다)
Updated version
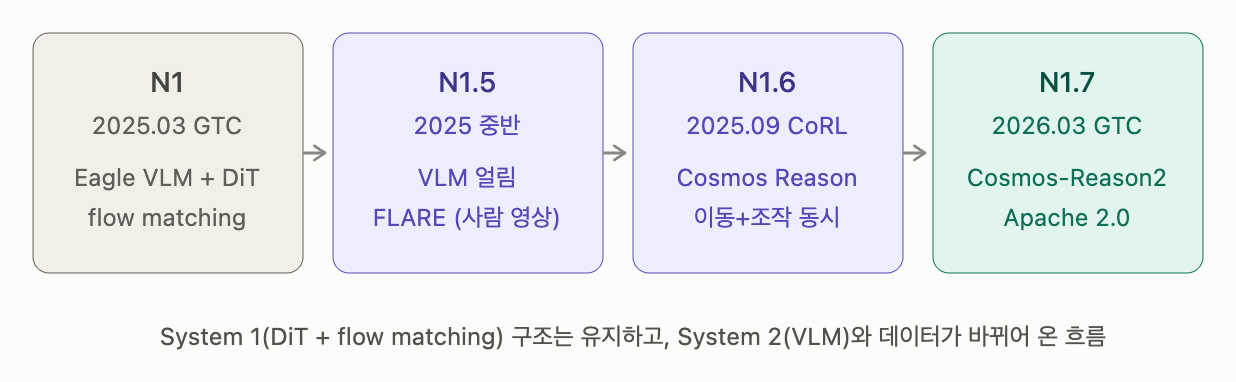
- N1 (2025.03): Eagle VLM + DiT action head + flow matching. “보고 이해하는 System 2 + 빠르게 움직이는 System 1” 구조가 여기서 시작됐다.
- N1.5 (2025 중반): VLM 을 사전학습·fine-tuning 모두에서 얼린다. Eagle 2.5 로 grounding 을 개선했고, flow matching loss 에 FLARE loss 를 더해 사람 1인칭 영상에서도 배울 수 있게 했다.
- N1.6 (2025.09, CoRL): 발표 때는 Cosmos Reason 통합(애매한 지시 → 단계별 계획)과 이동+조작 동시 수행을 내세웠다. 다만 공개 코드의 백본은 아직 Eagle 계열(
Eagle-Block2A-2B-v2)이다.- N1.7 (2026.03 GTC): VLM 백본을 Eagle → Cosmos-Reason2-2B (Qwen3-VL 구조) 로 교체했다. Apache 2.0 으로 상업 이용이 가능하고, LIBERO / DROID fine-tune 체크포인트도 같이 공개됐다.
→ 정리하면 action head(DiT + flow matching)는 거의 그대로이고, 바뀌어 온 건 VLM(System 2)과 데이터다.
Contents
- GR00T 전체 구조
- Data for training (LIBERO)
- Model architecture (3-1 VLM backbone / 3-2 Diffusion transformer / 3-3 Groot Policy)
(eval 과 attention mask 는 part2 에서)
1. GR00T 전체 구조
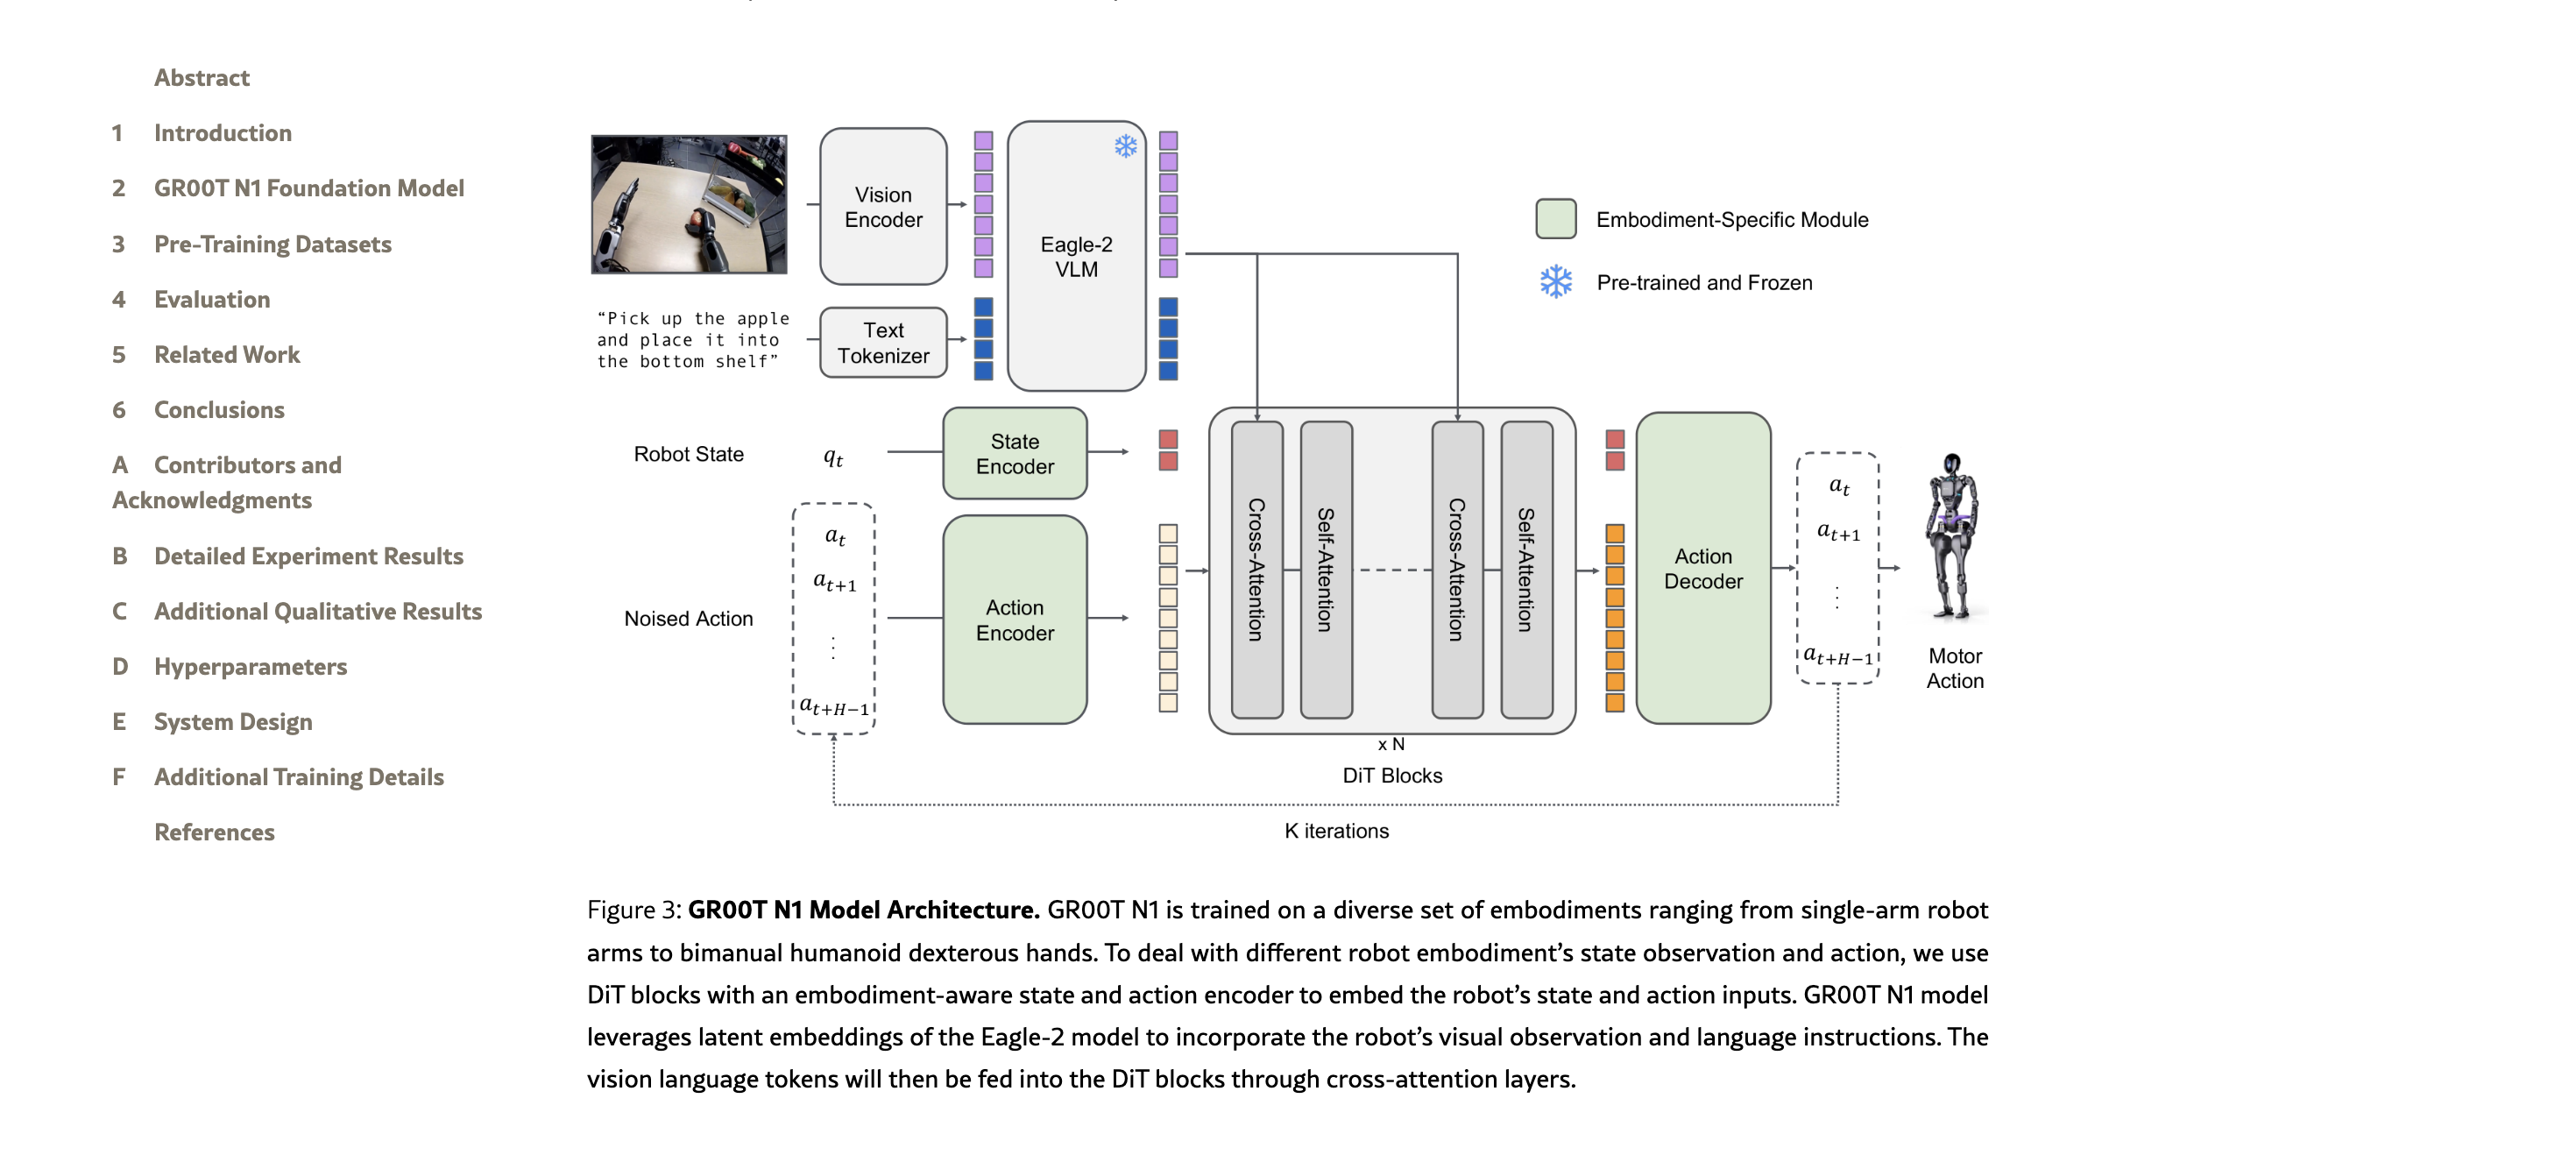
- Vision + text → VLM → Hidden state
- Action(noise) + State + (hidden state) → Attention → decoder → action
사실 위 구조는 VLM 과 Expert 이렇게 2가지이다. (VLA는 항상 두가지 모델로 구분). 여기서 이제 버전들 별로, VLM이 어떤 사전학습 모델이냐, Action decoder는 어떤 모델이냐, 이런 차이만 존재한다.
조금더 이해하기 쉽게 Schematic Block으로 살펴보면, 아래와 같다. (Version N1.7의 경우이다)
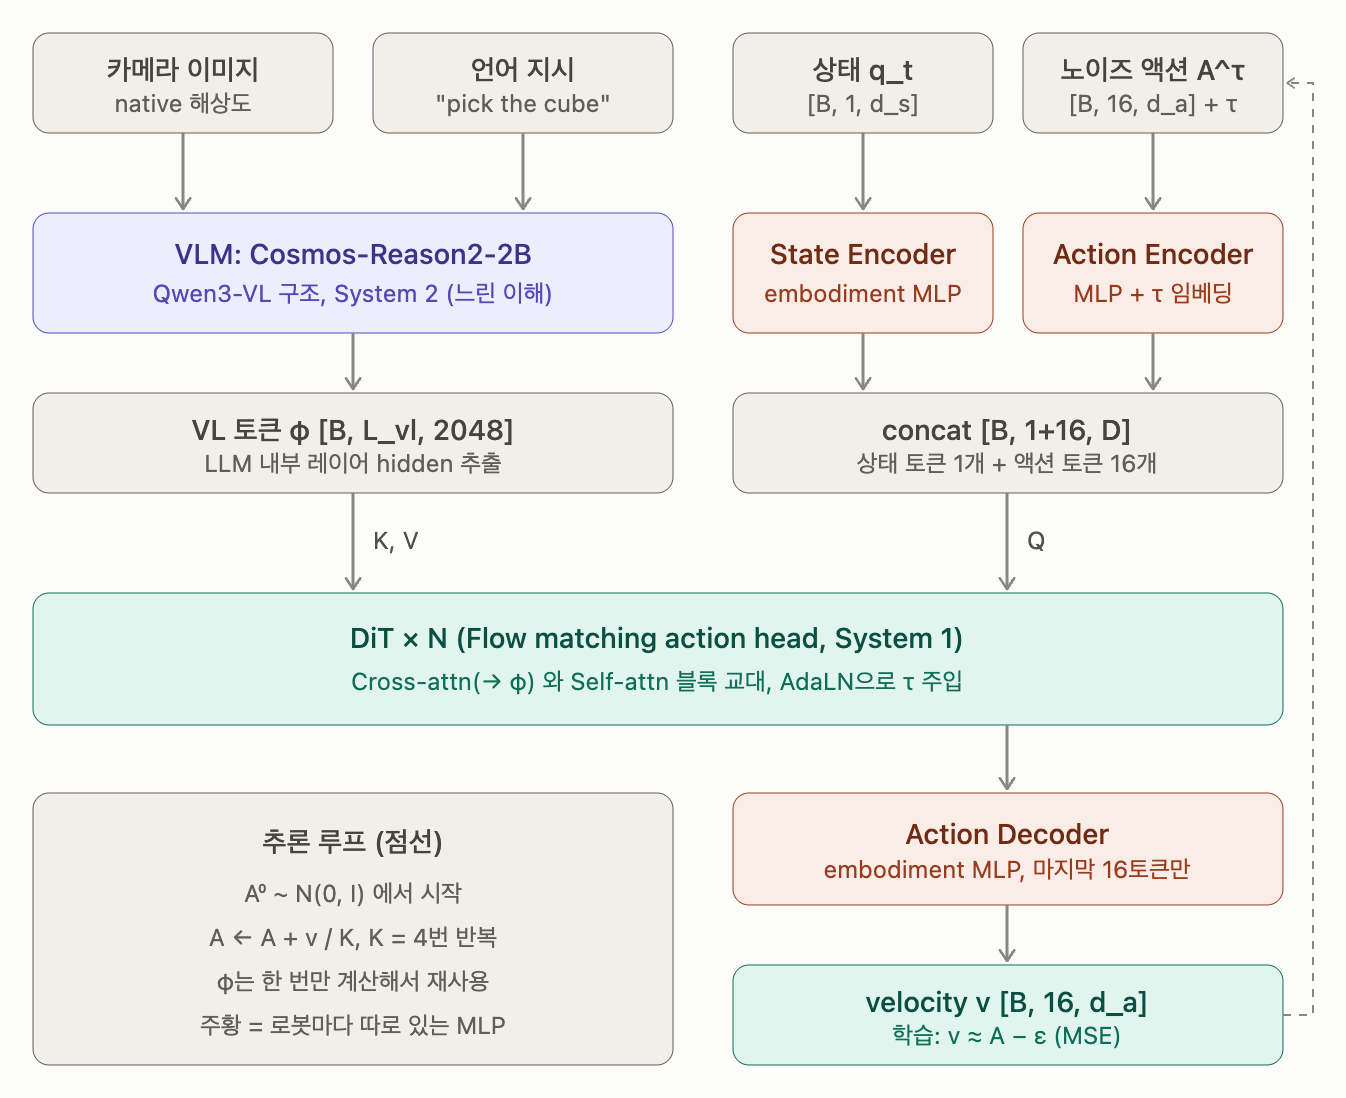
(기존 VLA와 다른 것은, State가 원래는 VLM으로 들어갔는데 Action쪽으로 들어간 것, 그리고 마지막에 action decoder가 따로 있는 것)
2. Data for training (LIBERO)
이번 데이터는 PushT 가 아니라 LIBERO 다. 7 축 로봇 팔 (Franka Panda) 이 부엌 / 책상에서 물건을 다루는 시뮬레이션 벤치마크이고, 요즘 VLA 논문들이 거의 다 여기서 점수를 낸다. GR00T 도 LIBERO 체크포인트를 공개해놨으니 비교하기 딱 좋다.
- 데이터: lerobot/libero (LeRobot 공식, 1.8GB)
먼저 데이터를 받자. PushT 때랑 똑같이 LeRobot 포맷 (parquet + mp4) 이다.
1
2
3
4
5
6
7
8
from huggingface_hub import snapshot_download
snapshot_download(repo_id="lerobot/libero", repo_type="dataset", local_dir="data/libero")

# data/libero/
# ├─ data/chunk-000/file-000 ~ 376.parquet           <- state, action, timestamp 숫자 표
# ├─ videos/observation.images.image/...             <- 3인칭 카메라 mp4
# ├─ videos/observation.images.image2/...            <- 손목 카메라 mp4
# └─ meta/info.json, stats.json, tasks.parquet, episodes/
2-1. 데이터 열어보기
영상 디코딩 없이 meta + parquet 숫자만 보는 data_checker.py 를 짜서 돌려봤다.
| 항목 | LIBERO | PushT (비교) |
|---|---|---|
| episode / frame | 1,693 / 273,465 | 206 / 25,650 |
| task | 40 (문장이 다 다름) | 1 |
| episode 길이 | 75 ~ 505 frame (중앙값 140) = 7.5 ~ 50.5 초 | - |
| 카메라 | 2 대 (3인칭 + 손목), 256×256 | 1 대, 96×96 |
| state / action | 8 / 7 | 2 / 2 |
| fps | 10 | 10 |
state 8 개 / action 7 개를 정확하게 열어보자.
1
2
3
4
5
6
7
8
9
# observation.state [8]  = 지금 로봇 손이 어디 있나
[0] eef_x, [1] eef_y, [2] eef_z     # 손끝 위치 (m)
[3] eef_ax, [4] eef_ay, [5] eef_az  # 손 회전 (axis-angle, rad)
[6] gripper_l, [7] gripper_r        # 손가락 두 개 위치 (0 ~ 0.042)

# action [7]  = 다음에 손을 얼마나 움직일까 (변화량)
[0] dx, [1] dy, [2] dz              # 손 이동량      -0.938 ~ 0.938
[3] dax, [4] day, [5] daz           # 손 회전량      -0.375 ~ 0.375
[6] gripper                         # 집기 명령      -1 (닫기) / +1 (열기)
- PushT 는 state 랑 action 이 둘 다 절대 좌표 (x, y) 였는데, LIBERO 의 action 은 변화량 (Δ) 이다. “지금 위치에서 이만큼 움직여”.
- gripper 는 사실상 -1 / +1 두 값뿐이다 (mean -0.05, std 0.999). 연속값처럼 예측하고, 실제로 쓸 때는 부호만 보면 된다.
task 40 개 = suite 4 개 × 10 개
LIBERO 는 태스크를 suite 라는 카테고리 4 개로 한 번 더 묶어준다. (long, goal, object and spatial)
| suite | task index | episode | 시험하는 것 | 예시 문장 |
|---|---|---|---|---|
| libero_10 (Long) | 0 ~ 9 | 379 | 두 동작 이어서 하기 | “turn on the stove and put the moka pot on it” |
| libero_goal | 10 ~ 19 | 428 | 같은 장면, 목표만 다름 | “open the top drawer and put the bowl inside” |
| libero_object | 20 ~ 29 | 454 | 같은 자리, 물건만 다름 | “pick up the ketchup and place it in the basket” |
| libero_spatial | 30 ~ 39 | 432 | 같은 검은 그릇, 위치만 다름 | “pick up the black bowl next to the cookie box and place it on the plate” |
(우리가 다루었던 PushT 는 문장이 1 개라서 LLM 이 사실상 놀았는데, 여기는 같은 장면에서도 문장에 따라 해야 할 일이 다르다. 언어가 진짜로 의미를 갖는 데이터다.)
2-2. delta_timestamps
PushT 때는 이미지 2 frame (0.1 초 전 + 지금) + action 16 개를 꺼냈었다. GR00T N1.7 은 조금 다르다.
1
2
3
4
5
6
7
8
def delta_timestamps(cfg: Config):
    '''지금 프레임의 사진/state + 앞으로 40칸(4초) action.'''
    return {
        "observation.images.image": [0.0],      # 3인칭 카메라, 지금만
        "observation.images.image2": [0.0],     # 손목 카메라, 지금만
        "observation.state": [0.0],
        "action": [i / cfg.fps for i in range(cfg.chunk_size)],   # 0.0, 0.1, ..., 3.9 (40 개)
    }
- 이미지는 지금 frame 하나만 쓴다. 대신 카메라가 2 대라서 모델 입력은
[B, 2, 3, 256, 256]이 된다. 여기서 2 는 시간이 아니라 카메라 두 대다 (PushT 때 2 는 시간축이었다. 헷갈리지 말자). - action chunk 는 40 칸 = 4 초. PushT (16 칸 = 1.6 초) 보다 훨씬 길게 한 번에 맞춘다.
- episode 끝에서 40 칸이 밖으로 나가면, PushT 때처럼 LeRobot 이
action_is_pad를 True 로 채워준다 → masked MSE 에서 뺀다.
카메라 두 개는 모델에 넣기 직전에 하나로 쌓는다.
1
2
3
4
5
6
7
@staticmethod
def stack_cameras(image, image2):
    '''카메라 두 대를 시간 축이 아니라 dim=1 에 붙인다. [B, 2, 3, H, W]'''
    if image.ndim == 5:          # delta_timestamps 때문에 생긴 시간 축 (길이 1) 제거
        image = image[:, -1]
        image2 = image2[:, -1]
    return torch.stack([image, image2], dim=1)
2-3. train / val split
PushT 는 episode 번호로 앞 190 개 / 뒤 16 개를 잘랐다. LIBERO 는 task 가 40 개라 그렇게 자르면 어떤 task 는 val 에만 있고 학습에는 없는 일이 생긴다. 그래서 task 마다 맨 끝 시연 5 개씩 을 val 로 뺐다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# lerobot/libero 가 스위트를 이어 붙인 순서. 태스크 10개씩.
SUITES = {
    "libero_10": (0, 10),
    "libero_goal": (10, 20),
    "libero_object": (20, 30),
    "libero_spatial": (30, 40),
}

def episode_split(suite: str | None, val_per_task: int):
    '''태스크마다 맨 끝 데모 val_per_task 개를 빼고 나머지를 학습.'''
    frames = pd.read_parquet(DATA_DIR / "data", columns=["episode_index", "task_index"])
    per_ep = frames.groupby("episode_index")["task_index"].first()   # episode -> task
    task_lo, task_hi = (0, 40) if suite is None else SUITES[suite]

    train_eps, val_eps = [], []
    for task_id, group in per_ep.groupby(per_ep):
        if not (task_lo <= int(task_id) < task_hi):
            continue
        eps = sorted(int(i) for i in group.index.tolist())
        k = min(val_per_task, max(1, len(eps) // 5))
        val_eps.extend(eps[-k:])
        train_eps.extend(eps[:-k])
    return train_eps, val_eps
suite를 주면 그 suite 의 task 10 개만 쓴다. 처음엔 NVIDIA 튜토리얼처럼 libero_spatial 하나로 시작할 예정.- 데이터셋 자체는 PushT 때랑 똑같이
LeRobotDataset에episodes=로 넘기면 끝.
1
2
3
4
train_ds = LeRobotDataset(
    "lerobot/libero", root=DATA_DIR, episodes=train_eps,
    delta_timestamps=delta, download_videos=False, video_backend="pyav",
)
2-4. Normalization
PushT 때랑 같다. meta/stats.json 의 mean / std 를 모델 안에 buffer 로 넣어두고, 학습 때 정규화 → 추론 때 역정규화.
1
2
3
4
self.register_buffer("state_mean", f32(stats["observation.state"]["mean"]))
self.register_buffer("state_std", f32(stats["observation.state"]["std"]).clamp(min=1e-6))
self.register_buffer("action_mean", f32(stats["action"]["mean"]))
self.register_buffer("action_std", f32(stats["action"]["std"]).clamp(min=1e-6))
clamp(min=1e-6): std 가 0 에 가까운 차원이 있으면 나눌 때 폭발하니까 안전장치.
이제 가장 중요한 모델 아키텍쳐로 넘어가자. 기존 아키텍쳐와 뭐가 다를까? 라는 의문을 가지고 들어가보자.
3. Model architecture
VLM
DiT
순서대로 살펴보자.
3-1. VLM backbone
사실 VLM부분은 심플하다.
imagepreprocessing +texttokenize → Prefix embeddings- Prefix Embeddings → VLM (vision encoder + LLM) →
hidden state(16 번째 layer 의 hidden 을 꺼내 씀)
인풋과 아웃풋이 직관적으로 확실하다.
시작전에 필요한 인스턴스들을 호출해주자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class Groot_VLM(torch.nn.Module):

    def __init__(self, config: Config):
        super().__init__()
        self.config = config

        from transformers import AutoTokenizer, Qwen3VLForConditionalGeneration, Qwen3VLProcessor
        self.tokenizer = AutoTokenizer.from_pretrained(config.tokenizer_name)
        self.tokenizer.padding_side = config.padding_side
        self.processor = Qwen3VLProcessor.from_pretrained(config.backbone_name)
        self.processor.tokenizer = self.tokenizer
        self.vlm = Qwen3VLForConditionalGeneration.from_pretrained(
            config.backbone_name, dtype=getattr(torch, config.dtype)
        )
        self.pad_mask = None
        self.att_1d_mask = None
We need tokenizer, processor, and VLM.
이제 사진을 preprocessing해주는 함수를 정의하자. 여기서 train이냐 아니냐에 따라서 처리방식이 달라지게 된다. 쉽게말하면 사진을 잘랐다가, 확대시키는 작업을 진행해준다. 왜?? 로봇이 물체의 위치를 외우는 일이 발생하기 때문이다. 매번 살짝 다른 위치를 잘라서 보여주면, 픽셀 자리를 통째로 외울 수가 없다.(학습과정에서만 진행한다, 평가는 불필요)
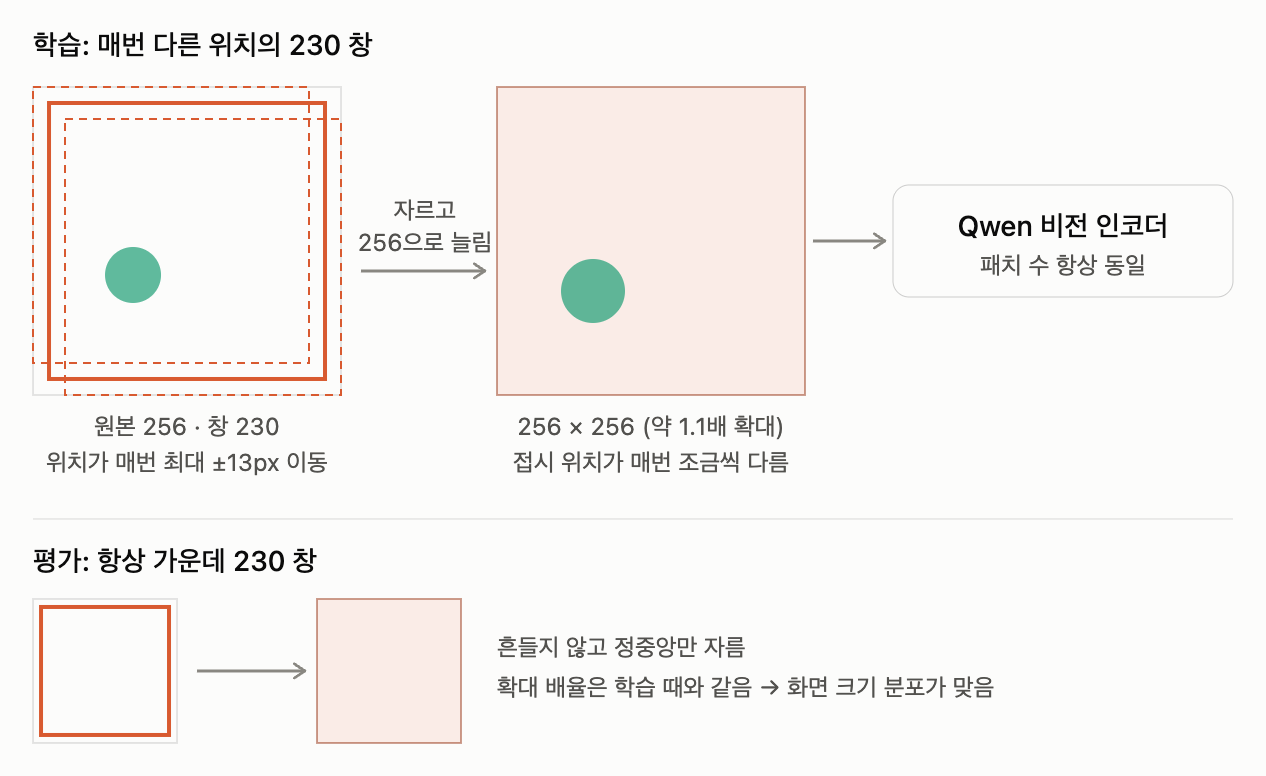
따라서, 우리는 이제 이를 코드로 구현해주자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def prepare_images(self, img, train=False):
    '''
        img: [B, 2, 3, 256, 256] float 0~1. 2 = 3인칭, 손목.
        230 창을 다시 256 으로 늘린다. 색은 여기서 안 건드린다.
        train=True  : 샘플마다 창 위치를 뽑고, 카메라 두 대는 그 위치를 같이 씀.
        train=False : 가운데. 평가.
        uint8 로 넘기면 Qwen 프로세서가 /255 와 CLIP mean/std 를 한다.
    '''
    B, n_cam, C, _, _ = img.shape
    flat = img.reshape(B * n_cam, C, img.shape[-2], img.shape[-1])
    target = self.config.image_size
    crop = self.config.image_crop_size
    if flat.shape[-2] != target or flat.shape[-1] != target:
        flat = F.interpolate(flat, size=(target, target), mode="bicubic", align_corners=False)
    views = flat.view(B, n_cam, C, target, target)
    slack = target - crop
    if train:
        tops = torch.randint(0, slack + 1, (B,))
        lefts = torch.randint(0, slack + 1, (B,))
    else:
        tops = torch.full((B,), slack // 2)
        lefts = torch.full((B,), slack // 2)

    windows = [
        views[b, :, :, int(tops[b]):int(tops[b]) + crop, int(lefts[b]):int(lefts[b]) + crop]
        for b in range(B)
    ]

    #Crop
    flat = torch.stack(windows).reshape(B * n_cam, C, crop, crop)

    #다시 확장.
    flat = F.interpolate(flat, size=(target, target), mode="bicubic", align_corners=False).clamp(0, 1)
    return (flat * 255).round().to(torch.uint8).view(B, n_cam, C, target, target)
이후에 이제 data에서 받은 text를 우리가 processor에 넘겨줘야하기 때문에, conversation 형태로 바꿔주자. (우리가 쓰는 Qwen3VLProcessor 의 형식에 맞게 바꿔줘야 한다.)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def build_conversation(self, text, n_cam):
     '''
     카메라 n_cam 장 + 문장 하나 -> Qwen 채팅 문자열.
     text: str 하나, 또는 배치 길이만큼의 list[str].
     '''
     if isinstance(text, str):
         text = [text]
     prompts = []
     for sentence in text:
         conversation = [{
             "role": "user",
             "content": [
                 *[{"type": "image"} for _ in range(n_cam)],
                 {"type": "text", "text": sentence},
             ],
         }]
         prompts.append(self.processor.apply_chat_template(
             conversation, tokenize=False, add_generation_prompt=False,
         ))
     return prompts
이후에 이제 Encoder를 통과시켜주자. (여기서 우리는 Qwen3VLForConditionalGeneration 을 사용한다. Cosmos-Reason2-2B 가 Qwen3-VL 구조라서 transformers 의 이 클래스로 그대로 불러올 수 있다)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
def forward(self, image, text, train=False):
     '''
     state 는 VLM 에 안 넣는다. 사진 두 장 + 문장만.
     반환 last_hidden_state 는 select_layer 번째 블록 hidden.
     '''

     # Image format change
     uint8 = self.prepare_images(image, train=train)
     B, n_cam = uint8.shape[:2]
     frames = [
         uint8[b, v].permute(1, 2, 0).cpu().numpy()
         for b in range(B)
         for v in range(n_cam)
     ]

     #text format change
     texts = self.build_conversation(text, n_cam)

     # Processor -> Embeddings for the encoder
     encoded = self.processor(text=texts, images=frames, padding=True, return_tensors="pt")

     # Move cpu -> gpu
     encoded = {k: v.to(self.vlm.device) for k, v in encoded.items() if torch.is_tensor(v)}

     # Pass the VLM
     out = self.vlm(**encoded, output_hidden_states=True, return_dict=True)
     hidden = out.hidden_states[self.config.select_layer]
     self.pad_mask = encoded["attention_mask"].bool()
     # N1.7 DiT 는 이 토큰 전체에 cross-attn. 예전 블록 마스크는 전부 한 블록.
     self.att_1d_mask = torch.zeros_like(self.pad_mask)
     out.last_hidden_state = hidden
     return out
결론적으로 preprocessing → embeddings → VLM → hidden state 이다.
3-2. Diffusion transformer (Action Expert)
다음은 이제 diffusion transformer이다. 여기서는 이제 사실 메인인 Action expert으로 넘어가자.
기본적으로 일단 재료들을 준비하자. 일단 projection이 굉장히 많이 일어난다. 여기서 재미있는게 Decoder dimension으로 모든 토큰들을 맞춰주는 작업을 하는 것이다.
- state
- action
- VLM hidden state
이 3가지를 모두 하나의 dim 의 차원으로 맞춰주는 작업을 진행한다. (정확히는 state, action 은 여기서 바로 dim 으로 바꾸고, VLM hidden 은 2048 그대로 두었다가 cross-attention 안의 W_k, W_v (kdim, vdim) 가 dim 으로 바꿔준다.) 여기서 이제 저 디멘션은 그러면 어떻게 결정이 되느냐??? Head dim * # of head로 결정이 되는것! (N1.7: 48 × 32 head = 1536)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Groot_DiT(torch.nn.Module):
    '''
    N1.7 action head.
    state 1토큰 + noisy action 을 붙이고, VLM hidden 을 cross-attn 으로 읽는다.
    출력은 action 칸의 속도 v_t. [B, horizon, action_dim]
    '''

    def __init__(self, config: Config):
        super().__init__()
        self.config = config
        dim = config.dit_heads * config.dit_head_dim
        self.dim = dim
        self.vlm_norm = torch.nn.LayerNorm(config.backbone_hidden)
        self.state_encoder = torch.nn.Sequential(
            torch.nn.Linear(config.state_dim, dim),
            torch.nn.SiLU(),
            torch.nn.Linear(dim, dim),
        )
        self.action_encoder = torch.nn.Linear(config.action_dim, dim)
        self.action_pos = torch.nn.Embedding(config.action_horizon, dim)
        self.blocks = torch.nn.ModuleList([
            _DiTBlock(dim, config.dit_heads, config.backbone_hidden, dim * 4)
            for _ in range(config.dit_layers)
        ])
        self.action_decoder = torch.nn.Sequential(
            torch.nn.Linear(dim, config.dit_hidden),
            torch.nn.SiLU(),
            torch.nn.Linear(config.dit_hidden, config.action_dim),
        )

    def _time_cond(self, t):
        return UtilsForVLA.sinusoidal_time_emb(t, self.dim)
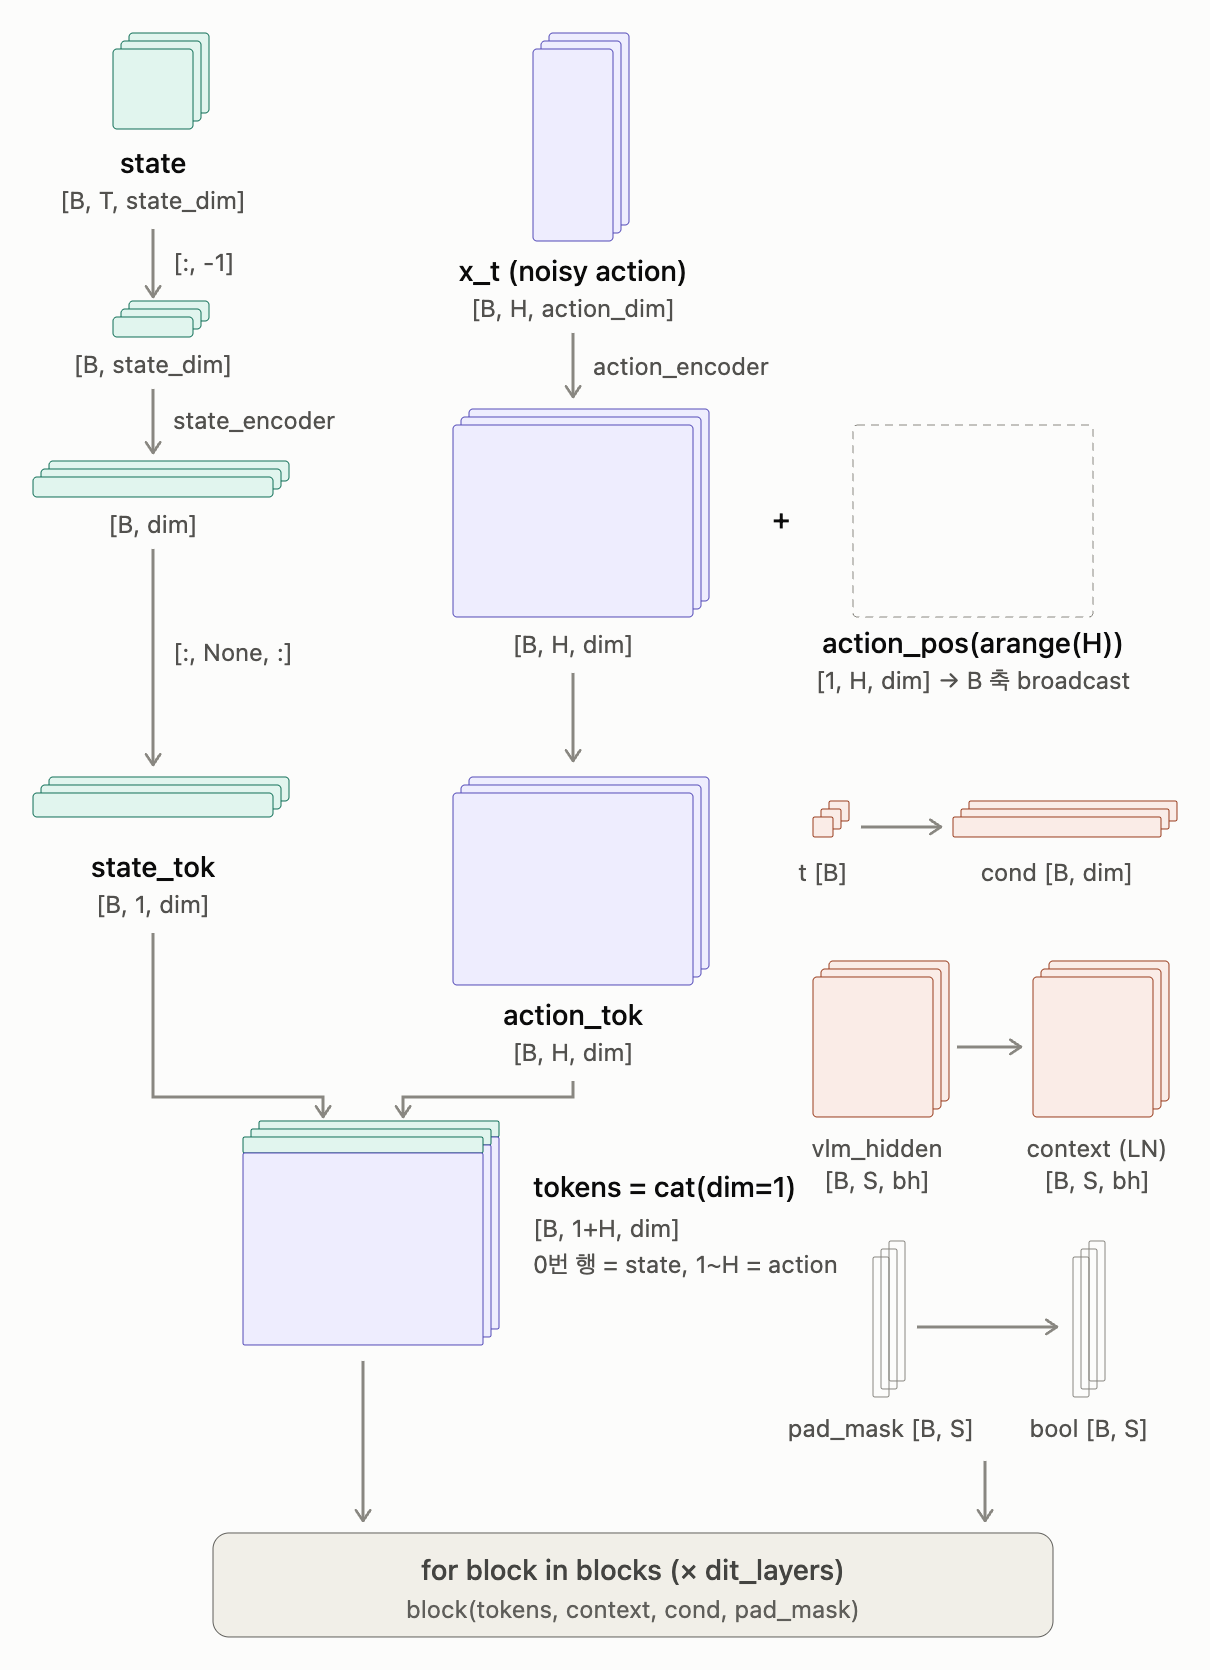
맨처음에 들어가는 요소들의 디멘션이 굉장히 많이 바뀌는게 결국에 Transformer attention 그것도 Multi Head attention을 하기 위해서이다.
여기서 action position은 action chunk 안에서 몇 번째 시점의 action 인지 (0 ~ 39) 에 대한 정보를 토큰에 넣어주고 (관절 번호가 아니다. 관절 7 개는 토큰 하나 안의 차원이다), 그리고 VLM hidden 또한 Normalization을 진행해준다.
이제 위에서 정의한 인스턴스들을 가지고, 정확한 흐름은 다음 코드를 통해서 알 수 있다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
def forward(self, state, x_t, t, vlm_hidden, pad_mask, att_1d_mask=None):
    if state.ndim == 3:
        state = state[:, -1]

    # state -> token. [B, 1, dim]
    state_tok = self.state_encoder(state)[:, None, :]

    # action -> token. [B, 40, 1536]  (chunk 40, dim = 32 head × 48)
    action_tok = self.action_encoder(x_t)

    # action token에 position encoding 을 더한다. [B, 40, 1536]
    pos = torch.arange(action_tok.shape[1], device=x_t.device)
    action_tok = action_tok + self.action_pos(pos)[None]

    # state와 action token을 연결한다. [B, 41, 1536]
    tokens = torch.cat([state_tok, action_tok], dim=1)

    # Denoising time condition 을 계산한다. [B, 1536]
    cond = self._time_cond(t)

    # VLM hidden 을 정규화한다. [B, seq_len, 2048]  (dim 으로 안 바꿈 -> cross-attn 의 kdim/vdim 이 2048)
    context = self.vlm_norm(vlm_hidden)
이후에 이제 Block을 여러개를 호출해주는데, 이제 블락을 하나씩 살펴보자.
1
2
3
4
5
6
7
# pad mask 를 bool 로 변환한다.
if pad_mask.dtype != torch.bool:
    pad_mask = pad_mask.bool()
for block in self.blocks:
    tokens = block(tokens, context, cond, pad_mask)

return self.action_decoder(tokens[:, 1:])
블락 한개의 구조는 다음과 같다. 생각보다 간단하다.
- Adaptive normalization (self)
- Self attention
- Adaptive normalization (cross)
- Cross attention
- Feed Forward Network (FFN)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
class _DiTBlock(torch.nn.Module):
    '''self-attn(state+action) 다음에 VLM hidden 으로 cross-attn. 시간은 AdaLN.'''

    def __init__(self, dim, heads, cross_dim, ffn_dim):
        super().__init__()
        self.adaln_self = _AdaLN(dim, dim)
        self.adaln_cross = _AdaLN(dim, dim)
        self.adaln_ff = _AdaLN(dim, dim)
        self.self_attn = torch.nn.MultiheadAttention(dim, heads, batch_first=True)
        self.cross_attn = torch.nn.MultiheadAttention(
            dim, heads, kdim=cross_dim, vdim=cross_dim, batch_first=True
        )
        self.ff = torch.nn.Sequential(
            torch.nn.Linear(dim, ffn_dim),
            torch.nn.GELU(),
            torch.nn.Linear(ffn_dim, dim),
        )

    def forward(self, x, context, cond, context_pad):
        '''
            context - Normed hidden state from VLM.
            cond    - Denoising time condition.
        '''
        h = self.adaln_self(x, cond)
        h = self.self_attn(h, h, h, need_weights=False)[0] + x
        y = self.adaln_cross(h, cond)
        y = self.cross_attn(
            y, context, context, key_padding_mask=~context_pad, need_weights=False
        )[0] + h
        return self.ff(self.adaln_ff(y, cond)) + y
이를 이제 한눈에 블락으로 살펴보면 다음과 같다. 여기선 눈에 띄는 것은,
1. adaptive normalization
2. time embedding
이렇게 2가지이다. (time embedding 자체는 전에도 있었지만, 그걸 넣는 방식이 이전에는 없었던 새로운 친구이기 때문이다)
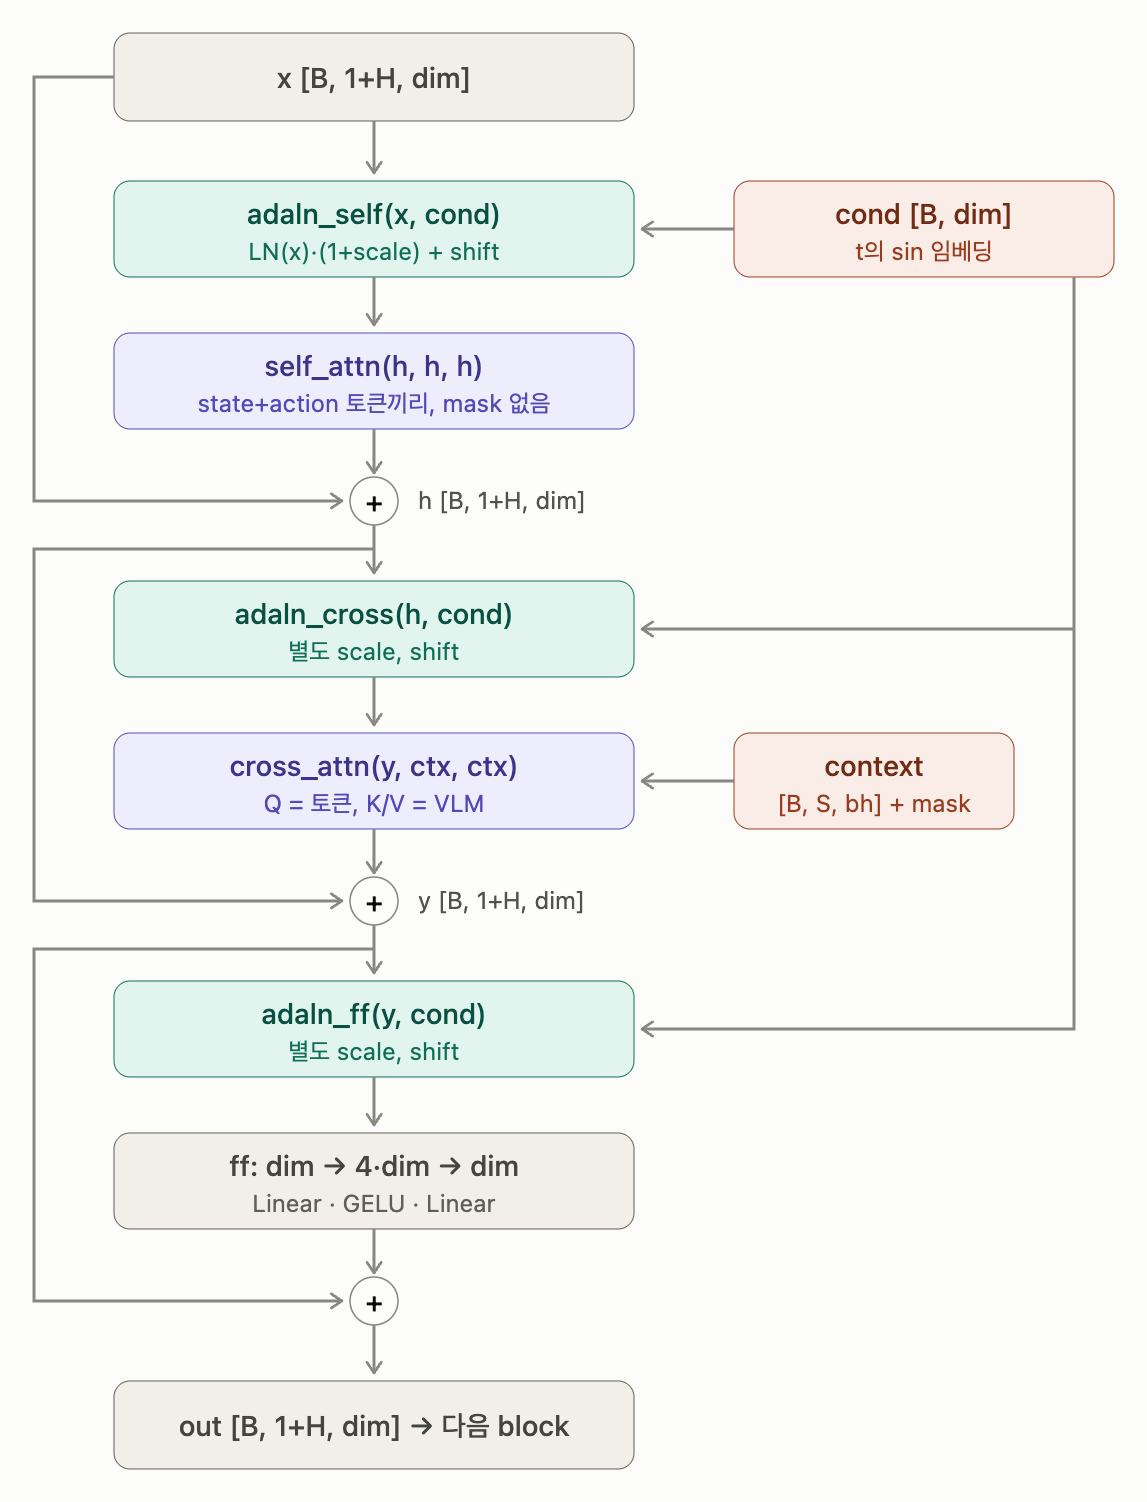
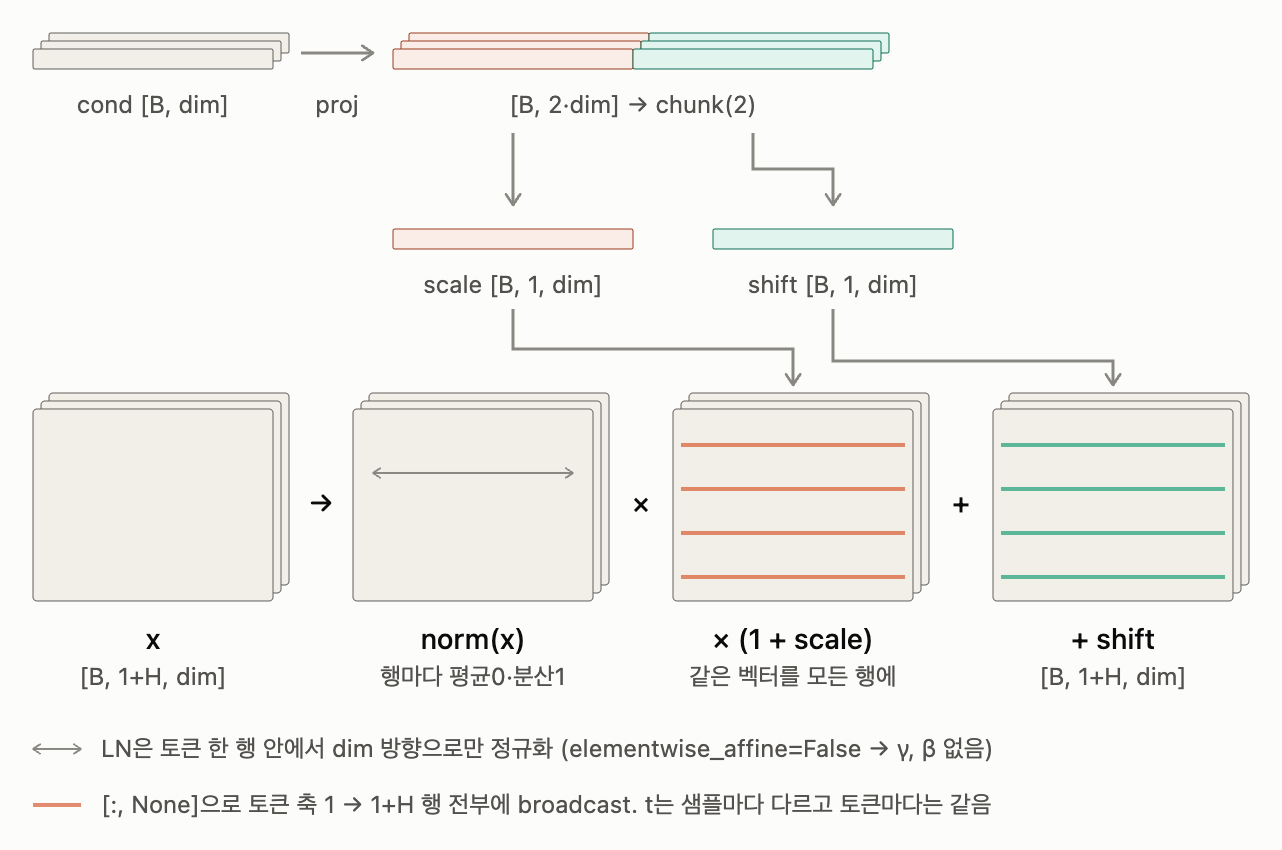
A. Adaptive Layer Normalization
여기서 원래는 시간을 그냥 텐서에 합쳤었는데 (cat + MLP), 이제는 시간을 Scale factor, shift factor 이렇게 2가지로 바꿔서 매 block 의 normalization 을 조절하는 데 사용한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class _AdaLN(torch.nn.Module):
    '''
        Adaptive Layer Normalization.
        같은 네트워크가 t에 따라 다른 속도를 내게 한다.
        x * (1 + scale) + shift , time -> scale, shift.
    '''
    def __init__(self, dim, cond_dim):
        super().__init__()
        self.norm = torch.nn.LayerNorm(dim, elementwise_affine=False)
        self.proj = torch.nn.Linear(cond_dim, dim * 2) #[B, dim] -> [B, dim*2]

    def forward(self, x, cond):
        scale, shift = self.proj(cond).chunk(2, dim=-1) #[B, 2 * dim] -> [B, dim], [B, dim]
        return self.norm(x) * (1 + scale[:, None]) + shift[:, None]
위 코드를 보기 쉽게 블락으로 표현하면 다음과 같다.
3-3. Overall Groot Policy model
이제 위 (인코더 + 디코더)를 합친 하나의 정책 모델을 정의하자.
위에서 정의한 두가지 VLM DiT 인스턴스를 정의해주고, 학습데이터를 사용할때 항상 기억할 것은 모델이 다루는 값은 정규화된 값이기 때문에 이 평균과 표준편차를 학습된 데이터들로부터 얻고 (meta json 파일에 저장되어있음) 이거를 가지고 이제 다시 원래 값으로 복원해주는 작업을 해줘야한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class GrootPolicy(torch.nn.Module):
    '''
    VLM 한 번 + DiT flow matching.
    학습 forward 는 masked MSE. sample_actions 는 t=1 noise 에서 Euler 로 action chunk.
    '''

    def __init__(self, config: Config, stats: dict):
        super().__init__()
        self.config = config
        self.backbone = Groot_VLM(config)
        self.dit = Groot_DiT(config)
        if not config.train_backbone:
            self.backbone.eval()
            for p in self.backbone.parameters():
                p.requires_grad_(False)

        f32 = lambda x: torch.tensor(x, dtype=torch.float32)
        self.register_buffer("state_mean", f32(stats["observation.state"]["mean"]))
        self.register_buffer("state_std", f32(stats["observation.state"]["std"]).clamp(min=1e-6))
        self.register_buffer("action_mean", f32(stats["action"]["mean"]))
        self.register_buffer("action_std", f32(stats["action"]["std"]).clamp(min=1e-6))
이제 forward method를 살펴보면, two image, state and an action 을 받고, 인코더를 먼저 통과시켜서 hidden state and pad_mask (prefix) 를 얻는다. 이후에 이제 velocity라는 미리정의된 메서드에다가 넣어주면 우리가 원하는 속도가 나오고 이를 이제 정답 u_t와 비교해서 MSE loss를 구하는 식으로 학습이 진행된다. (중간의 state_dropout 은 학습 때 일정 확률로 state 를 0 으로 지워버리는 것이다. 모델이 state 만 보고 action 을 베끼지 않고 사진과 문장도 보게 만드는 장치다.)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
def forward(self, batch):
    image = self.stack_cameras(batch["observation.images.image"], batch["observation.images.image2"])
    state = self.current_state(batch["observation.state"])
    action = batch["action"]
    state = (state - self.state_mean) / self.state_std
    action = (action - self.action_mean) / self.action_std
    if self.training and self.config.state_dropout > 0:
        drop = torch.rand(state.shape[0], device=state.device) < self.config.state_dropout
        state = state.masked_fill(drop[:, None], 0.0)

    hidden, pad_mask = self.encode(image, batch["task"], train=self.training)
    x_t, t, u_t = self.flow_targets(action)
    v_t = self.velocity(state, x_t, t, hidden, pad_mask)
    return self.masked_mse(v_t, u_t, batch["action_is_pad"])
자 여기서 이제 속도는 당연히 우리가 self.dit를 호출하면 얻도록 위에서 열심히 정의했었다.
1
2
3
4
def velocity(self, state, x_t, t, hidden, pad_mask):
    hidden = hidden.to(device=x_t.device, dtype=torch.float32)
    pad_mask = pad_mask.to(device=x_t.device)
    return self.dit(state, x_t, t, hidden, pad_mask)
여기서 디테일 한 부분들을 짚고 넘어가자.
- Masked MSE
- Flow targets
- Attention Mask
A. Masked MSE
핵심은 우리가 결국 정답지랑 예측값이랑 비교해서 Mean Squared Error를 구하는 것인데, Action이 사실 필요없는 값들이 들어있을 수도 있다. 예를들어서 [a1,a2,a3, None, None, None] 같은 값이 정답일 수 있다. 왜??? a3 다음에 episode 가 끝나서 미래 action 이 없기 때문이다. (LeRobot 이 마지막 값을 복사해서 길이를 맞추고 그 칸을 action_is_pad = True 로 표시해준다) 이런 경우를 위해서 action is pad 는 None 위치에 True가 저장되어있는 텐서이고, 그 부분은 MSE에서 제외되도록 해주는 메서드이다.
1
2
3
def masked_mse(self, v_t, u_t, action_is_pad):
    valid = (~action_is_pad)[..., None]
    return ((v_t - u_t) ** 2 * valid).sum() / (valid.sum() * self.config.action_dim)
B. Flow targets
Flow targets는 우리가 수도없이 들었었다. 그러니까, 우리가 action → u_t 속도장을 역으로 추정하는 방법이다.
- 임의의 노이즈 제작
- 시간을 랜덤하게 하나 선정
- 그 시간에서의 x_t 유도
- 그 시간에서의 u_t 유도
1
2
3
4
5
6
7
def flow_targets(self, action):
    noise = torch.randn_like(action)
    t = UtilsForVLA.sample_time_beta(action.shape[0], action.device)
    tt = t[:, None, None]
    x_t = tt * noise + (1 - tt) * action
    u_t = noise - action
    return x_t, t, u_t
지난시간에 자세하게 다루었으니 여기까지 서술하고 넘어가자.
C. Attention Mask
마스크는 가장 중요한 요소 중 하나이다. 결국에 우리가 학습을 할때, 어떤 정보가 어떤 정보를 참고하도록 attention을 설계했는지가 비록 블랙박스이지만 학습의 핵심이기 때문이다.
1
2
3
4
5
# 1. VLM encoder에서 pad mask 제작후 제출
hidden, pad_mask = self.encode(image, text, train=False)

# 2. 이후 Dit 로 투입
self.dit(state, x_t, t, hidden, pad_mask)
먼저 인코더에서는 토큰 패딩으로부터 우리가 attention mask를 구한다.
(가릴 부분이 토큰 패딩 뿐이기 때문이다)
1
2
3
4
5
6
7
8
class Groot_VLM(torch.nn.Module):
		...

		def forward(...):

				encoded = self.processor(text=texts, images=frames, padding=True, return_tensors="pt")
				...
				self.pad_mask = encoded["attention_mask"].bool()
우리의 VLM processor에서 자동으로 “attention_mask”라는 property에 저장이 되는게 킥이다.
이후에 이제 DiT 에서 context_pad 에 이 pad_mask 가 들어간다. pad_mask 는 진짜 토큰이 True 인데, nn.MultiheadAttention 의 key_padding_mask 는 반대로 True 가 ‘무시할 칸’ 이다. 그래서 ~context_pad 로 뒤집어서 padding 칸을 True 로 만들어 넣는다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class _DiTBlock(torch.nn.Module):
    '''self-attn(state+action) 다음에 VLM hidden 으로 cross-attn. 시간은 AdaLN.'''

		...

    def forward(self, x, context, cond, context_pad):

		    # Self attention에는 들어갈 게 없다. prefix가 안들어가니.

				# Cross attention 에는 투입.
        y = self.cross_attn(
            y, context, context, key_padding_mask=~context_pad, need_weights=False
        )[0] + h

        return self.ff(self.adaln_ff(y, cond)) + y
이제 이번시간에 attention은 torch 의 nn.MultiheadAttention 을 그대로 사용했기 때문에 그안에서 정확하게 어떻게 제작하는지는 이제 별도 글 (GR00T N1.7 Attention Mask) 에서 따로 다루도록 하겠다. (Self-attention의 경우에 어떻게 마스크가 생기고, Cross-attention에는 어떻게 마스크가 생기는지)
1
2
3
4
self.self_attn = torch.nn.MultiheadAttention(dim, heads, batch_first=True)
self.cross_attn = torch.nn.MultiheadAttention(
    dim, heads, kdim=cross_dim, vdim=cross_dim, batch_first=True
)
자 이제 모델 설계는 끝났고, 다음 블로그 part2 에서는 진짜 학습에 들어가자.
Summary
- 일단 아키텍쳐를 직접 구현을 해보았고 기존 SmolVLA, π0과 비교하면서 살펴보았다. 결국 VLA 는 항상 두 덩어리다. VLM (보고 이해) + action expert (움직임 생성). 버전마다 바뀌는 건 “어떤 VLM 이냐, action head 가 뭐냐” 뿐.
- 그 결과, VLM hiddenstate 가 expert 의 K, V 로 들어가는 방식이 다른 것이 특징이다.
- π₀ / 내 코드: VLM 과 expert 가 layer 마다 KV 를 공유 (A 방식)
- GR00T: VLM 을 한 번만 통과시켜서 16 번째 layer hidden 하나를 꺼내고, 그걸 DiT 의 모든 cross-attention 에 K, V 로 넣는다. self-attention 에는 안 들어간다.
- 그리고 Time embedding이 Adaptive Layer Norm을 활용해서 정보가 들어가는 것도 특징. 예전엔 action 토큰에 time embedding 을 붙였는데 (cat + MLP), 이제는 t 를 scale / shift 로 바꿔서 매 block 의 normalization 을 조절한다.
- state 가 VLM 이 아니라 action 쪽 (DiT) 으로 들어간다. VLM 은 사진 + 문장만 본다.
- state / action / VLM hidden 을 전부 하나의 차원 (1536 = 32 head × 48) 으로 맞춘다. 결국 attention 을 하기 위해서. (VLM hidden 은 cross-attention 안의 W_k, W_v 가 2048 → 1536 으로 바꿔준다)
- flow matching 자체 (Beta 로 t 뽑기, x_t, u_t, masked MSE) 는 내 코드랑 똑같다. GR00T 도 N1 → N1.7 동안 action head 는 거의 그대로고, 바뀐 건 VLM 과 데이터.
- 데이터는 LIBERO. task 40 개라 언어가 진짜 의미를 가진다.
[B, 2, ...]의 2 는 시간이 아니라 카메라 두 대, chunk 는 40 칸 (4 초), action 은 절대좌표가 아니라 변화량. - 처음부터 학습하면 H100 천 장 단위 규모라 개인은 불가능 → VLM 은 얼리고 action head 만 맞추는 fine-tuning 이 현실적인 길이다.
- 다음: part2 LIBERO eval + attention mask, 그리고 별도 글 에서
nn.MultiheadAttention안의 attention mask 직접 뜯어보기.