VLA - Recent Models Review
action 을 토큰으로 낼까, 연속값으로 낼까. OpenVLA, OpenVLA-OFT, π0, π0-FAST 4 개 모델을 내가 만든 π0 스타일 VLA 코드 기준으로, 각 모델이 어디를 어떻게 바꿨는지 정리한다.
Introduction
지금까지 π0 스타일 VLA (VLM prefix + flow matching action expert) 를 직접 만들어서 PushT 66% 까지 왔다. 이제 요즘 모델들 (WAM 등) 로 넘어가기 전에, VLA 설계에서 제일 큰 갈림길 하나를 먼저 정리하고 가자.
action 을 어떻게 내보낼까? → 글자처럼 토큰으로 (이산) vs 숫자 그대로 연속값으로
이번 글에서 볼 모델 4 개는 전부 이 질문에 대한 서로 다른 답이다.
| 모델 | 나온 시점 | action 표현 | action 을 내는 방식 | 논문 |
|---|---|---|---|---|
| OpenVLA | 2024.06 | 토큰 (차원마다 256 bin) | LLM 이 글자처럼 하나씩 생성 (autoregressive) | arXiv 2406.09246 |
| OpenVLA-OFT | 2025.02 | 연속값 | chunk 전체를 한 번에 (parallel) + MLP 회귀 (L1) | arXiv 2502.19645 |
| π0 | 2024.10 | 연속값 | action expert + flow matching (noise → action, 10 step) | arXiv 2410.24164 |
| π0-FAST | 2025.01 | 토큰 (chunk 를 주파수 변환 후 압축) | LLM 이 생성 (autoregressive) | arXiv 2501.09747 |
기준은 내가 만든 코드 다. 각 모델이 내 코드에서 어디를 어떻게 바꾼 것인지로 정리해보자. 내 코드의 핵심은 이 두 군데다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# Training
# 내 코드 (= π0 방식) 학습: 정답 action 에 noise 섞고 -> expert 가 속도 예측 -> MSE
x_t = t * noise + (1 - t) * action                    # [B, 16, 2]
u_t = noise - action                                  # 정답 속도
v_t = self.expert(x_t, t, cache, ...)                 # expert 가 예측한 속도
loss = ((v_t - u_t) ** 2 * valid).sum() / ...         # 연속값 회귀 (MSE)


# Inference
# 내 코드 추론: noise 에서 시작해서 Euler 10 step
x_t = torch.randn(B, 16, 2)
for _ in range(10):
    x_t = x_t + dt * self.expert(x_t, t, cache, ...)
    t = t + dt
1. OpenVLA — action 을 “글자” 로
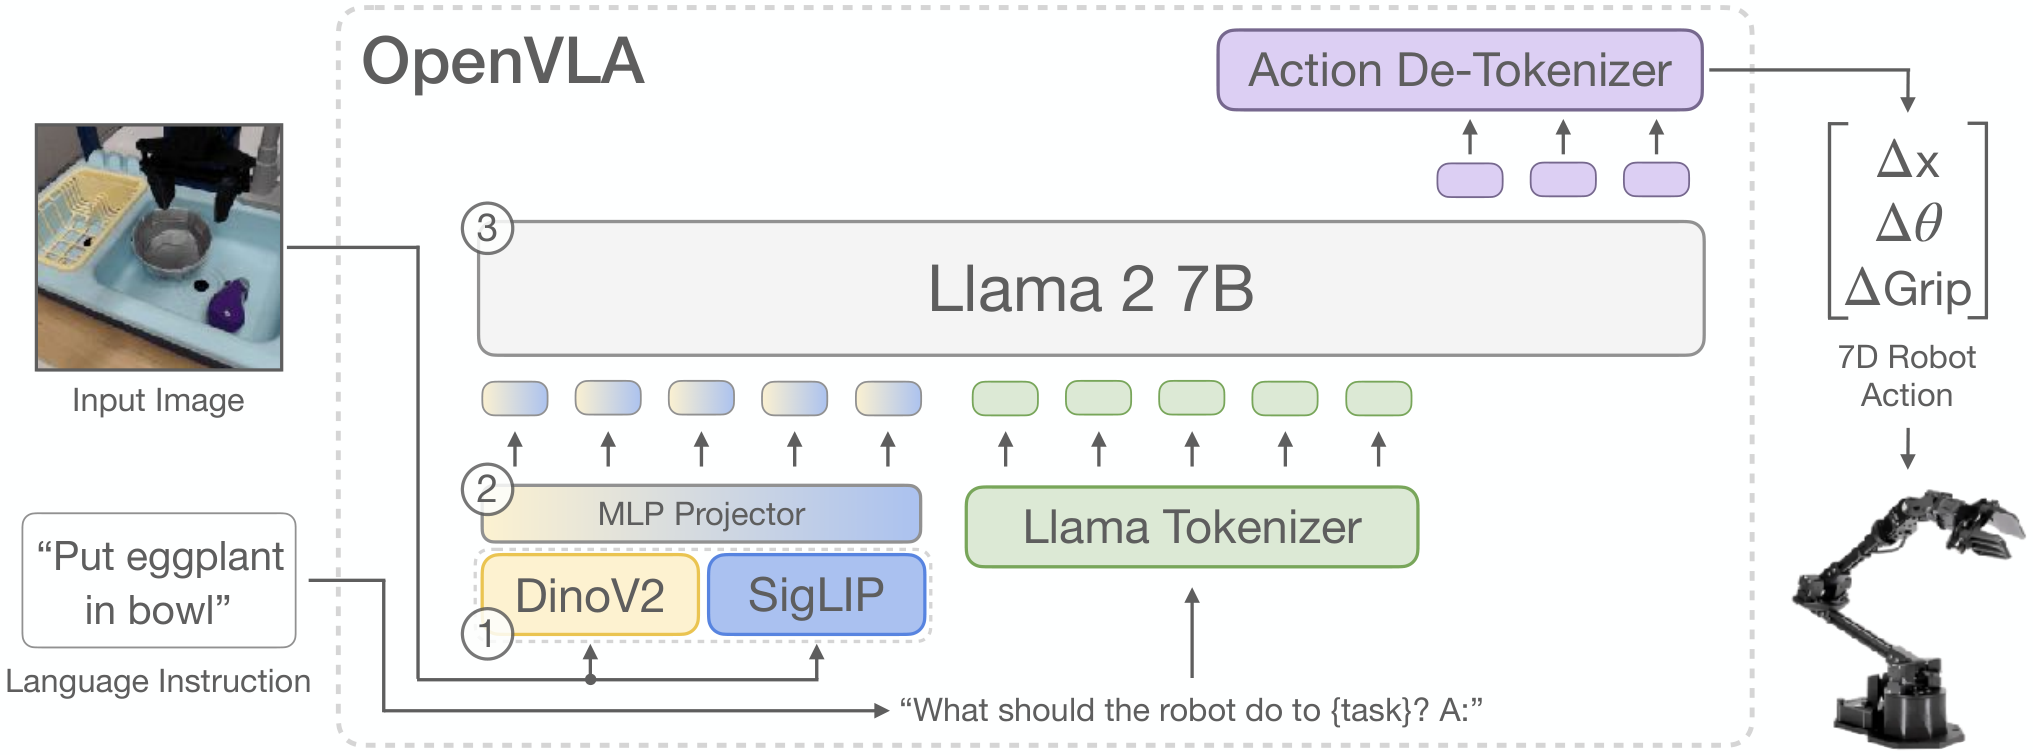
출처: Kim et al., “OpenVLA: An Open-Source Vision-Language-Action Model”, Fig. 2 (arXiv 2406.09246, CC BY 4.0)
- 7B. Prismatic VLM 기반 (vision: DINOv2 + SigLIP 두 개를 합친 encoder, LLM: Llama 2 7B)
- Open X-Embodiment 의 로봇 시연 약 97 만 개로 학습했다.
- action expert 가 없다. LLM 하나가 텍스트처럼 action 을 그대로 생성한다.
핵심 아이디어: action 을 bin 으로 쪼개서 단어로 만든다
- action 7 차원 (xyz 이동 3 + 회전 3 + gripper 1) 각각을 256 칸 (bin) 으로 나눈다. 칸 범위는 데이터의 1% ~ 99% 분위수 (극단값 무시).
- 각 칸 번호를 Llama 단어장에서 거의 안 쓰는 단어 256 개에 덮어씌운다. → action 1 개 = 토큰 7 개.
- 학습은 그냥 LLM 다음 토큰 맞히기 (cross-entropy). VLM 때 캡션 / 답변 학습이랑 완전히 똑같다.
!!!내 코드에서 바뀌는 곳
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# [OpenVLA] expert / flow matching 이 통째로 사라지고, VLM 의 lm_head 가 action 까지 낸다

# 1. 연속 action -> bin 번호 -> 토큰 id  (Dataset 쪽 전처리)
lo, hi = q01, q99                                         # 데이터 분위수 (차원별)
bins = ((action.clamp(lo, hi) - lo) / (hi - lo) * 255).round().long()   # [B, 7]  0~255
action_ids = vocab_size - 256 + bins                       # 단어장 맨 끝 256 개를 action 용으로

# 2. 학습: VLM 때 labels 만든 것처럼 action 토큰에만 loss
input_ids = cat([prompt_ids, action_ids])                  # [이미지 | 지시문 | action 7 토큰]
labels    = cat([-100 * ones_like(prompt_ids), action_ids])
loss = self.lm(inputs_embeds=..., labels=labels).loss      # cross-entropy (MSE 아님!)

# 3. 추론: generate 로 토큰 7 개 생성 -> bin 중앙값으로 되돌림
ids = generate(prefix, max_new_tokens=7)                   # 7 번 forward (KV cache)
action = lo + (ids - (vocab_size - 256)) / 255 * (hi - lo) # [7]  chunk 아님, 딱 1 step
| 내 코드 (π0 방식) | OpenVLA | |
|---|---|---|
| action 표현 | 연속값 | 256 bin 토큰 (정밀도에 한계) |
| loss | MSE (속도) | cross-entropy (다음 토큰) |
| 한 번 예측 | chunk 16 개 | 1 step (토큰 7 개) |
| 추론 | expert 10 번 (cache 고정) | LLM 7 번 (토큰마다 1 번) |
- 장점: VLM 구조를 그대로 쓴다. 새로 만들 게 거의 없다.
- 단점: 256 칸이라 정밀도에 한계. chunk 가 없어서 느리고 (논문 기준 약 6Hz) 동작이 떨린다. LIBERO 평균 약 76.5%.
2. OpenVLA-OFT — 같은 모델, fine-tuning 레시피만 바꿨더니
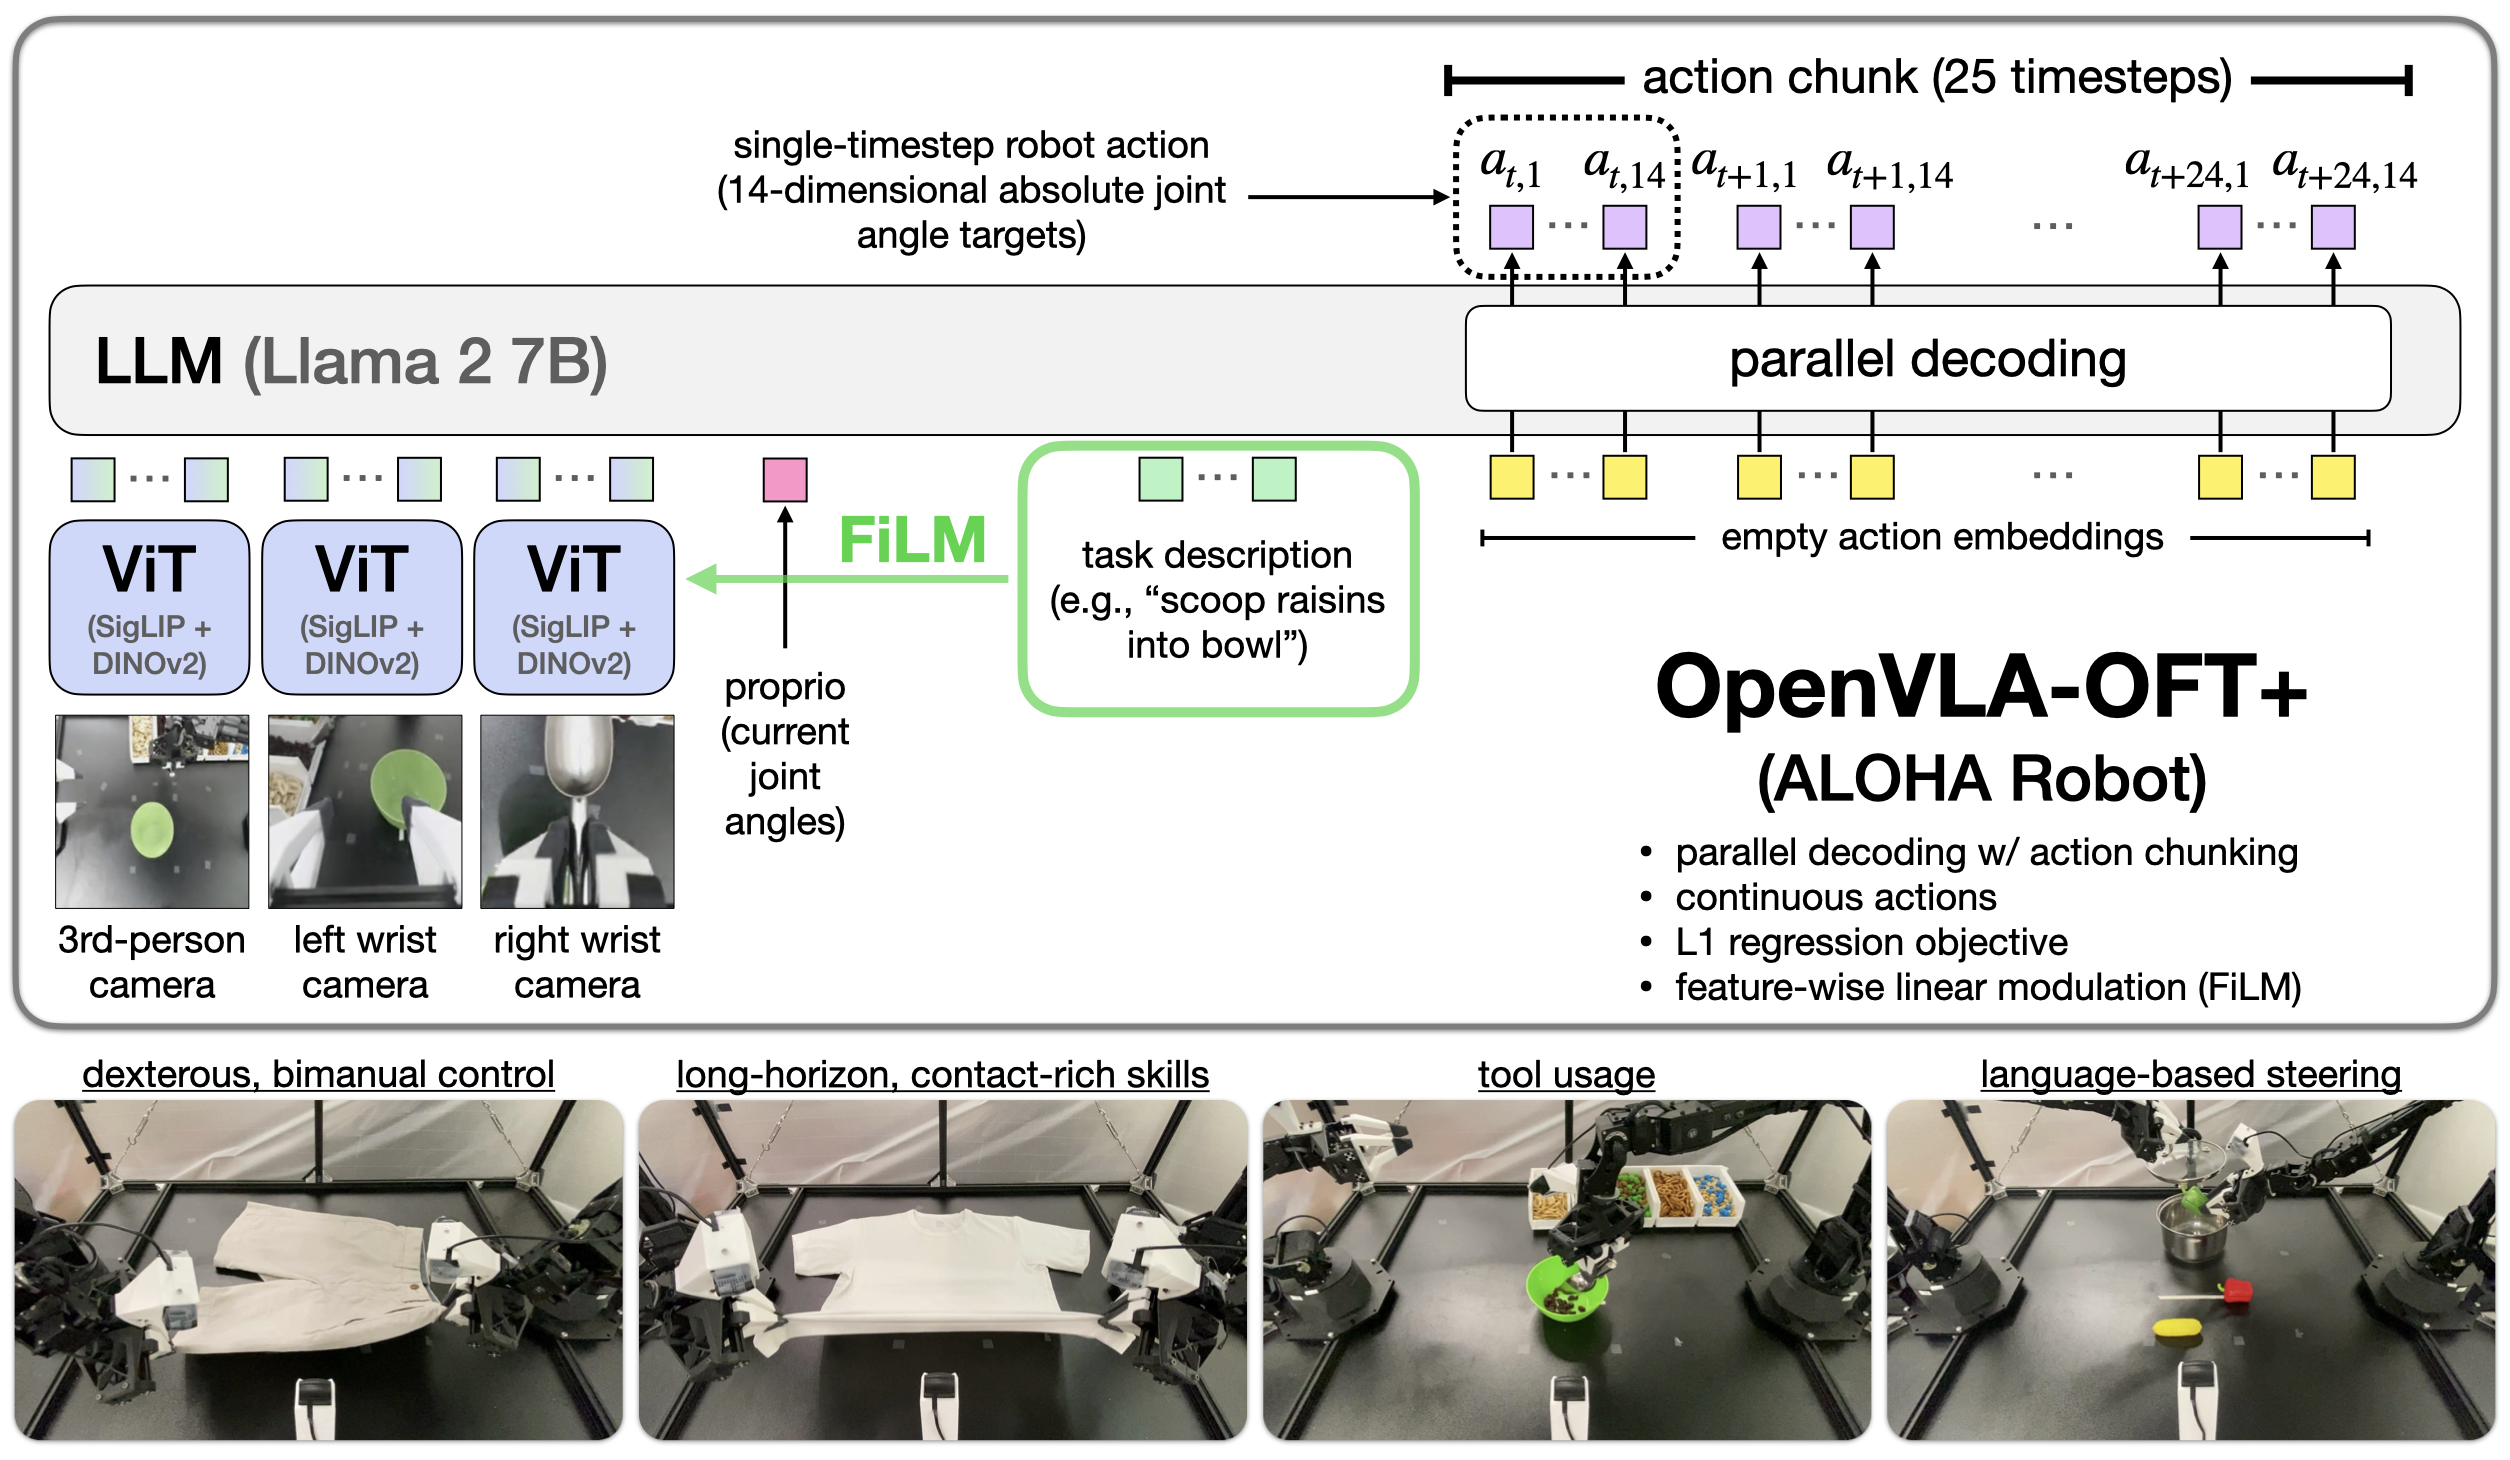
출처: Kim et al., “Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success”, Fig. 1 (arXiv 2502.19645, CC BY 4.0)
OpenVLA 를 그대로 두고 fine-tuning 방법만 바꿔서 성능과 속도를 둘 다 크게 올린 논문이다. 바꾼 건 딱 세 가지다.
- parallel decoding: 토큰을 하나씩 생성하지 않는다. action 자리에 빈 embedding 을 넣고 양방향 attention 으로 한 번에 다 채운다.
- action chunking: 한 번에 여러 step 을 낸다 (우리 chunk 16 과 같은 아이디어).
- 연속값 + L1 회귀: 토큰 / 단어장을 버리고, LLM 마지막 hidden 에 MLP head 를 붙여서 숫자를 바로 뽑는다.
!!!내 코드에서 바뀌는 곳
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# [OpenVLA-OFT] noise / t / Euler 가 없다. "빈칸 채우기" 를 한 번에

# 1. action 자리에 빈 embedding 을 chunk 길이만큼 붙임
empty = self.action_query.expand(B, 16 * 7, D)             # 학습되는 placeholder
h = self.lm(inputs_embeds=cat([prefix, empty]),
            attention_mask=bidirectional_on_action_part)    # action 부분은 서로 다 봄 (causal X)

# 2. MLP head 로 바로 연속값
action_pred = self.action_head(h[:, -16 * 7:]).view(B, 16, 7)   # [B, 16, 7]

# 3. loss = L1 (MSE 도 아니고 cross-entropy 도 아님)
loss = (action_pred - action).abs().mean()

# 추론: forward 딱 1 번 -> chunk 전체 (OpenVLA 는 토큰 수만큼, 우리는 expert 10 번)
- 결과: LIBERO 평균 약 97% (OpenVLA 76.5% → 97%), action 생성 속도도 수십 배 빨라졌다.
- 내 코드와 비교하면: chunk + 연속값 은 같은데, flow matching (noise → 10 step) 대신 한 방 회귀다. 단점은 시연이 여러 갈래 (왼쪽으로 돌기 / 오른쪽으로 돌기) 일 때 회귀는 평균을 내버릴 수 있다는 것. flow matching 은 갈래 중 하나를 뽑을 수 있다. (PushT 에서 n_action_steps 줄였을 때 흔들렸던 그 “갈래” 이야기)
3. π0 — 내가 만든 구조의 원본
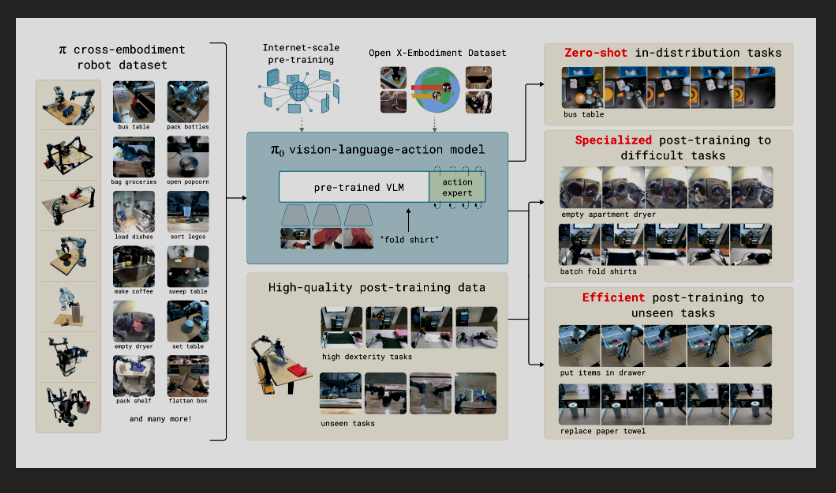
- PaliGemma 3B (VLM) + 약 300M action expert, layer 별 attention 으로 연결 (내 코드의 A 방식)
- action 은 flow matching 으로 연속값 chunk (논문은 chunk 50 step, 50Hz 로봇. noise → action 적분은 나랑 똑같이 10 step)
- 내 코드와 차이는 크기와 데이터뿐이다. 구조 / mask / Euler 10 step / Beta(1.5, 1) 시간 분포까지 같다.
1
2
3
4
5
# [π0] = 내 코드. 크기만 다름
VLM     PaliGemma 3B          # 나: SigLIP + SmolLM2 135M (12 layer)
expert  Gemma 300M            # 나: 21M (12 layer, hidden 384)
chunk   50                    # 나: 16
data    7 종 로봇 + OXE 로 사전학습 후 task 별 fine-tune   # 나: PushT 만
4. π0-FAST — 토큰인데, 똑똑하게 압축한 토큰
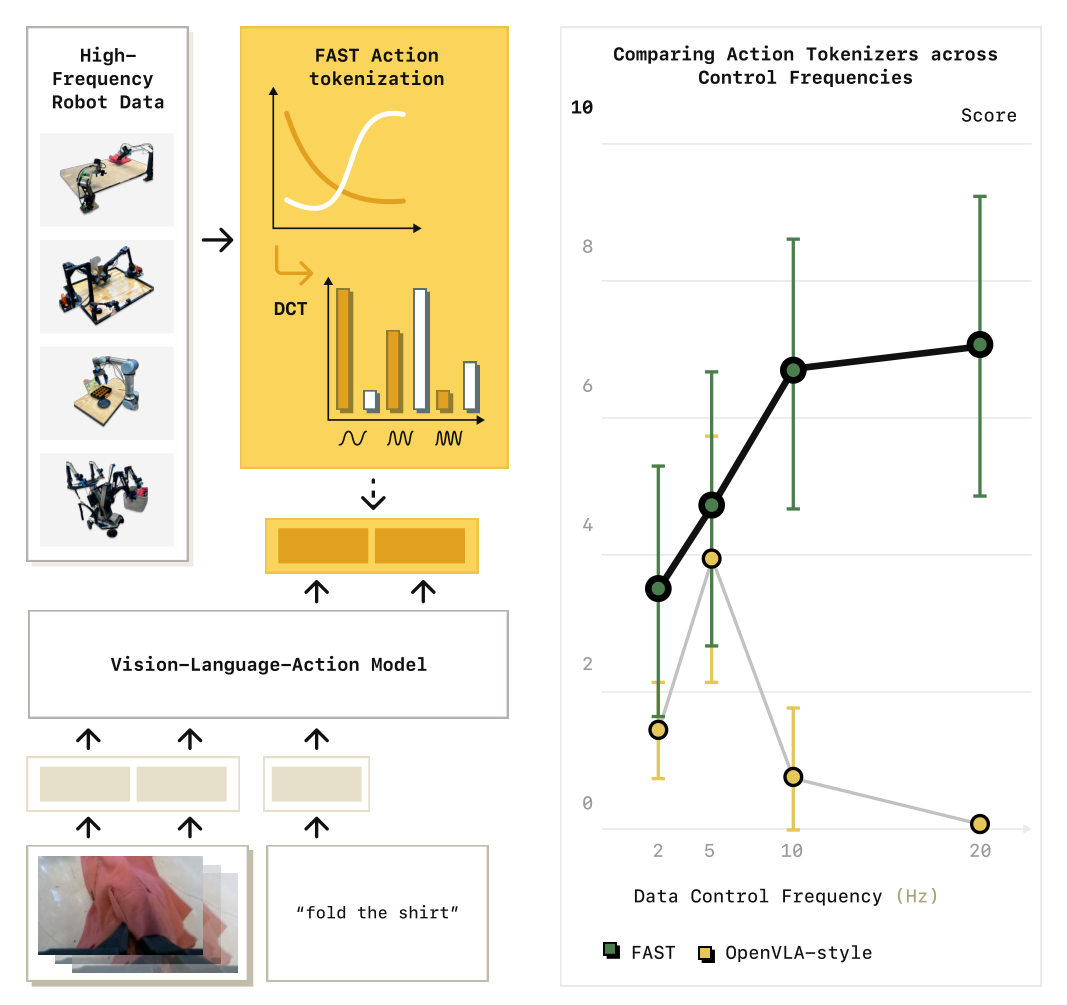
출처: Pertsch et al., “FAST: Efficient Action Tokenization for Vision-Language-Action Models”, Fig. 2 (arXiv 2501.09747, CC BY 4.0)
OpenVLA 처럼 토큰으로 가는데, step 마다 bin 으로 쪼개는 게 문제라고 본 논문이다. 로봇 action 은 매 step 이 이전 step 과 거의 비슷해서 (부드러운 곡선), step 별 토큰은 중복 정보투성이고 모델이 “앞 토큰 복사” 만 배운다.
FAST tokenizer: chunk 를 주파수로 바꿔서 압축
- action chunk 정규화
- 차원마다 DCT (이산 코사인 변환, JPEG 압축이랑 같은 원리) → 부드러운 곡선은 저주파 계수 몇 개로 거의 다 표현됨
- 계수를 scale 하고 반올림 (quantize) → 대부분 0
- 저주파부터 차원을 섞어서 일렬로 펴고 → BPE 로 압축 → 짧은 토큰열
1
2
3
4
5
6
7
8
9
10
11
12
# [π0-FAST] 토큰화만 바뀌고, 학습 / 추론은 OpenVLA 처럼 LLM next-token

from scipy.fft import dct, idct
chunk = normalize(action)                                  # [16, 7]  (논문은 더 긴 chunk)
coef  = dct(chunk, axis=0, norm="ortho")                   # 시간축 -> 주파수축, 차원마다
q     = (coef * scale).round().astype(int)                 # 고주파는 거의 0
flat  = q.T.flatten()  # (논문은 저주파부터 차원을 섞는 순서)
action_ids = bpe.encode(flat)                              # 0 이 많아서 확 줄어든 토큰열

loss = self.lm(..., labels=[-100 ... | action_ids]).loss   # cross-entropy

# 추론: generate -> bpe.decode -> /scale -> idct -> 역정규화 -> chunk
- 결과: π0 (flow matching) 와 비슷한 성능을, 학습은 약 5 배 빠르게. 대신 추론은 토큰을 하나씩 생성하니까 π0 보다 느리다.
- 1M 개 궤적으로 미리 학습시킨 범용 tokenizer FAST+ 도 공개했다.
5. 한 장으로 정리
| OpenVLA | OpenVLA-OFT | π0 (= 내 코드) | π0-FAST | |
|---|---|---|---|---|
| action | 토큰 (bin) | 연속값 | 연속값 | 토큰 (DCT + BPE) |
| chunk | X (1 step) | O | O | O |
| loss | cross-entropy | L1 | flow matching MSE | cross-entropy |
| action expert | X | X (MLP head) | O | X |
| 추론 forward 수 | action 차원 수만큼 | 1 | prefix 1 + expert 10 | 토큰 수만큼 |
| 여러 갈래 시연 | 토큰 분포라 OK | 평균 내버릴 수 있음 | OK (샘플링) | 토큰 분포라 OK |
결국 축은 두 개다. (1) 토큰 vs 연속값, (2) 한 번에 vs 여러 번. π0.5 는 FAST 토큰과 flow matching 을 둘 다 쓰고, 그 다음 WAM 은 여기에 “미래 영상까지 같이 예측” 을 얹는다. 다음 글에서 이어서.
References
- OpenVLA: https://arxiv.org/abs/2406.09246 / https://openvla.github.io
- OpenVLA-OFT: https://arxiv.org/abs/2502.19645 / https://openvla-oft.github.io
- π0: https://arxiv.org/abs/2410.24164 / https://www.physicalintelligence.company/blog/pi0
- π0-FAST: https://arxiv.org/abs/2501.09747 / https://www.physicalintelligence.company/research/fast
- 코드: LeRobot policies (pi0, pi0fast, pi05, smolvla)