VLA Architecture - Group Multi Head Attention
VLA의 Action Expert 내부 트랜스포머를 직접 구현해본다. 12개 block에서 self / cross attention이 번갈아 오는 구조, RoPE 위치 번호, Grouped Query Attention(GQA)의 head 수와 Linear 크기, prefix KV cache를 이어 붙이는 self attention과 cache만 다시 projection하는 cross attention까지 shape 단위로 정리한다.
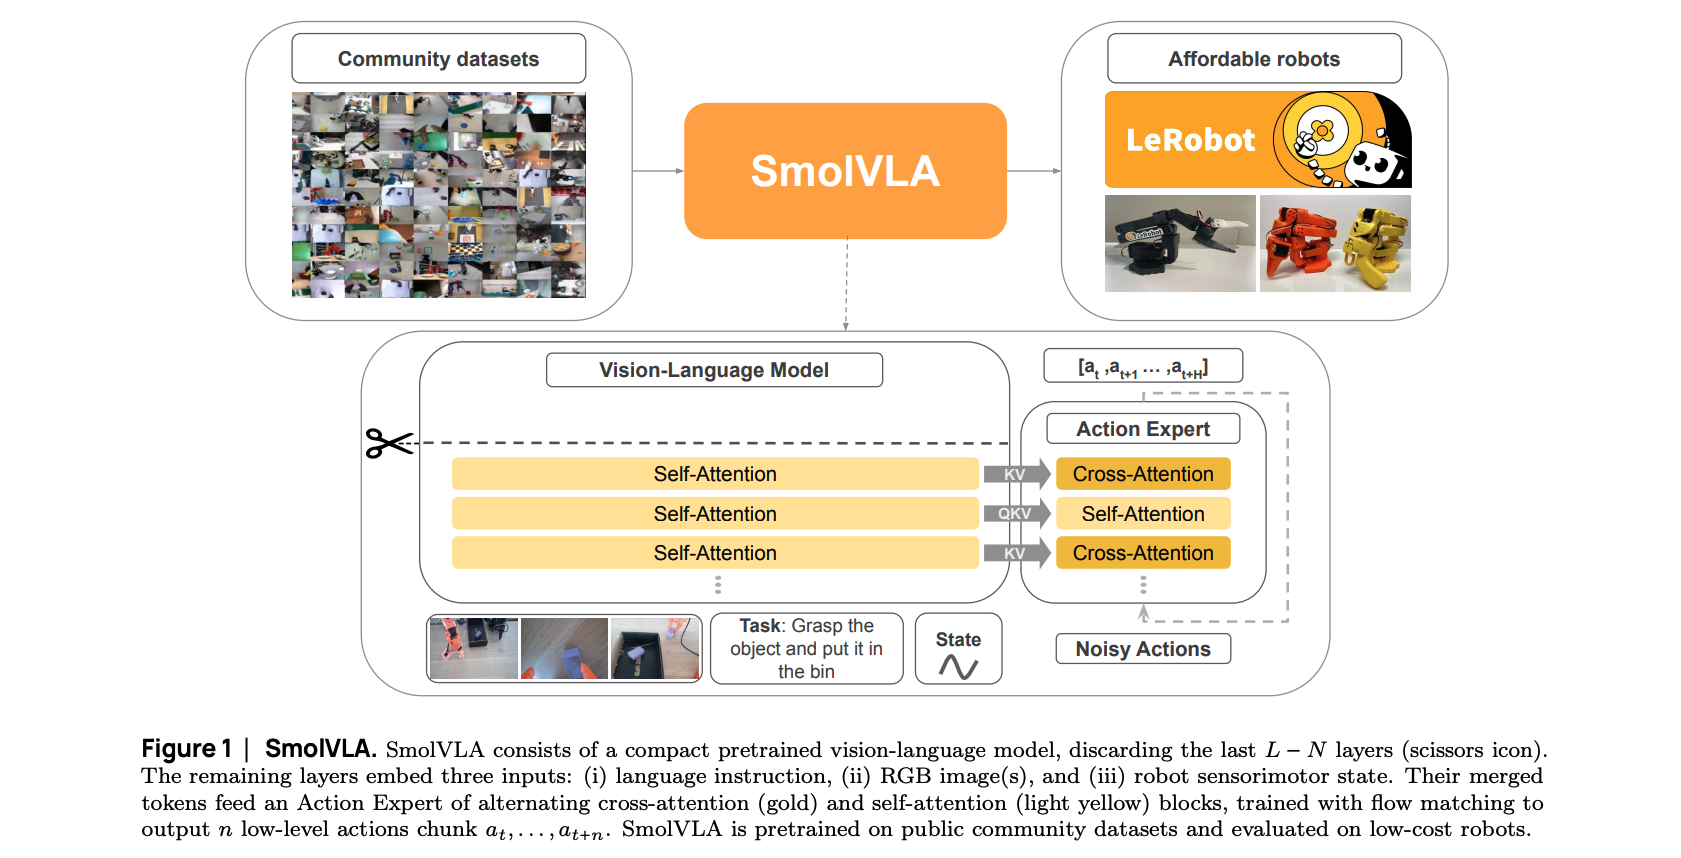
자 이번시간에는 정확히 modeling에 대해서 이야기를 같이 나눠 볼 것이다. 개인적으로 블로그의 양이 굉장히 많아질 것이기 때문에, 나누어서 작성 할 것이다. 전체적인 VLA의 2가지 흐름중에서 2번째 Expert 의 내부 트랜스포머 구조에 대해서 다루어보자.
- Prefix → VLM → KV Cache
- Suffix →
Expert(!!!!)→ Action chunk
1. Expert Transformer
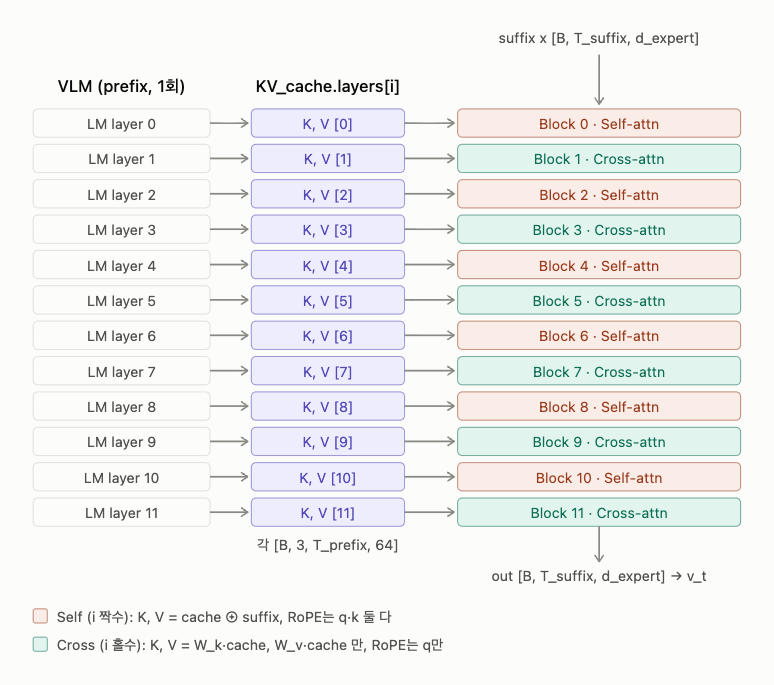
일단 SmolVLA의 핵심 구조는 위 그림처럼 총 12개의 transformer block이 연속적으로 있고, 연달아서 Self attention, Cross attention이 왔다 갔다 하는것이 특징이다. 그리고 그 block에 KV Cache가 각 레이어로 들어가는 것이 특징이다.
따라서, 그 block을 담을 리스트를 만들고, 그 안에 이제 SingleTransformerBlock을 제작해주자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# Expert transformer block has bunch of layers
class ExpertTransformer(torch.nn.Module):

    def __init__(self, config: Config):
        super().__init__()
        self.config = config
        self.transformer_blocks = nn.ModuleList()

        for i in range(config.expert_layers):
            self.transformer_blocks.append(SingleTransformerBlock(config, is_cross = (i%2 ==1)))

        # RoPE 의 cos/sin 만드는 모듈. LLM config (rope_theta, head_dim) 를 그대로 써야 prefix K 와 같은 회전 규칙
        from transformers import AutoConfig
        self.rotary_emb = LlamaRotaryEmbedding(AutoConfig.from_pretrained(config.lm_name))
여기서 이제, forward 가 하는 일은 딱 두 가지다.
- RoPE 용 cos / sin 을 미리 한 번 계산 (self 용, cross 용 두 세트)
- 12 개 block 을 차례로 통과. 이때 expert 의 i 번째 block 은 항상 LLM 의 같은 i 번째 layer cache (
KV_cache.layers[i]) 를 받는다 (layer 별 KV 공유).
코드와 input shape and contents를 같이 살펴보자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
def forward(self, x, attn_mask, KV_cache, position_ids=None):
      '''position_ids [B, T_suffix] = prefix 다음 번호 (406 ~ 421). None 이면 RoPE 안 씀'''
      rope_self = rope_cross = None
      if position_ids is not None:
          # self : prefix 다음 번호 그대로 (prefix K 와 같은 줄에 서야 하니까)
          rope_self = self.rotary_emb(x, position_ids)                                         # (cos, sin) [B, T_s, 64]
          # cross: SmolVLA 처럼 0 부터 다시 시작 (K 를 expert W_k 로 다시 projection 해서 prefix 번호와 직접 안 맞춤)
          rope_cross = self.rotary_emb(x, position_ids - position_ids.min(dim=1, keepdim=True).values)

      for i, layer in enumerate(self.transformer_blocks): # i starts from 0
          kv = (KV_cache.layers[i].keys, KV_cache.layers[i].values)
          rope = rope_cross if i % 2 == 1 else rope_self
          x = layer(x, attn_mask, kv, rope)
      return x
| 입력 | shape | 내용 |
|---|---|---|
x | [B, 16, 384] | suffix (noisy action + time embedding) |
attn_mask | [B, 429, 429] | prefix 413 + suffix 16 전체 2D mask (attention 안에서 잘라 씀) |
KV_cache | 12 layer × (K, V) [B, 3, 413, 64] | prefix 를 한 번 돌려서 나온 cache |
position_ids | [B, 16] | suffix 토큰의 위치 번호 = 406 ~ 421 |
여기서 ROPE라는 개념이 등장한다.(포지션 id라고 생각하면 된다)
Q. RoPE(Rotary Position Embedding)?? What’s that?
attention 의 score 는 q · k 내적이다. 그런데 내적만으로는 두 토큰이 몇 칸 떨어져 있는지 모른다. action 토큰 16 개는 시간 순서 (지금, 0.1 초 뒤, …, 1.5 초 뒤) 가 있으니까 위치 정보가 필요하다. 여기서 재미있는 행렬 연산 규칙 회전을 사용하는 것, RoPE 는 q, k 벡터를 위치만큼 회전시켜서 위치 정보를 대신해서 넣는다!!!
- 64 차원을 2 개씩 짝지어 32 개의 2D 평면으로 보고, 위치 m 에 있는 토큰은 각 평면에서
m · θ_j만큼 돌린다. - 그러면 돌린 q(위치 m) · 돌린 k(위치 n) 의 값이 각도 차이 = 거리 (m − n) 에만 의존하게 된다.
- 절대 위치가 아니라 상대 거리를 알게 되는 것
- 실제로 확인해보면
q(5)·k(3) == q(105)·k(103)(둘 다 거리 2) 가 성립했다.
비유: 시계 바늘. 토큰마다 자기 번호만큼 바늘을 돌려두면, 두 바늘의 각도 차이만 보고도 몇 칸 떨어졌는지 알 수 있다.
코드에서는 두 단계로 나뉜다.
1
2
3
4
5
6
# 1. (ExpertTransformer.forward) 위치 번호 -> cos, sin 표 만들기. 한 번만 계산해서 12 block 이 같이 씀
rope_self = self.rotary_emb(x, position_ids)          # (cos, sin) 각 [B, 16, 64]

# 2. (attention 안) split 직후 q, k 를 실제로 회전
cos, sin = rope
q, k_suffix = apply_rotary_pos_emb(q, k_suffix, cos, sin)    # 내부: q*cos + rotate_half(q)*sin
1-1. self 와 cross 의 위치 번호가 다르다
| layer | 쓰는 rope | suffix 위치 번호 | 회전하는 것 | 이유 |
|---|---|---|---|---|
| 짝수 (self) | rope_self | 406 ~ 421 | q, k_suffix | cache K (위치 0~405) 와 한 줄로 이어 붙으니까 prefix 다음 번호를 그대로 이어야 한다 |
| 홀수 (cross) | rope_cross | 0 ~ 15 | q 만 | cache K 를 expert 의 W_k 로 한 번 더 projection 해서 원래 회전이 섞여버린다 → prefix 번호와 맞출 의미가 없어서 0 부터 (SmolVLA 와 같음) |
- 406 은 어디서 나오냐: prefix 413 토큰 중 pad 7 개를 뺀 진짜 토큰이 406 개 (번호 0 ~ 405, state 가 405). 그래서 suffix 는 406 부터.
position_ids - position_ids.min(...)이 406 ~ 421 을 0 ~ 15 로 당기는 부분이다.- 마지막 loop 에서
rope = rope_cross if i % 2 == 1 else rope_self로 layer 마다 맞는 걸 골라서 block 에 넘겨준다.
2. Single Transformer block
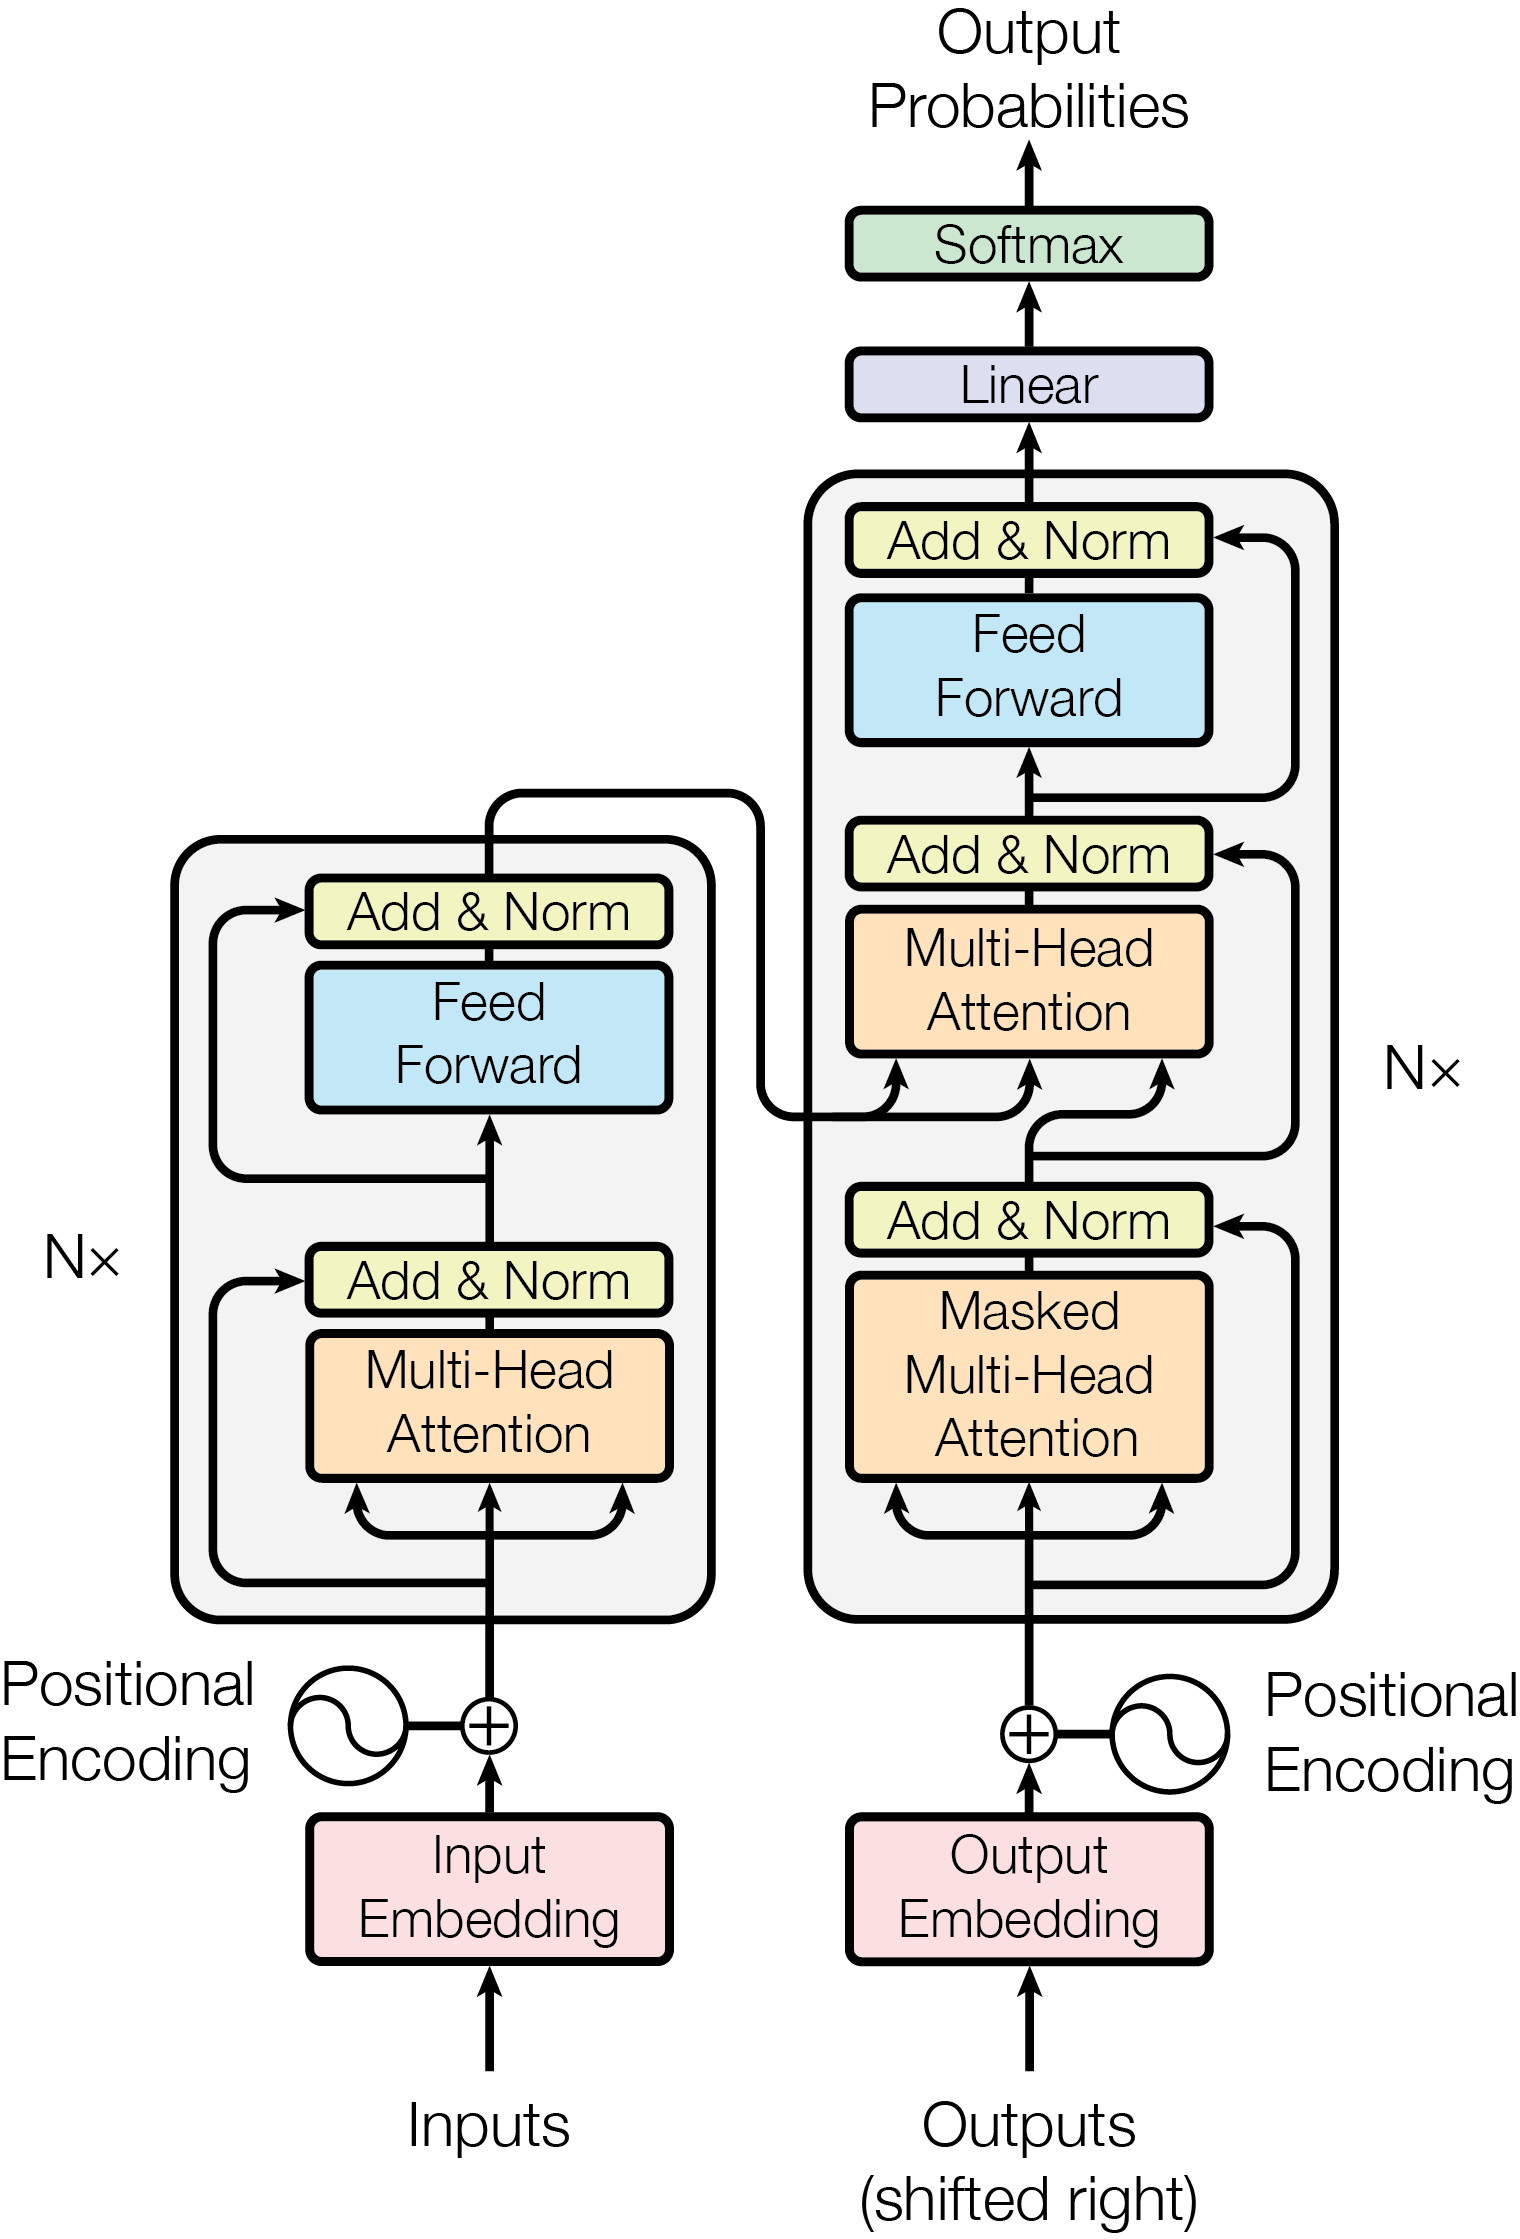
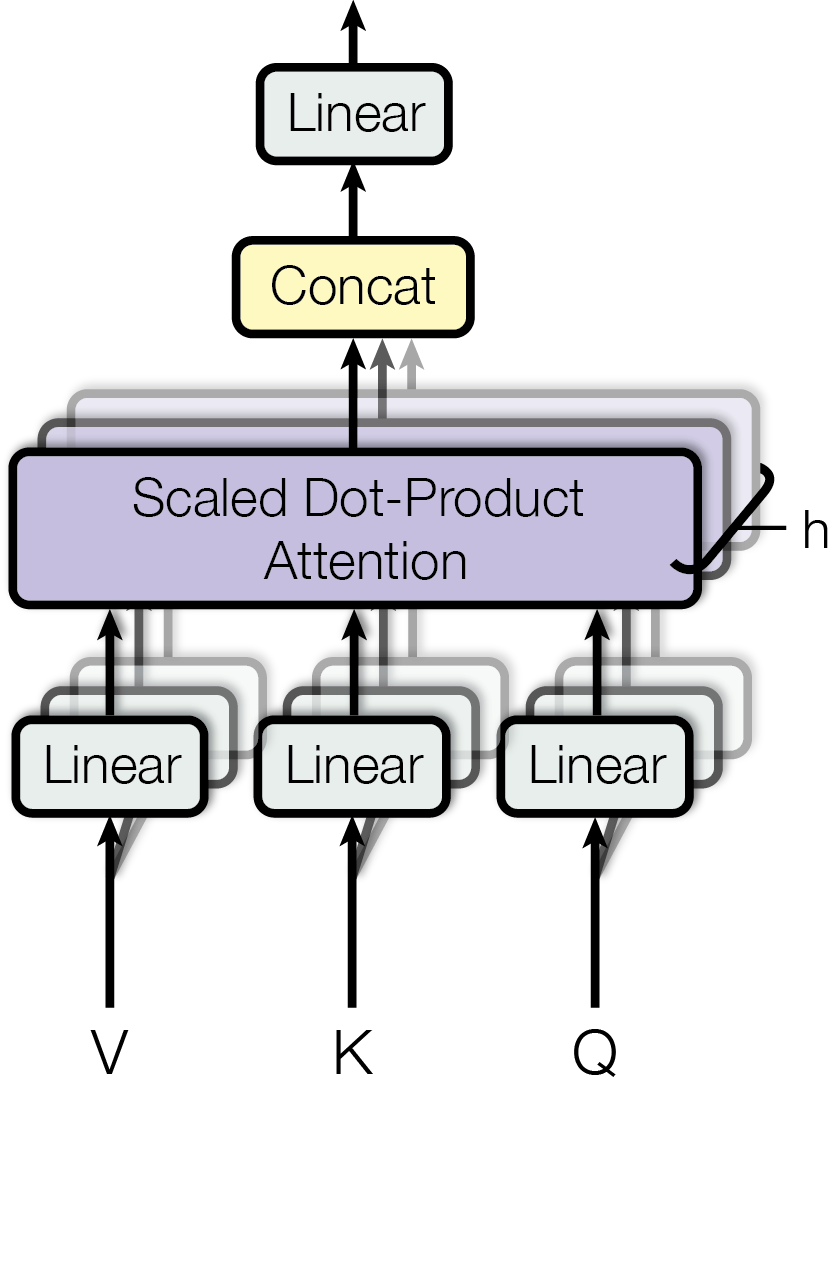
이제 12개 블락들 각각에 대해서 탐구 해볼 시간이다. 내부는 사실 우리가 “Attention is all you need”논문에서 읽은 딱 그 Block이다. 중요한 점은 Cross attention이냐 self attention이냐에 따라서 호출하는 class가 다르다는 점
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
# Transformer block
class SingleTransformerBlock(torch.nn.Module):

    def __init__(self, config: Config, is_cross: bool = False):
        super().__init__()
        self.LN1 = nn.LayerNorm(config.expert_hidden)
        self.LN2 = nn.LayerNorm(config.expert_hidden)

        self.FFN = nn.Sequential(
            nn.Linear(config.expert_hidden, config.expert_ff_hidden),
            nn.GELU(),
            nn.Linear(config.expert_ff_hidden, config.expert_hidden))

        if is_cross:
            self.attention = MultiHeadCrossAttention(config)
        else:
            self.attention = MultiHeadSelfAttention(config)


    # def forward(self, x, attn_mask, KV_cache):
    #     x = x + self.attention(self.LN1(x), attn_mask, KV_cache)
    def forward(self, x, attn_mask, KV_cache, rope=None):
        x = x + self.attention(self.LN1(x), attn_mask, KV_cache, rope)
        x = x + self.FFN(self.LN2(x))
        return x
“attention is all you need” Figure 들을 보면 좌측 사진의 오른쪽 즉 디코더 부분이랑 거의 동일하다. (정확히는 살짝 다르다. 원래 decoder block 은 masked self attention → cross attention → FFN 이 한 block 안에 다 들어있는데, 여기서는 block 하나에 attention 이 하나만 있고 self / cross 를 layer 마다 번갈아 쓴다. 그리고 LayerNorm 을 attention 앞에 거는 Pre-LN 이라는 것도 다르다.)
3. Group Multi-head Self attention
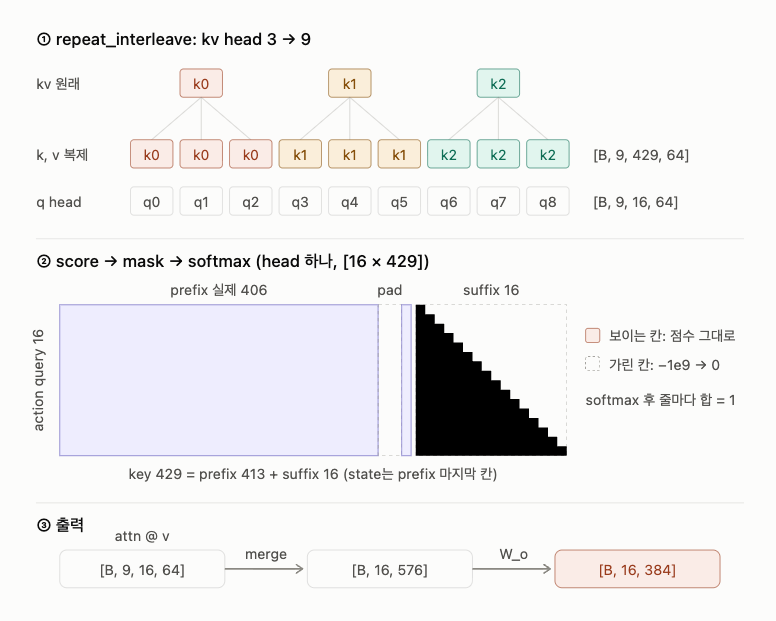
Self attention 은 짝수 layer 에서 쓰인다. 핵심은 suffix 가 만든 K, V 를 prefix cache 뒤에 이어 붙여서, action 토큰이 관측 (prefix 413) 과 다른 action (suffix 16) 을 한 번에 본다는 것. Attention 과정을 한눈에 보여주는 figure는 아래와 같다.
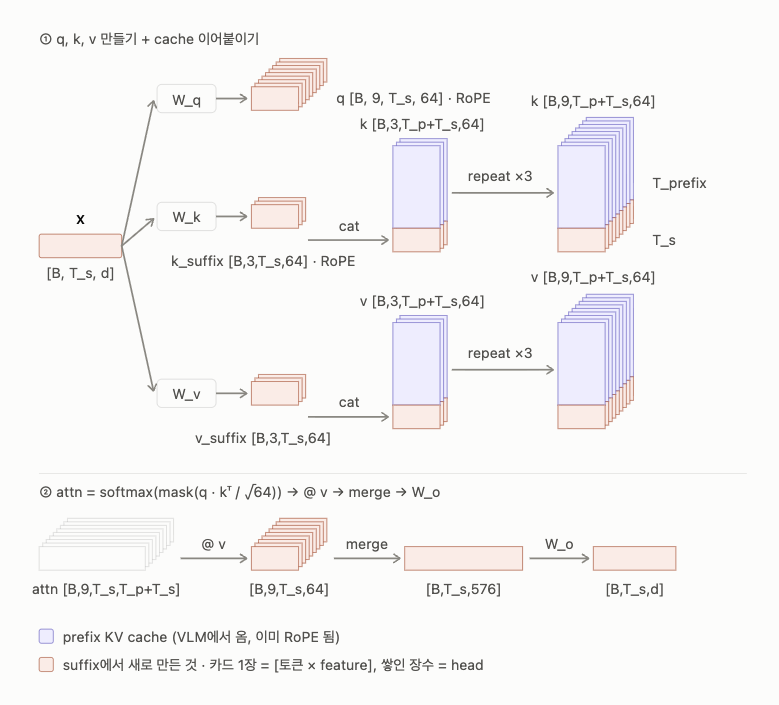
이를 이제 코드로 구현해보자.
3-1. Linear 크기 정하기 (__init__)
1
2
3
4
5
6
7
8
self.head_dim = config.head_dim                            # 64 (LLM 이 정한 값, 바꿀 수 없음)
self.d_q_head = config.head_dim * config.num_q_heads       # 64 * 9 = 576
self.d_kv_head = config.head_dim * config.num_kv_heads     # 64 * 3 = 192

self.W_q = torch.nn.Linear(self.suffix_dim, self.d_q_head)    # 384 -> 576
self.W_k = torch.nn.Linear(self.suffix_dim, self.d_kv_head)   # 384 -> 192
self.W_v = torch.nn.Linear(self.suffix_dim, self.d_kv_head)   # 384 -> 192
self.W_o = torch.nn.Linear(self.d_q_head, self.suffix_dim)    # 576 -> 384
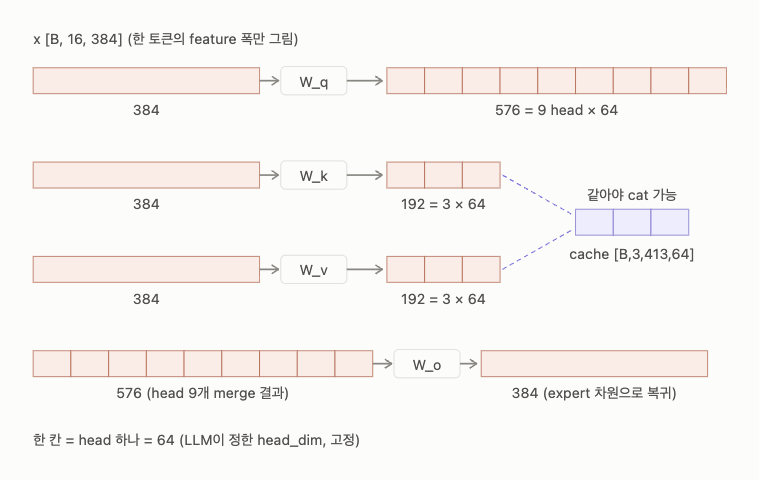
- q 는 head 9 개, k / v 는 head 3 개 (GQA). head_dim 은 전부 64.
- q → 9 * 64 = 576
- k, v → 3 * 64 = 192
로 만드는 게 포인트다. prefix cache 가
[B, 3, 413, 64]라서 head 수와 head_dim 이 같아야 뒤에서 이어 붙일 수 있다.
3-2. split / merge
굉장히 헷갈리지만, Head로 쪼개고 합치는 일들이 반복된다. 이를 위해서 그냥 함수로 만들어버리자.
1
2
3
4
5
6
7
def split(self, t):
    B,T,_ = t.shape
    return t.view(B,T,-1,self.head_dim).transpose(1,2)     # [B, T, H*64] -> [B, H, T, 64]

def merge(self, t):
    B, _, T, _ = t.shape
    return t.transpose(1,2).contiguous().view(B,T,-1)      # [B, H, T, 64] -> [B, T, H*64]
여기서 Head 의 갯수는 다르지만, head_dim (64) 이 q, k, v 모두 같아서 split 하나로 끝난다. -1 자리에 head 수가 알아서 들어간다. (q: 576/64 = 9, k: 192/64 = 3).
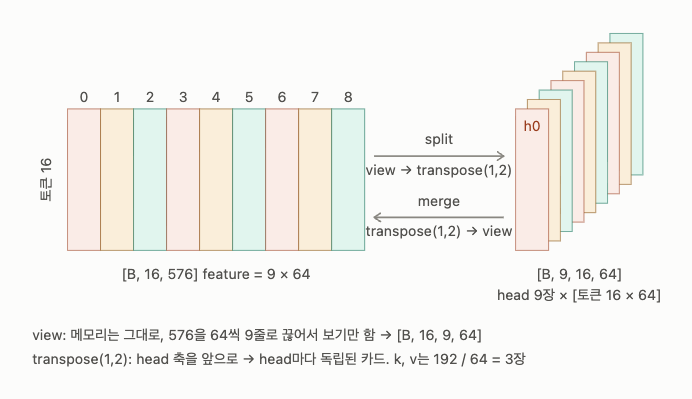
여기서 헤드 갯수를 다르게 한것은 그러니까 여러개의 q가 같은 k,v랑 연산하도록 k,v의 저장 갯수를 급격하게 줄인 것이다 (메모리 + 연산의 효율) → Grouped Query Attention (GQA)
3-3. q, k, v 만들고 RoPE
1
2
3
4
5
6
7
q = self.split(self.W_q(x))                                             # [B, 9, 16, 64]
k_suffix, v_suffix = self.split(self.W_k(x)), self.split(self.W_v(x))   # [B, 3, 16, 64]

# RoPE: suffix 의 q, k 만 회전 (v 는 X). prefix cache K 는 LLM 이 이미 회전시켜 둠
if rope is not None:
    cos, sin = rope
    q, k_suffix = apply_rotary_pos_emb(q, k_suffix, cos, sin)
- x 는 suffix
[B, 16, 384]. 여기서 q, k, v 세 개 다 만든다 (cross 는 q 만 만든다). - RoPE 는 concat 하기 전에 suffix 의 q, k 에만 건다 (위치 406 ~ 421). cache K 는 이미 돌려져 있어서 한 번 더 돌리면 안 된다. 그래서 split 을 RoPE 앞으로 올렸다.
3-4. prefix cache 뒤에 이어 붙이기
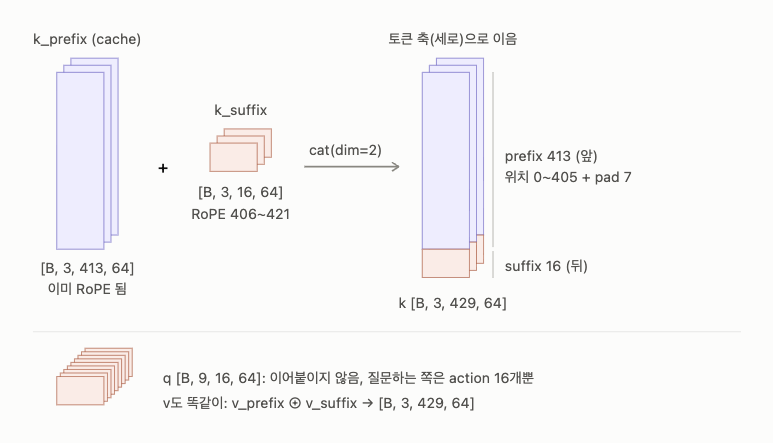
여기서 이제 Cache를 쌓아올리는게 재미있는 부분이다.
1
2
3
4
k_prefix, v_prefix = KV_cache                    # [B, 3, 413, 64]  (LLM layer i 의 cache)

k = torch.cat([k_prefix, k_suffix], dim = 2)     # [B, 3, 413 + 16 = 429, 64]
v = torch.cat([v_prefix, v_suffix], dim = 2)     # [B, 3, 429, 64]
- 토큰 축 (dim=2) 으로 잇는다. 순서는 prefix 가 앞, suffix 가 뒤 (mask 의 key 칸 순서랑 맞아야 함).
- q 는 이어 붙이지 않는다. 질문하는 쪽 (query) 은 action 16 개뿐이다.
- 이게 바로 A 방식 (layer 별 KV 공유) 의 핵심 한 줄.
3-5. GQA → score → mask → softmax → output
1
2
3
4
5
6
7
8
9
10
11
# kv head 3 개 -> 9 개로 복사 (q head 3 개가 kv head 1 개를 같이 씀)
k = k.repeat_interleave(self.config.Group_size, dim = 1)   # [B, 9, 429, 64]
v = v.repeat_interleave(self.config.Group_size, dim = 1)   # [B, 9, 429, 64]

scores = q @ k.transpose(-2, -1) / math.sqrt(self.head_dim)           # [B, 9, 16, 429]
attn_mask = attn_mask[:, None, -scores.shape[2]:, : scores.shape[3]]  # [B, 1, 16, 429]
scores = scores.masked_fill(attn_mask == False, -1e9)

attn = self.dropout(torch.softmax(scores, dim = -1))      # [B, 9, 16, 429]  줄마다 합 1
out = self.merge(attn @ v)                                 # [B, 9, 16, 64] -> [B, 16, 576]
return self.W_o(out)                                       # [B, 16, 384]
repeat_interleave라서[k0, k0, k0, k1, k1, k1, k2, k2, k2]순서 → q head 0~2 는 kv head 0, 3~5 는 kv head 1 을 본다.- mask 는 전체
[B, 429, 429]에서 마지막 16 줄 (action query) 만 잘라 쓴다. key 는 429 전부 (prefix pad 7 칸은 False, action 끼리는 causal). - mask 는 softmax 전에. 못 보는 칸을 -1e9 로 만들면 softmax 후 0.
- 마지막에
W_o로 576 → 384, 다시 expert 차원으로 돌아온다.
4. Group Multi head cross Attention
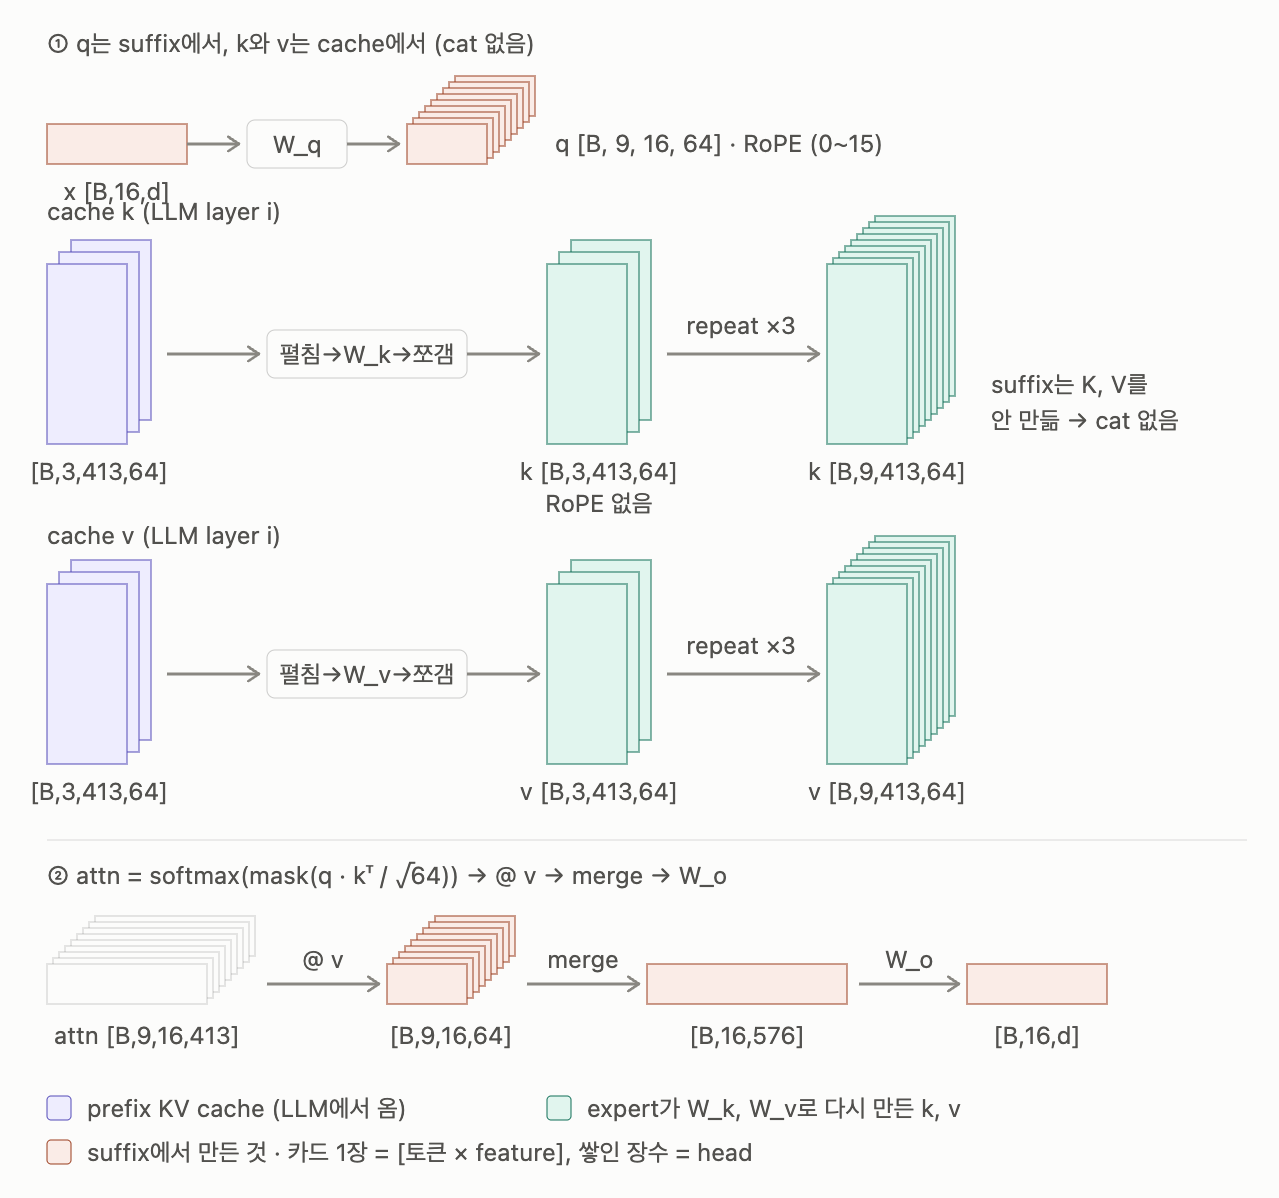
Cross attention 은 홀수 layer 에서 쓰인다. self 와 다른 점은 suffix 는 q 만 만들고, K, V 는 prefix cache 만 쓴다는 것. 즉 action 토큰이 이 layer 에서는 관측 (prefix 413) 만 보고, 다른 action 은 보지 않는다.
4-1. Linear 크기 정하기 (__init__)
1
2
3
4
self.W_q = torch.nn.Linear(self.suffix_dim, self.d_q_head)     # 384 -> 576
self.W_k = torch.nn.Linear(self.d_kv_head, self.d_kv_head)     # 192 -> 192
self.W_v = torch.nn.Linear(self.d_kv_head, self.d_kv_head)     # 192 -> 192
self.W_o = torch.nn.Linear(self.d_q_head, self.suffix_dim)     # 576 -> 384
W_q,W_o는 self 와 완전히 같다.- 다른 건
W_k,W_v의 입력이다. self 는 suffix x (384) 를 받았지만, cross 는 prefix cache (3 × 64 = 192) 를 받는다. 그래서 192 → 192. - 즉 LLM 이 만들어 둔 K, V 를 expert 가 자기 입맛에 맞게 한 번 더 projection 하는 것.
4-2. cache 펼치기 (head 합치기)
1
2
3
k, v = KV_cache # [B, 3, 413, 64]
k = merge(k)    # [B, 413, 192]
v = merge(v)    # [B, 413, 192]
- cache 는 이미 head 로 쪼개진
[B, 3, 413, 64]상태다.nn.Linear는 마지막 축에만 곱해지니까, head 3 장을 다시 옆으로 펼쳐서[B, 413, 192]로 만들어야W_k를 걸 수 있다. - 사실 3-2 의
merge와 똑같은 연산이다 (self.merge(k)로 써도 결과가 같다).
4-3. q, k, v projection → split → RoPE
1
2
3
4
5
6
7
8
q = self.split(self.W_q(x))    # [B, 16, 576]  -> [B, 9, 16, 64]
k = self.split(self.W_k(k))    # [B, 413, 192] -> [B, 3, 413, 64]
v = self.split(self.W_v(v))    # [B, 413, 192] -> [B, 3, 413, 64]

# RoPE: cross 는 q 만 회전 (rope_cross, 위치 0 ~ 15)
if rope is not None:
    cos, sin = rope
    q, _ = apply_rotary_pos_emb(q, q, cos, sin)     # 함수가 (q, k) 를 받아서 q 를 두 번 넣고 첫 번째만 씀
- 펼쳤다 → 곱했다 → 다시 쪼갠다. projection 이 끝나면 split 으로 다시 head 로 나눈다.
- RoPE 는 q 만 돌린다. k 는
W_k를 거치면서 LLM 이 걸어둔 회전이 섞여버렸으니, prefix 번호와 맞출 의미가 없다. 그래서 q 도 406 ~ 421 이 아니라 0 ~ 15 를 쓴다 (1-1 표 참고). - self 와 달리 cat 이 없다. suffix 는 K, V 를 만들지 않는다.
4-4. GQA → score → mask → softmax → output
1
2
3
4
5
6
7
8
9
10
k = k.repeat_interleave(self.config.Group_size, dim = 1)   # [B, 9, 413, 64]
v = v.repeat_interleave(self.config.Group_size, dim = 1)   # [B, 9, 413, 64]

scores = q @ k.transpose(-2, -1) / math.sqrt(self.head_dim)    # [B, 9, 16, 413]
attn_mask = attn_mask[:, None, -T_suffix:, :T_prefix]          # [B, 1, 16, 413]
scores = scores.masked_fill(attn_mask == False, -1e9)

attn = self.dropout(torch.softmax(scores, dim = -1))   # [B, 9, 16, 413]  줄마다 합 1
out = self.merge(attn @ v)                             # [B, 9, 16, 64] -> [B, 16, 576]
return self.W_o(out)                                   # [B, 16, 384]
- GQA 복제는 3-5 와 똑같다 (q head 0~2 → kv head 0, …).
- key 가 413 (prefix 만) 이다. 그래서 mask 도 마지막 16 줄 중 앞 413 칸만 잘라 쓴다. pad 7 칸만 False 이고, action 끼리의 causal 삼각형은 없다 (suffix key 가 아예 없으니까).
- 출력 shape 은 self 와 똑같이
[B, 16, 384]라서, block 안에서 residual 로 그대로 더해진다.
4-5. Self vs Cross 한눈에 비교
| Self (짝수 layer) | Cross (홀수 layer) | |
|---|---|---|
| K, V 출처 | cache ⊕ suffix (cat) | cache 만 (W_k, W_v 로 재투영) |
W_k, W_v 입력 | suffix x, 384 | cache, 192 |
| key 길이 | 429 | 413 |
| RoPE | q, k_suffix / 위치 406 ~ 421 | q 만 / 위치 0 ~ 15 |
| mask | pad False + action causal | pad False 만 |
| action 끼리 | 서로 본다 | 안 본다 |
정리하면, self layer 에서는 action 끼리 정보를 주고받으면서 관측도 같이 보고, cross layer 에서는 관측만 expert 방식으로 다시 뜯어본다. 이걸 12 layer 동안 번갈아 반복하는 구조다.
5. Summary
- 일단 Self attention , cross attention 의 의미에 대해서 정확하게 이해를 할 수 있었다. KV Cache를 둘다 다른 decoder로부터 받는 것은 동일하지만, K,V에 자신의 x (여기서는 suffix) 정보가 들어가냐 안들어가냐의 차이였다.
- 헷갈리는 Grouped Query Attention (GQA) 의 용도, 그리고 연산 과정을 정확하게 이해할 수 있었다. 중요한 사실은 Head dim은 동일 하다는 것이다.
- 번외로 기존 KV Cache 도 Head dim이 64였다는 게, 그러니까 다른 디코더에서 정보를 받으면 그 디코더와 Head dim을 맞추는 경향이 있는 것 같다.
- 근데 사실 경향이라기보다는 self layer 에서는 cache 뒤에 suffix K, V 를 이어 붙여야 하니까 head 수랑 Head dim 이 같아야만 한다. 맞추지 않으면 cat 자체가 안 된다.
- Causal Mask에서 맨 마지막에는 결국에 qk\^T의 디멘션과 맞추어서 마스크를 잘라주어야하는게 특징이다.
- 무엇보다 가장 아하모멘트 였던거는 W_q, k, v의 차원을 보는 거였는데, 심플하게 그냥 Head dim 과 head갯수가 q,k,v가 몇개인지 보고곱해준다음에 그 디멘션이 나오도록 W_q, k, v를 짜주면 된다. suffix로부터 특정 디멘션이 되어야만 하기 때문이다.(무슨 말인지 이해되나?)
- 꽤 재밌었다. 직접 구현이 그래도 할 수 있다는 것도 신기하고 솔직하게 FVM python code 짜는 것보다 훨씬 흠… 간단하다는 생각이 들었다 하하하