VLA Modeling (Training)
VLM에 이어서 SmolVLA / π₀ 스타일 VLA를 직접 만들어 PushT로 학습시켜본다. delta_timestamps로 데이터 만들기, flow matching loss(u_t vs v_t), lr 두 그룹과 warmup+cosine, overfit 테스트, 45분 학습 결과와 gym-pusht 시뮬레이터 성공률 16%까지 정리한다.
Introduction
지난번 VLM 에 이어서 이번에는 VLA (Vision Language Action) 모델을 직접 설계해보자. 목표는 SmolVLA / Pi0 스타일 (A 방식: layer 별 KV 공유) 의 VLA 를 PushT 데이터로 돌리는 것이다.
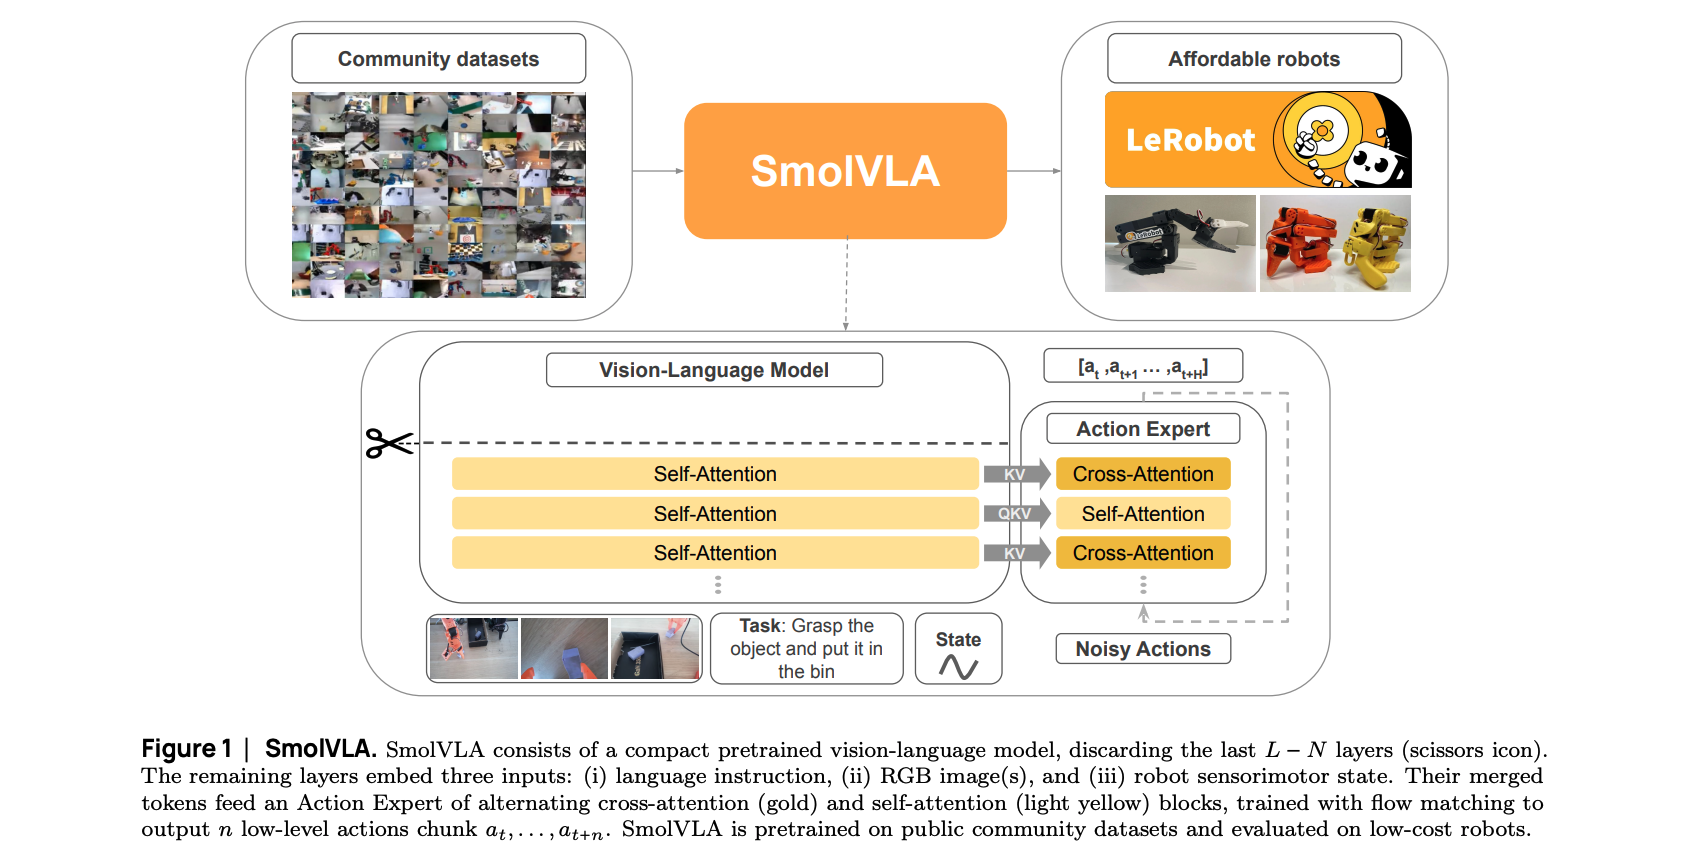
SmolVLA 는 HuggingFace 가 공개한 450M 짜리 작은 VLA 다. 이번 구조는 거의 이걸 보고 따라 만들었다.
- 블로그: SmolVLA: Efficient Vision-Language-Action Model trained on Lerobot Community Data
- 논문: SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics (arXiv 2506.01844)
- 코드: huggingface/lerobot — policies/smolvla (
smolvlm_with_expert.py가 self / cross attention 번갈아 쌓는 부분) - 모델: lerobot/smolvla_base
중요한 점은 이번에는 VLM 때처럼 HuggingFace 모델을 그냥 호출만 하는 게 아니라, 진짜 까다로운 부분은 직접 손으로 짰다. 이 자세한 Expert Transformer 아키텍쳐는 다음 시간에 다루고, 오늘은 저거를 사용해서 어떻게 학습했고, 결과는??? 이라는 질문에 답을 해보자.
파일 구성은 아래와 같다.
(계속해서 바꿔갈 것이지만, 개인적으로 이렇게 4개의 파일로 설계하는 것이 현재까지는 편하다)
1
2
3
4
configuration.py   # 설계도 (모든 차원)
modeling.py        # encoder (VLM prefix) + expert (suffix) + 전체 모델 / sample_actions
transformer.py     # GQA self / cross attention, block, 12-layer expert
utills.py          # sinusoidal time emb, make_att_2d_masks, beta time sampling
일단 전체적으로 어떻게 정보들이 흘러가고 Input output이 뭔지를 이해해보자.
- Image, text, state token → embedding → “prefix”
- Prefix → VLM → KV Cache
- noise + time → embedding → “suffix”
- suffix + KV cache → Action expert → v_t
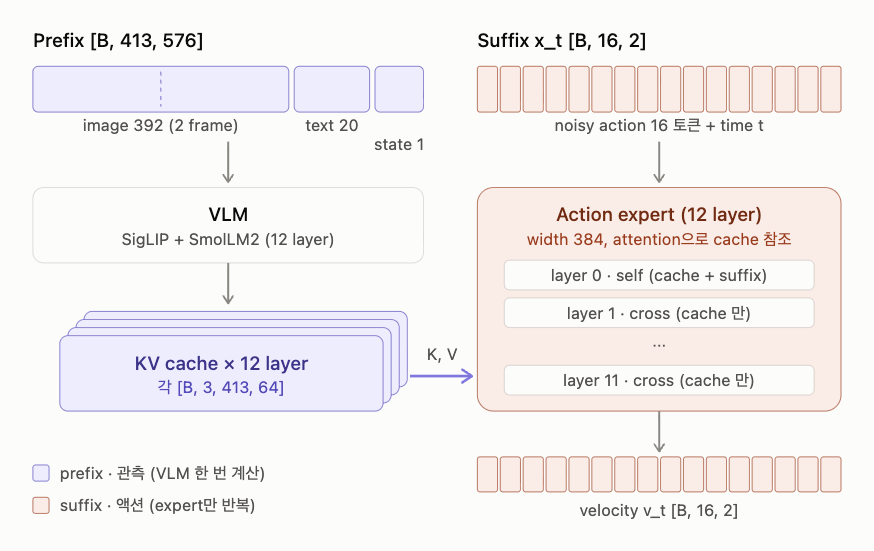
최종적으로 우리가 얻는 것은 Velocity tensor이다. 이는 diffusion model 에서 노이즈가 어느 방향으로 얼마만큼 이동해야 하는 가를 알려주는 텐서. 이제 아키텍쳐를 여기까지 큰 그림으로 이해하고, 자세하게 들어가보자.
Contents
- Data for training
- Model
- Preprocessing for train
- Training loop
- Training on RunPod
- Result
- Eval (gym-pusht 시뮬레이터)
- Summary
1. Data for training
데이터는 gym-pusht라는 아주 심플한 VLA 벤치마크용 데이터를 사용해보자. T자 모형을 정답(초록색)에다가 맞추는 게임이라고 생각하면 된다.
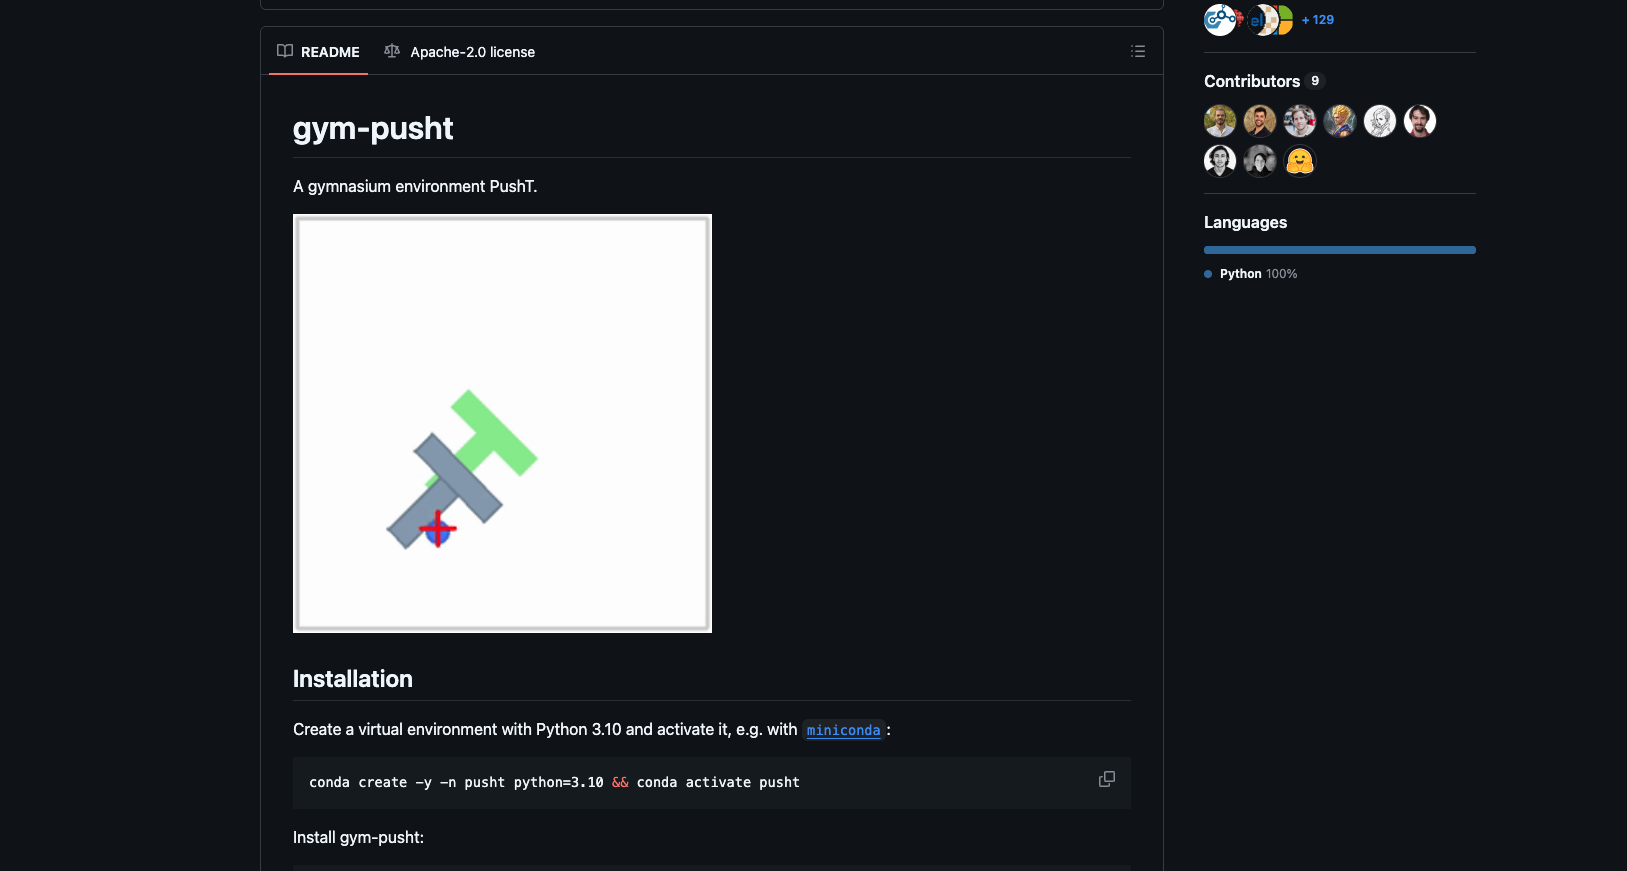
먼저 데이터를 다운로드 하자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# how to download
# 방법 1 (우리가 쓴 방법): LeRobotDataset 이 root 에 데이터가 없으면 HF Hub 에서 알아서 받아온다
from pathlib import Path
from lerobot.datasets.lerobot_dataset import LeRobotDataset

DATA_DIR = Path("data/pusht")
ds = LeRobotDataset("lerobot/pusht", root=DATA_DIR)    # 처음 한 번만 다운로드 (약 7MB), 다음부터는 로컬에서 읽음
print(len(ds), ds.num_episodes)                         # 25650 206

# 방법 2: 파일만 통째로 받기
from huggingface_hub import snapshot_download
snapshot_download(repo_id="lerobot/pusht", repo_type="dataset", local_dir="data/pusht")

# 받고 나면 이런 구조
# data/pusht/
# ├─ data/chunk-000/file-000.parquet           <- state, action, timestamp 같은 숫자 표
# ├─ videos/observation.image/.../file-000.mp4  <- 이미지는 mp4 영상으로 따로
# └─ meta/info.json, stats.json, tasks.parquet  <- 스키마 / 정규화 값 / task 문장
여기서 하나 주의할 점. HF datasets 의 load_dataset("lerobot/pusht") 로 열면 parquet 만 읽어서 이미지가 안 보인다 (이미지는 mp4 에 있음). LeRobotDataset 이 parquet 의 timestamp 를 보고 mp4 에서 해당 frame 을 꺼내서 같이 붙여주는 것.
데이터를 먼저 lerobot dataset library를 사용해서, 읽어오자. 여기서 주의할 점은 우리는 데이터 하나당 과거 프레임 한장 그리고 이제 미래 액션도 필요하다. 즉, 현재 시간 t 데이터에 대해서 미래와 과거 데이터가 필요하기 때문에 정확히 어떤 데이터가 필요한지를 delta_timestamps에 정의해주자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
from lerobot.datasets.lerobot_dataset import LeRobotDataset
delta_timestamps = {
    "observation.image":[-0.1,0.0],
    "action":[a / cfg.fps for a in range(cfg.chunk_size)]     # 0.0, 0.1, ..., 1.5 (fps / chunk 는 config 에서)
}

# overall 206 episodes, 190 for train, 16 for validation
train_ds = LeRobotDataset("lerobot/pusht", root=DATA_DIR, delta_timestamps=delta_timestamps, episodes=list(range(0, 190)))
val_ds = LeRobotDataset("lerobot/pusht", root=DATA_DIR, delta_timestamps=delta_timestamps, episodes=list(range(190, 206)))

#DataLoader
train_loader = torch.utils.data.DataLoader(train_ds, batch_size=cfg.batch_size, shuffle=True,
                                           num_workers=cfg.num_workers, drop_last=True, persistent_workers=True)
val_loader = torch.utils.data.DataLoader(val_ds, batch_size=cfg.batch_size, shuffle=True,
                                         num_workers=cfg.num_workers, generator=torch.Generator().manual_seed(0))
이후에 Dataloader를 통해서 train , val data를 각각 load하는 인스턴스를 생성.
2. Model
전체 적인 모델 내부 흐름을 한 줄 요약하면 이렇다.
- Vision Language Model (image + state + text → KV cache)
- Expert Model (KV cache + x_t + time → v_t)
prefix (관측) → VLM → layer 별 KV cache → action expert 가 그 cache 를 보면서 noisy action 을 velocity 로 바꾼다.
여기서 이 흐름에 맞게 모델을 설계하였고, 이를 SmolVLA_overall 이라는 클래스로 정의하였다. 흐름을 타고 들어가보자.
실제 호출은 train main 함수 안에서 다음과 같이 진행하였고, train_ds.meta.stats는 데이터에서 이후에 우리가 필요한 정보들이 담겨있다. (정규화작업을 위한 정보들)
1
2
3
4
# # Step3. Call SMolVLA_overall for the loss
from modeling import SmolVLA_overall
model = SmolVLA_overall(cfg, train_ds.meta.stats).to(cfg.device)
제작한 내부 구조를 살펴보면, 일단 정규화작업을 위해서 mean, std를 state and action에 대한 값들을 읽어서 정의해주자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class SmolVLA_overall(torch.nn.Module):

    # def __init__(self, config: Config):
    def __init__(self, config: Config, stats: dict):
        '''stats = train_ds.meta.stats (data/pusht/meta/stats.json, 값은 numpy array)'''
        super().__init__()
        self.config = config
        self.encoder = SmolVLA_encoder(config)
        self.expert = SmolVLA_expert(config)


        f32 = lambda x: torch.tensor(x, dtype=torch.float32)
        self.register_buffer("state_mean", f32(stats["observation.state"]["mean"]))   # [2]
        self.register_buffer("state_std", f32(stats["observation.state"]["std"]))
        self.register_buffer("action_mean", f32(stats["action"]["mean"]))             # [2]
        self.register_buffer("action_std", f32(stats["action"]["std"]))
그리고 encoder(VLM), expert 는 각각 따로 정의해주자. (계속 말하지만, 보통 VLA는 이미지와 텍스트 state를 판단해서 임베딩으로 바꿔주는 VLM(encoder + decoder)가 선행되고 그리고 이제 이어서 expert transformer가 작동하는 방식으로 진행된다.
이후에 forward 메서드가 사실 가장 핵심이다. 총 4가지 단계
정규화 state and action
Encoder → Cache
Expert → v_t
Masked MSE
거쳐서 최종적으로 loss 값을 도출해내는 메서드로 작용한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# def forward(self, image, text, state, action):
def forward(self, batch):

    # batch (DataLoader 가 준 dict) 에서 꺼내기. action_is_pad 는 LeRobot 이 delta_timestamps 보고 만들어 준 것
    image, text = batch["observation.image"], batch["task"]           # [B, 2, 3, 96, 96], list[str] B 개
    state, action = batch["observation.state"], batch["action"]       # [B, 2], [B, 16, 2]
    action_is_pad = batch["action_is_pad"]                            # [B, 16] True = episode 밖 가짜 칸

    # 1. Normalize the state and action
    state = (state - self.state_mean) / self.state_std # [B, 2]
    action = (action - self.action_mean) / self.action_std # [B, 16, 2]

    # 2. Encoder -> cache
    cache = self.encoder(image, text, state).past_key_values

   (...)

    return loss
다음 블로그에서 정확하게 어떻게 Cache가 나오는지는 설명할 예정이다. 일단은 우리가 prefix (image + state + text) → embedding 으로 전환해서 이거를 이제 action expert의 attention 연산에 사용된다고 인지하자.
이제 정확하게 Loss를 어떻게 구하는지를 자세하게 살펴보자.
이후에 이제 쉽게 말하면, 데이터에서 정답 vs 우리가 Expert에서 구한 값을 비교해서 MSE loss를 구한다.
Data → Action chunk → x_t → u_t (ground truth velocity)
noise, t → x_t → Expert(x_t, t, cache, …) → v_t (Our prediction)
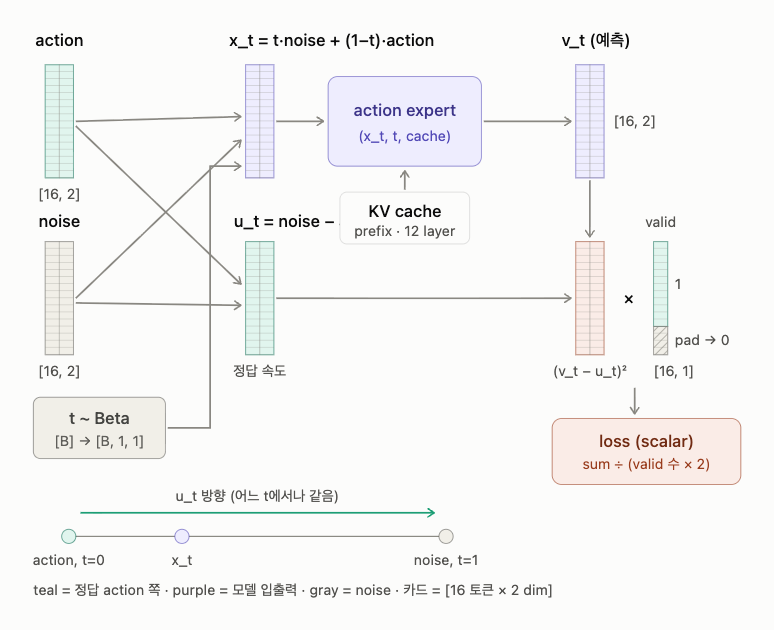
코드로 살펴보면 다음 순서로 작동한다.
- 먼저 노이즈를
actionfrom data 와 동일한 차원으로 생성하고 (랜덤) - Denoise time t를 Beta distribution에서 하나 선택한다.
- 여기서 시간은 실제 시간이 아니라 디노이징을 위한 시간임을 명시하자!!!
- 그리고 t → tt 작업은 그냥 batch 갯수만큼 증폭시키는 것.
- 이후에 이제 정의한 정보들로 x_t를 정의한다 (Linear interpolation)
- x_t → u_t ( ground truth)
- 이를 이제 우리가 expert(x_t, t, cache, …) 으로 구한 v_t와 비교해서 MSE를 도출한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 3. Expert -> v_t
from utills import UtilsForVLA

noise = torch.randn_like(action)                                         # [B, 16, 2]
t = UtilsForVLA.sample_time_beta(action.shape[0], action.device)         # [B]
tt = t[:, None, None] # [B, 1, 1]
x_t = tt * noise + (1 - tt) * action # [B, 16, 2]
u_t = noise - action # [B, 16, 2]

v_t = self.expert(x_t, t, cache, self.encoder.pad_mask, self.encoder.att_1d_mask) # we got velocity from the expert.
valid = (~action_is_pad)[..., None]                    # [B, 16, 1]

# 4. Masked MSE (action padding exist!)
loss = ((v_t - u_t) ** 2 * valid).sum() / (valid.sum() * self.config.action_dim)
3. Preprocessing for train
학습 루프 들어가기 전에 optimizer, scheduler, val_loss 세 개만 준비하자.
Optimizer: lr 을 두 그룹으로
이번에는 SigLIP, SmolLM2 까지 전부 학습한다 (185M). 그런데 이미 학습된 애들한테 새로 만든 애들과 같은 lr 을 주면 원래 능력을 잊어버린다. 그래서 lr 을 두 그룹으로 나눴다. (VLM Stage 2 때랑 같은 아이디어)
- new (expert 전체 + mm / state projector): 랜덤에서 시작 → 크게
1e-4 - pretrained (SigLIP + SmolLM2): 이미 학습됨 → 작게
1e-5
방법은 단순하다. pretrained 파라미터의 id 를 모아두고, 거기 없는 건 전부 new 로 분류.
1
2
3
4
5
6
7
8
9
# lr 두 그룹: 새로 만든 부분은 크게, pretrained (SigLIP, SmolLM2) 는 작게 (크게 건드리면 원래 능력 잊음)
pretrained = list(model.encoder.img_encoder.parameters()) + list(model.encoder.lm.parameters())
pretrained_ids = {id(p) for p in pretrained}
new = [p for p in model.parameters() if id(p) not in pretrained_ids]     # expert 전체 + mm/state projector

optimizer = torch.optim.AdamW([
    {"params": new, "lr": 1e-4},          # 21.7M
    {"params": pretrained, "lr": 1e-5},   # 163.7M
])
Scheduler: warmup + cosine
처음 500 step 동안 lr 을 0 → 목표값까지 천천히 올리고 (warmup), 그 뒤로는 cosine 모양으로 0 까지 내린다. 처음엔 expert 가 랜덤이라 gradient 가 크고 불안정한데, 그때 큰 lr 로 확 움직이면 pretrained 쪽까지 망가질 수 있어서. 두 그룹 모두 같은 모양으로 비율만 유지하면서 움직인다.
1
2
3
from transformers import get_cosine_schedule_with_warmup
scheduler = get_cosine_schedule_with_warmup(optimizer, 500, cfg.training_steps)   # (optimizer, warmup, 전체 step)
params = [p for g in optimizer.param_groups for p in g["params"]]                # grad clip 용
실제 학습에 쓴 scheduler 그대로 lr 만 뽑아서 그려보면 이렇다. (두 그룹이 10 배 차이라 y 축은 log)
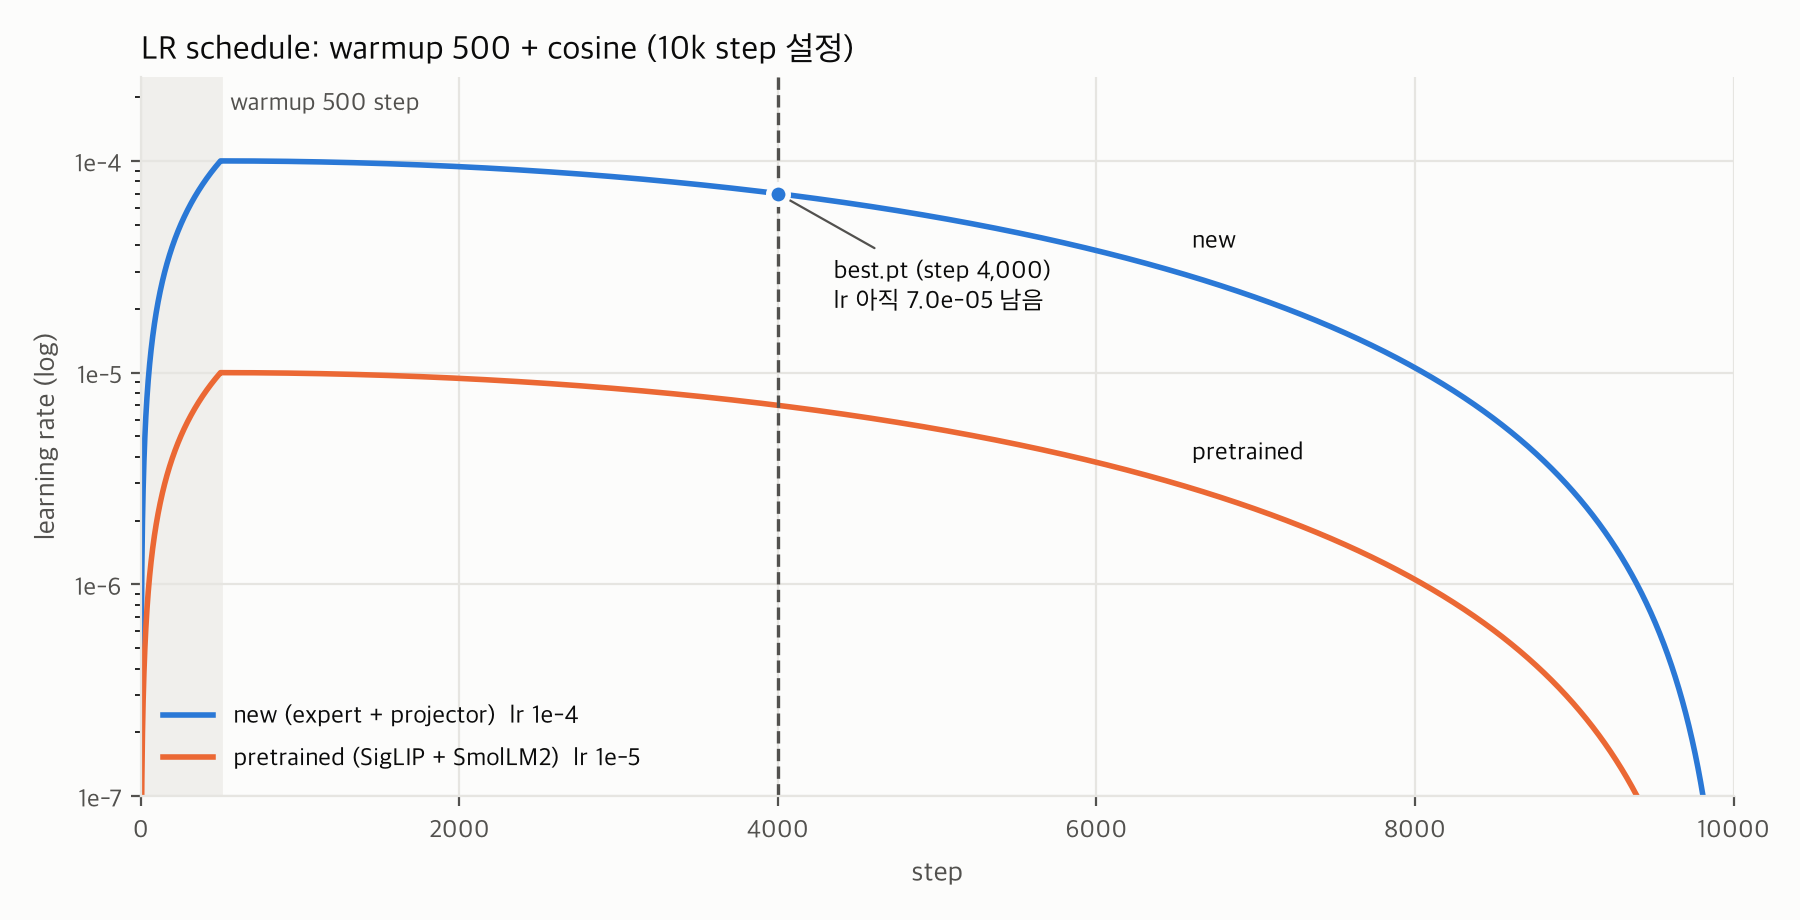
- 두 그룹이 모양은 같고 높이만 10 배 차이. scheduler 는 비율만 곱해주는 것.
best.pt가 나온 4,000 step 에서 lr 은 아직 7.0e-5 (최대값의 70%). 즉 lr 이 충분히 내려가기 전에 val 이 올라가기 시작했다 → 뒤에서 말할 “짧은 학습 + 이른 overfit” 이야기.
val_loss: seed 고정
flow matching loss 는 매번 noise 와 t 를 랜덤으로 뽑는다. 그냥 돌리면 val 할 때마다 다른 문제로 채점하는 셈이라 loss 가 오르락내리락해서 비교가 안 된다. 그래서 val 할 때만 seed 를 0 으로 고정하고, 끝나면 학습용 랜덤 상태를 원래대로 되돌렸다.
1
2
3
4
5
6
7
8
9
10
11
12
13
def val_loss():
    # flow matching loss 는 noise / t 를 랜덤으로 뽑음 -> seed 고정해서 매번 같은 문제로 채점
    model.eval()
    g = torch.random.get_rng_state(); gc = torch.cuda.get_rng_state() if torch.cuda.is_available() else None
    torch.manual_seed(0)
    total = 0.0
    with torch.no_grad():
        for vb in val_batches:            # 고정된 20 batch
            total += model(to_device(vb)).item()
    torch.random.set_rng_state(g)         # 학습용 랜덤 상태 복구
    if gc is not None: torch.cuda.set_rng_state(gc)
    model.train()
    return total / len(val_batches)
(val batch 자체도 DataLoader 에 seed 고정한 generator 를 줘서 매번 같은 20 batch 를 쓴다.)
4. Training loop
1
2
3
4
5
6
7
8
import time, json
OUT = Path(__file__).parent / "result"
OUT.mkdir(exist_ok=True)
best = float("inf")
hist = {"train_loss": [], "val_loss": []}
t0 = time.time()
it = iter(train_loader)
model.train()
이제 실제 학습을 돌려보자, 학습을 돌리면서 loss를 저장하고, 그리고 중간중간에 Validation data를 가지고 loss를 구해서 학습이 잘 진행되고 있는지 확인하자.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18

for step in range(1, cfg.training_steps + 1):
    if overfit:
        batch = b                              # 맨 처음 꺼낸 batch 하나만 반복
    else:
      try:
        batch = next(it)
      except StopIteration:
        it = iter(train_loader)
        batch = next(it)

    loss = model(to_device(batch))

    optimizer.zero_grad()
    loss.backward()
    torch.nn.utils.clip_grad_norm_(params, cfg.grad_clip)
    optimizer.step()
    scheduler.step()
일단 배치를 불러오는데 만약에 모든 배치를 한바퀴 다돌리면 except이 발생하기 때문에, 그런 경우 it instance를 다시 호출해서, 즉 데이터를 섞어서 배치를 다시 생성해서 또 하나씩 처음부터 뽑아준다.
optimizer.zero_grad()→ 모든 파라미터의.grad를 0 으로 초기화.loss.backward()→ loss 에서 거꾸로 chain rule 로 타고 내려가면서 파라미터마다 ∂loss/∂w 를 계산만 해서.grad에 저장.clip_grad_norm_(params, 1.0)→ 전체 grad 크기 (norm) 가 1.0 을 넘으면 비율 그대로 줄여준다. 방향은 그대로, 크기만 제한 (한 번에 너무 크게 튀는 것 방지).optimizer.step()→ 저장된.grad를 보고 가중치를 실제로 업데이트. 기본은w = w - lr · grad인데, AdamW 라서 grad 의 이동평균 (momentum) 과 크기 보정, weight decay 까지 같이 들어간다. 그룹별로 lr 이 다르니까 new 는 1e-4, pretrained 는 1e-5 로 움직인다.scheduler.step()→ 다음 step 에서 쓸 learning rate 를 조절 (warmup / cosine 곡선을 한 칸 전진).
정리하면 backward 는 “어느 방향으로 얼마나 고칠지” 계산만 하고, step 이 그걸 보고 실제로 고친다. 내비게이션으로 치면 backward 는 길찾기, step 은 실제로 한 걸음 움직이는 것. 그래서 순서는 항상 zero_grad → backward → (clip) → step → scheduler.
5. Training on RunPod
학습은 로컬이 아니라 RunPod(gpu server 대여) 에서 돌렸다. and then 본 학습 전에 overfit 테스트부터 한 번 했다.
5-1. Overfit test
batch 1 개만 300 step 반복 학습. 모델이 이 batch 하나도 못 외우면 mask / loss 어딘가에 버그가 있다는 뜻이라, 몇 분 투자해서 먼저 확인하자.
1
2
3
4
5
6
7
loss (step 0, 랜덤 expert -> 약 2 근처면 정상) 1.8227533102035522
step 50 | loss 0.5732 | lr 9.72e-05 | 2.00 it/s
step 100 | loss 0.1418 | lr 8.12e-05 | 2.05 it/s
step 150 | loss 0.3743 | lr 5.56e-05 | 2.07 it/s
step 200 | loss 0.1320 | lr 2.83e-05 | 2.08 it/s
step 250 | loss 0.0513 | lr 7.66e-06 | 2.08 it/s
step 300 | loss 0.1082 | lr 0.00e+00 | 2.08 it/s
- 1.82 → 0.05 ~ 0.13 까지 떨어진다 → 외울 수 있다 = 파이프라인에 큰 버그는 없다.
- step 0 loss 가 약 2 인 것도 정상이다.
- (랜덤 expert 는 v ≈ 0 을 뱉고, 정답 u_t = noise − action 의 분산이 1 + 1 = 2 이기 때문)
- flow matching 은 매 step noise / t 를 새로 뽑아서 같은 batch 여도 완전히 0 까지는 안 간다.
5-2. 본 학습 설정
| 항목 | 값 |
|---|---|
| GPU | RunPod A40 (48GB) 1장, Secure cloud ($0.59/hr) |
| 속도 | 2.07 it/s, GPU util 98%, 메모리 11.3 GB |
| 학습 시간 | 약 45분 (약 5,650 step 에서 중단), overfit 테스트 포함 pod 전체 약 1시간 (약 $0.6) |
| Steps / batch | 10,000 step 계획, batch 16 → val 이 올라가서 중간에 중단 |
| Optimizer | AdamW, lr 1e-4 (new) / 1e-5 (pretrained), warmup 500 + cosine, grad clip 1.0 |
| 학습 파라미터 | 185.4M 전부 (new 21.7M + pretrained 163.7M) |
| 데이터 | pusht 206 episode → train 0~189 / val 190~205 |
6. Result (45분 학습)
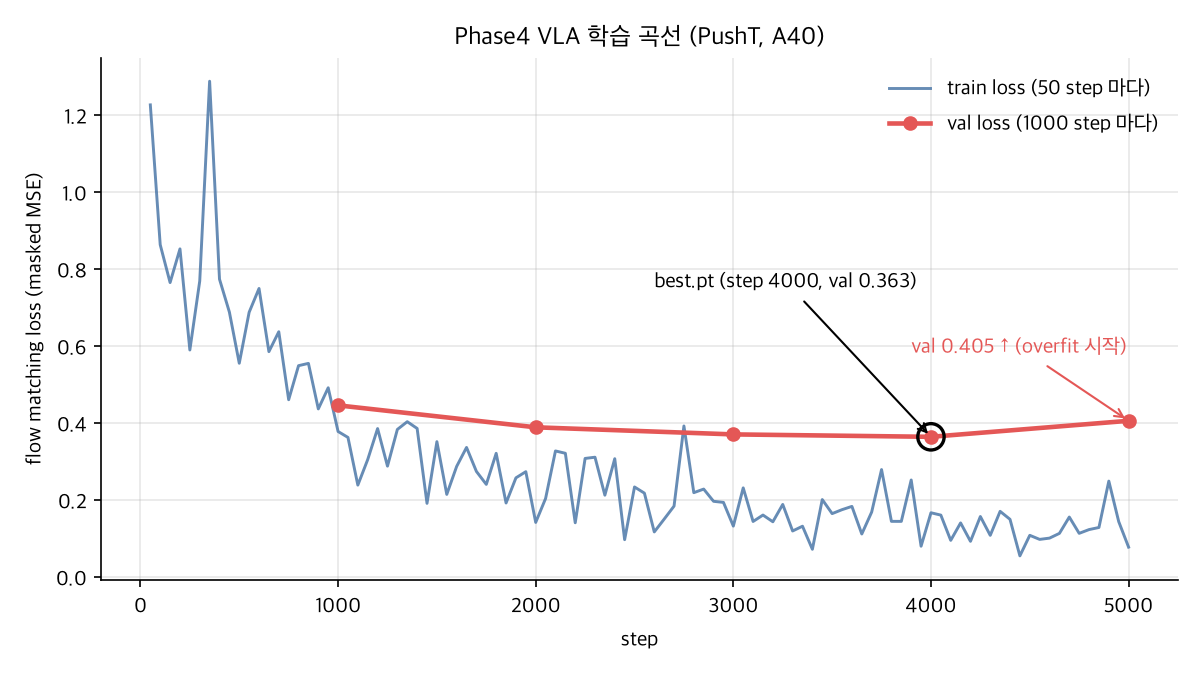
| step | 1000 | 2000 | 3000 | 4000 | 5000 |
|---|---|---|---|---|---|
| val loss | 0.445 | 0.388 | 0.370 | 0.363 (best) | 0.405 ↑ |
- val 이
4,000step 까지 0.445 → 0.363 으로 내려가다가5,000에서 0.405 로 다시 올라갔다 →overfit시작. conclusion → (best 는 step 4,000) - 그 사이 train loss 는 0.06 ~ 0.08 까지 계속 내려간다. train / val 차이가 5 배 이상이다.
- 4,000 step × batch 16 = 64,000 샘플 ≈ 2.7 epoch 만에 best 가 나왔다. 185M 를 전부 풀어서 학습하니까 작은 PushT 데이터 (206 episode) 를 금방 외워버리는 것. VLM Stage 2 때
"LLM 을 풀면 외우는 능력도 커진다"고 했던 게 여기서 진짜overfit으로 나타났다.
Q 그러면 보통 모델 학습할때 몇 epoch로 하는데 보통??
정해진 숫자는 없다. 데이터 크기, 모델 크기, 그리고 pretrained 를 fine-tune 하는지 처음부터 학습하는지에 따라 완전히 다르다. 그래서 epoch 를 미리 정하기보다는 val 곡선을 보고 멈추는 게 보통이다.
| 상황 | 대략적인 epoch | 이유 |
|---|---|---|
| 큰 pretrained 모델 (LLM / VLM) fine-tune | 1 ~ 3 | 이미 아는 게 많아서 금방 맞추고, 더 돌리면 외우거나 원래 능력을 잊는다 |
| 작은 모델을 처음부터 (예: ImageNet 분류) | 수십 ~ 수백 | 랜덤에서 시작하니까 오래 봐야 한다 |
| 로봇 모방학습 (작은 데이터, 예: Diffusion Policy × PushT) | 수백 이상 | episode 가 수백 개뿐이라 같은 데이터를 수백 번 본다. 대신 random crop 같은 augmentation 으로 매번 조금씩 다른 사진을 보여줘서 overfit 을 막는다 |
- 그리고 로봇 쪽은 보통 epoch 대신 step 으로 말한다 (예: “batch 64 로 200k step”). episode 길이가 제각각이라 epoch 단위가 애매하기 때문. 우리 코드도 step 단위로 돌린다.
- 실전에서는 step 을 넉넉하게 잡아두고 → N step 마다 val (가능하면 실제 성공률) 을 재고 → 가장 좋았던 checkpoint 만 남긴다 (early stopping).
우리 경우는 2.7 epoch 에서 best 가 나왔다. pretrained 185M 를 통째로 푸는 fine-tune 이라 “1~3 epoch 에서 외우기 시작” 하는 건 이상한 게 아니다. 문제는 로봇 정책은 보통 훨씬 더 오래 학습해야 정밀해진다는 것. 그래서 다음에는 augmentation 으로 overfit 을 늦춰서 더 오래 학습할 수 있게 만드는 게 목표다.
7. Eval (gym-pusht 시뮬레이터)
loss 가 낮다고 로봇이 잘 움직이는 건 아니다. 진짜 점수는 시뮬레이터에서 직접 굴려봐야 나온다. 그 전에 추론 함수부터 보자.
7-1. sample_actions (VLA 판 generate)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
@torch.no_grad()
def sample_actions(self, image, text, state):
    '''
    추론 (VLA 판 generate): 관측 -> action chunk
        image : [B, 2, 3, 96, 96]  0~1 (이전 frame, 현재 frame)
        text  : list[str] B 개
        state : [B, 2]  픽셀 좌표 (정규화 전 원래 값)
    return  : [B, 16, 2]  픽셀 좌표 action (env.step 에 바로 넣을 값)
    '''
    # 1. state 정규화 (학습 때와 같은 mean / std buffer)
    state = (state - self.state_mean) / self.state_std                       # [B, 2]

    # 2. prefix 1 번 -> cache (Euler 10 step 동안 고정)
    cache = self.encoder(image, text, state).past_key_values

    # 3. t=1 순수 noise 에서 시작 -> Euler 로 t=0 (action) 쪽으로
    B = state.shape[0]
    x_t = torch.randn(B, 16, 2, device=state.device)                         # [B, 16, 2]
    t = torch.ones(B, device=state.device)                                   # [B]
    dt = -1.0 / 10                                                           # -0.1
    for _ in range(10):
        v_t = self.expert(x_t, t, cache, self.encoder.pad_mask, self.encoder.att_1d_mask)       # 속도
        x_t = x_t + dt * v_t
        t = t + dt

    # 4. 역정규화: 정규화된 공간 -> 픽셀 좌표
    return x_t * self.action_std + self.action_mean                          # [B, 16, 2]
흐름은 딱 4 단계다.
- state 정규화: 학습 때 정규화된 state 를 봤으니까 추론 때도 똑같이 정규화해서 넣는다. mean / std 는 모델 안 buffer 라서
best.pt에 같이 저장돼 있다. - prefix 1 번 → cache: 이미지 / 문장 / state 는 action 을 다듬는 동안 안 바뀐다. 그래서 encoder 는 딱 한 번만 돌리고 layer 별 KV cache 를 만들어 둔다.
- noise → Euler 10 step: t = 1 (순수 noise) 에서 출발해서, expert 가 알려주는 속도 v_t 를 따라 한 걸음씩 걸어간다. 학습 때
x_t = t·noise + (1−t)·action이었으니까 t = 0 쪽이 action 이다. 그래서 dt 는 음수 (−0.1) 이고 10 번 걸으면 t 가 1 → 0 이 된다. - 역정규화: 결과는 정규화된 공간의 값이라 mean / std 로 되돌려서 픽셀 좌표로 만든다. 이게 바로
env.step()에 들어간다.
VLM 의 generate 랑 비교하면 구조가 똑같다. 둘 다 루프 들어가기 전에 prefix 를 한 번 돌려서 cache 를 만들고 (prefill), 루프에서 그 cache 를 재사용한다. 다른 건 루프 안에서 뭘 반복하냐다.
VLM generate | VLA sample_actions | |
|---|---|---|
| 시작점 | <|im_start|>assistant\n 까지의 prompt | 순수 noise [B, 16, 2] |
| 루프 1 번 | 토큰 1 개 생성 (argmax) | action 16 개 전체를 조금 다듬기 (Euler 1 step) |
| cache | 토큰마다 1 씩 늘어남 | 413 으로 고정 |
| 반복 횟수 | eos 나올 때까지 (최대 20) | 항상 10 번 |
| 결과 | 답변 token id | action chunk [B, 16, 2] (픽셀 좌표) |
수치해석 비유: 학습한 expert 는 “지금 위치에서 어느 방향으로 얼마나 가야 하나” 를 알려주는 속도장 (velocity field) 이고, sample_actions 는 그 속도장을 따라 forward Euler 로 ODE 를 t = 1 → 0 으로 적분하는 것.
7-2. Rollout loop
이제 이 함수를 시뮬레이터 (gym_pusht/PushT-v0) 안에서 반복해서 부른다.
50 episode(seed 1000 + i, phase2 와 같은 문제)- action chunk 16 개 중 앞 8 개만 실행하고 다시 예측 (
n_action_steps = 8) - episode 최대 300 step
- env 는 현재 frame 만 주기 때문에, 직전 frame 을 기억해서 [이전, 현재] 2 frame 으로 묶어 넣는다 (첫 step 은 현재 frame 두 번 = 학습 때 pad 처리와 같음)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
prev_img = obs_to_img(obs)                       # 첫 step: 이전 frame 없음 -> 현재 frame 으로 채움
for step in range(300):
    cur_img = obs_to_img(obs)
    if not queue:
        image = torch.stack([prev_img, cur_img])[None]                                   # [1, 2, 3, 96, 96]
        state = torch.from_numpy(np.asarray(obs["agent_pos"], dtype=np.float32))[None].to(DEVICE)   # [1, 2]
        chunk = model.sample_actions(image, [TASK], state)[0]                           # [16, 2] 픽셀 좌표
        queue = list(chunk[:8].cpu().numpy())                                            # 앞 8 개만
    action = queue.pop(0)

    prev_img = cur_img                           # 매 env step 마다 갱신 (0.1 초 전 = 1 step 전)
    obs, reward, terminated, truncated, info = env.step(action)
    max_reward = max(max_reward, float(reward))
    if info.get("is_success", False):
        success = True
- queue 가 비었을 때만
sample_actions를 부른다 → 8 step 에 한 번 예측. prev_img는 예측할 때만이 아니라 매 env step 마다 갱신해야 한다. 학습 데이터의 “0.1 초 전” 이 env 1 step 전이기 때문.- 점수는 두 개: success (T 블록이 목표와 약 95% 이상 겹침) / coverage (episode 동안 겹친 비율의 최대값).
7-3. Eval 결과 (성공률 16%)
성공률 16% (8 / 50), 평균 coverage 0.72 (50 episode 에 약 4 분)
| 정책 | 성공률 | 평균 coverage |
|---|---|---|
| 랜덤 정책 | 0% | 0.09 |
| phase2 (비전 freeze, cross-attn expert) | 0% (0 / 10) | 0.18 |
phase4 VLA (best.pt, step 4000) | 16% (8 / 50) | 0.72 |
- 성공한 episode: 4, 7, 8, 10, 27, 43, 45, 46 (ep 43 은 73 step 만에 성공).
- 50 개 중 27 개가 coverage 0.9 이상. T 블록을 목표 근처까지는 대부분 잘 밀어 넣는다.
- phase2 는 블록을 구석으로 밀어내던 수준이었는데 coverage 가 0.18 → 0.72 로 4 배. 비전 인코더를 같이 학습시킨 효과가 확실히 있다.
❌ 거의 다 왔는데 실패한 예시 (ep 0, coverage 0.96)
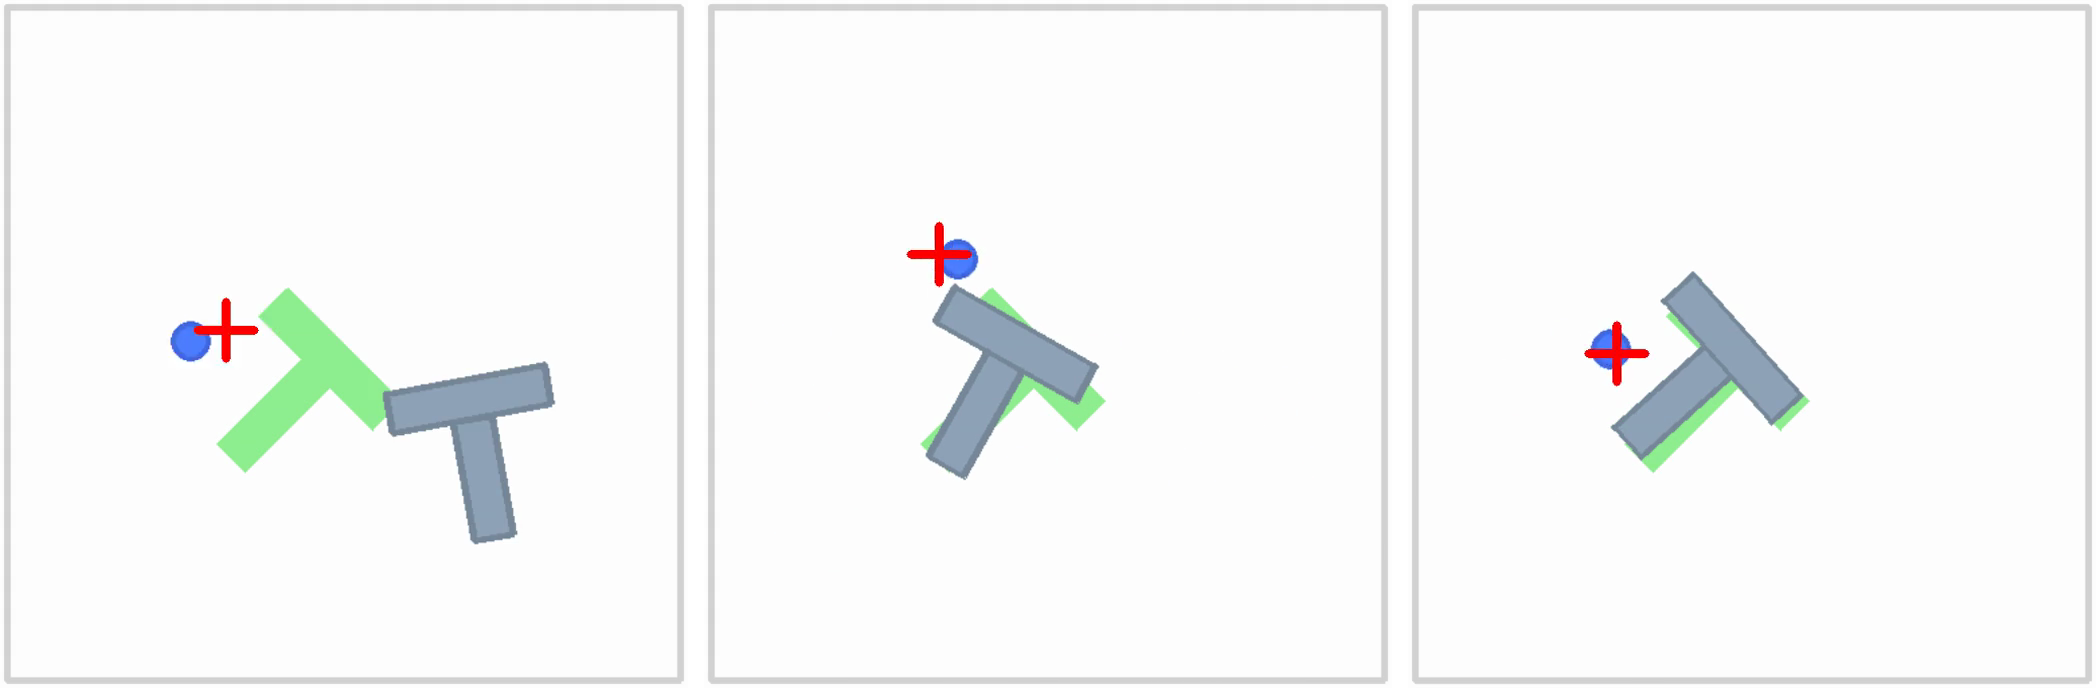
왼쪽부터 시작 / 중간 (150 step) / 끝 (300 step). 파란 원이 로봇 (pusher), 빨간 + 가 action 목표 위치, 초록이 목표 T, 회색이 밀어야 할 T 블록이다. 처음엔 멀리 떨어져 있던 블록을 목표 위치까지 끌고 와서 각도까지 거의 맞췄는데 (96% 겹침), 마지막 몇 픽셀 / 몇 도를 못 맞추고 300 step 이 끝난다. 실패의 대부분이 이런 “거의 다 왔는데” 패턴이다.
7-4. n_action_steps 를 줄이면 좋아질까?
가설: 8 step 을 관측 없이 (눈 감고) 실행해서 마지막 정렬을 못 하는 거라면, 더 자주 다시 예측하면 좋아져야 한다. 재학습 없이 같은 best.pt 로 eval 만 다시 돌렸다.
| n_action_steps | 성공률 | 평균 coverage |
|---|---|---|
| 8 (기존) | 16% (8 / 50) | 0.72 |
| 4 | 2% (1 / 50) | 0.66 |
| 2 | 6% (3 / 50) | 0.48 |
- 예상과 반대. 자주 다시 예측할수록 coverage 가 0.72 → 0.66 → 0.48 로 떨어진다.
- 매번 새 noise 에서 chunk 를 다시 뽑으니까, 뽑을 때마다 계획이 바뀌면서 (왼쪽으로 돌까 오른쪽으로 돌까) 손이 흔들리는 것 같다. chunk 를 길게 끝까지 따라가는 게 오히려 일관성이 있다.
- 결론: 실행 길이는 원인이 아니다 → 짧은 학습 + 이른 overfit, augmentation 없음 쪽이 더 유력하다. 다음은 random crop augmentation 을 넣고 더 길게 재학습해볼 계획.
8. Summary (My thoughts and what I learned)
- Loss를 구하는 방식이 핵심이다. V_t를 결국에 expert는 output하기 때문에 우리가, 정답지 action을 통해서 정답 U_t를 제작하고, 그것과 MSE를 통해서 구한다.
여기서 주의할 점이 바로 데이터에 있는
Action chunk → U_t를 구하는 방식을 주목할 필요가 있다.(굉장히 너무 많이 햇갈려서 수도없이 질문을 claude, gpt에게 했었다;;)
- Action chunk : [B, L, d]
- L: 액션 청크 길이 (미래 몇 frame까지 로봇이 액션을 예측하는가?) → 여기서는 16
- d: 로봇의 dof가 되겠다 → PushT는 (x, y) 2
- 여기서 먼저 Time을 정의한다. Time은 Beta distribution에서 0~1 사이 연속값을 샘플마다 하나씩 뽑는다 → t
[B]- (수정) 처음에 “denoise time step 10 개 중 하나” 라고 생각했는데 아니다. 10 step 은 추론 (Euler) 에서만 쓰는 것이고, 학습 때 t 는 0.734, 0.21 같은 아무 실수다. 그래서 재학습 없이 추론 step 수를 5, 20 으로 바꿔도 된다.
- Action chunk : [B, L, d]
- x_t = t * noise + (1-t) * action → linear interpolation 으로 x_t 를 0~1 사이 어떤 t 에서든 정의할 수 있다. (t=1 이면 순수 noise, t=0 이면 정답 action)
- 여기서 시간에 따라 미분해주면 u_t = dx_t/dt = noise - action 즉 재미있게도 디노이즈 타임스텝과 독립적으로 일정하다는 사실이다!!! (noise → action 을 잇는 직선이니까 기울기가 일정)
- 이름 정리: u_t = 정답 속도 (데이터로 만듦), v_t = expert 가 예측한 속도. loss = MSE(v_t, u_t).
그렇다면, 직관적으로 생각하면 denoise time step마다 v_t(x_t, t) vs u_t 를 해야하는데 매번 정답 u_t는 어차피 동일한 것이다 ㅋㅋ (단, expert 입력인 x_t 는 t 마다 다르다. 같은 답을 서로 다른 위치에서 맞히는 연습) 그래서 이제 자세하게 위에 코드를 보면 beta distribution에서 시간을 임의로 하나 선택한다. 그게 이제 하단 코드였다. (utills.py 에 적어놓음)
1
2
3
4
5
6
7
#sample the time from the beta distribution.
def sample_time_beta(batch_size: int, device: str) -> torch.Tensor:
    '''
    beta distribution is a distribution that is defined on the interval [0,1].
    we use the beta distribution to sample the time from the interval [0,1].
    '''
    return torch.distributions.Beta(1.5,1.0).sample((batch_size,)).to(device) * 0.999 + 0.001
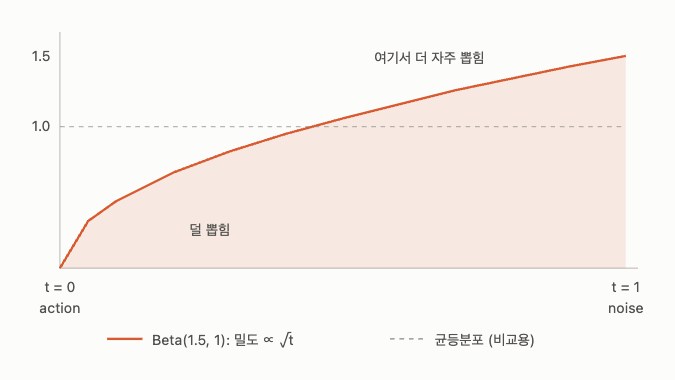
여기서 왜 굳이 uniform이 아니라 Beta(1.5, 1.0) 일까? 이 분포는 t 가 1 (노이즈) 쪽으로 더 자주 뽑히도록 기울어져 있다. 노이즈가 많을수록 어느 방향으로 가야할지 제일 모호한 구간이라, 어려운 문제를 더 많이 연습시키는 것. (π₀ 에서도 같은 아이디어로 Beta 분포를 쓴다) 그리고 * 0.999 + 0.001 은 t 가 정확히 0 이 나오는 것만 막는 안전장치.
자 그렇다면 이제 결국에 loss를 구할때는 denoise time step 10 번을 loop를 돌지 않는다는 사실이 핵심이다.
Q. 그러면 굳이 그냥 10개 denoise time. step 각각 v_t연산해서 에러 구하는게 더 정확한거 아닌가?
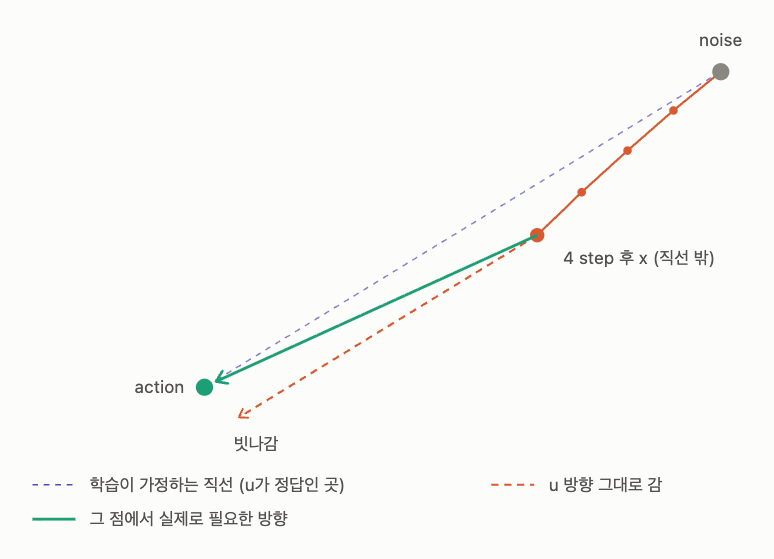
결론: 기대값으로는 같은 걸 학습한다. 랜덤 t 하나가 더 효율적이고, 고정된 10 개 t 는 오히려 손해다.
- loss 의 진짜 정의는 “모든 t 에 대한 평균” (기대값) 이다. 샘플마다 t 를 랜덤으로 하나 뽑는 건 그 평균을 동전 던지기로 추정하는 것 (Monte Carlo). batch 16 개가 서로 다른 t 를 뽑고, step 이 수천 번 반복되니까 결국 모든 t 를 골고루 연습하게 된다.
- 샘플 하나에 t 를 10 개씩 쓰면 계산이 10 배인데, 얻는 건 “같은 장면을 10 번 보는 것” 이다. 같은 계산이면 서로 다른 장면 10 개를 보는 게 더 이득이다 (batch 를 키우는 것과 비슷).
- 그리고 10 개를 고정된 값 (1.0, 0.9, …, 0.1) 으로 쓰면 그 10 개 지점에서만 속도를 배운다. 그러면 추론 step 수를 바꾸는 순간 (예: 20 step → t = 0.95 같은 처음 보는 지점) 성능이 떨어진다. 연속 t 로 학습해야 속도장 전체를 배운다.
- 마지막으로 하나 더. 정답 u_t 는 직선이라 일정하지만, expert 가 배우는 v_t(x_t, t) 는 일정하지 않다. 같은 x_t 를 지나는 (noise, action) 쌍이 여러 개라서 expert 는 그 평균 방향을 배우게 되고, 그래서 학습된 경로는 휘어 있다. 추론에서 한 번에 안 가고 10 step 으로 나눠 걷는 이유가 이거다.