ASPIRE - Agentic Skills Discovery for Robotics
NVIDIA ASPIRE 는 LLM 이 로봇 제어 코드를 직접 쓰고, 실패 원인을 추론해서 고치고, 검증된 해결법을 Skill Library 로 쌓는다. Closed-loop 실행 엔진, Evolutionary Search, Actor / Verifier / Coordinator 로 Skill 을 검증하는 과정까지 공개 저장소 설정과 함께 정리한다.
Reference
NVIDIA ASPIRE 공식 연구 페이지 · 논문 (arXiv 2607.00272) · 공식 GitHub
Overview
오늘은 NVIDIA의 ASPIRE: Agentic /Skills Discovery for Robotics 논문을 한번 깊게 살펴보자.
개인적으로 Agentic Workflow가 결국 로봇에도 적용될 거라고 생각해왔는데, ASPIRE는 이를 굉장히 직관적인 방식으로 구현한 연구다. LLM이 단순히 다음 Action을 예측하는 것이 아니라, 로봇을 제어하는 코드를 직접 작성하고, 실패하면 디버깅하고, 그 과정에서 얻은 지식을 다음 작업에 재사용한다.
처음 그림을 봤을 때는 Skill과 Policy가 헷갈렸다. 그래서 이번에는 Primitive API부터 시작해서 Policy π, 실행 로그, Evolutionary Search, Skill Library까지 한 단계씩 연결해서 이해해보려고 한다.
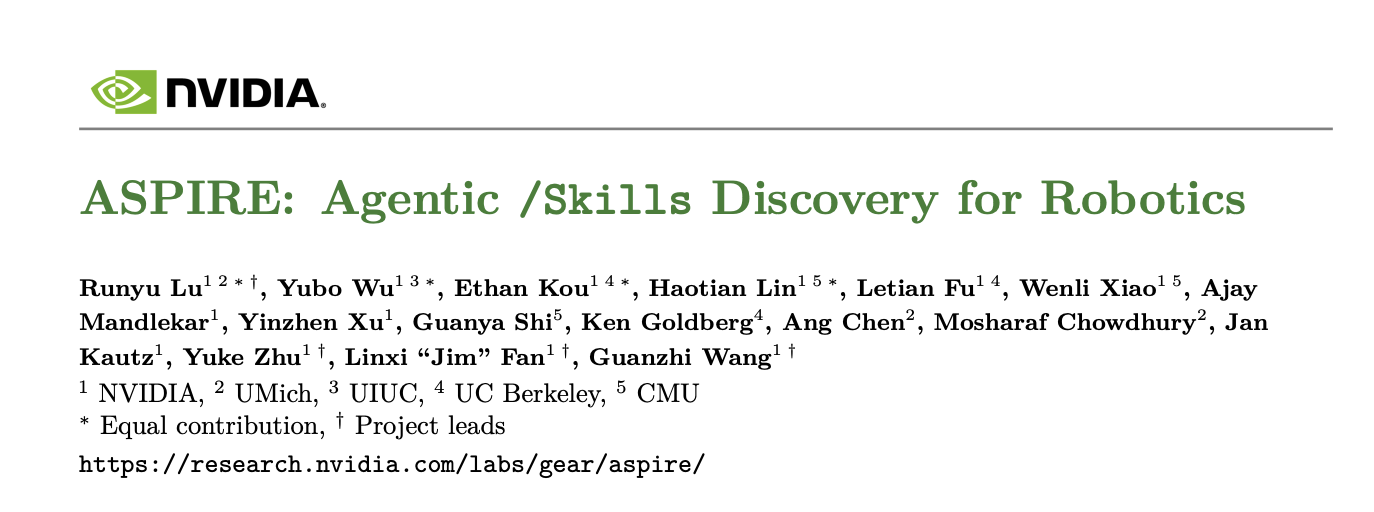
최근에는 공간 정보를 다루고 코드를 생성할 수 있는 강력한 멀티모달 LLM이 등장하면서, 이를 로봇 Policy 개발에 어떻게 활용할지에 관한 연구도 많아지고 있다. 그렇다면 이미 코딩과 추론에 강한 LLM을 로봇 시스템 안에서 어떻게 구조화하는 것이 효율적일까? ASPIRE는 이 질문에 대한 하나의 답이다.
먼저 핵심 세 가지
- Closed-loop Robot Execution Engine: 코드를 실행하고, 무엇이 잘못됐는지 상세하게 기록한다.
- Continually Expanding Skill Library: 검증된 해결 방법을 재사용 가능한 지식으로 축적한다.
- Evolutionary Search: 하나의 코드만 고치는 것이 아니라 다양한 후보 프로그램을 탐색한다.
이 세 가지를 이해하면 전체 논문의 구조가 거의 보인다.
- 1. Problem Definition — 왜 이런 방식이 필요한가?
- 2. Architecture — 전체 시스템의 세 가지 계층
- 3. Closed-loop Robot Execution Engine
- 4. Iterative Debugging — 하나의 Policy를 계속 개선하기
- 5. Evolutionary Search — 여러 π를 동시에 탐색한다
- 6. Skill Library — 성공 경험이 어떻게 지식으로 바뀔까?
- 7. Experiments — 정말 효과가 있을까?
- 8. 한계와 생각해 볼 점
- 9. 개인적인 결론
1. Problem Definition — 왜 이런 방식이 필요한가?
먼저 왜 이 방식을 연구하기 시작했을까?? 기존 VLA에서는 카메라 이미지, 로봇 상태, 언어 명령을 입력하고 신경망이 Action을 예측하도록 학습한다. 이를 위해 인간 시연 데이터를 수집하고, 필요하면 Fine-tuning이나 RL을 진행한다.
ASPIRE는 접근이 다르다. 로봇에는 이미 물체 인식, Grasp Planning, Motion Planning, 그리퍼 제어 같은 여러 기능이 구현되어 있을 수 있다. 그렇다면 이 기능들을 어떤 순서와 조건으로 실행할지는 이미 논리를 대규모로 학습한 거대한 LLM이 코드로 작성할 수 있지 않을까?
중요한 건 LLM이 VLA보다 저수준 제어에 본질적으로 뛰어나다는 주장이 아니다. LLM의 코드 생성·추론·디버깅 능력을 로봇 작업 수행에 활용한다는 것이 핵심이다.
2. Architecture — 전체 시스템의 세 가지 계층
전체 흐름을 단순화하면 다음과 같다.
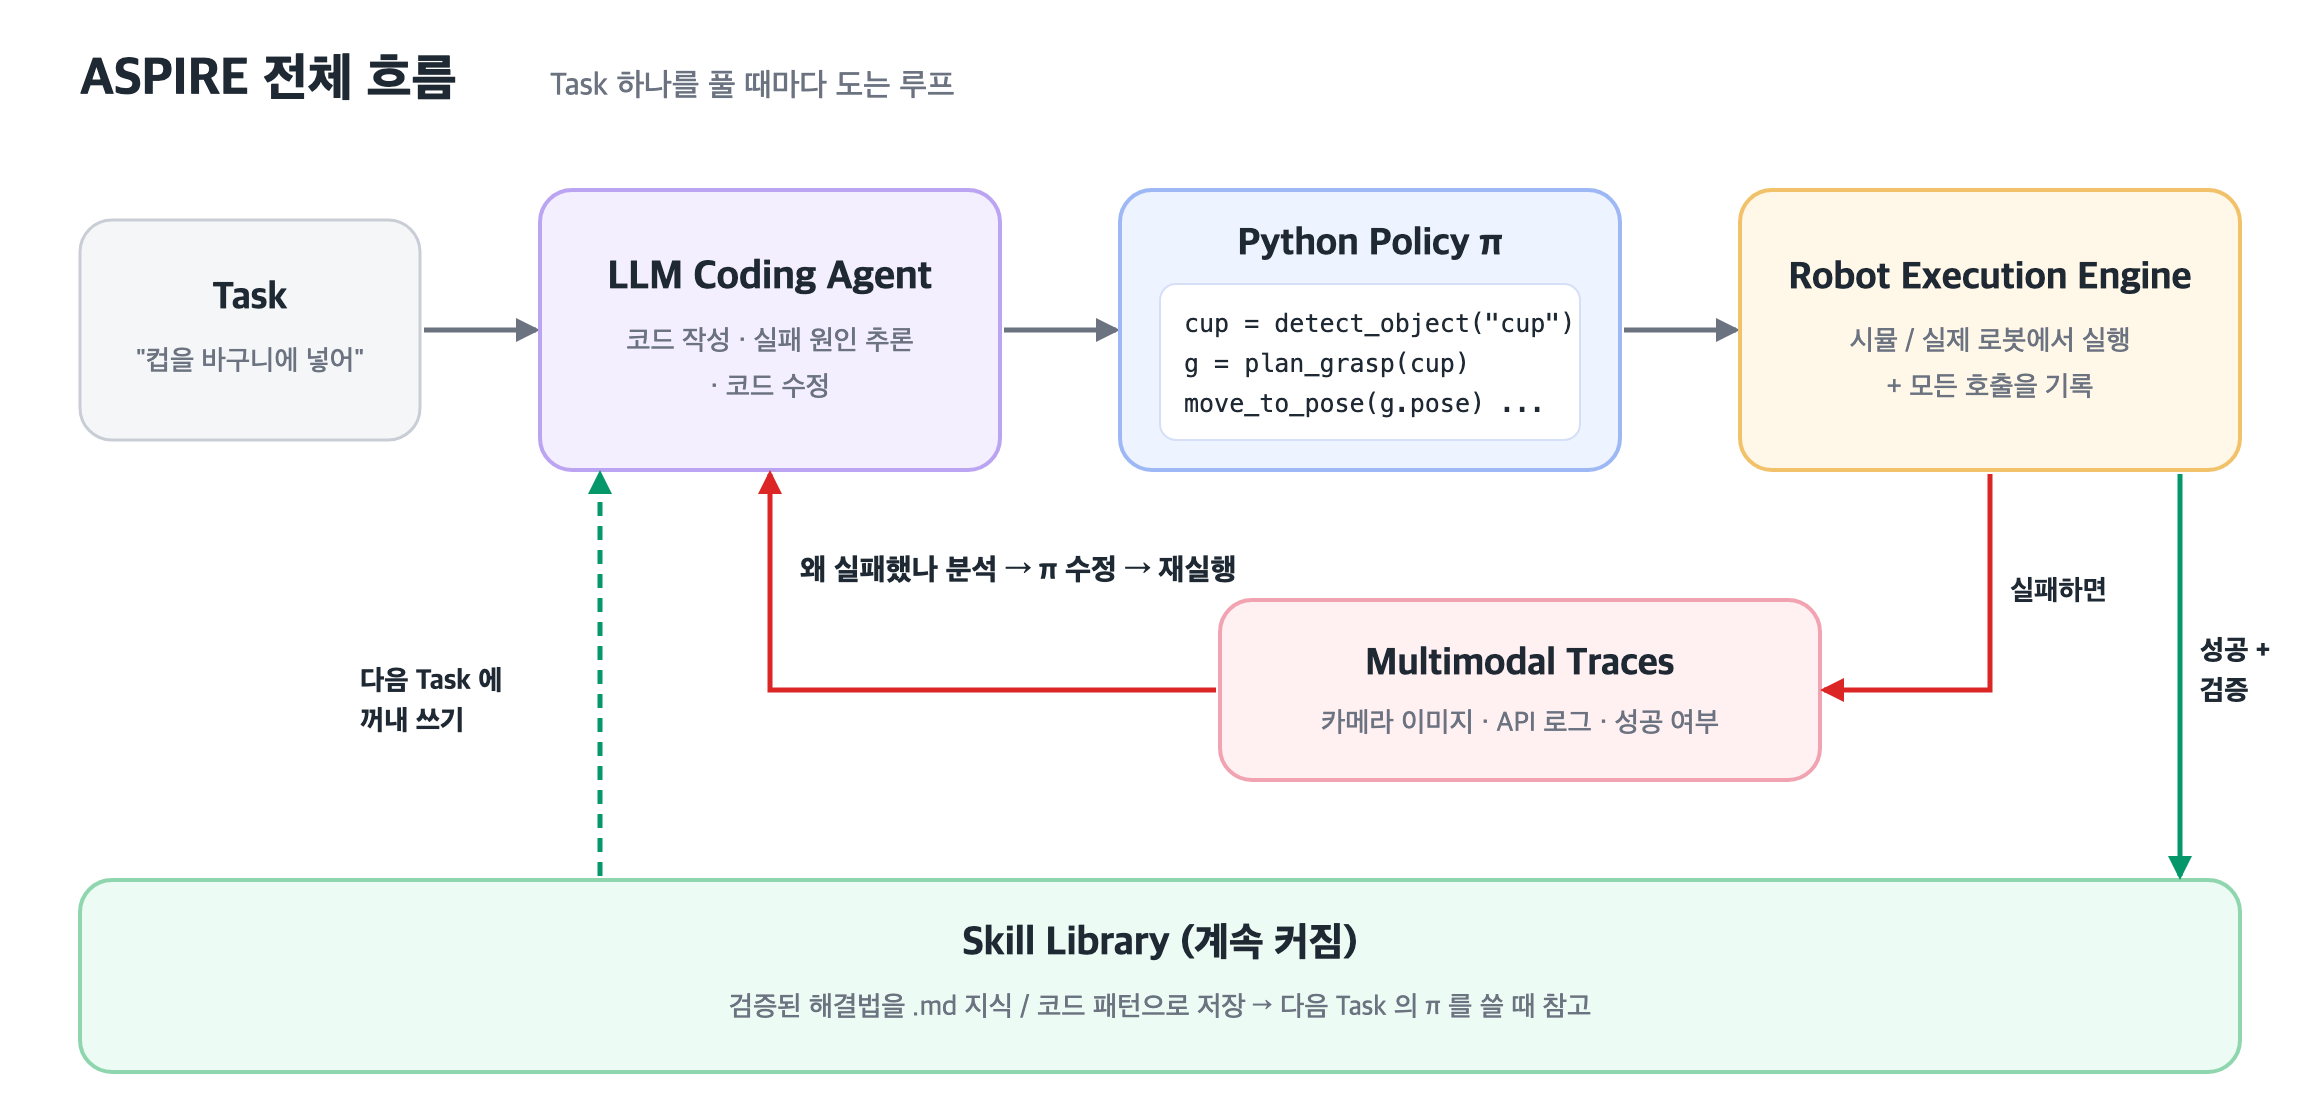
실패하면 빨간 화살표처럼 다시 Coding Agent 로 돌아가서 코드를 고치고, 성공해서 검증까지 통과한 해결법은 초록 화살표처럼 Skill Library 에 쌓인다. 그리고 다음 Task 를 풀 때 이 Library 를 꺼내 쓴다. 이 루프 하나가 ASPIRE 전체다.
여기서 Policy를 작성하는 Agent와 실제로 프로그램을 실행하는 Engine은 구분된다. 로봇 동작이 실패하면 Engine이 프로그램을 자동 수정하는 것이 아니라, 실행 정보를 받은 Coding Agent가 수정안을 작성한다.
3. Closed-loop Robot Execution Engine
3-1. Primitive API는 사전에 구현되어 있다
예를 들어 다음과 같은 함수가 있다고 생각해보자.
1
2
3
4
5
detect_object()
plan_grasp()
move_to_pose()
open_gripper()
close_gripper()
이것들은 개념을 설명하기 위한 함수명이다. 실제 ASPIRE의 API 명세와 정확히 동일하다는 뜻은 아니다.
중요한 건 이 함수들 내부에 Perception, Grasp, Motion Planning, Control 등의 기능이 이미 존재한다는 사실이다. LLM은 이 API를 호출해서 전체 작업을 수행할 프로그램을 만든다.
그렇다면 LLM이 SAM3의 네트워크나 IK Solver 자체를 수정하는가? 기본적인 ASPIRE 설정에서는 아니다. 사전에 제공된 Primitive API 내부 구현은 고정되고, LLM이 작성하는 것은 그 위의 상위 제어 로직이다.
공개 저장소를 보면 실제로 이 도구들은 별도 서비스로 떠 있다. 물체 인식은 SAM3, grasp 후보는 Contact-GraspNet, IK 는 PyRoki 가 각각 GPU 한 장씩 차지하고 돌아가고, LLM 이 짠 프로그램은 이걸 API 로만 부른다. 재밌는 건 규칙이 꽤 빡빡하다는 거다. 프로그램은 시뮬레이터 내부 상태 (물체의 정답 위치 같은) 에 직접 접근하면 안 되고, numpy 같은 라이브러리 import 도 못 한다. 실제 로봇에서도 얻을 수 있는 정보만으로 풀라는 뜻이다.
3-2. Policy π는 정확히 무엇일까?
π는 ASPIRE에서 LLM이 생성한 실행 가능한 로봇 제어 프로그램이라고 생각하면 된다. 기존 RL에서 쓰는 πθ라는 신경망 Policy와는 표현 방식이 다르다.
예를 들어 컵을 집어서 바구니에 넣는 최초 프로그램 π₀는 이런 모습일 수 있다.
1
2
3
4
5
6
7
8
cup = detect_object("cup")
basket = detect_object("basket")
grasp = plan_grasp(cup)

move_to_pose(grasp.pose)
close_gripper()
move_to_pose(basket.place_pose)
open_gripper()
실패했다면 LLM이 조건문과 반복문을 추가해 새 Policy π₁을 작성할 수 있다.
1
2
3
4
5
6
7
grasps = plan_grasp(cup)
for grasp in grasps:
    move_to_pose(grasp.pose)
    close_gripper()
    if verify_grasp():
        break
    open_gripper()
둘 다 설명용 의사코드다. π₁이 단순히 다른 함수 조합인 것뿐 아니라, 상태에 따라 행동이 달라지는 새로운 알고리즘이라는 점이 중요하다.
3-3. 왜 Closed-loop일까? — Multimodal Traces
로봇이 실패했을 때 Task failed라는 한 줄만 있으면 원인을 찾기 어렵다. 그래서 ASPIRE의 Engine은 Primitive 호출의 입력·출력, 중간 이미지, 실행 결과 등 여러 형태의 정보를 기록한다.
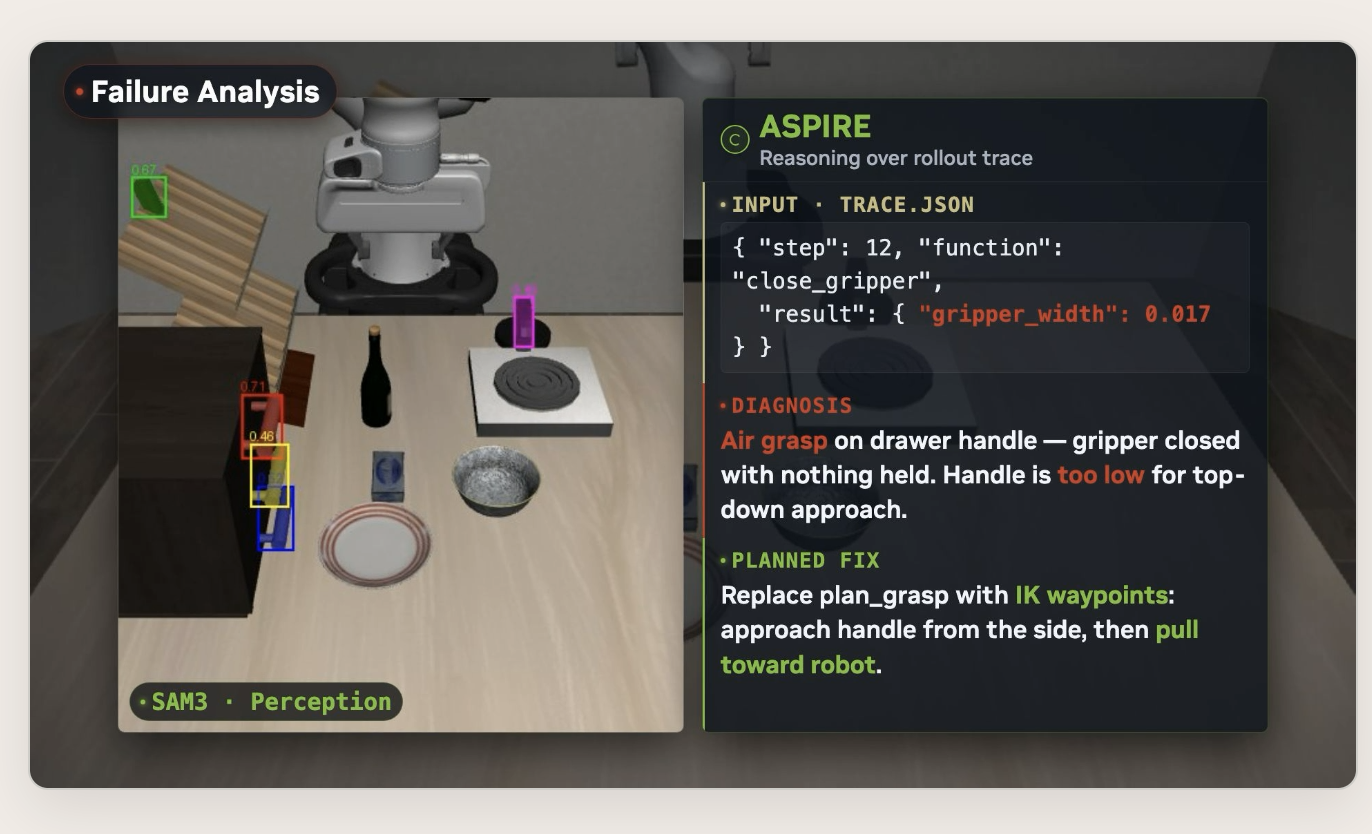
예를 들어 move_to_pose()는 성공했고 close_gripper()도 실행됐지만 컵을 잡지 못했다고 해보자. 함수 호출이 정상 종료됐다고 작업이 성공한 것은 아니다. LLM은 3인칭 이미지, 물체 상태, API 로그, Task Evaluator의 결과 등을 함께 보면서 원인을 추론해야 한다.
성공 판별기(Evaluator)는 목표 달성 여부를 판단하고, Coding Agent는 관측 정보와 로그를 통해 왜 실패했는지 분석한다. 이 둘의 역할은 다르다.
이제 ‘Closed-loop’라는 이름이 이해된다. 단순히 코드를 생성하고 끝내는 것이 아니라 실행 → 관찰 → 실패 분석 → 코드 수정 → 재실행이라는 피드백 루프가 있기 때문이다.
솔직히 이 부분은 글로만 보면 한 번에 이해가 안 된다. 그림으로 보자.
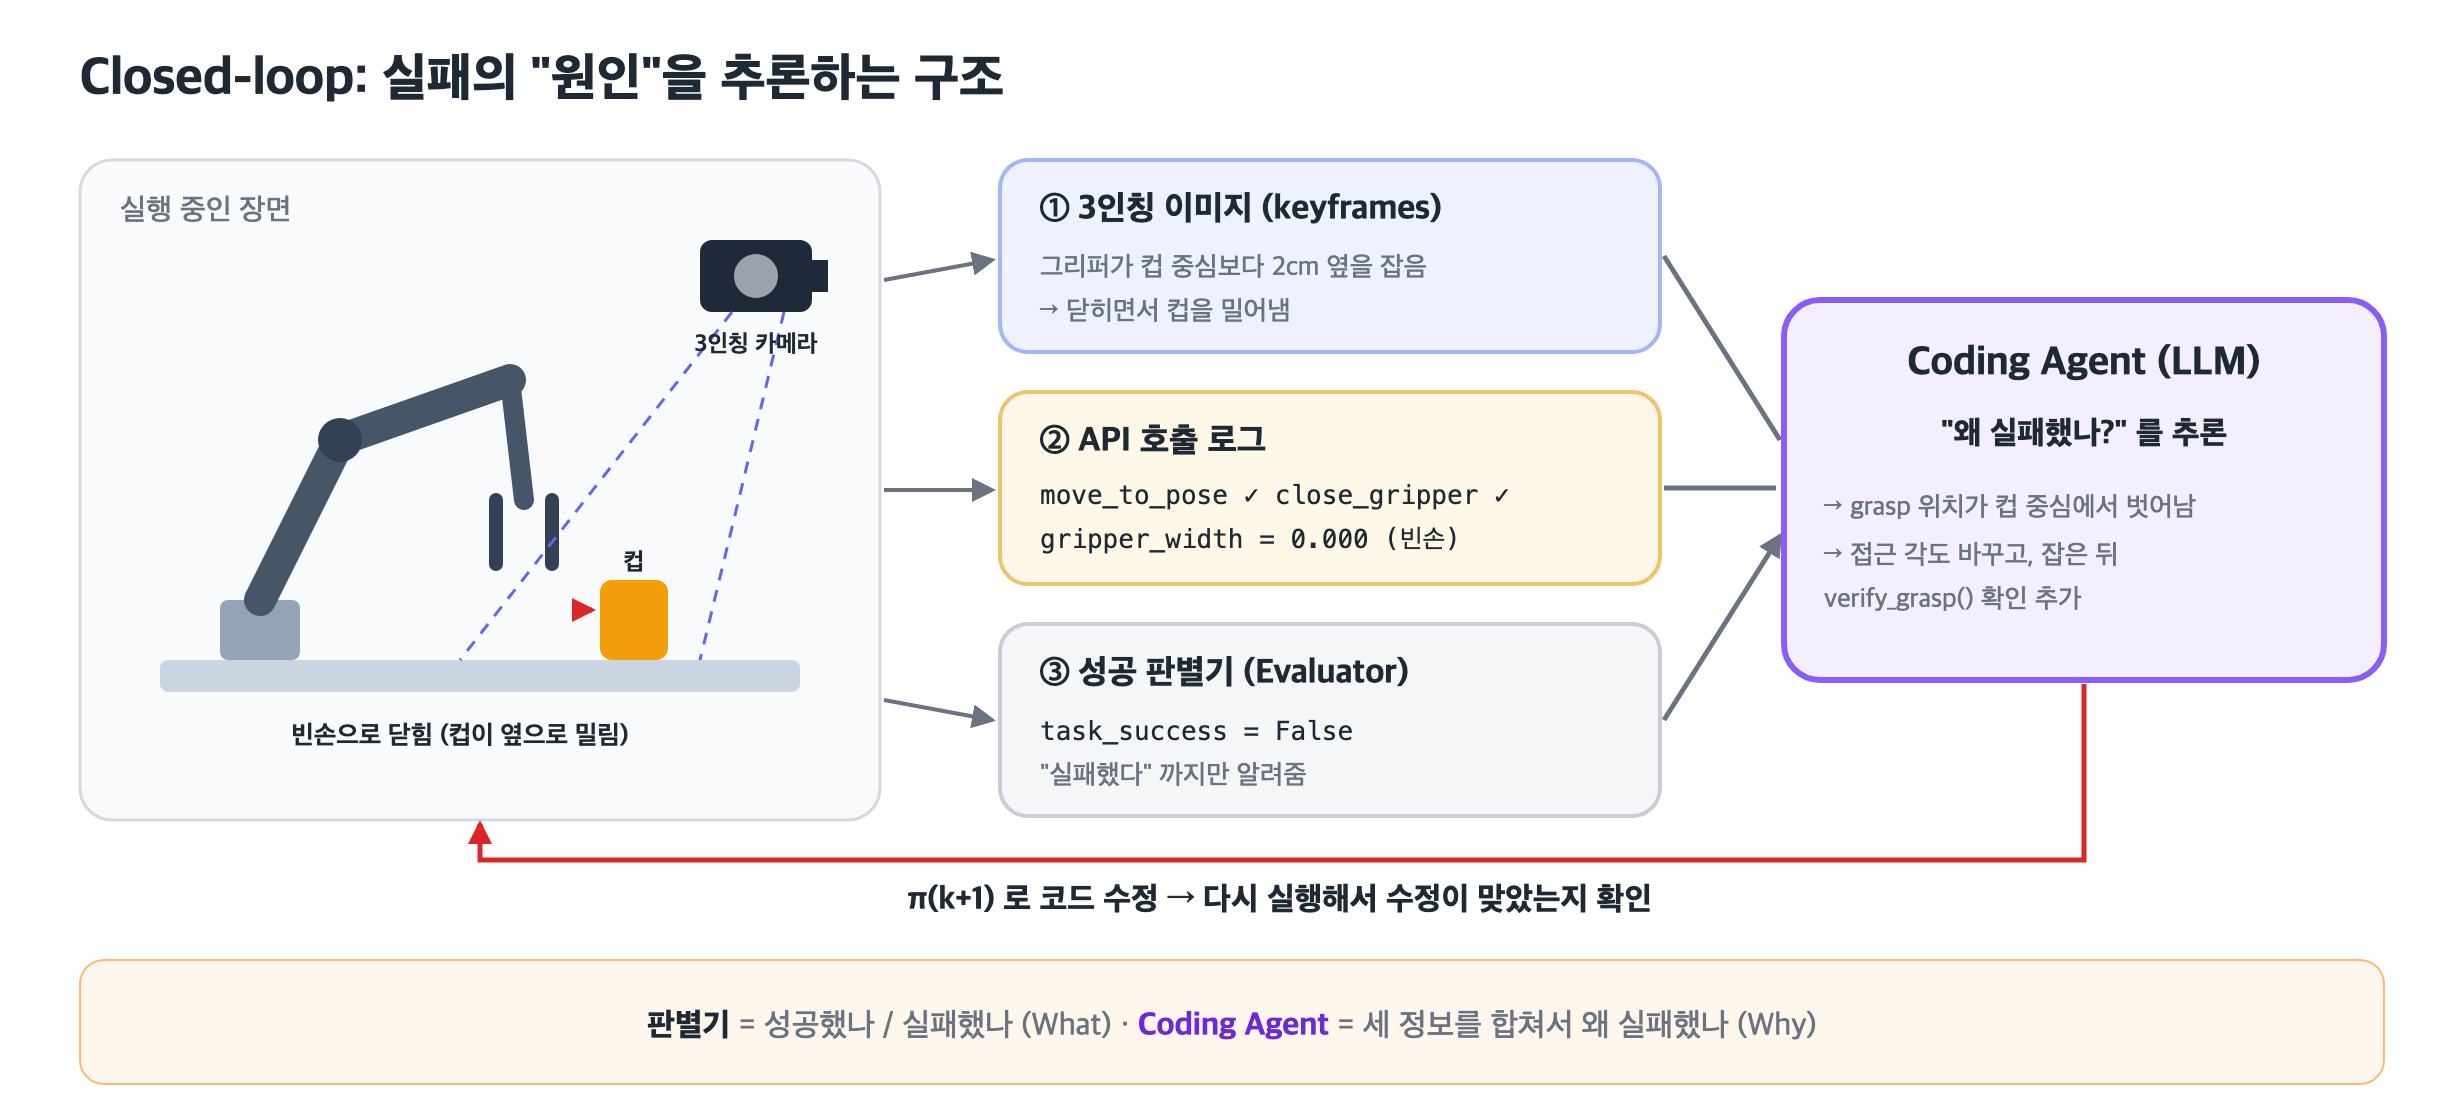
정보는 세 군데서 들어온다.
- 3인칭 카메라 이미지: 로봇 밖, 제3의 위치에서 장면을 찍은 keyframe 이다. “그리퍼가 컵 중심보다 옆을 잡았다” 같은 걸 눈으로 확인할 수 있다.
- API 호출 로그: 어떤 함수가 어떤 입력으로 불렸고 뭘 돌려줬는지. “close_gripper 는 정상 종료됐는데 그리퍼 폭이 0 → 빈손” 같은 것.
- 성공 판별기 (Evaluator): 목표를 달성했나 못했나. 딱 성공 / 실패만 알려준다.
여기가 핵심이다. 판별기는 “실패했다” (What) 까지만 알려준다. Coding Agent 는 이 세 가지를 합쳐서 “왜 실패했나” (Why) 를 추론한다. 단순히 성공 / 실패를 보는 게 아니라 원인을 찾아내는 역할이고, 그 원인을 바탕으로 다음 코드를 고친다.
4. Iterative Debugging — 하나의 Policy를 계속 개선하기
최초 프로그램을 π₀라고 하자. 실행 로그를 T₀, 목표를 G라고 하면, 다음과 같이 개념적으로 표현할 수 있다.
LLM이 원인을 잘못 판단할 수도 있다. 예를 들어 Grasp 자세가 문제라고 생각했는데 실제로는 물체와 그리퍼의 마찰 조건 때문일 수도 있다. 따라서 LLM의 추론이 정답이 되는 것이 아니라, 다시 실행한 결과가 수정안의 타당성을 판단한다.
4-1. 한 번의 iteration 에서 실제로 하는 일
그럼 한 iteration 에서 정확히 뭘 하고, 다음 iteration 으로 넘어갈 때 뭘 바꿀까? 논문 본문만으로는 잘 안 보여서 공개 저장소 (Fix Loop 설정) 를 직접 열어봤다.
- 개발용 seed 51–65 (15 개 장면) 에서 현재 π 를 전부 돌린다. seed 하나만 보고 고치면 그 장면에만 맞춘 코드가 되니까.
- 실패한 run 의 keyframe 과 로그를 읽고, seed 별이 아니라 실패 유형 별로 묶어서 고친다. (예: “그릇을 놓치는 유형”, “선반에 팔이 걸리는 유형”)
- 고친 버전은 다시 15 개 seed 전부에서 점수를 매긴다. 일부 seed 만 좋아지고 다른 seed 가 깨지는 걸 잡기 위해서다.
- 최종 버전을 고르면 한 번도 안 본 unseen-check seed 66–80 에서 한 번 확인하고, 최종 점수는 held-out seed 1–50 에서 따로 낸다.
즉 “다음 iteration 에서 뭘 수정하나?” 의 답은 코드 (π) 자체이고, 판단 기준은 개발 seed 에서의 통과율이다. 여러 π 를 동시에 만드는 기준은 바로 다음 5 장에서 이어진다.
5. Evolutionary Search — 여러 π를 동시에 탐색한다
여기서부터가 개인적으로 가장 재밌는 부분이다.
Iterative Debugging은 π₀ → π₁ → π₂처럼 하나의 프로그램을 계속 수정한다. 하지만 첫 번째 접근이 잘못된 전략에 갇혀 있다면 계속 디버깅해도 해결하지 못할 수 있다.
그래서 ASPIRE는 여러 후보 프로그램 π₀, π₁, …, πₖ를 생성하고, 각각을 실행·개선하면서 다양한 해결 방법을 탐색한다.
π₀: 정면에서 손잡이를 잡기π₁: 측면에서 손잡이에 접근하기π₂: 손잡이 위치를 다시 인식한 뒤 잡기
각 후보는 단순한 Action Sequence가 아니라 Primitive API 호출, 조건문, 반복문, 기존 Skill의 활용 등을 담은 하나의 코드 기반 Policy다.
영상을 보면 여러 Policy가 병렬적으로 탐색되는 과정을 볼 수 있다. 처음 봤을 때는 닥터 스트레인지가 수많은 미래를 미리 살펴보는 장면이 떠올랐다. 비슷한 직관은 있지만, 정확히는 시뮬레이션과 평가 환경에서 여러 후보 제어 프로그램을 실험하는 것이다.
여기서 주의할 점이 있다. ‘가장 확률이 높은 Policy 하나를 선택해서 곧바로 실제 로봇에 실행한다’는 뜻은 아니다. 후보를 테스트하고 디버깅하는 과정과 평가용으로 선택된 프로그램을 실제 환경에서 실행하는 단계는 구분해야 한다. 또 모든 후보가 한 번씩 실행되는 것이 아니라, 탐색 전략과 예산에 따라 평가가 진행된다.
5-1. 후보 π 는 어떤 기준으로 만들고, 다음 세대에선 뭘 바꾸나
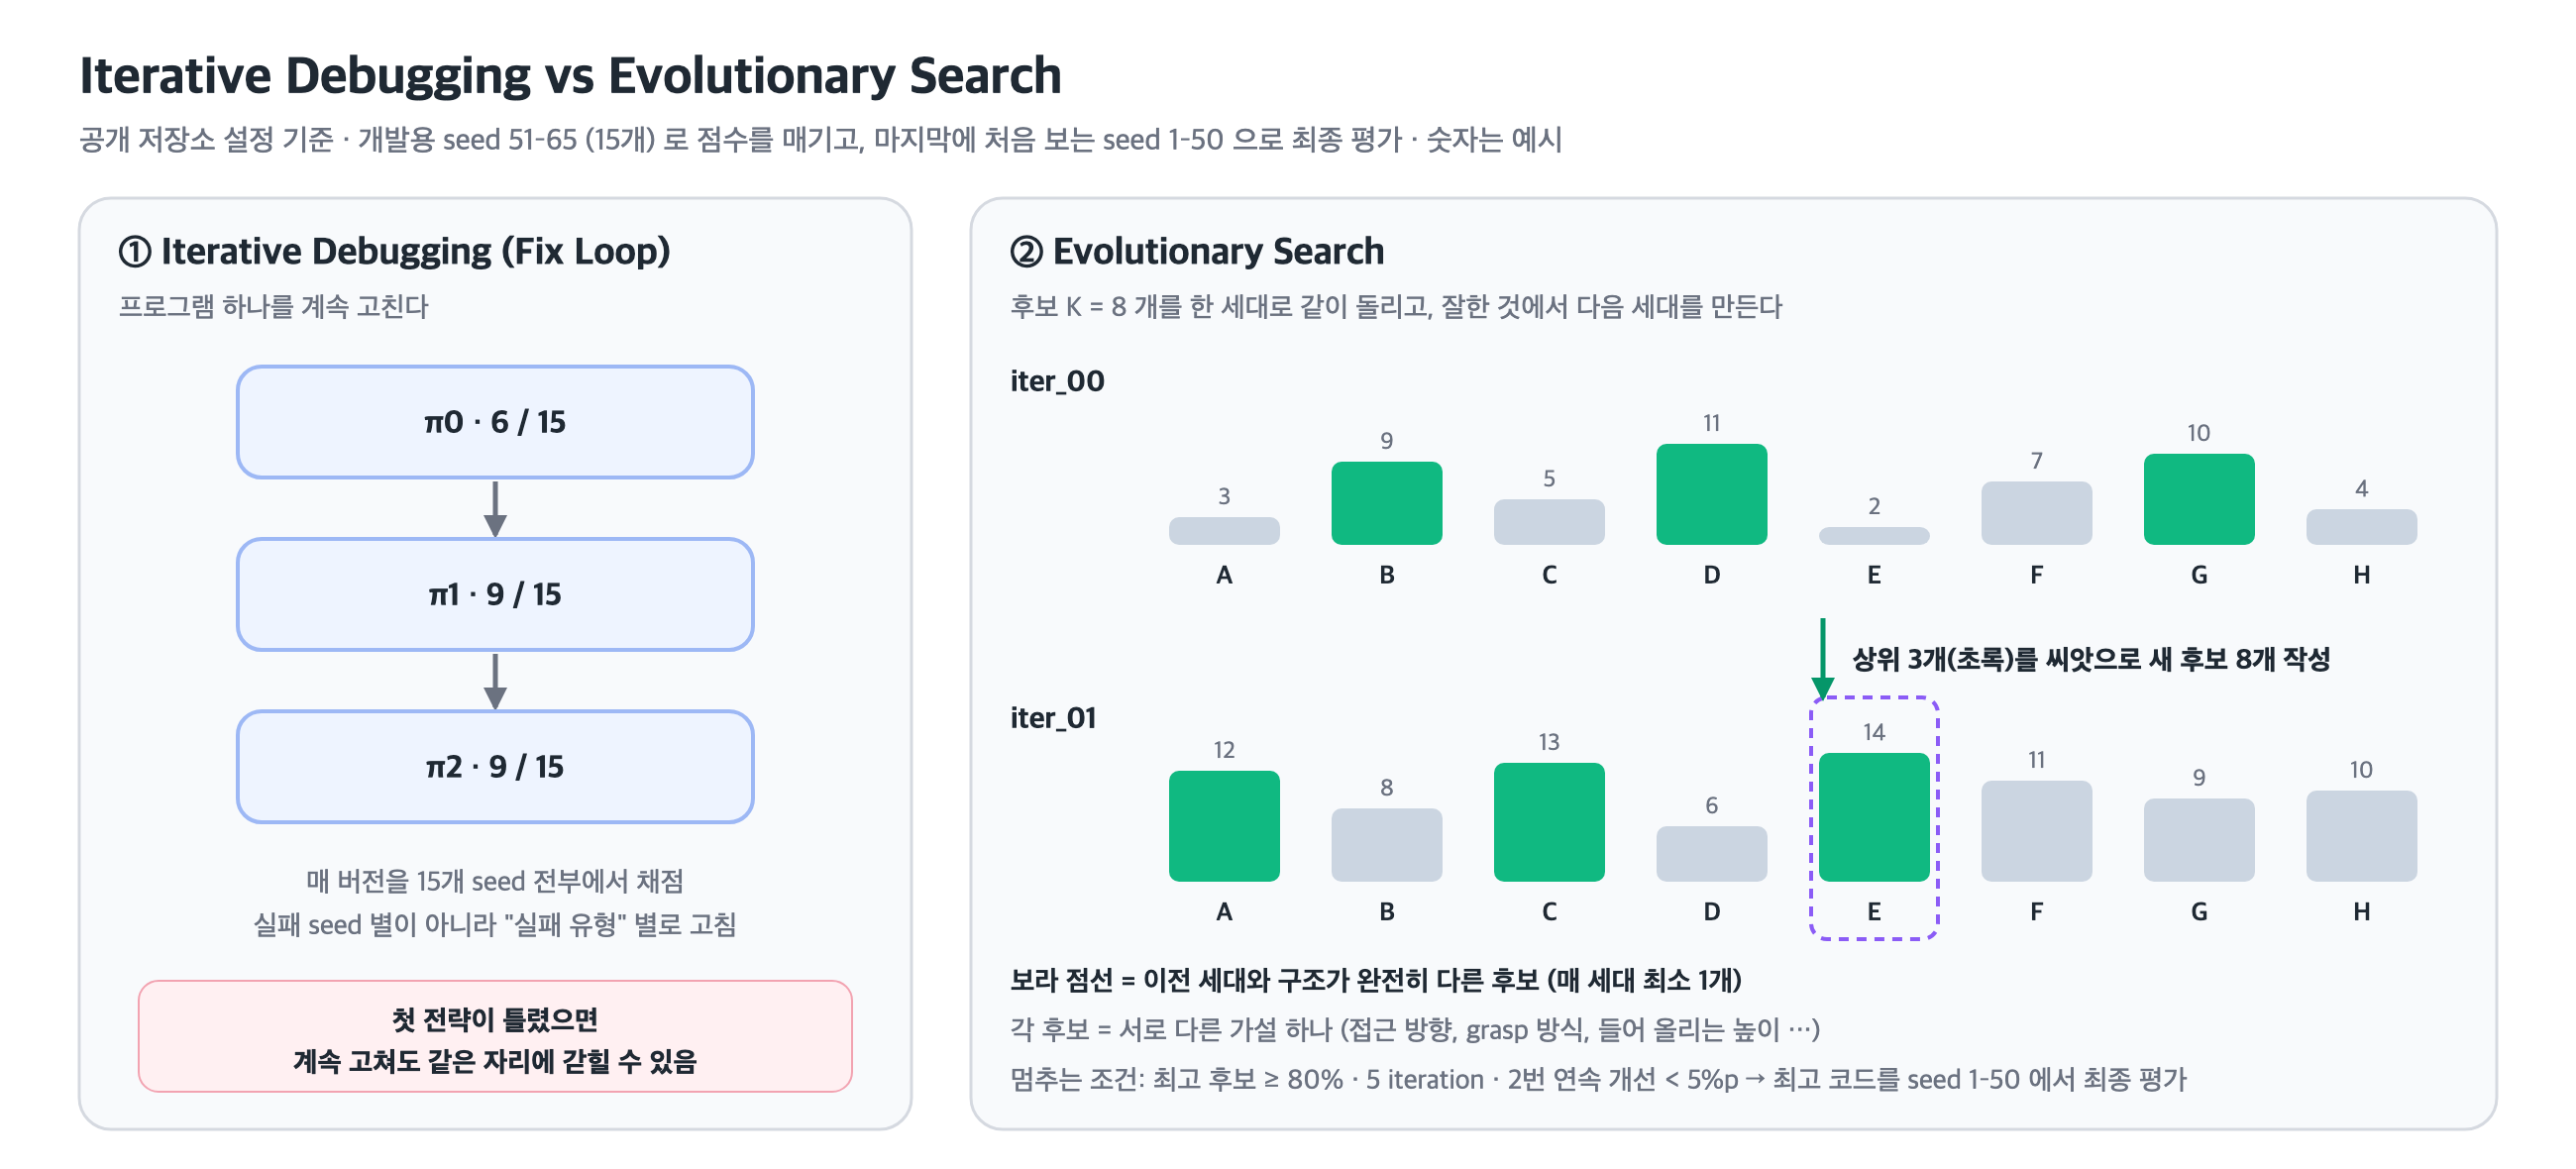
공개 저장소의 Evolutionary Search 설정을 보면 규칙이 꽤 명확하다.
- 시작 전 (iter_00 이전): 장면 스냅샷을 찍어서 보고
task_analysis.md를 먼저 쓴다. 물체 모양, 잡는 방법, 놓을 곳의 형태, 놓는 방법, 그리고 확인해볼 가설까지 5 가지를 적는다. 이걸 안 쓰고 후보부터 쓰는 건 금지다. - 후보 8 개 (K = 8): 각 후보는 서로 다른 가설 하나를 시험해야 한다. 접근 방향, grasp 방식, 들어 올리는 높이 같은 것. 두 후보가 같은 단계에서 같은 이유로 실패하면 하나는 낭비라는 기준이다. 그리고 Fix Loop 에서 나온 최고 코드는 그대로
candidate_A로 들어가서 “이겨야 할 기준선” 이 된다. - 평가: 후보 8 개 × 개발 seed 15 개를 다 돌려서 점수 표를 만든다.
- 다음 세대: 실패 영상을 다 읽고 원인을 정리해서
task_analysis.md를 업데이트한다. 확실히 틀린 방법은 “Eliminated” 로 적어두고 다시 시험하지 않는다. 그리고 지금까지의 상위 3 개를 씨앗으로 새 후보 8 개를 쓰는데, 최소 1 개는 이전과 구조가 완전히 다른 후보여야 한다. - 멈추는 조건: 최고 후보가 개발 seed 에서 80% 이상 / 5 iteration 도달 / 2 번 연속 개선이 5%p 미만. 그 다음 최고 코드를 held-out seed 1–50 에서 최종 평가한다.
그러니까 진화 (Evolutionary) 라는 이름이 딱 맞다. 잘한 후보가 살아남아서 다음 세대의 부모가 되고, 일부러 돌연변이 같은 새 후보를 하나씩 섞는다. (숫자들은 공개 저장소 설정 기준이고, 실험마다 다를 수 있다.)
6. Skill Library — 성공 경험이 어떻게 지식으로 바뀔까?
먼저 Primitive API와 Skill의 차이를 구분하자. 그림으로 보면 세 층이다.
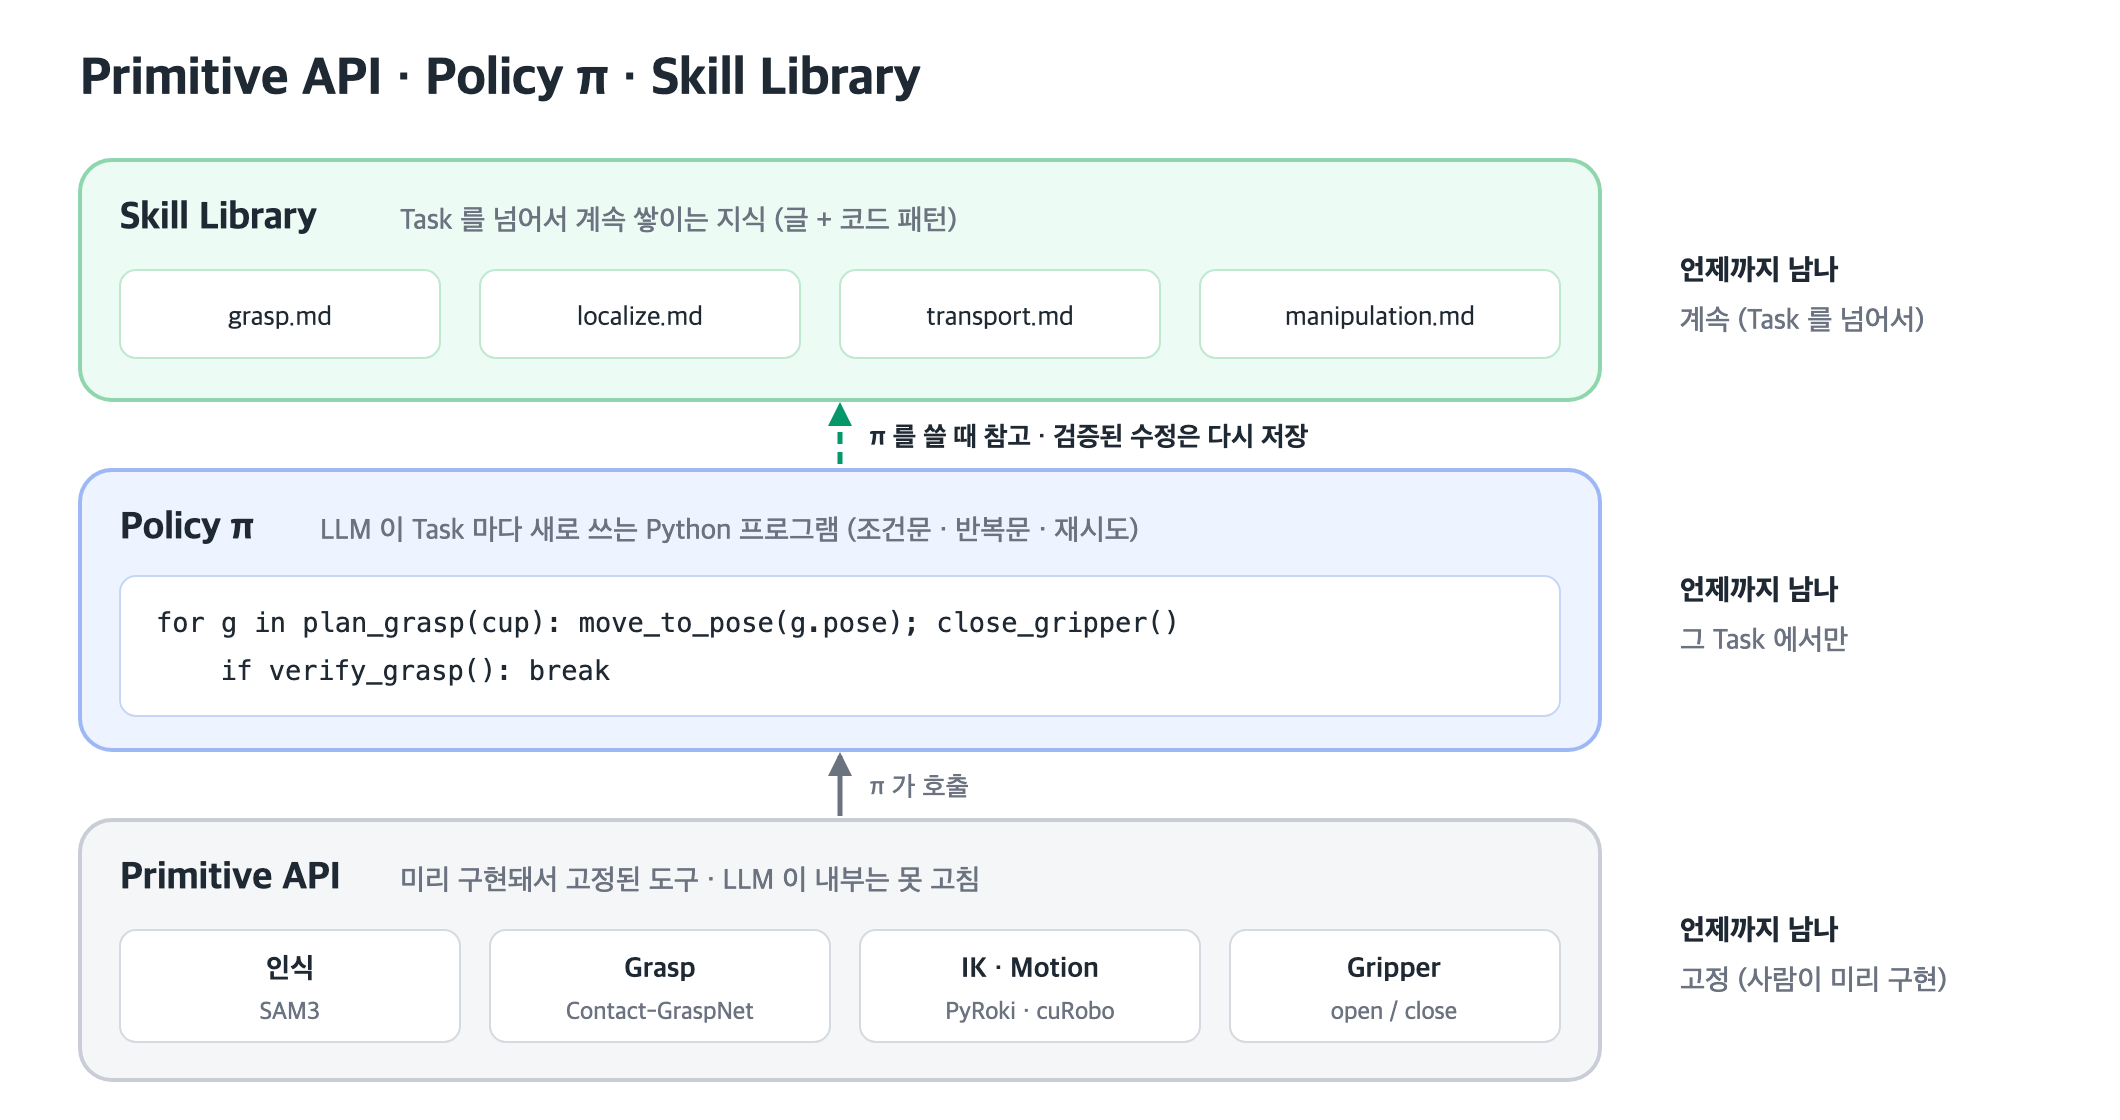
Primitive API는 이미 구현된 기본 도구다. 반면 Skill은 여러 작업을 해결하는 과정에서 얻은 재사용 가능한 절차, 코드 패턴, 실패 수정 전략 등의 지식이다.
처음에는 성공한 Policy의 연속된 API 호출 조각을 잘라서 저장하는 것이라고 생각했다. 하지만 정확히는 그것보다 넓다. 여러 Primitive를 묶은 코드 조각일 수도 있고, 특정 실패 상황에서 어떤 방식으로 접근해야 하는지 설명하는 텍스트 지침일 수도 있다. 검증된 전체 프로그램의 패턴을 재사용할 수도 있다.
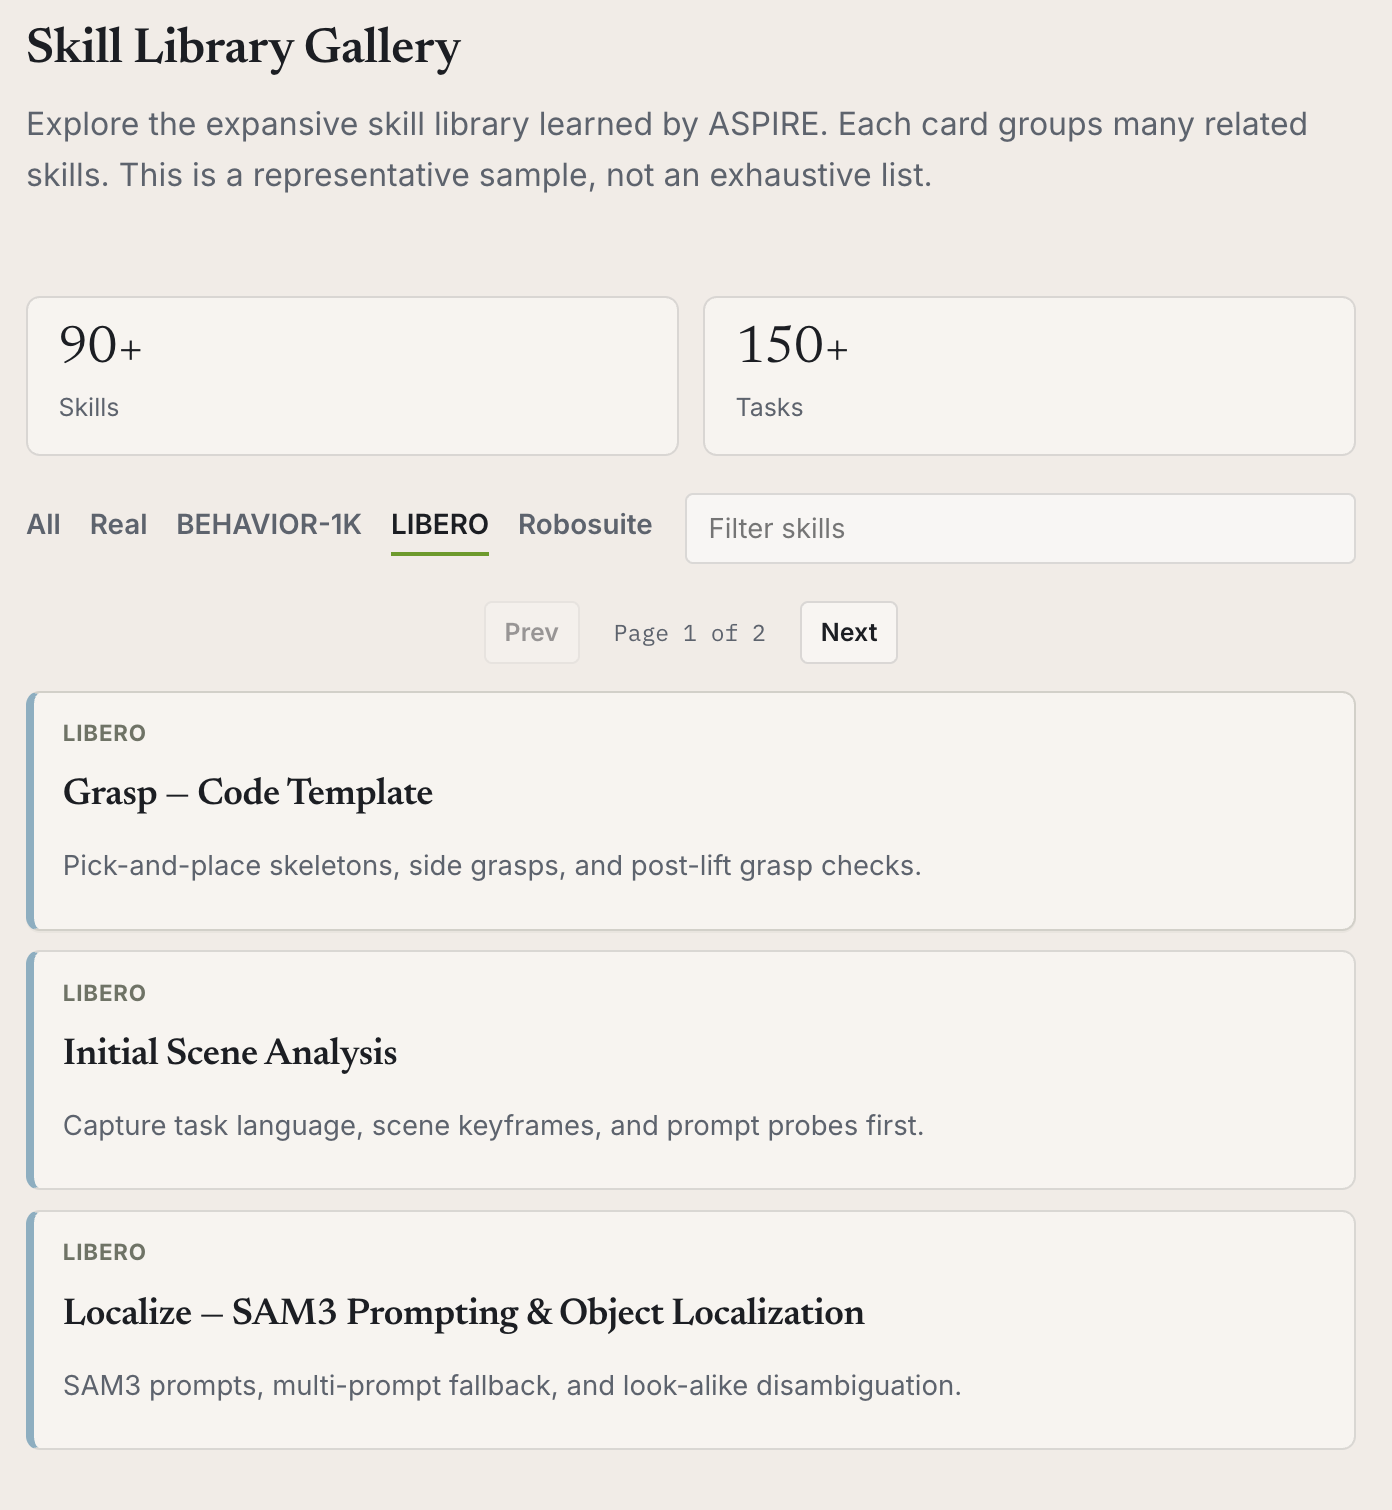
공식 Skill Gallery는 이러한 지식이 카테고리별로 정리돼 있음을 보여준다. 일종의 로봇용 .md Skill 문서처럼 다음 Coding Agent가 읽고 활용하는 것이다. 실제로 저장소에는 grasp.md, localize.md, transport.md, manipulation.md 같은 파일로 들어가 있다. Claude Code 의 skill 이랑 거의 같은 모양인 것을 알 수 있음.
6-1. 누가 Skill을 제안하고, 누가 검증하는가?
나도 솔직히 이 부분이 처음에는 헷갈렸다. 성공한 Policy가 있는데 왜 다시 검증해야 할까?
공개된 ASPIRE의 Iterative Debugging 구현에서는 역할이 나뉜다.
① Actor Agent: 원래 Task를 해결하면서 유용한 Skill 후보를 제안한다.
② Verifier Agent: Actor가 작성한 성공 코드를 직접 보지 않고, 제안된 Skill과 Skill Library를 참고하여 같은 Task를 다시 해결해 본다.
③ Coordinator Agent: Verifier의 평가 보고서를 확인하고 검증된 Skill만 Library에 반영한다.
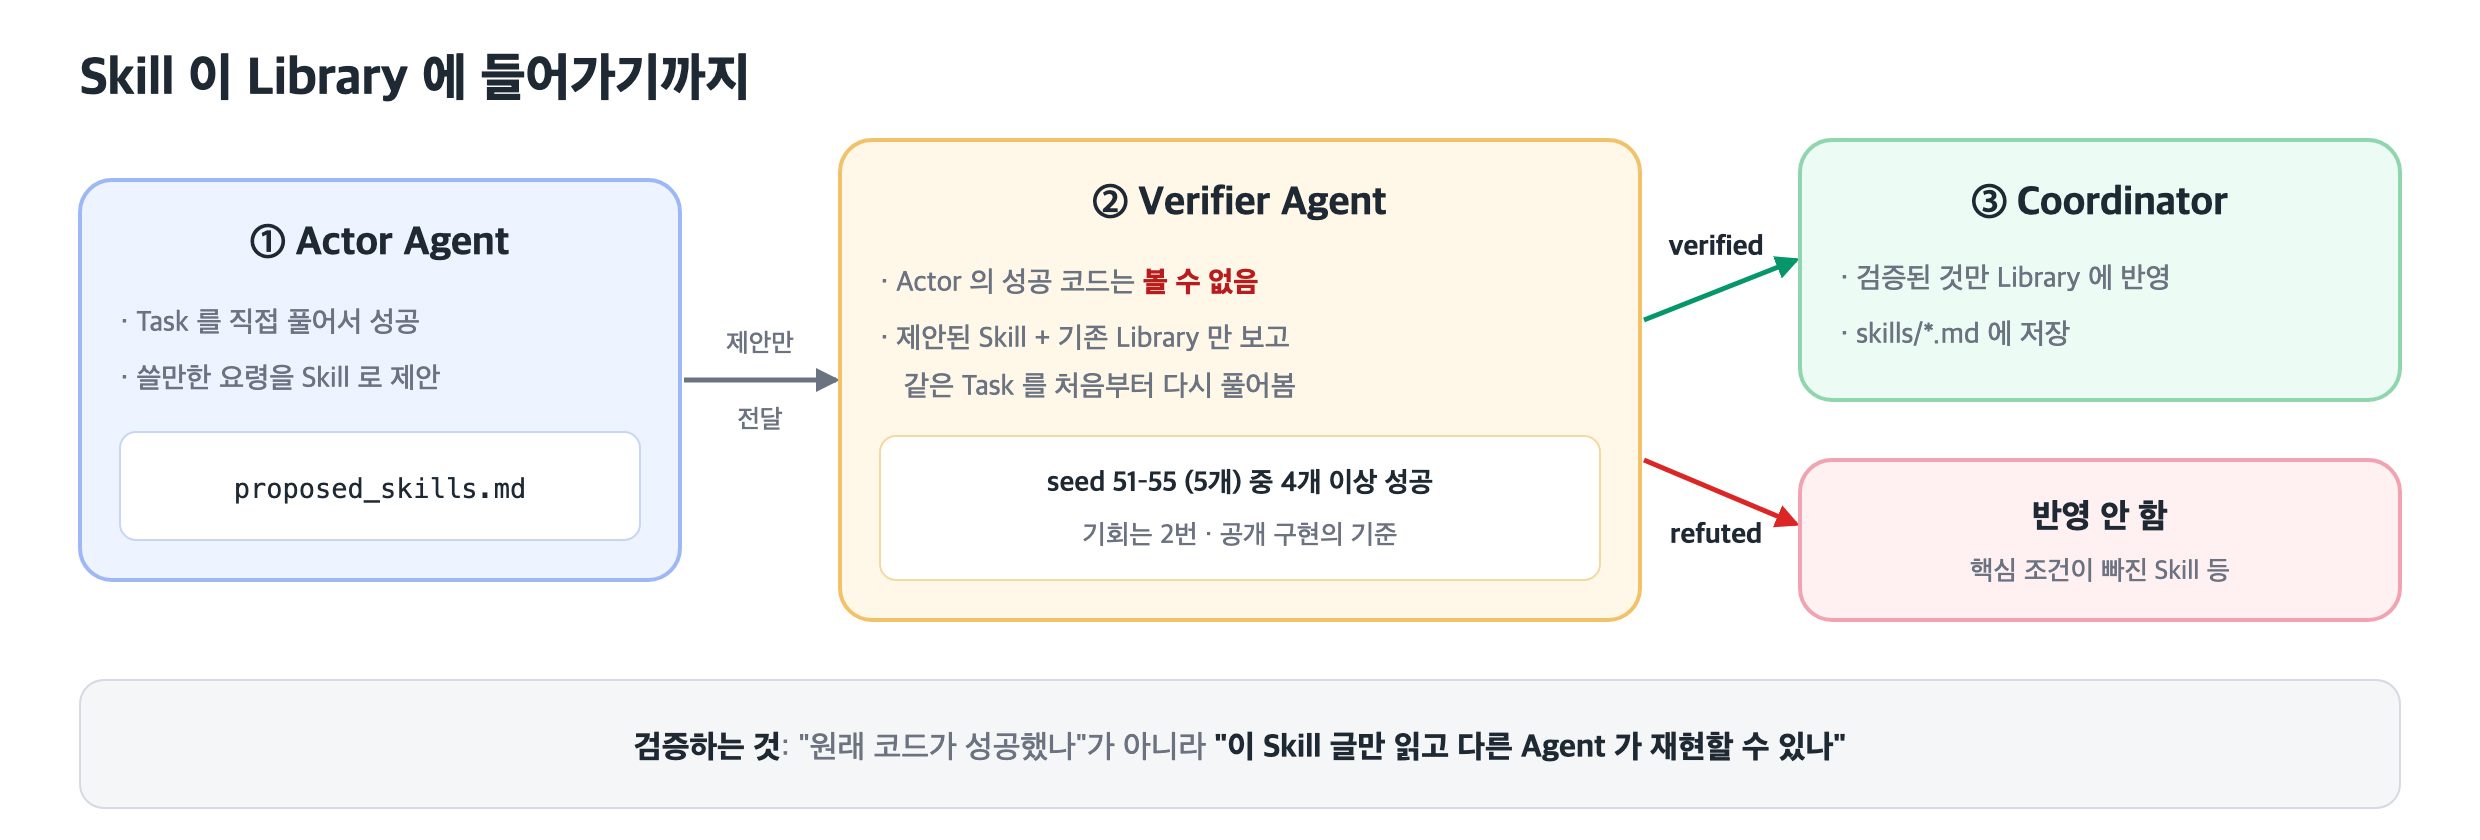
중요한 건 원래 프로그램이 성공했다는 것과, 그 프로그램에서 추출한 지식이 다른 Agent에게 전달 가능하다는 것은 다르다는 것이다.
예를 들어 Actor가 서랍을 여는 데 성공하더라도, ‘손잡이를 적절히 잡아라’라는 식으로 핵심 조건을 빠뜨린 Skill을 남겼다면 다음 Agent는 작업을 재현하지 못할 수 있다.
공개된 Verifier 설정의 예에서는 개발 seed 51–55, 5개 Seed 중 4개 이상 통과해야 Verified 판정을 받는다 (기회는 2 번). 단, 이는 해당 구현의 검증 프로토콜이지 ASPIRE의 모든 실험에 동일하게 적용되는 보편적인 기준은 아니다.
그리고 이 검증은 같은 작업에서 지식을 전달할 수 있는지 테스트하는 것이지, 완전히 새로운 작업에서도 일반화된다는 보장은 아니다. 그건 별도 Zero-shot Transfer 평가가 필요하다.
참고: Verifier 지침 · Coordinator 지침
6-2. Continually Expanding Skill Library의 의미
Task A에서 얻은 지식이 Task B의 초기 Policy를 작성하는 데 도움을 주고, Task B에서 얻은 또 다른 수정 전략이 Task C에 사용될 수 있다.
즉, 경험이 누적되면서 Agent가 처음부터 시행착오를 반복할 필요가 줄어드는 구조다.
이때 ‘학습’은 반드시 모델 Weight가 바뀐다는 뜻이 아니다. NVIDIA는 이를 Gradient Descent 대신 Skill Refinement를 중심으로 하는 Continual Learning이라고 설명한다. 학습 결과도 하나의 Weight 파일보다는 계속 확장되는 Sensorimotor Skill Repository에 가깝다.
7. Experiments — 정말 효과가 있을까?
공식 실험은 LIBERO-Pro, Robosuite, BEHAVIOR-1K 등 다양한 로봇 조작 환경을 다룬다. NVIDIA가 2026년 10월 발표한 ASPIRE v1.0 공개 저장소에서는 LIBERO-Pro의 80개 작업에서 99% 성공률을 보고한다. 참고로 공식 페이지 기준 논문 본 실험은 LIBERO-Pro 160 개 작업을 각각 처음 보는 50 개 seed 에서 평가한다. 작은 debug split 에서 디버깅하고, 겹치지 않는 held-out seed 에서 점수를 내는 구조다.
하지만 이 성능을 모든 로봇 작업에서의 일반적인 성공률이라고 해석하면 안 된다. 어떤 벤치마크, 시드, 모델, 디버깅 조건을 사용했는지 구분해서 봐야 한다.
7-1. Zero-shot Transfer는 무엇인가?
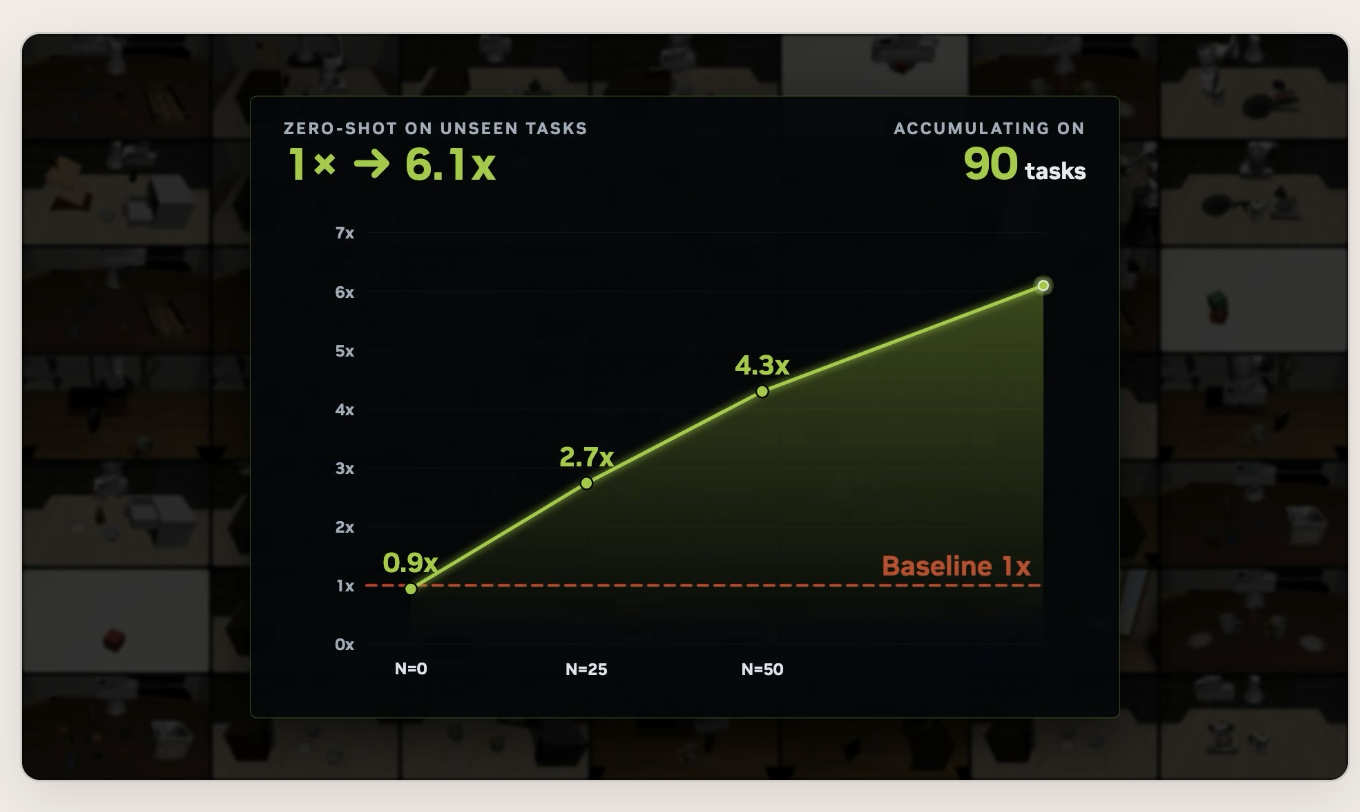
이미 다른 작업을 수행하면서 구축한 Skill Library가 있다고 하자. 이제 처음 보는 새로운 작업에 대해 별도 작업별 디버깅 없이 그 Library의 지식을 참고하여 프로그램을 생성한다. 이것이 ASPIRE에서 중요한 Zero-shot Transfer 관점이다.
‘아무런 사전 지식도 없는 상태에서 Zero-shot’이라는 뜻이 아니다. 기존 작업에서 누적된 Skill이 미지의 작업에 전이되는지를 평가하는 것이다.
공식 프로젝트에서는 Skill Library의 크기가 증가할수록 미학습 LIBERO-Long 작업의 성공률이 높아지는 경향을 제시한다.
7-2. Sim-to-Real과 비용
시뮬레이션에서 발견한 Skill을 실제 로봇 프로그래밍에 제공했을 때 처음 성공하는 코드를 만들기까지 필요한 토큰 수가 줄어드는지도 실험한다. 이는 단순한 로봇 동작 성공률과는 별개의 중요한 지표다.
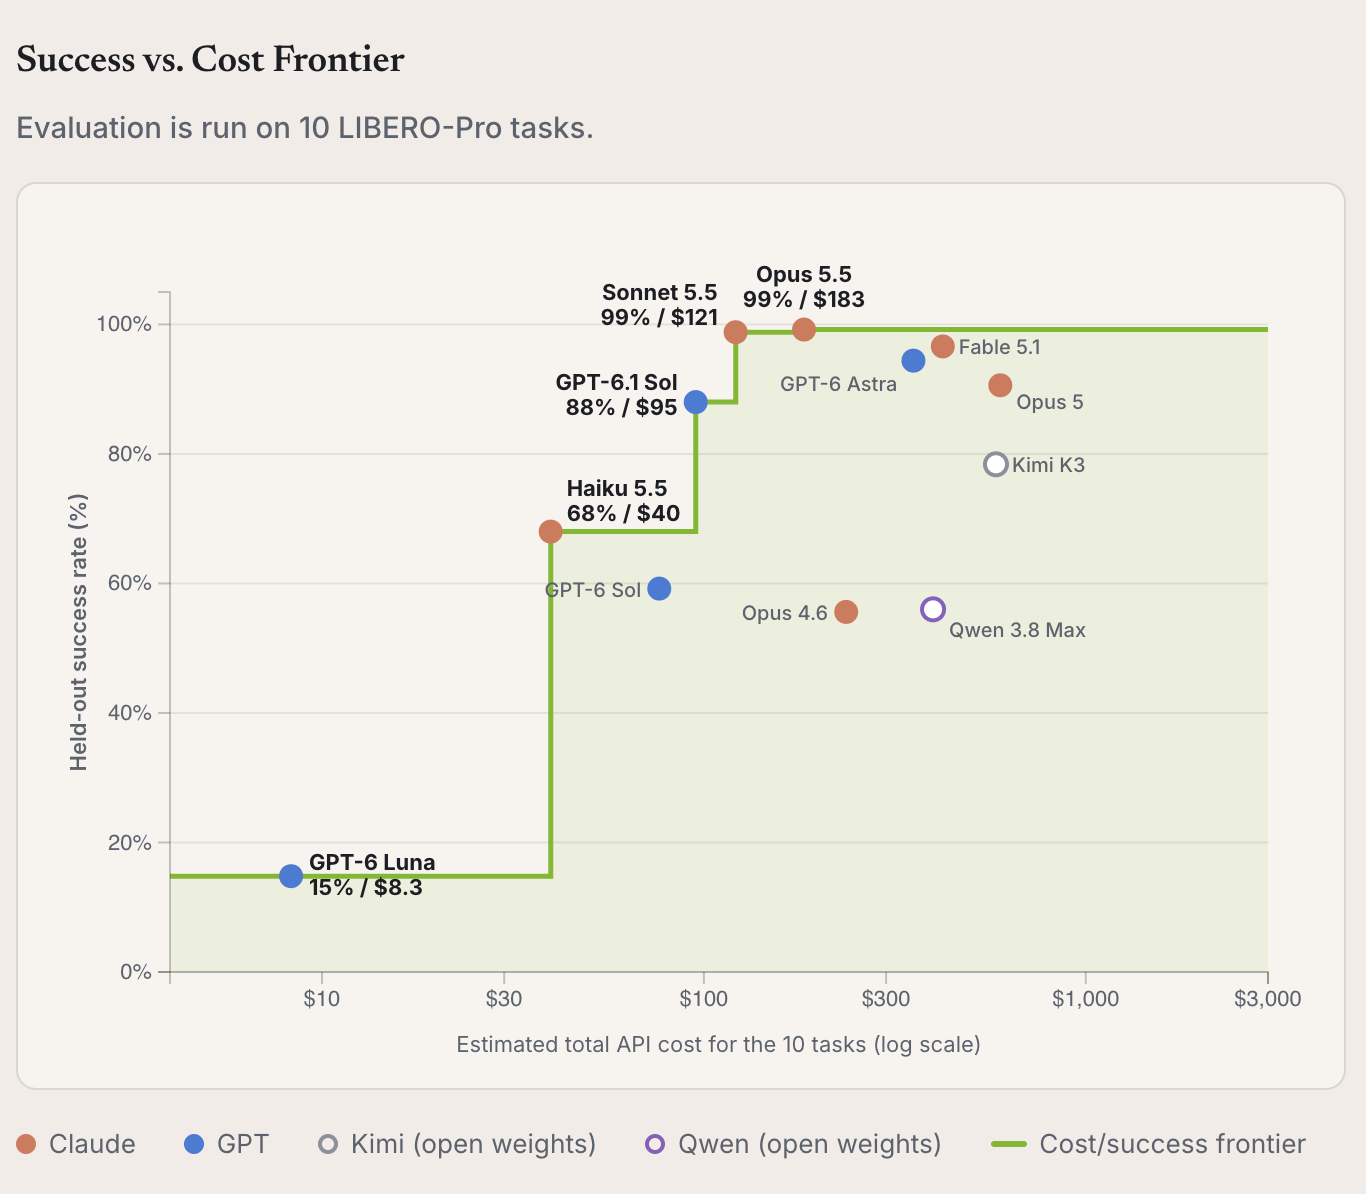
위 이미지는 내가 흥미롭게 본 API 토큰 사용 비용 자료다. 다만 이 비용 수치가 가리키는 모델·실험 설정·Task 수를 함께 봐야 한다. 특정 그림만 보고 ASPIRE의 모든 작업이 ‘10개 Task당 100달러’라고 일반화할 수는 없다.
또 하나 눈에 띄는 건 LLM 의존성이다. 같은 10 개 LIBERO-Pro 작업에서 어떤 모델을 쓰느냐에 따라 성공률이 15% (GPT-6 Luna) 부터 99% (Claude Opus 5.5) 까지 벌어진다. 그런데 제일 비싼 모델이 제일 잘하는 것도 아니라서, 결국 성공률 대비 비용을 같이 봐야 한다.
개인적으로는 이런 방식이 기술적으로 매력적이면서도, LLM 호출 비용과 시뮬레이션 실행 비용이 실제 확장성의 관건이 될 것 같다.
8. 한계와 생각해 볼 점
논문이 인정하는 한계도 꽤 분명하다.
- Primitive API의 범위: LLM은 이미 구현된 도구 위에서 정책을 생성하므로, 하위 API가 표현하지 못하는 행동에는 한계가 있다.
- 실제 로봇의 안전과 리셋: 시뮬레이션과 달리 물리 환경에서는 실패 후 원상복구, 안전성, Calibration이 어렵다.
- 강력한 LLM 의존성: Coding Agent가 복잡한 프로그램을 디버깅할 수 있어야 한다.
- 탐색 비용: 프로그램을 많이 생성하고 실행할수록 LLM 호출과 Rollout 비용이 증가한다.
- Library 관리: Skill이 많아지면 중복되고 오래된 지식, 잘못 일반화된 전략을 관리해야 한다.
8-1. VLA를 대체하는 연구일까?
내가 생각하는 결론은 꼭 그렇지는 않다는 것이다.
| 구분 | 일반적인 VLA | ASPIRE |
|---|---|---|
| 학습·개선 대상 | 신경망 Policy 가중치 | 코드 기반 Policy와 Skill Library |
| 대표 출력 | Action / Action Chunk | 실행 가능한 제어 프로그램 |
| 주요 입력 | 관측·언어·로봇 상태 | Task·API·기존 Skill·실행 로그 |
| 강점 | 관측 기반 연속 행동 예측 | 작업 절차 생성, 디버깅, 지식 재사용 |
| 의존성 | 학습 데이터와 모델 일반화 | Primitive API와 LLM 코딩 능력 |
VLA는 다음 Action을 어떻게 예측할지에 집중하는 반면, ASPIRE는 기존 로봇 기능을 이용해 어떤 프로그램을 작성하고 개선할지에 집중한다.
그래서 오히려 두 접근을 계층적으로 결합할 가능성도 있다. 상위 Agent가 작업을 계획하고 오류를 수정하면서, 특정 저수준 조작은 VLA나 별도의 학습된 Skill Policy에 위임하는 방식이다. 다만 이는 앞으로 시도해볼 만한 확장 방향이지, ASPIRE의 모든 실험에서 검증된 구성이라는 뜻은 아니다.
9. 개인적인 결론
처음 이 논문을 접했을 때는 ‘LLM이 여러 API를 조합해서 로봇을 움직이는 것 아닌가?’ 정도로 생각했다. 그런데 하나씩 살펴보니 진짜 중요한 부분은 API를 호출하는 행위 자체가 아니었다.
실패를 관찰하고 코드를 수정하는 Closed-loop, 다양한 정책을 탐색하는 Evolutionary Search, 그리고 그 결과를 다음 작업에 활용하는 Skill Library가 함께 돌아간다는 것이 핵심이었다.
특히 재미있는 점은 로봇 학습을 반드시 수많은 Demonstration과 Gradient Descent만으로 바라볼 필요가 없다는 것이다. LLM을 이용해 로봇 행동 프로그램을 점진적으로 개선하고, 그 경험을 코드와 지식으로 축적하는 방법도 있다는 것을 보여준다.
물론 저수준 제어 능력이나 실제 로봇의 물리적 제약은 여전히 남아 있다. 그렇지만 ‘로봇용 Agentic Workflow’라는 방향에서 ASPIRE는 꽤 의미 있는 연구라고 생각한다.
앞으로 더 궁금한 건 이렇게 생성된 Skill을 학습된 VLA Policy와 어떻게 연결할 수 있는가, 그리고 대규모 시뮬레이션에서 얻은 실패·성공 기록을 어떻게 저비용으로 축적할 수 있는가다.
이게 최근에 들은 이야기랑 정확히 연결된다. 지난주에 홀리데이로보틱스에서 박사후 연구를 하고 계신 연구원님이 이런 말씀을 하셨다. 개별 skill 하나하나는 fine-tuning 으로 정책 모델에 학습시킬 수 있지만, Long horizon task 로 넘어가면 skill 들을 어떤 순서와 우선순위로, 어떤 조건에서 이어 붙일지가 아직 부족하다는 것이다.
ASPIRE 의 Skill Library 는 바로 이 “조합” 쪽 문제를 코드와 지식으로 풀어보려는 시도로 보인다. 사람으로 치면 자전거 타기, 축구, 야구 같은 skill 이 머릿속에 있으면, 처음 보는 환경이든 배트 종류가 바뀌든 축구화 디자인이 달라지든 그 작업을 해낼 수 있다. 로봇도 결국 skill 을 쌓아두고 상황에 맞게 꺼내서 이어 붙이는 방향으로 가게 될 것 같다.